Kim byli John Nelder i Robert Wedderburn?
John Ashworth Nelder (1924–2010) był brytyjskim statystykiem, współtwórcą uogólnionych modeli liniowych (GLM) i metody simpleks. Urodził się 8 października 1924 r. w Dulverton w hrabstwie Somerset. Po roku studiów matematyki w Cambridge (1942–1943) spędził trzy lata w Królewskich Siłach Powietrznych (RAF), a po powrocie ukończył matematykę (1948) i statystykę matematyczną (1949). Został pierwszym statystykiem stacji badawczej warzywnictwa w Wellesbourne, a w 1968 r. zastąpił Franka Yatesa na stanowisku szefa statystyki w Rothamsted. Od 1972 r. był też profesorem wizytującym w Imperial College w Londynie, w 1984 r. przeszedł na emeryturę i zmarł 7 sierpnia 2010 r. (McCullagh i in., 2011).
Robert W. M. Wedderburn pracował w Dziale Statystyki w Rothamsted, którym kierował Nelder. Zmarł przedwcześnie w czerwcu 1975 r.; roczny raport stacji pisał, że w ciągu kilku lat pracy stał się wybitnym młodszym członkiem działu (Rothamsted Experimental Station, 1976).
Najważniejsze pomysły
- Uogólnione modele liniowe (1972). Nelder i Wedderburn (1972) pokazali, że jedną procedurą – iteracyjnie ważoną regresją liniową – można uzyskać oszacowania największej wiarygodności dla obserwacji z rozkładu normalnego, dwumianowego (w tym analiza probitowa), Poissona i gamma, jeśli efekty predyktorów są liniowe po odpowiednim przekształceniu. Zamiast analizy wariancji zaproponowali porównywanie logarytmów wiarygodności, czyli dewiancji. Według nekrologu Neldera pomysł wyszedł ze spostrzeżenia, że modyfikacja metody Newtona–Raphsona, której Fisher użył przy regresji dla danych binarnych, działa znacznie szerzej: wystarczą funkcja wariancji i funkcja łącząca (McCullagh i in., 2011).
- Quasi-wiarygodność (1974). Wedderburn (1974) zauważył, że do estymacji nie trzeba znać całego rozkładu – wystarczy założyć, jak wariancja zależy od średniej. Dla jednoparametrowej rodziny wykładniczej quasi-wiarygodność pokrywa się z wiarygodnością.
- Metoda simpleks (1965). Nelder i Roger Mead opisali minimalizację funkcji wielu zmiennych bez pochodnych: porównuje się wartości funkcji w wierzchołkach simpleksu (dla dwóch zmiennych – trójkąta) i zastępuje najgorszy wierzchołek nowym punktem, aż simpleks skurczy się wokół minimum (Nelder i Mead, 1965).
- Programy. Nelder rozwijał GenStat i współtworzył GLIM – interaktywny program do dopasowywania GLM, którego prawa przekazał Royal Statistical Society. Z Peterem McCullaghem napisał podręcznik „Generalized Linear Models” (wyd. 1983, drugie 1989; McCullagh i Nelder, 1989; McCullagh i in., 2011).
Ciekawostka
Statystyk na tropie rzadkich ptaków. Nelder był zapalonym obserwatorem ptaków i jednym z trojga znalazców pierwszego w Wielkiej Brytanii drozda syberyjskiego. Bardziej dumny był jednak z innego artykułu w „British Birds” z 1962 r.: statystycznie pokazał w nim, jak mało wiarygodne są liczne doniesienia o rzadkich ptakach z okolic Hastings z początku XX wieku, co uzasadniło późniejsze ich odrzucenie. Sam uważał tę analizę za niemal banalną, a autorzy jego nekrologu widzą w niej wczesny przykład GLM – sprzed spotkania z Wedderburnem (McCullagh i in., 2011).
Był też wirtuozem fortepianu – grywał sonaty Mozarta i śpiewał komiczne piosenki przy własnym akompaniamencie (McCullagh i in., 2011).
Przykład na historycznych danych
Zbiór ships z pakietu MASS pochodzi z podręcznika McCullagha i Neldera (pomoc pakietu wskazuje wydanie z 1983 r., rozdz. 6.3.2): liczba uszkodzeń statków i łączna liczba miesięcy służby według typu statku (A–E), okresu budowy i okresu eksploatacji. Po pominięciu 6 kombinacji bez ani jednego miesiąca służby zostają 34 wiersze, 356 uszkodzeń i 163 574 miesiące służby.
Dopasowujemy regresję Poissona z offsetem log(miesięcy służby) na trzy sposoby. IRLS ręcznie: w każdym kroku liczymy zmienną roboczą i wagi (dla Poissona z logarytmem wagą jest μ) i rozwiązujemy ważoną MNK. Dewiancja spada z 80.41 po pierwszym kroku do 41.53, 38.73 i 38.695 – dalej zmieniają się już tylko dalekie miejsca po przecinku. glm() daje identyczne współczynniki po 5 iteracjach (dewiancja 38.695 przy 25 df). Statki eksploatowane w latach 1975–1979 miały 1.47 raza więcej uszkodzeń na miesiąc służby niż w latach 1960–1974 (współczynnik 0.3845).
Quasi-Poisson w duchu Wedderburna zostawia te same współczynniki, ale szacuje parametr dyspersji φ = 1.69, więc błąd standardowy efektu okresu rośnie z 0.118 do 0.154 (zob. nadmierna dyspersja). Wreszcie optim() z domyślną metodą Neldera–Meada przy 9 parametrach zatrzymuje się po 502 obliczeniach funkcji z kodem 1 (limit iteracji) przy −log L = 80.06 zamiast 68.28. Przy 2 parametrach (wyraz wolny i okres) trafia w wynik glm() do trzeciego miejsca po przecinku po 59 obliczeniach funkcji; IWLS potrzebuje 6 iteracji.
Na rysunku
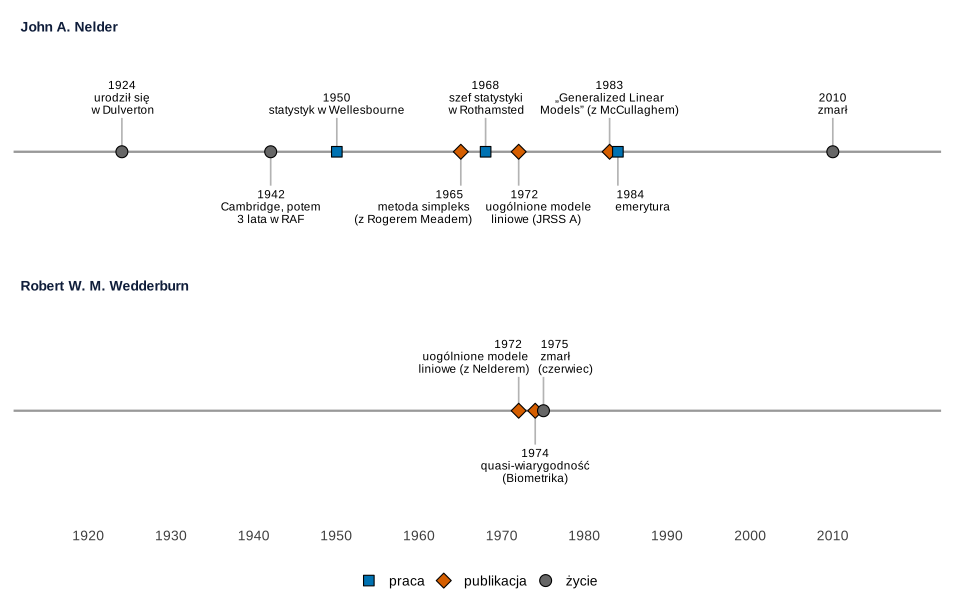
Co widać. Współpraca obu autorów zmieściła się w kilku latach w Rothamsted; Nelder rozwijał jej owoce przez kolejne 35 lat.
Na co uważać. Nie podajemy roku urodzenia Wedderburna, bo nie znaleźliśmy go w źródle, które mogliśmy przeczytać; pas Wedderburna pokazuje więc tylko lata jego publikacji i śmierci.
Podpis do pracy:
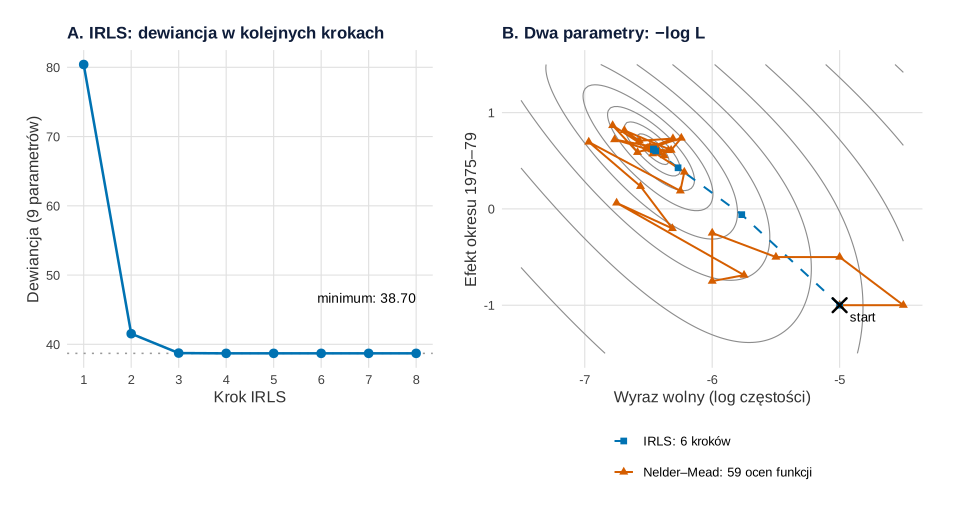
Co widać. IRLS korzysta z kształtu wiarygodności i po trzech krokach jest praktycznie u celu. Simpleks zna tylko wartości funkcji: schodzi zygzakiem i kurczy się wokół minimum.
Na co uważać. Przy dziewięciu parametrach Nelder–Mead zatrzymuje się daleko od minimum, a wynik zależy od punktu startowego. „Ocena funkcji” i krok IRLS to różne jednostki – krok IRLS jest droższy.
Podpis do pracy:
Gdzie spotkasz Neldera i Wedderburna w swojej pracy
Gdy liczysz regresję logistyczną, Poissona, gamma albo model mieszany GLMM, korzystasz z ich ramy: rozkład, predyktor liniowy, funkcja łącząca.
- funkcja
glm()w R liczy model metodą IWLS – to algorytm z pracy z 1972 r.; liczbę iteracji pokazujem$iter, a brak zbieżności to sygnał, by sprawdzić np. separację; - rodziny
quasipoissoniquasibinomialto quasi-wiarygodność Wedderburna – używasz ich, gdy wariancja jest większa, niż zakłada rozkład; - modele porównujesz dewiancją i testem ilorazu wiarygodności, a nie sumami kwadratów;
- dokumentacja funkcji
optim()podaje, że jej domyślną metodą jest implementacja metody Neldera i Meada (1965), która używa tylko wartości funkcji, jest odporna, ale stosunkowo wolna – dobra do własnych, nietypowych funkcji wiarygodności z kilkoma parametrami.
Zob. też wpis Regresja dla zliczeń krok po kroku.
Spory, mity i trudne strony
- „Uogólniony” czy „ogólny”? Nelder przyznawał, że żałuje nazwy, bo myli się ją z węższym ogólnym modelem liniowym (McCullagh i in., 2011). Ogólny model liniowy to regresja i ANOVA z błędem normalnym; uogólniony dopuszcza inne rozkłady i funkcje łączące.
- Zasada marginalności. Nelder ostro krytykował testowanie efektu głównego przy obecnej w modelu interakcji z tym czynnikiem (np. sumy kwadratów typu III w SAS i SPSS); uważał, że model z interakcją bez efektów głównych nie ma sensu naukowego (McCullagh i in., 2011).
GLM, IRLS i metoda Neldera–Meada w R
Kod wczytuje zbiór ships z pakietu MASS, dopasowuje regresję Poissona z offsetem ręcznie algorytmem IRLS i porównuje wynik z glm(), szacuje dyspersję w modelu quasi-Poissona, minimalizuje −log L funkcją optim() z domyślną metodą Neldera–Meada (9 i 2 parametry), a na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje; punkt startowy (−5, −1) w modelu z dwoma parametrami wybraliśmy ręcznie, żeby droga obu algorytmów była dobrze widoczna.
1. IRLS ręcznie, glm(), quasi-Poisson i optim() (rysunek 2)
Kod R rysunku 2
# Nelder i Wedderburn: uogólniony model liniowy liczony ręcznie (IRLS), glm(), quasi-Poisson i optim() z metodą Neldera–Meada
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(irls = "#0072B2", nm = "#D55E00", kontur = "grey55")   # Okabe–Ito + szarość
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(ships, package = "MASS")             # uszkodzenia statków: typ, okres budowy, okres eksploatacji, miesiące służby
statki <- subset(ships, service > 0)      # 6 kombinacji bez ani jednego miesiąca służby nie wnosi informacji
statki$year <- factor(statki$year)
statki$period <- factor(statki$period)
c(wiersze = nrow(statki), uszkodzenia = sum(statki$incidents), miesiace_sluzby = sum(statki$service))

# 1. IRLS ręcznie: regresja Poissona z offsetem log(miesięcy służby) jako ważona MNK powtarzana do zbieżności
X <- model.matrix(~ type + year + period, data = statki)
y <- statki$incidents
off <- log(statki$service)
beta <- c(log(sum(y) / sum(statki$service)), rep(0, ncol(X) - 1))   # start: wspólna częstość uszkodzeń
przebieg <- data.frame()
for (krok in 1:8) {
  eta <- drop(X %*% beta) + off
  mu <- exp(eta)
  z <- eta - off + (y - mu) / mu          # zmienna robocza
  w <- mu                                 # wagi robocze: 1 / [g'(mu)^2 V(mu)] = mu dla Poissona z logiem
  nowa <- drop(solve(crossprod(X, w * X), crossprod(X, w * z)))
  mu_n <- exp(drop(X %*% nowa) + off)
  dewiancja <- 2 * sum(ifelse(y > 0, y * log(y / mu_n), 0) - (y - mu_n))
  przebieg <- rbind(przebieg, data.frame(krok, dewiancja, zmiana = max(abs(nowa - beta))))
  beta <- nowa
}
przebieg$dewiancja <- round(przebieg$dewiancja, 5)
przebieg$zmiana <- signif(przebieg$zmiana, 3)
przebieg

# 2. To samo przez glm(): te same współczynniki, liczba iteracji IWLS, dewiancja
m <- glm(incidents ~ type + year + period + offset(log(service)), family = poisson, data = statki)
round(cbind(IRLS_recznie = beta, glm = coef(m), IRR = exp(coef(m))), 4)
c(iteracje_glm = m$iter, dewiancja = round(deviance(m), 3), df = df.residual(m))

# 3. Quasi-wiarygodność (Wedderburn 1974): ta sama średnia, wariancja = phi * mu; phi z reszt Pearsona
mq <- glm(incidents ~ type + year + period + offset(log(service)), family = quasipoisson, data = statki)
phi <- summary(mq)$dispersion
round(c(phi = phi, SE_period_Poisson = sqrt(vcov(m)["period75", "period75"]), SE_period_quasi = sqrt(vcov(mq)["period75", "period75"])), 3)

# 4. optim() – domyślnie metoda Neldera–Meada (simpleks), która używa tylko wartości funkcji
minus_logL <- function(b) -sum(dpois(y, exp(drop(X %*% b) + off), log = TRUE))
nm9 <- optim(rep(0, ncol(X)), minus_logL)
c(oceny_funkcji = unname(nm9$counts[1]), kod_zbieznosci = nm9$convergence,
  minus_logL_NM = round(nm9$value, 2), minus_logL_glm = round(-as.numeric(logLik(m)), 2))

# Ten sam algorytm przy dwóch parametrach (wyraz wolny i okres eksploatacji): zapisujemy każdy oceniany punkt
X2 <- model.matrix(~ period, data = statki)
odwiedzone <- data.frame()
minus_logL2 <- function(b) {
  odwiedzone <<- rbind(odwiedzone, data.frame(b0 = b[1], b1 = b[2]))
  -sum(dpois(y, exp(drop(X2 %*% b) + off), log = TRUE))
}
start <- c(-5, -1)
nm2 <- optim(start, minus_logL2)
m2 <- glm(incidents ~ period + offset(log(service)), family = poisson, data = statki, start = start)
round(rbind(Nelder_Mead = nm2$par, glm_IWLS = coef(m2)), 4)
c(oceny_funkcji_NM = unname(nm2$counts[1]), iteracje_IWLS = m2$iter)

# Kroki IRLS z tego samego punktu startowego (do rysunku)
b <- start; kroki <- data.frame(b0 = b[1], b1 = b[2])
for (i in 1:m2$iter) {
  eta <- drop(X2 %*% b) + off; mu <- exp(eta)
  b <- drop(solve(crossprod(X2, mu * X2), crossprod(X2, mu * (eta - off + (y - mu) / mu))))
  kroki <- rbind(kroki, data.frame(b0 = b[1], b1 = b[2]))
}

# Rysunek 2A: dewiancja w kolejnych krokach IRLS (pełny model, 9 parametrów)
pA <- ggplot(przebieg, aes(krok, dewiancja)) +
  geom_hline(yintercept = deviance(m), colour = "grey60", linetype = "dotted") +
  geom_line(colour = kol[["irls"]], linewidth = 0.9) +
  geom_point(colour = kol[["irls"]], size = 3, shape = 16) +
  annotate("text", x = 8, y = deviance(m) + 8, label = sprintf("minimum: %.2f", deviance(m)), hjust = 1, size = 3.6) +
  scale_x_continuous(breaks = 1:8) +
  labs(title = "A. IRLS: dewiancja w kolejnych krokach", x = "Krok IRLS", y = "Dewiancja (9 parametrów)") +
  motyw
# Rysunek 2B: powierzchnia −log L dla dwóch parametrów; punkty oceniane przez Neldera–Meada i kroki IRLS
siatka <- expand.grid(b0 = seq(-7.5, -4.5, length.out = 120), b1 = seq(-1.5, 1.5, length.out = 120))
siatka$f <- apply(siatka, 1, function(b) -sum(dpois(y, exp(drop(X2 %*% b) + off), log = TRUE)))
odwiedzone$nr <- seq_len(nrow(odwiedzone))
sciezki <- rbind(data.frame(odwiedzone[, c("b0", "b1")], metoda = sprintf("Nelder–Mead: %d ocen funkcji", nrow(odwiedzone))),
                 data.frame(kroki, metoda = sprintf("IRLS: %d kroków", m2$iter)))
pB <- ggplot() +
  geom_contour(data = siatka, aes(b0, b1, z = log(f - min(f) + 1)), colour = kol[["kontur"]], bins = 12, linewidth = 0.4) +
  geom_path(data = sciezki, aes(b0, b1, colour = metoda, linetype = metoda), linewidth = 0.7) +
  geom_point(data = sciezki, aes(b0, b1, colour = metoda, shape = metoda), size = 2) +
  annotate("point", x = start[1], y = start[2], shape = 4, size = 4, stroke = 1.3) +
  annotate("text", x = start[1] + 0.08, y = start[2] - 0.12, label = "start", hjust = 0, size = 3.5) +
  scale_colour_manual(values = setNames(c(kol[["nm"]], kol[["irls"]]), unique(sciezki$metoda)), name = NULL) +
  scale_linetype_manual(values = setNames(c("solid", "dashed"), unique(sciezki$metoda)), name = NULL) +
  scale_shape_manual(values = setNames(c(17, 15), unique(sciezki$metoda)), name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(title = "B. Dwa parametry: −log L", x = "Wyraz wolny (log częstości)", y = "Efekt okresu 1975–79") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.15))
p2
Wynik w R
        wiersze     uszkodzenia miesiace_sluzby
             34             356          163574
  krok dewiancja   zmiana
1    1  80.40834 9.96e-01
2    2  41.53255 4.37e-01
3    3  38.73323 1.81e-01
4    4  38.69506 3.19e-02
5    5  38.69505 5.78e-04
6    6  38.69505 1.68e-07
7    7  38.69505 7.99e-14
8    8  38.69505 6.93e-14
            IRLS_recznie     glm    IRR
(Intercept)      -6.4059 -6.4059 0.0017
typeB            -0.5433 -0.5433 0.5808
typeC            -0.6874 -0.6874 0.5029
typeD            -0.0760 -0.0760 0.9269
typeE             0.3256  0.3256 1.3848
year65            0.6971  0.6971 2.0080
year70            0.8184  0.8184 2.2669
year75            0.4534  0.4534 1.5737
period75          0.3845  0.3845 1.4688
iteracje_glm    dewiancja           df
       5.000       38.695       25.000
              phi SE_period_Poisson   SE_period_quasi
            1.691             0.118             0.154
 oceny_funkcji kod_zbieznosci  minus_logL_NM minus_logL_glm
        502.00           1.00          80.06          68.28
            (Intercept) period75
Nelder_Mead     -6.4608   0.6199
glm_IWLS        -6.4609   0.6201
oceny_funkcji_NM    iteracje_IWLS
              59                6
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: John A. Nelder (1924–2010) i Robert W. M. Wedderburn (zm. 1975) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1924, 1942, 1950, 1965, 1968, 1972, 1983, 1984, 2010,
          1972, 1974, 1975),
  osoba = c(rep("John A. Nelder", 9), rep("Robert W. M. Wedderburn", 3)),
  opis = c("urodził się\nw Dulverton", "Cambridge, potem\n3 lata w RAF", "statystyk w Wellesbourne",
           "metoda simpleks\n(z Rogerem Meadem)", "szef statystyki\nw Rothamsted", "uogólnione modele\nliniowe (JRSS A)",
           "„Generalized Linear\nModels” (z McCullaghem)", "emerytura", "zmarł",
           "uogólnione modele\nliniowe (z Nelderem)", "quasi-wiarygodność\n(Biometrika)", "zmarł\n(czerwiec)"),
  rodzaj = c("życie", "życie", "praca", "publikacja", "praca", "publikacja", "publikacja", "praca", "życie",
             "publikacja", "publikacja", "życie"),
  strona = c(1, -1, 1, -1, 1, -1, 1, -1, 1,
             1, -1, 1),
  wyrownanie = c(0.5, 0.5, 0.5, 0.9, 0.5, 0.3, 0.5, 0.05, 0.5,
                 0.9, 0.5, 0.1))   # rozsunięcie bliskich etykiet
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("John A. Nelder", "Robert W. M. Wedderburn"))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = 0.5 * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = 0.56 * strona, label = paste0(rok, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1916, 2018), breaks = seq(1920, 2010, by = 10)) +
  scale_y_continuous(limits = c(-1.5, 1.5)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (GLM – funkcja glm(), optymalizacja – optim() z pakietu stats; dane – pakiet MASS; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim byli John Nelder i Robert Wedderburn?
Brytyjskimi statystykami z działu statystyki w Rothamsted. Nelder (1924–2010) kierował tym działem od 1968 r., współtworzył programy GenStat i GLIM oraz metodę simpleks; Wedderburn był jego młodszym współpracownikiem i zmarł przedwcześnie w czerwcu 1975 r. (McCullagh i in., 2011; Rothamsted Experimental Station, 1976).
Co to jest IRLS w uogólnionych modelach liniowych?
Iteracyjnie ważona metoda najmniejszych kwadratów: w każdym kroku liczy się zmienną roboczą i wagi z bieżących przewidywań i rozwiązuje ważoną regresję liniową, aż oszacowania przestaną się zmieniać. Nelder i Wedderburn (1972) pokazali, że daje ona oszacowania największej wiarygodności dla rozkładów z rodziny wykładniczej; tak liczy funkcja glm() w R.
Czym jest quasi-wiarygodność Wedderburna?
Sposobem estymacji, w którym zamiast pełnego rozkładu zakłada się tylko związek między średnią a wariancją obserwacji (Wedderburn, 1974). W R korzystają z niego rodziny quasipoisson i quasibinomial, które szacują dodatkowy parametr dyspersji.
Czy metoda Neldera–Meada to domyślna metoda optim() w R?
Tak – dokumentacja funkcji optim() podaje, że domyślna metoda jest implementacją metody Neldera i Meada (1965), która używa tylko wartości funkcji i jest odporna, ale stosunkowo wolna. Przy wielu parametrach może zatrzymać się przed minimum, dlatego warto sprawdzać kod zbieżności.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- McCullagh, P., & Nelder, J. A. (1989). Generalized linear models (2nd ed.). Chapman and Hall. https://doi.org/10.1007/978-1-4899-3242-6
- McCullagh, P., Gilchrist, R., & Payne, R. (2011). John Ashworth Nelder, 1924–2010 [Obituary]. Journal of the Royal Statistical Society: Series A (Statistics in Society), 174(2), 499–504. https://doi.org/10.1111/j.1467-985x.2010.00680.x ● Otwarty dostęp
- Nelder, J. A., & Mead, R. (1965). A simplex method for function minimization. The Computer Journal, 7(4), 308–313. https://doi.org/10.1093/comjnl/7.4.308
- Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370–384. https://doi.org/10.2307/2344614
- Rothamsted Experimental Station. (1976). Report for 1975 – Part 1. Lawes Agricultural Trust. https://doi.org/10.23637/eradoc-1-132 ● Otwarty dostęp
- Wedderburn, R. W. M. (1974). Quasi-likelihood functions, generalized linear models, and the Gauss–Newton method. Biometrika, 61(3), 439–447. https://doi.org/10.1093/biomet/61.3.439
Cytowania BibTeX
@book{mccullagh1989generalized, author={McCullagh, P. and Nelder, J. A.}, title={{Generalized linear models}}, year={1989}, edition={2}, publisher={Chapman and Hall}, doi={10.1007/978-1-4899-3242-6}}@article{mccullagh2011john, author={McCullagh, Peter and Gilchrist, Bob and Payne, Roger}, title={{John Ashworth Nelder, 1924–2010 [Obituary]}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2011}, volume={174}, number={2}, pages={499--504}, doi={10.1111/j.1467-985x.2010.00680.x}}@article{nelder1965simplex, author={Nelder, J. A. and Mead, R.}, title={{A simplex method for function minimization}}, journal={The Computer Journal}, year={1965}, volume={7}, number={4}, pages={308--313}, doi={10.1093/comjnl/7.4.308}}@article{nelder1972generalized, author={Nelder, J. A. and Wedderburn, R. W. M.}, title={{Generalized linear models}}, journal={Journal of the Royal Statistical Society: Series A (General)}, year={1972}, volume={135}, number={3}, pages={370--384}, doi={10.2307/2344614}}@techreport{rothamsted1976report, author={{Rothamsted Experimental Station}}, title={{Report for 1975 – Part 1}}, year={1976}, institution={Lawes Agricultural Trust}, doi={10.23637/eradoc-1-132}}@article{wedderburn1974quasi, author={Wedderburn, R. W. M.}, title={{Quasi-likelihood functions, generalized linear models, and the Gauss–Newton method}}, journal={Biometrika}, year={1974}, volume={61}, number={3}, pages={439--447}, doi={10.1093/biomet/61.3.439}}