Kim jest Jerome Friedman?
Jerome H. Friedman (ur. 1939), zwany Jerrym, to statystyk ze Stanford University, współautor drzew decyzyjnych CART i twórca boostingu gradientowego. Statystykiem stał się okrężną drogą: z wykształcenia jest fizykiem cząstek elementarnych i, jak sam mówi, nigdy nie był na żadnym kursie statystyki (Fisher, 2015).
Urodził się w Yrece w północnej Kalifornii. Po dwóch latach w Chico State przeniósł się w 1959 r. na Uniwersytet Kalifornijski w Berkeley, gdzie w 1962 r. skończył fizykę, a w 1968 r. obronił doktorat z fizyki wysokich energii; promotorem był Ron Ross z grupy Luisa Alvareza. Na studiach przeglądał zdjęcia śladów cząstek z komór pęcherzykowych. W fizyce poznał też metodę największej wiarygodności, od której, jak wspomina, zaczęło się jego zainteresowanie statystyką (Fisher, 2015).
W 1972 r. objął kierownictwo grupy badań obliczeniowych (Computation Research Group) w akceleratorowym centrum SLAC pod Stanfordem i prowadził ją do 2006 r. Od 1981 r. był równocześnie profesorem statystyki w Stanfordzie na pół etatu, a w 2007 r. został profesorem emerytowanym. W 2005 r. wybrano go do American Academy of Arts and Sciences, a w 2010 r. do National Academy of Sciences (Fisher, 2015).
Najważniejsze pomysły
- Projection pursuit (1974). Z Johnem Tukeyem opracował algorytm szukający takich jedno- i dwuwymiarowych rzutów danych wielowymiarowych, które najwięcej ujawniają (Friedman i Tukey, 1974). W przeciwieństwie do PCA nie maksymalizuje wariancji. Była to jego pierwsza praca statystyczna (Fisher, 2015).
- CART (1984). Z Leo Breimanem, Richardem Olshenem i Charlesem Stone’em napisał monografię o drzewach klasyfikacyjnych i regresyjnych (Breiman i in., 1984). Jego droga do drzew wiodła przez szybkie algorytmy szukania najbliższych sąsiadów, które dzieliły przestrzeń danych rekurencyjnie (Fisher, 2015).
- MARS (1991). Wielowymiarowe adaptacyjne splajny regresyjne: model składa się z iloczynów prostych funkcji odcinkowych, a ich liczbę i położenie węzłów wybierają dane. Pomysł wyrósł z drzew, ale daje funkcję ciągłą i oddziela efekty addytywne od interakcji (Friedman, 1991).
- Gradient boosting (2001). Model budowany krok po kroku jako suma małych drzew, z których każde jest dopasowywane do ujemnego gradientu funkcji straty – w regresji ze stratą kwadratową po prostu do reszt. Działa też dla straty bezwzględnej, Hubera i dla klasyfikacji (Friedman, 2001). Przy pracy nad nią Friedman zauważył, że zmniejszanie wkładu każdego drzewa (współczynnik uczenia, shrinkage) poprawia trafność (Fisher, 2015).
- Uczenie statystyczne. Z Trevorem Hastiem i Robertem Tibshiranim wyjaśnił boosting z perspektywy statystyki i współtworzył pakiet glmnet do lasso i elastic net (Fisher, 2015).
Ciekawostka
Przez około dziesięć lat Friedman co czwartek jeździł do Berkeley, by pracować z Breimanem. Breiman rezerwował na to cały dzień i nikogo innego wtedy nie przyjmował. Po pracy obaj szli na piwo. Właśnie w pubie zapadła decyzja o nazwie metody przekształceń zmiennych, nad którą wtedy pracowali: Breiman pokazał przez okno sklep żelazny po drugiej stronie ulicy z dużym czerwonym szyldem „Ace” – i tak powstała nazwa ACE (Fisher, 2015).
Gradient boosting też ma swoje miejsce urodzenia. Narodził się w latach 1998–1999 w Sydney, w czasie pobytu Friedmana w instytucie CSIRO: zafascynowany boostingiem postanowił rozszerzyć go na regresję i inne funkcje straty (Fisher, 2015).
Przykład: boosting z pni ręcznie
Dane pochodzą z pakietu ISLR: statystyki zawodników ligi baseballowej MLB z sezonu 1986 i z całej kariery oraz ich pensje na początek sezonu 1987. Po usunięciu braków zostaje 263 zawodników. Prognozujemy logarytm pensji (transformacja logarytmiczna) z 19 zmiennych. Losowo (set.seed(2001)) 175 zawodników trafia do zbioru uczącego, 88 – do testowego.
Algorytm z pracy Friedmana (2001) w wersji dla straty kwadratowej mieści się w kilkunastu liniach. Zaczynamy od średniej. W każdym kroku dopasowujemy do bieżących reszt pień – drzewo z jednym podziałem (rpart, maxdepth = 1) – i dodajemy do modelu jego prognozę pomnożoną przez współczynnik uczenia ν. Porównujemy ν = 1 (pełny krok) i ν = 0.1.
Punkty odniesienia na zbiorze testowym: sama średnia daje średni kwadrat błędu (MSE) 0.758, regresja liniowa 0.354, a jedno drzewo CART przycięte walidacją krzyżową 0.314. Przy ν = 1 błąd testowy spada najniżej do 0.245 (16 pni), a potem waha się wokół 0.27, choć na zbiorze uczącym maleje do 0.002 po 500 krokach. Przy ν = 0.1 schodzi wolniej, ale niżej: do 0.213 przy 67 pniach; po 500 krokach wynosi 0.250. Pierwsze 100 pni najczęściej dzieliło zawodników według liczby lat w lidze (18 razy).
Na rysunku
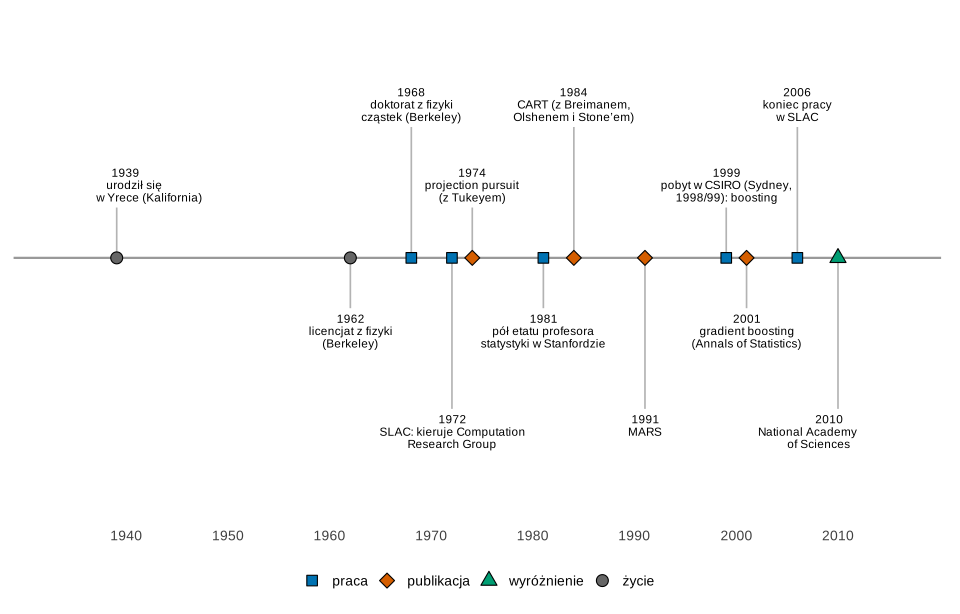
Co widać. Fizyka do 1972 r., potem praca na styku obliczeń i statystyki.
Na co uważać. W latach 1981–2006 Friedman pracował równocześnie w SLAC i na wydziale statystyki.
Podpis do pracy:
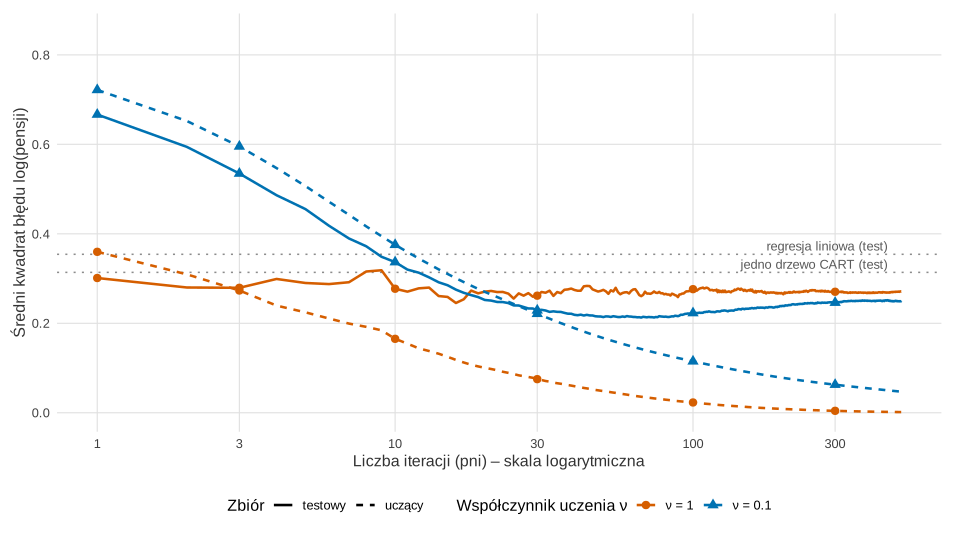
ISLR::Hitters. Obliczenia i rysunek: R, pakiety rpart i ggplot2 (set.seed(2001)).Co widać. Błąd na zbiorze uczącym spada bez końca – to nie jest miara jakości. Na zbiorze testowym pełny krok (ν = 1) szybko osiąga dno i dalej tylko „szumi”, a mały krok (ν = 0.1) potrzebuje więcej pni, ale dochodzi do niższego błędu niż regresja liniowa, pojedyncze drzewo i boosting z ν = 1. Za minimum błąd powoli rośnie – to przeuczenie.
Na co uważać. Przy 88 zawodnikach testowych różnice rzędu 0.01–0.03 mogą zależeć od podziału. Liczby iteracji nie wybiera się z krzywej testowej: w praktyce służy do tego walidacja krzyżowa na zbiorze uczącym.
Podpis do pracy:
Gdzie spotkasz Friedmana w swojej pracy
- Modele predykcyjne. Gdy w pracy porównujesz regresję z gradient boostingiem (pakiety gbm, xgboost), używasz algorytmu z 2001 r. Jego hiperparametry – liczba drzew, współczynnik uczenia, głębokość – pochodzą z tej pracy.
- Drzewa decyzyjne. Funkcja
rpart()w R realizuje idee CART: podziały binarne i przycinanie walidacją krzyżową. Drzewo regresyjne i las losowy na jednym przykładzie pokazuje wpis Drzewa decyzyjne i lasy losowe. - Nieliniowe zależności. MARS jest bliskim krewnym splajnów i GAM – zob. wpis Nieliniowe zależności: splajny i GAM.
- Podręcznik. Jest współautorem The Elements of Statistical Learning (z Hastiem i Tibshiranim), choć – jak przyznaje – większość książki napisali jego współautorzy (Fisher, 2015).
Spory, mity i trudne strony
- Czy Friedman wymyślił boosting? Nie: sama idea boostingu pochodzi z literatury uczenia maszynowego – Friedman wskazuje prace Freunda i Schapire’a z 1996 r. Jego wkład to statystyczne wyjaśnienie boostingu (z Hastiem i Tibshiranim) i ogólna konstrukcja „gradientowa” dla dowolnej różniczkowalnej funkcji straty (Fisher, 2015; Friedman, 2001).
- „To nie jest statystyka”. Friedman wspomina, że po jednym z jego wystąpień Colin Mallows uznał pokazaną metodę za fascynującą, ale dodał, że to nie jest statystyka. Według Friedmana nie była to wrogość, tylko powszechna wtedy konsternacja: ciekawe, ale co to ma wspólnego ze statystyką (Fisher, 2015). Do sporu o granice statystyki wraca David Donoho.
Gradient boosting ręcznie w R
Kod dzieli dane ISLR::Hitters na zbiór uczący i testowy, dopasowuje boosting z pni (drzew rpart o jednym podziale) dla dwóch współczynników uczenia, liczy punkty odniesienia (średnia, regresja liniowa, przycięte drzewo CART) i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Ziarna: set.seed(2001) (podział danych) i set.seed(1984) (walidacja krzyżowa drzewa).
1. Boosting z pni a liczba iteracji: rysunek 2
Kod R rysunku 2
# Gradient boosting ręcznie: drzewa-pnie z rpart dopasowywane kolejno do reszt (strata kwadratowa)
suppressPackageStartupMessages({library(rpart); library(ggplot2)})
kol <- c("ν = 1" = "#D55E00", "ν = 0.1" = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# Dane: zawodnicy ligi MLB, statystyki z sezonu 1986 i całej kariery, pensja z 1987 r. (tys. USD)
data(Hitters, package = "ISLR")
d <- na.omit(Hitters)
d$y <- log(d$Salary); d$Salary <- NULL
nrow(d)
set.seed(2001)
ucz <- sample(nrow(d), 175)
du <- d[ucz, ]; dt <- d[-ucz, ]
X_u <- du[setdiff(names(d), "y")]; X_t <- dt[setdiff(names(d), "y")]

# Algorytm (Friedman, 2001): F0 = średnia; w kroku m dopasuj pień do reszt y − F i dodaj v · pień (v – współczynnik uczenia ν)
boosting <- function(v, M) {
  F_u <- rep(mean(du$y), nrow(du)); F_t <- rep(mean(du$y), nrow(dt))
  wynik <- data.frame(m = 0:M, uczacy = NA, testowy = NA, zmienna = NA)
  wynik[1, 2:3] <- c(mean((du$y - F_u)^2), mean((dt$y - F_t)^2))
  for (m in 1:M) {
    dane_r <- cbind(X_u, r = du$y - F_u)                     # reszty = minus gradient straty kwadratowej / 2
    pien <- rpart(r ~ ., data = dane_r, control = rpart.control(maxdepth = 1, cp = 0, minsplit = 10, xval = 0))
    F_u <- F_u + v * predict(pien, X_u)
    F_t <- F_t + v * predict(pien, X_t)
    wynik[m + 1, 2:3] <- c(mean((du$y - F_u)^2), mean((dt$y - F_t)^2))
    wynik$zmienna[m + 1] <- as.character(pien$frame$var[1])
  }
  wynik
}
M <- 500
b1 <- boosting(v = 1, M); b01 <- boosting(v = 0.1, M)

# Punkty odniesienia: średnia, regresja liniowa, jedno drzewo przycięte walidacją krzyżową
mse <- function(p) mean((dt$y - p)^2)
lin <- lm(y ~ ., data = du)
set.seed(1984)
drz <- rpart(y ~ ., data = du, control = rpart.control(cp = 0.001, xval = 10))
cp_min <- drz$cptable[which.min(drz$cptable[, "xerror"]), "CP"]
drz <- prune(drz, cp = cp_min)
odniesienie <- c(srednia = mse(mean(du$y)), regresja_liniowa = mse(predict(lin, dt)), drzewo_CART = mse(predict(drz, dt)))
round(odniesienie, 3)

# Błąd testowy (MSE logarytmu pensji) po wybranych liczbach iteracji
kroki <- c(1, 5, 10, 25, 50, 100, 200, 500)
round(data.frame(iteracje = kroki, uczacy_v1 = b1$uczacy[kroki + 1], testowy_v1 = b1$testowy[kroki + 1],
                 uczacy_v01 = b01$uczacy[kroki + 1], testowy_v01 = b01$testowy[kroki + 1]), 3)
# minimum błędu testowego (tylko do opisu; w praktyce liczbę iteracji wybiera się walidacją krzyżową)
sapply(list(v1 = b1, v01 = b01), function(b) c(iteracje = b$m[which.min(b$testowy)], MSE = round(min(b$testowy), 3)))

# Które zmienne wybierały pnie w pierwszych 100 iteracjach (v = 0.1)?
head(sort(table(b01$zmienna[2:101]), decreasing = TRUE), 5)

# Rysunek: błąd na zbiorze uczącym i testowym w funkcji liczby iteracji
dl <- rbind(data.frame(m = b1$m, mse = b1$uczacy, v = "ν = 1", zbior = "uczący"),
            data.frame(m = b1$m, mse = b1$testowy, v = "ν = 1", zbior = "testowy"),
            data.frame(m = b01$m, mse = b01$uczacy, v = "ν = 0.1", zbior = "uczący"),
            data.frame(m = b01$m, mse = b01$testowy, v = "ν = 0.1", zbior = "testowy"))
dl <- dl[dl$m >= 1, ]
dl$v <- factor(dl$v, levels = c("ν = 1", "ν = 0.1")); dl$zbior <- factor(dl$zbior, levels = c("testowy", "uczący"))
ref <- data.frame(y = odniesienie[2:3], etykieta = c("regresja liniowa (test)", "jedno drzewo CART (test)"))
p2 <- ggplot(dl, aes(m, mse, colour = v, linetype = zbior)) +
  geom_hline(data = ref, aes(yintercept = y), colour = "grey55", linetype = "dotted") +
  geom_text(data = ref, aes(x = 450, y = y, label = etykieta), inherit.aes = FALSE, hjust = 1, vjust = -0.4,
            size = 3.4, colour = "grey35") +
  geom_line(linewidth = 0.9) +
  geom_point(data = dl[dl$m %in% c(1, 3, 10, 30, 100, 300), ], aes(shape = v), size = 2.6) +
  scale_colour_manual(values = kol, name = "Współczynnik uczenia ν") +
  scale_shape_manual(values = c("ν = 1" = 16, "ν = 0.1" = 17), name = "Współczynnik uczenia ν") +
  scale_linetype_manual(values = c("testowy" = "solid", "uczący" = "22"), name = "Zbiór") +
  scale_x_log10(breaks = c(1, 3, 10, 30, 100, 300)) +
  coord_cartesian(ylim = c(0, 0.85)) +
  labs(x = "Liczba iteracji (pni) – skala logarytmiczna", y = "Średni kwadrat błędu log(pensji)") +
  motyw
p2
Wynik w R
[1] 263
         srednia regresja_liniowa      drzewo_CART
           0.758            0.354            0.314
  iteracje uczacy_v1 testowy_v1 uczacy_v01 testowy_v01
1        1     0.360      0.301      0.722       0.667
2        5     0.224      0.290      0.507       0.455
3       10     0.165      0.277      0.375       0.337
4       25     0.087      0.255      0.243       0.240
5       50     0.048      0.275      0.167       0.214
6      100     0.023      0.276      0.115       0.223
7      200     0.008      0.266      0.078       0.239
8      500     0.002      0.271      0.047       0.250
             v1    v01
iteracje 16.000 67.000
MSE       0.245  0.213

 Years CAtBat CHmRun  CRuns   CRBI
    18      9      9      9      8
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Jerome H. Friedman (ur. 1939) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1939, 1962, 1968, 1972, 1974, 1981, 1984, 1991, 1999, 2001, 2006, 2010),
  opis = c("urodził się\nw Yrece (Kalifornia)", "licencjat z fizyki\n(Berkeley)", "doktorat z fizyki\ncząstek (Berkeley)",
           "SLAC: kieruje Computation\nResearch Group", "projection pursuit\n(z Tukeyem)", "pół etatu profesora\nstatystyki w Stanfordzie",
           "CART (z Breimanem,\nOlshenem i Stone’em)", "MARS", "pobyt w CSIRO (Sydney,\n1998/99): boosting", "gradient boosting\n(Annals of Statistics)",
           "koniec pracy\nw SLAC", "National Academy\nof Sciences"),
  rodzaj = c("życie", "życie", "praca", "praca", "publikacja", "praca", "publikacja", "publikacja", "praca", "publikacja",
             "praca", "wyróżnienie"),
  poziom = c(0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3, -1.5),   # wysokość etykiety
  wyrownanie = c(0.2, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.8))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1933, 2016), breaks = seq(1940, 2010, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (drzewa – pakiet rpart; regresja liniowa – lm() z pakietu stats; dane – pakiet ISLR; rysunki – pakiet ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rpart (wersja 4.1.24): Therneau, T., & Atkinson, B. (2025). rpart: Recursive partitioning and regression trees [R package]. https://doi.org/10.32614/CRAN.package.rpart
- ISLR (wersja 1.4): James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). ISLR: Data for an introduction to statistical learning with applications in R [R package]. https://doi.org/10.32614/CRAN.package.ISLR
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Kim jest Jerome Friedman?
Amerykańskim statystykiem (ur. 1939), z wykształcenia fizykiem cząstek. Doktorat z fizyki wysokich energii zrobił w Berkeley w 1968 r., w latach 1972–2006 kierował grupą badań obliczeniowych w SLAC, a od 1981 r. był też profesorem statystyki w Stanfordzie. Jest współautorem CART i twórcą MARS oraz gradient boostingu (Fisher, 2015).
Co wymyślił Jerome Friedman?
Między innymi metodę projection pursuit, opracowaną z Tukeyem w 1974 r., drzewa klasyfikacyjne i regresyjne CART, opisane z Breimanem, Olshenem i Stone’em w 1984 r., wielowymiarowe adaptacyjne splajny regresyjne MARS (1991) i gradient boosting (2001), czyli budowanie modelu z małych drzew dopasowywanych kolejno do gradientu funkcji straty.
Czym różni się gradient boosting Friedmana od zwykłego boostingu?
Boosting z uczenia maszynowego dotyczył klasyfikacji. Friedman (2001) opisał go jako spadek gradientowy w przestrzeni funkcji, co pozwala użyć dowolnej różniczkowalnej funkcji straty: kwadratowej, bezwzględnej, Hubera czy logistycznej. W regresji ze stratą kwadratową każde kolejne drzewo dopasowuje się po prostu do reszt.
Po co w boostingu mały współczynnik uczenia?
Bo każde drzewo dodaje wtedy tylko ułamek poprawki i model mniej dopasowuje się do szumu. W przykładzie z danymi o pensjach baseballistów boosting z pni z ν = 0.1 osiągnął niższy błąd testowy (MSE 0.213) niż z pełnym krokiem ν = 1 (0.245), choć potrzebował więcej iteracji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Drzewa decyzyjne i lasy losowe
CART i przycinanie w rpart, las losowy w ranger, ważność permutacyjna, zależność cząstkowa, walidacja na nowych danych i wzór opisu.
Czytaj →PoradnikNieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984). Classification and regression trees. Wadsworth International Group.
- Fisher, N. I. (2015). A conversation with Jerry Friedman. Statistical Science, 30(2), 268–295. https://doi.org/10.1214/14-sts509 ● Otwarty dostęp
- Friedman, J. H. (1991). Multivariate adaptive regression splines. The Annals of Statistics, 19(1), 1–67. https://doi.org/10.1214/aos/1176347963 ● Otwarty dostęp
- Friedman, J. H. (2001). Greedy function approximation: A gradient boosting machine. The Annals of Statistics, 29(5), 1189–1232. https://doi.org/10.1214/aos/1013203451
- Friedman, J. H., & Tukey, J. W. (1974). A projection pursuit algorithm for exploratory data analysis. IEEE Transactions on Computers, C-23(9), 881–890. https://doi.org/10.1109/t-c.1974.224051
Cytowania BibTeX
@book{breiman1984classification, author={Breiman, Leo and Friedman, Jerome H. and Olshen, Richard A. and Stone, Charles J.}, title={{Classification and regression trees}}, year={1984}, publisher={Wadsworth International Group}}@article{fisher2015conversation, author={Fisher, Nicholas I.}, title={{A conversation with Jerry Friedman}}, journal={Statistical Science}, year={2015}, volume={30}, number={2}, pages={268--295}, doi={10.1214/14-sts509}}@article{friedman1991multivariate, author={Friedman, Jerome H.}, title={{Multivariate adaptive regression splines}}, journal={The Annals of Statistics}, year={1991}, volume={19}, number={1}, pages={1--67}, doi={10.1214/aos/1176347963}}@article{friedman2001greedy, author={Friedman, Jerome H.}, title={{Greedy function approximation: A gradient boosting machine}}, journal={The Annals of Statistics}, year={2001}, volume={29}, number={5}, pages={1189--1232}, doi={10.1214/aos/1013203451}}@article{friedman1974projection, author={Friedman, Jerome H. and Tukey, John W.}, title={{A projection pursuit algorithm for exploratory data analysis}}, journal={IEEE Transactions on Computers}, year={1974}, volume={C-23}, number={9}, pages={881--890}, doi={10.1109/t-c.1974.224051}}