Kim był William S. Cleveland?
William Swain Cleveland (1943–2026) urodził się 24 stycznia 1943 r. w Sussex w stanie New Jersey. Studiował matematykę w Princeton – pracę dyplomową prowadził u niego William Feller – a w 1969 r. obronił doktorat ze statystyki w Yale pod kierunkiem Leonarda Jimmiego Savage’a (Cleveland, b.d.; Drake & Son Funeral Home, 2026).
Większość kariery spędził w Bell Labs w Murray Hill, w dziale badań statystycznych, którym przez 12 lat kierował (Cleveland, b.d.). Pracował tam m.in. z Johnem Tukeyem i Johnem Chambersem (Drake & Son Funeral Home, 2026). Od 1 stycznia 2004 r. był profesorem statystyki (Shanti S. Gupta Distinguished Professor) i informatyki w Purdue University. Zmarł 27 marca 2026 r. w wieku 83 lat.
Najważniejsze pomysły
- LOESS (1979). Cleveland (1979) zaproponował wygładzanie wykresu rozrzutu odporną regresją lokalnie ważoną: wartość krzywej w punkcie x pochodzi z wielomianu dopasowanego ważonymi najmniejszymi kwadratami do sąsiednich obserwacji, a procedura odporna chroni krzywą przed obserwacjami odstającymi. Metodę opisuje hasło LOESS.
- Percepcja graficzna (1984). Z Robertem McGillem uporządkował elementarne zadania, które wykonuje oko przy odczytywaniu liczb z wykresu (położenie na wspólnej skali, długość, kąt, pole i inne), według dokładności odczytu. Wniosek: wykresy powinny korzystać z zadań z czołówki tej listy, a popularne wykresy kołowe i skumulowane słupkowe warto zastępować m.in. wykresami punktowymi (Cleveland i McGill, 1984).
- Trellis. Z zespołem opracował wykres Trellis – siatkę paneli, w których te same zmienne pokazuje się warunkowo, dla kolejnych wartości innej zmiennej. Trafił do S-Plus i do R (Cleveland, b.d.); w R implementuje go pakiet lattice. To jedna z odmian małych wielokrotności.
Za prace w czasopiśmie Technometrics dwa razy dostał Nagrodę Wilcoxona (1975, 1977) i raz Nagrodę Youdena (1987), a w 2016 r. nagrodę American Statistical Association za całokształt dorobku w dziedzinie grafiki i obliczeń (Purdue University Department of Statistics, b.d.). Założył też Sekcję Grafiki Statystycznej ASA (Cleveland, b.d.).
Ciekawostka
Cleveland był jednym z pierwszych, którzy nadali nazwie „data science” jej dzisiejsze znaczenie. W artykule w „International Statistical Review” zaproponował plan rozszerzenia statystyki o sześć obszarów pracy wydziału uniwersyteckiego. Wartość pracy technicznej miała się mierzyć tym, na ile pomaga ona analitykowi danych (Cleveland, 2001). We własnym życiorysie naukowym zaznaczył, że plan przedstawił najpierw w referacie na sesji Międzynarodowego Instytutu Statystycznego w 1999 r., a samo określenie było używane wcześniej, tylko w innych znaczeniach (Cleveland, b.d.).
Wśród tych sześciu obszarów są teoria i modele statystyczne, metody i algorytmy statystyki oraz uczenia maszynowego, środowiska obliczeniowe i analizy prawdziwych danych, oceniane po tym, co z nich wynikło. Według nekrologu poza statystyką był też muzykiem i śpiewakiem – zainteresowanie i muzyką, i matematyką przejął po ojcu, nauczycielu obu tych przedmiotów (Drake & Son Funeral Home, 2026).
Przykład na danych z pakietu R
Zbiór ethanol z pakietu lattice to – według pliku pomocy – 88 pomiarów z silnika jednocylindrowego zasilanego etanolem, opisanych przez N. D. Brinkmana w 1981 r.: stężenie tlenków azotu w spalinach (NOx), współczynnik ekwiwalencji E (bogactwo mieszanki paliwa z powietrzem) i stopień sprężania C (5 ustawień). Plik pomocy jako odniesienie podaje książkę Clevelanda Visualizing Data.
Zwykła regresja liniowa NOx na E nie widzi prawie nic: nachylenie −0.566, R² = .010, p = .346. Tymczasem na wykresie rozrzutu widać wyraźny „garb”. LOESS ze span = 0.3 (10.1 parametru efektywnego) wyjaśnia 93.6% zmienności, a ze span = 0.75 (4.3 parametru) – 88.3%. Obie krzywe mają szczyt przy E ≈ 0.92–0.93, na wysokości 3.78 i 3.67 µg/J; mniejszy span daje dodatkowe drobne załamania na lewym zboczu.
Rozrzut wokół krzywej nie jest jednak tylko szumem. Gdy LOESS w E połączymy z liniową zależnością od C (tak zwane dopasowanie warunkowo parametryczne), odchylenie standardowe reszt spada z 0.337 do 0.184. Szczyt pozostaje przy E ≈ 0.90–0.92, ale jego wysokość rośnie ze sprężaniem: od 3.51 µg/J przy C = 7.5 do 4.32 µg/J przy C = 18.
Na rysunku
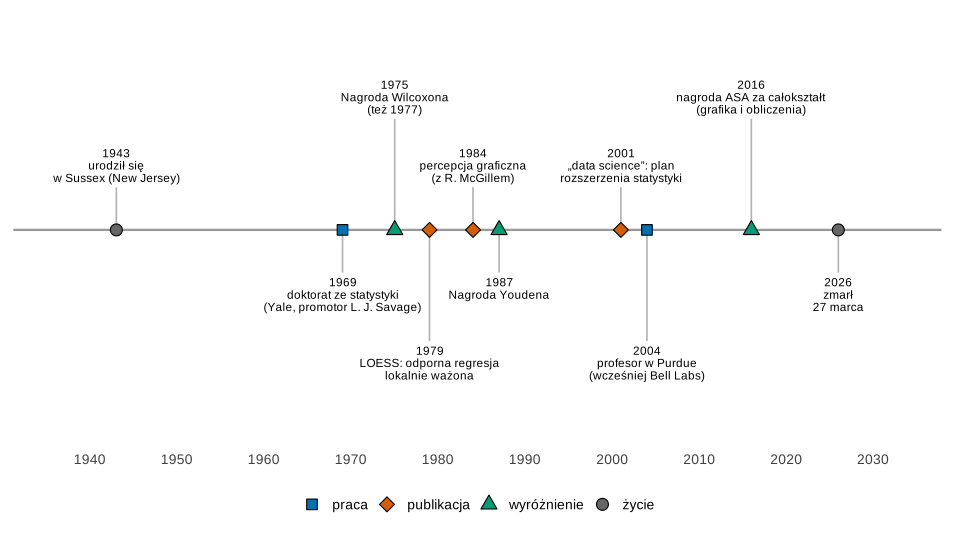
Co widać. Najbardziej znane prace – LOESS i percepcja graficzna – powstały w latach Bell Labs, a program data science Cleveland ogłosił, zanim przeniósł się na uczelnię.
Na co uważać. Źródła nie podają roku przyjścia do Bell Labs ani lat kierowania działem, dlatego tych zdarzeń nie ma na osi.
Podpis do pracy:
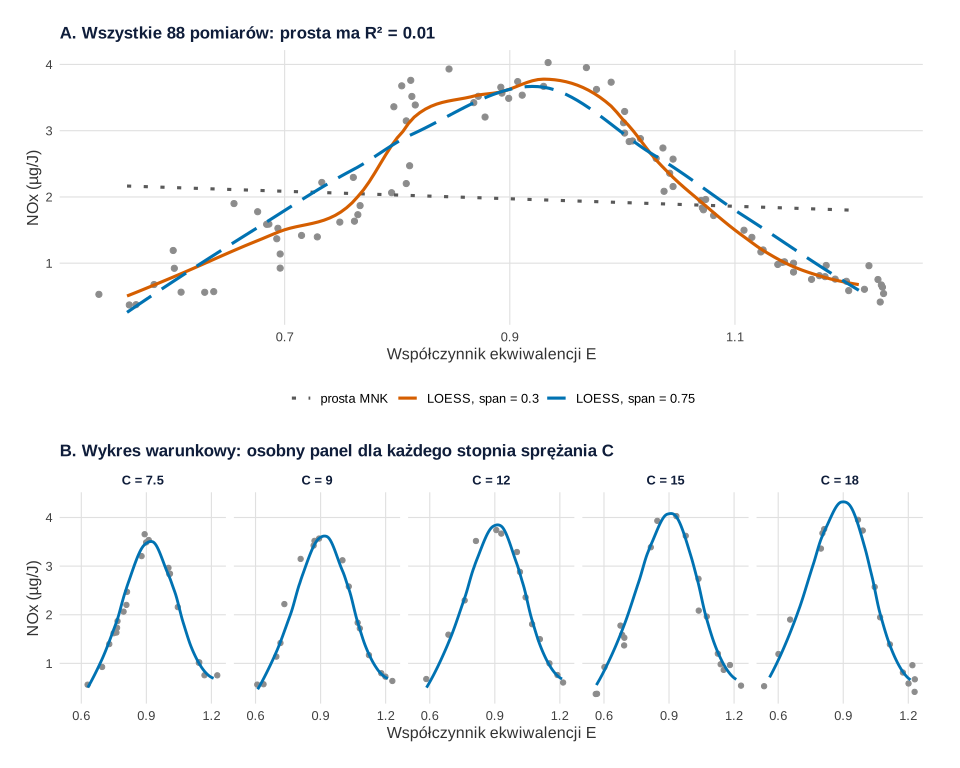
lattice::ethanol. Obliczenia i rysunek: R, pakiety ggplot2 i patchwork (bez losowania).Co widać. W panelu A prosta jest prawie płaska, choć zależność jest silna – tylko nieliniowa. LOESS pokazuje ją bez zakładania kształtu z góry. Panel B to pomysł z czasów Trellis: ten sam wykres w małych panelach dla kolejnych wartości trzeciej zmiennej. Duża część rozrzutu z panelu A znika, bo wynikała z różnic w sprężaniu.
Na co uważać. Wartości span (0.3 i 0.75) wybraliśmy ręcznie, żeby pokazać różnicę; mniejszy span lepiej dopasowuje się do tych danych, ale część jego załamań może być szumem. W panelu B kształt krzywej w E jest wspólny, a od C zależy liniowo – to założenie modelu, nie wniosek z danych.
Podpis do pracy:
Gdzie spotkasz Clevelanda w swojej pracy
- Linia wygładzona na wykresie rozrzutu. W ggplot2 funkcja
geom_smooth()przy mniej niż 1000 obserwacji domyślnie rysuje właśnie LOESS. Zanim wpiszesz do pracy r albo prostą regresji, zobacz, czy krzywa nie ma garbu jak w rysunku 2. LOESS przydaje się też na wykresie reszt względem wartości dopasowanych; o modelowaniu nieliniowości pisze wpis Nieliniowe zależności: splajny i GAM. - Wybór typu wykresu. Porządek zadań percepcyjnych z 1984 r. to argument za punktami na wspólnej osi zamiast kół i słupków skumulowanych; praktyczne wskazówki są we wpisie Wykresy w pracy dyplomowej.
- Panele zamiast jednego zatłoczonego wykresu. Gdy zależność zmienia się z trzecią zmienną (interakcja), pokaż ją w panelach ze wspólną skalą, jak w rysunku 2B.
Spory, mity i trudne strony
- Czy Cleveland „wymyślił” data science? Sam pisał, że nazwy używano wcześniej w innych znaczeniach; przypisuje sobie nadanie jej dzisiejszego sensu (Cleveland, b.d.). Ostrożniej więc mówić, że zaproponował program, niż że ukuł termin.
- „Wykresy kołowe są zakazane”. Cleveland i McGill (1984) porównywali dokładność odczytu liczb, a nie estetykę. Ich wniosek dotyczy sytuacji, w której czytelnik ma porównywać wartości; zbliżone tezy o oszczędnej grafice głosił Edward Tufte.
- lowess czy loess? W R to dwie różne funkcje:
lowess()ma domyślnie span 2/3 i trzy iteracje odporne, aloess()– span 0.75, lokalne parabole i brak iteracji odpornych (chyba że ustawiszfamily = "symmetric"). Podając w pracy „krzywą LOESS”, podaj funkcję i span.
LOESS i wykres warunkowy w R
Kod wczytuje dane lattice::ethanol, dopasowuje prostą i LOESS przy dwóch wartościach span, a potem model LOESS warunkowany na stopniu sprężania i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. LOESS na danych o spalaniu etanolu: rysunek 2
Kod R rysunku 2
# William S. Cleveland: LOESS i wykres warunkowy na jego danych o spalaniu etanolu (lattice::ethanol)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(prosta = "grey35", s03 = "#D55E00", s075 = "#0072B2")             # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(ethanol, package = "lattice")
# NOx – tlenki azotu w spalinach (mikrogramy/J); E – współczynnik ekwiwalencji (bogactwo mieszanki);
# C – stopień sprężania silnika (5 ustawień); 88 pomiarów
str(ethanol)
table(C = ethanol$C)

# 1. Prosta regresja liniowa: czy NOx zależy od E?
m_lin <- lm(NOx ~ E, data = ethanol)
round(c(nachylenie = unname(coef(m_lin)[2]), R2 = summary(m_lin)$r.squared,
        p = summary(m_lin)$coefficients[2, 4]), 3)

# 2. LOESS (lokalne parabole, degree = 2) przy dwóch wartościach span
siatka <- data.frame(E = seq(0.56, 1.21, by = 0.005))
dopasuj <- function(s) {
  m <- loess(NOx ~ E, data = ethanol, span = s, degree = 2)
  y <- predict(m, siatka)
  data.frame(span = s, enp = round(m$enp, 1), sd_reszt = round(m$s, 3),
             R2 = round(1 - sum(residuals(m)^2) / sum((ethanol$NOx - mean(ethanol$NOx))^2), 3),
             E_szczyt = siatka$E[which.max(y)], NOx_szczyt = round(max(y), 2))
}
do.call(rbind, lapply(c(0.3, 0.75), dopasuj))

# 3. Warunkowanie na C: LOESS w E, a w C zależność liniowa (model warunkowo parametryczny)
m_EC <- loess(NOx ~ E * C, data = ethanol, span = 0.5, degree = 2,
              parametric = "C", drop.square = "C")
m_E <- loess(NOx ~ E, data = ethanol, span = 0.5, degree = 2)
round(c(sd_reszt_tylko_E = m_E$s, sd_reszt_E_i_C = m_EC$s), 3)
szczyty <- do.call(rbind, lapply(sort(unique(ethanol$C)), function(cc) {
  y <- predict(m_EC, data.frame(E = siatka$E, C = cc))
  data.frame(C = cc, E_szczyt = siatka$E[which.max(y)], NOx_szczyt = round(max(y, na.rm = TRUE), 2))
}))
szczyty

# Rysunek: A – wszystkie pomiary, prosta i dwie krzywe LOESS; B – wykres warunkowy (panele według C)
krzywe <- rbind(data.frame(E = siatka$E, NOx = predict(m_lin, siatka), linia = "prosta MNK"),
                data.frame(E = siatka$E, NOx = predict(loess(NOx ~ E, ethanol, span = 0.3), siatka), linia = "LOESS, span = 0.3"),
                data.frame(E = siatka$E, NOx = predict(loess(NOx ~ E, ethanol, span = 0.75), siatka), linia = "LOESS, span = 0.75"))
krzywe$linia <- factor(krzywe$linia, levels = c("prosta MNK", "LOESS, span = 0.3", "LOESS, span = 0.75"))
pA <- ggplot(ethanol, aes(E, NOx)) +
  geom_point(colour = "grey55", size = 1.8) +
  geom_line(data = krzywe, aes(colour = linia, linetype = linia), linewidth = 1.1) +
  scale_colour_manual(values = unname(kol), name = NULL) +
  scale_linetype_manual(values = c("dotted", "solid", "longdash"), name = NULL) +
  labs(title = sprintf("A. Wszystkie 88 pomiarów: prosta ma R² = %.2f", summary(m_lin)$r.squared),
       x = "Współczynnik ekwiwalencji E", y = "NOx (µg/J)") +
  motyw
warunkowe <- do.call(rbind, lapply(sort(unique(ethanol$C)), function(cc) {
  zakres <- range(ethanol$E[ethanol$C == cc])
  e <- siatka$E[siatka$E >= zakres[1] & siatka$E <= zakres[2]]
  data.frame(C = cc, E = e, NOx = predict(m_EC, data.frame(E = e, C = cc)))
}))
etyk <- function(x) paste0("C = ", x)
pB <- ggplot(ethanol, aes(E, NOx)) +
  geom_point(colour = "grey55", size = 1.5) +
  geom_line(data = warunkowe, colour = kol[["s075"]], linewidth = 1) +
  facet_wrap(~ C, nrow = 1, labeller = as_labeller(etyk)) +
  scale_x_continuous(breaks = c(0.6, 0.9, 1.2)) +
  labs(title = "B. Wykres warunkowy: osobny panel dla każdego stopnia sprężania C",
       x = "Współczynnik ekwiwalencji E", y = "NOx (µg/J)") +
  motyw
p2 <- pA / pB + plot_layout(heights = c(1.3, 1))
p2
Wynik w R
'data.frame':	88 obs. of  3 variables:
 $ NOx: num  3.74 2.29 1.5 2.88 0.76 ...
 $ C  : num  12 12 12 12 12 9 9 9 12 12 ...
 $ E  : num  0.907 0.761 1.108 1.016 1.189 ...
C
7.5   9  12  15  18
 22  17  14  19  16
nachylenie         R2          p
    -0.566      0.010      0.346
  span  enp sd_reszt    R2 E_szczyt NOx_szczyt
1 0.30 10.1    0.308 0.936     0.93       3.78
2 0.75  4.3    0.397 0.883     0.92       3.67
sd_reszt_tylko_E   sd_reszt_E_i_C
           0.337            0.184
     C E_szczyt NOx_szczyt
1  7.5    0.920       3.51
2  9.0    0.920       3.62
3 12.0    0.915       3.85
4 15.0    0.910       4.08
5 18.0    0.900       4.32
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: William S. Cleveland (1943–2026) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1943, 1969, 1975, 1979, 1984, 1987, 2001, 2004, 2016, 2026),
  opis = c("urodził się\nw Sussex (New Jersey)", "doktorat ze statystyki\n(Yale, promotor L. J. Savage)",
           "Nagroda Wilcoxona\n(też 1977)", "LOESS: odporna regresja\nlokalnie ważona",
           "percepcja graficzna\n(z R. McGillem)", "Nagroda Youdena",
           "„data science”: plan\nrozszerzenia statystyki", "profesor w Purdue\n(wcześniej Bell Labs)",
           "nagroda ASA za całokształt\n(grafika i obliczenia)", "zmarł\n27 marca"),
  rodzaj = c("życie", "praca", "wyróżnienie", "publikacja", "publikacja", "wyróżnienie",
             "publikacja", "praca", "wyróżnienie", "życie"),
  poziom = c(0.5, -0.5, 1.3, -1.3, 0.5, -0.5, 0.5, -1.3, 1.3, -0.5),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1936, 2033), breaks = seq(1940, 2030, by = 10)) +
  scale_y_continuous(limits = c(-2.3, 2.3)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (regresja i LOESS – funkcje lm() i loess() z pakietu stats; dane – pakiet lattice; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lattice (wersja 0.22.9): Sarkar, D. (2008). Lattice: Multivariate data visualization with R. Springer. https://lattice.r-forge.r-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był William S. Cleveland?
Amerykańskim statystykiem (1943–2026). Studiował matematykę w Princeton, w 1969 r. obronił doktorat ze statystyki w Yale, przez większość kariery pracował w Bell Labs (12 lat jako kierownik działu badań statystycznych), a od 2004 r. był profesorem w Purdue University. Znany z LOESS, badań nad czytaniem wykresów i wykresu Trellis.
Co to jest LOESS i skąd się wziął?
Regresja lokalnie ważona: krzywa przez wykres rozrzutu powstaje z wielu małych regresji ważonych odległością od danego punktu. Cleveland opisał ją w 1979 r. w „Journal of the American Statistical Association”. W danych o spalaniu etanolu prosta ma R² = .010, a LOESS ze span = 0.75 wyjaśnia 88.3% zmienności.
Co ustalili Cleveland i McGill o wykresach?
Że liczby odczytujemy najdokładniej z położenia punktów na wspólnej skali, gorzej z długości, kątów i pól. Dlatego zalecali wykresy punktowe zamiast wielu wykresów kołowych i słupkowych skumulowanych (Cleveland i McGill, 1984).
Czy to Cleveland wymyślił termin data science?
Nie samo słowo – w swoim życiorysie zaznaczył, że używano go wcześniej w innych znaczeniach. W 1999 r. w referacie i w 2001 r. w artykule zaproponował dzisiejsze rozumienie: rozszerzenie statystyki o sześć obszarów, od teorii po środowiska obliczeniowe i analizę prawdziwych danych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikNieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cleveland, W. S. (1979). Robust locally weighted regression and smoothing scatterplots. Journal of the American Statistical Association, 74(368), 829–836. https://doi.org/10.1080/01621459.1979.10481038
- Cleveland, W. S. (2001). Data science: An action plan for expanding the technical areas of the field of statistics. International Statistical Review, 69(1), 21–26. https://doi.org/10.1111/j.1751-5823.2001.tb00477.x
- Cleveland, W. S. (b.d.). William S. Cleveland: Background, past research, current research, and publications. Purdue University, Department of Statistics. Pobrano 20 listopada 2026 z https://www.stat.purdue.edu/~wsc/ ● Otwarty dostęp
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Drake & Son Funeral Home. (2026). William "Bill" Swain Cleveland [nekrolog]. Dignity Memorial. https://www.dignitymemorial.com/obituaries/chicago-il/william-cleveland-12806860 ● Otwarty dostęp
- Purdue University Department of Statistics. (b.d.). William S. Cleveland [profil pracownika]. Pobrano 20 listopada 2026 z https://www.stat.purdue.edu/people/faculty/wsc.html ● Otwarty dostęp
Cytowania BibTeX
@article{cleveland1979robust, author={Cleveland, William S.}, title={{Robust locally weighted regression and smoothing scatterplots}}, journal={Journal of the American Statistical Association}, year={1979}, volume={74}, number={368}, pages={829--836}, doi={10.1080/01621459.1979.10481038}}@article{cleveland2001data, author={Cleveland, William S.}, title={{Data science: An action plan for expanding the technical areas of the field of statistics}}, journal={International Statistical Review}, year={2001}, volume={69}, number={1}, pages={21--26}, doi={10.1111/j.1751-5823.2001.tb00477.x}}@misc{clevelandbdpurdue, author={Cleveland, William S.}, title={{William S. Cleveland: Background, past research, current research, and publications}}, publisher={Purdue University, Department of Statistics}, url={https://www.stat.purdue.edu/~wsc/}}@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@misc{dignity2026cleveland, author={{Drake \& Son Funeral Home}}, title={{William "Bill" Swain Cleveland [nekrolog]}}, year={2026}, publisher={Dignity Memorial}, url={https://www.dignitymemorial.com/obituaries/chicago-il/william-cleveland-12806860}}@misc{purduebdclevelandprofil, author={{Purdue University Department of Statistics}}, title={{William S. Cleveland [profil pracownika]}}, publisher={Purdue University}, url={https://www.stat.purdue.edu/people/faculty/wsc.html}}