Kim jest Edward Tufte?
Edward R. Tufte (ur. 1942) to amerykański politolog i statystyk, znany przede wszystkim jako autor zasad projektowania wykresów. Studiował statystykę na Uniwersytecie Stanforda, a doktorat z nauk politycznych uzyskał w Yale. Od 1967 r. uczył w Princeton, a w latach 1977–1999 w Yale, gdzie prowadził zajęcia z nauk politycznych i statystyki (Yaffa, 2011).
Szerszej publiczności dał się poznać w 1983 r. książką The Visual Display of Quantitative Information, wydaną przez własne wydawnictwo Graphics Press (Tufte, 1983). Potem ukazały się m.in. Envisioning Information (1990) i Beautiful Evidence (Tufte, 2006), a jego jednodniowe kursy prezentowania danych przyciągnęły do 2011 r. ponad 190 tys. osób. W marcu 2010 r. został społecznym doradcą federalnej rady, która nadzorowała przejrzystość wydatków z amerykańskiego pakietu stymulacyjnego (Yaffa, 2011).
Najważniejsze pomysły
- Proporcja tuszu danych. To stosunek tuszu, który pokazuje dane, do całego tuszu w rysunku. Im wyższa, tym lepiej – większość tuszu nie-danych da się usunąć bez straty informacji (Midway, 2020).
- Chartjunk. Tak Tufte nazwał elementy, które nie mówią nic nowego o danych: nadmiar kolorów i etykiet, kolorowe tło, zbędne linie siatki. W jego ujęciu to tusz nie-danych albo nadmiarowy tusz danych (Rougier i in., 2014).
- Małe wielokrotności i sparklines. Seria małych wykresów na wspólnych osiach – małe wielokrotności – i sparklines, drobne wykresy liniowe wielkości słowa, wplecione w tekst lub tabelę. Te drugie opisał w Beautiful Evidence (Tufte, 2006); pojawiły się potem m.in. w serwisach finansowych i w Excelu (Yaffa, 2011).
- Styl poznawczy PowerPointa. W eseju o slajdach NASA policzył, że wykresy na nich pokazywały średnio dwanaście liczb. Komisja badająca katastrofę promu Columbia przywołała jego analizę w raporcie z sierpnia 2003 r. (Yaffa, 2011).
Ciekawostka
Książka na hipotekę. Według reportażu Yaffy (2011) wydawcy, którym Tufte pokazał rękopis, chcieli przeprojektować wiele stron i widzieli w nim niszowy tytuł na kilka tysięcy egzemplarzy. Tufte wziął więc drugą hipotekę na dom, oprocentowaną na 18%, i wydał książkę sam, razem z projektantem Howardem Grallą. Drukarni kazał oprawić tylko połowę pierwszego nakładu 5000 egzemplarzy.
Książka ukazała się w kwietniu 1983 r. i do 2011 r. doczekała się dwudziestego dodruku. Sam Tufte mówił, że wydawanie na własną rękę pozwoliło mu na niezwykłą drobiazgowość w dopracowaniu każdej strony (Yaffa, 2011).
Przykład na historycznych danych
Zbiór VADeaths z pakietu datasets to roczne współczynniki zgonów na 1000 osób w Wirginii w 1940 r., w pięciu grupach wieku od 50–54 do 70–74 lat i czterech grupach ludności: wieś i miasto, mężczyźni i kobiety; plik pomocy podaje jako źródło artykuł L. Molyneaux, S. K. Gilliam i L. C. Florant w American Sociological Review z 1947 r. Narysowaliśmy je dwa razy: jako wykres słupkowy z typowymi ozdobnikami – szarym tłem, gęstą siatką, ramkami, legendą w ramce i wartością nad każdym słupkiem – oraz jako wykres liniowy z podpisami przy liniach, bez siatki i tła.
Tusz policzyliśmy z pikseli: każdy wykres wydrukowaliśmy do pliku PNG dwa razy w tym samym układzie – w całości i z tuszem nie-danych zamalowanym na biało. Proporcja tuszu danych wzrosła z 0.36 do 0.50. Ważniejsze jest jednak co innego: wersja z ozdobnikami zużywa 12.3 razy więcej tuszu, a tuszu nie-danych – 15.6 razy więcej. Prosty wykres pokazuje przy tym coś, co w gąszczu słupków ginie: w każdej grupie wieku najwięcej zgonów jest wśród mężczyzn w mieście (od 15.4 do 71.1 na 1000), a krzywe kobiet ze wsi i z miasta niemal się pokrywają.
Na rysunku
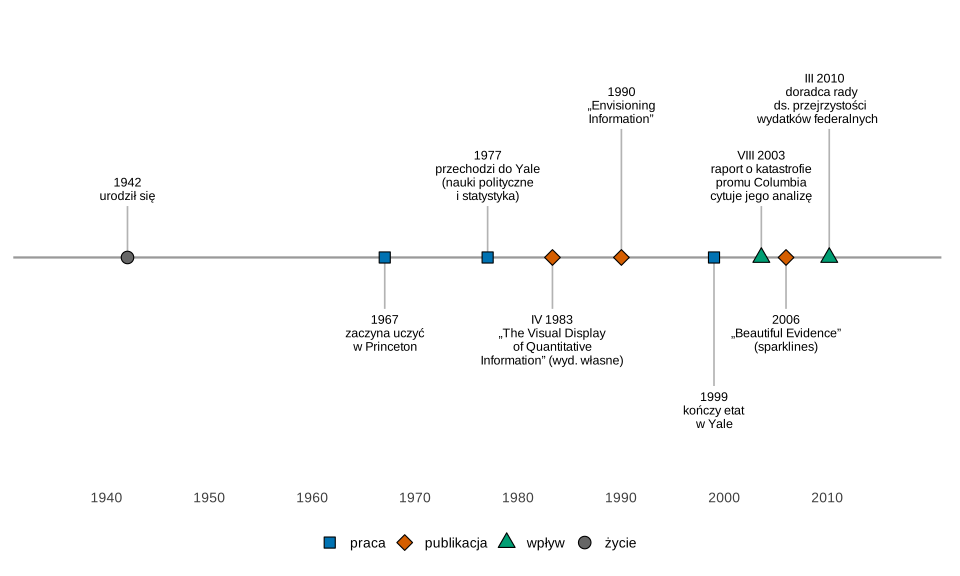
Co widać. Książki o grafice powstały, gdy Tufte był już profesorem z kilkunastoletnim stażem; późniejsze daty dotyczą wpływu jego prac na instytucje publiczne.
Na co uważać. Reportaż Yaffy (2011) datuje Beautiful Evidence na 2007 r., a opis katalogowy – na 2006 r.; podajemy rok z katalogu.
Podpis do pracy:
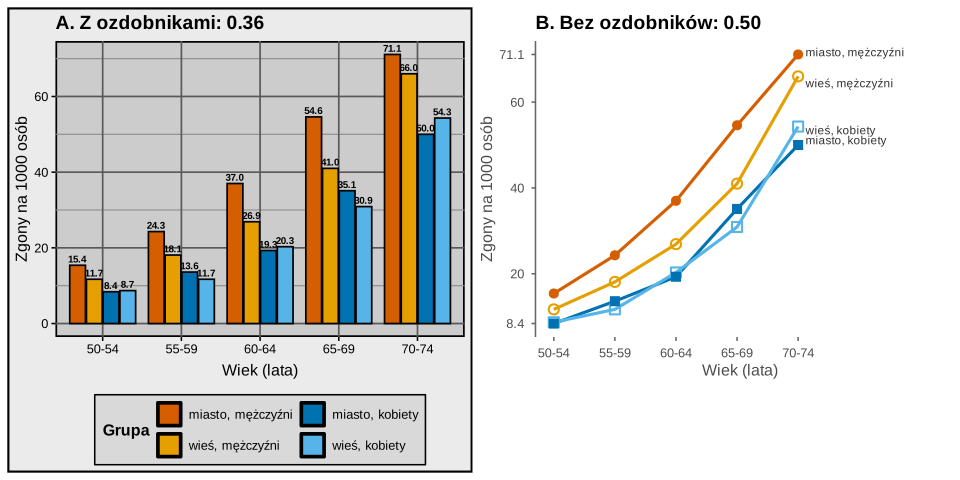
VADeaths): ten sam wykres z ozdobnikami (A) i bez nich (B); w tytułach proporcja tuszu danych. Obliczenia i rysunek: R, pakiety ggplot2, patchwork i png (bez losowania).Co widać. W wersji A oko błądzi między słupkami, legendą i liczbami; w wersji B od razu widać rosnące krzywe i kolejność grup.
Na co uważać. Nasza miara tuszu to przybliżenie: liczy zaczernienie pikseli przy jednej rozdzielczości, a etykiety osi i podpisy linii traktuje jak tusz nie-danych, choć są potrzebne. Dlatego proporcja w wersji B nie jest bliska 1, a pełne, kolorowe słupki podbijają proporcję w wersji A. Przejście od słupków do linii zmienia też formę wykresu, nie tylko usuwa ozdobniki. Rysunek 2 na stronie zostawiliśmy w motywie z kodu, bo ozdobniki są tu częścią przykładu.
Podpis do pracy:
Gdzie spotkasz Tufte’a w swojej pracy
Zasady Tufte’a przydają się przy każdym rysunku do pracy:
- przed oddaniem rysunku usuń tło, ramki i zbędną siatkę, a liczby nad słupkami zostaw tylko wtedy, gdy czytelnik ich potrzebuje – więcej we wpisie wykresy w pracy dyplomowej;
- wiele grup lub krajów pokaż jako małe wielokrotności na wspólnych osiach, a zmianę przed–po – jako wykres nachyleń;
- średnie wielu kategorii czytelniej pokaże wykres punktowy Clevelanda niż słupki; o percepcji wykresów pisał William S. Cleveland;
- prosty rysunek uzupełnij szczegółowym podpisem (Midway, 2020) – wzory znajdziesz we wpisie tabele i rysunki do artykułu.
Klasyków grafiki statystycznej, do których Tufte często wraca, przedstawiają hasła o Williamie Playfairze i Charlesie Josephie Minardzie.
Spory i trudne strony
- Czy ozdobniki zawsze szkodzą? Bateman i in. (2010) porównali wykresy z rozbudowaną grafiką z prostymi: ozdobne opisywano równie trafnie, a po dwóch–trzech tygodniach zapamiętywano je istotnie lepiej. Autorzy nie zalecają ozdabiania wszystkich wykresów, ale ich wyniki podważają część przesłanek minimalizmu.
- Kontekst ma znaczenie. Rougier i in. (2014) przypominają, że element, który w jednym wykresie jest ozdobnikiem, w innym bywa uzasadniony – np. szare tło, które zaznacza ważny zakres wartości.
- Proporcja to nie cel sam w sobie. Nasz przykład pokazuje, że wysoka proporcja tuszu danych nie gwarantuje czytelności: liczy się, czy wykres odpowiada na pytanie badawcze.
Tusz danych w R
Kod wczytuje zbiór VADeaths, buduje dwie wersje wykresu – z ozdobnikami i bez nich – i mierzy tusz: każdą wersję drukuje do tymczasowego pliku PNG raz w całości, a raz z tuszem nie-danych zamalowanym na biało, i sumuje zaczernienie pikseli. Na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1); na stronie oś czasu dostała motyw serwisu, a rysunek 2 jest identyczny z wynikiem kodu. Kod nie losuje.
1. Z ozdobnikami i bez: rysunek 2
Kod R rysunku 2
# Edward Tufte: ten sam wykres z „ozdobnikami” (chartjunk) i bez nich; proporcja tuszu danych (data-ink ratio) liczona z pikseli
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(png)})
data(VADeaths, package = "datasets")             # zgony na 1000 osób rocznie, Wirginia, 1940
VADeaths
dane <- data.frame(wiek = rep(rownames(VADeaths), times = 4),
                   grupa = rep(c("wieś, mężczyźni", "wieś, kobiety", "miasto, mężczyźni", "miasto, kobiety"), each = 5),
                   zgony = as.vector(VADeaths))
dane$grupa <- factor(dane$grupa, levels = c("miasto, mężczyźni", "wieś, mężczyźni", "miasto, kobiety", "wieś, kobiety"))
kol <- c("miasto, mężczyźni" = "#D55E00", "wieś, mężczyźni" = "#E69F00",
         "miasto, kobiety" = "#0072B2", "wieś, kobiety" = "#56B4E9")   # Okabe–Ito
ksz <- c("miasto, mężczyźni" = 16, "wieś, mężczyźni" = 1, "miasto, kobiety" = 15, "wieś, kobiety" = 0)

# Każdy wykres ma argument nd: kolor tuszu „nie-danych” (tło, siatka, osie, opisy). nd = "white" zostawia sam tusz danych
przed <- function(nd = TRUE) {
  k <- function(x) if (isTRUE(nd)) x else "white"
  ggplot(dane, aes(wiek, zgony, fill = grupa)) +
    geom_col(position = position_dodge(0.85), width = 0.8, colour = "black", linewidth = 0.6) +
    geom_text(aes(label = sprintf("%.1f", zgony)), position = position_dodge(0.85), vjust = -0.4, size = 2.6,
              fontface = "bold", alpha = if (isTRUE(nd)) 1 else 0) +
    scale_fill_manual(values = kol, name = "Grupa") +
    labs(title = "A. Z ozdobnikami", x = "Wiek (lata)", y = "Zgony na 1000 osób") +
    theme_grey(base_size = 12) +
    theme(panel.background = element_rect(fill = k("grey80"), colour = k("black"), linewidth = 1.2),
          panel.grid.major = element_line(colour = k("grey35"), linewidth = 0.6),
          panel.grid.minor = element_line(colour = k("grey55"), linewidth = 0.4),
          plot.background = element_rect(fill = k("grey92"), colour = k("black"), linewidth = 1.5),
          legend.background = element_rect(fill = k("grey85"), colour = k("black")),
          legend.key = element_rect(fill = k("grey85"), colour = k("black")),
          legend.text = element_text(colour = k("black")), legend.title = element_text(colour = k("black"), face = "bold"),
          axis.text = element_text(colour = k("black")), axis.title = element_text(colour = k("black")),
          axis.ticks = element_line(colour = k("black")),
          plot.title = element_text(colour = k("black"), face = "bold"), legend.position = "bottom") +
    guides(fill = guide_legend(nrow = 2, override.aes = list(colour = k("black"), fill = if (isTRUE(nd)) kol else "white")))
}
po <- function(nd = TRUE) {
  k <- function(x) if (isTRUE(nd)) x else "white"
  koniec <- subset(dane, wiek == "70-74")
  ggplot(dane, aes(wiek, zgony, group = grupa, colour = grupa, shape = grupa)) +
    geom_line(linewidth = 1.1) +
    geom_point(size = 2.8, stroke = 1.1, fill = "white") +
    geom_text(data = koniec, aes(label = grupa), hjust = 0, nudge_x = 0.12, size = 3.1, colour = "grey20",
              alpha = if (isTRUE(nd)) 1 else 0,
              vjust = c(0.2, 1.3, -0.1, 0.9)[match(koniec$grupa, levels(dane$grupa))]) +
    scale_colour_manual(values = kol, guide = "none") +
    scale_shape_manual(values = ksz, guide = "none") +
    scale_x_discrete(expand = expansion(add = c(0.3, 2.4))) +
    scale_y_continuous(breaks = c(8.4, 20, 40, 60, 71.1), labels = c("8.4", "20", "40", "60", "71.1")) +
    labs(title = "B. Bez ozdobników", x = "Wiek (lata)", y = "Zgony na 1000 osób") +
    theme_minimal(base_size = 12) +
    theme(panel.grid = element_blank(), axis.line.y = element_line(colour = k("grey40")),
          axis.ticks = element_line(colour = k("grey40")),
          axis.text = element_text(colour = k("grey30")), axis.title = element_text(colour = k("grey30")),
          plot.title = element_text(colour = k("black"), face = "bold"),
          plot.background = element_rect(fill = "white", colour = NA))
}

# Tusz = suma „zaczernienia” pikseli (1 − jasność); wykres rysowany dwa razy w tym samym układzie:
# z całym tuszem i z tuszem nie-danych zamalowanym na biało
tusz <- function(wykres, szer = 6, wys = 4.5) {
  plik <- tempfile(fileext = ".png")
  png(plik, width = szer, height = wys, units = "in", res = 100, bg = "white")
  print(wykres); dev.off()
  obraz <- png::readPNG(plik)[, , 1:3]
  jasnosc <- 0.299 * obraz[, , 1] + 0.587 * obraz[, , 2] + 0.114 * obraz[, , 3]
  sum(1 - jasnosc)
}
wynik <- data.frame(wykres = c("A. z ozdobnikami", "B. bez ozdobników"),
                    tusz_caly = c(tusz(przed()), tusz(po())),
                    tusz_danych = c(tusz(przed(nd = FALSE)), tusz(po(nd = FALSE))))
wynik$tusz_nie_danych <- wynik$tusz_caly - wynik$tusz_danych
wynik$proporcja_tuszu_danych <- round(wynik$tusz_danych / wynik$tusz_caly, 2)
wynik[, 2:4] <- round(wynik[, 2:4])
wynik
round(c(tusz_caly_A_do_B = wynik$tusz_caly[1] / wynik$tusz_caly[2],
        tusz_nie_danych_A_do_B = wynik$tusz_nie_danych[1] / wynik$tusz_nie_danych[2]), 1)   # ile razy więcej tuszu zużywa wersja A

# Rysunek 2: obie wersje obok siebie (w tytułach – proporcja tuszu danych)
pA <- przed() + labs(title = sprintf("A. Z ozdobnikami: %.2f", wynik$proporcja_tuszu_danych[1]))
pB <- po() + labs(title = sprintf("B. Bez ozdobników: %.2f", wynik$proporcja_tuszu_danych[2]))
p2 <- pA + pB + plot_layout(widths = c(1, 1))
p2
Wynik w R
      Rural Male Rural Female Urban Male Urban Female
50-54       11.7          8.7       15.4          8.4
55-59       18.1         11.7       24.3         13.6
60-64       26.9         20.3       37.0         19.3
65-69       41.0         30.9       54.6         35.1
70-74       66.0         54.3       71.1         50.0
             wykres tusz_caly tusz_danych tusz_nie_danych
1  A. z ozdobnikami     84599       30581           54018
2 B. bez ozdobników      6894        3440            3454
  proporcja_tuszu_danych
1                   0.36
2                   0.50
      tusz_caly_A_do_B tusz_nie_danych_A_do_B
                  12.3                   15.6
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Edward Tufte (ur. 1942) – daty według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1942, 1967, 1977, 1983.3, 1990, 1999, 2003.6, 2006, 2010.2),
  etykieta = c("1942", "1967", "1977", "IV 1983", "1990", "1999", "VIII 2003", "2006", "III 2010"),
  opis = c("urodził się", "zaczyna uczyć\nw Princeton", "przechodzi do Yale\n(nauki polityczne\ni statystyka)",
           "„The Visual Display\nof Quantitative\nInformation” (wyd. własne)", "„Envisioning\nInformation”",
           "kończy etat\nw Yale", "raport o katastrofie\npromu Columbia\ncytuje jego analizę",
           "„Beautiful Evidence”\n(sparklines)", "doradca rady\nds. przejrzystości\nwydatków federalnych"),
  rodzaj = c("życie", "praca", "praca", "publikacja", "publikacja", "praca", "wpływ", "publikacja", "wpływ"))
zdarzenia$strona     <- c(1, -1, 1, -1, 1, -1, 1, -1, 1)
zdarzenia$poziom     <- c(0.6, 0.6, 0.6, 0.6, 1.5, 1.5, 0.6, 0.6, 1.5)
zdarzenia$wyrownanie <- c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.6)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wpływ" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wpływ" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = (poziom + 0.07) * strona, label = paste0(etykieta, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie),
            size = 3.3, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1935, 2017), breaks = seq(1940, 2010, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.6)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (zapis PNG – png() z pakietu grDevices, odczyt pikseli – readPNG() z pakietu png; rysunki – pakiety ggplot2 i patchwork). Wynik pomiaru tuszu może się nieznacznie różnić przy innym systemie lub zestawie czcionek. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- png (wersja 0.1.9): Urbanek, S. (2026). png: Read and write PNG images [R package]. https://doi.org/10.32614/CRAN.package.png
Najczęstsze pytania
Kim jest Edward Tufte?
Amerykańskim politologiem i statystykiem (ur. 1942), który uczył w Princeton od 1967 r., a w latach 1977–1999 w Yale. Napisał i sam wydał książki o grafice statystycznej, z których pierwsza, „The Visual Display of Quantitative Information”, ukazała się w 1983 r. (Yaffa, 2011).
Co to jest chartjunk?
Termin Tufte’a (1983) na elementy wykresu, które nie dodają informacji albo wprowadzają zamęt: nadmiar kolorów i etykiet, kolorowe tło, zbędne linie siatki. Według Tufte’a to tusz nie-danych albo nadmiarowy tusz danych (Rougier i in., 2014).
Co to jest proporcja tuszu danych (data-ink ratio)?
Stosunek tuszu, który pokazuje dane, do całego tuszu użytego w rysunku. Tufte radził, by był jak najwyższy, czyli by usuwać tusz, który niczego nie mówi o danych (Midway, 2020). W naszym przykładzie wzrósł z 0.36 do 0.50.
Czy wykres z ozdobnikami jest zawsze gorszy?
Nie zawsze. W eksperymencie Batemana i in. (2010) wykresy z rozbudowaną grafiką odczytywano równie trafnie jak proste, a po dwóch–trzech tygodniach zapamiętywano je lepiej. W pracy naukowej, gdzie liczy się precyzja odczytu, nadal wybierz prosty wykres.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikTabele i rysunki do artykułu
Wymogi czasopism, wykresy z danymi zamiast słupków, kolory czytelne dla daltonistów, eksport z R w 300 dpi i materiały uzupełniające.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bateman, S., Mandryk, R. L., Gutwin, C., Genest, A., McDine, D., & Brooks, C. (2010). Useful junk? The effects of visual embellishment on comprehension and memorability of charts. In Proceedings of the SIGCHI Conference on Human Factors in Computing Systems (CHI ’10) (pp. 2573–2582). ACM. https://doi.org/10.1145/1753326.1753716
- Midway, S. R. (2020). Principles of effective data visualization. Patterns, 1(9), Article 100141. https://doi.org/10.1016/j.patter.2020.100141 ● Otwarty dostęp
- Rougier, N. P., Droettboom, M., & Bourne, P. E. (2014). Ten simple rules for better figures. PLoS Computational Biology, 10(9), Article e1003833. https://doi.org/10.1371/journal.pcbi.1003833 ● Otwarty dostęp
- Tufte, E. R. (1983). The visual display of quantitative information. Graphics Press.
- Tufte, E. R. (2006). Beautiful evidence. Graphics Press.
- Yaffa, J. (2011). The information sage. Washington Monthly. https://washingtonmonthly.com/magazine/mayjune-2011/the-information-sage ● Otwarty dostęp
Cytowania BibTeX
@inproceedings{bateman2010useful, author={Bateman, Scott and Mandryk, Regan L. and Gutwin, Carl and Genest, Aaron and McDine, David and Brooks, Christopher}, title={{Useful junk? The effects of visual embellishment on comprehension and memorability of charts}}, booktitle={Proceedings of the SIGCHI Conference on Human Factors in Computing Systems (CHI ’10)}, year={2010}, pages={2573--2582}, publisher={ACM}, doi={10.1145/1753326.1753716}}@article{midway2020principles, author={Midway, Stephen R.}, title={{Principles of effective data visualization}}, journal={Patterns}, year={2020}, volume={1}, number={9}, eid={100141}, doi={10.1016/j.patter.2020.100141}}@article{rougier2014ten, author={Rougier, Nicolas P. and Droettboom, Michael and Bourne, Philip E.}, title={{Ten simple rules for better figures}}, journal={PLoS Computational Biology}, year={2014}, volume={10}, number={9}, eid={e1003833}, doi={10.1371/journal.pcbi.1003833}}@book{tufte1983visual, author={Tufte, Edward R.}, title={{The visual display of quantitative information}}, year={1983}, publisher={Graphics Press}}@book{tufte2006beautiful, author={Tufte, Edward R.}, title={{Beautiful evidence}}, year={2006}, publisher={Graphics Press}}@misc{yaffa2011information, author={Yaffa, Joshua}, title={{The information sage}}, howpublished={Washington Monthly}, year={2011}, publisher={Washington Monthly}, url={https://washingtonmonthly.com/magazine/mayjune-2011/the-information-sage}}