Kim był Frank Hampel?
Frank Rudolf Hampel (1941–2018) był statystykiem, profesorem Politechniki Federalnej w Zurychu (ETH), twórcą dwóch pojęć, którymi do dziś opisuje się odporność metod statystycznych: funkcji wpływu i punktu załamania. Dorastał w Niemczech w czasie II wojny światowej. Rodzina zamieszkała w domu dziadka na Górnym Śląsku; gdy po wojnie region ten znalazł się w granicach Polski, musiała wyjechać i osiadła w okolicach Getyngi (Künsch, 2019).
Studiował fizykę, matematykę i filozofię w Monachium i Getyndze, a w 1968 r. obronił doktorat na Uniwersytecie Kalifornijskim w Berkeley. Po doktoracie przyjechał do Zurychu razem z matematykiem Volkerem Strassenem: na Uniwersytecie Zuryskim prowadził doradztwo statystyczne, a z Peterem Huberem z ETH łączyły go wspólne seminaria (Buja i Künsch, 2008; Künsch, 2019).
W latach 1970–71 był, obok Petera Bickela i Hubera, gościem Johna Tukeya w Princeton w czasie „roku odporności”, który ukształtował dalszy rozwój dziedziny. W 1974 r. został profesorem nadzwyczajnym ETH, wkrótce zwyczajnym, i pracował tam do emerytury w 2006 r. W 2007 r. otrzymał doktorat honorowy Uniwersytetu w Dortmundzie. Zmarł 2 października 2018 r. w Thalwilu koło Zurychu (Künsch, 2019).
Najważniejsze pomysły
- Funkcja wpływu (1974). Mówi, o ile w przybliżeniu zmieni się oszacowanie, gdy do danych dodamy, usuniemy lub zmienimy jedną obserwację. Formalnie to pierwsza pochodna estymatora traktowanego jako funkcjonał rozkładu. W pracy z 1974 r. Hampel opisał nią m.in. średnie ucinane i winsoryzowane oraz estymatory Hubera i powiązał ją z metodą jackknife (Hampel, 1974).
- Punkt załamania (1971). Największy odsetek dowolnie złych obserwacji, jaki estymator znosi, zanim jego wynik może uciec do nieskończoności – miara globalna, w odróżnieniu od lokalnej funkcji wpływu (Hampel, 1971; Künsch, 2019).
- Optymalność. Wariancja asymptotyczna estymatora to wartość oczekiwana kwadratu jego funkcji wpływu. To pozwoliło Hampelowi postawić i rozwiązać centralne zadanie statystyki odpornej: najmniejsza wariancja przy ograniczonym wpływie pojedynczej obserwacji (Künsch, 2019).
- Książka z 1986 r. „Robust Statistics: The Approach Based on Influence Functions”, napisana z Elvezio Ronchettim, Peterem Rousseeuwem i Wernerem Stahelem, przez ponad dwie dekady była podstawowym wykładem dziedziny (Hampel i in., 1986; Künsch, 2019).
Ciekawostka
Do statystyki odpornej Hampela skierował jego profesor w Getyndze, Konrad Jacobs, który pokazał mu pracę Hubera z 1964 r. (Huber, 1964) i namówił do wyjazdu do Berkeley na roczne stypendium wymiany. Hampel został tam na doktorat. Formalnie promotorem był Erich Lehmann, ale ten we wspomnieniach przyznał, że w praktyce nie miał w pracę żadnego wkładu: jego rolą było szybko docenić jej dojrzałość, zachęcać i nie przeszkadzać (Künsch, 2019).
Poza statystyką Hampel był zapalonym przyrodnikiem: obserwował gwiazdy, ptaki, storczyki i ważki, a żadna droga nie była dla niego za daleka, jeśli na jej końcu mógł zobaczyć gatunek, którego jeszcze nie widział (Künsch, 2019).
Przykład: ile złych wyników zniesie estymator
Zbiór abbey z pakietu MASS to – według pliku pomocy – 31 oznaczeń zawartości niklu (ppm) w kanadyjskiej skale sjenitowej. Większość wyników leży między 5.2 a 18, ale są też 24, 28, 34 i 125. Średnia wynosi 16.01, średnia ucinana 10% – 11.62, ucinana 25% – 10.95, mediana 11.00, a estymator Hubera (k = 1.345, skala MAD) – 11.44.
Punkt załamania w tej próbie. Zastępujemy k największych wyników wartością absurdalną. Średnia „pęka” już przy jednym zepsutym wyniku (1 z 31, czyli 3.2% próby): gdy 125 zamienimy na 1000, rośnie z 16.01 do 44.23. Średnia ucinana 10% wytrzymuje 3 zepsute wyniki i pęka przy 4 (12.9%), ucinana 25% – przy 8 (25.8%), a mediana i estymator Hubera ze skalą MAD dopiero przy 16, czyli ponad połowie próby.
Funkcja wpływu przy rozkładzie normalnym. Liczymy jej największą wartość bezwzględną (czułość na grube błędy, γ*) i wariancję asymptotyczną E[IF²]. Dla średniej γ* jest nieskończone, a wariancja wynosi 1. Dla mediany: γ* = 1.253 i wariancja 1.571 (sprawność .637), dla średniej ucinanej 25%: 1.349 i 1.195 (.837), dla ucinanej 10%: 1.602 i 1.060 (.943), dla estymatora Hubera: 1.637 i 1.053 (.950). Symulacja (set.seed(1974), 5000 prób po 200 obserwacji) potwierdza te wariancje: n·Var wyniosło 1.021, 1.520, 1.199, 1.072 i 1.066. Ograniczony wpływ kosztuje więc trochę efektywności, ale nie musi kosztować wiele.
Na rysunku
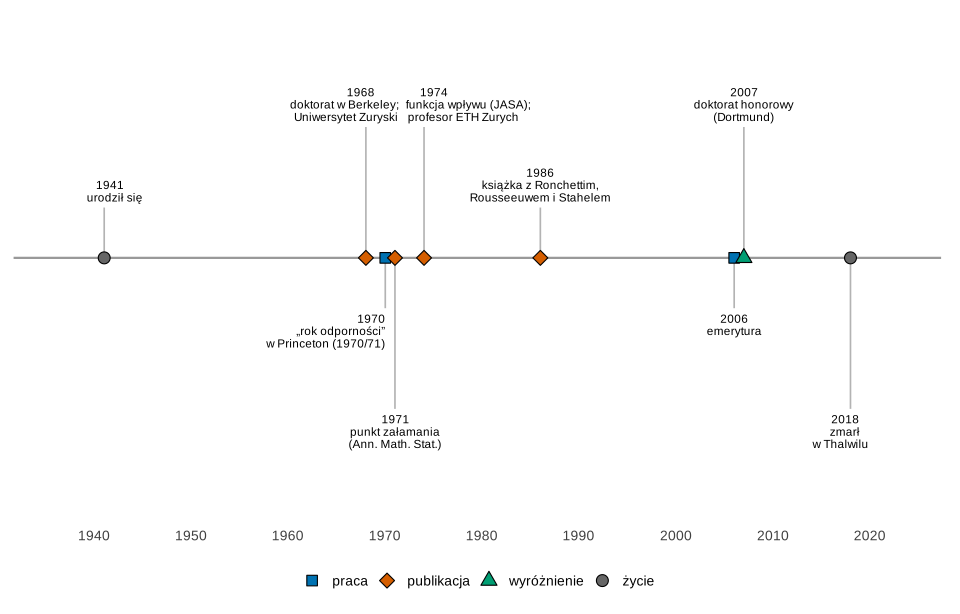
Co widać. Najważniejsze prace powstały w ciągu kilku lat po doktoracie, a cała kariera naukowa – w Zurychu.
Na co uważać. Cytowane źródła nie podają roku wyjazdu do Berkeley ani roku awansu na profesora zwyczajnego, więc tych zdarzeń na osi nie ma.
Podpis do pracy:
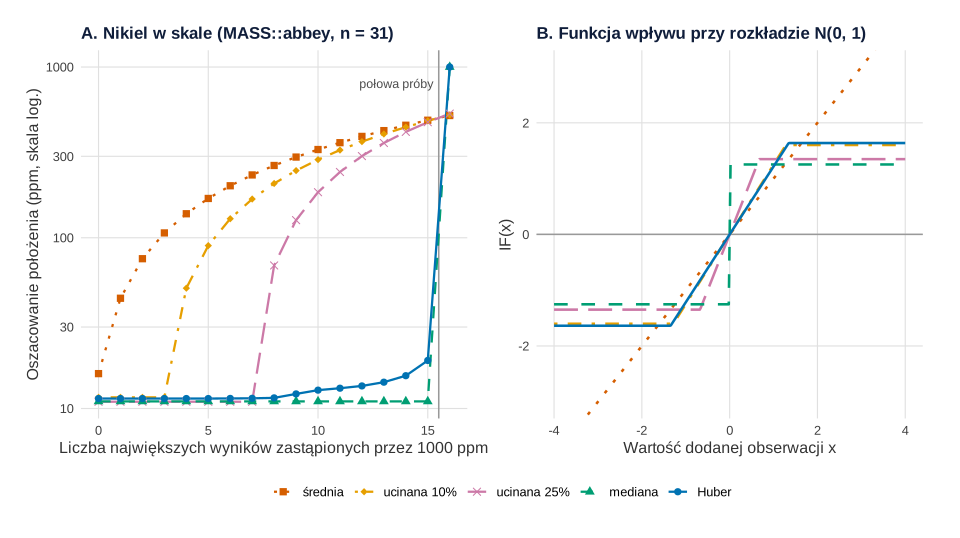
MASS::abbey (A) i ich funkcje wpływu przy rozkładzie normalnym (B). Obliczenia i rysunek: R, pakiety MASS, ggplot2 i patchwork.Co widać. W panelu A każda linia wybucha w swoim punkcie załamania: średnia od razu, średnie ucinane po przekroczeniu odsetka ucinanych wyników, mediana i estymator Hubera dopiero po połowie próby. W panelu B linia średniej rośnie bez końca, a pozostałe funkcje wpływu są ograniczone.
Na co uważać. Punkt załamania mówi, kiedy estymator przestaje działać, a nie, jak bardzo się myli wcześniej: przy 15 zepsutych wynikach estymator Hubera wynosi 19.11 zamiast 11.44. Funkcja wpływu w panelu B dotyczy pojedynczej obserwacji i rozkładu normalnego.
Podpis do pracy:
Gdzie spotkasz Hampela w swojej pracy
- Wybór miary położenia. Gdy uzasadniasz medianę, średnią ucinaną albo test Yuena zamiast średniej i testu t, korzystasz z języka Hampela: ograniczony wpływ i wysoki punkt załamania.
- Regresja odporna. Estymator MM łączy punkt załamania 0.5 z wysoką sprawnością – zob. estymator M.
- Diagnostyka regresji. DFBETAS i odległość Cooka pytają o to samo co funkcja wpływu: jak zmieni się wynik po usunięciu jednej obserwacji.
- Raportowanie obserwacji odstających. Zamiast pisać, że wyniki usunięto, podaj wynik estymatora o wysokim punkcie załamania obok klasycznego.
Spory, mity i trudne strony
- Ograniczony wpływ to nie to samo co odporność globalna. Średnia ucinana 10% ma ograniczoną funkcję wpływu, a mimo to w naszej próbie pęka już przy 13% zepsutych wyników. Dlatego Hampel używał obu pojęć naraz.
- Nie tylko odstające wyniki. Hampel zajmował się też odchyleniami od założenia niezależności obserwacji i uważał zależność długiego zasięgu za najważniejszy rodzaj niezauważonej zależności (Künsch, 2019); estymatory odporne nie chronią przed tym problemem.
- Podstawy statystyki. W ostatnich latach zajmował się filozoficznymi podstawami statystyki i opisem niepewności przez górne i dolne prawdopodobieństwa; jak ocenia Künsch (2019), dopiero się okaże, czy te idee zostaną uznane.
Punkt załamania i funkcja wpływu w R
Kod liczy pięć estymatorów położenia dla danych MASS::abbey, wyznacza punkt załamania w tej próbie przez zastępowanie największych wyników wartościami absurdalnymi, oblicza funkcje wpływu, czułość na grube błędy i wariancje asymptotyczne przy rozkładzie normalnym, sprawdza te wariancje symulacją i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Ziarno: set.seed(1974); wartości zastępcze (1000 i 106 ppm) i próg „pęknięcia” (1000 ppm) ustaliliśmy ręcznie.
1. Punkt załamania i funkcja wpływu: rysunek 2
Kod R rysunku 2
# Punkt załamania i funkcja wpływu Hampela: średnia, średnie ucinane, mediana i estymator Hubera
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(MASS)})
kol <- c("średnia" = "#D55E00", "ucinana 10%" = "#E69F00", "ucinana 25%" = "#CC79A7", "mediana" = "#009E73", "Huber" = "#0072B2")   # Okabe–Ito
lin <- c("średnia" = "dotted", "ucinana 10%" = "dotdash", "ucinana 25%" = "longdash", "mediana" = "dashed", "Huber" = "solid")
ksz <- c("średnia" = 15, "ucinana 10%" = 18, "ucinana 25%" = 4, "mediana" = 17, "Huber" = 16)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

huber_mu <- function(x, k = 1.345) {          # estymator Hubera położenia, skala MAD (IRLS)
  s <- mad(x); mu <- median(x)
  if (s == 0) return(mu)                    # ponad połowa wyników równa: MAD = 0
  for (i in 1:200) { w <- pmin(1, k / abs((x - mu) / s)); mu_n <- sum(w * x) / sum(w); if (abs(mu_n - mu) < 1e-10) break; mu <- mu_n }
  mu_n
}
estymatory <- function(x) c("średnia" = mean(x), "ucinana 10%" = mean(x, trim = 0.10), "ucinana 25%" = mean(x, trim = 0.25),
                            "mediana" = median(x), "Huber" = huber_mu(x))

# 1. Dane: 31 oznaczeń niklu w kanadyjskiej skale sjenitowej (ppm), MASS::abbey
data(abbey, package = "MASS")
x <- abbey
n <- length(x); n
sort(x)
round(estymatory(x), 2)

# 2. Punkt załamania w skończonej próbie: k największych wyników zastępujemy wartością „zepsutą” z
zepsuj <- function(x, k, z) { y <- sort(x); if (k > 0) y[(n - k + 1):n] <- z; y }
kk <- 0:16
sciezki <- t(sapply(kk, function(k) estymatory(zepsuj(x, k, 1000))))
# estymator „pęka”, gdy podąża za zepsutą wartością: przy z = 10^6 przekracza 1000 ppm
peka <- t(sapply(kk, function(k) estymatory(zepsuj(x, k, 1e6)) > 1000))
k_zal <- apply(peka, 2, function(p) min(kk[p]))
rbind(k_zalamania = k_zal, procent_proby = round(100 * k_zal / n, 1))
round(cbind(k = kk, sciezki)[c(1, 2, 4, 5, 8, 9, 16, 17), ], 2)

# 3. Funkcja wpływu IF(x) przy rozkładzie N(0, 1) (Hampel, 1974); skala znana
IF <- list(
  "średnia"     = function(z) z,
  "ucinana 10%" = function(z) { q <- qnorm(0.90); pmin(pmax(z, -q), q) / (1 - 2 * 0.10) },
  "ucinana 25%" = function(z) { q <- qnorm(0.75); pmin(pmax(z, -q), q) / (1 - 2 * 0.25) },
  "mediana"     = function(z) sign(z) / (2 * dnorm(0)),
  "Huber"       = function(z) { k <- 1.345; pmin(pmax(z, -k), k) / (2 * pnorm(k) - 1) })
# czułość na grube błędy γ* = sup |IF| oraz wariancja asymptotyczna = E[IF(X)²]
gamma_gw <- sapply(IF, function(f) max(abs(f(c(-Inf, Inf)))))
war_as <- sapply(IF, function(f) integrate(function(z) f(z)^2 * dnorm(z), -Inf, Inf)$value)
round(rbind(gamma_gwiazdka = gamma_gw, wariancja_asympt = war_as, sprawnosc = 1 / war_as), 3)

# 4. Kontrola symulacją: n·Var estymatora dla prób po 200 obserwacji z N(0, 1)
set.seed(1974)
sym <- replicate(5000, estymatory(rnorm(200)))
round(200 * apply(sym, 1, var), 3)

# Rysunek: A – estymatory przy zastępowaniu k największych wyników wartością 1000 ppm; B – funkcje wpływu
dA <- data.frame(k = rep(kk, times = 5), estymator = rep(names(kol), each = length(kk)), wartosc = as.vector(sciezki))
dA$estymator <- factor(dA$estymator, levels = names(kol))
pA <- ggplot(dA, aes(k, wartosc, colour = estymator, linetype = estymator, shape = estymator)) +
  geom_vline(xintercept = 15.5, colour = "grey60") +
  annotate("text", x = 15.3, y = 800, label = "połowa próby", hjust = 1, size = 3.3, colour = "grey30") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.2) +
  scale_y_log10(breaks = c(10, 30, 100, 300, 1000)) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = lin, name = NULL) +
  scale_shape_manual(values = ksz, name = NULL) +
  labs(title = "A. Nikiel w skale (MASS::abbey, n = 31)", x = "Liczba największych wyników zastąpionych przez 1000 ppm",
       y = "Oszacowanie położenia (ppm, skala log.)") +
  motyw
z <- seq(-4, 4, by = 0.02)
dB <- do.call(rbind, lapply(names(IF), function(e) data.frame(z = z, IF = IF[[e]](z), estymator = e)))
dB$estymator <- factor(dB$estymator, levels = names(kol))
pB <- ggplot(dB, aes(z, IF, colour = estymator, linetype = estymator)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_line(linewidth = 0.9) +
  coord_cartesian(ylim = c(-3, 3)) +
  scale_colour_manual(values = kol, guide = "none") + scale_linetype_manual(values = lin, guide = "none") +   # legenda wspólna z panelem A
  labs(title = "B. Funkcja wpływu przy rozkładzie N(0, 1)", x = "Wartość dodanej obserwacji x", y = "IF(x)") +
  motyw
p2 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2
Wynik w R
[1] 31
 [1]   5.2   6.5   6.9   7.0   7.0   7.0   7.4   8.0   8.0   8.0   8.0   8.5
[13]   9.0   9.0  10.0  11.0  11.0  12.0  12.0  13.7  14.0  14.0  14.0  16.0
[25]  17.0  17.0  18.0  24.0  28.0  34.0 125.0
    średnia ucinana 10% ucinana 25%     mediana       Huber
      16.01       11.62       10.95       11.00       11.44
              średnia ucinana 10% ucinana 25% mediana Huber
k_zalamania       1.0         4.0         8.0    16.0  16.0
procent_proby     3.2        12.9        25.8    51.6  51.6
      k średnia ucinana 10% ucinana 25% mediana   Huber
[1,]  0   16.01       11.62       10.95      11   11.44
[2,]  1   44.23       11.62       10.95      11   11.44
[3,]  3  106.75       11.62       10.95      11   11.44
[4,]  4  138.23       50.66       10.95      11   11.44
[5,]  7  233.33      168.58       10.95      11   11.47
[6,]  8  265.07      207.94       68.84      11   11.54
[7,] 15  487.95      484.32      475.26      11   19.11
[8,] 16  519.85      523.88      533.44    1000 1000.00
                 średnia ucinana 10% ucinana 25% mediana Huber
gamma_gwiazdka       Inf       1.602       1.349   1.253 1.637
wariancja_asympt       1       1.060       1.195   1.571 1.053
sprawnosc              1       0.943       0.837   0.637 0.950
    średnia ucinana 10% ucinana 25%     mediana       Huber
      1.021       1.072       1.199       1.520       1.066
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Frank R. Hampel (1941–2018) – lata według Künscha (2019), Buji i Künscha (2008) oraz dat publikacji
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1941, 1968, 1970, 1971, 1974, 1986, 2006, 2007, 2018),
  opis = c("urodził się", "doktorat w Berkeley;\nUniwersytet Zuryski", "„rok odporności”\nw Princeton (1970/71)", "punkt załamania\n(Ann. Math. Stat.)",
           "funkcja wpływu (JASA);\nprofesor ETH Zurych", "książka z Ronchettim,\nRousseeuwem i Stahelem", "emerytura", "doktorat honorowy\n(Dortmund)", "zmarł\nw Thalwilu"),
  rodzaj = c("życie", "publikacja", "praca", "publikacja", "publikacja", "publikacja", "praca", "wyróżnienie", "życie"),
  poziom = c(0.5, 1.3, -0.5, -1.5, 1.3, 0.5, -0.5, 1.3, -1.5),   # wysokość etykiety
  wyrownanie = c(0.3, 0.7, 1, 0.5, 0.15, 0.5, 0.5, 0.5, 0.7))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1936, 2023), breaks = seq(1940, 2020, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (średnie ucinane – mean(trim = ), mediana i MAD – median(), mad(), całkowanie – integrate() z pakietów base i stats; dane z pakietu MASS; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Frank Hampel?
Statystykiem (1941–2018), który dorastał w Niemczech, studiował w Monachium i Getyndze, doktoryzował się w Berkeley w 1968 r., a od 1974 r. do emerytury w 2006 r. był profesorem ETH Zurych. Wprowadził funkcję wpływu i punkt załamania (Künsch, 2019).
Co to jest punkt załamania estymatora?
Największy odsetek dowolnie złych obserwacji, jaki estymator znosi, zanim jego wynik może uciec do nieskończoności (Hampel, 1971). Średnia ma punkt załamania 0, średnia ucinana 25% – 25%, a mediana – 50%. W 31 oznaczeniach niklu średnia pęka przy jednym złym wyniku, mediana dopiero przy 16.
Co mówi funkcja wpływu Hampela?
O ile w przybliżeniu zmieni się oszacowanie po dodaniu, usunięciu lub zmianie jednej obserwacji o wartości x (Hampel, 1974). Jeśli jest nieograniczona, jak dla średniej, jedna skrajna obserwacja może dowolnie przesunąć wynik. Jej największa wartość bezwzględna to czułość na grube błędy.
Kto był promotorem Franka Hampela?
Formalnie Erich Lehmann w Berkeley, ale Lehmann wspominał, że w praktyce nie miał wkładu w tę pracę. Do statystyki odpornej Hampela skierował wcześniej jego profesor w Getyndze, Konrad Jacobs, pokazując mu pracę Hubera z 1964 r. (Künsch, 2019).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Buja, A., & Künsch, H. R. (2008). A conversation with Peter Huber. Statistical Science, 23(1), 120–135. https://doi.org/10.1214/07-sts251 ● Otwarty dostęp
- Hampel, F. R. (1971). A general qualitative definition of robustness. The Annals of Mathematical Statistics, 42(6), 1887–1896. https://doi.org/10.1214/aoms/1177693054 ● Otwarty dostęp
- Hampel, F. R. (1974). The influence curve and its role in robust estimation. Journal of the American Statistical Association, 69(346), 383–393. https://doi.org/10.1080/01621459.1974.10482962
- Hampel, F. R., Ronchetti, E. M., Rousseeuw, P. J., & Stahel, W. A. (1986). Robust statistics: The approach based on influence functions. Wiley.
- Huber, P. J. (1964). Robust estimation of a location parameter. The Annals of Mathematical Statistics, 35(1), 73–101. https://doi.org/10.1214/aoms/1177703732 ● Otwarty dostęp
- Künsch, H. R. (2019). Obituary: Frank Hampel, 1941–2018. IMS Bulletin, 48(1), 6. https://imstat.org/2018/12/14/obituary-frank-hampel-1941-2018/ ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{buja2008conversation, author={Buja, Andreas and Künsch, Hans R.}, title={{A conversation with Peter Huber}}, journal={Statistical Science}, year={2008}, volume={23}, number={1}, pages={120--135}, doi={10.1214/07-sts251}}@article{hampel1971general, author={Hampel, Frank R.}, title={{A general qualitative definition of robustness}}, journal={The Annals of Mathematical Statistics}, year={1971}, volume={42}, number={6}, pages={1887--1896}, doi={10.1214/aoms/1177693054}}@article{hampel1974influence, author={Hampel, Frank R.}, title={{The influence curve and its role in robust estimation}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={346}, pages={383--393}, doi={10.1080/01621459.1974.10482962}}@book{hampel1986robust, author={Hampel, Frank R. and Ronchetti, Elvezio M. and Rousseeuw, Peter J. and Stahel, Werner A.}, title={{Robust statistics: The approach based on influence functions}}, year={1986}, publisher={Wiley}}@article{huber1964robust, author={Huber, Peter J.}, title={{Robust estimation of a location parameter}}, journal={The Annals of Mathematical Statistics}, year={1964}, volume={35}, number={1}, pages={73--101}, doi={10.1214/aoms/1177703732}}@article{kunsch2019obituary, author={Künsch, Hans R.}, title={{Obituary: Frank Hampel, 1941–2018}}, journal={IMS Bulletin}, year={2019}, volume={48}, number={1}, pages={6}, publisher={Institute of Mathematical Statistics}, url={https://imstat.org/2018/12/14/obituary-frank-hampel-1941-2018/}}