Czym jest TUG i co z niego analizujesz
Timed Up and Go (TUG) to test sprawności, a nie kwestionariusz. Mierzysz czas, w jakim osoba wstaje z krzesła z podłokietnikami, przechodzi 3 metry, zawraca, wraca i siada. Podsiadlo i Richardson (1991) opisali go u 60 pacjentów dziennego szpitala geriatrycznego. Czas był rzetelny przy ocenie przez tę samą osobę i przez różne osoby. Korelował też ze Skalą Berga, prędkością chodu i Indeksem Barthel. Wynik to liczba sekund: krótszy czas oznacza lepszą mobilność.
TUG często pojawia się w pracach z fizjoterapii i geriatrii, a także z pielęgniarstwa i zdrowia publicznego, gdy badanie dotyczy osób starszych. Warsztat tych kierunków opisują wpisy statystyka dla fizjoterapeuty i statystyka w pracy z pielęgniarstwa. W badaniach upadków TUG zwykle stoi obok Skali Równowagi Berga, skali Tinetti, kwestionariusza lęku przed upadkiem FES-I i testu 6-minutowego marszu.
Ten wpis uzupełnia nasz wcześniejszy poradnik Timed Up and Go – analiza wyników. Tamten opisuje protokół, rzetelność dwóch prób (ICC, SEM, MDC), zmianę przed i po oraz wartości referencyjne dla wieku. Tutaj zajmujemy się badaniem, w którym TUG ma różnicować grupy albo przewidywać upadki. Omawiamy cztery problemy: skośny czas w porównaniu grup, osoby, które nie ukończyły próby, wersję z zadaniem poznawczym i liczbę upadków jako wynik.
Badanie przykładowe: 180 osób i rok obserwacji
Dane są symulowane i możesz je pobrać jako plik CSV. Scenariusz to badanie prospektywne: 180 osób w wieku 65–90 lat mieszkających samodzielnie. Na początku każda wykonała TUG oraz TUG z zadaniem poznawczym (TUG-cog, np. odliczanie w trakcie chodu). Potem przez 12 miesięcy osoby notowały upadki w kalendarzu. Plik zawiera wiek, płeć, oba czasy w sekundach, znacznik przerwanej próby TUG-cog i liczbę upadków.
Definicję upadku i sposób jego rejestrowania ustal przed badaniem i opisz w metodzie. Sieć ProFaNE opracowała wspólny zestaw definicji i miar wyników dla badań nad upadkami, właśnie po to, by wyniki różnych badań dało się porównać (Lamb i in., 2005).
Krok 1. Czas jako zmienna skośna
Czas nie może być ujemny, a kilka osób potrzebuje go dużo więcej niż reszta. W przykładzie TUG miał M = 9.30 s (SD = 2.70), medianę 9.1 s i IQR 7.20–10.83 s, przy zakresie 4.2–19.6 s. Skośność wyniosła 0.86, a po logarytmowaniu 0.03. TUG-cog ukończyło 169 osób: mediana 11.0 s, IQR 8.3–13.7 s.
Przy takim rozkładzie w tabeli opisowej podaj medianę i IQR, a obok średnią i SD. Logarytm czasu ma tu szczególną zaletę: różnica na logarytmach to stosunek czasów. Keene (1995) zaleca, by analizę na logarytmach dodatnich danych ciągłych rozważać już na etapie protokołu, a nie dopiero po obejrzeniu danych. Średnia z logarytmów po przekształceniu wstecznym to średnia geometryczna. W próbie wyniosła 8.94 s, czyli mniej niż średnia arytmetyczna, którą „ciągną w górę” najwolniejsze osoby.
Krok 2. Porównanie osób z upadkiem i bez upadku
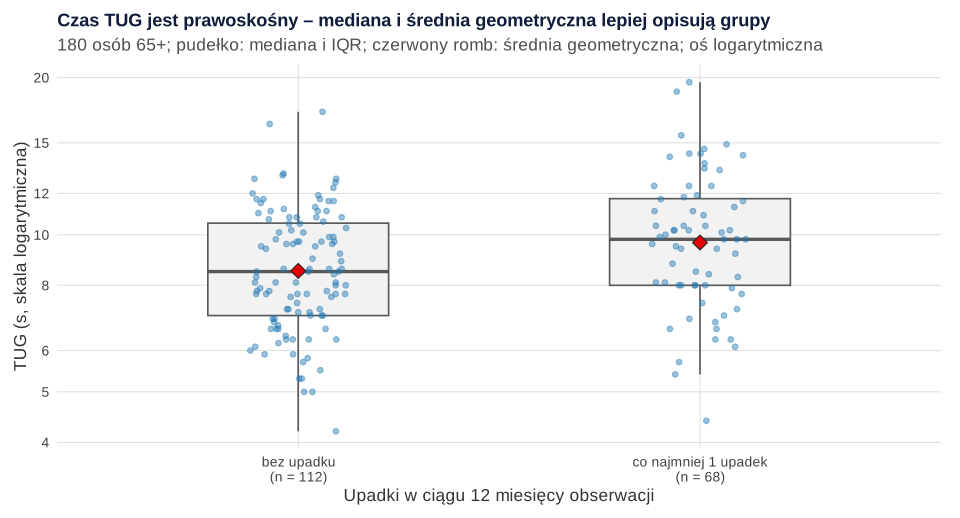
W ciągu roku co najmniej raz upadło 68 osób (37.8%). Na początku badania miały dłuższy TUG niż pozostałe 112 osób: mediana 9.8 s [8.0, 11.7] wobec 8.5 s [7.0, 10.5] (rysunek 1).
Masz dwie dobre drogi analizy. Wybierz jedną jako główną przed analizą danych, a drugą podaj jako analizę wrażliwości.
- Regresja liniowa na log(czasu) z korektą o wiek. Wykładnik współczynnika to stosunek średnich geometrycznych. U osób z upadkiem czas był średnio 1.137 raza dłuższy, 95% CI [1.053, 1.228], t(177) = 3.29, p = .001, czyli o około 14%. Ten zapis ma sens niezależnie od tego, czy grupa jest szybka, czy wolna.
- Test Manna–Whitneya z estymatorem Hodgesa–Lehmanna: W = 4738, p = .006, przesunięcie 1.1 s, 95% CI [0.3, 1.9]. Nie wymaga założeń o rozkładzie, ale nie pozwala na korektę o wiek.
Zauważ kierunek pytania. To porównanie mówi, że osoby, które potem upadły, chodziły wolniej. Nie mówi, jak dobrze TUG przewiduje upadek u konkretnej osoby. Tym zajmuje się krok 5.
Krok 3. Osoby, które nie ukończyły próby
W prawdziwym badaniu część osób nie ukończy testu: przerwie próbę z zadaniem, odmówi albo badający przerwie ją ze względów bezpieczeństwa. To nie są przypadkowe braki danych. Najczęściej dotyczą osób najsłabszych, więc są to braki typu MNAR. W przykładzie TUG-cog przerwało 11 osób: 7 z 68 osób z upadkiem (10.3%) i 4 ze 112 bez upadku (3.6%).
Gdy usuniesz te osoby, porównujesz grupy „oczyszczone” z najwolniejszych uczestników. Lachin (1999) opisał podejście najgorszej rangi (ang. worst-rank score): osobie, której pomiar brakuje z powodu zdarzenia związanego z chorobą, przypisujesz rangę gorszą od każdego zmierzonego wyniku. Następnie wykonujesz test rangowy. Lachin pokazał, że przy określonych założeniach taki test jest nieobciążony. W kodzie wystarczy wpisać przerwanej próbie dowolną wartość większą od najdłuższego czasu, bo test Manna–Whitneya używa tylko kolejności.
| Analiza | n | W | p | P(gorszy wynik u osoby z upadkiem) |
|---|---|---|---|---|
| Tylko osoby, które ukończyły próbę | 169 | 3994 | .022 | .61 |
| Najgorsza ranga dla przerwanych prób | 180 | 4764 | .005 | .63 |
Ostatnia kolumna to prawdopodobieństwo, że losowa osoba z upadkiem ma gorszy wynik niż losowa osoba bez upadku. Analiza z najgorszą rangą wykorzystuje wszystkie 180 osób i daje nieco silniejszy efekt, bo przerwane próby częściej zdarzały się w grupie z upadkiem. W metodzie napisz, ile prób przerwano, w której grupie i z jakiego powodu, a regułę najgorszej rangi ustal w protokole.
Koszt zadania podwójnego
Przy TUG-cog studenci często liczą koszt zadania jako procentowe wydłużenie czasu: 100 × (TUG-cog − TUG) / TUG. W przykładzie mediana kosztu wyniosła 23.3% [14.8, 30.0]. Ten iloraz to ta sama informacja co różnica logarytmów obu czasów, więc możesz go analizować tak jak w kroku 2. Przy przerwanej próbie kosztu nie da się policzyć, a reguła najgorszej rangi znów jest naturalnym wyjściem. Pamiętaj też, że w badaniu Shumway-Cook, Brauer i Woollacott (2000) zadanie dodatkowe wydłużało czas, ale nie poprawiało rozpoznawania osób skłonnych do upadków. Próba liczyła jednak tylko 30 osób.
Krok 4. Liczba upadków jako wynik
Liczba upadków w roku to zliczenie. Większość osób ma 0, kilka ma ich wiele. W przykładzie 112 osób nie upadło, 46 upadło raz, 11 dwa razy, 4 trzy razy, a 7 cztery razy lub więcej. Średnia wyniosła 0.63, a wariancja 1.25. Wariancja jest prawie dwa razy większa od średniej, a regresja Poissona zakłada, że są równe. Robertson, Campbell i Herbison (2005) porównali metody analizy w badaniach zapobiegania upadkom. Zalecają regresję ujemną dwumianową, bo uwzględnia nadmierną zmienność i różny czas obserwacji, a przy tym jest łatwa w użyciu.
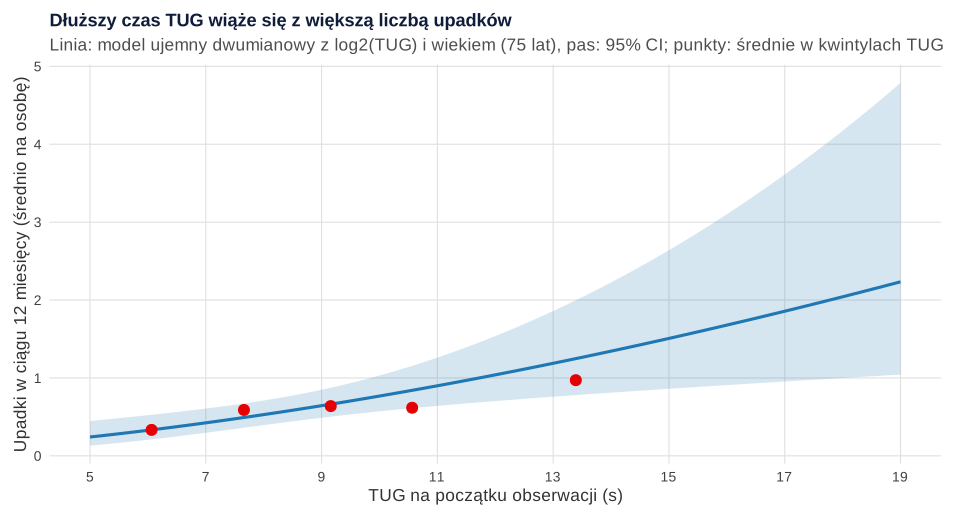
W przykładzie model Poissona miał wskaźnik dyspersji 1.72 i AIC = 405.0, a model ujemny dwumianowy AIC = 385.2. TUG wprowadziliśmy jako log2(czasu), więc współczynnik dotyczy podwojenia czasu. Iloraz częstości upadków (IRR) wyniósł 3.17, 95% CI [1.65, 6.09], z = 3.46, p < .001. Podwojenie czasu to jednak duża różnica. Bardziej realistyczny zapis to IRR = 1.17, 95% CI [1.07, 1.28] na każde wydłużenie czasu o 10% (rysunek 2). Wiek w tym samym modelu nie był istotny (IRR na 10 lat = 0.76, 95% CI [0.52, 1.10], p = .148). Nie wnioskuj z tego, że wiek „nie ma znaczenia”: TUG już zawiera dużą część spowolnienia związanego z wiekiem. Gdy obserwacja trwała różnie długo, dodaj offset z logarytmem czasu obserwacji. Pełny przykład regresji dla zliczeń jest we wpisie regresja dla zliczeń krok po kroku.
Krok 5. Czy TUG przewiduje upadek? AUC i progi
Pytanie o przewidywanie to pytanie o dyskryminację. Pole pod krzywą ROC dla co najmniej jednego upadku wyniosło AUC = .622, 95% CI [.537, .707]. To słaba dyskryminacja, mimo wyraźnej różnicy średnich w kroku 2. Różnica między grupami może być istotna statystycznie, a rozkłady i tak mocno na siebie zachodzą (rysunek 1). Jak wybrać i opisać punkt odcięcia, pokazuje wpis krzywa ROC i punkt odcięcia krok po kroku.
W pracach często pojawia się próg ≥ 13.5 s. Barry i in. (2014) w metaanalizie badań osób starszych mieszkających w społeczności przyjęli go jako próg wyższego ryzyka. Uzyskali zbiorczą swoistość 0.74 i czułość tylko 0.31. Wnioskują, że TUG ma ograniczoną zdolność przewidywania upadków i nie powinien być jedynym narzędziem do identyfikacji osób z wysokim ryzykiem. W naszej próbie wynik ≥ 13.5 s miało 12 osób. Czułość wyniosła .147, a swoistość .982. Próg ten opisuj więc jako kryterium z literatury z podaniem źródła. Własne wnioski opieraj na czasie jako zmiennej ciągłej, bo dzielenie zmiennej ciągłej na grupy zmniejsza moc (Altman i Royston, 2006). Wpis służy do analizy danych badawczych i nie jest wskazówką do oceny konkretnego pacjenta.
Jak opisać wyniki w pracy
Przykładowy akapit wyników:
Czas TUG miał rozkład prawoskośny (Me = 9.1 s, IQR 7.2–10.8 s), dlatego analizowano jego logarytm. W ciągu 12 miesięcy upadło co najmniej raz 68 z 180 osób (37.8%). Po uwzględnieniu wieku osoby, które upadły, miały na początku badania średnio o 14% dłuższy czas TUG (stosunek średnich geometrycznych 1.14, 95% CI [1.05, 1.23], p = .001). W regresji ujemnej dwumianowej wydłużenie czasu TUG o 10% wiązało się z 17% większą częstością upadków (IRR = 1.17, 95% CI [1.07, 1.28]). Zdolność dyskryminacyjna TUG była jednak niewielka (AUC = .62, 95% CI [.54, .71]). Próbę z zadaniem poznawczym przerwało 11 osób; w analizie przypisano im najgorszą rangę (Lachin, 1999).
W metodzie opisz protokół testu (krzesło, polecenie, pomoce do chodzenia, liczbę prób), definicję upadku i sposób jego zbierania oraz regułę dla przerwanych prób. Rzetelność pomiaru podaj ze źródła albo z własnych powtórzonych prób. Jak policzyć ICC i MDC, opisuje nasz poprzedni wpis o TUG. Różnice między RCI, MDC i MCID wyjaśnia wpis RCI, MDC i MCID.
Licencja. TUG to procedura opisana w artykule, a nie chroniony formularz. Nie znaleźliśmy oficjalnej strony autorów z warunkami użycia (stan na 1 listopada 2026 r.). W pracy cytuj Podsiadlo i Richardson (1991) i opisz własny protokół.
TUG w R: log czasu, najgorsza ranga, regresja ujemna dwumianowa i AUC
Kod odtwarza liczby z tekstu i zapisuje plik CSV. Regresję liniową na logarytmie i testy rangowe liczy bazowe R, regresję ujemną dwumianową – pakiet MASS, a AUC z przedziałem DeLonga – pROC. Funkcja do prawdopodobieństwa „gorszego wyniku” jest zdefiniowana w kodzie.
Analiza czasu TUG i liczby upadków krok po kroku
R
# B305 – Test Timed Up and Go (TUG): czas jako zmienna skośna w porównaniu grup, osoby, które nie
# ukończyły próby, TUG z zadaniem poznawczym i liczba upadków w obserwacji rocznej
# (dane symulowane, set.seed(30505)). 180 osób w wieku 65+ mieszkających samodzielnie;
# na początku TUG (s) i TUG z zadaniem poznawczym (TUG-cog, s); potem 12 miesięcy kalendarza upadków.
# Rzetelności (ICC, SEM, MDC) tu nie liczymy – opisuje ją wpis /blog/timed-up-and-go-analiza-wynikow/.
suppressPackageStartupMessages({ library(MASS); library(pROC) })
set.seed(30505)
n <- 180
wiek <- round(runif(n, 65, 90))
kobieta <- rbinom(n, 1, 0.62)
sprawnosc <- rnorm(n)                                         # ukryta słabość (wyższa = gorzej)
tug <- round(exp(log(8.6) + 0.018 * (wiek - 75) + 0.24 * sprawnosc + rnorm(n, 0, 0.12)), 1)
koszt_log <- 0.20 + 0.05 * sprawnosc + rnorm(n, 0, 0.09)      # wydłużenie czasu przy zadaniu (skala log)
tug_cog <- round(tug * exp(koszt_log), 1)
nie_ukonczyl <- rbinom(n, 1, plogis(-3.4 + 1.6 * sprawnosc + 0.06 * (wiek - 75))) == 1
tug_cog[nie_ukonczyl] <- NA                                   # próba z zadaniem przerwana
upadki <- rnbinom(n, size = 0.7, mu = exp(-0.80 + 0.60 * log(tug / 8.6) + 0.20 * sprawnosc + 0.01 * (wiek - 75)))
dane <- data.frame(id = 1:n, wiek, kobieta, tug, tug_cog, tug_cog_przerwany = as.integer(nie_ukonczyl), upadki)
write.csv(dane, "../tug-dane-przyklad.csv", row.names = FALSE)   # plik do pobrania

# Krok 1. Rozkład czasu: średnia, mediana, średnia geometryczna, skośność
skos <- function(x) { x <- x[!is.na(x)]; mean((x - mean(x))^3) / sd(x)^3 }
opis <- function(x) { x <- x[!is.na(x)]
  round(c(n = length(x), M = mean(x), SD = sd(x), Me = median(x), Q1 = unname(quantile(x, .25)),
          Q3 = unname(quantile(x, .75)), min = min(x), max = max(x), GM = exp(mean(log(x))),
          skos = skos(x), skos_log = skos(log(x))), 2) }
rbind(TUG = opis(dane$tug), TUG_cog = opis(dane$tug_cog))
c(przerwane_proby = sum(nie_ukonczyl))

# Krok 2. Osoby z upadkiem (co najmniej 1 w 12 miesięcy) a bez upadku
dane$upadek <- as.integer(dane$upadki >= 1)
dane$grupa <- factor(dane$upadek, levels = c(1, 0), labels = c("upadek", "bez_upadku"))  # różnica = upadek − bez
table(dane$upadek)
round(sapply(split(dane$tug, dane$upadek), function(x) c(Me = median(x), Q1 = unname(quantile(x, .25)),
      Q3 = unname(quantile(x, .75)), GM = exp(mean(log(x))))), 2)
m_log <- lm(log(tug) ~ upadek + I(wiek - 75), data = dane)       # regresja na log(czasu)
round(exp(cbind(iloraz = coef(m_log), confint(m_log)))[2, ], 3)  # stosunek średnich geometrycznych
signif(summary(m_log)$coefficients[2, ], 4)
mw <- wilcox.test(tug ~ grupa, data = dane, conf.int = TRUE, exact = FALSE)
round(c(W = unname(mw$statistic), HL = unname(mw$estimate), HL_dolna = mw$conf.int[1], HL_gorna = mw$conf.int[2]), 2)
signif(mw$p.value, 3)

# Krok 3. TUG z zadaniem poznawczym: koszt zadania i osoby, które przerwały próbę
dane$koszt_proc <- 100 * (dane$tug_cog - dane$tug) / dane$tug
round(c(Me = median(dane$koszt_proc, na.rm = TRUE), Q1 = unname(quantile(dane$koszt_proc, .25, na.rm = TRUE)),
        Q3 = unname(quantile(dane$koszt_proc, .75, na.rm = TRUE))), 1)
table(przerwany = dane$tug_cog_przerwany, upadek = dane$upadek)
# a) tylko osoby z pełnym wynikiem (pomija przerwane próby)
cc <- wilcox.test(tug_cog ~ grupa, data = dane, exact = FALSE)
# b) najgorsza ranga (Lachin, 1999): przerwana próba = wynik gorszy od każdego zmierzonego
dane$tug_cog_wr <- ifelse(is.na(dane$tug_cog), max(dane$tug_cog, na.rm = TRUE) + 100, dane$tug_cog)
wr <- wilcox.test(tug_cog_wr ~ grupa, data = dane, exact = FALSE)
auc_rang <- function(x, g) { r <- rank(x); n1 <- sum(g == 1); n0 <- sum(g == 0)
  (sum(r[g == 1]) - n1 * (n1 + 1) / 2) / (n1 * n0) }        # P(osoba z upadkiem ma gorszy wynik)
cbb <- !is.na(dane$tug_cog)
signif(rbind(pelne_wyniki = c(n = sum(cbb), W = unname(cc$statistic), p = cc$p.value,
                              P_gorszy = auc_rang(dane$tug_cog[cbb], dane$upadek[cbb])),
             najgorsza_ranga = c(n = n, W = unname(wr$statistic), p = wr$p.value,
                                 P_gorszy = auc_rang(dane$tug_cog_wr, dane$upadek))), 4)

# Krok 4. Liczba upadków: regresja ujemna dwumianowa z log2(TUG) i wiekiem
round(c(M = mean(dane$upadki), wariancja = var(dane$upadki)), 2)
table(pmin(dane$upadki, 4))                                    # 4 = cztery lub więcej
m_p <- glm(upadki ~ log2(tug) + I((wiek - 75) / 10), family = poisson, data = dane)
m_nb <- glm.nb(upadki ~ log2(tug) + I((wiek - 75) / 10), data = dane)
round(c(dyspersja_poisson = sum(residuals(m_p, type = "pearson")^2) / m_p$df.residual,
        AIC_poisson = AIC(m_p), AIC_nb = AIC(m_nb), theta = m_nb$theta), 2)
round(exp(cbind(IRR = coef(m_nb), confint.default(m_nb)))[-1, ], 2)   # IRR na podwojenie czasu i na 10 lat
signif(summary(m_nb)$coefficients[-1, ], 4)
round(exp(log2(1.1) * c(coef(m_nb)[2], confint.default(m_nb)[2, ])), 2)   # IRR na czas dłuższy o 10%

# Krok 5. Dyskryminacja: AUC dla co najmniej jednego upadku i opis progu 13.5 s z literatury
r <- roc(dane$upadek, dane$tug, quiet = TRUE, direction = "<")
round(c(AUC = as.numeric(auc(r)), ci.auc(r, method = "delong")[c(1, 3)]), 3)
prog <- dane$tug >= 13.5
round(c(n_powyzej = sum(prog), czulosc = mean(prog[dane$upadek == 1]), swoistosc = mean(!prog[dane$upadek == 0])), 3)
Wynik w R
          n    M   SD   Me  Q1    Q3 min  max    GM skos skos_log
TUG     180  9.3 2.70  9.1 7.2 10.83 4.2 19.6  8.94 0.86     0.03
TUG_cog 169 11.3 3.64 11.0 8.3 13.70 4.8 24.1 10.73 0.62    -0.05
przerwane_proby
             11

  0   1
112  68
       0     1
Me  8.50  9.80
Q1  7.00  8.00
Q3 10.53 11.72
GM  8.52  9.66
iloraz  2.5 % 97.5 %
 1.137  1.053  1.228
  Estimate Std. Error    t value   Pr(>|t|)
  0.128300   0.038950   3.294000   0.001195
       W       HL HL_dolna HL_gorna
  4738.0      1.1      0.3      1.9
[1] 0.00609
  Me   Q1   Q3
23.3 14.8 30.0
         upadek
przerwany   0   1
        0 108  61
        1   4   7
                  n    W        p P_gorszy
pelne_wyniki    169 3994 0.022120   0.6062
najgorsza_ranga 180 4764 0.004829   0.6255
        M wariancja
     0.63      1.25

  0   1   2   3   4
112  46  11   4   7
dyspersja_poisson       AIC_poisson            AIC_nb             theta
             1.72            405.02            385.16              1.05
                   IRR 2.5 % 97.5 %
log2(tug)         3.17  1.65   6.09
I((wiek - 75)/10) 0.76  0.52   1.10
                  Estimate Std. Error z value  Pr(>|z|)
log2(tug)           1.1540      0.333   3.464 0.0005314
I((wiek - 75)/10)  -0.2778      0.192  -1.447 0.1480000
log2(tug)     2.5 %    97.5 %
     1.17      1.07      1.28
  AUC
0.622 0.537 0.707
n_powyzej   czulosc swoistosc
   12.000     0.147     0.982
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Sama średnia i SD przy skośnym czasie. Podaj medianę i IQR, a porównania rób na logarytmach albo testem rangowym.
- Usuwanie osób, które nie ukończyły próby. To zwykle najsłabsi uczestnicy. Policz ich, opisz i uwzględnij, np. przez najgorszą rangę.
- Regresja liniowa albo test t dla liczby upadków. To zliczenia z nadmierną zmiennością – użyj modelu ujemnego dwumianowego.
- Mylenie różnicy grup z trafnością prognostyczną. Istotna różnica średnich nie oznacza dobrego AUC.
- Próg bez źródła. Każdy punkt odcięcia podawaj z cytowaniem i z czułością oraz swoistością z tego źródła.
- Odwrócony kierunek. Dłuższy czas oznacza gorszą sprawność. Napisz to w tabelach i podpisach wykresów.
Jeśli chcesz, żeby ktoś sprawdził plan analizy TUG i upadków w Twojej pracy, możesz skorzystać z oferty analizy statystyczne dla studentów. Wyniki i tak musisz umieć samodzielnie wyjaśnić i obronić.
Najczęstsze pytania
Jak porównać czas TUG między dwiema grupami?
Czas jest prawoskośny, więc porównuj logarytmy, np. w regresji liniowej z korektą o wiek. Wykładnik współczynnika to stosunek średnich geometrycznych: w przykładzie osoby, które upadły, miały czas o 14% dłuższy (1.14, 95% CI [1.05, 1.23]). Alternatywą bez korekty jest test Manna–Whitneya z estymatorem Hodgesa–Lehmanna.
Co zrobić z osobą, która nie ukończyła testu TUG?
Nie usuwaj jej po cichu, bo zwykle to najsłabsi uczestnicy, a brak nie jest losowy. Możesz przypisać jej najgorszą rangę, czyli wynik gorszy od każdego zmierzonego, i wykonać test rangowy (Lachin, 1999). Regułę ustal w protokole, a w pracy podaj, ile prób przerwano, w której grupie i dlaczego.
Jak analizować liczbę upadków w zależności od wyniku TUG?
Liczba upadków to zliczenie z dużą liczbą zer i wariancją większą niż średnia. Robertson i in. (2005) zalecają regresję ujemną dwumianową. Wprowadź TUG jako log czasu, a wynik podaj jako iloraz częstości (IRR), np. na wydłużenie czasu o 10%. Przy różnym czasie obserwacji dodaj offset.
Czy TUG dobrze przewiduje upadki?
Sprawdź to polem pod krzywą ROC, a nie samą różnicą średnich. W przykładzie różnica grup była istotna, ale AUC wyniosło tylko .62. W metaanalizie Barry i in. (2014) próg ≥ 13.5 s miał czułość 0.31 i swoistość 0.74; autorzy uznali, że TUG nie powinien sam służyć do identyfikacji osób z wysokim ryzykiem.
Jak policzyć koszt zadania podwójnego w TUG?
Najprościej jako procentowe wydłużenie czasu: 100 × (TUG z zadaniem − TUG) / TUG. To ta sama informacja co różnica logarytmów obu czasów, więc analizuj ją tak jak sam czas. Przerwanej próby z zadaniem nie zamieniaj na brak danych – uwzględnij ją, np. przez najgorszą rangę.
Powiązane hasła
Przeczytaj też
Timed Up and Go – analiza wyników
Protokół, skośny rozkład czasu, ICC, SEM i MDC dwóch prób, zmiana przed i po, próg 13.5 s i wartości referencyjne dla wieku – z przykładem w R.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikKrzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →PoradnikSkala Tinetti – analiza wyników
Wersje skali, wynik 0–28 i podskale, korelacja z TUG, OR, krzywa ROC i progi z literatury oraz optymizm progu Youdena – z przykładem w R.
Czytaj →PoradnikFES-I – jak policzyć wynik
Suma 16–64, reguła braków autorów, progi Delbaere, Short FES-I, rzetelność i porównanie osób po upadku – z przykładem w R i wzorem opisu.
Czytaj →Analizujesz TUG i upadki w pracy dyplomowej?
Sprawdzimy plan analizy, model dla liczby upadków, sposób potraktowania przerwanych prób i opis wyników, a potem wyjaśnimy analizę tak, żebyś umiał(a) samodzielnie ją opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Royston, P. (2006). The cost of dichotomising continuous variables. BMJ, 332(7549), 1080. https://doi.org/10.1136/bmj.332.7549.1080 ● Otwarty dostęp
- Barry, E., Galvin, R., Keogh, C., Horgan, F., & Fahey, T. (2014). Is the Timed Up and Go test a useful predictor of risk of falls in community dwelling older adults: A systematic review and meta-analysis. BMC Geriatrics, 14(1), Article 14. https://doi.org/10.1186/1471-2318-14-14 ● Otwarty dostęp
- Keene, O. N. (1995). The log transformation is special. Statistics in Medicine, 14(8), 811–819. https://doi.org/10.1002/sim.4780140810
- Lachin, J. M. (1999). Worst-rank score analysis with informatively missing observations in clinical trials. Controlled Clinical Trials, 20(5), 408–422. https://doi.org/10.1016/s0197-2456(99)00022-7
- Lamb, S. E., Jørstad-Stein, E. C., Hauer, K., Becker, C., & Prevention of Falls Network Europe and Outcomes Consensus Group. (2005). Development of a common outcome data set for fall injury prevention trials: The Prevention of Falls Network Europe consensus. Journal of the American Geriatrics Society, 53(9), 1618–1622. https://doi.org/10.1111/j.1532-5415.2005.53455.x
- Podsiadlo, D., & Richardson, S. (1991). The timed “Up & Go”: A test of basic functional mobility for frail elderly persons. Journal of the American Geriatrics Society, 39(2), 142–148. https://doi.org/10.1111/j.1532-5415.1991.tb01616.x
- Robertson, M. C., Campbell, A. J., & Herbison, P. (2005). Statistical analysis of efficacy in falls prevention trials. The Journals of Gerontology Series A: Biological Sciences and Medical Sciences, 60(4), 530–534. https://doi.org/10.1093/gerona/60.4.530
- Shumway-Cook, A., Brauer, S., & Woollacott, M. (2000). Predicting the probability for falls in community-dwelling older adults using the Timed Up & Go Test. Physical Therapy, 80(9), 896–903. https://doi.org/10.1093/ptj/80.9.896
Cytowania BibTeX
@article{altman2006cost, author={Altman, Douglas G. and Royston, Patrick}, title={{The cost of dichotomising continuous variables}}, journal={BMJ}, year={2006}, volume={332}, number={7549}, pages={1080}, doi={10.1136/bmj.332.7549.1080}}@article{barry2014timed, author={Barry, Emma and Galvin, Rose and Keogh, Claire and Horgan, Frances and Fahey, Tom}, title={{Is the Timed Up and Go test a useful predictor of risk of falls in community dwelling older adults: A systematic review and meta-analysis}}, journal={BMC Geriatrics}, year={2014}, volume={14}, number={1}, eid={14}, doi={10.1186/1471-2318-14-14}}@article{keene1995log, author={Keene, Oliver N.}, title={{The log transformation is special}}, journal={Statistics in Medicine}, year={1995}, volume={14}, number={8}, pages={811--819}, doi={10.1002/sim.4780140810}}@article{lachin1999worst, author={Lachin, John M.}, title={{Worst-rank score analysis with informatively missing observations in clinical trials}}, journal={Controlled Clinical Trials}, year={1999}, volume={20}, number={5}, pages={408--422}, doi={10.1016/s0197-2456(99)00022-7}}@article{lamb2005development, author={Lamb, Sarah E. and Jørstad-Stein, Ellen C. and Hauer, Klaus and Becker, Clemens and {Prevention of Falls Network Europe and Outcomes Consensus Group}}, title={{Development of a common outcome data set for fall injury prevention trials: The Prevention of Falls Network Europe consensus}}, journal={Journal of the American Geriatrics Society}, year={2005}, volume={53}, number={9}, pages={1618--1622}, doi={10.1111/j.1532-5415.2005.53455.x}}@article{podsiadlo1991timed, author={Podsiadlo, Diane and Richardson, Sandra}, title={{The timed “Up \& Go”: A test of basic functional mobility for frail elderly persons}}, journal={Journal of the American Geriatrics Society}, year={1991}, volume={39}, number={2}, pages={142--148}, doi={10.1111/j.1532-5415.1991.tb01616.x}}@article{robertson2005statistical, author={Robertson, M. C. and Campbell, A. J. and Herbison, P.}, title={{Statistical analysis of efficacy in falls prevention trials}}, journal={The Journals of Gerontology Series A: Biological Sciences and Medical Sciences}, year={2005}, volume={60}, number={4}, pages={530--534}, doi={10.1093/gerona/60.4.530}}@article{shumwaycook2000predicting, author={Shumway-Cook, Anne and Brauer, Sandy and Woollacott, Marjorie}, title={{Predicting the probability for falls in community-dwelling older adults using the Timed Up \& Go Test}}, journal={Physical Therapy}, year={2000}, volume={80}, number={9}, pages={896--903}, doi={10.1093/ptj/80.9.896}}