Czym jest Skala Równowagi Berga
Skala Równowagi Berga (ang. Berg Balance Scale, BBS) to test funkcjonalny, w którym fizjoterapeuta ocenia, jak osoba radzi sobie z codziennymi zadaniami wymagającymi utrzymania równowagi. Skalę opracował zespół Katherine Berg z Uniwersytetu McGilla z myślą o osobach starszych. Berg i in. (1992) sprawdzili jej trafność w grupie 113 mieszkańców domu opieki i 70 pacjentów po ostrym udarze. Wynik korelował z ocenami opiekunów, samooceną i laboratoryjnym pomiarem kołysania, a także przewidywał wielokrotne upadki. W kolejnej pracy Berg i in. (1995) opisali rzetelność: zgodność oceniających wyniosła ICC = .98, a powtarzalność oceny tej samej osoby po tygodniu ICC = .97.
Ten wpis nie uczy przeprowadzania badania – do tego potrzebny jest oryginalny protokół i szkolenie. Pokazuje, co zrobić z wynikami w pracy dyplomowej: jak opisać rozkład, rzetelność i zmianę przed i po programie oraz czego nie wolno wnioskować z punktu odcięcia. Te same kroki dla innych testów funkcjonalnych znajdziesz we wpisach o teście Timed Up and Go i teście 6-minutowego marszu.
Procedura i punktacja w skrócie
BBS składa się z 14 zadań. Każde ocenia się od 0 do 4 punktów w zależności od tego, jak osoba wykonuje czynność, a wynik ogólny to suma, czyli od 0 do 56 punktów (Shirley Ryan AbilityLab, 2020). Wyższy wynik oznacza lepszą równowagę. Zadania obejmują między innymi przejście z siadu do stania, stanie bez podparcia, przesiadanie się, stanie z zamkniętymi oczami, sięganie w przód, podnoszenie przedmiotu z podłogi, obrót o 360° i stanie na jednej nodze. Według tej samej karty narzędzia badanie trwa 15–20 minut, a potrzebne są stoper, dwa krzesła (z podłokietnikami i bez), stopień lub podnóżek oraz linijka.
| Cecha | Skala Równowagi Berga |
|---|---|
| Liczba zadań | 14, wszystkie wykonywane przez badanego i oceniane przez fizjoterapeutę |
| Ocena zadania | 0–4 pkt (skala porządkowa) |
| Wynik ogólny | suma 0–56 pkt; bez pozycji odwróconych i bez podskal |
| Kierunek | więcej punktów = lepsza równowaga |
| Czas | 15–20 min |
Szczegółowych kryteriów punktacji poszczególnych zadań nie przepisuj z pamięci ani z niepewnych stron. Weź je z oryginalnego formularza i podaj jego źródło w opisie narzędzia. Karta w bazie Rehabilitation Measures opisuje BBS jako narzędzie bezpłatne i dostępne w domenie publicznej (Shirley Ryan AbilityLab, 2020). Jeśli korzystasz z polskiej wersji formularza, sprawdź, kto ją przygotował i czy opublikowano jej właściwości psychometryczne. Jak opisać narzędzie w rozdziale metodologicznym, pokazuje wpis opis narzędzia badawczego – wzór.
Badanie przykładowe
Liczby w dalszej części pochodzą z symulowanych danych. Sześćdziesiąt cztery osoby po 65. roku życia, mieszkające we własnym domu, przydzielono losowo do 12-tygodniowego treningu równowagi (n = 32) albo do grupy kontrolnej z edukacją zdrowotną (n = 32). BBS wykonano przed programem (T0), powtórnie po 48 godzinach przez tę samą fizjoterapeutkę (T0r) i po 12 tygodniach (T1). Dane możesz pobrać jako plik skala-berga-dane-przyklad.csv (64 wiersze, 1.4 KB). Kod odtwarzający wszystkie liczby jest w sekcji Przykład w R.
Krok 1. Opisz rozkład i sprawdź efekt sufitu
Wynik BBS to suma ocen porządkowych z górną granicą 56. W grupach osób sprawnych wiele wyników leży więc tuż przy maksimum, a rozkład jest lewoskośny. W przykładzie przed programem średnia wyniosła 41.25 pkt (SD = 11.59), mediana 43.0 pkt (IQR: 31.75–52.00), a zakres 14–56. Skośność wyniosła −0.40, a test Shapiro–Wilka wskazał odstępstwo od normalności (p < .001). Po programie skośność wzrosła do −1.00. W grupie treningowej wynik 56 pkt uzyskało przed programem 2 z 32 osób, a po programie już 7 z 32 (21.9%).
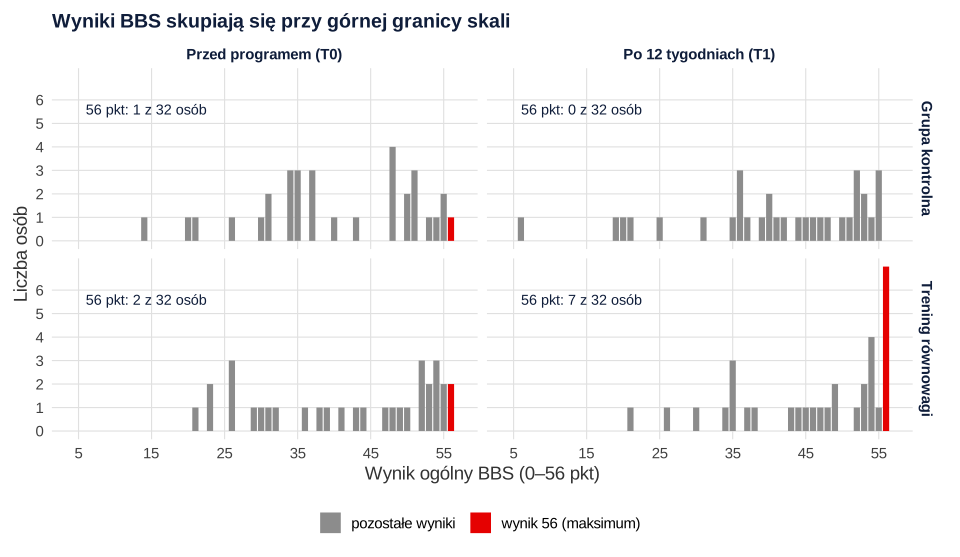
To zjawisko nazywa się efektem sufitu, a w testach sprawności – efektem pułapu. Osoba z wynikiem 56 może mieć bardzo dobrą albo tylko przyzwoitą równowagę – skala już tego nie rozróżni. Downs i in. (2013) w przeglądzie systematycznym zauważyli efekt sufitu u części badanych, a Blum i Korner-Bitensky (2008) znaleźli efekty podłogi lub sufitu w trzech badaniach osób po udarze i radzą łączyć BBS z innymi miarami równowagi. W pracy zawsze podaj więc odsetek wyników minimalnych i maksymalnych.
Co z tego wynika dla opisu? Podaj obok średniej i SD także medianę i IQR, bo przy skośnym rozkładzie lepiej oddają typowy wynik. Ogólne zasady znajdziesz we wpisie statystyki opisowe w pracy. Na poziomie zadań sprawdź, które z nich prawie wszyscy wykonują bez trudu. W przykładzie ocenę 4 uzyskało od 18.8% do 60.9% badanych, zależnie od zadania.
Krok 2. Rzetelność: ICC, SEM i MDC95
Spójność wewnętrzna 14 zadań była wysoka, α = .96. Przy teście funkcjonalnym ważniejsze jest jednak pytanie, czy powtórzony pomiar daje ten sam wynik. Dlatego w przykładzie fizjoterapeutka powtórzyła badanie po 48 godzinach. Jak zaplanować takie badanie, kto ma mierzyć i ile razy, opisujemy szczegółowo w poradniku o badaniu rzetelności pomiaru klinicznego, a krótko w haśle rzetelność testów sprawności. Tutaj tylko trzy liczby, które warto podać:
- Błąd systematyczny. Średnia różnica T0r − T0 wyniosła −0.17 pkt, 95% CI [−0.82, 0.47], t(63) = −0.53, p = .596.
- ICC. ICC(A,1) = .976, 95% CI [.961, .985]. Według kryteriów Koo i Li (2016), opartych na przedziale ufności, to rzetelność doskonała. Wynik jest bliski metaanalizie Downsa i in. (2013), w której łączna rzetelność wewnątrzosobnicza wyniosła .98.
- SEM i MDC95. SEM = 1.82 pkt, a MDC95 = 1.96 × √2 × SEM = 5.06 pkt. Zmiana o mniej niż około 5 punktów u pojedynczej osoby mieści się więc w błędzie pomiaru.
Wysoki ICC nie znaczy, że skala wychwyci małą poprawę u konkretnego pacjenta. Downs i in. (2013) podają, że MDC95 w uwzględnionych badaniach wahała się od 2.8 do 6.6 pkt, zależnie od miejsca na skali, i była mniejsza blisko 56 pkt z powodu efektu sufitu. Stevenson (2001) u pacjentów po udarze oszacował, że do 90% pewności rzeczywistej zmiany potrzeba zmiany o ±6 pkt. Własne MDC licz zawsze na swoich danych i podawaj wzór. MDC na podstawie ICC i SD możesz sprawdzić w kalkulatorze RCI i MDC.
Krok 3. Analiza przed i po
W badaniu z grupą kontrolną i pomiarem wyjściowym najlepiej sprawdza się ANCOVA: wynik po programie jest zmienną zależną, a wynik wyjściowy – kowariantem. Vickers i Altman (2001) pokazują, że to podejście daje zwykle większą moc niż porównanie samych wyników końcowych czy zmian i nie zależy od przypadkowej nierównowagi grup na starcie. Porównanie strategii na jednych danych znajdziesz w poradniku ANCOVA w badaniu przed i po, a szerszy kontekst – w przewodniku badania kliniczne i pomiar przed i po.
| Grupa | T0: M (SD) | T1: M (SD) | Zmiana: M (SD) | Zmiana: Me [IQR] |
|---|---|---|---|---|
| Trening równowagi | 42.12 (11.93) | 46.34 (10.06) | 4.22 (3.81) | 3 [1.00, 7.25] |
| Kontrola | 40.38 (11.36) | 41.12 (12.40) | 0.75 (4.06) | 0 [−1.25, 4.00] |
Po uwzględnieniu wyniku wyjściowego grupa treningowa miała po 12 tygodniach średnio o 3.62 pkt wyższy wynik niż kontrolna, 95% CI [1.70, 5.54], t(61) = 3.77, p < .001. Średnie skorygowane wyniosły 45.55 pkt, 95% CI [44.19, 46.90], i 41.92 pkt, 95% CI [40.57, 43.28]. Podzielona przez SD wyjściowe różnica daje d = 0.31. Rozkład reszt nie odbiegał wyraźnie od normalnego (Shapiro–Wilk p = .058). Ponieważ zmiany są skośne i ograniczone sufitem, warto dodać analizę wrażliwości: test Manna–Whitneya dla zmian dał W = 275.5, p = .001, r = .40, a estymator Hodgesa–Lehmanna przesunięcia wyniósł 3 pkt, 95% CI [1.00, 5.00]. Oba wyniki prowadzą do tego samego wniosku.
Krok 4. Sprawdź, czy efekt sufitu nie zniekształca wyniku
ANCOVA zakłada jednakowe nachylenie zależności T1 od T0 w obu grupach. W przykładzie to założenie nie było spełnione: interakcja T0 × grupa była istotna, F(1, 60) = 8.23, p = .006. Przyczynę widać na rysunku 2. Osoba z wynikiem 52 pkt może zyskać najwyżej 4 punkty, a osoba z wynikiem 25 pkt – nawet 31. W grupie treningowej zmiana silnie zależała od wyniku wyjściowego, r = −.61, 95% CI [−.79, −.33], p < .001. U 16 osób z T0 poniżej 45 pkt wynik wzrósł średnio o 6.75 pkt, a u 16 osób z T0 co najmniej 45 pkt – o 1.69 pkt.
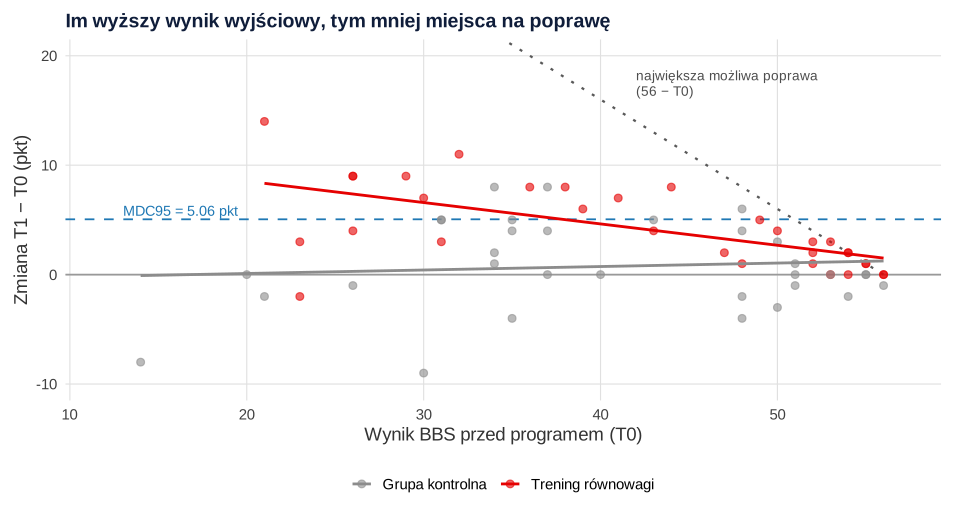
Gdy nachylenia się różnią, jedna liczba „efekt programu” nie wystarczy. Raportuj model z interakcją i podaj efekt dla kilku wyników wyjściowych. W przykładzie trening dawał przewagę 6.17 pkt przy T0 = 30, 95% CI [3.63, 8.70], p < .001, i 3.90 pkt przy T0 = 40, 95% CI [2.07, 5.72], p < .001. Przy T0 = 50 przewaga wyniosła 1.63 pkt, 95% CI [−0.66, 3.91], p = .160. Tego ostatniego wyniku nie interpretuj jako „trening nie działa u sprawniejszych”. Skala po prostu nie ma u nich miejsca, by pokazać poprawę. Jeśli planujesz badanie osób sprawnych, rozważ test z wyższym pułapem i opisz to ograniczenie w pracy. Jak to zrobić, pokazuje wpis ograniczenia badania – jak je opisać.
Krok 5. Zmiana u pojedynczej osoby
Średnia różnica między grupami nie mówi, u ilu osób zaszła zmiana większa niż błąd pomiaru. Dlatego warto policzyć odsetek osób, których wynik wzrósł co najmniej o MDC95. W przykładzie było to 11 z 32 osób w grupie treningowej (34.4%) i 3 z 32 w grupie kontrolnej (9.4%). Nie myl tego progu z MCID: MDC mówi, czy zmiana przekracza błąd narzędzia, a MCID – czy jest ważna dla pacjenta. Oba progi i wskaźnik wiarygodnej zmiany omawiamy we wpisie RCI, MDC i MCID. Downs i in. (2013) przestrzegają, że BBS może nie wykrywać umiarkowanych, klinicznie ważnych zmian u pojedynczych osób.
Punkty odcięcia i normy: ostrożnie
W pracach dyplomowych często pojawia się zdanie „wynik poniżej 45 pkt oznacza wysokie ryzyko upadku”. Karta narzędzia przypisuje próg < 45 pkt pracy Berg i in. (1992), ale późniejsze badania studzą entuzjazm. Muir i in. (2008) obserwowali przez rok 210 starszych osób. BBS dobrze różnicowała osoby z wielokrotnymi upadkami w analizie ROC, ale podział na progu ≤ 45 pkt wykrywał tylko 25% osób, które upadły choć raz, i 45% osób z wielokrotnymi upadkami. Autorzy odradzają dychotomizację i zalecają traktowanie wyniku jako ciągłego gradientu ryzyka. Lima i in. (2018) w przeglądzie systematycznym znaleźli trzy badania z progami od 45 do 51 pkt i uznali, że sama BBS nie wystarcza do oceny ryzyka upadku.
Wniosek dla pracy: analizuj wynik ogólny jako zmienną ilościową, a punkt odcięcia podawaj tylko z cytowaniem i z jego czułością i swoistością. Próg przesiewowy nie jest rozpoznaniem ani prognozą dla konkretnej osoby. Z normami wiekowymi porównuj wyniki tylko wtedy, gdy masz opublikowane źródło norm dla podobnej populacji, i podaj je w tekście. W tym wpisie celowo nie podajemy norm, bo ich nie zweryfikowaliśmy.
Wzór opisu w pracy
Poniższy fragment dopasuj do swojego badania. Liczby pochodzą z przykładu na danych symulowanych.
Jeśli analiza wyników testów funkcjonalnych sprawia Ci trudność, możemy sprawdzić Twoje obliczenia i wyjaśnić je tak, żebyś mógł lub mogła je samodzielnie obronić – zobacz analizy statystyczne dla studentów. Więcej przykładów z fizjoterapii znajdziesz we wpisie statystyka dla fizjoterapeuty.
Przykład w R
Kod generuje dane symulowane na poziomie 14 zadań (oceny 0–4), sumuje je do wyniku ogólnego i odtwarza wszystkie liczby z tekstu. ICC liczy funkcja ICC() z pakietu psych (z argumentem lmer = FALSE), ANCOVA i analizę wrażliwości – funkcje lm() i wilcox.test() z podstawowego R. Rysunki powstają w skrypcie b109-rysunki.R z pakietem ggplot2.
1. Rozkład, rzetelność i analiza przed i po
R
# Skala Równowagi Berga (BBS) – analiza wyników (dane symulowane, set.seed(10901)).
# 64 osoby w wieku 65+ mieszkające w domu, losowo przydzielone do 12-tygodniowego treningu równowagi
# (n = 32) albo do grupy kontrolnej z edukacją zdrowotną (n = 32).
# Pomiary: T0 – przed programem; T0r – powtórzenie T0 po 48 h (ta sama fizjoterapeutka); T1 – po 12 tygodniach.
# Każde z 14 zadań oceniane 0–4; wynik ogólny = suma (0–56).
suppressPackageStartupMessages(library(psych))
set.seed(10901)
n <- 64
grupa <- factor(rep(c("trening", "kontrola"), each = n / 2), levels = c("kontrola", "trening"))
theta0 <- rnorm(n, -0.9, 0.75)
progi <- t(sapply(seq(-1.9, -0.6, length.out = 14), function(b) b + c(-1.5, -0.9, -0.3, 0.6)))
u <- matrix(rnorm(n * 14, 0, 0.45), n, 14)          # stała „trudność zadania dla danej osoby”
odpowiedzi <- function(theta, szum = 0.22) {
  sapply(1:14, function(j) {
    x <- theta + u[, j] + rnorm(length(theta), 0, szum)
    rowSums(outer(x, progi[j, ], ">="))
  })
}
efekt <- ifelse(grupa == "trening", 0.45, 0.08)
theta_r <- theta0 + rnorm(n, 0, 0.10)
theta1 <- theta0 + efekt + rnorm(n, 0, 0.25)
pozT0 <- odpowiedzi(theta0); pozT0r <- odpowiedzi(theta_r); pozT1 <- odpowiedzi(theta1)
dane <- data.frame(id = 1:n, grupa = grupa, T0 = rowSums(pozT0), T0r = rowSums(pozT0r), T1 = rowSums(pozT1))
write.csv(dane, "b109-dane.csv", row.names = FALSE)

# ---- 1. Rozkład wyniku
opis <- function(x) c(M = mean(x), SD = sd(x), Me = median(x), Q1 = unname(quantile(x, .25)),
                      Q3 = unname(quantile(x, .75)), min = min(x), max = max(x),
                      skosnosc = psych::skew(x), proc_56 = 100 * mean(x == 56), proc_ge_53 = 100 * mean(x >= 53))
cat("Rozkład wyniku BBS (cała próba):\n")
print(round(rbind(T0 = opis(dane$T0), T0r = opis(dane$T0r), T1 = opis(dane$T1)), 2))
cat("\nWedług grup:\n")
for (g in levels(dane$grupa)) { d <- dane[dane$grupa == g, ]; cat(g, "\n")
  print(round(rbind(T0 = opis(d$T0), T1 = opis(d$T1)), 2)) }
cat("\nShapiro–Wilk T0: "); print(shapiro.test(dane$T0)$p.value)
cat("Najczęstsza ocena zadania na T0 (moda w zadaniach 1–14):\n")
print(apply(pozT0, 2, function(x) as.integer(names(which.max(table(x))))))
cat("Odsetek ocen 4 w zadaniach na T0:\n"); print(round(100 * colMeans(pozT0 == 4), 1))

# ---- 2. Spójność wewnętrzna (T0)
a <- psych::alpha(as.data.frame(pozT0), warnings = FALSE)
cat("\nAlfa Cronbacha T0:", round(a$total$raw_alpha, 3), "\n")

# ---- 3. Test–retest (T0 i T0r): ICC, SEM, MDC95
ic <- ICC(as.matrix(dane[, c("T0", "T0r")]), lmer = FALSE)
print(ic$results[ic$results$type %in% c("ICC2", "ICC3"), c("type", "ICC", "lower bound", "upper bound")])
s <- ic$summary[[1]]
mse <- s[3, "Mean Sq"]; var_pom <- max(0, (s[2, "Mean Sq"] - mse) / n)
sem_a <- sqrt(var_pom + mse)
icc2 <- ic$results[ic$results$type == "ICC2", "ICC"]
sd_t0 <- sd(dane$T0)
roz <- dane$T0r - dane$T0
tt <- t.test(dane$T0r, dane$T0, paired = TRUE)
print(round(c(sr_roznica = mean(roz), CI_d = tt$conf.int[1], CI_g = tt$conf.int[2], t = unname(tt$statistic), p = tt$p.value,
              SEM_zgodnosc = sem_a, SEM_z_ICC = sd_t0 * sqrt(1 - icc2), MDC95 = 1.96 * sqrt(2) * sem_a,
              SD_roznic = sd(roz)), 3))
MDC95 <- 1.96 * sqrt(2) * sem_a

# ---- 4. Przed i po: ANCOVA z pomiarem wyjściowym
m <- lm(T1 ~ T0 + grupa, data = dane)
print(summary(m)$coefficients)
cat("95% CI efektu grupy:\n"); print(confint(m)["grupatrening", ])
cat("Średnie skorygowane (T0 = średnia próby):\n")
nd <- data.frame(T0 = mean(dane$T0), grupa = factor(c("kontrola", "trening"), levels = levels(dane$grupa)))
print(cbind(nd, round(predict(m, nd, interval = "confidence"), 2)))
cat("d (różnica skorygowana / SD T0):", round(coef(m)["grupatrening"] / sd_t0, 2), "\n")
dane$zmiana <- dane$T1 - dane$T0
cat("\nZmiana T1 − T0 w grupach:\n")
print(round(do.call(rbind, lapply(split(dane$zmiana, dane$grupa), function(x)
  c(M = mean(x), SD = sd(x), Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75))))), 2))
cat("Analiza wrażliwości – test Manna–Whitneya dla zmian:\n")
w <- wilcox.test(zmiana ~ grupa, data = dane, conf.int = TRUE, exact = FALSE)
print(w)
z <- qnorm(w$p.value / 2); cat("r = Z/sqrt(N):", round(abs(z) / sqrt(n), 2), "\n")
cat("Reszty ANCOVA – Shapiro–Wilk p:", round(shapiro.test(resid(m))$p.value, 3), "\n")
cat("Interakcja T0 × grupa (homogeniczność nachyleń):\n")
print(anova(m, lm(T1 ~ T0 * grupa, data = dane)))

# ---- 4a. Nachylenia niejednorodne (efekt sufitu): efekt treningu dla wybranych wyników wyjściowych
mi <- lm(T1 ~ T0 * grupa, data = dane)
print(round(summary(mi)$coefficients, 4))
for (c0 in c(30, 40, 50)) {
  mc <- lm(T1 ~ I(T0 - c0) * grupa, data = dane)
  ci <- confint(mc)["grupatrening", ]
  pp <- summary(mc)$coefficients["grupatrening", 4]
  cat(sprintf("Efekt treningu przy T0 = %d: %.2f, 95%% CI [%.2f, %.2f], %s\n", c0, coef(mc)["grupatrening"],
              ci[1], ci[2], if (pp < .001) "p < .001" else sprintf("p = %s", sub("^0", "", sprintf("%.3f", pp)))))
}

# ---- 5. Zmiana u pojedynczej osoby względem MDC95
dane$powyzej_mdc <- dane$zmiana >= MDC95
print(table(dane$grupa, dane$powyzej_mdc))
print(round(100 * tapply(dane$powyzej_mdc, dane$grupa, mean), 1))
cat("Odsetek wyników 56 na T1 w grupach:\n")
print(round(100 * tapply(dane$T1 == 56, dane$grupa, mean), 1))
cat("Zmiana a wynik wyjściowy (korelacja w grupie treningowej):\n")
tr <- subset(dane, grupa == "trening"); print(cor.test(tr$T0, tr$zmiana))
cat("Średnia zmiana w grupie treningowej wg T0 < 45 i T0 >= 45:\n")
print(round(tapply(tr$zmiana, tr$T0 >= 45, mean), 2)); print(table(tr$T0 >= 45))
saveRDS(list(MDC95 = MDC95), "b109-mdc.rds")
Wynik w R
Rozkład wyniku BBS (cała próba):
        M    SD   Me    Q1    Q3 min max skosnosc proc_56 proc_ge_53
T0  41.25 11.59 43.0 31.75 52.00  14  56    -0.40    4.69      21.88
T0r 41.08 11.93 44.5 33.00 51.25  15  56    -0.46    6.25      23.44
T1  43.73 11.50 46.5 36.00 53.25   6  56    -1.00   10.94      31.25

Według grup:
kontrola
       M    SD   Me Q1    Q3 min max skosnosc proc_56 proc_ge_53
T0 40.38 11.36 38.5 34 50.25  14  56    -0.41    3.12      15.62
T1 41.12 12.40 43.0 36 52.00   6  55    -0.95    0.00      18.75
trening
       M    SD   Me    Q1    Q3 min max skosnosc proc_56 proc_ge_53
T0 42.12 11.93 45.5 30.75 53.00  21  56    -0.40    6.25      28.12
T1 46.34 10.06 49.0 37.75 54.25  21  56    -0.84   21.88      43.75

Shapiro–Wilk T0: [1] 0.0005648564
Najczęstsza ocena zadania na T0 (moda w zadaniach 1–14):
 [1] 4 4 4 4 4 4 4 4 4 4 3 3 3 3
Odsetek ocen 4 w zadaniach na T0:
 [1] 60.9 53.1 54.7 51.6 45.3 45.3 39.1 35.9 39.1 34.4 26.6 20.3 18.8 20.3

Alfa Cronbacha T0: 0.959
                     type       ICC lower bound upper bound
Single_random_raters ICC2 0.9762017   0.9611689   0.9854644
Single_fixed_raters  ICC3 0.9759390   0.9607005   0.9853130
  sr_roznica         CI_d         CI_g            t            p SEM_zgodnosc    SEM_z_ICC
      -0.172       -0.816        0.472       -0.533        0.596        1.824        1.787
       MDC95    SD_roznic
       5.055        2.579
              Estimate Std. Error   t value     Pr(>|t|)
(Intercept)  4.2736298 1.81778717  2.351007 2.197060e-02
T0           0.9127274 0.04178079 21.845622 1.551486e-30
grupatrening 3.6214770 0.96061760  3.769947 3.708562e-04
95% CI efektu grupy:
   2.5 %   97.5 %
1.700603 5.542351
Średnie skorygowane (T0 = średnia próby):
     T0    grupa   fit   lwr   upr
1 41.25 kontrola 41.92 40.57 43.28
2 41.25  trening 45.55 44.19 46.90
d (różnica skorygowana / SD T0): 0.31

Zmiana T1 − T0 w grupach:
            M   SD Me    Q1   Q3
kontrola 0.75 4.06  0 -1.25 4.00
trening  4.22 3.81  3  1.00 7.25
Analiza wrażliwości – test Manna–Whitneya dla zmian:

	Wilcoxon rank sum test with continuity correction

data:  zmiana by grupa
W = 275.5, p-value = 0.001457
alternative hypothesis: true location shift is not equal to 0
95 percent confidence interval:
 -4.999955 -1.000023
sample estimates:
difference in location
             -3.000014

r = Z/sqrt(N): 0.4
Reszty ANCOVA – Shapiro–Wilk p: 0.058
Interakcja T0 × grupa (homogeniczność nachyleń):
Analysis of Variance Table

Model 1: T1 ~ T0 + grupa
Model 2: T1 ~ T0 * grupa
  Res.Df    RSS Df Sum of Sq      F   Pr(>F)
1     61 895.42
2     60 787.37  1    108.06 8.2342 0.005669 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                Estimate Std. Error t value Pr(>|t|)
(Intercept)      -0.5321     2.3997 -0.2217   0.8253
T0                1.0318     0.0573 18.0122   0.0000
grupatrening     12.9750     3.3838  3.8345   0.0003
T0:grupatrening  -0.2270     0.0791 -2.8695   0.0057
Efekt treningu przy T0 = 30: 6.17, 95% CI [3.63, 8.70], p < .001
Efekt treningu przy T0 = 40: 3.90, 95% CI [2.07, 5.72], p < .001
Efekt treningu przy T0 = 50: 1.63, 95% CI [-0.66, 3.91], p = .160

           FALSE TRUE
  kontrola    29    3
  trening     21   11
kontrola  trening
     9.4     34.4
Odsetek wyników 56 na T1 w grupach:
kontrola  trening
     0.0     21.9
Zmiana a wynik wyjściowy (korelacja w grupie treningowej):

	Pearson's product-moment correlation

data:  tr$T0 and tr$zmiana
t = -4.233, df = 30, p-value = 0.0002006
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.7914378 -0.3340285
sample estimates:
       cor
-0.6114989

Średnia zmiana w grupie treningowej wg T0 < 45 i T0 >= 45:
FALSE  TRUE
 6.75  1.69

FALSE  TRUE
   16    16
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Tylko średnia i SD. Przy lewoskośnym rozkładzie dodaj medianę, IQR i odsetek wyników 56 pkt.
- Wynik 45 pkt jako diagnoza. Próg to narzędzie przesiewowe o ograniczonej czułości (Muir i in., 2008), a nie rozpoznanie.
- Zamiana wyniku na kategorie „ryzyko/brak ryzyka” przed analizą. Tracisz informację i moc; analizuj wynik ogólny.
- Osobne testy t w każdej grupie zamiast porównania między grupami. Istotna zmiana w grupie treningowej i nieistotna w kontrolnej nie dowodzą różnicy między grupami.
- Brak sprawdzenia interakcji T0 × grupa. Przy efekcie sufitu nachylenia często się różnią, a jedna skorygowana różnica zaciera obraz.
- MDC z cudzego badania bez komentarza. MDC zależy od populacji i miejsca na skali; podaj źródło albo policz własne.
- Normy z niesprawdzonych tabel. Porównuj z normami tylko wtedy, gdy możesz je zacytować.
Najczęstsze pytania
Ile punktów można uzyskać w skali Berga?
Od 0 do 56. Skala ma 14 zadań, każde oceniane od 0 do 4 pkt, a wynik ogólny to ich suma (Shirley Ryan AbilityLab, 2020). Wyższy wynik oznacza lepszą równowagę. Skala nie ma podskal ani pozycji odwróconych.
Czy wynik poniżej 45 w skali Berga oznacza ryzyko upadku?
Próg 45 pkt często się cytuje, ale nie traktuj go jak diagnozy. Muir i in. (2008) pokazali, że podział na progu ≤ 45 wykrywał tylko 25% osób, które upadły w ciągu roku, a Lima i in. (2018) uznali, że sama BBS nie wystarcza do oceny ryzyka upadku. W pracy analizuj wynik jako zmienną ilościową, a próg podawaj z cytowaniem.
O ile musi wzrosnąć wynik w skali Berga, żeby uznać poprawę?
Zmiana musi przekroczyć minimalną wykrywalną zmianę (MDC95). W przeglądzie Downsa i in. (2013) MDC95 wynosiła od 2.8 do 6.6 pkt, zależnie od miejsca na skali; w przykładzie z tego wpisu 5.06 pkt. Policz MDC na własnych danych test–retest albo podaj źródło, z którego je bierzesz.
Jak przeanalizować skalę Berga przed i po terapii z grupą kontrolną?
Użyj ANCOVA: wynik po terapii jako zmienna zależna, wynik wyjściowy jako kowariant, grupa jako czynnik. Sprawdź interakcję wynik wyjściowy × grupa, bo efekt sufitu często sprawia, że osoby z wysokim wynikiem mają mniej miejsca na poprawę. Jako analizę wrażliwości możesz porównać zmiany testem Manna–Whitneya.
Dlaczego w skali Berga występuje efekt sufitu?
Wynik ma górną granicę 56 pkt, a wiele osób sprawnych wykonuje wszystkie zadania bez trudu. Ich wyniki skupiają się przy maksimum i skala nie rozróżnia dalszej poprawy. Downs i in. (2013) oraz Blum i Korner-Bitensky (2008) opisują ten efekt, a ci drudzy radzą łączyć BBS z innymi miarami równowagi.
Powiązane hasła
Przeczytaj też
Badanie rzetelności pomiaru klinicznego
Plan badania powtarzalności, forma ICC, SEM i MDC95, wykres Blanda–Altmana, zgodność dwóch urządzeń i raport według GRRAS – z przykładem w R.
Czytaj →PoradnikBadania kliniczne i pomiar przed i po – przewodnik
Osiem etapów badania z interwencją: schemat, etyka, błąd pomiaru, liczebność, ITT, ANCOVA, RCI i MCID oraz CONSORT – z linkami do każdego etapu.
Czytaj →PoradnikStatystyka dla fizjoterapeuty
Pomiar przed i po terapii, test t i Wilcoxona, MCID dla skali NRS, ANCOVA, trzy pomiary, ICC i regresja do średniej – z danymi, kodem R i opisem APA.
Czytaj →Masz wyniki skali Berga i nie wiesz, jak je przeanalizować?
Sprawdzimy rozkład i rzetelność wyników, dobierzemy analizę przed i po oraz wyjaśnimy obliczenia tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Berg, K. O., Wood-Dauphinee, S. L., Williams, J. I., & Maki, B. (1992). Measuring balance in the elderly: Validation of an instrument. Canadian Journal of Public Health, 83(Suppl. 2), S7–S11. https://pubmed.ncbi.nlm.nih.gov/1468055/
- Berg, K., Wood-Dauphinee, S., & Williams, J. I. (1995). The Balance Scale: Reliability assessment with elderly residents and patients with an acute stroke. Scandinavian Journal of Rehabilitation Medicine, 27(1), 27–36. https://doi.org/10.2340/1650197719952736 ● Otwarty dostęp
- Blum, L., & Korner-Bitensky, N. (2008). Usefulness of the Berg Balance Scale in stroke rehabilitation: A systematic review. Physical Therapy, 88(5), 559–566. https://doi.org/10.2522/ptj.20070205
- Downs, S., Marquez, J., & Chiarelli, P. (2013). The Berg Balance Scale has high intra- and inter-rater reliability but absolute reliability varies across the scale: A systematic review. Journal of Physiotherapy, 59(2), 93–99. https://doi.org/10.1016/s1836-9553(13)70161-9 ● Otwarty dostęp
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Lima, C. A., Ricci, N. A., Nogueira, E. C., & Perracini, M. R. (2018). The Berg Balance Scale as a clinical screening tool to predict fall risk in older adults: A systematic review. Physiotherapy, 104(4), 383–394. https://doi.org/10.1016/j.physio.2018.02.002
- Muir, S. W., Berg, K., Chesworth, B., & Speechley, M. (2008). Use of the Berg Balance Scale for predicting multiple falls in community-dwelling elderly people: A prospective study. Physical Therapy, 88(4), 449–459. https://doi.org/10.2522/ptj.20070251
- Shirley Ryan AbilityLab. (2020). Berg Balance Scale. Rehabilitation Measures Database. https://www.sralab.org/rehabilitation-measures/berg-balance-scale ● Otwarty dostęp
- Stevenson, T. J. (2001). Detecting change in patients with stroke using the Berg Balance Scale. Australian Journal of Physiotherapy, 47(1), 29–38. https://doi.org/10.1016/s0004-9514(14)60296-8 ● Otwarty dostęp
- Vickers, A. J., & Altman, D. G. (2001). Analysing controlled trials with baseline and follow up measurements. BMJ, 323(7321), 1123–1124. https://doi.org/10.1136/bmj.323.7321.1123 ● Otwarty dostęp
Cytowania BibTeX
@article{berg1992measuring, author={Berg, Katherine O. and Wood-Dauphinee, Sharon L. and Williams, J. Ivan and Maki, Brian}, title={{Measuring balance in the elderly: Validation of an instrument}}, journal={Canadian Journal of Public Health}, year={1992}, volume={83}, number={Suppl. 2}, pages={S7--S11}, url={https://pubmed.ncbi.nlm.nih.gov/1468055/}}@article{berg1995balance, author={Berg, Katherine and Wood-Dauphinee, Sharon and Williams, J. Ivan}, title={{The Balance Scale: Reliability assessment with elderly residents and patients with an acute stroke}}, journal={Scandinavian Journal of Rehabilitation Medicine}, year={1995}, volume={27}, number={1}, pages={27--36}, doi={10.2340/1650197719952736}}@article{blum2008usefulness, author={Blum, Lisa and Korner-Bitensky, Nicol}, title={{Usefulness of the Berg Balance Scale in stroke rehabilitation: A systematic review}}, journal={Physical Therapy}, year={2008}, volume={88}, number={5}, pages={559--566}, doi={10.2522/ptj.20070205}}@article{downs2013berg, author={Downs, Stephen and Marquez, Jodie and Chiarelli, Pauline}, title={{The Berg Balance Scale has high intra- and inter-rater reliability but absolute reliability varies across the scale: A systematic review}}, journal={Journal of Physiotherapy}, year={2013}, volume={59}, number={2}, pages={93--99}, doi={10.1016/s1836-9553(13)70161-9}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{lima2018berg, author={Lima, Camila A. and Ricci, Natalia A. and Nogueira, Eduardo C. and Perracini, Monica R.}, title={{The Berg Balance Scale as a clinical screening tool to predict fall risk in older adults: A systematic review}}, journal={Physiotherapy}, year={2018}, volume={104}, number={4}, pages={383--394}, doi={10.1016/j.physio.2018.02.002}}@article{muir2008use, author={Muir, Susan W. and Berg, Katherine and Chesworth, Bert and Speechley, Mark}, title={{Use of the Berg Balance Scale for predicting multiple falls in community-dwelling elderly people: A prospective study}}, journal={Physical Therapy}, year={2008}, volume={88}, number={4}, pages={449--459}, doi={10.2522/ptj.20070251}}@misc{sralabbbs, author={{Shirley Ryan AbilityLab}}, title={{Berg Balance Scale}}, howpublished={Rehabilitation Measures Database}, year={2020}, publisher={Shirley Ryan AbilityLab}, url={https://www.sralab.org/rehabilitation-measures/berg-balance-scale}}@article{stevenson2001detecting, author={Stevenson, Ted J.}, title={{Detecting change in patients with stroke using the Berg Balance Scale}}, journal={Australian Journal of Physiotherapy}, year={2001}, volume={47}, number={1}, pages={29--38}, doi={10.1016/s0004-9514(14)60296-8}}@article{vickers2001analysing, author={Vickers, Andrew J. and Altman, Douglas G.}, title={{Analysing controlled trials with baseline and follow up measurements}}, journal={BMJ}, year={2001}, volume={323}, number={7321}, pages={1123--1124}, doi={10.1136/bmj.323.7321.1123}}