Pięć typowych projektów w pracy z dziennikarstwa i komunikacji społecznej
Prace dyplomowe z dziennikarstwa i komunikacji społecznej opierają się na dwóch rodzajach materiału. Pierwszym są same media: artykuły, materiały telewizyjne, nagłówki, posty i komentarze. Drugim są ludzie: odbiorcy, czytelnicy, użytkownicy mediów społecznościowych, czasem dziennikarze. W pierwszym przypadku jednostką analizy jest tekst, a dane powstają w wyniku kodowania. W drugim jednostką jest osoba, a dane pochodzą z ankiety albo eksperymentu. Najwięcej problemów sprawiają analizy łączące te dwa światy, np. gdy w jednej pracy pojawia się analiza zawartości i ankieta. Tabela porządkuje pięć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Analiza zawartości mediów | Czy dwa portale różnią się ramami, w jakich przedstawiają wydarzenia? | artykuły zakodowane według instrukcji, próba rzetelności kodowana przez dwie osoby | alfa Krippendorffa i kappa dla każdej zmiennej, chi-kwadrat z resztami | V Craméra |
| 2. Ankieta odbiorców | Czy zaufanie do mediów zależy od głównego źródła informacji? | skala Likerta, pytanie o źródło | ANOVA Welcha, test Gamesa–Howella | ω², różnice średnich z 95% CI |
| 3. Eksperyment z nagłówkiem | Czy nagłówek typu clickbait zmienia ocenę wiarygodności i chęć czytania? | losowy przydział do wersji, skala wiarygodności, odpowiedź tak/nie | test t Welcha, różnica dwóch proporcji | g Hedgesa, różnica odsetków z 95% CI |
| 4. Media społecznościowe | Czy posty z wideo dostają więcej komentarzy niż posty z linkiem? | liczby komentarzy pod postami | regresja ujemna dwumianowa | IRR z 95% CI |
| 5. Rozpoznawanie fałszywych informacji | Czy osoby spędzające więcej czasu w mediach społecznościowych gorzej rozpoznają fałszywe nagłówki? | wynik testu 0–12, czas korzystania z mediów, wiek | regresja wieloraka | R², β z 95% CI |
Wszystkie dane w przykładach są symulowane i nie opisują żadnych rzeczywistych redakcji ani portali. Możesz je pobrać jako plik XLSX (osobny arkusz dla każdego projektu i arkusz z opisem) i powtórzyć analizy w dowolnym programie. Jeśli nie wiesz jeszcze, jaki test pasuje do Twoich zmiennych, zacznij od kreatora doboru testu, a ogólny plan pracy znajdziesz w przewodniku statystyka w pracy dyplomowej. Projekty ankietowe są podobne do prac z socjologii, dlatego zajrzyj też do poradnika statystyka w pracy z socjologii, gdzie omawiamy margines błędu, ważenie i regresję logistyczną.
Zanim zaczniesz: jednostka analizy, próba i etyka
Nazwij jednostkę analizy. W analizie zawartości jednostką może być artykuł, akapit, nagłówek, wypowiedź, post albo komentarz. Od tego wyboru zależy, co liczysz: „30% artykułów zawierało ramę konfliktu” to inna informacja niż „30% akapitów”. Ustal jednostkę przed kodowaniem i trzymaj się jej w całej pracy. Gdy w jednym artykule kodujesz kilka wypowiedzi, wypowiedzi z tego samego tekstu nie są niezależne, a zwykły test chi-kwadrat przeszacuje pewność wyniku.
Opisz, jak dobrałeś(-aś) materiał. Najczęściej bierzesz wszystkie teksty z określonego okresu, które zawierają dane słowo kluczowe, albo losujesz dni z kalendarza. Oba sposoby są w porządku, jeśli je opiszesz: jakie media, jaki okres, jakie słowa kluczowe, ile tekstów odrzucono i dlaczego. Wyniki dotyczą tego zbioru tekstów, a nie „polskich mediów” w ogóle. To samo dotyczy ankiety rozesłanej w mediach społecznościowych: osoby, które ją wypełniły, nie reprezentują wszystkich odbiorców mediów.
Pomyśl o etyce danych z sieci. Publicznie dostępny post nie oznacza zgody autora na cytowanie go w pracy. Williams i in. (2017) krytykują publikowanie wpisów z Twittera bez zgody autorów tylko dlatego, że są publiczne i regulamin serwisu na to pozwala. Proponują podejście, które uwzględnia opinie samych użytkowników, kontekst wypowiedzi w sieci i ryzyko identyfikacji osób. W pracy dyplomowej analizuj posty i komentarze w formie zakodowanej, cytuj dosłownie przede wszystkim profile instytucji i redakcji, a wypowiedzi osób prywatnych parafrazuj tak, aby nie dało się ich odnaleźć w wyszukiwarce. Więcej o tym piszemy w poradniku analiza dyskursu w pracy magisterskiej, który pomoże też wtedy, gdy Twoje pytanie dotyczy raczej sposobu konstruowania znaczeń niż liczenia kategorii.
Projekt 1. Analiza zawartości: ramy informacyjne w dwóch portalach
Analiza zawartości (ilościowa analiza treści) to najbardziej typowa metoda prac z dziennikarstwa. Przykład: 240 artykułów o tym samym temacie społecznym, po 120 z dwóch portali (portal A i portal B). Dla każdego artykułu ustalasz dominującą ramę informacyjną, ton, obecność cytowanego eksperta i to, czy tekst wzywa odbiorców do działania. Kategorie ram wzięto z badania Semetko i Valkenburg (2000), które opisały pięć ram: przypisanie odpowiedzialności, konflikt, ludzki wymiar, konsekwencje ekonomiczne i moralność. W ich analizie ponad czterech tysięcy materiałów prasowych i telewizyjnych użycie ram zależało od typu medium, a media sensacyjne częściej sięgały po ramę ludzkiego wymiaru. Takie wcześniejsze badanie dobrze uzasadnia hipotezę i klucz kategorii.
Instrukcja kodowania i próba rzetelności
Zanim zaczniesz kodować wszystkie teksty, przygotuj instrukcję kodowania (książkę kodową): definicję każdej zmiennej, kategorie, przykłady i reguły dla przypadków granicznych. Następnie druga osoba (np. koleżanka z roku po krótkim szkoleniu) koduje niezależnie część materiału. W przykładzie była to losowa próba 60 artykułów (25%). Dopiero gdy zgodność jest zadowalająca, kodujesz resztę. Jeśli zgodność jest słaba, poprawiasz instrukcję i powtarzasz próbę na nowych tekstach, a nie na tych samych.
Lombard i in. (2002) przeanalizowali 200 badań z analizą zawartości i stwierdzili, że autorzy często nie oceniali zgodności kodujących albo podawali tylko odsetek zgodności, który jest zbyt liberalnym wskaźnikiem. Odsetek nie uwzględnia zgodności przypadkowej. Dlatego obok niego podaj kappę Cohena albo alfę Krippendorffa. Hayes i Krippendorff (2007) proponują alfę jako standard dla danych z kodowania, bo działa przy dowolnej liczbie kodujących, różnych poziomach pomiaru i brakach danych. Krippendorff (2004) analizuje popularne współczynniki zgodności, pokazuje, że część obiegowych przekonań o nich jest błędna, i formułuje zalecenia dotyczące testowania rzetelności w analizie treści. Minimalny poziom zgodności ustal przed kodowaniem, zapisz go w planie pracy i uzasadnij cytowaniem, a nie dopiero po zobaczeniu wyników.
| Zmienna | Poziom pomiaru | Zgodność | κ [95% CI] | α Krippendorffa [95% CI] |
|---|---|---|---|---|
| Dominująca rama | nominalny, 5 kategorii | 91.7% | .89 [.81, .98] | .90 [.80, .98] |
| Ton artykułu | porządkowy, 3 kategorie | 85.0% | .75 [.60, .90] | .84 [.71, .94] |
| Cytowany ekspert | nominalny, tak/nie | 93.3% | .85 [.71, .99] | .85 [.70, .97] |
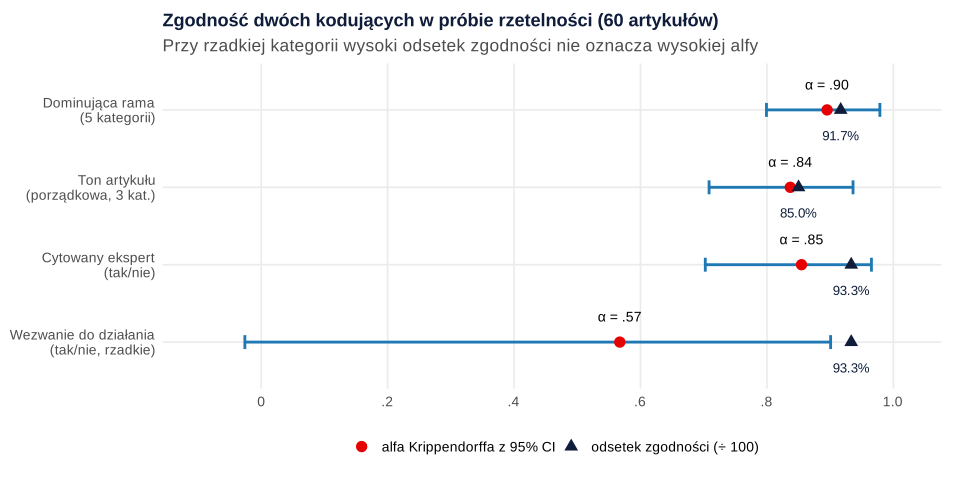
| Wezwanie do działania | nominalny, tak/nie | 93.3% | .56 [.18, .95] | .57 [−.03, .90] |
Przy tonie artykułu alfa jest liczona na poziomie porządkowym, więc pomyłka „negatywny – neutralny” waży mniej niż „negatywny – pozytywny”. Zwykła kappa traktuje obie pomyłki jednakowo, dlatego jest niższa. Przy porządkowej zmiennej możesz zamiast niej podać kappę ważoną. Przedziały ufności dla alfy wyznaczono metodą bootstrap, losując artykuły ze zwracaniem.
Dlaczego 93% zgodności może nie wystarczyć
Rysunek 1 pokazuje typowy problem. Przy zmiennej „wezwanie do działania” kodujący zgadzali się w 93.3% artykułów, tak samo jak przy cytowanym ekspercie. Alfa wynosi jednak tylko .57, a jej przedział ufności sięga od wartości ujemnych do .90. Powód jest prosty: wezwanie do działania pojawiło się rzadko (każda osoba zaznaczyła je w 5 z 60 tekstów, obie zgodnie tylko w 3). Przy tak rzadkiej kategorii zgodność wynika głównie z tego, że oba kodujące wpisują „nie”. Alfa i kappa to wychwytują. Co możesz zrobić? Doprecyzować definicję, dobrać do próby rzetelności więcej tekstów z tą kategorią albo opisać zmienną jako niepewną i nie budować na niej głównych wniosków. Paradoksy kappy przy rzadkich kategoriach omawiamy szerzej w poradniku zgodność sędziów: kappa, ICC i alfa Krippendorffa, a kappę dla dwóch kodujących szybko policzysz w kalkulatorze kappy Cohena.
Porównanie portali: chi-kwadrat i reszty
Po kodowaniu porównujesz rozkład ram w obu portalach. W portalu A najczęstsza była rama odpowiedzialności (34.2%, 41 z 120), a w portalu B rama ludzkiego wymiaru (32.5%, 39 z 120 wobec 15.0% w portalu A). Rozkład ram różnił się między portalami: test chi-kwadrat niezależności χ²(4) = 14.33, p = .006, V Craméra = .24. Najmniejsza liczebność oczekiwana wynosiła 13.0, więc warunek testu był spełniony. Sam test mówi tylko, że rozkłady się różnią. Gdzie leży różnica, pokazują reszty standaryzowane skorygowane: najwięcej wnosi rama ludzkiego wymiaru (3.19 w portalu B) i rama odpowiedzialności (2.31 w portalu A). Jak czytać reszty i co zrobić z małymi liczebnościami, opisujemy w poradniku test chi-kwadrat krok po kroku.
Ta analiza różni się od kodowania odpowiedzi na pytania otwarte w ankiecie, gdzie jednostką jest respondent, a jedna odpowiedź może mieć kilka kodów. Tamtą procedurę opisujemy w poradniku analiza treści pytań otwartych. Przy bardzo dużych zbiorach tekstów (tysiące postów) zamiast ręcznego kodowania możesz użyć metod automatycznych, opisanych w poradniku analiza tekstu w R. Wtedy też warto sprawdzić wynik algorytmu na próbie zakodowanej ręcznie.
Projekt 2. Ankieta odbiorców: zaufanie do mediów a źródło informacji
Druga duża grupa prac to badania odbiorców. Przykład: 300 osób odpowiedziało na pięć pytań o zaufanie do mediów informacyjnych (skala Likerta 1–5) i wskazało główne źródło informacji: telewizję (n = 91), portale internetowe (n = 114) albo media społecznościowe (n = 95). Rzetelność skali była dobra (alfa Cronbacha = .87), więc wynik policzono jako średnią z pozycji.
Średnie zaufanie wynosiło 3.27 (SD = 0.70) w grupie telewizji, 3.18 (SD = 0.77) w grupie portali i 2.75 (SD = 0.88) w grupie mediów społecznościowych. Grupy mają różne liczebności i różne rozproszenie, dlatego zamiast klasycznej ANOVA użyto ANOVA Welcha. Delacre i in. (2019) pokazali w symulacjach, że przy realistycznych różnicach wariancji klasyczny test F może dawać silnie obciążone wyniki, i zalecają domyślne stosowanie testu Welcha przy porównywaniu średnich. Wynik: F(2, 192.87) = 10.94, p < .001, ω² = .07, 95% CI [.03, 1.00]. Porównania par wykonano testem Gamesa–Howella: osoby korzystające głównie z mediów społecznościowych ufały mediom mniej niż widzowie telewizji (różnica 0.52 punktu, 95% CI [0.25, 0.80], p < .001) i mniej niż użytkownicy portali (0.43, 95% CI [0.16, 0.70], p < .001). Telewizja i portale nie różniły się istotnie (0.09, 95% CI [−0.15, 0.33], p = .654).
To badanie przekrojowe, a źródło informacji ludzie wybierają sami. Wynik nie znaczy więc, że media społecznościowe obniżają zaufanie. Równie dobrze osoby nieufne mogą częściej wybierać media społecznościowe, a obie zmienne mogą zależeć od wieku. W pracy pisz o związku, a nie o wpływie. Jak zbudować kwestionariusz do takiego badania, opisujemy w poradniku jak zrobić ankietę do pracy dyplomowej.
Projekt 3. Eksperyment z nagłówkiem: informacyjny czy clickbait
Eksperyment w pracy dyplomowej wcale nie musi być trudny. Wystarczy ankieta online, w której program losowo pokazuje jedną z dwóch wersji tego samego artykułu. Przykład: 196 osób zobaczyło artykuł z nagłówkiem informacyjnym albo z nagłówkiem typu clickbait (po 98 osób). Treść artykułu była identyczna. Pytanie brzmi, czy wersja nagłówka zmienia ocenę wiarygodności tekstu i chęć przeczytania go w całości. Molyneux i Coddington (2020) w dwóch eksperymentach online zauważyli, że nagłówki typu clickbait mogą obniżać postrzeganą wiarygodność i jakość tekstu. Na takie badanie możesz się powołać, stawiając hipotezę.
Losowanie i sprawdzenie manipulacji
O sile tego schematu decyduje randomizacja: dzięki losowemu przydziałowi grupy różnią się (poza przypadkiem) tylko wersją nagłówka, więc różnicę w wynikach można przypisać nagłówkowi. Najpierw sprawdź, czy manipulacja zadziałała (sprawdzenie manipulacji). Nagłówek clickbaitowy oceniano jako bardziej sensacyjny (M = 5.03, SD = 1.28) niż informacyjny (M = 3.13, SD = 1.27), t(193.99) = 10.41, p < .001. Gdyby ta różnica była mała, brak efektu na wiarygodność niewiele by znaczył, bo uczestnicy mogliby w ogóle nie dostrzec różnicy między wersjami.
Wiarygodność: test Welcha i g Hedgesa
Wiarygodność mierzono czterema pozycjami 1–7 (α = .81). Artykuł z nagłówkiem informacyjnym oceniano jako nieco bardziej wiarygodny (M = 4.72, SD = 0.99) niż z nagłówkiem clickbaitowym (M = 4.46, SD = 0.93). Różnica wyniosła 0.26 punktu, 95% CI [−0.01, 0.53], test t Welcha: t(193.03) = 1.90, p = .059, g Hedgesa = 0.27, 95% CI [−0.01, 0.55]. Wynik nie jest istotny, ale to nie dowód braku efektu. Przedział ufności obejmuje zarówno zero, jak i różnicę bliską pół punktu. Uczciwy wniosek brzmi: „kierunek zgodny z hipotezą, wynik nierozstrzygający przy tej liczebności”. Taki wynik dobrze opisać w dyskusji razem z liczbą osób, której potrzebowałoby kolejne badanie.
Chęć przeczytania całego tekstu: różnica dwóch odsetków
Na pytanie „czy chcesz przeczytać cały artykuł?” odpowiedź „tak” wybrało 42.9% osób z nagłówkiem informacyjnym (42 z 98) i 60.2% z nagłówkiem clickbaitowym (59 z 98). Różnica wyniosła 17.3 punktu procentowego, 95% CI [3.4, 30.4] (przedział Newcombe’a), χ²(1) = 5.90, p = .015. Newcombe (1998) porównał jedenaście metod przedziału ufności dla różnicy dwóch proporcji i wskazał, że prosty przedział Walda ma słabe pokrycie, a metoda łącząca przedziały Wilsona obu proporcji działa dobrze. W przykładzie widać więc ciekawy kompromis: clickbait zwiększa deklarowaną chęć czytania, a jednocześnie może nieco obniżać wiarygodność tekstu. Odsetki w dwóch grupach porównasz bez kodu w kalkulatorze tabeli 2×2, a wybór między testem chi-kwadrat, testem dla dwóch proporcji i przedziałem dla różnicy wyjaśniamy w poradniku jak porównać odsetki w dwóch grupach.
Pamiętaj, że w ankiecie mierzysz deklarowaną chęć, a nie rzeczywiste kliknięcia. Scacco i Muddiman (2020) w badaniu terenowym na stronach dziewięciu lokalnych gazet analizowali faktyczne wybory czytelników i okazało się, że internauci częściej wybierali tradycyjne nagłówki streszczające treść. Deklaracja z ankiety i zachowanie w sieci mogą więc prowadzić do innych wniosków, a w ograniczeniach pracy warto o tym napisać.
Projekt 4. Media społecznościowe: liczba komentarzy pod postami
Prace o komunikacji w mediach społecznościowych często analizują zaangażowanie: liczbę reakcji, komentarzy albo udostępnień. To są zliczenia: liczby całkowite, nieujemne, zwykle silnie prawoskośne, z kilkoma postami, które „wybuchły”. Przykład: 360 postów jednego profilu redakcji z jednego roku. Dla każdego postu zapisano format (link, zdjęcie, wideo), to, czy opublikowano go w weekend, oraz liczbę komentarzy.
Dlaczego nie test t i nie zwykła regresja
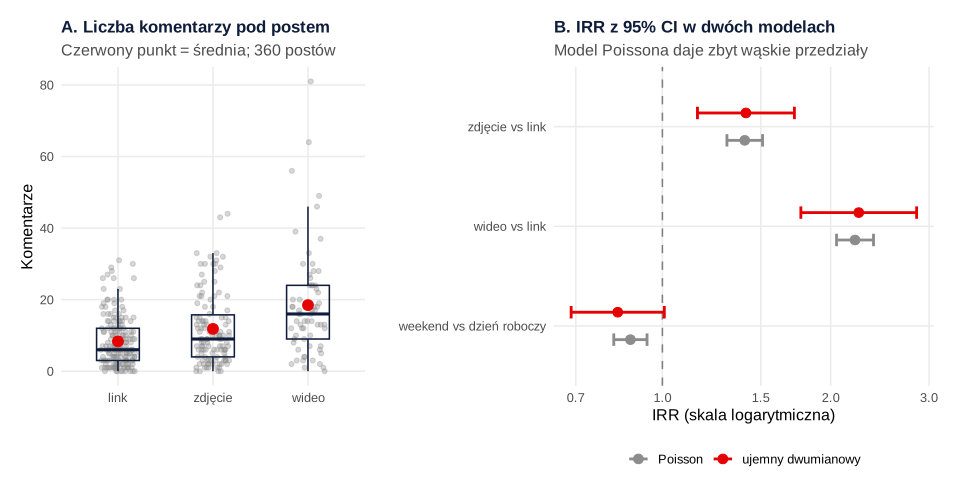
Średnia liczba komentarzy wynosiła 8.3 przy linkach, 11.8 przy zdjęciach i 18.5 przy wideo, ale wariancje były wielokrotnie większe od średnich (np. 234.5 przy wideo). Coxe i in. (2009) wyjaśniają, że przy zliczeniach o niskiej średniej zwykła regresja liniowa może dawać obciążone wyniki, a naturalnym punktem wyjścia jest regresja Poissona. Model Poissona zakłada jednak, że wariancja równa się średniej. Tutaj współczynnik rozproszenia wyniósł 7.86, czyli dane są silnie nadmiernie rozproszone. Wtedy model Poissona daje za małe błędy standardowe i za wąskie przedziały ufności (rysunek 2B). Rozwiązaniem jest regresja ujemna dwumianowa albo model quasi-Poissona. Coxe i in. (2009) opisują oba warianty jako rozwiązanie na wypadek naruszenia kluczowego założenia modelu Poissona. W przykładzie model ujemny dwumianowy dopasował się znacznie lepiej (AIC 2446.4 wobec 4005.0).
Interpretacja: iloraz częstości (IRR)
Współczynniki modelu dla zliczeń po potęgowaniu (exp) dają iloraz częstości (ang. incidence rate ratio, IRR). Posty z wideo miały średnio 2.25 razy więcej komentarzy niż posty z linkiem, 95% CI [1.77, 2.85], p < .001, a posty ze zdjęciem 1.41 razy więcej, 95% CI [1.16, 1.72], p < .001. Format jako całość: test ilorazu wiarygodności χ²(2) = 45.26, p < .001. Najciekawszy jest jednak weekend. W modelu Poissona posty weekendowe miały istotnie mniej komentarzy (IRR = 0.88, 95% CI [0.82, 0.94], p < .001), a w modelu ujemnym dwumianowym ten sam efekt jest niepewny (IRR = 0.83, 95% CI [0.69, 1.01], p = .060). Zignorowanie nadmiernego rozproszenia dałoby więc „odkrycie”, którego dane nie uzasadniają. Pełną procedurę z diagnostyką omawiamy w poradniku regresja dla zliczeń krok po kroku.
Dwie uwagi praktyczne. Po pierwsze, gdy porównujesz profile o różnej liczbie obserwujących albo posty o różnym zasięgu, uwzględnij to w modelu (offset w regresji Poissona), bo inaczej porównujesz wielkość profili, a nie skuteczność postów. Po drugie, posty z tego samego profilu i tego samego tygodnia nie są w pełni niezależne: reagują na te same wydarzenia i ten sam algorytm platformy. Przy kilku profilach rozważ model wielopoziomowy albo błędy standardowe odporne na skupienia, a w ograniczeniach pracy napisz, że dane pochodzą z jednego profilu i jednego okresu.
Projekt 5. Rozpoznawanie fałszywych nagłówków
Kompetencje medialne to częsty temat prac licencjackich. Przykład: 250 osób oceniło 12 nagłówków (połowa prawdziwych, połowa fałszywych), a wynikiem jest liczba trafnych ocen (0–12). Pytanie brzmi, czy wynik zależy od czasu spędzanego w mediach społecznościowych, gdy uwzględni się codzienne czytanie serwisu informacyjnego i wiek. Średni wynik wynosił 6.89 (SD = 1.97), a respondenci spędzali w mediach społecznościowych średnio 2.63 godziny dziennie (SD = 1.82).
W regresji wielorakiej model wyjaśnił 14% wariancji wyniku, F(3, 246) = 12.93, p < .001, R² = .14 (skorygowany R² = .13). Każda dodatkowa godzina w mediach społecznościowych wiązała się z wynikiem niższym średnio o 0.26 punktu, b = −0.26, 95% CI [−0.39, −0.14], β = −.24, p < .001. Osoby codziennie czytające serwis informacyjny miały wynik wyższy o 1.00 punkt, b = 1.00, 95% CI [0.53, 1.47], p < .001. Wiek nie miał istotnego związku z wynikiem, b = 0.01, 95% CI [−0.002, 0.03], p = .094. Przy zmiennej zero-jedynkowej (czytanie serwisu) interpretuj przede wszystkim b, czyli różnicę w punktach, a nie standaryzowane β.
Dwie ostrożności. Wynik testu jest ograniczony do przedziału 0–12, więc gdy wiele osób uzyskuje wynik maksymalny, regresja liniowa przestaje dobrze pasować i lepszy bywa model dla liczby sukcesów na 12 prób (regresja logistyczna dwumianowa). Poza tym to znowu badanie przekrojowe: czas spędzany w mediach społecznościowych może być skutkiem, a nie przyczyną słabszych kompetencji.
Jak opisać analizę statystyczną w pracy
W pracy z analizą zawartości rozdział metodologiczny musi pozwolić innej osobie powtórzyć kodowanie. Opisz więc: jakie media i jaki okres objęto badaniem, jak wybrano teksty, co było jednostką analizy, jakie zmienne kodowano (pełna instrukcja kodowania w aneksie), kto kodował, jak duża była próba rzetelności i jak ją wybrano, jakie miary zgodności policzono i co zrobiono z rozbieżnościami. W pracy z ankietą albo eksperymentem dodaj sposób rekrutacji, losowanie wersji i liczbę osób wykluczonych. Poniżej wzór akapitu o analizie statystycznej dla projektów 1 i 3. Gotowe zdania z wynikami innych testów wygenerujesz w generatorze opisu wyników APA.
Jeśli potrzebujesz pomocy w doborze analiz do swojego projektu albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z pięciu projektów w R
Kod odtwarza wszystkie liczby z tego wpisu, a ostatni przepis – rysunki i plik XLSX do pobrania. Każdy z przepisów 1–3 tworzy własne dane symulowane, więc możesz go uruchomić osobno. Najważniejszy jest przepis 1 z pełną analizą zawartości: od zgodności kodujących do porównania portali. Alfę Krippendorffa i kappę liczy pakiet DescTools, wielkości efektu – pakiet effectsize, a model ujemny dwumianowy – pakiet MASS.
1. Projekt 1: analiza zawartości – zgodność kodujących (kappa, alfa Krippendorffa z bootstrapem) i chi-kwadrat z resztami
R
# Projekt 1: analiza zawartości mediów – zgodność kodujących i porównanie portali (dane symulowane).
# 240 artykułów z dwóch portali (120 + 120). Dwie osoby kodują niezależnie próbę rzetelności
# (60 artykułów, 25%); resztę koduje jedna osoba według tej samej instrukcji kodowania.
# Zmienne: dominująca rama (5 kategorii), ton (negatywny < neutralny < pozytywny),
# cytowany ekspert (tak/nie), wezwanie do działania (tak/nie – kategoria rzadka).
suppressPackageStartupMessages({ library(DescTools); library(effectsize) })
set.seed(22201)
ramy <- c("odpowiedzialność", "konflikt", "ludzki wymiar", "ekonomiczna", "moralność")
N <- 240
portal <- factor(rep(c("portal A", "portal B"), each = N / 2))
pr_A <- c(.32, .28, .14, .18, .08); pr_B <- c(.18, .24, .36, .10, .12)
rama <- ifelse(portal == "portal A", sample(ramy, N, TRUE, pr_A), sample(ramy, N, TRUE, pr_B))
rama <- factor(rama, levels = ramy)
ton <- sample(1:3, N, TRUE, prob = c(.45, .40, .15))           # 1 = negatywny, 2 = neutralny, 3 = pozytywny
ekspert <- rbinom(N, 1, ifelse(portal == "portal A", .55, .35))
apel <- rbinom(N, 1, .05)
art <- data.frame(id = 1:N, portal, rama, ton, ekspert, apel)

# --- Próba rzetelności: 60 losowo wybranych artykułów kodowanych przez dwie osoby
proba <- sort(sample(N, 60))
pomyl <- function(x, p, wartosci) ifelse(runif(length(x)) < p, sapply(x, function(v) sample(setdiff(wartosci, v), 1)), x)
k1 <- data.frame(rama = as.character(art$rama[proba]), ton = art$ton[proba], ekspert = art$ekspert[proba], apel = art$apel[proba])
k2 <- k1
k1$rama <- pomyl(k1$rama, .08, ramy); k2$rama <- pomyl(k2$rama, .12, ramy)
k1$ton <- pmin(3, pmax(1, k1$ton + sample(c(-1, 0, 1), 60, TRUE, c(.08, .84, .08))))
k2$ton <- pmin(3, pmax(1, k2$ton + sample(c(-1, 0, 1), 60, TRUE, c(.10, .80, .10))))
k1$ekspert <- pomyl(k1$ekspert, .04, 0:1); k2$ekspert <- pomyl(k2$ekspert, .06, 0:1)
k1$apel <- pomyl(k1$apel, .03, 0:1); k2$apel <- pomyl(k2$apel, .04, 0:1)

# Zgodność dla każdej zmiennej: odsetek zgodności, kappa Cohena, alfa Krippendorffa z 95% CI (bootstrap jednostek)
zgodnosc <- function(a, b, poziom) {
  num <- function(v) as.numeric(factor(v, levels = sort(unique(c(a, b)))))
  m <- rbind(num(a), num(b))
  alfa <- KrippAlpha(m, method = poziom)$value
  boot <- replicate(2000, { i <- sample(ncol(m), replace = TRUE); KrippAlpha(m[, i], method = poziom)$value })
  kap <- CohenKappa(factor(a, levels = sort(unique(c(a, b)))), factor(b, levels = sort(unique(c(a, b)))), conf.level = .95)
  c(zgodnosc_proc = 100 * mean(a == b), kappa = unname(kap[1]), kappa_lo = unname(kap[2]), kappa_hi = unname(kap[3]),
    alfa = alfa, alfa_lo = unname(quantile(boot, .025, na.rm = TRUE)), alfa_hi = unname(quantile(boot, .975, na.rm = TRUE)))
}
set.seed(22211)
rzet <- rbind(rama = zgodnosc(k1$rama, k2$rama, "nominal"), ton = zgodnosc(k1$ton, k2$ton, "ordinal"),
              ekspert = zgodnosc(k1$ekspert, k2$ekspert, "nominal"), apel = zgodnosc(k1$apel, k2$apel, "nominal"))
round(rzet, 3)
# Jak rzadka jest kategoria „wezwanie do działania” w próbie rzetelności?
c(kodujacy1 = sum(k1$apel), kodujacy2 = sum(k2$apel), oba_tak = sum(k1$apel == 1 & k2$apel == 1))

# --- Analiza główna: dominująca rama a portal (240 artykułów)
tab <- table(art$portal, art$rama); tab
round(100 * prop.table(tab, 1), 1)
ch <- chisq.test(tab); ch
round(min(ch$expected), 1)
round(ch$stdres, 2)
cramers_v(tab, adjust = FALSE)
Wynik w R
        zgodnosc_proc kappa kappa_lo kappa_hi  alfa alfa_lo alfa_hi
rama           91.667 0.894    0.806    0.983 0.895   0.799   0.979
ton            85.000 0.750    0.600    0.900 0.837   0.708   0.936
ekspert        93.333 0.853    0.715    0.992 0.855   0.703   0.965
apel           93.333 0.564    0.181    0.946 0.567  -0.026   0.901
kodujacy1 kodujacy2   oba_tak
        5         5         3

           odpowiedzialność konflikt ludzki wymiar ekonomiczna moralność
  portal A               41       33            18          18        10
  portal B               25       26            39          14        16

           odpowiedzialność konflikt ludzki wymiar ekonomiczna moralność
  portal A             34.2     27.5          15.0        15.0       8.3
  portal B             20.8     21.7          32.5        11.7      13.3

	Pearson's Chi-squared test

data:  tab
X-squared = 14.331, df = 4, p-value = 0.006311

[1] 13

           odpowiedzialność konflikt ludzki wymiar ekonomiczna moralność
  portal A             2.31     1.05         -3.19        0.76     -1.25
  portal B            -2.31    -1.05          3.19       -0.76      1.25
Cramer's V |       95% CI
-------------------------
0.24       | [0.10, 1.00]

- One-sided CIs: upper bound fixed at [1.00].
2. Projekty 2 i 3: ANOVA Welcha z testem Gamesa–Howella oraz eksperyment z nagłówkiem
R
# Projekt 2: ankieta odbiorców – zaufanie do mediów informacyjnych a główne źródło informacji;
# projekt 3: eksperyment z nagłówkiem (informacyjny a clickbaitowy) – dane symulowane.
suppressPackageStartupMessages({ library(effectsize); library(psych); library(rstatix) })

# --- Projekt 2: 300 respondentów, skala zaufania (5 pozycji 1–5), główne źródło informacji
set.seed(22202)
n <- 300
zrodlo <- factor(sample(c("telewizja", "portale internetowe", "media społecznościowe"), n, TRUE, prob = c(.30, .40, .30)),
                 levels = c("telewizja", "portale internetowe", "media społecznościowe"))
lat <- rnorm(n, c(0.25, 0.10, -0.35)[as.integer(zrodlo)], c(0.8, 0.9, 1.15)[as.integer(zrodlo)])
poz <- sapply(1:5, function(j) as.integer(cut(0.8 * lat + rnorm(n, 0, 0.6), c(-Inf, -1.6, -0.5, 0.5, 1.5, Inf))))
colnames(poz) <- paste0("zauf", 1:5)
p2 <- data.frame(id = 1:n, zrodlo, poz)
p2$zaufanie <- rowMeans(poz)
round(psych::alpha(poz, warnings = FALSE)$total[c("raw_alpha", "std.alpha")], 2)
aggregate(zaufanie ~ zrodlo, p2, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
oneway.test(zaufanie ~ zrodlo, data = p2, var.equal = FALSE)          # ANOVA Welcha
omega_squared(aov(zaufanie ~ zrodlo, data = p2), partial = FALSE)
games_howell_test(p2, zaufanie ~ zrodlo)[, c("group1", "group2", "estimate", "conf.low", "conf.high", "p.adj")]

# --- Projekt 3: eksperyment z nagłówkiem, losowy przydział do wersji (ankieta online)
set.seed(22203)
n3 <- 196
wersja <- factor(sample(rep(c("informacyjny", "clickbaitowy"), n3 / 2)), levels = c("informacyjny", "clickbaitowy"))
# sprawdzenie manipulacji: „nagłówek jest sensacyjny” (1–7)
sens <- pmin(7, pmax(1, round(rnorm(n3, ifelse(wersja == "clickbaitowy", 5.1, 3.2), 1.3))))
# wiarygodność artykułu: średnia 4 pozycji 1–7
osoba <- rnorm(n3, ifelse(wersja == "clickbaitowy", -0.35, 0), 1)   # ogólna ocena wiarygodności u danej osoby
wiar <- sapply(1:4, function(j) pmin(7, pmax(1, round(4.7 + 0.9 * osoba + rnorm(n3, 0, 0.8)))))
klik <- rbinom(n3, 1, ifelse(wersja == "clickbaitowy", .58, .44))   # „chcę przeczytać cały artykuł” (tak = 1)
p3 <- data.frame(id = 1:n3, wersja, sens, wiar1 = wiar[, 1], wiar2 = wiar[, 2], wiar3 = wiar[, 3], wiar4 = wiar[, 4], klik)
p3$wiarygodnosc <- rowMeans(wiar)
table(p3$wersja)
round(psych::alpha(wiar, warnings = FALSE)$total["raw_alpha"], 2)
aggregate(cbind(sens, wiarygodnosc) ~ wersja, p3, function(x) round(c(M = mean(x), SD = sd(x)), 2))
t.test(sens ~ wersja, data = p3)                                    # sprawdzenie manipulacji
t.test(wiarygodnosc ~ wersja, data = p3)                            # test Welcha
hedges_g(wiarygodnosc ~ wersja, data = p3, pooled_sd = FALSE)
# Chęć przeczytania całego artykułu: odsetki, różnica z 95% CI Newcombe'a (metoda hybrydowa Wilsona)
k <- tapply(p3$klik, p3$wersja, sum); m <- tapply(p3$klik, p3$wersja, length)
wilson <- function(k, n) { z <- qnorm(.975); p <- k / n
  (p + z^2 / (2 * n) + c(-1, 1) * z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))) / (1 + z^2 / n) }
p_kl <- k["clickbaitowy"] / m["clickbaitowy"]; p_in <- k["informacyjny"] / m["informacyjny"]
w_kl <- wilson(k["clickbaitowy"], m["clickbaitowy"]); w_in <- wilson(k["informacyjny"], m["informacyjny"])
roz <- p_kl - p_in
ci_newcombe <- c(roz - sqrt((p_kl - w_kl[1])^2 + (w_in[2] - p_in)^2), roz + sqrt((w_kl[2] - p_kl)^2 + (p_in - w_in[1])^2))
round(100 * c(informacyjny = unname(p_in), clickbaitowy = unname(p_kl), roznica = unname(roz), lo = unname(ci_newcombe[1]), hi = unname(ci_newcombe[2])), 1)
chisq.test(table(p3$wersja, p3$klik), correct = FALSE)
Wynik w R
 raw_alpha std.alpha
      0.87      0.87
                 zrodlo zaufanie.n zaufanie.M zaufanie.SD
1             telewizja      91.00       3.27        0.70
2   portale internetowe     114.00       3.18        0.77
3 media społecznościowe      95.00       2.75        0.88

	One-way analysis of means (not assuming equal variances)

data:  zaufanie and zrodlo
F = 10.935, num df = 2.00, denom df = 192.87, p-value = 3.172e-05

# Effect Size for ANOVA (Type I)

Parameter | Omega2 |       95% CI
---------------------------------
zrodlo    |   0.07 | [0.03, 1.00]

- One-sided CIs: upper bound fixed at [1.00].# A tibble: 3 × 6
  group1              group2                estimate conf.low conf.high     p.adj
  <chr>               <chr>                    <dbl>    <dbl>     <dbl>     <dbl>
1 telewizja           portale internetowe    -0.0905   -0.333     0.152 0.654
2 telewizja           media społecznościowe  -0.523    -0.798    -0.248 0.0000365
3 portale internetowe media społecznościowe  -0.433    -0.704    -0.161 0.000658

informacyjny clickbaitowy
          98           98
 raw_alpha
      0.81
        wersja sens.M sens.SD wiarygodnosc.M wiarygodnosc.SD
1 informacyjny   3.13    1.27           4.72            0.99
2 clickbaitowy   5.03    1.28           4.46            0.93

	Welch Two Sample t-test

data:  sens by wersja
t = -10.407, df = 193.99, p-value < 2.2e-16
alternative hypothesis: true difference in means between group informacyjny and group clickbaitowy is not equal to 0
95 percent confidence interval:
 -2.257656 -1.538262
sample estimates:
mean in group informacyjny mean in group clickbaitowy
                  3.132653                   5.030612


	Welch Two Sample t-test

data:  wiarygodnosc by wersja
t = 1.8965, df = 193.03, p-value = 0.05938
alternative hypothesis: true difference in means between group informacyjny and group clickbaitowy is not equal to 0
95 percent confidence interval:
 -0.01039714  0.53080531
sample estimates:
mean in group informacyjny mean in group clickbaitowy
                  4.724490                   4.464286

Hedges' g |        95% CI
-------------------------
0.27      | [-0.01, 0.55]

- Estimated using un-pooled SD.informacyjny clickbaitowy      roznica           lo           hi
        42.9         60.2         17.3          3.4         30.4

	Pearson's Chi-squared test

data:  table(p3$wersja, p3$klik)
X-squared = 5.9035, df = 1, p-value = 0.01511
3. Projekty 4 i 5: regresja dla zliczeń komentarzy i regresja wieloraka
R
# Projekt 4: liczba komentarzy pod postami redakcji w mediach społecznościowych (zliczenia);
# projekt 5: rozpoznawanie fałszywych nagłówków a korzystanie z mediów (regresja) – dane symulowane.
suppressPackageStartupMessages({ library(MASS); library(effectsize) })

# --- Projekt 4: 360 postów jednego profilu redakcji z jednego roku
set.seed(22204)
n <- 360
format <- factor(sample(c("link", "zdjęcie", "wideo"), n, TRUE, prob = c(.50, .30, .20)), levels = c("link", "zdjęcie", "wideo"))
weekend <- rbinom(n, 1, 2 / 7)
mu <- exp(log(9) + c(0, 0.35, 0.70)[as.integer(format)] - 0.20 * weekend)
komentarze <- rnbinom(n, mu = mu, size = 1.3)
p4 <- data.frame(id = 1:n, format, weekend, komentarze)
aggregate(komentarze ~ format, p4, function(x) round(c(n = length(x), M = mean(x), Var = var(x), Me = median(x), zero = mean(x == 0) * 100), 1))
m_pois <- glm(komentarze ~ format + weekend, family = poisson, data = p4)
round(sum(residuals(m_pois, type = "pearson")^2) / df.residual(m_pois), 2)   # współczynnik rozproszenia
m_nb <- glm.nb(komentarze ~ format + weekend, data = p4)
round(c(theta = m_nb$theta, AIC_Poisson = AIC(m_pois), AIC_NB = AIC(m_nb)), 2)
irr <- function(m) { b <- coef(m)[-1]; se <- sqrt(diag(vcov(m)))[-1]
  round(cbind(IRR = exp(b), lo = exp(b - 1.96 * se), hi = exp(b + 1.96 * se), p = 2 * pnorm(-abs(b / se))), 4) }
irr(m_pois)
irr(m_nb)
# Test ilorazu wiarygodności dla formatu w modelu ujemnym dwumianowym
anova(glm.nb(komentarze ~ weekend, data = p4), m_nb)

# --- Projekt 5: test rozpoznawania 12 nagłówków (prawdziwe/fałszywe), 250 respondentów
set.seed(22205)
n5 <- 250
wiek <- round(runif(n5, 18, 70))
godz_sm <- round(pmax(0, rgamma(n5, shape = 2.2, rate = 0.9)), 1)        # godziny dziennie w mediach społecznościowych
prasa <- rbinom(n5, 1, plogis(-1.2 + 0.03 * (wiek - 18)))               # czyta serwis informacyjny codziennie (1 = tak)
wynik <- pmin(12, pmax(0, round(7.4 - 0.30 * godz_sm + 0.9 * prasa + 0.01 * (wiek - 40) + rnorm(n5, 0, 1.8))))
p5 <- data.frame(id = 1:n5, wiek, godz_sm, prasa, wynik)
round(sapply(p5[, -1], function(x) c(M = mean(x), SD = sd(x))), 2)
m5 <- lm(wynik ~ godz_sm + prasa + wiek, data = p5)
summary(m5)
round(confint(m5), 3)
standardize_parameters(m5)
Wynik w R
   format komentarze.n komentarze.M komentarze.Var komentarze.Me komentarze.zero
1    link        177.0          8.3           48.4           6.0             5.1
2 zdjęcie        118.0         11.8           97.8           9.0             3.4
3   wideo         65.0         18.5          234.5          16.0             1.5
[1] 7.86
      theta AIC_Poisson      AIC_NB
       1.58     4005.02     2446.37
                 IRR     lo     hi     p
formatzdjęcie 1.4039 1.3046 1.5107 0e+00
formatwideo   2.2112 2.0490 2.3862 0e+00
weekend       0.8766 0.8185 0.9387 2e-04
                 IRR     lo     hi      p
formatzdjęcie 1.4108 1.1554 1.7226 0.0007
formatwideo   2.2454 1.7690 2.8501 0.0000
weekend       0.8320 0.6867 1.0080 0.0603
Likelihood ratio tests of Negative Binomial Models

Response: komentarze
             Model    theta Resid. df    2 x log-lik.   Test    df LR stat.     Pr(Chi)
1          weekend 1.373861       358       -2481.625
2 format + weekend 1.583077       356       -2436.365 1 vs 2     2  45.2599 1.48572e-10
    wiek godz_sm prasa wynik
M  42.70    2.63  0.41  6.89
SD 15.23    1.82  0.49  1.97

Call:
lm(formula = wynik ~ godz_sm + prasa + wiek, data = p5)

Residuals:
    Min      1Q  Median      3Q     Max
-5.2370 -1.0870  0.1642  1.1977  5.6413

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept)  6.610486   0.383306  17.246  < 2e-16 ***
godz_sm     -0.261532   0.064370  -4.063 6.52e-05 ***
prasa        0.996591   0.238607   4.177 4.11e-05 ***
wiek         0.012995   0.007738   1.679   0.0943 .
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 1.843 on 246 degrees of freedom
Multiple R-squared:  0.1362,	Adjusted R-squared:  0.1256
F-statistic: 12.93 on 3 and 246 DF,  p-value: 7.193e-08

             2.5 % 97.5 %
(Intercept)  5.856  7.365
godz_sm     -0.388 -0.135
prasa        0.527  1.467
wiek        -0.002  0.028
# Standardization method: refit

Parameter   | Std. Coef. |         95% CI
-----------------------------------------
(Intercept) |   3.90e-16 | [-0.12,  0.12]
godz sm     |      -0.24 | [-0.36, -0.12]
prasa       |       0.25 | [ 0.13,  0.37]
wiek        |       0.10 | [-0.02,  0.22]
4. Rysunki i plik XLSX
R
# Rysunki i plik XLSX do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b222-rysunki.R > b222-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(svglite); library(patchwork); library(openxlsx) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", dane = "grey55", neutralny = "#8C8C8C", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 13) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05)),
          plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
          strip.text = element_text(face = "bold", colour = KOLORY[["granat"]]), legend.position = "bottom",
          plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100), round(file.info(plik)$size / 1024)))
}
minus <- function(x) gsub("-", "−", x)
pdf(NULL)
invisible(capture.output({ for (f in c("b222-1-analiza-zawartosci.R", "b222-2-ankieta-eksperyment.R", "b222-3-media-spolecznosciowe.R")) source(f) }))

# Rysunek 1: zgodność kodujących – odsetek zgodności a alfa Krippendorffa z 95% CI
nazwy <- c(rama = "Dominująca rama\n(5 kategorii)", ton = "Ton artykułu\n(porządkowa, 3 kat.)",
           ekspert = "Cytowany ekspert\n(tak/nie)", apel = "Wezwanie do działania\n(tak/nie, rzadkie)")
d1 <- data.frame(zmienna = factor(nazwy[rownames(rzet)], levels = rev(nazwy)), rzet[, c("zgodnosc_proc", "alfa", "alfa_lo", "alfa_hi")])
print(d1, digits = 3, row.names = FALSE)
r1 <- ggplot(d1, aes(y = zmienna)) +
  geom_errorbar(aes(xmin = alfa_lo, xmax = alfa_hi), width = .18, orientation = "y", colour = KOLORY[["drugi"]], linewidth = 1) +
  geom_point(aes(x = alfa, shape = "alfa Krippendorffa z 95% CI"), colour = KOLORY[["akcent"]], size = 3.6) +
  geom_point(aes(x = zgodnosc_proc / 100, shape = "odsetek zgodności (÷ 100)"), colour = KOLORY[["granat"]], size = 3.2) +
  geom_text(aes(x = alfa, label = minus(sprintf("α = %s", sub("^(-?)0\\.", "\\1.", sprintf("%.2f", alfa))))), nudge_y = .33, size = 3.7) +
  geom_text(aes(x = zgodnosc_proc / 100, label = sprintf("%.1f%%", zgodnosc_proc)), nudge_y = -.33, size = 3.5, colour = KOLORY[["granat"]]) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(limits = c(-.1, 1.02), breaks = seq(0, 1, .2), labels = function(x) ifelse(x == 0, "0", sub("^0\\.", ".", sprintf("%.1f", x)))) +
  labs(title = "Zgodność dwóch kodujących w próbie rzetelności (60 artykułów)",
       subtitle = "Przy rzadkiej kategorii wysoki odsetek zgodności nie oznacza wysokiej alfy", x = NULL, y = NULL) +
  theme_metodolog(13)
zapisz_svg(r1, "../statystyka-dziennikarstwo-zgodnosc-kodujacych.svg", szer = 10, wys = 5)

# Rysunek 2: komentarze pod postami – rozkład i IRR z modelu Poissona i ujemnego dwumianowego
rA <- ggplot(p4, aes(format, komentarze)) +
  geom_jitter(width = .18, height = 0, alpha = .35, colour = KOLORY[["dane"]], size = 1.4) +
  geom_boxplot(width = .45, outlier.shape = NA, fill = NA, colour = KOLORY[["granat"]]) +
  stat_summary(fun = mean, geom = "point", colour = KOLORY[["akcent"]], size = 3.4) +
  labs(title = "A. Liczba komentarzy pod postem", subtitle = "Czerwony punkt = średnia; 360 postów", x = NULL, y = "Komentarze") +
  theme_metodolog(12)
ir <- rbind(data.frame(model = "Poisson", efekt = rownames(irr(m_pois)), irr(m_pois)),
            data.frame(model = "ujemny dwumianowy", efekt = rownames(irr(m_nb)), irr(m_nb)))
ir$efekt <- factor(c(formatzdjęcie = "zdjęcie vs link", formatwideo = "wideo vs link", weekend = "weekend vs dzień roboczy")[ir$efekt],
                   levels = rev(c("zdjęcie vs link", "wideo vs link", "weekend vs dzień roboczy")))
print(ir, row.names = FALSE)
rB <- ggplot(ir, aes(IRR, efekt, colour = model)) + geom_vline(xintercept = 1, linetype = 2, colour = "grey50") +
  geom_errorbar(aes(xmin = lo, xmax = hi), width = .25, orientation = "y", linewidth = 1, position = position_dodge(width = .55)) +
  geom_point(size = 3, position = position_dodge(width = .55)) +
  scale_colour_manual(values = c(Poisson = KOLORY[["neutralny"]], `ujemny dwumianowy` = KOLORY[["akcent"]]), name = NULL) +
  scale_x_log10(breaks = c(.7, 1, 1.5, 2, 3)) +
  labs(title = "B. IRR z 95% CI w dwóch modelach", subtitle = "Model Poissona daje zbyt wąskie przedziały", x = "IRR (skala logarytmiczna)", y = NULL) +
  theme_metodolog(12)
zapisz_svg(rA + rB + plot_layout(widths = c(1, 1.25)), "../statystyka-dziennikarstwo-komentarze-zliczenia.svg", szer = 10, wys = 5.2)

# Plik XLSX z danymi do pobrania
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z dziennikarstwa – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
p1_rzet <- data.frame(id = proba, setNames(k1, paste0(names(k1), "_k1")), setNames(k2, paste0(names(k2), "_k2")))
opis <- data.frame(arkusz = c("P1_artykuly", "P1_proba_rzetelnosci", "P2_ankieta_zaufanie", "P3_eksperyment_naglowek", "P4_posty", "P5_falszywe_naglowki"),
  zawartosc = c("240 artykułów z dwóch portali: dominująca rama, ton (1 = negatywny, 2 = neutralny, 3 = pozytywny), ekspert, wezwanie do działania (1 = tak)",
                "60 artykułów zakodowanych niezależnie przez dwie osoby (_k1, _k2)",
                "300 respondentów: główne źródło informacji, 5 pozycji zaufania 1–5 i wynik (średnia)",
                "196 uczestników: wersja nagłówka, sprawdzenie manipulacji (1–7), 4 pozycje wiarygodności 1–7, chęć przeczytania (1 = tak)",
                "360 postów: format, weekend (1 = tak), liczba komentarzy",
                "250 respondentów: wiek, godziny dziennie w mediach społecznościowych, codzienne czytanie serwisu informacyjnego, wynik testu 0–12"),
  uwaga = "Dane symulowane do nauki analizy; nie pochodzą z prawdziwego badania.")
for (ark in list(list("Opis", opis), list("P1_artykuly", art), list("P1_proba_rzetelnosci", p1_rzet), list("P2_ankieta_zaufanie", p2),
                 list("P3_eksperyment_naglowek", p3), list("P4_posty", p4), list("P5_falszywe_naglowki", p5))) {
  addWorksheet(wb, ark[[1]]); writeData(wb, ark[[1]], ark[[2]]); setColWidths(wb, ark[[1]], 1:ncol(ark[[2]]), "auto") }
plik <- "../statystyka-dziennikarstwo-dane-przyklad.xlsx"
saveWorkbook(wb, plik, overwrite = TRUE)
sapply(getSheetNames(plik), function(s) nrow(read.xlsx(plik, s)))
cat("rozmiar KB:", round(file.info(plik)$size / 1024), "\n")
Wynik w R
                                   zmienna zgodnosc_proc  alfa alfa_lo alfa_hi
            Dominująca rama\n(5 kategorii)          91.7 0.895  0.7992   0.979
        Ton artykułu\n(porządkowa, 3 kat.)          85.0 0.837  0.7085   0.936
               Cytowany ekspert\n(tak/nie)          93.3 0.855  0.7025   0.965
 Wezwanie do działania\n(tak/nie, rzadkie)          93.3 0.567 -0.0259   0.901
Zapisano ../statystyka-dziennikarstwo-zgodnosc-kodujacych.svg: w HTML width="1000" height="500" (10 KB)
             model                    efekt    IRR     lo     hi      p
           Poisson          zdjęcie vs link 1.4039 1.3046 1.5107 0.0000
           Poisson            wideo vs link 2.2112 2.0490 2.3862 0.0000
           Poisson weekend vs dzień roboczy 0.8766 0.8185 0.9387 0.0002
 ujemny dwumianowy          zdjęcie vs link 1.4108 1.1554 1.7226 0.0007
 ujemny dwumianowy            wideo vs link 2.2454 1.7690 2.8501 0.0000
 ujemny dwumianowy weekend vs dzień roboczy 0.8320 0.6867 1.0080 0.0603
Zapisano ../statystyka-dziennikarstwo-komentarze-zliczenia.svg: w HTML width="1000" height="520" (65 KB)
                   Opis             P1_artykuly    P1_proba_rzetelnosci     P2_ankieta_zaufanie
                      6                     240                      60                     300
P3_eksperyment_naglowek                P4_posty    P5_falszywe_naglowki
                    196                     360                     250
rozmiar KB: 52
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje chisq.test(), oneway.test(), t.test(), glm() i lm() z pakietu stats); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests (R package version 0.7.3) [Computer software]. https://doi.org/10.32614/CRAN.package.rstatix
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z dziennikarstwa i komunikacji społecznej
- Brak próby rzetelności albo sam odsetek zgodności. Bez drugiej osoby kodującej nie wiadomo, czy kategorie mierzą to samo u różnych ludzi. Podawaj kappę albo alfę dla każdej zmiennej, a nie jedną średnią dla całej instrukcji kodowania.
- Kodowanie próby rzetelności po rozmowie z drugą osobą. Kodujący muszą pracować niezależnie; rozbieżności omawiasz dopiero po policzeniu zgodności.
- Uogólnianie z wybranego zbioru tekstów na „media” lub z ankiety w mediach społecznościowych na „odbiorców”. Wnioski dotyczą badanego materiału i badanej próby.
- Mieszanie jednostek analizy. Odsetki liczone raz od artykułów, a raz od wypowiedzi, oraz test chi-kwadrat na wypowiedziach pochodzących z tych samych tekstów.
- „Wpływ” w badaniu przekrojowym. Związek źródła informacji z zaufaniem albo czasu w mediach z kompetencjami nie mówi, co jest przyczyną.
- Eksperyment bez sprawdzenia manipulacji i wniosek „nagłówek nie ma znaczenia” z nieistotnego wyniku przy szerokim przedziale ufności.
- Test t albo model Poissona dla zliczeń reakcji i komentarzy bez sprawdzenia nadmiernego rozproszenia. W przykładzie zmieniło to wniosek o weekendzie z p < .001 na p = .060.
- Porównywanie surowych liczb reakcji między profilami o różnej liczbie obserwujących bez offsetu albo przeliczenia na zasięg.
- Cytowanie dosłowne wpisów osób prywatnych z imieniem i nazwiskiem albo w sposób pozwalający je odnaleźć.
Najczęstsze pytania
Ile tekstów powinna zakodować druga osoba w analizie zawartości do pracy magisterskiej?
Nie ma jednej obowiązującej liczby. W praktyce druga osoba koduje niezależnie losową część materiału, często kilkadziesiąt tekstów albo kilkanaście–kilkadziesiąt procent całości, tak aby w próbie znalazły się wszystkie kategorie, także rzadkie. Przy rzadkiej kategorii mała próba daje bardzo szeroki przedział ufności dla alfy lub kappy. Liczbę tekstów i sposób ich wyboru ustal przed kodowaniem i opisz w rozdziale metodologicznym.
Alfa Krippendorffa czy kappa Cohena w analizie zawartości mediów?
Przy dwóch kodujących i zmiennej nominalnej bez braków obie miary dają zwykle zbliżone wartości. Alfa Krippendorffa jest wygodniejsza, gdy kodujących jest więcej niż dwóch, gdy część tekstów ma braki kodów albo gdy zmienna jest porządkowa (np. ton artykułu), bo uwzględnia poziom pomiaru. Niezależnie od wyboru podaj wynik osobno dla każdej zmiennej z 95% przedziałem ufności, a obok odsetek zgodności.
Jak przeanalizować liczbę polubień i komentarzy pod postami w pracy licencjackiej?
Liczby reakcji i komentarzy to zliczenia, zwykle silnie prawoskośne i z wariancją wielokrotnie większą od średniej. Zamiast testu t albo zwykłej regresji użyj regresji ujemnej dwumianowej i podaj ilorazy częstości (IRR) z 95% CI. Gdy porównujesz profile o różnej liczbie obserwujących, uwzględnij to przez offset albo przelicz reakcje na zasięg postu.
Jak zrobić eksperyment z nagłówkiem w ankiecie online do pracy dyplomowej?
Przygotuj dwie wersje tego samego materiału różniące się tylko nagłówkiem i ustaw w programie ankietowym losowy przydział uczestników do wersji. Dodaj pytanie sprawdzające manipulację (np. jak sensacyjny był nagłówek) i mierz wynik skalą wielopozycyjną. Średnie porównaj testem t Welcha z g Hedgesa, a odsetki odpowiedzi tak/nie – różnicą proporcji z 95% CI.
Czy wyniki ankiety rozesłanej w mediach społecznościowych dotyczą wszystkich odbiorców mediów?
Nie. Taka ankieta daje próbę dobraną wygodnie: odpowiadają osoby aktywne w danym miejscu sieci i zainteresowane tematem. Opisuj odsetki i średnie jako cechy badanej próby, porównania między grupami traktuj jako związki, a nie efekty przyczynowe, i omów ograniczenia doboru w dyskusji.
Powiązane hasła
Przeczytaj też
Zgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikAnaliza treści pytań otwartych
Klucz kategoryzacji, pilotaż, kappa dla każdej kategorii, odsetki z przedziałem Wilsona i porównanie grup – z plikiem Excel, kodem R i opisem APA.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →Piszesz pracę z dziennikarstwa i nie wiesz, jak policzyć wyniki kodowania albo ankiety?
Pomożemy przygotować próbę rzetelności, policzyć zgodność kodujących, dobrać testy do ankiety, eksperymentu lub danych z mediów społecznościowych i wyjaśnić wyniki tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Coxe, S., West, S. G., & Aiken, L. S. (2009). The analysis of count data: A gentle introduction to Poisson regression and its alternatives. Journal of Personality Assessment, 91(2), 121–136. https://doi.org/10.1080/00223890802634175
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Hayes, A. F., & Krippendorff, K. (2007). Answering the call for a standard reliability measure for coding data. Communication Methods and Measures, 1(1), 77–89. https://doi.org/10.1080/19312450709336664
- Krippendorff, K. (2004). Reliability in content analysis: Some common misconceptions and recommendations. Human Communication Research, 30(3), 411–433. https://doi.org/10.1111/j.1468-2958.2004.tb00738.x
- Lombard, M., Snyder-Duch, J., & Bracken, C. C. (2002). Content analysis in mass communication: Assessment and reporting of intercoder reliability. Human Communication Research, 28(4), 587–604. https://doi.org/10.1111/j.1468-2958.2002.tb00826.x
- Molyneux, L., & Coddington, M. (2020). Aggregation, clickbait and their effect on perceptions of journalistic credibility and quality. Journalism Practice, 14(4), 429–446. https://doi.org/10.1080/17512786.2019.1628658
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Scacco, J. M., & Muddiman, A. (2020). The curiosity effect: Information seeking in the contemporary news environment. New Media & Society, 22(3), 429–448. https://doi.org/10.1177/1461444819863408
- Semetko, H. A., & Valkenburg, P. M. (2000). Framing European politics: A content analysis of press and television news. Journal of Communication, 50(2), 93–109. https://doi.org/10.1111/j.1460-2466.2000.tb02843.x
- Williams, M. L., Burnap, P., & Sloan, L. (2017). Towards an ethical framework for publishing Twitter data in social research: Taking into account users’ views, online context and algorithmic estimation. Sociology, 51(6), 1149–1168. https://doi.org/10.1177/0038038517708140 ● Otwarty dostęp
Cytowania BibTeX
@article{coxe2009analysis, author={Coxe, Stefany and West, Stephen G. and Aiken, Leona S.}, title={{The analysis of count data: A gentle introduction to Poisson regression and its alternatives}}, journal={Journal of Personality Assessment}, year={2009}, volume={91}, number={2}, pages={121--136}, doi={10.1080/00223890802634175}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@article{hayes2007answering, author={Hayes, Andrew F. and Krippendorff, Klaus}, title={{Answering the call for a standard reliability measure for coding data}}, journal={Communication Methods and Measures}, year={2007}, volume={1}, number={1}, pages={77--89}, doi={10.1080/19312450709336664}}@article{krippendorff2004reliability, author={Krippendorff, Klaus}, title={{Reliability in content analysis: Some common misconceptions and recommendations}}, journal={Human Communication Research}, year={2004}, volume={30}, number={3}, pages={411--433}, doi={10.1111/j.1468-2958.2004.tb00738.x}}@article{lombard2002content, author={Lombard, Matthew and Snyder-Duch, Jennifer and Bracken, Cheryl Campanella}, title={{Content analysis in mass communication: Assessment and reporting of intercoder reliability}}, journal={Human Communication Research}, year={2002}, volume={28}, number={4}, pages={587--604}, doi={10.1111/j.1468-2958.2002.tb00826.x}}@article{molyneux2020aggregation, author={Molyneux, Logan and Coddington, Mark}, title={{Aggregation, clickbait and their effect on perceptions of journalistic credibility and quality}}, journal={Journalism Practice}, year={2020}, volume={14}, number={4}, pages={429--446}, doi={10.1080/17512786.2019.1628658}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{scacco2020curiosity, author={Scacco, Joshua M. and Muddiman, Ashley}, title={{The curiosity effect: Information seeking in the contemporary news environment}}, journal={New Media \& Society}, year={2020}, volume={22}, number={3}, pages={429--448}, doi={10.1177/1461444819863408}}@article{semetko2000framing, author={Semetko, Holli A. and Valkenburg, Patti M.}, title={{Framing European politics: A content analysis of press and television news}}, journal={Journal of Communication}, year={2000}, volume={50}, number={2}, pages={93--109}, doi={10.1111/j.1460-2466.2000.tb02843.x}}@article{williams2017towards, author={Williams, Matthew L. and Burnap, Pete and Sloan, Luke}, title={{Towards an ethical framework for publishing Twitter data in social research: Taking into account users’ views, online context and algorithmic estimation}}, journal={Sociology}, year={2017}, volume={51}, number={6}, pages={1149--1168}, doi={10.1177/0038038517708140}}