Sześć typowych projektów w pracy z administracji i politologii
Prace ilościowe z administracji i politologii dotyczą zwykle trzech rodzajów jednostek: osób (mieszkańców, klientów urzędu, wyborców), instytucji (urzędów, jednostek samorządu) i terytoriów (gmin, powiatów, województw). Od tego, która jednostka jest w wierszu Twojej bazy danych, zależy wybór analizy i zakres wniosków. Tabela porządkuje sześć projektów, które omawiamy w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Ocena usług urzędu | Czy klienci e-usług oceniają obsługę lepiej niż klienci obsłużeni na miejscu? | indeks satysfakcji z kilku pozycji 1–5, kanał obsługi | test t Welcha, regresja z kontrolą wieku | g Hedgesa, różnica średnich z CI |
| 2. Zaufanie do instytucji | Którym instytucjom mieszkańcy ufają bardziej? | ta sama osoba ocenia kilka instytucji (1–5) | test Friedmana, Wilcoxon dla par z korektą Holma | W Kendalla, korelacja rangowo-biseryjna |
| 3. Partycypacja | Kto deklaruje udział w głosowaniu nad budżetem obywatelskim? | wynik tak/nie, kilka predyktorów | regresja logistyczna | OR z CI, średnie efekty krańcowe (AME) |
| 4. Eksperyment sondażowy | Czy informacja o koszcie zmienia poparcie dla projektu? | dwie losowo przydzielone wersje pytania | test dla dwóch proporcji | różnica w p.p. z CI, OR, h Cohena |
| 5. Porównanie gmin | Czy wykształcenie mieszkańców wiąże się z udziałem w konsultacjach? | odsetki dla gmin i dane osób w gminach | korelacja ekologiczna, model wielopoziomowy | r, OR na poziomie osób i gmin |
| 6. Dane z dużych sondaży | Jak zmieniało się zaufanie do instytucji publicznych w kolejnych falach? | ESS, PGSS lub inne dane archiwalne | analiza z wagami i schematem losowania | zależnie od modelu |
Projekty 1–5 liczymy na danych symulowanych. Możesz je pobrać jako plik XLSX (osobny arkusz dla każdego projektu i arkusz z opisem zmiennych). Przykłady są neutralne politycznie: nie dotyczą partii ani polityków, tylko usług, instytucji i form udziału mieszkańców w sprawach lokalnych. Jeśli Twoja praca jest bliższa klasycznemu sondażowi z tabelami krzyżowymi i ważeniem, zajrzyj do poradnika statystyka w pracy z socjologii, a przy modelach na danych finansowych jednostek – do wpisu statystyka w pracy z zarządzania i ekonomii. Ogólny plan pracy, od pytań badawczych po rozdział wyników, opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: jednostka analizy i źródło danych
Recenzent pracy z administracji zapyta najpierw, o kim lub o czym są Twoje wnioski. Ankieta wśród klientów urzędu mówi o tych klientach, a nie o wszystkich mieszkańcach gminy. Tabela z wynikami głosowań w gminach mówi o gminach, a nie o wyborcach. Zestawienie wydatków jednostek samorządu mówi o budżetach, a nie o jakości usług. Przed analizą zapisz w jednym zdaniu, co jest jednostką analizy i jaka populacja stoi za Twoimi danymi.
Drugie pytanie dotyczy źródła danych. W pracach z tych kierunków spotyka się trzy sytuacje:
- Własna ankieta, np. wśród klientów urzędu albo mieszkańców jednej gminy. Masz pełną kontrolę nad pytaniami, ale próba jest zwykle mała i dobrana wygodnie, więc wnioski dotyczą tej próby.
- Dane urzędowe i zagregowane, np. frekwencja, liczba wniosków, wydatki na mieszkańca, struktura wykształcenia w gminach. Są pełne i wiarygodne, ale opisują terytoria, a nie ludzi. Zawsze podaj instytucję, nazwę zestawienia i datę odczytu.
- Dane z dużych sondaży, takich jak European Social Survey czy Polski Generalny Sondaż Społeczny. Mają losowe próby, wagi i dokumentację, ale pytania zostały ułożone przez kogoś innego.
Trzecia sprawa to zmienne deklaratywne. Udział w głosowaniu, konsultacjach czy zebraniach to zachowania cenione społecznie. Tourangeau i Yan (2007) pokazali w przeglądzie badań, że przy pytaniach drażliwych błędne raportowanie jest częste i zależy od warunków badania, m.in. od obecności ankietera. Dlatego w pracy pisz o „deklarowanym udziale”, a mechanizm opisz w ograniczeniach (zob. aprobata społeczna).
Projekt 1. Ocena usług urzędu
Pytanie: czy osoby, które załatwiały sprawę przez e-usługę, oceniają obsługę lepiej niż osoby obsłużone w czasie wizyty w urzędzie? Zmienne: kanał obsługi (dwie grupy), indeks satysfakcji ze średniej czterech pozycji (czas załatwienia sprawy, kompetencje, jasność informacji, ocena ogólna, każda 1–5), wiek i ocena obsługi wobec oczekiwań (od −2 „dużo gorzej, niż oczekiwałem” do 2 „dużo lepiej”). Plan: rzetelność indeksu, porównanie dwóch grup testem Welcha z g Hedgesa, a potem regresja z kontrolą wieku.
W sondażu 600 mieszkańców sprawę w urzędzie w ostatnim roku załatwiało 405 osób: 219 przez e-usługę i 186 na miejscu. Cztery pozycje tworzyły spójny indeks (α Cronbacha = .82, korelacje pozycji z resztą skali od .61 do .67). Klienci e-usług ocenili obsługę wyżej (M = 3.67, SD = 0.81) niż klienci obsłużeni na miejscu (M = 3.19, SD = 0.80). Różnica wyniosła 0.48 punktu, 95% CI [0.32, 0.64], t(394.65) = 5.97, p < .001, g = 0.59, 95% CI [0.39, 0.79]. Ocenę ogólną 4 lub 5 wystawiło 63.0% klientów e-usług i 40.9% klientów obsłużonych na miejscu.
Taki wynik łatwo przecenić, bo kanał nie był przydzielany losowo. Z e-usług korzystały osoby młodsze (M = 44.8 roku wobec 55.3). Do tego satysfakcja zależy nie tylko od samej obsługi, ale też od tego, czego klient się spodziewał. Van Ryzin (2004) wykazał w sondażu mieszkańców Nowego Jorku, że oczekiwania, a zwłaszcza ich potwierdzenie lub niepotwierdzenie, odgrywają zasadniczą rolę w ocenach usług miejskich. W naszych danych ocena wobec oczekiwań silnie korelowała z indeksem satysfakcji (ρ Spearmana = .57, p < .001). W regresji liniowej z kanałem, wiekiem i oceną wobec oczekiwań różnica między kanałami zmalała do 0.32 punktu (SE = 0.07, p < .001), a wiek nie miał już istotnego związku z satysfakcją (b = 0.003 na rok, p = .278). Pierwszy wynik opisuje więc różnicę między grupami klientów, a drugi przybliża porównanie osób o podobnym wieku i podobnych oczekiwaniach. Żaden nie jest dowodem, że wprowadzenie e-usługi „podniosło” satysfakcję.
Projekt 2. Zaufanie do instytucji
Pytanie: którym instytucjom mieszkańcy ufają bardziej? Zmienne: zaufanie do urzędu gminy, sądów, policji i parlamentu, każde na skali od 1 („zdecydowanie nie ufam”) do 5 („zdecydowanie ufam”). Plan: te same osoby oceniają cztery instytucje, więc pomiary są zależne. Do porównania kilku pomiarów porządkowych u tych samych osób służy test Friedmana, a jako wielkość efektu podaje się W Kendalla. Porównania parami przeprowadź testem Wilcoxona dla par z korektą Holma, z korelacją rangowo-biseryjną jako miarą efektu.
Mediana wyniosła 3 dla każdej z czterech instytucji, więc same mediany niczego tu nie różnicują. Lepiej pokazać odsetek osób ufających (odpowiedzi 4–5) i średnie. Urzędowi gminy ufało 48.7% badanych (M = 3.40), policji 42.5% (M = 3.25), sądom 31.5% (M = 2.98), a parlamentowi 20.3% (M = 2.56). Rozkłady zaufania różniły się, χ²(3) = 251.90, p < .001, W Kendalla = .14. Wszystkie sześć porównań parami było istotnych po korekcie Holma. Największa różnica dotyczyła urzędu gminy i parlamentu (rrb = .72, p < .001), a najmniejsza – urzędu gminy i policji (rrb = .18, p = .001).
Często pojawia się pokusa, by zsumować zaufanie do wszystkich instytucji w jeden wskaźnik. Zrób to tylko wtedy, gdy masz uzasadnienie teoretyczne i sprawdzisz rzetelność. Tu α = .71 dla czterech pozycji, czyli umiarkowana spójność. Pozycje mają przy tym wyraźnie różne średnie, a wynik sumaryczny zatarłby właśnie te różnice, o które pytasz. Rozkład odpowiedzi dla każdej instytucji najlepiej pokazać na wykresie słupkowym rozbieżnym.
Projekt 3. Kto głosuje nad budżetem obywatelskim: regresja logistyczna
Pytanie: od czego zależy deklarowany udział w ostatnim głosowaniu nad budżetem obywatelskim? Zmienne: udział (tak/nie), wiek, wykształcenie wyższe, lata zamieszkania w mieście, zaufanie do urzędu miasta (1–5) i korzystanie z e-usług urzędu. Plan: odsetki w grupach, regresja logistyczna, ilorazy szans z 95% CI, średnie efekty krańcowe i wykres przewidywanych prawdopodobieństw. To pełny przykład, który w całości odtwarza kod R na końcu wpisu.
Udział zadeklarowało 287 z 900 osób, czyli 31.9%, 95% CI [28.9, 35.0]. Odsetek rósł z zaufaniem do urzędu: od 12.2% przy odpowiedzi 1 do 49.1% przy odpowiedzi 5. Model z pięcioma predyktorami był lepszy od modelu pustego, χ²(5) = 81.86, p < .001, R² McFaddena = .07, R² Nagelkerkego = .12. Liczba zdarzeń (287) była wielokrotnie większa od liczby parametrów, a czynniki inflacji wariancji nie przekraczały 1.33.
| Predyktor | OR | 95% CI | p | AME (p.p.) [95% CI] |
|---|---|---|---|---|
| Wiek (o 10 lat) | 1.13 | [1.01, 1.27] | .029 | 2.5 [0.2, 4.6] |
| Wykształcenie wyższe (wobec niższego) | 2.02 | [1.46, 2.80] | < .001 | 13.6 [7.7, 19.5] |
| Lata zamieszkania (o 10 lat) | 1.16 | [1.01, 1.32] | .032 | – |
| Zaufanie do urzędu (o 1 punkt) | 1.63 | [1.42, 1.89] | < .001 | 9.4 [6.6, 11.5] |
| Korzystanie z e-usług (tak wobec nie) | 1.65 | [1.14, 2.40] | .008 | 9.5 [3.1, 15.6] |
Iloraz szans 1.63 dla zaufania oznacza, że każdy punkt skali zwiększa szansę (stosunek prawdopodobieństwa udziału do prawdopodobieństwa jego braku) 1.63 razy przy tych samych wartościach pozostałych zmiennych. Nie oznacza to, że ktoś głosuje „1.63 razy częściej”. Mood (2010) pokazała, że ilorazy szans zmieniają się po dodaniu do modelu innych zmiennych, nawet nieskorelowanych z predyktorami. Nie można ich więc wprost porównywać między modelami, grupami ani falami badania. Dlatego obok OR podaj średnie efekty krańcowe (AME) w punktach procentowych. Hanmer i Kalkan (2013) zalecają liczyć je metodą wartości obserwowanych: zmieniasz wartość jednej zmiennej u każdej osoby w próbie, a potem uśredniasz przewidywania. Nie liczysz więc efektu dla jednego „przeciętnego” respondenta. W przykładzie wykształcenie wyższe wiązało się z prawdopodobieństwem udziału wyższym średnio o 13.6 punktu procentowego, a każdy punkt zaufania – o 9.4 punktu.
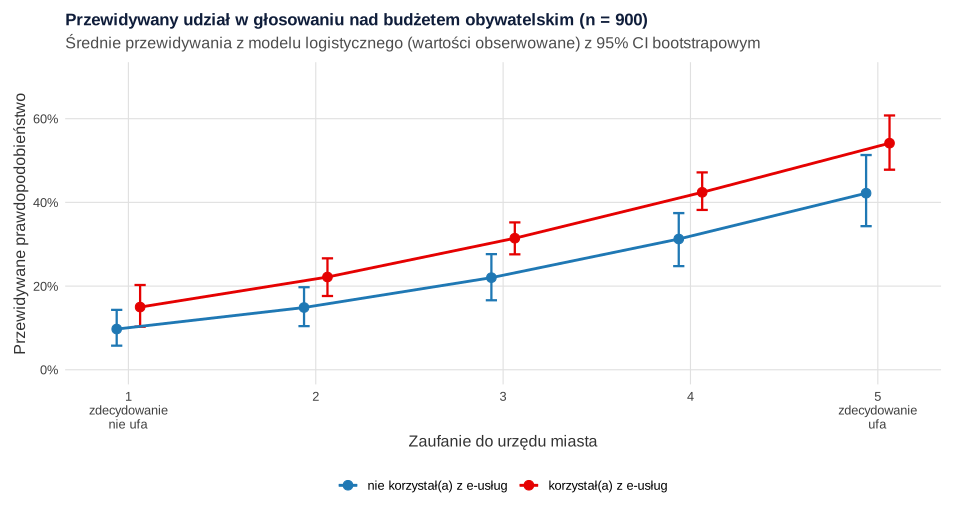
Rysunek przewidywanych prawdopodobieństw jest dla czytelnika najczytelniejszy. Przewidywany udział wynosi 9.7% u osoby, która zdecydowanie nie ufa urzędowi i nie korzysta z e-usług, a 54.2% u osoby, która zdecydowanie ufa i z nich korzysta. Kalibracja modelu w decylach przewidywań była zadowalająca (test Hosmera–Lemeshowa: χ²(8) = 10.13, p = .256). Założenia, diagnostykę i krzywą ROC opisujemy w poradniku regresja logistyczna krok po kroku. Jeśli zamiast „tak/nie” pytasz o preferowaną formę udziału (np. głosowanie przez internet, w punkcie stacjonarnym albo brak udziału), potrzebujesz wielomianowej regresji logistycznej.
Pamiętaj, że to model związków, a nie przyczyn. Zaufanie może sprzyjać udziałowi, ale udział (i to, że wybrany projekt został zrealizowany) może też budować zaufanie.
Projekt 4. Eksperyment sondażowy: czy informacja o koszcie zmienia poparcie
Pytanie: czy podanie kosztu projektu w przeliczeniu na mieszkańca zmienia poparcie dla remontu biblioteki gminnej? Zmienne: wylosowana wersja pytania (A – sam opis projektu, B – opis z kosztem) i poparcie (tak/nie). Plan: odsetki w obu wersjach, różnica z 95% CI, test dla dwóch proporcji, iloraz szans i h Cohena.
Eksperyment sondażowy to w politologii jeden z najprostszych sposobów, by zbadać przyczynowy wpływ sformułowania, informacji albo opisu sytuacji. Respondent nie wybiera wersji pytania, tylko dostaje ją losowo, więc różnicę w odpowiedziach można przypisać wersji. Gaines i in. (2007) przypominają jednak, że takie eksperymenty nie są panaceum. Efekt dotyczy reakcji na pytanie w ankiecie, w jednym momencie i w danej próbie, a jego przeniesienie na rzeczywiste zachowania wymaga ostrożności. Bardziej rozbudowaną wersję tego schematu, z kilkoma cechami opisu zmienianymi naraz, opisujemy przy okazji eksperymentu winietowego.
W panelu internetowym 820 osób losowo przydzielono po równo do dwóch wersji. Wersje nie różniły się wyraźnie wiekiem (M = 45.8 i 46.7 roku) ani odsetkiem kobiet (51.5% i 47.1%). Równowagi po losowaniu nie sprawdzaj testami istotności, bo różnice między wylosowanymi grupami z definicji są przypadkowe. Wystarczy pokazać je opisowo. Poparcie wyniosło 57.1% (234 z 410) w wersji bez kosztu i 49.3% (202 z 410) w wersji z kosztem. Różnica 7.8 punktu procentowego, 95% CI [1.0, 14.5], była istotna, χ²(1) = 5.02, p = .025. Przedział policzono metodą Newcombe’a, która łączy przedziały Wilsona dla obu odsetków. W porównaniu jedenastu metod okazała się ona dobra i prosta do policzenia przy każdej liczebności (Newcombe, 1998). Iloraz szans poparcia w wersji z kosztem wyniósł 0.73, 95% CI [0.55, 0.96], a h Cohena = 0.16, czyli efekt mały.
Te same liczby wpiszesz do kalkulatora tabeli 2×2, który poda test, OR i przedziały bez programu statystycznego. Dodanie wieku i płci do modelu nie zmieniło wniosku (logarytm OR −0.31 bez tych zmiennych i −0.32 z nimi, SE = 0.14 w obu modelach). W eksperymencie zmienne kontrolne nie są potrzebne do usunięcia zakłóceń, a jeśli je dodajesz, zapowiedz to w planie analizy.
Projekt 5. Porównanie gmin: dane zagregowane i błąd ekologiczny
Pytanie: czy wykształcenie wiąże się z udziałem w konsultacjach społecznych? Zmienne: w wersji zagregowanej – odsetek osób biorących udział w konsultacjach i odsetek osób z wyższym wykształceniem w każdej ze 120 gmin. W wersji indywidualnej – dane 40 mieszkańców z każdej gminy (razem 4800 osób). Plan: korelacja między gminami, a następnie modele na danych osób: z efektami stałymi gmin i model wielopoziomowy z efektem indywidualnym i kontekstowym.
Na danych o gminach związek jest wyraźny i ujemny. Im większy odsetek osób z wyższym wykształceniem, tym mniejszy udział w konsultacjach, r = −.59, 95% CI [−.70, −.47], p < .001. Każdy punkt procentowy osób z wyższym wykształceniem odpowiadał udziałowi niższemu średnio o 0.83 punktu. Kusi wniosek, że „osoby wykształcone rzadziej biorą udział w konsultacjach”. Byłby to jednak klasyczny błąd ekologiczny, czyli przeniesienie związku między jednostkami terytorialnymi na osoby. Robinson (1950) w artykule, od którego pochodzi to pojęcie, porównywał właśnie korelacje liczone dla obszarów z korelacjami dla osób.
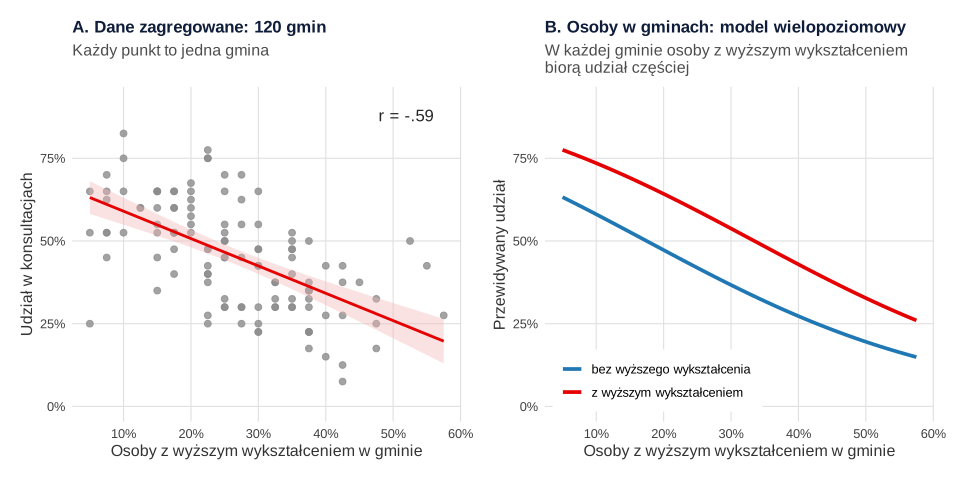
Dane indywidualne pokazują coś innego. W modelu z efektami stałymi gmin, czyli przy porównaniu osób z tej samej gminy, osoby z wyższym wykształceniem miały ponad dwukrotnie większą szansę udziału (OR = 2.05, 95% CI [1.77, 2.36]). Model wielopoziomowy rozdziela oba poziomy. Efekt indywidualny wykształcenia był dodatni (OR = 2.01, 95% CI [1.74, 2.31]), a efekt kontekstowy odsetka wykształconych w gminie – ujemny (OR = 0.65 na każde 10 punktów procentowych, 95% CI [0.59, 0.71]). W gminach z niskim odsetkiem osób wykształconych udział deklarowało 73.7% osób z wyższym wykształceniem i 56.1% pozostałych, a w gminach z wysokim odsetkiem – odpowiednio 36.8% i 25.9%. Ujemna korelacja między gminami wynika więc z cech samych gmin (w symulacji: dużych miast z niskim udziałem), a nie z zachowania osób wykształconych. Schwartz (1994) dodaje, że zmienne opisujące grupy mają też samodzielną wartość. Pytanie o gminy jest uprawnione, o ile wnioski dotyczą gmin.
Jeśli łączysz dane osób z różnych gmin w jednym modelu bez uwzględnienia gminy, błędy standardowe bywają zaniżone. Cameron i Miller (2015) zalecają w takiej sytuacji błędy standardowe odporne na klastrowanie. W przykładzie, w prostym modelu z samym wykształceniem, korekta zwiększyła błąd standardowy wyrazu wolnego z 0.034 do 0.064, a współczynnika wykształcenia – z 0.066 do 0.073. Gdy masz te same gminy w kilku latach, sięgnij po modele panelowe opisane we wpisie dane panelowe – efekty stałe, losowe i test Hausmana. O tym, co ginie przy łączeniu danych w odsetki i średnie, piszemy w haśle agregacja danych.
Projekt 6. Wtórna analiza dużych sondaży (ESS, PGSS)
Pytanie: np. czy zaufanie do instytucji publicznych różni się między grupami wieku albo między falami badania? Zmienne: gotowe pytania o zaufanie (zwykle na skali 0–10 albo 1–4), cechy społeczno-demograficzne, rok fali. Plan: wybór pytań i fal, sprawdzenie, czy brzmienie pytań było takie samo w każdej fali, analiza z wagami i schematem losowania, a dopiero potem testy i modele.
Wtórna analiza danych z dużych sondaży to dobry temat pracy z politologii. Próby są losowe i liczne, a dane bezpłatne do celów naukowych. Trzeba jednak pracować z dokumentacją. Duży sondaż ma warstwy, klastry i wagi, a pominięcie ich zaniża błędy standardowe. Jak pobrać dane, którą wagę wybrać i jak policzyć błędy standardowe, opisujemy w poradniku analiza danych z dużych badań sondażowych. Budowę wag od podstaw pokazuje wpis ważenie danych sondażowych krok po kroku. Ograniczenia pracy na cudzych danych omawiamy w poradniku reanaliza i wtórna analiza danych.
Dwie rady specyficzne dla politologii. Po pierwsze, porównując kraje albo fale, nie porównuj ilorazów szans z osobnych modeli – to ten sam problem, który opisała Mood (2010). Lepiej porównać przewidywane odsetki albo dodać do jednego modelu interakcję z krajem lub falą. Po drugie, jeśli łączysz dane sondażowe z danymi o regionach lub krajach, pamiętasz już z projektu 5, że zmienne na poziomie terytorium wymagają modelu wielopoziomowego.
Jak opisać analizę statystyczną w pracy
Rozdział o metodach powinien jasno odpowiadać na trzy pytania: kto lub co jest jednostką analizy, skąd pochodzą dane i jakie analizy wykonano. Poniżej wzór akapitu dla projektów 1–4. Jeśli nie wiesz, który test pasuje do Twojej hipotezy, przejdź przez kreator doboru testu statystycznego. Zdania z wynikami dla najczęstszych testów przygotujesz w generatorze opisu wyników w stylu APA.
Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z pięciu projektów w R
Kod odtwarza wszystkie liczby z tego wpisu, a ostatni przepis – rysunki i plik XLSX do pobrania. Każdy z przepisów 1–4 tworzy własne dane symulowane, więc możesz go uruchomić osobno. Najważniejszy jest przepis 2 z pełną analizą regresji logistycznej. Wielkości efektu liczy pakiet effectsize, przedział Newcombe’a – pakiet DescTools, a model wielopoziomowy – pakiet lme4.
1. Projekty 1 i 2: indeks satysfakcji, test t Welcha i g Hedgesa; zaufanie – test Friedmana, W Kendalla i Wilcoxon z korektą Holma
R
# Projekty 1 i 2: ocena usług urzędu i zaufanie do instytucji (dane symulowane).
# Sondaż 600 dorosłych mieszkańców jednej gminy. Część osób załatwiała w ostatnim roku sprawę
# w urzędzie: przez e-usługę albo w czasie wizyty. Wszyscy ocenili zaufanie do czterech instytucji.
suppressPackageStartupMessages({ library(effectsize); library(psych) })
set.seed(22601)
n <- 600
wiek <- round(pmin(85, pmax(18, rnorm(n, 49, 16))))
sprawa <- rbinom(n, 1, 0.68) == 1                                  # załatwiał(a) sprawę w urzędzie
kanal <- ifelse(runif(n) < plogis(1.6 - 0.045 * (wiek - 18)), "e-usługa", "wizyta w urzędzie")
kanal[!sprawa] <- NA
# Ocena wobec oczekiwań: -2 = dużo gorzej, 0 = zgodnie z oczekiwaniami, 2 = dużo lepiej
wobec_ocz <- ifelse(sprawa, pmin(2, pmax(-2, round(rnorm(n, 0.15 + 0.35 * (kanal %in% "e-usługa"), 0.95)))), NA)
f_sat <- 0.55 * wobec_ocz + 0.25 * (kanal %in% "e-usługa") + rnorm(n, 0, 0.75)
pozycja <- function(lad, prog = c(-1.6, -0.7, 0.3, 1.3)) findInterval(lad * f_sat + rnorm(n, 0, 0.7), prog) + 1
p1 <- data.frame(id = 1:n, wiek, sprawa, kanal, wobec_ocz,
                 s_czas = pozycja(0.80), s_kompetencje = pozycja(0.90), s_informacja = pozycja(0.85), s_ogolna = pozycja(1.00))
p1[!sprawa, c("s_czas", "s_kompetencje", "s_informacja", "s_ogolna")] <- NA
u <- subset(p1, sprawa)
u$kanal <- factor(u$kanal, levels = c("wizyta w urzędzie", "e-usługa"))
pozycje <- c("s_czas", "s_kompetencje", "s_informacja", "s_ogolna")
u$satysfakcja <- rowMeans(u[, pozycje])

# Projekt 1: rzetelność indeksu, porównanie kanałów i związek z oczekiwaniami
cat("Załatwiało sprawę:", nrow(u), "| według kanału:\n"); print(table(u$kanal))
a <- psych::alpha(u[, pozycje]); round(c(alfa = a$total$raw_alpha, r_min = min(a$item.stats$r.drop), r_max = max(a$item.stats$r.drop)), 3)
aggregate(satysfakcja ~ kanal, u, function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2))
tw <- t.test(satysfakcja ~ kanal, data = u)                           # test t Welcha (domyślny w R)
tw
hedges_g(satysfakcja ~ kanal, data = u, pooled_sd = FALSE)
# Kanał wybierają częściej młodsi: różnica po uwzględnieniu wieku i oceny wobec oczekiwań
aggregate(wiek ~ kanal, u, function(x) round(c(M = mean(x), SD = sd(x)), 1))
round(coef(summary(lm(satysfakcja ~ kanal + wiek + wobec_ocz, data = u))), 4)
# Odsetek ocen „4” lub „5” w ocenie ogólnej według kanału
round(100 * tapply(u$s_ogolna >= 4, u$kanal, mean), 1)
# Ocena wobec oczekiwań a satysfakcja (korelacja Spearmana)
round(prop.table(table(u$wobec_ocz)) * 100, 1)
cor.test(u$satysfakcja, u$wobec_ocz, method = "spearman", exact = FALSE)

# Projekt 2: zaufanie do czterech instytucji (1 = zdecydowanie nie ufam ... 5 = zdecydowanie ufam)
osoba <- rnorm(n)                                                     # ogólna skłonność do ufania
ufnosc <- function(srednia, lad) findInterval(srednia + lad * osoba + rnorm(n, 0, 0.9), c(-1.5, -0.5, 0.5, 1.5)) + 1
p2 <- data.frame(id = 1:n, urzad_gminy = ufnosc(0.45, 0.7), sady = ufnosc(-0.05, 0.7),
                 policja = ufnosc(0.30, 0.7), parlament = ufnosc(-0.55, 0.7))
inst <- c("urzad_gminy", "sady", "policja", "parlament")
round(rbind(Me = sapply(p2[, inst], median), M = sapply(p2[, inst], mean), proc_ufa = 100 * sapply(p2[, inst], function(x) mean(x >= 4))), 2)
m <- as.matrix(p2[, inst])
friedman.test(m)
suppressWarnings(kendalls_w(m))                                      # W Kendalla z 95% CI
# Porównania parami: test Wilcoxona dla par z korektą Holma
pary <- combn(inst, 2)
pw <- do.call(rbind, lapply(seq_len(ncol(pary)), function(j) {
  x <- p2[[pary[1, j]]]; y <- p2[[pary[2, j]]]
  w <- suppressWarnings(wilcox.test(x, y, paired = TRUE, exact = FALSE))
  rb <- rank_biserial(x, y, paired = TRUE)
  data.frame(para = paste(pary[1, j], "-", pary[2, j]), V = unname(w$statistic), p = w$p.value, r_rb = rb$r_rank_biserial)
}))
pw$p_holm <- p.adjust(pw$p, "holm"); pw$p <- signif(pw$p, 3); pw$p_holm <- signif(pw$p_holm, 3); pw$r_rb <- round(pw$r_rb, 2)
pw
# Czy cztery pozycje tworzą jeden indeks „zaufania do instytucji”?
round(psych::alpha(p2[, inst])$total$raw_alpha, 3)
Wynik w R
Załatwiało sprawę: 405 | według kanału:

wizyta w urzędzie          e-usługa
              186               219
 alfa r_min r_max
0.818 0.613 0.670
              kanal satysfakcja.M satysfakcja.SD satysfakcja.n
1 wizyta w urzędzie          3.19           0.80        186.00
2          e-usługa          3.67           0.81        219.00

	Welch Two Sample t-test

data:  satysfakcja by kanal
t = -5.9719, df = 394.65, p-value = 5.234e-09
alternative hypothesis: true difference in means between group wizyta w urzędzie and group e-usługa is not equal to 0
95 percent confidence interval:
 -0.6385141 -0.3222312
sample estimates:
mean in group wizyta w urzędzie          mean in group e-usługa
                       3.190860                        3.671233

Hedges' g |         95% CI
--------------------------
-0.59     | [-0.79, -0.39]

- Estimated using un-pooled SD.              kanal wiek.M wiek.SD
1 wizyta w urzędzie   55.3    14.2
2          e-usługa   44.8    13.9
              Estimate Std. Error t value Pr(>|t|)
(Intercept)     3.0145     0.1411 21.3632   0.0000
kanale-usługa   0.3227     0.0732  4.4104   0.0000
wiek            0.0026     0.0024  1.0865   0.2779
wobec_ocz       0.4670     0.0351 13.3106   0.0000
wizyta w urzędzie          e-usługa
             40.9              63.0

  -2   -1    0    1    2
 2.7 19.0 35.6 32.6 10.1

	Spearman's rank correlation rho

data:  u$satysfakcja and u$wobec_ocz
S = 4805479, p-value < 2.2e-16
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.5659642

         urzad_gminy  sady policja parlament
Me              3.00  3.00    3.00      3.00
M               3.40  2.98    3.25      2.56
proc_ufa       48.67 31.50   42.50     20.33

	Friedman rank sum test

data:  m
Friedman chi-squared = 251.9, df = 3, p-value < 2.2e-16

Kendall's W |       95% CI
--------------------------
0.14        | [0.11, 1.00]

- One-sided CIs: upper bound fixed at [1.00].                     para       V        p  r_rb   p_holm
1      urzad_gminy - sady 65140.5 2.47e-16  0.44 9.87e-16
2   urzad_gminy - policja 50527.0 1.15e-03  0.18 1.15e-03
3 urzad_gminy - parlament 90901.5 3.42e-43  0.72 2.05e-42
4          sady - policja 32383.5 1.67e-07 -0.28 3.35e-07
5        sady - parlament 64700.5 6.31e-14  0.40 1.89e-13
6     policja - parlament 82387.5 5.71e-33  0.63 2.86e-32
[1] 0.708
2. Projekt 3 (pełny przykład): regresja logistyczna, ilorazy szans, średnie efekty krańcowe i kalibracja
R
# Projekt 3 (pełny przykład): kto deklaruje udział w głosowaniu nad budżetem obywatelskim?
# Sondaż 900 dorosłych mieszkańców miasta (dane symulowane). Zmienna zależna: deklarowany udział
# w ostatnim głosowaniu (1 = tak, 0 = nie). Predyktory: wiek, wykształcenie wyższe, lata zamieszkania
# w mieście, zaufanie do urzędu miasta (1–5) i korzystanie z e-usług urzędu w ostatnim roku.
set.seed(22602)
n <- 900
wiek <- round(pmin(85, pmax(18, rnorm(n, 47, 16))))
wyzsze <- rbinom(n, 1, plogis(0.4 - 0.025 * (wiek - 47)))
lata_zam <- pmin(wiek - 17, round(rexp(n, 1 / 22)))
zaufanie <- findInterval(rnorm(n, 0.1 + 0.2 * wyzsze, 1), c(-1.4, -0.5, 0.5, 1.4)) + 1
e_uslugi <- rbinom(n, 1, plogis(0.9 - 0.05 * (wiek - 47) + 0.8 * wyzsze))
eta <- -2.0 + 0.012 * (wiek - 47) + 0.55 * wyzsze + 0.18 * lata_zam / 10 + 0.38 * (zaufanie - 3) + 0.75 * e_uslugi
glosowal <- rbinom(n, 1, plogis(eta))
d <- data.frame(id = 1:n, glosowal, wiek, wyzsze, lata_zam, zaufanie, e_uslugi)
d$wiek10 <- d$wiek / 10; d$lata10 <- d$lata_zam / 10

# 1. Opis: odsetek deklarujących udział (95% CI Wilsona) i odsetki w grupach
prop.test(sum(d$glosowal), n, correct = FALSE)[c("estimate", "conf.int")]
round(100 * tapply(d$glosowal, d$zaufanie, mean), 1); table(d$zaufanie)
round(100 * tapply(d$glosowal, d$e_uslugi, mean), 1)

# 2. Model logistyczny i test ilorazu wiarygodności względem modelu pustego
m1 <- glm(glosowal ~ wiek10 + wyzsze + lata10 + zaufanie + e_uslugi, family = binomial, data = d)
m0 <- glm(glosowal ~ 1, family = binomial, data = d)
anova(m0, m1, test = "LRT")
ll1 <- as.numeric(logLik(m1)); ll0 <- as.numeric(logLik(m0))
c(McFadden = 1 - ll1 / ll0, Nagelkerke = (1 - exp(2 * (ll0 - ll1) / n)) / (1 - exp(2 * ll0 / n)))

# 3. Ilorazy szans z 95% CI (przedziały profilowe) i wartości p
ci <- suppressMessages(confint(m1))
tab <- data.frame(b = coef(m1), SE = sqrt(diag(vcov(m1))), OR = exp(coef(m1)), OR_lo = exp(ci[, 1]), OR_hi = exp(ci[, 2]),
                  p = coef(summary(m1))[, 4])
print(round(tab, 4))

# 4. Średnie efekty krańcowe (AME) metodą wartości obserwowanych: dla każdej osoby
#    przewidywanie przy zmienionej wartości jednej zmiennej, a potem średnia różnic
ame <- function(model, dane) {
  pr <- function(zm, wart) { nd <- dane; nd[[zm]] <- wart; mean(predict(model, nd, type = "response")) }
  c(wyzsze = pr("wyzsze", 1) - pr("wyzsze", 0),
    e_uslugi = pr("e_uslugi", 1) - pr("e_uslugi", 0),
    zaufanie_1pkt = mean(sapply(1:4, function(k) pr("zaufanie", k + 1) - pr("zaufanie", k))),
    wiek_10lat = pr("wiek10", dane$wiek10 + 1) - pr("wiek10", dane$wiek10))
}
ame_est <- ame(m1, d)
B <- 500; boot <- matrix(NA, B, length(ame_est))
for (b in 1:B) {
  db <- d[sample.int(n, replace = TRUE), ]
  mb <- glm(formula(m1), family = binomial, data = db)
  boot[b, ] <- ame(mb, db)
}
round(100 * cbind(AME = ame_est, lo = apply(boot, 2, quantile, .025), hi = apply(boot, 2, quantile, .975)), 1)

# 5. Przewidywane prawdopodobieństwo według zaufania i korzystania z e-usług (wartości obserwowane)
pp <- expand.grid(zaufanie = 1:5, e_uslugi = 0:1)
pp$p <- mapply(function(z, e) { nd <- d; nd$zaufanie <- z; nd$e_uslugi <- e; mean(predict(m1, nd, type = "response")) },
               pp$zaufanie, pp$e_uslugi)
pp$p <- round(100 * pp$p, 1); pp

# 6. Diagnostyka: liczba zdarzeń na parametr, VIF (ręcznie) i kalibracja w decylach
c(zdarzenia = sum(d$glosowal), parametry = length(coef(m1)) - 1)
X <- model.matrix(m1)[, -1]; round(diag(solve(cor(X))), 2)
d$p_hat <- fitted(m1); d$decyl <- cut(d$p_hat, quantile(d$p_hat, 0:10 / 10), include.lowest = TRUE, labels = FALSE)
kal <- aggregate(cbind(obserwowane = glosowal, przewidywane = p_hat) ~ decyl, d, mean); round(kal, 3)
hl <- sum(table(d$decyl) * (kal$obserwowane - kal$przewidywane)^2 / (kal$przewidywane * (1 - kal$przewidywane)))
c(HL = round(hl, 2), df = 8, p = round(pchisq(hl, 8, lower.tail = FALSE), 3))
Wynik w R
$estimate
        p
0.3188889

$conf.int
[1] 0.2892659 0.3500514
attr(,"conf.level")
[1] 0.95

   1    2    3    4    5
12.2 21.1 27.4 42.2 49.1

  1   2   3   4   5
 49 185 317 237 112
   0    1
25.7 34.1
Analysis of Deviance Table

Model 1: glosowal ~ 1
Model 2: glosowal ~ wiek10 + wyzsze + lata10 + zaufanie + e_uslugi
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1       899     1126.8
2       894     1045.0  5   81.861 3.423e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  McFadden Nagelkerke
0.07264565 0.12175404
                  b     SE     OR  OR_lo  OR_hi      p
(Intercept) -4.0225 0.4676 0.0179 0.0070 0.0440 0.0000
wiek10       0.1259 0.0577 1.1341 1.0130 1.2702 0.0291
wyzsze       0.7006 0.1659 2.0150 1.4604 2.8001 0.0000
lata10       0.1463 0.0683 1.1575 1.0126 1.3240 0.0322
zaufanie     0.4909 0.0736 1.6339 1.4169 1.8913 0.0000
e_uslugi     0.5000 0.1885 1.6487 1.1443 2.3979 0.0080
               AME  lo   hi
wyzsze        13.6 7.7 19.5
e_uslugi       9.5 3.1 15.6
zaufanie_1pkt  9.4 6.6 11.5
wiek_10lat     2.5 0.2  4.6
   zaufanie e_uslugi    p
1         1        0  9.7
2         2        0 14.9
3         3        0 22.0
4         4        0 31.3
5         5        0 42.2
6         1        1 15.0
7         2        1 22.2
8         3        1 31.4
9         4        1 42.4
10        5        1 54.2
zdarzenia parametry
      287         5
  wiek10   wyzsze   lata10 zaufanie e_uslugi
    1.33     1.07     1.16     1.01     1.15
   decyl obserwowane przewidywane
1      1       0.121        0.110
2      2       0.198        0.168
3      3       0.170        0.213
4      4       0.211        0.250
5      5       0.311        0.289
6      6       0.422        0.329
7      7       0.322        0.366
8      8       0.344        0.412
9      9       0.533        0.473
10    10       0.556        0.581
    HL     df      p
10.130  8.000  0.256
3. Projekt 4: eksperyment sondażowy – różnica odsetków z CI Newcombe’a, test χ² i iloraz szans
R
# Projekt 4: eksperyment sondażowy – czy informacja o koszcie zmienia poparcie dla projektu?
# 820 respondentów panelu internetowego losowo dostało jedną z dwóch wersji pytania o projekt
# remontu biblioteki gminnej (dane symulowane):
#   A – opis projektu; B – ten sam opis + informacja o koszcie w przeliczeniu na mieszkańca.
# Zmienna zależna: poparcie (1 = zdecydowanie lub raczej popiera, 0 = pozostałe odpowiedzi).
suppressPackageStartupMessages(library(DescTools))
set.seed(22603)
n <- 820
wersja <- sample(rep(c("A: bez kosztu", "B: z kosztem"), each = n / 2))
wiek <- round(pmin(80, pmax(18, rnorm(n, 45, 15))))
kobieta <- rbinom(n, 1, 0.52)
poparcie <- rbinom(n, 1, plogis(0.35 - 0.45 * (wersja == "B: z kosztem") + 0.008 * (wiek - 45)))
d <- data.frame(id = 1:n, wersja = factor(wersja, levels = c("A: bez kosztu", "B: z kosztem")), wiek, kobieta, poparcie)

# 1. Kontrola losowania: rozkład cech w obu wersjach (opisowo, bez testów)
aggregate(cbind(wiek, kobieta) ~ wersja, d, function(x) round(mean(x), 3))

# 2. Odsetki poparcia, różnica z 95% CI (metoda Newcombe'a – hybrydowa Wilsona) i test
tab <- table(d$wersja, factor(d$poparcie, levels = 1:0, labels = c("popiera", "nie popiera"))); tab
x <- tab[, "popiera"]; m <- rowSums(tab)
round(100 * x / m, 1)
BinomDiffCI(x[1], m[1], x[2], m[2], method = "score")              # różnica A − B (Newcombe)
prop.test(x, m, correct = FALSE)                                    # test χ² dla dwóch proporcji
# Ten sam przedział ręcznie z przedziałów Wilsona dla każdej wersji
w <- sapply(1:2, function(i) prop.test(x[i], m[i], correct = FALSE)$conf.int)
p <- unname(x / m); dlt <- p[1] - p[2]
c(roznica = dlt, lo = dlt - sqrt((p[1] - w[1, 1])^2 + (w[2, 2] - p[2])^2), hi = dlt + sqrt((w[2, 1] - p[1])^2 + (p[2] - w[1, 2])^2))

# 3. Iloraz szans z 95% CI i h Cohena
mod <- glm(poparcie ~ wersja, family = binomial, data = d)
round(exp(c(OR = unname(coef(mod)[2]), suppressMessages(confint(mod))[2, ])), 3)
c(h_Cohena = 2 * asin(sqrt(p[1])) - 2 * asin(sqrt(p[2])))

# 4. Ta sama analiza z kontrolą wieku i płci – wniosek o efekcie wersji się nie zmienia
mod2 <- glm(poparcie ~ wersja + wiek + kobieta, family = binomial, data = d)
round(rbind(bez_kontroli = coef(summary(mod))[2, 1:2], z_kontrola = coef(summary(mod2))[2, 1:2]), 3)
Wynik w R
         wersja   wiek kobieta
1 A: bez kosztu 45.778   0.515
2  B: z kosztem 46.676   0.471

                popiera nie popiera
  A: bez kosztu     234         176
  B: z kosztem      202         208
A: bez kosztu  B: z kosztem
         57.1          49.3
     est.A: bez kosztu      lwr.ci    upr.ci
[1,]        0.07804878 0.009752919 0.1453242

	2-sample test for equality of proportions without continuity correction

data:  x out of m
X-squared = 5.0153, df = 1, p-value = 0.02512
alternative hypothesis: two.sided
95 percent confidence interval:
 0.009950841 0.146146720
sample estimates:
   prop 1    prop 2
0.5707317 0.4926829

    roznica          lo          hi
0.078048780 0.009752919 0.145324223
    OR  2.5 % 97.5 %
 0.730  0.554  0.961
 h_Cohena
0.1565742
             Estimate Std. Error
bez_kontroli   -0.314      0.140
z_kontrola     -0.323      0.141
4. Projekt 5: korelacja ekologiczna, efekty stałe gmin, błędy standardowe klastrowe i model wielopoziomowy
R
# Projekt 5: porównanie gmin na danych zagregowanych i błąd ekologiczny (dane symulowane).
# 120 gmin; w każdej 40 mieszkańców z sondażu (razem 4800 osób). Pytanie: czy wykształcenie
# wiąże się z udziałem w konsultacjach społecznych? Na poziomie osób wyższe wykształcenie zwiększa
# szansę udziału, ale w gminach o większym odsetku osób z wyższym wykształceniem (duże miasta)
# udział jest ogólnie niższy – to efekt kontekstu gminy, a nie cecha osób.
suppressPackageStartupMessages({ library(lme4); library(sandwich) })
set.seed(22604)
G <- 120; n_g <- 40
gm <- data.frame(gmina = 1:G, odsetek_wyzsze = round(runif(G, 0.10, 0.45), 3))
gm$efekt_gminy <- rnorm(G, 0, 0.30)
os <- gm[rep(1:G, each = n_g), ]
os$wyzsze <- rbinom(nrow(os), 1, os$odsetek_wyzsze)
os$udzial <- rbinom(nrow(os), 1, plogis(-0.3 + 0.70 * os$wyzsze - 6.5 * (os$odsetek_wyzsze - 0.25) + os$efekt_gminy))

# 1. Dane zagregowane: odsetek udziału i odsetek z wyższym wykształceniem w każdej gminie (z próby)
ag <- aggregate(cbind(udzial, wyzsze) ~ gmina, os, mean)
names(ag) <- c("gmina", "udzial_proc", "wyzsze_proc"); ag[, 2:3] <- 100 * ag[, 2:3]
round(sapply(ag[, 2:3], function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 1)
cor.test(ag$wyzsze_proc, ag$udzial_proc)                           # korelacja ekologiczna
round(coef(summary(lm(udzial_proc ~ wyzsze_proc, data = ag))), 3)  # o ile p.p. zmienia się udział na 1 p.p. wykształconych

# 2. Dane indywidualne: model bez kontekstu (zwykłe i klastrowe SE) i model z efektami stałymi gmin
m_ind <- glm(udzial ~ wyzsze, family = binomial, data = os)
round(cbind(OR = exp(coef(m_ind)), SE_zwykly = sqrt(diag(vcov(m_ind))), SE_klastrowy = sqrt(diag(vcovCL(m_ind, cluster = ~ gmina)))), 3)
m_fe <- glm(udzial ~ wyzsze + factor(gmina), family = binomial, data = os)
round(c(OR_wyzsze = exp(coef(m_fe)[["wyzsze"]]), exp(confint.default(m_fe)["wyzsze", ])), 3)

# 3. Model wielopoziomowy z efektem indywidualnym i kontekstowym (odsetek wykształconych w gminie)
os$kontekst <- ave(os$wyzsze, os$gmina) * 10                      # na 10 p.p. odsetka w gminie
m_ml <- glmer(udzial ~ wyzsze + kontekst + (1 | gmina), family = binomial, data = os)
est <- fixef(m_ml); se <- sqrt(diag(as.matrix(vcov(m_ml))))
round(cbind(b = est, SE = se, OR = exp(est), lo = exp(est - 1.96 * se), hi = exp(est + 1.96 * se)), 3)
round(c(wariancja_gmin = as.numeric(VarCorr(m_ml)$gmina), ICC = as.numeric(VarCorr(m_ml)$gmina) / (as.numeric(VarCorr(m_ml)$gmina) + pi^2 / 3)), 3)

# 4. Odsetki udziału osób z wyższym i bez wyższego wykształcenia w trzech grupach gmin
os$typ <- cut(os$odsetek_wyzsze, c(0, .2167, .3333, 1), labels = c("niski odsetek", "średni odsetek", "wysoki odsetek"))
round(100 * tapply(os$udzial, list(os$typ, wyzsze = os$wyzsze), mean), 1)
Wynik w R
    udzial_proc wyzsze_proc
M          45.4        26.5
SD         15.9        11.5
min         7.5         5.0
max        82.5        57.5

	Pearson's product-moment correlation

data:  ag$wyzsze_proc and ag$udzial_proc
t = -8.0395, df = 118, p-value = 7.798e-13
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.6995435 -0.4652638
sample estimates:
       cor
-0.5948942

            Estimate Std. Error t value Pr(>|t|)
(Intercept)   67.274      2.969  22.661        0
wyzsze_proc   -0.827      0.103  -8.040        0
               OR SE_zwykly SE_klastrowy
(Intercept) 0.753     0.034        0.064
wyzsze      1.436     0.066        0.073
OR_wyzsze     2.5 %    97.5 %
    2.045     1.770     2.362
                 b    SE    OR    lo    hi
(Intercept)  0.761 0.131 2.140 1.656 2.765
wyzsze       0.696 0.073 2.006 1.740 2.312
kontekst    -0.435 0.047 0.647 0.591 0.709
wariancja_gmin            ICC
         0.209          0.060
                wyzsze
                    0    1
  niski odsetek  56.1 73.7
  średni odsetek 38.7 54.6
  wysoki odsetek 25.9 36.8
5. Rysunki i plik XLSX
R
# Rysunki i plik XLSX do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b226-rysunki.R > b226-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(svglite); library(patchwork); library(openxlsx) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", dane = "grey55", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 14) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: width=\"%d\" height=\"%d\" (%d KB)\n", basename(plik), round(szer * 100), round(wys * 100), round(file.info(plik)$size / 1024)))
}
pdf(NULL)
# Dane z przepisów 1–4 (każdy plik tworzy swoje dane symulowane od zera)
e1 <- new.env(); e2 <- new.env(); e3 <- new.env(); e4 <- new.env()
invisible(capture.output({ sys.source("b226-1-uslugi-zaufanie.R", e1); sys.source("b226-2-budzet-obywatelski.R", e2)
                           sys.source("b226-3-eksperyment.R", e3); sys.source("b226-4-gminy.R", e4) }))

# Rysunek 1: błąd ekologiczny – gminy (A) i osoby w gminach (B)
ag <- e4$ag; os <- e4$os; m_ml <- e4$m_ml
rA <- ggplot(ag, aes(wyzsze_proc, udzial_proc)) +
  geom_point(colour = KOLORY[["dane"]], size = 2, alpha = .8) +
  geom_smooth(method = "lm", formula = y ~ x, se = TRUE, colour = KOLORY[["akcent"]], fill = "#f4b6b6", linewidth = 1) +
  annotate("text", x = 56, y = 88, label = sprintf("r = %s", sub("0\\.", ".", sprintf("%.2f", cor(ag$wyzsze_proc, ag$udzial_proc)))),
           hjust = 1, size = 4.4, colour = "grey15") +
  scale_x_continuous(labels = function(x) paste0(x, "%")) + scale_y_continuous(labels = function(x) paste0(x, "%"), limits = c(0, 92)) +
  labs(title = "A. Dane zagregowane: 120 gmin", subtitle = "Każdy punkt to jedna gmina",
       x = "Osoby z wyższym wykształceniem w gminie", y = "Udział w konsultacjach") + theme_metodolog(12)
siatka <- expand.grid(kontekst = seq(min(os$kontekst), max(os$kontekst), length.out = 60), wyzsze = 0:1)
siatka$p <- 100 * predict(m_ml, newdata = siatka, re.form = NA, type = "response")
siatka$grupa <- factor(siatka$wyzsze, 0:1, c("bez wyższego wykształcenia", "z wyższym wykształceniem"))
print(round(siatka[c(1, 60, 61, 120), c("kontekst", "wyzsze", "p")], 2))
rB <- ggplot(siatka, aes(kontekst * 10, p, colour = grupa)) + geom_line(linewidth = 1.3) +
  scale_colour_manual(values = c(KOLORY[["drugi"]], KOLORY[["akcent"]]), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(x, "%")) + scale_y_continuous(labels = function(x) paste0(x, "%"), limits = c(0, 92)) +
  labs(title = "B. Osoby w gminach: model wielopoziomowy", subtitle = "W każdej gminie osoby z wyższym wykształceniem\nbiorą udział częściej",
       x = "Osoby z wyższym wykształceniem w gminie", y = "Przewidywany udział") +
  theme_metodolog(12) + theme(legend.position = "inside", legend.position.inside = c(.02, .03), legend.justification = c(0, 0),
                               legend.background = element_rect(fill = "white", colour = NA))
zapisz_svg(rA + rB, "../statystyka-administracja-blad-ekologiczny.svg", szer = 10, wys = 5)

# Rysunek 2: przewidywane prawdopodobieństwo udziału w głosowaniu nad budżetem obywatelskim
d <- e2$d; m1 <- e2$m1
pp_fun <- function(model, dane) mapply(function(z, e) { nd <- dane; nd$zaufanie <- z; nd$e_uslugi <- e
  mean(predict(model, nd, type = "response")) }, rep(1:5, 2), rep(0:1, each = 5))
set.seed(22605)
bt <- replicate(300, { db <- d[sample.int(nrow(d), replace = TRUE), ]; pp_fun(glm(formula(m1), family = binomial, data = db), db) })
pp <- data.frame(zaufanie = rep(1:5, 2), e_uslugi = factor(rep(0:1, each = 5), 0:1, c("nie korzystał(a) z e-usług", "korzystał(a) z e-usług")),
                 p = 100 * pp_fun(m1, d), lo = 100 * apply(bt, 1, quantile, .025), hi = 100 * apply(bt, 1, quantile, .975))
print(round(pp[, c("zaufanie", "p", "lo", "hi")], 1))
r2 <- ggplot(pp, aes(zaufanie, p, colour = e_uslugi)) +
  geom_errorbar(aes(ymin = lo, ymax = hi), width = .12, position = position_dodge(.25), linewidth = .8) +
  geom_line(position = position_dodge(.25), linewidth = 1) + geom_point(position = position_dodge(.25), size = 3) +
  scale_colour_manual(values = c(KOLORY[["drugi"]], KOLORY[["akcent"]]), name = NULL) +
  scale_x_continuous(breaks = 1:5, labels = c("1\nzdecydowanie\nnie ufa", "2", "3", "4", "5\nzdecydowanie\nufa")) +
  scale_y_continuous(labels = function(x) paste0(x, "%"), limits = c(0, 70)) +
  labs(title = "Przewidywany udział w głosowaniu nad budżetem obywatelskim (n = 900)",
       subtitle = "Średnie przewidywania z modelu logistycznego (wartości obserwowane) z 95% CI bootstrapowym",
       x = "Zaufanie do urzędu miasta", y = "Przewidywane prawdopodobieństwo") + theme_metodolog(12)
zapisz_svg(r2, "../statystyka-administracja-budzet-obywatelski.svg", szer = 10, wys = 5.4)

# Plik XLSX z danymi do samodzielnej analizy
plik <- "../statystyka-administracja-politologia-dane.xlsx"
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z administracji i politologii – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
u <- e1$u; u$satysfakcja <- round(u$satysfakcja, 2)
opis <- data.frame(arkusz = c("P1_uslugi", "P2_zaufanie", "P3_budzet_obywatelski", "P4_eksperyment", "P5_gminy", "P5_mieszkancy"),
  zawartosc = c("405 osób, które załatwiały sprawę w urzędzie: kanał, ocena wobec oczekiwań (−2 do 2), 4 pozycje satysfakcji 1–5 i indeks",
                "600 mieszkańców: zaufanie do urzędu gminy, sądów, policji i parlamentu (1–5)",
                "900 mieszkańców miasta: deklarowany udział w głosowaniu (1/0), wiek, wykształcenie wyższe, lata zamieszkania, zaufanie, e-usługi",
                "820 respondentów: wylosowana wersja pytania, wiek, płeć (kobieta = 1) i poparcie projektu (1/0)",
                "120 gmin: odsetek udziału w konsultacjach i odsetek osób z wyższym wykształceniem (z próby)",
                "4800 mieszkańców 120 gmin: numer gminy, wykształcenie wyższe (1/0), udział w konsultacjach (1/0)"),
  uwaga = "Dane symulowane do nauki analizy; nie pochodzą z prawdziwego badania.")
arkusze <- list(Opis = opis, P1_uslugi = u[, c("id", "wiek", "kanal", "wobec_ocz", e1$pozycje, "satysfakcja")], P2_zaufanie = e1$p2,
                P3_budzet_obywatelski = d[, c("id", "glosowal", "wiek", "wyzsze", "lata_zam", "zaufanie", "e_uslugi")],
                P4_eksperyment = e3$d, P5_gminy = transform(ag, udzial_proc = round(udzial_proc, 1), wyzsze_proc = round(wyzsze_proc, 1)),
                P5_mieszkancy = os[, c("gmina", "wyzsze", "udzial")])
for (nm in names(arkusze)) { addWorksheet(wb, nm); writeData(wb, nm, arkusze[[nm]]); setColWidths(wb, nm, 1:ncol(arkusze[[nm]]), "auto") }
saveWorkbook(wb, plik, overwrite = TRUE)
sapply(getSheetNames(plik), function(s) nrow(read.xlsx(plik, s)))
cat("rozmiar KB:", round(file.info(plik)$size / 1024), "\n")
Wynik w R
    kontekst wyzsze     p
1       0.50      0 63.25
60      5.75      0 14.90
61      0.50      1 77.54
120     5.75      1 25.98
Zapisano statystyka-administracja-blad-ekologiczny.svg: width="1000" height="500" (36 KB)
   zaufanie    p   lo   hi
1         1  9.7  5.8 14.3
2         2 14.9 10.4 19.7
3         3 22.0 16.6 27.6
4         4 31.3 24.8 37.4
5         5 42.2 34.3 51.3
6         1 15.0 10.3 20.3
7         2 22.2 17.6 26.6
8         3 31.4 27.6 35.2
9         4 42.4 38.2 47.2
10        5 54.2 47.8 60.8
Zapisano statystyka-administracja-budzet-obywatelski.svg: width="1000" height="540" (11 KB)
                 Opis             P1_uslugi           P2_zaufanie
                    6                   405                   600
P3_budzet_obywatelski        P4_eksperyment              P5_gminy
                  900                   820                   120
        P5_mieszkancy
                 4800
rozmiar KB: 140
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test(), lm(), glm(), friedman.test(), wilcox.test(), cor.test(), prop.test() i p.adjust() z pakietu stats); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z administracji i politologii
- Wnioski o mieszkańcach z danych o gminach. W przykładzie korelacja między gminami była ujemna, a związek na poziomie osób dodatni.
- „Frekwencja” zamiast „deklarowany udział” przy danych z ankiety i brak wzmianki o możliwym zawyżaniu deklaracji.
- Wnioski przyczynowe z porównania grup, które same wybrały kanał obsługi, formę udziału albo usługę, np. „e-usługi podnoszą satysfakcję”.
- Kilka instytucji ocenianych przez te same osoby analizowane jak niezależne grupy (np. testem Kruskala–Wallisa zamiast Friedmana).
- Jeden wskaźnik „zaufania do instytucji” zsumowany bez uzasadnienia i bez sprawdzenia rzetelności.
- Same ilorazy szans w regresji logistycznej, czytane jak „razy częściej”, i porównywanie OR z różnych modeli lub fal.
- Testowanie równowagi grup po losowaniu w eksperymencie i dodawanie zmiennych kontrolnych dopiero wtedy, gdy wynik jest nieistotny.
- Dane z ESS lub PGSS bez wag i bez schematu losowania, a także łączenie fal, w których pytanie brzmiało inaczej.
- Przykłady i pytania naruszające neutralność, np. sugerujące odpowiedź albo oceniające konkretne ugrupowania, gdy temat pracy tego nie wymaga.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy magisterskiej z administracji?
Zależy to od pytania i jednostki analizy. Ocenę usług urzędu z kilku pozycji porównuj między grupami klientów testem t Welcha z g Hedgesa, zaufanie do kilku instytucji w tej samej grupie osób – testem Friedmana z W Kendalla, a zmienną tak/nie (np. udział w konsultacjach) – regresją logistyczną z ilorazami szans i średnimi efektami krańcowymi. Dane o gminach analizuj jako dane o gminach, nie o mieszkańcach.
Czy z danych o frekwencji w gminach można wnioskować o zachowaniu mieszkańców?
Nie wprost. Korelacja między odsetkami w gminach (np. odsetkiem osób z wyższym wykształceniem i frekwencją) opisuje gminy i może mieć inny kierunek niż związek na poziomie osób. To błąd ekologiczny. Aby mówić o mieszkańcach, potrzebujesz danych indywidualnych, najlepiej z informacją o gminie, i modelu wielopoziomowego albo modelu z efektami stałymi gmin.
Jak przeanalizować eksperyment sondażowy z dwiema wersjami pytania?
Porównaj odsetek wybranej odpowiedzi w dwóch wylosowanych wersjach. Podaj różnicę w punktach procentowych z 95% przedziałem ufności (metoda Newcombe’a), test chi-kwadrat lub z dla dwóch proporcji i dodatkowo iloraz szans. Równowagi grup po losowaniu nie sprawdzaj testami istotności, tylko pokaż rozkład cech w obu wersjach.
Czy deklarowany udział w głosowaniu to to samo co frekwencja?
Nie. W sondażach udział w głosowaniach bywa zawyżany, bo jest zachowaniem cenionym społecznie, a osoby zainteresowane sprawami publicznymi mogą chętniej odpowiadać na ankiety. W pracy pisz o deklarowanym udziale, a frekwencję z oficjalnych wyników podawaj osobno, ze źródłem i datą odczytu.
Czy w pracy z politologii mogę użyć danych z ESS albo PGSS?
Tak, wtórna analiza dużych sondaży jest dobrym tematem pracy. Pobierz dane razem z dokumentacją, użyj zalecanych wag, uwzględnij schemat losowania przy błędach standardowych i opisz dokładnie, które pytania i fale badania analizujesz. Najpierw sprawdź, czy pytania mierzą to, o co pytasz w swojej hipotezie.
Powiązane hasła
Przeczytaj też
Analiza danych z ESS, PGSS i Diagnozy Społecznej
Dostęp i rejestracja, wagi dweight, pspwght i anweight, warstwy i klastry, błędy standardowe ze schematu i regresja w R z wzorem opisu.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikStatystyka w pracy z socjologii
Sondaż, tabele krzyżowe z resztami, ważenie próby, regresja logistyczna z AME i skale postaw: plan analiz, APA, dane XLSX i kod R.
Czytaj →Piszesz pracę z administracji albo politologii i masz dane z ankiety lub o gminach?
Pomożemy ustalić jednostkę analizy, dobrać testy i modele, policzyć wyniki z wielkością efektu i wyjaśnić je tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Gaines, B. J., Kuklinski, J. H., & Quirk, P. J. (2007). The logic of the survey experiment reexamined. Political Analysis, 15(1), 1–20. https://doi.org/10.1093/pan/mpl008
- Hanmer, M. J., & Kalkan, K. O. (2013). Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models. American Journal of Political Science, 57(1), 263–277. https://doi.org/10.1111/j.1540-5907.2012.00602.x
- Mood, C. (2010). Logistic regression: Why we cannot do what we think we can do, and what we can do about it. European Sociological Review, 26(1), 67–82. https://doi.org/10.1093/esr/jcp006 ● Otwarty dostęp: pełny tekst
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351–357. https://doi.org/10.2307/2087176
- Schwartz, S. (1994). The fallacy of the ecological fallacy: The potential misuse of a concept and the consequences. American Journal of Public Health, 84(5), 819–824. https://doi.org/10.2105/ajph.84.5.819 ● Otwarty dostęp: pełny tekst
- Tourangeau, R., & Yan, T. (2007). Sensitive questions in surveys. Psychological Bulletin, 133(5), 859–883. https://doi.org/10.1037/0033-2909.133.5.859
- Van Ryzin, G. G. (2004). Expectations, performance, and citizen satisfaction with urban services. Journal of Policy Analysis and Management, 23(3), 433–448. https://doi.org/10.1002/pam.20020
Cytowania BibTeX
@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{gaines2007logic, author={Gaines, Brian J. and Kuklinski, James H. and Quirk, Paul J.}, title={{The logic of the survey experiment reexamined}}, journal={Political Analysis}, year={2007}, volume={15}, number={1}, pages={1--20}, doi={10.1093/pan/mpl008}}@article{hanmer2013behind, author={Hanmer, Michael J. and Kalkan, Kerem Ozan}, title={{Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models}}, journal={American Journal of Political Science}, year={2013}, volume={57}, number={1}, pages={263--277}, doi={10.1111/j.1540-5907.2012.00602.x}}@article{mood2010logistic, author={Mood, Carina}, title={{Logistic regression: Why we cannot do what we think we can do, and what we can do about it}}, journal={European Sociological Review}, year={2010}, volume={26}, number={1}, pages={67--82}, doi={10.1093/esr/jcp006}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{robinson1950ecological, author={Robinson, W. S.}, title={{Ecological correlations and the behavior of individuals}}, journal={American Sociological Review}, year={1950}, volume={15}, number={3}, pages={351--357}, doi={10.2307/2087176}}@article{schwartz1994fallacy, author={Schwartz, Sharon}, title={{The fallacy of the ecological fallacy: The potential misuse of a concept and the consequences}}, journal={American Journal of Public Health}, year={1994}, volume={84}, number={5}, pages={819--824}, doi={10.2105/ajph.84.5.819}}@article{tourangeau2007sensitive, author={Tourangeau, Roger and Yan, Ting}, title={{Sensitive questions in surveys}}, journal={Psychological Bulletin}, year={2007}, volume={133}, number={5}, pages={859--883}, doi={10.1037/0033-2909.133.5.859}}@article{vanryzin2004expectations, author={Van Ryzin, Gregg G.}, title={{Expectations, performance, and citizen satisfaction with urban services}}, journal={Journal of Policy Analysis and Management}, year={2004}, volume={23}, number={3}, pages={433--448}, doi={10.1002/pam.20020}}