Przykład: 40 salonów, 12 audytorów i rok wizyt
Fikcyjna sieć 40 salonów sprzedaży samochodów (cztery regiony po 10 salonów) zatrudnia 12 audytorów w roli klienta-tajemniczego (mystery shopping). Audytor udaje klienta zainteresowanego zakupem auta i po wizycie wypełnia listę kontrolną: 20 pozycji po 5 punktów, od „powitanie w ciągu 2 minut” po „telefon po wizycie w 48 h”. Wynik audytu ma skalę 0–100. Każdy salon dostaje 3 wizyty w kwartale, za każdym razem od innego audytora – w roku 12 wizyt, razem 480. Dyrekcja sprzedaży co kwartał publikuje ranking salonów i pyta: czy różnice w rankingu to różnice między salonami, czy między audytorami – i ile wizyt trzeba, żeby ranking był wiarygodny?
Wilson (2001) opisuje klienta-tajemniczego jako formę obserwacji uczestniczącej: badacz udaje klienta, a personel nie wie, że jest oceniany. Lista kontrolna wygląda na obiektywną, ale wypełnia ją człowiek – jeden audytor surowiej liczy minuty oczekiwania, inny łagodniej rozumie „pytania o potrzeby klienta”.
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy: prawdziwe różnice między salonami (SD = 0.55 w skali logitowej), surowość audytorów (SD = 0.35), wahania z wizyty na wizytę (SD = 0.45), trudność każdej z 20 pozycji (pięć pozycji prawie nikt nie oblewa) oraz to, że 80% wizyt robi jeden z trzech audytorów „swojego” regionu. Dwóm audytorom nadaliśmy wyraźny styl: A05 z regionu Południe jest bardzo surowy, A10 z regionu Zachód – łagodny. Ziarno 709 ustalono raz; parametrów danych nie zmienialiśmy po pierwszym uruchomieniu. Prawdziwy poziom salonów (oczekiwany wynik u przeciętnego audytora) wynosi od 54.1 do 90.0 punktu. Dane pobierzesz jako mystery-shopping-salony-dane.csv (wiersz = jedna wizyta, z wynikiem każdej pozycji 0/1).
Rysunek 1: kto odwiedza które salony
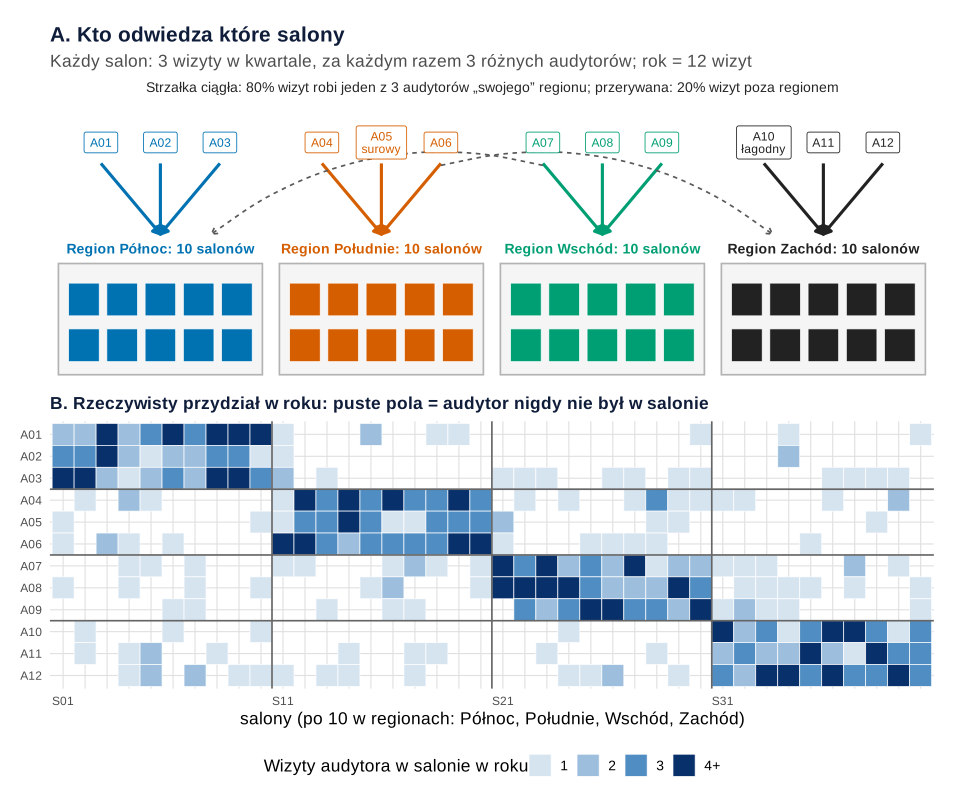
set.seed(709)).Co widać. Salon i audytor to czynniki skrzyżowane: każdy audytor odwiedza wiele salonów, każdy salon widzi wielu audytorów. Skrzyżowanie jest jednak częściowe. Z 480 możliwych par „audytor – salon” wystąpiło 233, a 72.7% wizyt zrobił audytor z regionu salonu. Cel 80% nie został osiągnięty, bo w jednym kwartale salon nie może dostać dwa razy tego samego audytora.
Jak może zmylić. Salony z Południa częściej widzą surowego A05, a z Zachodu – łagodnego A10; różnica regionów w surowej średniej udaje różnicę w obsłudze.
Podpis do pracy:
Zdanie do Metody:
Zgodność audytorów: model skrzyżowany i ICC
Wynik wizyty składa się z trzech części: poziomu salonu, surowości audytora i wszystkiego, co zmienia się z wizyty na wizytę (kto akurat obsługuje, pora dnia, przypadek). Rozdzieli je model mieszany ze skrzyżowanymi efektami losowymi w pakiecie lme4 (Bates i in., 2015). Kwartał wchodzi jako efekt stały, salon i audytor – jako efekty losowe:
To ten sam rachunek, który teoria generalizowalności nazywa badaniem G: komponenty wariancji szacuje się liniowym modelem mieszanym (Jiang, 2018). Finn (2001) pokazuje, że dla menedżerów taka perspektywa jest użyteczniejsza niż klasyczna teoria testów, bo od razu odpowiada na pytanie o liczbę wizyt.
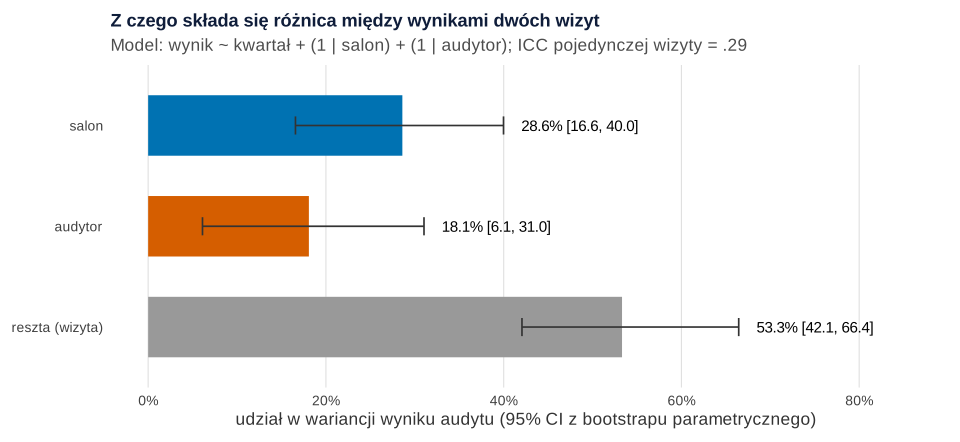
Co widać. Salony odpowiadają za 28.6% wariancji wyniku pojedynczej wizyty, audytorzy – za 18.1%, a reszta – za 53.3% (SD: 7.4, 5.9 i 10.1 punktu). Przedziały na rysunku pochodzą z bootstrapu parametrycznego (500 prób).
Z tych składowych liczysz dwa współczynniki ICC – dwie formy z klasyfikacji Shrouta i Fleissa (1979):
- ICC bezwzględnej zgodności pojedynczej wizyty = wariancja salonu / całość = .29, 95% CI [.17, .40]. Tak rzetelny jest wynik jednej wizyty, gdy nie wiesz, który audytor przyjdzie.
- ICC po korekcie audytora = wariancja salonu / (salon + reszta) = .35 [.22, .48]. Tak rzetelna byłaby wizyta, gdyby surowość audytora odjąć.
Według progów Koo i Li (2016) obie wartości oznaczają słabą rzetelność pojedynczej wizyty. Koo i Li zalecają też podawać model, typ i definicję ICC – tutaj model dwuczynnikowy z losowymi audytorami. Szerzej o wyborze miary piszemy w poradniku zgodność sędziów: kappa, ICC, alfa.
Jak może zmylić. Model bez audytora daje ICC = .32 – wyższe niż prawidłowe .29. Audytorzy pracują głównie w swoich regionach, więc ich surowość przykleja się do salonów i udaje różnice w jakości obsługi. Efekt audytora jest wyraźny: test ilorazu wiarygodności χ²(1) = 63.87, p < .001.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: efekt surowego audytora
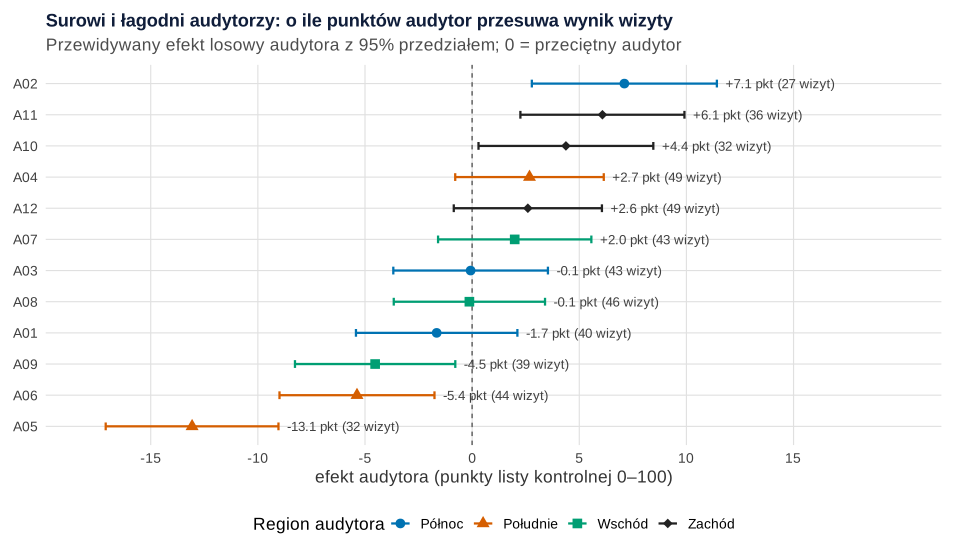
Co widać. Wykres gąsienicowy pokazuje, o ile punktów audytor przesuwa wynik wizyty względem przeciętnego audytora. A05 obniża wynik o 13.1 punktu, 95% przedział [−17.1, −9.0]; A02 podnosi go o 7.1 [2.8, 11.4]. Najsurowszego i najłagodniejszego dzieli 20.2 punktu – 2.7 razy więcej niż odchylenie standardowe prawdziwych różnic między salonami (7.4 punktu). Przedziały trzech audytorów leżą w całości poniżej zera, a trzech – powyżej. Oszacowania korelują z prawdziwą surowością na poziomie r = .94.
Jak może zmylić. Surowa średnia audytora A05 jest o 15.8 punktu niższa od średniej sieci, a model mówi o 13.1. Różnica to salony, które odwiedzał; model odróżnia je od surowości audytora dzięki wizytom innych audytorów. Efekty losowe są też ściągane do średniej.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: ranking surowy i skorygowany
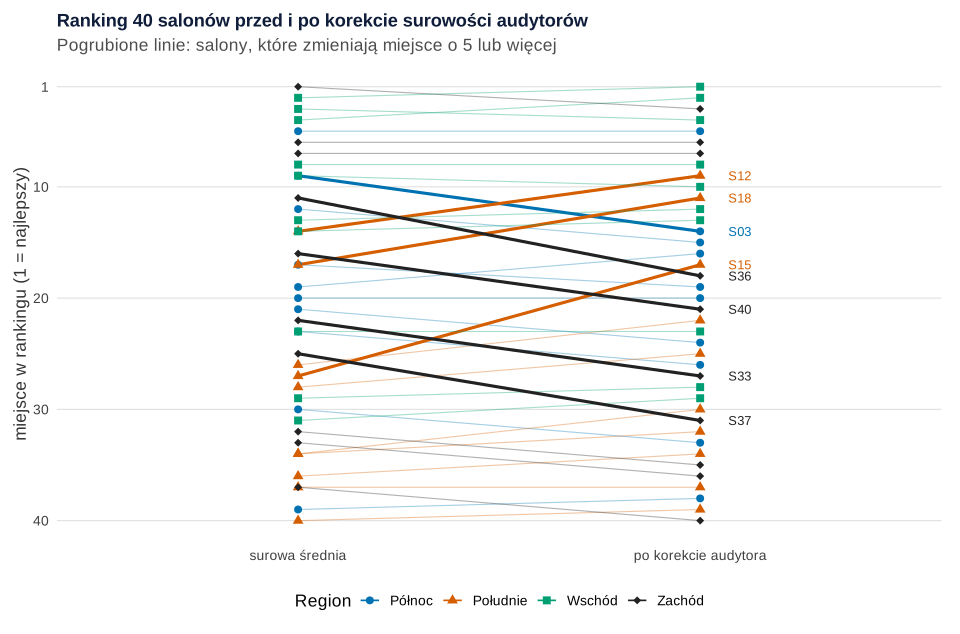
Co widać. Wynik skorygowany to przewidywanie modelu przy przeciętnym audytorze. Po korekcie salon zmienia miejsce średnio o 2.6 pozycji, najwięcej o 10, a osiem salonów – o 5 lub więcej. Salony z Południa zyskują średnio 3.7 miejsca, z Zachodu tracą 3.4. S15 miał w surowym rankingu 73.8 punktu i 27. miejsce; po korekcie – 77.8 punktu i 17. miejsce (prawdziwe: 14.). Jego audytorzy byli przeciętnie o 4.2 punktu surowsi od średniej. Takie „pechowe losowanie” wyjaśnia różnicę między wynikiem surowym a skorygowanym prawie w całości (r = .92).
Korekta poprawia zgodność całej listy z prawdą: korelacja rang Spearmana wynosi .84 dla surowej średniej i .89 dla wyniku skorygowanego. Wśród pięciu ostatnich salonów surowy ranking trafia w 3 prawdziwie najsłabsze, skorygowany – w 4.
Jak może zmylić. Korekta nie czyni rankingu pewnym. W prawdziwej pierwszej dziesiątce znalazło się 7 salonów z surowej dziesiątki i tylko 6 ze skorygowanej. Przy 12 wizytach o kolejności na szczycie decyduje też przypadek, a nie tylko audytor. Różnicę między oceną a pozycją na liście opisuje hasło ranking a ocena pozycji.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: ile wizyt potrzeba na rzetelną ocenę salonu
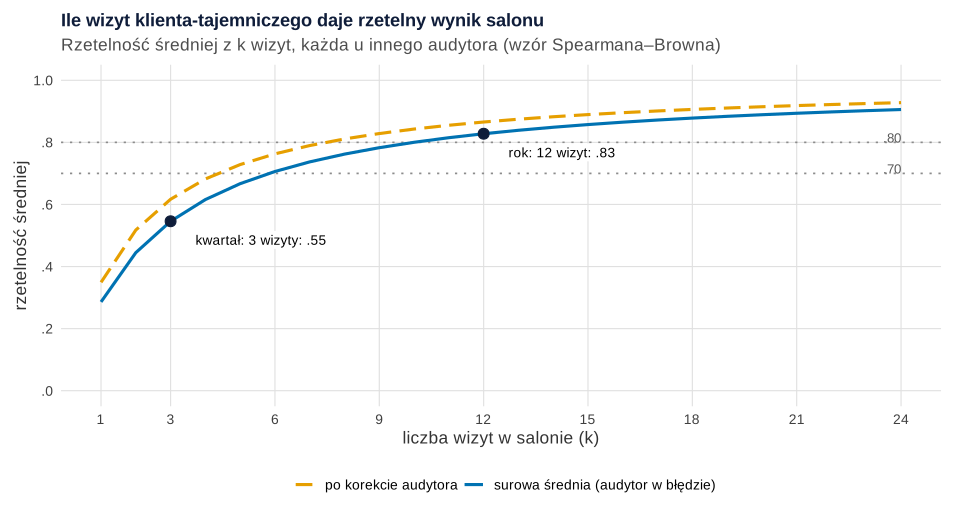
Co widać. Gdy każdą wizytę robi inny audytor, rzetelność średniej z k wizyt wynosi: wariancja salonu / [wariancja salonu + (audytor + reszta) / k]. To wzór Spearmana–Browna zastosowany do ICC = .29. Kwartalny wynik z 3 wizyt ma rzetelność .55, roczny z 12 wizyt – .83. Do .70 trzeba 6 wizyt, do .80 – 10, do .90 – 23. Gdyby surowość audytora odjąć, do .80 wystarczy 8 wizyt.
Sprawdzenie na danych. Rzetelność .55 to przewidywana korelacja wyników tego samego salonu z dwóch kwartałów. Średnia korelacja kwartałów w danych wynosi właśnie .55 (od .47 do .70). Prawie połowa zróżnicowania kwartalnych wyników to szum – dlatego salon, który był na dnie, w następnym kwartale zwykle wypada lepiej bez żadnej poprawy (regresja do średniej).
Jak może zmylić. Wzór zakłada, że audytorzy są losowani z tej samej puli, a salon się nie zmienia. Planowanie liczby wizyt w duchu badań D opisuje wpis teoria generalizowalności – badania G i D.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: pozycje listy, których nikt nie oblewa
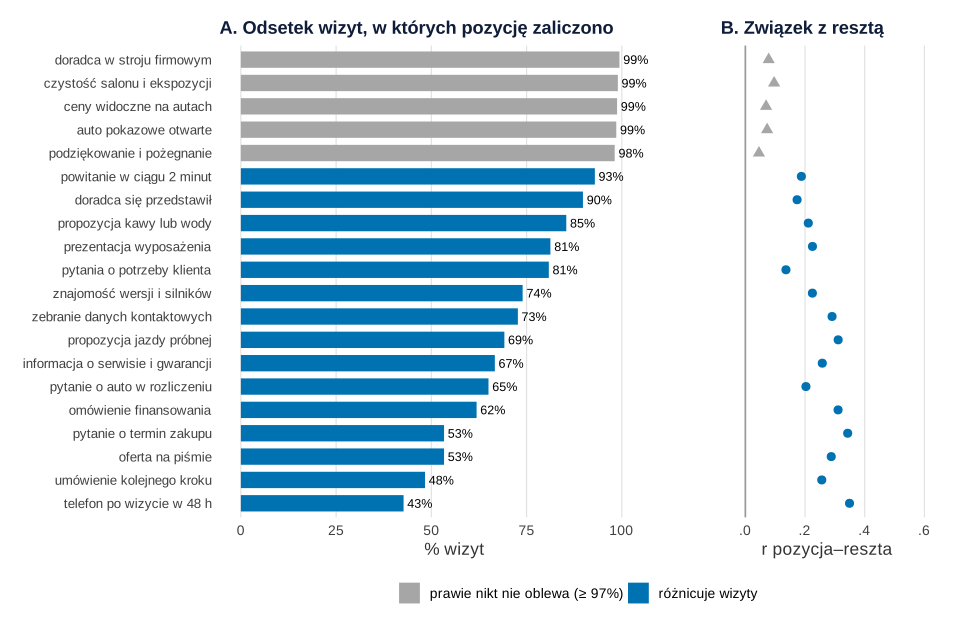
Co widać. Pięć pozycji zaliczono w 98.1–99.4% wizyt, a ich korelacja z resztą listy wynosi .05–.10. Razem dają średnio 24.7 z 76.6 punktu, a nic nie mówią o różnicach między salonami. Najwięcej informacji niosą pozycje trudne, np. telefon po wizycie.
Jak może zmylić. Te pozycje nie psują rankingu: wynik bez nich, przeskalowany do 0–100, koreluje z pełnym na poziomie .999 (średnie salonów), a ICC pojedynczej wizyty praktycznie się nie zmienia (.286 i .290). Psują interpretację: średnia spada z 76.6 do 69.2 punktu, a 24.0% wizyt z wynikiem 90+ wygląda na „prawie perfekcyjną obsługę”. To efekt sufitu na poziomie pozycji: lista mierzy podstawy, które wszyscy już opanowali.
Podpis do pracy:
Zdanie do Wyników:
Czy przydział „swoich” audytorów psuje ranking?
Zasymulowaliśmy 200 nowych sieci z losową surowością audytorów (bez ręcznych A05 i A10) dla dwóch schematów przydziału. W tabeli: średnia korelacja rang Spearmana z prawdziwym poziomem salonów (błąd Monte Carlo 0.002–0.003).
| Przydział | Surowa średnia | Po korekcie audytora | Korekta lepsza (% sieci) |
|---|---|---|---|
| regionalny (80% „swoich”) | .891 | .909 | 82.5% |
| losowy (każdy audytor równie często) | .902 | .912 | 76.5% |
Przydział regionalny obniża trafność surowego rankingu, a korekta odzyskuje stratę. Różnice są małe, bo surowość trzech losowych audytorów w regionie częściowo się znosi; duże są wtedy, gdy region obsługuje jeden wyraźnie surowy audytor, jak A05.
Co z tym zrobić w firmie
- Nie publikuj kwartalnego rankingu z 3 wizyt jako miejsca na liście. Przy rzetelności .55 pokazuj trzy grupy (wyraźnie powyżej, w normie, wyraźnie poniżej średniej sieci) albo średnią kroczącą z 4 kwartałów.
- Losuj audytorów między regionami. Każdy audytor powinien odwiedzić salony w każdym regionie – wtedy model oddzieli surowość od jakości salonu. Unikaj pracy jednego audytora w jednym regionie.
- Raz w roku sprawdź audytorów na wykresie gąsienicowym. Audytor z przedziałem daleko od zera (jak A05) potrzebuje szkolenia kalibracyjnego.
- Licz premie z wyniku skorygowanego – „pech w losowaniu” audytorów nie powinien kosztować premii.
- Przebuduj listę kontrolną. Pozycje zaliczane w 98% wizyt przenieś do krótkiej listy „warunków minimalnych”, a punkty daj zachowaniom, które różnicują salony.
- Zestaw wynik z innymi danymi. Blessing i Natter (2019) na danych z trzech sieci nie znaleźli wyraźnej korelacji ocen klientów-tajemniczych z ocenami prawdziwych klientów ani ze sprzedażą. Porównaj wynik audytu z ankietą klientów (SERVQUAL – luka między oczekiwaniami a oceną) i ze skargami na 1000 zamówień.
Jak opisać w pracy
W Metodzie opisz listę kontrolną, liczbę wizyt i audytorów, przydział i formę ICC. W Wynikach podaj komponenty wariancji z przedziałami, ICC pojedynczej wizyty i rzetelność średniej z tylu wizyt, ilu naprawdę używa firma. Inne tematy prac z tej dziedziny zbiera wpis statystyka w pracy z zarządzania i ekonomii, a ocenianie ludzi przez wielu oceniających – ocena 360 stopni.
Kod R: dane, model skrzyżowany, ranking i symulacja
Kod odtwarza wszystkie liczby z tekstu, tabelę i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, przepis 2 – model m, z którego korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane), 2 (bootstrap parametryczny) i 7 (symulacja 200 sieci dla każdego schematu); każdy losujący blok zaczyna od własnego set.seed(709). Ziarno 709 ustalono raz i nie zmieniano go. Ręcznie ustalono: 4 regiony po 10 salonów, 3 audytorów na region, 3 wizyty w kwartale przez 4 kwartały, 80% szans na audytora z regionu salonu, odchylenia standardowe w skali logitowej – salonów 0.55, audytorów 0.35, wizyt 0.45 – trudności 20 pozycji listy (pięć pozycji z trudnością 4.2–4.8, czyli zaliczanych prawie zawsze) oraz efekty dwóch audytorów: A05 = −0.80 (surowy) i A10 = +0.60 (łagodny). Po pierwszym uruchomieniu nie zmieniano parametrów danych; poprawiono tylko kolor regionu Zachód (z purpurowego na grafitowy – lepsza rozróżnialność przy deuteranopii) i zakres osi na rysunku 3.
1. Paleta, dane i rysunek 1
R
# Rysunek 1. Fikcyjna sieć 40 salonów samochodowych: klient-tajemniczy, 12 audytorów, rok wizyt (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol_region <- c("Północ" = "#0072B2", "Południe" = "#D55E00", "Wschód" = "#009E73", "Zachód" = "#222222")
kol_skladowa <- c("salon" = "#0072B2", "audytor" = "#D55E00", "reszta (wizyta)" = "grey60")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie
regiony <- names(kol_region)
S <- 40; A <- 12; K <- 4; wizyt_w_kwartale <- 3        # 40 salonów, 12 audytorów, 4 kwartały, 3 wizyty
salony <- data.frame(salon = sprintf("S%02d", 1:S), region = rep(regiony, each = 10))
audytorzy <- data.frame(audytor = sprintf("A%02d", 1:A), region = rep(regiony, each = 3))
p_swoj <- 0.80          # 80% wizyt robi audytor z regionu salonu (przydział niezrównoważony)
sd_salon <- 0.55        # prawdziwe różnice między salonami (skala logitowa)
sd_audytor <- 0.35      # surowość/łagodność audytorów
sd_wizyta <- 0.45       # wahania z wizyty na wizytę (kto akurat obsługuje, pora dnia)
# Lista kontrolna: 20 pozycji po 5 punktów (wynik 0–100); trudność = logit zaliczenia u przeciętnego salonu
pozycje <- data.frame(
  pozycja = c("czystość salonu i ekspozycji", "ceny widoczne na autach", "doradca w stroju firmowym",
              "auto pokazowe otwarte", "podziękowanie i pożegnanie",
              "powitanie w ciągu 2 minut", "doradca się przedstawił", "propozycja kawy lub wody",
              "pytania o potrzeby klienta", "prezentacja wyposażenia", "znajomość wersji i silników",
              "propozycja jazdy próbnej", "pytanie o auto w rozliczeniu", "omówienie finansowania",
              "oferta na piśmie", "informacja o serwisie i gwarancji", "pytanie o termin zakupu",
              "zebranie danych kontaktowych", "umówienie kolejnego kroku", "telefon po wizycie w 48 h"),
  trudnosc = c(4.6, 4.4, 4.8, 4.2, 4.5,
               2.4, 2.1, 1.6, 1.4, 1.5, 1.1, 0.6, 0.3, 0.2, 0.0, 0.5, -0.1, 0.8, -0.3, -0.6))
pozycje$latwa <- seq_len(nrow(pozycje)) <= 5          # 5 pozycji, których prawie nikt nie oblewa

set.seed(709)                                          # ziarno ustalone raz, bez dobierania pod wynik
salony$efekt <- rnorm(S, 0, sd_salon)
audytorzy$efekt <- rnorm(A, 0, sd_audytor)
audytorzy$efekt[audytorzy$audytor == "A05"] <- -0.80   # ręcznie: bardzo surowy audytor z regionu Południe
audytorzy$efekt[audytorzy$audytor == "A10"] <- 0.60    # ręcznie: łagodny audytor z regionu Zachód
# Przydział: w każdym kwartale 3 różnych audytorów na salon, 80% szans na „swojego” z regionu
wizyty <- do.call(rbind, lapply(1:S, function(s) do.call(rbind, lapply(1:K, function(k) {
  swoj <- audytorzy$region == salony$region[s]
  w <- ifelse(swoj, p_swoj / 3, (1 - p_swoj) / 9)
  data.frame(salon = salony$salon[s], region = salony$region[s], kwartal = paste0("Q", k),
             audytor = sample(audytorzy$audytor, wizyt_w_kwartale, prob = w))
}))))
wizyty$wizyta <- sprintf("W%03d", seq_len(nrow(wizyty)))
wizyty$efekt_wizyty <- rnorm(nrow(wizyty), 0, sd_wizyta)
eta <- outer(salony$efekt[match(wizyty$salon, salony$salon)] + audytorzy$efekt[match(wizyty$audytor, audytorzy$audytor)] +
             wizyty$efekt_wizyty, pozycje$trudnosc, "+")       # logit zaliczenia: wizyta × pozycja
zal <- matrix(rbinom(length(eta), 1, plogis(eta)), nrow(eta))   # 1 = pozycja zaliczona
colnames(zal) <- sprintf("p%02d", 1:20)
wizyty$wynik <- 5 * rowSums(zal)                                # wynik audytu 0–100
# Prawdziwy poziom salonu: oczekiwany wynik u przeciętnego audytora (wahania wizyty uśrednione)
v <- qnorm(ppoints(200), 0, sd_wizyta)
salony$prawda <- sapply(salony$efekt, function(u) 5 * sum(sapply(pozycje$trudnosc, function(b) mean(plogis(u + b + v)))))

dane <- cbind(wizyty[, c("wizyta", "salon", "region", "kwartal", "audytor", "wynik")], zal)
write.csv(dane, "mystery-shopping-salony-dane.csv", row.names = FALSE)

c(salony = S, audytorzy = A, wizyty = nrow(dane))
round(c(srednia = mean(dane$wynik), sd = sd(dane$wynik), min = min(dane$wynik), max = max(dane$wynik)), 1)
round(quantile(salony$prawda, c(0, .5, 1)), 1)                 # prawdziwe poziomy salonów
liczba <- table(audytor = dane$audytor, salon = dane$salon)
c(par_audytor_salon = sum(liczba > 0), z_wszystkich = length(liczba))
mean(audytorzy$region[match(dane$audytor, audytorzy$audytor)] == dane$region)  # odsetek wizyt „swojego” audytora
table(wizyty_audytora = rowSums(liczba))
round(audytorzy$efekt, 2)

# Rysunek 1. Grafika: przydział audytorów do salonów (A) i liczba wizyt w roku (B)
rx <- c(1, 3.6, 6.2, 8.8)                                          # środki regionów
sal_xy <- data.frame(region = rep(regiony, each = 10), x = rep(rx, each = 10) + rep(seq(-0.9, 0.9, length.out = 5), 8),
                     y = rep(rep(c(1.2, 0.5), each = 5), 4))
aud_xy <- data.frame(audytor = audytorzy$audytor, region = audytorzy$region,
                     x = rep(rx, each = 3) + rep(c(-0.7, 0, 0.7), 4), y = 3.6)
aud_xy$opis <- ifelse(aud_xy$audytor == "A05", "A05\nsurowy", ifelse(aud_xy$audytor == "A10", "A10\nłagodny", aud_xy$audytor))
pA <- ggplot() +
  annotate("rect", xmin = rx - 1.2, xmax = rx + 1.2, ymin = 0.05, ymax = 1.75, fill = "grey96", colour = "grey70") +
  annotate("text", x = rx, y = 1.98, label = paste0("Region ", regiony, ": 10 salonów"), size = 3.7, fontface = "bold",
           colour = kol_region) +
  geom_segment(data = aud_xy, aes(x = x, y = y - 0.32, xend = rep(rx, each = 3), yend = 2.2, colour = region),
               linewidth = 1.1, arrow = arrow(length = unit(2.2, "mm"), type = "closed"), show.legend = FALSE) +
  annotate("curve", x = rx[2] + 0.7, y = 3.25, xend = rx[4] - 0.6, yend = 2.2, curvature = -0.25, linetype = "22",
           colour = "grey35", linewidth = 0.6, arrow = arrow(length = unit(1.8, "mm"))) +
  annotate("curve", x = rx[3] - 0.7, y = 3.25, xend = rx[1] + 0.6, yend = 2.2, curvature = 0.25, linetype = "22",
           colour = "grey35", linewidth = 0.6, arrow = arrow(length = unit(1.8, "mm"))) +
  geom_tile(data = sal_xy, aes(x, y, fill = region), width = 0.36, height = 0.5, colour = "white", show.legend = FALSE) +
  geom_label(data = aud_xy, aes(x, y, label = opis, colour = region), size = 3.2, lineheight = 0.85, fill = "white",
             label.padding = unit(1.6, "mm"), show.legend = FALSE) +
  annotate("text", x = 4.9, y = 4.45, size = 3.7, colour = "grey15",
           label = "Strzałka ciągła: 80% wizyt robi jeden z 3 audytorów „swojego” regionu; przerywana: 20% wizyt poza regionem") +
  scale_fill_manual(values = kol_region) + scale_colour_manual(values = kol_region) +
  coord_cartesian(xlim = c(-0.3, 10.1), ylim = c(0, 4.7), expand = FALSE) +
  labs(title = "A. Kto odwiedza które salony", subtitle = "Każdy salon: 3 wizyty w kwartale, za każdym razem 3 różnych audytorów; rok = 12 wizyt") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(8, 10, 4, 10))
siatka <- as.data.frame(liczba)
siatka$region_salonu <- salony$region[match(siatka$salon, salony$salon)]
siatka$audytor <- factor(siatka$audytor, levels = rev(audytorzy$audytor))
pB <- ggplot(subset(siatka, Freq > 0), aes(salon, audytor, fill = factor(pmin(Freq, 4)))) +
  geom_tile(colour = "white") +
  geom_vline(xintercept = c(10.5, 20.5, 30.5), colour = "grey40") + geom_hline(yintercept = c(3.5, 6.5, 9.5), colour = "grey40") +
  scale_fill_manual(values = c("1" = "#D6E4F0", "2" = "#9DBFDD", "3" = "#4F8DC2", "4" = "#08306B"),
                    labels = c("1", "2", "3", "4+"), name = "Wizyty audytora w salonie w roku") +
  scale_x_discrete(labels = function(x) ifelse(x %in% c("S01", "S11", "S21", "S31"), x, "")) +
  labs(title = "B. Rzeczywisty przydział w roku: puste pola = audytor nigdy nie był w salonie", x = "salony (po 10 w regionach: Północ, Południe, Wschód, Zachód)",
       y = NULL) +
  motyw + theme(panel.grid = element_blank(), axis.text.y = element_text(size = 9), axis.text.x = element_text(size = 9))
p1 <- pA / pB + plot_layout(heights = c(1.15, 1))
p1   # zapis: ggsave("mystery-shopping-przydzial-audytorow.svg", p1, width = 10, height = 8.4)
Wynik w R
   salony audytorzy    wizyty
       40        12       480
srednia      sd     min     max
   76.6    13.5    35.0   100.0
  0%  50% 100%
54.1 75.4 90.0
par_audytor_salon      z_wszystkich
              233               480
[1] 0.7270833
wizyty_audytora
27 32 36 39 40 43 44 46 49
 1  2  1  1  1  2  1  1  2
 [1] -0.13  0.51  0.19  0.11 -0.80 -0.34 -0.08 -0.11 -0.27  0.60  0.59  0.27
2. Model skrzyżowany, udziały wariancji i ICC (rysunek 2)
R
# Zgodność audytorów: udział wariancji salonu, audytora i reszty w modelu skrzyżowanym (dane z przepisu 1)
library(lme4)
dane$kwartal <- factor(dane$kwartal)
m <- lmer(wynik ~ kwartal + (1 | salon) + (1 | audytor), data = dane, REML = TRUE)
print(VarCorr(m), comp = c("Variance", "Std.Dev."))
round(fixef(m), 2)

udzialy <- function(model) {                         # udziały składowych w wariancji pojedynczej wizyty
  vc <- as.data.frame(VarCorr(model))
  v <- setNames(vc$vcov, vc$grp)
  c(salon = v[["salon"]], audytor = v[["audytor"]], reszta = v[["Residual"]]) / sum(v)
}
icc <- function(model) {
  vc <- as.data.frame(VarCorr(model)); v <- setNames(vc$vcov, vc$grp)
  c(ICC_bezwzgledna = v[["salon"]] / sum(v),                         # audytor losowy, nieznany: ICC(A,1)
    ICC_po_korekcie_audytora = v[["salon"]] / (v[["salon"]] + v[["Residual"]]))  # gdy efekt audytora odjęty
}
round(100 * udzialy(m), 1)
round(icc(m), 3)

# 95% przedziały z bootstrapu parametrycznego (500 prób, własne ziarno)
set.seed(709)
b <- bootMer(m, function(x) c(udzialy(x), icc(x)), nsim = 500, type = "parametric")
ci <- apply(b$t, 2, quantile, c(.025, .975), na.rm = TRUE)
round(ci, 3)

# Dla porównania: model bez audytora (jednoczynnikowy) – audytor „chowa się” w reszcie
m0 <- lmer(wynik ~ kwartal + (1 | salon), data = dane, REML = TRUE)
vc0 <- as.data.frame(VarCorr(m0))$vcov
round(c(ICC_bez_audytora = vc0[1] / sum(vc0)), 3)
anova(m0, m, refit = FALSE)                              # test ilorazu wiarygodności dla efektu audytora (REML)

# Rysunek 2. Udział składowych w wariancji wyniku pojedynczej wizyty
d2 <- data.frame(skladowa = factor(names(kol_skladowa), levels = rev(names(kol_skladowa))),
                 udzial = 100 * udzialy(m), dol = 100 * ci[1, 1:3], gora = 100 * ci[2, 1:3])
p2 <- ggplot(d2, aes(udzial, skladowa, fill = skladowa)) +
  geom_col(width = 0.6, show.legend = FALSE) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.18, orientation = "y", colour = "grey20") +
  geom_text(aes(x = gora + 2, label = sprintf("%.1f%%  [%.1f, %.1f]", udzial, dol, gora)), hjust = 0, size = 4) +
  scale_fill_manual(values = kol_skladowa) +
  scale_x_continuous(limits = c(0, 85), breaks = seq(0, 80, 20), labels = function(x) paste0(x, "%")) +
  labs(title = "Z czego składa się różnica między wynikami dwóch wizyt",
       subtitle = sprintf("Model: wynik ~ kwartał + (1 | salon) + (1 | audytor); ICC pojedynczej wizyty = %s",
                          sub("^0", "", sprintf("%.2f", icc(m)[1]))),
       x = "udział w wariancji wyniku audytu (95% CI z bootstrapu parametrycznego)", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank())
p2   # zapis: ggsave("mystery-shopping-udzial-wariancji.svg", p2, width = 10, height = 4.6)
Wynik w R
 Groups   Name        Variance Std.Dev.
 salon    (Intercept)  54.559   7.3864
 audytor  (Intercept)  34.496   5.8733
 Residual             101.706  10.0849
(Intercept)   kwartalQ2   kwartalQ3   kwartalQ4
      77.35       -0.92       -0.37       -1.83
  salon audytor  reszta
   28.6    18.1    53.3
         ICC_bezwzgledna ICC_po_korekcie_audytora
                   0.286                    0.349
      salon audytor reszta ICC_bezwzgledna ICC_po_korekcie_audytora
2.5%  0.166   0.061  0.421           0.166                    0.221
97.5% 0.400   0.310  0.664           0.400                    0.476
ICC_bez_audytora
           0.323
Data: dane
Models:
m0: wynik ~ kwartal + (1 | salon)
m: wynik ~ kwartal + (1 | salon) + (1 | audytor)
   npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m0    6 3751.8 3776.9 -1869.9    3739.8
m     7 3689.9 3719.2 -1838.0    3675.9 63.869  1   1.33e-15 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
3. Wykres gąsienicowy audytorów (rysunek 3)
R
# Efekt surowego audytora: efekty losowe audytorów z przedziałami (model m z przepisu 2)
re <- ranef(m, condVar = TRUE)$audytor
se <- sqrt(attr(re, "postVar")[1, 1, ])
aud <- data.frame(audytor = rownames(re), efekt = re[, 1], se = se,
                  prawda_logit = audytorzy$efekt[match(rownames(re), audytorzy$audytor)],
                  region = audytorzy$region[match(rownames(re), audytorzy$audytor)],
                  wizyty = as.vector(table(dane$audytor)[rownames(re)]))
aud$dol <- aud$efekt - 1.96 * aud$se; aud$gora <- aud$efekt + 1.96 * aud$se
aud <- aud[order(aud$efekt), ]
print(transform(aud[, c("audytor", "region", "wizyty")], efekt = round(aud$efekt, 1), dol = round(aud$dol, 1),
                gora = round(aud$gora, 1), prawda_logit = round(aud$prawda_logit, 2)), row.names = FALSE)
round(c(r_z_prawda = cor(aud$efekt, aud$prawda_logit), roznica_skrajnych = diff(range(aud$efekt))), 2)
c(przedzial_ponizej_zera = sum(aud$gora < 0), powyzej_zera = sum(aud$dol > 0))

# Średnie surowe audytorów też się różnią – ale część różnic to salony, do których trafili
sr_sur <- tapply(dane$wynik, dane$audytor, mean)
round(sort(sr_sur - mean(dane$wynik)), 1)

# Rysunek 3. Wykres gąsienicowy audytorów
aud$audytor <- factor(aud$audytor, levels = aud$audytor)
p3 <- ggplot(aud, aes(efekt, audytor)) +
  geom_vline(xintercept = 0, colour = "grey45", linetype = "22") +
  geom_errorbar(aes(xmin = dol, xmax = gora, colour = region), width = 0.25, linewidth = 0.8, orientation = "y") +
  geom_point(aes(colour = region, shape = region), size = 3) +
  geom_text(aes(x = gora + 0.4, label = paste0(sprintf("%+.1f", efekt), " pkt (", wizyty, " wizyt)")),
            hjust = 0, size = 3.5, colour = "grey25") +
  scale_colour_manual(values = kol_region, name = "Region audytora") +
  scale_shape_manual(values = c(16, 17, 15, 18), name = "Region audytora") +
  scale_x_continuous(limits = c(-18, 20), breaks = seq(-15, 15, 5)) +
  labs(title = "Surowi i łagodni audytorzy: o ile punktów audytor przesuwa wynik wizyty",
       subtitle = "Przewidywany efekt losowy audytora z 95% przedziałem; 0 = przeciętny audytor",
       x = "efekt audytora (punkty listy kontrolnej 0–100)", y = NULL) +
  motyw
p3   # zapis: ggsave("mystery-shopping-wykres-gasienicowy-audytorow.svg", p3, width = 10, height = 5.6)
Wynik w R
 audytor   region wizyty efekt   dol gora prawda_logit
     A05 Południe     32 -13.1 -17.1 -9.0        -0.80
     A06 Południe     44  -5.4  -9.0 -1.8        -0.34
     A09   Wschód     39  -4.5  -8.3 -0.8        -0.27
     A01   Północ     40  -1.7  -5.4  2.1        -0.13
     A08   Wschód     46  -0.1  -3.7  3.4        -0.11
     A03   Północ     43  -0.1  -3.7  3.5         0.19
     A07   Wschód     43   2.0  -1.6  5.6        -0.08
     A12   Zachód     49   2.6  -0.9  6.1         0.27
     A04 Południe     49   2.7  -0.8  6.1         0.11
     A10   Zachód     32   4.4   0.3  8.5         0.60
     A11   Zachód     36   6.1   2.3  9.9         0.59
     A02   Północ     27   7.1   2.8 11.4         0.51
       r_z_prawda roznica_skrajnych
             0.94             20.17
przedzial_ponizej_zera           powyzej_zera
                     3                      3
  A05   A06   A01   A09   A03   A12   A04   A08   A07   A10   A11   A02
-15.8  -8.1  -2.8  -1.0  -0.4   1.3   2.0   2.7   3.8   5.2   6.1   7.3
4. Ranking surowy i skorygowany (rysunek 4)
R
# Ranking salonów: surowa średnia z 12 wizyt vs wynik skorygowany o audytora (model m z przepisu 2)
sal <- data.frame(salon = salony$salon, region = salony$region, prawda = salony$prawda,
                  surowy = as.vector(tapply(dane$wynik, dane$salon, mean)[salony$salon]))
# wynik skorygowany: średnia przewidywań dla salonu przy przeciętnym audytorze, uśredniona po kwartałach
sal$skorygowany <- sapply(sal$salon, function(s)
  mean(predict(m, newdata = data.frame(salon = s, kwartal = levels(dane$kwartal)), re.form = ~ (1 | salon))))
# „pech w losowaniu”: średni efekt audytorów, którzy odwiedzili salon
ef_aud <- setNames(ranef(m)$audytor[, 1], rownames(ranef(m)$audytor))
sal$sredni_efekt_audytorow <- as.vector(tapply(ef_aud[dane$audytor], dane$salon, mean)[sal$salon])
sal$miejsce_surowe <- rank(-sal$surowy, ties.method = "min")
sal$miejsce_skor <- rank(-sal$skorygowany, ties.method = "min")
sal$miejsce_prawda <- rank(-sal$prawda)
sal$zmiana <- sal$miejsce_surowe - sal$miejsce_skor              # dodatnia = awans po korekcie

round(c(spearman_surowy_prawda = cor(sal$surowy, sal$prawda, method = "spearman"),
        spearman_skor_prawda = cor(sal$skorygowany, sal$prawda, method = "spearman"),
        r_pech_a_roznica = cor(sal$sredni_efekt_audytorow, sal$surowy - sal$skorygowany)), 2)
round(c(srednia_zmiana_miejsca = mean(abs(sal$zmiana)), max_zmiana = max(abs(sal$zmiana)),
        zmiana_o_5_lub_wiecej = sum(abs(sal$zmiana) >= 5)), 2)
top10 <- function(x) sal$salon[rank(-x, ties.method = "first") <= 10]
c(top10_surowy_w_prawdziwej = length(intersect(top10(sal$surowy), top10(sal$prawda))),
  top10_skor_w_prawdziwej = length(intersect(top10(sal$skorygowany), top10(sal$prawda))))
print(aggregate(cbind(zmiana, sredni_efekt_audytorow) ~ region, sal, function(x) round(mean(x), 2)), row.names = FALSE)
print(head(sal[order(-abs(sal$zmiana)), c("salon", "region", "surowy", "skorygowany", "miejsce_surowe",
                                           "miejsce_skor", "miejsce_prawda", "sredni_efekt_audytorow")], 6),
      digits = 3, row.names = FALSE)
# Ostatnie miejsca: kogo „ukarałby” surowy ranking
sal$salon[sal$miejsce_surowe > 35]; sal$salon[sal$miejsce_skor > 35]; sal$salon[sal$miejsce_prawda > 35]

# Rysunek 4. Miejsce w rankingu: surowym i po korekcie
d4 <- rbind(data.frame(salon = sal$salon, region = sal$region, ranking = "surowa średnia", miejsce = sal$miejsce_surowe),
            data.frame(salon = sal$salon, region = sal$region, ranking = "po korekcie audytora", miejsce = sal$miejsce_skor))
d4$ranking <- factor(d4$ranking, levels = c("surowa średnia", "po korekcie audytora"))
duze <- sal$salon[abs(sal$zmiana) >= 5]
p4 <- ggplot(d4, aes(ranking, miejsce, group = salon, colour = region)) +
  geom_line(aes(alpha = salon %in% duze, linewidth = salon %in% duze)) +
  geom_point(aes(shape = region), size = 2.4) +
  geom_text(data = subset(d4, salon %in% duze & ranking == "po korekcie audytora"),
            aes(label = salon), nudge_x = 0.07, hjust = 0, size = 3.4, show.legend = FALSE) +
  scale_y_reverse(breaks = c(1, 10, 20, 30, 40)) +
  scale_alpha_manual(values = c(0.35, 1), guide = "none") + scale_linewidth_manual(values = c(0.4, 1.1), guide = "none") +
  scale_colour_manual(values = kol_region, name = "Region") + scale_shape_manual(values = c(16, 17, 15, 18), name = "Region") +
  labs(title = "Ranking 40 salonów przed i po korekcie surowości audytorów",
       subtitle = "Pogrubione linie: salony, które zmieniają miejsce o 5 lub więcej", x = NULL, y = "miejsce w rankingu (1 = najlepszy)") +
  motyw + theme(panel.grid.major.x = element_blank())
p4   # zapis: ggsave("mystery-shopping-ranking-salonow.svg", p4, width = 10, height = 6.2)
Wynik w R
spearman_surowy_prawda   spearman_skor_prawda       r_pech_a_roznica
                  0.84                   0.89                   0.92
srednia_zmiana_miejsca             max_zmiana  zmiana_o_5_lub_wiecej
                   2.6                   10.0                    8.0
top10_surowy_w_prawdziwej   top10_skor_w_prawdziwej
                        7                         6
   region zmiana sredni_efekt_audytorow
   Północ   -1.5                   1.09
 Południe    3.7                  -3.26
   Wschód    0.6                  -0.90
   Zachód   -3.4                   2.97
 salon   region surowy skorygowany miejsce_surowe miejsce_skor miejsce_prawda
   S15 Południe   73.8        77.8             27           17             14
   S36   Zachód   81.2        77.5             11           18             25
   S18 Południe   78.3        81.0             17           11             10
   S37   Zachód   74.6        72.3             25           31             26
   S03   Północ   81.7        80.2              9           14              9
   S12 Południe   79.6        82.6             14            9             11
 sredni_efekt_audytorow
                 -4.228
                  3.556
                 -3.407
                  2.930
                  0.909
                 -4.001
[1] "S10" "S11" "S17" "S20" "S39"
[1] "S10" "S17" "S20" "S35" "S39"
[1] "S10" "S17" "S34" "S35" "S39"
5. Ile wizyt potrzeba – Spearman–Brown (rysunek 5)
R
# Ile wizyt potrzeba na rzetelną ocenę salonu? Spearman–Brown z komponentów wariancji (model m z przepisu 2)
vc <- as.data.frame(VarCorr(m)); v <- setNames(vc$vcov, vc$grp)
rzet <- function(k, korekta = FALSE) {               # rzetelność średniej z k wizyt, każda u innego audytora
  blad <- if (korekta) v[["Residual"]] else v[["audytor"]] + v[["Residual"]]
  v[["salon"]] / (v[["salon"]] + blad / k)
}
icc1 <- rzet(1)
sb <- function(k, r1) k * r1 / (1 + (k - 1) * r1)     # wzór Spearmana–Browna: to samo co rzet()
round(c(k1 = rzet(1), k3_kwartal = rzet(3), k6 = rzet(6), k12_rok = rzet(12), sb_k3 = sb(3, icc1)), 3)
ile <- function(cel, korekta = FALSE) min(which(sapply(1:100, rzet, korekta = korekta) >= cel))
c(do_70 = ile(.70), do_80 = ile(.80), do_90 = ile(.90), do_80_po_korekcie = ile(.80, TRUE))
round(c(k3_po_korekcie = rzet(3, TRUE), k12_po_korekcie = rzet(12, TRUE)), 3)

# Sprawdzenie na danych: korelacja średnich salonów z dwóch różnych kwartałów (po 3 wizyty)
kw <- tapply(dane$wynik, list(dane$salon, dane$kwartal), mean)
r_kw <- cor(kw)
round(r_kw, 2)
round(c(srednia_korelacja_kwartalow = mean(r_kw[upper.tri(r_kw)]), przewidziana_k3 = rzet(3)), 2)

# Rysunek 5. Rzetelność średniej z k wizyt
d5 <- rbind(data.frame(k = 1:24, r = sapply(1:24, rzet), wariant = "surowa średnia (audytor w błędzie)"),
            data.frame(k = 1:24, r = sapply(1:24, rzet, korekta = TRUE), wariant = "po korekcie audytora"))
pkt <- data.frame(k = c(3, 12), r = rzet(c(3, 12)), etykieta = c("kwartał: 3 wizyty", "rok: 12 wizyt"))
p5 <- ggplot(d5, aes(k, r, colour = wariant, linetype = wariant)) +
  geom_hline(yintercept = c(.7, .8), colour = "grey55", linetype = "13") +
  annotate("text", x = 24, y = c(.7, .8) + .015, label = c(".70", ".80"), hjust = 1, size = 3.5, colour = "grey35") +
  geom_line(linewidth = 1.1) +
  geom_point(data = pkt, aes(k, r), inherit.aes = FALSE, size = 3.4, colour = "#0f1d3a") +
  geom_label(data = pkt, aes(k, r, label = paste0(etykieta, ": ", sub("^0", "", sprintf("%.2f", r)))),
             inherit.aes = FALSE, nudge_x = 0.6, nudge_y = -0.06, hjust = 0, size = 3.6, linewidth = 0) +
  scale_colour_manual(values = c("surowa średnia (audytor w błędzie)" = "#0072B2", "po korekcie audytora" = "#E69F00"), name = NULL) +
  scale_linetype_manual(values = c("surowa średnia (audytor w błędzie)" = "solid", "po korekcie audytora" = "42"), name = NULL) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, .2), labels = function(x) sub("^0", "", sprintf("%.1f", x))) +
  scale_x_continuous(breaks = c(1, 3, 6, 9, 12, 15, 18, 21, 24)) +
  labs(title = "Ile wizyt klienta-tajemniczego daje rzetelny wynik salonu",
       subtitle = "Rzetelność średniej z k wizyt, każda u innego audytora (wzór Spearmana–Browna)",
       x = "liczba wizyt w salonie (k)", y = "rzetelność średniej") +
  motyw
p5   # zapis: ggsave("mystery-shopping-ile-wizyt.svg", p5, width = 10, height = 5.4)
Wynik w R
        k1 k3_kwartal         k6    k12_rok      sb_k3
     0.286      0.546      0.706      0.828      0.546
            do_70             do_80             do_90 do_80_po_korekcie
                6                10                23                 8
 k3_po_korekcie k12_po_korekcie
          0.617           0.866
     Q1   Q2   Q3   Q4
Q1 1.00 0.53 0.70 0.47
Q2 0.53 1.00 0.54 0.50
Q3 0.70 0.54 1.00 0.56
Q4 0.47 0.50 0.56 1.00
srednia_korelacja_kwartalow             przewidziana_k3
                       0.55                        0.55
6. Pozycje listy kontrolnej (rysunek 6)
R
# Pozycje listy kontrolnej: które coś różnicują, a których nikt nie oblewa (dane z przepisu 1)
zal_cols <- sprintf("p%02d", 1:20)
X <- as.matrix(dane[, zal_cols])
odsetek <- colMeans(X)
r_reszta <- sapply(seq_along(zal_cols), function(j) cor(X[, j], rowSums(X[, -j])))   # korelacja pozycja–reszta
# Na poziomie salonów: na ile pozycja różnicuje salony (SD odsetka zaliczeń między salonami)
sd_salony <- apply(apply(X, 2, function(x) tapply(x, dane$salon, mean)), 2, sd)
tab <- data.frame(pozycja = pozycje$pozycja, odsetek = round(100 * odsetek, 1), r_reszta = round(r_reszta, 2),
                  sd_miedzy_salonami = round(100 * sd_salony, 1))
print(tab[order(-tab$odsetek), ], row.names = FALSE)
nikt <- odsetek >= .97
c(pozycji_97_proc = sum(nikt), punktow_z_tych_pozycji = round(mean(5 * rowSums(X[, nikt])), 1))

# Wynik bez „pozycji, których nikt nie oblewa”, przeskalowany do 0–100
wynik15 <- 100 * rowSums(X[, !nikt]) / sum(!nikt)
round(c(srednia_20 = mean(dane$wynik), srednia_15 = mean(wynik15),
        r_wizyty = cor(dane$wynik, wynik15),
        r_salony = cor(tapply(dane$wynik, dane$salon, mean), tapply(wynik15, dane$salon, mean))), 3)
m15 <- lmer(wynik15 ~ kwartal + (1 | salon) + (1 | audytor), data = cbind(dane, wynik15 = wynik15))
vc15 <- as.data.frame(VarCorr(m15)); v15 <- setNames(vc15$vcov, vc15$grp)
round(c(ICC_20_pozycji = icc(m)[[1]], ICC_15_pozycji = v15[["salon"]] / sum(v15)), 3)
mean(dane$wynik >= 90)                                    # odsetek wizyt z wynikiem 90+ (wygląda „bardzo dobrze”)

# Rysunek 6. Odsetek zaliczeń i korelacja z resztą listy
d6 <- data.frame(pozycja = factor(pozycje$pozycja, levels = pozycje$pozycja[order(odsetek)]),
                 odsetek = 100 * odsetek, r = r_reszta, grupa = ifelse(nikt, "prawie nikt nie oblewa (≥ 97%)", "różnicuje wizyty"))
kol6 <- c("prawie nikt nie oblewa (≥ 97%)" = "grey65", "różnicuje wizyty" = "#0072B2")
p6a <- ggplot(d6, aes(odsetek, pozycja, fill = grupa)) + geom_col(width = 0.7) +
  geom_text(aes(label = sprintf("%.0f%%", odsetek)), hjust = -0.15, size = 3.3) +
  scale_fill_manual(values = kol6, name = NULL) + scale_x_continuous(limits = c(0, 112), breaks = seq(0, 100, 25)) +
  labs(title = "A. Odsetek wizyt, w których pozycję zaliczono", x = "% wizyt", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank(), axis.text.y = element_text(size = 10))
p6b <- ggplot(d6, aes(r, pozycja, colour = grupa, shape = grupa)) + geom_point(size = 2.8, show.legend = FALSE) +
  geom_vline(xintercept = 0, colour = "grey60") +
  scale_colour_manual(values = kol6, name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_continuous(limits = c(-0.05, 0.6), breaks = seq(0, .6, .2), labels = function(x) sub("^0", "", sprintf("%.1f", x))) +
  labs(title = "B. Związek z resztą", x = "r pozycja–reszta", y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
p6 <- (p6a | p6b) + plot_layout(widths = c(2.2, 1), guides = "collect") & theme(legend.position = "bottom")
p6   # zapis: ggsave("mystery-shopping-lista-kontrolna.svg", p6, width = 10, height = 6.4)
Wynik w R
                           pozycja odsetek r_reszta sd_miedzy_salonami
         doradca w stroju firmowym    99.4     0.08                2.2
      czystość salonu i ekspozycji    99.0     0.10                2.8
           ceny widoczne na autach    98.8     0.07                3.6
             auto pokazowe otwarte    98.5     0.07                3.2
        podziękowanie i pożegnanie    98.1     0.05                4.4
         powitanie w ciągu 2 minut    92.9     0.19                6.7
           doradca się przedstawił    89.8     0.17               10.4
          propozycja kawy lub wody    85.4     0.21               12.3
           prezentacja wyposażenia    81.2     0.22               13.4
        pytania o potrzeby klienta    80.8     0.14               13.1
       znajomość wersji i silników    74.0     0.22               16.5
      zebranie danych kontaktowych    72.7     0.29               17.0
          propozycja jazdy próbnej    69.2     0.31               17.9
 informacja o serwisie i gwarancji    66.7     0.26               18.3
      pytanie o auto w rozliczeniu    65.0     0.20               15.8
            omówienie finansowania    61.9     0.31               19.6
                  oferta na piśmie    53.3     0.29               19.6
           pytanie o termin zakupu    53.3     0.34               17.2
         umówienie kolejnego kroku    48.3     0.26               19.1
         telefon po wizycie w 48 h    42.7     0.35               20.0
       pozycji_97_proc punktow_z_tych_pozycji
                   5.0                   24.7
srednia_20 srednia_15   r_wizyty   r_salony
    76.552     69.153      0.996      0.999
ICC_20_pozycji ICC_15_pozycji
         0.286          0.290
[1] 0.2395833
7. Symulacja: przydział regionalny a losowy
R
# Czy przydział „swoich” audytorów psuje ranking? Symulacja 200 sieci dla dwóch schematów przydziału
# Te same parametry co w przepisie 1, ale nowe salony, audytorzy (losowa surowość, bez ręcznych A05/A10) i wizyty.
symuluj_siec <- function(p_swoj) {
  ef_s <- rnorm(S, 0, sd_salon); ef_a <- rnorm(A, 0, sd_audytor)
  w <- do.call(rbind, lapply(1:S, function(s) do.call(rbind, lapply(1:K, function(k) {
    swoj <- audytorzy$region == salony$region[s]
    data.frame(salon = s, kwartal = k, audytor = sample(1:A, wizyt_w_kwartale,
               prob = ifelse(swoj, p_swoj / 3, (1 - p_swoj) / 9)))
  }))))
  eta <- outer(ef_s[w$salon] + ef_a[w$audytor] + rnorm(nrow(w), 0, sd_wizyta), pozycje$trudnosc, "+")
  w$wynik <- 5 * rowSums(matrix(rbinom(length(eta), 1, plogis(eta)), nrow(eta)))
  w$salon <- factor(w$salon); w$audytor <- factor(w$audytor); w$kwartal <- factor(w$kwartal)
  mm <- suppressMessages(lmer(wynik ~ kwartal + (1 | salon) + (1 | audytor), data = w))
  sur <- tapply(w$wynik, w$salon, mean); skor <- ranef(mm)$salon[levels(w$salon), 1]
  c(surowy = cor(sur, ef_s, method = "spearman"), skorygowany = cor(skor, ef_s, method = "spearman"))
}
set.seed(709)
regionalny <- t(replicate(200, symuluj_siec(0.80)))   # 80% wizyt „swojego” audytora (jak w sieci)
set.seed(709)
losowy <- t(replicate(200, symuluj_siec(3 / 12)))      # każdy audytor równie prawdopodobny
wyn <- rbind(regionalny = colMeans(regionalny), losowy = colMeans(losowy))
round(wyn, 3)
round(rbind(regionalny = apply(regionalny, 2, sd), losowy = apply(losowy, 2, sd)) / sqrt(200), 3)   # błąd MC
round(c(regionalny = mean(regionalny[, 2] > regionalny[, 1]), losowy = mean(losowy[, 2] > losowy[, 1])), 3)
Wynik w R
           surowy skorygowany
regionalny  0.891       0.909
losowy      0.902       0.912
           surowy skorygowany
regionalny  0.003       0.002
losowy      0.003       0.002
regionalny     losowy
     0.825      0.765
8. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (Północ / Południe, salon / audytor)" = c("#0072B2", "#D55E00"),
             "niebieski – zielony (Północ / Wschód)" = c("#0072B2", "#009E73"),
             "cynober – zielony (Południe / Wschód)" = c("#D55E00", "#009E73"),
             "zielony – grafitowy (Wschód / Zachód)" = c("#009E73", "#222222"),
             "niebieski – grafitowy (Północ / Zachód)" = c("#0072B2", "#222222"),
             "cynober – grafitowy (Południe / Zachód)" = c("#D55E00", "#222222"),
             "niebieski – pomarańczowy (krzywe rzetelności)" = c("#0072B2", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                         widzenie_typowe
niebieski – cynober (Północ / Południe, salon / audytor)           114.6
niebieski – zielony (Północ / Wschód)                               70.1
cynober – zielony (Południe / Wschód)                              102.4
zielony – grafitowy (Wschód / Zachód)                               65.1
niebieski – grafitowy (Północ / Zachód)                             52.8
cynober – grafitowy (Południe / Zachód)                             86.9
niebieski – pomarańczowy (krzywe rzetelności)                      120.2
czerwony – zielony (do unikania)                                   121.7
                                                         deuteranopia
niebieski – cynober (Północ / Południe, salon / audytor)        108.3
niebieski – zielony (Północ / Wschód)                            55.4
cynober – zielony (Południe / Wschód)                            53.5
zielony – grafitowy (Wschód / Zachód)                            43.6
niebieski – grafitowy (Północ / Zachód)                          54.4
cynober – grafitowy (Południe / Zachód)                          77.0
niebieski – pomarańczowy (krzywe rzetelności)                   121.5
czerwony – zielony (do unikania)                                 21.1
                                                         protanopia
niebieski – cynober (Północ / Południe, salon / audytor)       91.9
niebieski – zielony (Północ / Wschód)                          58.0
cynober – zielony (Południe / Wschód)                          37.3
zielony – grafitowy (Wschód / Zachód)                          50.8
niebieski – grafitowy (Północ / Zachód)                        52.6
cynober – grafitowy (Południe / Zachód)                        63.8
niebieski – pomarańczowy (krzywe rzetelności)                 109.3
czerwony – zielony (do unikania)                               31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, korelacje – pakiety base i stats). Model mieszany ze skrzyżowanymi efektami losowymi i bootstrap parametryczny wykonano pakietem lme4. Rysunki wykonano w ggplot2 (zestawienie paneli – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ranking z jednego kwartału (rzetelność .55) i ICC z modelu bez audytora (.32 zamiast .29).
- Audytor pracujący tylko w jednym regionie. Jego surowości nie oddzieli od jakości tych salonów nawet model.
- Audytor znany personelowi. Wilson (2001) zwraca uwagę, że wyniki są traktowane poważnie dopiero wtedy, gdy pracownicy akceptują tę formę oceny. Rozpoznany audytor dostaje lepszą obsługę niż prawdziwy klient.
- Wynik audytu jako cel sam w sobie. Lista mierzy zgodność z procedurą, a nie zadowolenie klientów (Blessing i Natter, 2019).
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak sprawdzić zgodność audytorów w badaniu mystery shopping?
Dopasuj model mieszany z losowymi efektami salonu i audytora, np. w R: lmer(wynik ~ (1 | salon) + (1 | audytor)). Udział wariancji salonu to ICC pojedynczej wizyty, a udział audytora mówi, ile wyniku zależy od tego, kto przyszedł. W przykładzie było to 28.6% i 18.1%, czyli ICC = .29.
Ile wizyt klienta-tajemniczego potrzeba, żeby ocenić salon?
Policz to z ICC wzorem Spearmana–Browna: rzetelność średniej z k wizyt = k × ICC / [1 + (k − 1) × ICC]. Przy ICC = .29 trzy wizyty dają .55, a dwanaście .83; do rzetelności .80 trzeba 10 wizyt, każdej u innego audytora.
Jak skorygować wynik mystery shopping o surowego audytora?
Użyj przewidywania modelu mieszanego dla przeciętnego audytora zamiast surowej średniej salonu. Korekta działa tylko wtedy, gdy audytorzy odwiedzają salony w różnych regionach – jeśli audytor pracuje w jednym regionie, jego surowości nie da się odróżnić od jakości tamtejszych salonów.
Czy ranking salonów z jednego kwartału mystery shopping jest wiarygodny?
Zwykle nie. Przy 3 wizytach w kwartale rzetelność wyniosła w przykładzie .55, a wyniki tych samych salonów z różnych kwartałów korelowały średnio na poziomie .55. Pokazuj grupy (powyżej, w normie, poniżej średniej) albo średnią z kilku kwartałów, a nie miejsce na liście.
Co zrobić z pozycjami listy kontrolnej, które wszyscy zaliczają?
Wydziel je jako warunki minimalne. Pozycje zaliczane w 98–99% wizyt prawie nie korelują z resztą listy i nie różnicują salonów, a podnoszą średnią: w przykładzie dawały 24.7 z 76.6 punktu, bez zmiany kolejności salonów.
Powiązane hasła
Przeczytaj też
Efekty skrzyżowane: uczestnicy × bodźce
Skrzyżowane efekty losowe osób i bodźców w lme4, maksymalna struktura, symulacja błędu I rodzaju, moc zależna od liczby bodźców i opis APA.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikSERVQUAL – luka oczekiwania i oceny
600 klientów przychodni weterynaryjnych: luki z CI, rzetelność luk, CFA, luki vs same oceny (SERVPERF) i porównanie placówek – z kodem R.
Czytaj →Analizujesz wyniki klienta-tajemniczego albo piszesz o nich pracę?
Pomożemy oddzielić salon od audytora w modelu mieszanym, policzyć ICC i liczbę potrzebnych wizyt oraz opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Blessing, G., & Natter, M. (2019). Do mystery shoppers really predict customer satisfaction and sales performance? Journal of Retailing, 95(3), 47–62. https://doi.org/10.1016/j.jretai.2019.04.001 ● Otwarty dostęp
- Finn, A. (2001). Mystery shopper benchmarking of durable-goods chains and stores. Journal of Service Research, 3(4), 310–320. https://doi.org/10.1177/109467050134004
- Jiang, Z. (2018). Using the linear mixed-effect model framework to estimate generalizability variance components in R. Methodology, 14(3), 133–142. https://doi.org/10.1027/1614-2241/a000149
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
- Wilson, A. M. (2001). Mystery shopping: Using deception to measure service performance. Psychology & Marketing, 18(7), 721–734. https://doi.org/10.1002/mar.1027
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{blessing2019mystery, author={Blessing, Gerald and Natter, Martin}, title={{Do mystery shoppers really predict customer satisfaction and sales performance?}}, journal={Journal of Retailing}, year={2019}, volume={95}, number={3}, pages={47--62}, doi={10.1016/j.jretai.2019.04.001}}@article{finn2001mystery, author={Finn, Adam}, title={{Mystery shopper benchmarking of durable-goods chains and stores}}, journal={Journal of Service Research}, year={2001}, volume={3}, number={4}, pages={310--320}, doi={10.1177/109467050134004}}@article{jiang2018using, author={Jiang, Zhehan}, title={{Using the linear mixed-effect model framework to estimate generalizability variance components in R}}, journal={Methodology}, year={2018}, volume={14}, number={3}, pages={133--142}, doi={10.1027/1614-2241/a000149}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{shrout1979intraclass, author={Shrout, Patrick E. and Fleiss, Joseph L.}, title={{Intraclass correlations: Uses in assessing rater reliability}}, journal={Psychological Bulletin}, year={1979}, volume={86}, number={2}, pages={420--428}, doi={10.1037/0033-2909.86.2.420}}@article{wilson2001mystery, author={Wilson, Alan M.}, title={{Mystery shopping: Using deception to measure service performance}}, journal={Psychology \& Marketing}, year={2001}, volume={18}, number={7}, pages={721--734}, doi={10.1002/mar.1027}}