Czym jest indeks Charlsona
Indeks chorób współistniejących Charlsona (Charlson Comorbidity Index, CCI) to ważona suma chorób przewlekłych, które zwiększają ryzyko zgonu. To nie jest kwestionariusz z pytaniami do pacjenta, tylko reguła liczenia: dla każdej choroby obecnej w dokumentacji dodajesz jej wagę. Charlson, Pompei, Ales i MacKenzie (1987) opracowali indeks w kohorcie 559 pacjentów oddziału internistycznego. Roczna śmiertelność wynosiła tam 12% przy wyniku 0, 26% przy 1–2, 52% przy 3–4 i 85% przy wyniku 5 lub wyższym.
Indeks często pojawia się w pracach z medycyny, pielęgniarstwa i zdrowia publicznego. Najczęściej jest zmienną kontrolną: pozwala porównać grupy pacjentów, które różnią się obciążeniem chorobami. Ogólny warsztat tych kierunków opisują wpisy statystyka dla lekarza, statystyka w pracy z pielęgniarstwa i statystyka w pracy ze zdrowia publicznego. W badaniach osób starszych CCI stoi często obok skal sprawności, np. indeksu Barthel, i przesiewu żywieniowego MUST.
Indeks służy do badań i korekty ryzyka (ang. risk adjustment), a nie do decyzji o leczeniu konkretnej osoby. Charlson i in. (2022) w przeglądzie właściwości klinimetrycznych opisują go jako narzędzie do przewidywania śmiertelności długoterminowej. W części populacji, np. na oddziałach intensywnej terapii, gorzej przewiduje śmiertelność szpitalną niż narzędzia tworzone do tego celu.
Choroby i wagi: skąd je brać
Artykuł z 1987 r. jest płatny i nie mogliśmy przeczytać jego tabeli wag. Jego streszczenie podaje tylko kategorie wyniku i śmiertelność. Dlatego wagi w tym wpisie pochodzą z tabeli 1 w pracy Charlson, Wells, Ullman, King i Shmukler (2014), której współautorką jest twórczyni indeksu. Artykuł jest w otwartym dostępie. Ta wersja służyła do przewidywania kosztów i ma 23 stany. Dziewiętnaście z nich to choroby wersji oryginalnej, którą Charlson i in. (2022) nazywają wersją 19-pozycyjną. Cztery dodane stany pomijamy: depresję, nadciśnienie, przyjmowanie warfaryny i owrzodzenia skóry. Zanim oddasz pracę, porównaj wagi z oryginałem z 1987 r. w bibliotece uczelni.
| Waga | Choroby |
|---|---|
| 1 | zawał serca, zastoinowa niewydolność serca, choroba naczyń obwodowych, choroba naczyń mózgowych, otępienie, przewlekła choroba płuc, choroba reumatyczna, choroba wrzodowa, łagodna choroba wątroby, cukrzyca bez powikłań narządowych |
| 2 | porażenie połowicze, umiarkowana lub ciężka choroba nerek, cukrzyca z powikłaniami narządowymi, dowolny nowotwór, białaczka, chłoniak |
| 3 | umiarkowana lub ciężka choroba wątroby |
| 6 | guz lity z przerzutami, HIV/AIDS |
Definicje chorób (np. co znaczy „łagodna” choroba wątroby) są w publikacjach źródłowych i w algorytmach kodowania. Nie zgaduj ich z nazw w tabeli.
Jak policzyć wynik krok po kroku
- Wybierz źródło danych i wersję. Indeks policzysz z dokumentacji medycznej, z kodów ICD w bazie szpitalnej albo z wywiadu. Charlson i in. (2022) opisują bardzo dużą zgodność samoopisu z dokumentacją. Wersji nie mieszaj w jednej analizie.
- Zakoduj każdą chorobę jako 0/1. Jedna kolumna na chorobę, 1 = choroba obecna przed punktem startu obserwacji. Choroby, które pojawiły się później, mogą być skutkiem badanej ekspozycji, więc nie wchodzą do korekty.
- Ustal regułę dla par łagodna–ciężka postać. Cukrzyca bez powikłań i z powikłaniami, łagodna i ciężka choroba wątroby oraz nowotwór i nowotwór z przerzutami to stopnie tej samej choroby. W przykładzie liczymy tylko cięższą postać. To decyzja badacza, którą trzeba opisać. Sprawdź, jak rozwiązuje to algorytm, z którego korzystasz.
- Zsumuj wagi. Wynik 0 oznacza brak chorób z listy. Wyższy wynik oznacza większe obciążenie chorobami.
- Zdecyduj, jak użyjesz wyniku. Jako zmienną liczbową w modelu albo w kategoriach 0, 1–2, 3–4 i 5+, takich jak w streszczeniu pracy z 1987 r. Kategorie są wygodne w tabeli opisowej. W modelu zwykle lepiej sprawdza się wynik liczbowy (sekcja o przykładzie).
Wersja z wiekiem
Charlson, Szatrowski, Peterson i Gold (1994) sprawdzili łączny wynik wieku i chorób u 218 pacjentów po planowych operacjach. Ryzyko względne zgonu wynosiło 1.4 na każdy punkt indeksu i 1.4 na każdą dekadę wieku. Dlatego autorzy połączyli oba składniki w jeden wynik. Schematu punktów za wiek nie podajemy. Streszczenie go nie zawiera, a pełnego tekstu nie mogliśmy przeczytać. Jeśli promotor wymaga wersji z wiekiem, weź reguły z artykułu z 1994 r. W pracy badawczej zwykle prościej i przejrzyściej jest wprowadzić do modelu wiek i CCI jako dwie osobne zmienne. Wtedy dane same pokażą, ile „waży” dekada życia.
Indeks z kodów ICD
Deyo, Cherkin i Ciol (1992) przystosowali indeks do kodów ICD-9-CM w bazach administracyjnych. Quan i in. (2005) opracowali algorytmy dla ICD-10. W kanadyjskich danych szpitalnych przewidywały one śmiertelność co najmniej tak dobrze jak dawne algorytmy (statystyka C .860 wobec .842). Quan i in. (2011) na nowo przypisali wagi na danych z Calgary. W porównaniu z wagami oryginalnymi pięć chorób dostało wagę 0, trzy niższą, cztery wyższą, a pięć zostało bez zmian. Tak powstał indeks 12 chorób. To już inna wersja, więc w pracy nazwij ją wprost. Tabele kodów weź z publikacji, a w metodzie podaj, którego algorytmu użyłeś. Wymaga tego lista RECORD dla badań na danych rutynowych (Benchimol i in., 2015).
Interpretacja i licencja
CCI nie ma „normy” ani progu diagnostycznego. To miara obciążenia chorobami, której zadaniem jest wyrównanie porównań. Kategorie 0, 1–2, 3–4 i 5+ pochodzą z kohorty z 1987 r. i opisują tamtą grupę pacjentów. Nie przenoś odsetków zgonów z tamtego badania na swoją próbę. Dzielenie zmiennej ciągłej na grupy zmniejsza moc i osłabia kontrolę zakłócania (Royston i in., 2006). W modelu korekty używaj więc raczej wyniku liczbowego. Jeśli związek z wynikiem nie jest liniowy, sięgnij po splajny.
Licencja. Nie znaleźliśmy oficjalnej strony z warunkami użycia indeksu (stan na 1 listopada 2026 r.). CCI to metoda opisana w artykułach naukowych, a nie formularz chroniony jak kwestionariusz psychologiczny. W pracy podaj źródło wag i wersję. Artykuły z 1987 i 1994 r. są płatne. Praca z 2014 r. jest udostępniona na licencji CC BY 4.0.
Przykład: 900 pacjentów po hospitalizacji
Dane są symulowane i możesz je pobrać jako plik CSV. Scenariusz to retrospektywne badanie kohortowe 900 osób w wieku 65+ wypisanych ze szpitala. Pytanie brzmi: czy udział w programie opieki domowej po wypisie wiąże się z mniejszym ryzykiem zgonu w ciągu roku? Do programu częściej trafiały osoby w lepszym stanie. Dlatego zmienną zakłócającą jest obciążenie chorobami. Plik zawiera wiek, udział w programie, zgon w ciągu roku i 19 kolumn 0/1 z chorobami.
Obie postacie tej samej choroby miało 13 osób z cukrzycą, 1 osoba z chorobą wątroby i 5 osób z nowotworem. Po zastosowaniu reguły „tylko cięższa postać” indeks miał zakres 0–13, M = 1.98, SD = 2.20, Me = 1 [0, 3]. Rozkład jest prawoskośny: 28.7% osób miało wynik 0, a 10.8% wynik 5 lub wyższy.
| CCI | n (%) | Zgony | Odsetek zgonów [95% CI] |
|---|---|---|---|
| 0 | 258 (28.7%) | 18 | 7.0% [4.5, 10.8] |
| 1–2 | 377 (41.9%) | 36 | 9.5% [7.0, 12.9] |
| 3–4 | 168 (18.7%) | 25 | 14.9% [10.3, 21.0] |
| 5+ | 97 (10.8%) | 46 | 47.4% [37.8, 57.3] |
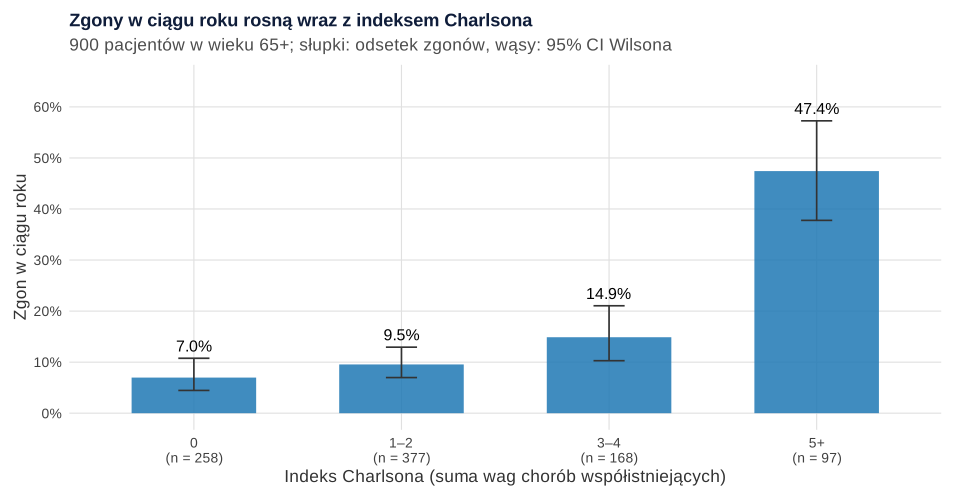
Przedziały ufności dla odsetków policzono metodą Wilsona (zob. przedział ufności dla proporcji). Uczestnicy programu (n = 422) mieli średnio niższy indeks niż pozostali (n = 478): M = 1.31 (SD = 1.62) wobec 2.57 (SD = 2.47). Zmarło 9.2% uczestników i 18.0% pozostałych osób.
CCI jako zmienna kontrolna w regresji logistycznej
Zgon w ciągu roku to zmienna 0/1, więc użyliśmy regresji logistycznej. Wiek wprowadziliśmy w dekadach, a CCI jako wynik liczbowy. Wyniki podajemy jako ilorazy szans z profilowymi 95% CI. Kolejne modele pokazują, jak zmienia się OR dla programu po dodaniu zmiennych kontrolnych:
- bez korekty: OR = 0.46, 95% CI [0.31, 0.69];
- z wiekiem: OR = 0.53, 95% CI [0.35, 0.79];
- z wiekiem i CCI: OR = 0.81, 95% CI [0.52, 1.27], p = .364.
W ostatnim modelu każdy punkt indeksu wiązał się ze wzrostem szans zgonu: OR = 1.38, 95% CI [1.27, 1.50]. Dla każdej dekady wieku OR wyniósł 1.77, 95% CI [1.34, 2.34]. Model z kategoriami CCI dał prawie ten sam OR dla programu: 0.81, 95% CI [0.51, 1.26]. Miał jednak wyższe AIC (638.8 wobec 635.5), więc wynik liczbowy opisał dane co najmniej równie dobrze przy mniejszej liczbie parametrów.
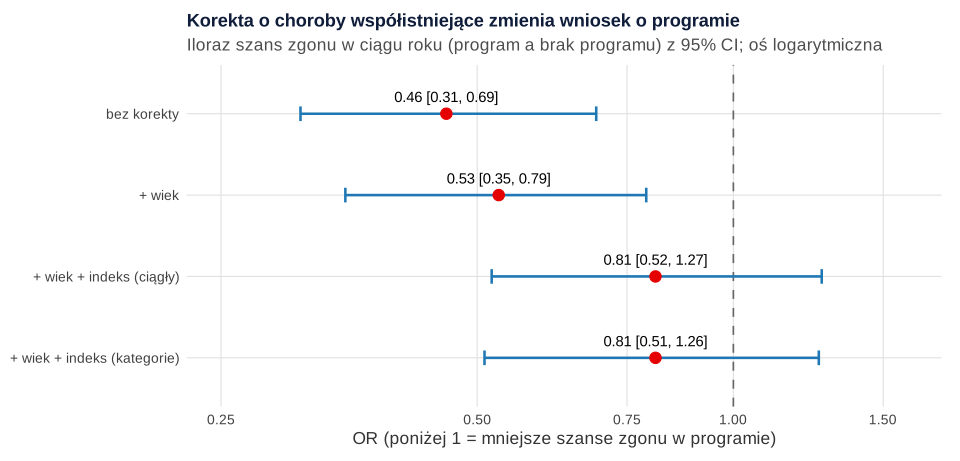
Wniosek z wykresu lasu: bez korekty program wyglądał na silnie „ochronny”. Ta przewaga wynikała jednak głównie z tego, że do programu trafiali zdrowsi pacjenci. W symulacji ustawiliśmy niewielki prawdziwy efekt programu, a próba nie wystarczyła, by go wykazać. To typowy obraz w danych obserwacyjnych. Korekta zmniejsza zakłócanie tylko przez zmienne, które zmierzono, więc w pracy pisz o związku, a nie o skutku programu. Przy 125 zgonach i 5 parametrach w największym modelu na jeden parametr przypadało 25 zdarzeń. To bezpieczny zapas według reguły EPV (Peduzzi i in., 1996).
Wagi czy zwykła liczba chorób?
Model z wiekiem i zwykłą liczbą chorób miał pole pod krzywą ROC AUC = .725, 95% CI [.672, .779]. Model z wiekiem i CCI miał AUC = .729, 95% CI [.674, .784]. Sam wiek dawał AUC = .619. Różnica w dyskryminacji była więc niewielka, ale AIC wyraźnie wskazało model z wagami (634.3 wobec 644.9). W tych danych wagi lepiej opisują ryzyko, bo jedna choroba z wagą 6 „waży” więcej niż dwie lekkie.
Jak opisać indeks Charlsona w pracy
Wzór zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane swojego badania. Zasady opisu modeli z korektą rozwija wpis regresja logistyczna krok po kroku, a układ metody w badaniu obserwacyjnym – wytyczne STROBE, CONSORT i TRIPOD.
Rozkład indeksu w grupach pokaż w tabeli 1. Gdy grupy bardzo różnią się obciążeniem chorobami, rozważ też metody propensity score. Przy wyniku typu „czas do zgonu” CCI wchodzi tak samo do modelu Coxa (zob. Kaplan–Meier i model Coxa krok po kroku).
Indeks Charlsona w R: wynik, kategorie i korekta w regresji logistycznej
Kod odtwarza liczby z tekstu i zapisuje plik CSV. Wagi są w nazwanym wektorze wagi, więc łatwo je podmienić na inną wersję indeksu. Iloraz szans z profilowym przedziałem liczy bazowe R, przedziały Wilsona – DescTools, a AUC – pROC.
Indeks chorób współistniejących Charlsona krok po kroku
R
# B281 – Indeks chorób współistniejących Charlsona: wynik i użycie jako zmiennej kontrolnej
# (dane symulowane, set.seed(2811)). Retrospektywna kohorta 900 pacjentów w wieku 65+ po hospitalizacji;
# pytanie: czy udział w programie opieki domowej po wypisie wiąże się z ryzykiem zgonu w ciągu roku?
# Wagi 19 chorób: tabela 1 w pracy Charlson i in. (2014), współautorstwa twórczyni indeksu
# (19 stanów z wersji oryginalnej; cztery stany dodane w tamtej adaptacji pominięto).
# Zasada „tylko cięższa postać” (cukrzyca, choroba wątroby, nowotwór) to decyzja badacza – opisz ją w pracy.
# Punktów za wiek (wersja łączona z 1994 r.) NIE kodujemy: ich schematu nie potwierdziliśmy w źródle.
suppressPackageStartupMessages({ library(DescTools); library(pROC) })
set.seed(2811)
wagi <- c(zawal = 1, niewydolnosc_serca = 1, choroba_naczyn_obwodowych = 1, choroba_naczyn_mozgowych = 1,
          otepienie = 1, przewlekla_choroba_pluc = 1, choroba_reumatyczna = 1, choroba_wrzodowa = 1,
          lagodna_choroba_watroby = 1, cukrzyca_bez_powiklan = 1, porazenie_polowicze = 2,
          choroba_nerek = 2, cukrzyca_z_powiklaniami = 2, nowotwor = 2, bialaczka = 2, chloniak = 2,
          ciezka_choroba_watroby = 3, nowotwor_z_przerzutami = 6, aids = 6)
czestosc <- c(.12, .15, .08, .12, .08, .14, .05, .05, .04, .17, .02, .10, .07, .10, .01, .015, .01, .03, .003)
n <- 900
wiek <- round(pmin(97, 65 + rgamma(n, shape = 3, scale = 4.5)))
z <- rnorm(n) + 0.04 * (wiek - 80)                                    # ukryta „kruchość” pacjenta
choroby <- sapply(seq_along(wagi), function(j) rbinom(n, 1, plogis(qlogis(czestosc[j]) + 0.6 * z)))
colnames(choroby) <- names(wagi)
cci_ukryty <- as.vector(choroby %*% wagi)
program <- rbinom(n, 1, plogis(0.25 - 0.30 * cci_ukryty - 0.04 * (wiek - 80)))  # chorzy rzadziej trafiają do programu
zgon_1rok <- rbinom(n, 1, plogis(-2.3 + 0.30 * cci_ukryty + 0.065 * (wiek - 80) - 0.35 * program))
dane <- data.frame(id = 1:n, wiek, program, zgon_1rok, choroby)
write.csv(dane, "../charlson-dane-przyklad.csv", row.names = FALSE)    # plik do pobrania

# Krok 1. Hierarchia: przy cięższej postaci nie liczymy łagodniejszej (decyzja badacza)
pary <- list(c("cukrzyca_z_powiklaniami", "cukrzyca_bez_powiklan"),
             c("ciezka_choroba_watroby", "lagodna_choroba_watroby"),
             c("nowotwor_z_przerzutami", "nowotwor"))
X <- as.matrix(dane[, names(wagi)])
for (p in pary) X[X[, p[1]] == 1, p[2]] <- 0
sapply(pary, function(p) sum(dane[[p[1]]] == 1 & dane[[p[2]]] == 1))   # ile osób miało obie postacie

# Krok 2. Indeks = suma wag; obok liczba chorób (bez wag)
dane$cci <- as.vector(X %*% wagi)
dane$liczba_chorob <- rowSums(X)
table(dane$cci)
round(c(M = mean(dane$cci), SD = sd(dane$cci), Me = median(dane$cci),
        Q1 = quantile(dane$cci, .25, names = FALSE), Q3 = quantile(dane$cci, .75, names = FALSE)), 2)
dane$cci_kat <- cut(dane$cci, c(-Inf, 0, 2, 4, Inf), labels = c("0", "1-2", "3-4", "5+"))
round(100 * prop.table(table(dane$cci_kat)), 1)

# Krok 3. Śmiertelność roczna w kategoriach indeksu (przedział Wilsona)
smiert <- t(sapply(split(dane$zgon_1rok, dane$cci_kat), function(y)
  c(n = length(y), zgony = sum(y), 100 * BinomCI(sum(y), length(y), method = "wilson"))))
round(smiert, 1)

# Krok 4. Zmienna zakłócająca: indeks w grupach programu
round(sapply(split(dane$cci, dane$program), function(x) c(n = length(x), M = mean(x), SD = sd(x))), 2)
round(tapply(dane$zgon_1rok, dane$program, mean) * 100, 1)

# Krok 5. Regresja logistyczna: bez korekty, z wiekiem, z wiekiem i indeksem
dane$wiek10 <- (dane$wiek - 80) / 10                                   # wiek w dekadach, wyśrodkowany na 80 lat
m0 <- glm(zgon_1rok ~ program, binomial, dane)
m1 <- glm(zgon_1rok ~ program + wiek10, binomial, dane)
m2 <- glm(zgon_1rok ~ program + wiek10 + cci, binomial, dane)
m3 <- glm(zgon_1rok ~ program + wiek10 + cci_kat, binomial, dane)
or <- function(m) round(exp(cbind(OR = coef(m), suppressMessages(confint(m))))[-1, , drop = FALSE], 2)
or(m0); or(m1); or(m2); or(m3)
format.pval(summary(m2)$coefficients["program", 4], digits = 3)
round(c(AIC_cci_liniowo = AIC(m2), AIC_cci_kategorie = AIC(m3)), 1)

# Krok 6. Ważony indeks a zwykła liczba chorób: zdolność dyskryminacji (AUC) modeli z wiekiem
m_licz <- glm(zgon_1rok ~ wiek10 + liczba_chorob, binomial, dane)
m_cci <- glm(zgon_1rok ~ wiek10 + cci, binomial, dane)
m_wiek <- glm(zgon_1rok ~ wiek10, binomial, dane)
auc <- function(m) { r <- roc(dane$zgon_1rok, fitted(m), quiet = TRUE); round(as.numeric(ci.auc(r)), 3)[c(2, 1, 3)] }
rbind(tylko_wiek = auc(m_wiek), wiek_liczba_chorob = auc(m_licz), wiek_cci = auc(m_cci))
round(c(AIC_liczba = AIC(m_licz), AIC_cci = AIC(m_cci)), 1)
c(zdarzenia = sum(dane$zgon_1rok), predyktory_m3 = length(coef(m3)) - 1)
Wynik w R
[1] 13  1  5

  0   1   2   3   4   5   6   7   8   9  10  11  12  13
258 216 161 104  64  31  20  12  14   8   6   2   3   1
   M   SD   Me   Q1   Q3
1.98 2.20 1.00 0.00 3.00

   0  1-2  3-4   5+
28.7 41.9 18.7 10.8
      n zgony
0   258    18  7.0  4.5 10.8
1-2 377    36  9.5  7.0 12.9
3-4 168    25 14.9 10.3 21.0
5+   97    46 47.4 37.8 57.3
        0      1
n  478.00 422.00
M    2.57   1.31
SD   2.47   1.62
   0    1
18.0  9.2
          OR 2.5 % 97.5 %
program 0.46  0.31   0.69
          OR 2.5 % 97.5 %
program 0.53  0.35   0.79
wiek10  1.85  1.42   2.42
          OR 2.5 % 97.5 %
program 0.81  0.52   1.27
wiek10  1.77  1.34   2.34
cci     1.38  1.27   1.50
             OR 2.5 % 97.5 %
program    0.81  0.51   1.26
wiek10     1.75  1.32   2.32
cci_kat1-2 1.22  0.67   2.26
cci_kat3-4 1.98  1.03   3.87
cci_kat5+  9.36  4.91  18.51
[1] "0.364"
  AIC_cci_liniowo AIC_cci_kategorie
            635.5             638.8
                    [,1]  [,2]  [,3]
tylko_wiek         0.619 0.562 0.676
wiek_liczba_chorob 0.725 0.672 0.779
wiek_cci           0.729 0.674 0.784
AIC_liczba    AIC_cci
     644.9      634.3
    zdarzenia predyktory_m3
          125             5
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://CRAN.R-project.org/package=DescTools
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy indeksie Charlsona
- Mieszanie wersji. Wagi z 1987 r., indeks 12 chorób Quana i in. (2011) i adaptacje kosztowe dają różne wyniki. Nazwij wersję i źródło wag.
- Liczenie obu postaci tej samej choroby. Bez reguły hierarchii osoba z cukrzycą z powikłaniami dostaje 1 punkt za dużo. Opisz, jak rozwiązałeś te pary.
- Choroby z okresu po ekspozycji. Do korekty bierz choroby obecne przed startem obserwacji. Późniejsze mogą być skutkiem tego, co badasz.
- Punkty za wiek bez źródła. Schemat wersji z wiekiem weź z pracy z 1994 r. Prościej jest wprowadzić wiek jako osobną zmienną.
- Kategorie zamiast wyniku. Grupy 0, 1–2, 3–4, 5+ są dobre do tabeli, ale w modelu korekty tracą informację (Royston i in., 2006).
- Wniosek przyczynowy po korekcie. CCI nie mierzy wszystkich różnic między grupami. Pisz o związku skorygowanym, a nie o efekcie interwencji. Kiedy warto kontrolować wiek i płeć, wyjaśnia wpis czy kontrolować wiek i płeć.
Jeśli chcesz, żeby ktoś sprawdził kodowanie chorób i model korekty w Twojej bazie, możesz skorzystać z oferty analizy statystyczne dla studentów. Wyniki i tak musisz umieć samodzielnie wyjaśnić i obronić.
Najczęstsze pytania
Jak policzyć indeks Charlsona?
Dla każdej z 19 chorób wersji oryginalnej zapisz 0 albo 1, pomnóż obecne choroby przez ich wagi (1, 2, 3 lub 6) i zsumuj. Przy dwóch postaciach tej samej choroby, np. cukrzycy bez powikłań i z powikłaniami, ustal regułę i ją opisz. W przykładzie liczymy tylko postać cięższą. Wagi weź z publikacji źródłowej, nie z niepodpisanego kalkulatora.
Ile punktów za wiek dodaje się w indeksie Charlsona?
Charlson i in. (1994) zaproponowali łączny wynik wieku i chorób, bo ryzyko zgonu rosło podobnie z każdym punktem indeksu i każdą dekadą wieku. Streszczenie artykułu nie podaje jednak schematu punktów, a pełnego tekstu nie mogliśmy sprawdzić. Weź reguły z artykułu z 1994 r. albo wprowadź do modelu wiek i indeks jako osobne zmienne.
Czy indeks Charlsona wprowadzać do regresji jako liczbę, czy w kategoriach?
Zwykle jako liczbę. Kategorie 0, 1–2, 3–4 i 5+ są wygodne w tabeli opisowej, ale podział zmiennej ciągłej zmniejsza moc i osłabia kontrolę zakłócania. W przykładzie model z wynikiem liczbowym miał niższe AIC niż model z kategoriami. Gdy związek nie jest liniowy, użyj splajnów.
Jaki wynik indeksu Charlsona jest wysoki?
Indeks nie ma normy ani progu diagnostycznego. W pierwszej kohorcie Charlsona i in. (1987) śmiertelność roczna przy wyniku 5 i więcej wynosiła 85%, ale to dotyczyło tamtych pacjentów z lat 80. W swojej pracy opisuj rozkład wyniku w próbie i używaj go do korekty, a nie do etykietowania pacjentów.
Czy do indeksu Charlsona potrzebna jest licencja?
Nie znaleźliśmy oficjalnej strony z warunkami użycia (stan na 1 listopada 2026 r.). Indeks jest metodą opisaną w artykułach naukowych, więc w pracy wystarczy podać źródło wag i wersję. Artykuły z 1987 i 1994 r. są płatne, a praca Charlson i in. (2014) z tabelą wag jest na licencji CC BY 4.0.
Powiązane hasła
Przeczytaj też
Regresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikStatystyka dla lekarza
ARR, RR, NNT i NNH z przedziałem ufności, PPV i ilorazy wiarygodności, krzywe Kaplana–Meiera i HR, non-inferiority, pułapki i pierwsze kroki własnego badania.
Czytaj →PoradnikKaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikSkala Katza (ADL) – jak policzyć wynik
Sześć czynności tak/nie, wynik 0–6 a stopnie z oryginału, hierarchia czynności, KR-20 i zmiana przy wypisie – z przykładem w R i wzorem opisu w pracy.
Czytaj →Liczysz indeks Charlsona z dokumentacji i nie wiesz, jak go użyć w modelu?
Sprawdzimy kodowanie chorób, wybór wersji i wag, budowę modelu z korektą i opis wyników, a potem wyjaśnimy analizę tak, żebyś umiał(a) samodzielnie ją opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Benchimol, E. I., Smeeth, L., Guttmann, A., Harron, K., Moher, D., Petersen, I., Sørensen, H. T., von Elm, E., Langan, S. M., & RECORD Working Committee. (2015). The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLOS Medicine, 12(10), Article e1001885. https://doi.org/10.1371/journal.pmed.1001885 ● Otwarty dostęp
- Charlson, M. E., Carrozzino, D., Guidi, J., & Patierno, C. (2022). Charlson Comorbidity Index: A critical review of clinimetric properties. Psychotherapy and Psychosomatics, 91(1), 8–35. https://doi.org/10.1159/000521288 ● Otwarty dostęp
- Charlson, M. E., Pompei, P., Ales, K. L., & MacKenzie, C. R. (1987). A new method of classifying prognostic comorbidity in longitudinal studies: Development and validation. Journal of Chronic Diseases, 40(5), 373–383. https://doi.org/10.1016/0021-9681(87)90171-8
- Charlson, M., Szatrowski, T. P., Peterson, J., & Gold, J. (1994). Validation of a combined comorbidity index. Journal of Clinical Epidemiology, 47(11), 1245–1251. https://doi.org/10.1016/0895-4356(94)90129-5
- Charlson, M., Wells, M. T., Ullman, R., King, F., & Shmukler, C. (2014). The Charlson comorbidity index can be used prospectively to identify patients who will incur high future costs. PLOS ONE, 9(12), Article e112479. https://doi.org/10.1371/journal.pone.0112479 ● Otwarty dostęp
- Deyo, R. A., Cherkin, D. C., & Ciol, M. A. (1992). Adapting a clinical comorbidity index for use with ICD-9-CM administrative databases. Journal of Clinical Epidemiology, 45(6), 613–619. https://doi.org/10.1016/0895-4356(92)90133-8
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373–1379. https://doi.org/10.1016/s0895-4356(96)00236-3 ● Otwarty dostęp
- Quan, H., Li, B., Couris, C. M., Fushimi, K., Graham, P., Hider, P., Januel, J.-M., & Sundararajan, V. (2011). Updating and validating the Charlson comorbidity index and score for risk adjustment in hospital discharge abstracts using data from 6 countries. American Journal of Epidemiology, 173(6), 676–682. https://doi.org/10.1093/aje/kwq433
- Quan, H., Sundararajan, V., Halfon, P., Fong, A., Burnand, B., Luthi, J.-C., Saunders, L. D., Beck, C. A., Feasby, T. E., & Ghali, W. A. (2005). Coding algorithms for defining comorbidities in ICD-9-CM and ICD-10 administrative data. Medical Care, 43(11), 1130–1139. https://doi.org/10.1097/01.mlr.0000182534.19832.83
- Royston, P., Altman, D. G., & Sauerbrei, W. (2006). Dichotomizing continuous predictors in multiple regression: A bad idea. Statistics in Medicine, 25(1), 127–141. https://doi.org/10.1002/sim.2331
Cytowania BibTeX
@article{benchimol2015reporting, author={Benchimol, Eric I. and Smeeth, Liam and Guttmann, Astrid and Harron, Katie and Moher, David and Petersen, Irene and Sørensen, Henrik T. and von Elm, Erik and Langan, Sinéad M. and {RECORD Working Committee}}, title={{The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement}}, journal={PLOS Medicine}, year={2015}, volume={12}, number={10}, eid={e1001885}, doi={10.1371/journal.pmed.1001885}}@article{charlson2022charlson, author={Charlson, Mary E. and Carrozzino, Danilo and Guidi, Jenny and Patierno, Chiara}, title={{Charlson Comorbidity Index: A critical review of clinimetric properties}}, journal={Psychotherapy and Psychosomatics}, year={2022}, volume={91}, number={1}, pages={8--35}, doi={10.1159/000521288}}@article{charlson1987new, author={Charlson, Mary E. and Pompei, Peter and Ales, Kathy L. and MacKenzie, C. Ronald}, title={{A new method of classifying prognostic comorbidity in longitudinal studies: Development and validation}}, journal={Journal of Chronic Diseases}, year={1987}, volume={40}, number={5}, pages={373--383}, doi={10.1016/0021-9681(87)90171-8}}@article{charlson1994validation, author={Charlson, Mary and Szatrowski, Ted P. and Peterson, Janey and Gold, Jeffrey}, title={{Validation of a combined comorbidity index}}, journal={Journal of Clinical Epidemiology}, year={1994}, volume={47}, number={11}, pages={1245--1251}, doi={10.1016/0895-4356(94)90129-5}}@article{charlson2014charlson, author={Charlson, Mary and Wells, Martin T. and Ullman, Ralph and King, Fionnuala and Shmukler, Celia}, title={{The Charlson comorbidity index can be used prospectively to identify patients who will incur high future costs}}, journal={PLOS ONE}, year={2014}, volume={9}, number={12}, eid={e112479}, doi={10.1371/journal.pone.0112479}}@article{deyo1992adapting, author={Deyo, Richard A. and Cherkin, Daniel C. and Ciol, Marcia A.}, title={{Adapting a clinical comorbidity index for use with ICD-9-CM administrative databases}}, journal={Journal of Clinical Epidemiology}, year={1992}, volume={45}, number={6}, pages={613--619}, doi={10.1016/0895-4356(92)90133-8}}@article{peduzzi1996simulation, author={Peduzzi, Peter and Concato, John and Kemper, Elizabeth and Holford, Theodore R. and Feinstein, Alvan R.}, title={{A simulation study of the number of events per variable in logistic regression analysis}}, journal={Journal of Clinical Epidemiology}, year={1996}, volume={49}, number={12}, pages={1373--1379}, doi={10.1016/s0895-4356(96)00236-3}}@article{quan2011updating, author={Quan, Hude and Li, Bing and Couris, Chantal M. and Fushimi, Kiyohide and Graham, Patrick and Hider, Phil and Januel, Jean-Marie and Sundararajan, Vijaya}, title={{Updating and validating the Charlson comorbidity index and score for risk adjustment in hospital discharge abstracts using data from 6 countries}}, journal={American Journal of Epidemiology}, year={2011}, volume={173}, number={6}, pages={676--682}, doi={10.1093/aje/kwq433}}@article{quan2005coding, author={Quan, Hude and Sundararajan, Vijaya and Halfon, Patricia and Fong, Andrew and Burnand, Bernard and Luthi, Jean-Christophe and Saunders, L. Duncan and Beck, Cynthia A. and Feasby, Thomas E. and Ghali, William A.}, title={{Coding algorithms for defining comorbidities in ICD-9-CM and ICD-10 administrative data}}, journal={Medical Care}, year={2005}, volume={43}, number={11}, pages={1130--1139}, doi={10.1097/01.mlr.0000182534.19832.83}}@article{royston2006dichotomizing, author={Royston, Patrick and Altman, Douglas G. and Sauerbrei, Willi}, title={{Dichotomizing continuous predictors in multiple regression: A bad idea}}, journal={Statistics in Medicine}, year={2006}, volume={25}, number={1}, pages={127--141}, doi={10.1002/sim.2331}}