Czym jest AUDIT i skąd pochodzi
AUDIT (Alcohol Use Disorders Identification Test) to 10-pozycyjny test przesiewowy w kierunku ryzykownego i szkodliwego picia alkoholu. Powstał w projekcie Światowej Organizacji Zdrowia prowadzonym w sześciu krajach. Pytania wybrano ze 150-pozycyjnego wywiadu, który przeprowadzono z 1888 pacjentami podstawowej opieki zdrowotnej (Saunders i in., 1993). Dziesięć pytań obejmuje spożycie alkoholu, zachowania związane z piciem i problemy alkoholowe. WHO wydała do testu podręcznik dla podstawowej opieki zdrowotnej. Opisuje on, jak używać AUDIT do przesiewu, krótkiej oceny i planowania krótkiej interwencji (Babor i in., 2001).
W pracach dyplomowych AUDIT służy zwykle do opisu wzorców picia w grupie, np. wśród studentów, albo jako zmienna w analizie związków, np. z odczuwanym stresem czy dobrostanem WHO-5. W obu przypadkach liczysz go tak samo. Interpretacja jest jednak trudniejsza niż w zwykłej skali, bo w grę wchodzą progi, płeć i skrócona wersja AUDIT-C.
Budowa: 10 pozycji, trzy obszary, nietypowa punktacja
Według strony AUDIT, na której jako kontakt podano pierwszego autora testu, pozycje 1–8 punktuje się 0, 1, 2, 3 albo 4, a pozycje 9 i 10 tylko 0, 2 albo 4 (AUDIT Screen, b.d.). Tak samo punktuje je wersja wywiadu w podręczniku WHO: odpowiedź środkowa dotyczy zdarzenia sprzed ostatniego roku i daje 2 punkty, a odpowiedź o ostatnim roku – 4 punkty (Babor i in., 2001). Ta różnica to najczęstsze źródło błędów w bazach danych. Trzy obszary testu, czyli spożycie, możliwa zależność i szkody, można liczyć osobno. Częściej liczy się jednak jeden wynik ogólny. Pierwsze trzy pytania dotyczą spożycia i tworzą skróconą wersję AUDIT-C. Pozostałe siedem dotyczy objawów zależności i szkód związanych z piciem. Pytania o problemy odnoszą się do ostatniego roku. Treści pozycji nie przytaczamy, bo w tym cyklu nie przedrukowujemy pozycji narzędzi, choć AUDIT jest w domenie publicznej.
| Element | Pozycje | Punktacja | Zakres |
|---|---|---|---|
| Spożycie (AUDIT-C) | 1–3 | 0–4 | 0–12 |
| Zależność i szkody | 4–8 | 0–4 | 0–28 |
| Zależność i szkody | 9–10 | 0, 2 albo 4 | |
| Wynik ogólny | 1–10 | suma | 0–40 |
Zakresy wynikają z punktacji podanej przez Saundersa i in. (1993) oraz na stronie AUDIT (AUDIT Screen, b.d.). Ważna jest też definicja porcji standardowej. W pytaniach 2 i 3 „drink” oznaczał od 8 do 13 gramów czystego alkoholu. Jeśli w danym kraju porcja jest inna, strona AUDIT zaleca dostosować kategorie odpowiedzi (AUDIT Screen, b.d.). Dlatego używaj wersji językowej przygotowanej dla polskiego kontekstu i nie przerabiaj kategorii samodzielnie.
Jak policzyć wynik AUDIT krok po kroku
- Sprawdź kodowanie. Pozycje 1–8 mogą mieć tylko wartości 0–4, a pozycje 9 i 10 tylko 0, 2 i 4. Formularz online zwykle zapisuje trzy opcje pozycji 9 i 10 jako 1, 2 i 3, więc musisz je przekodować (zob. rekodowanie).
- Zsumuj 10 pozycji. Wynik ogólny mieści się w zakresie 0–40. AUDIT nie ma pozycji odwróconych.
- Policz AUDIT-C, jeśli go potrzebujesz: suma pozycji 1–3, zakres 0–12.
- Ustal regułę dla braków przed analizą. Cytowane źródła nie podają reguły imputacji. Przy teście przesiewowym z progami bezpieczniej nie liczyć wyniku osobom z brakami i podać, ilu osób to dotyczy.
Ogólne zasady przekodowania i sumowania w Excelu, SPSS i R opisuje poradnik jak policzyć wynik kwestionariusza, a pojedynczy wynik sprawdzisz w kalkulatorze wyniku skali.
Interpretacja: przedziały ryzyka, próg 8 i płeć
W badaniu rozwojowym 92% osób z rozpoznanym piciem ryzykownym lub szkodliwym miało wynik 8 lub wyższy, a 94% osób bez takiego picia – wynik niższy niż 8 (Saunders i in., 1993). Stąd wziął się klasyczny punkt odcięcia 8. Strona AUDIT opisuje wynik ogólny następująco (AUDIT Screen, b.d.):
| Wynik | Opis na stronie AUDIT |
|---|---|
| 0 | abstynencja, bez problemów alkoholowych |
| 1–7 | picie niskiego ryzyka według wytycznych WHO |
| 8–14 | picie ryzykowne lub szkodliwe; typowo krótka interwencja |
| 15 i więcej | prawdopodobna zależność (umiarkowane lub ciężkie zaburzenie używania alkoholu) |
Podręcznik WHO dla podstawowej opieki zdrowotnej (Babor i in., 2001) dzieli wynik na cztery strefy ryzyka i każdej przypisuje rodzaj interwencji:
| Strefa | Wynik | Sugerowane postępowanie według podręcznika WHO |
|---|---|---|
| I | 0–7 | picie niskiego ryzyka lub abstynencja; edukacja o alkoholu |
| II | 8–15 | prosta porada nastawiona na ograniczenie ryzykownego picia |
| III | 16–19 | prosta porada, krótkie poradnictwo i dalsze monitorowanie |
| IV | 20–40 | skierowanie do specjalisty na ocenę diagnostyczną i ewentualne leczenie zależności |
Według podręcznika granice stref mogą się nieco różnić między krajami, zależnie od wzorców picia, zawartości alkoholu w porcji standardowej i celu przesiewu, a cały podział autorzy nazywają wstępnym. Podręcznik zaleca też, by osobie z co najmniej 2 punktami w pytaniach 4–6 albo z 4 punktami w pytaniu 9 lub 10 zaproponować interwencję o jeden poziom wyższą, niż wynika z sumy (Babor i in., 2001). Strefy WHO (8–15, 16–19, 20+) nie pokrywają się z przedziałami ze strony AUDIT (8–14, 15+), więc w pracy użyj jednego podziału i podaj jego źródło.
Podręcznik wymienia też dwa warianty progu. Próg 10 daje większą swoistość kosztem czułości, a obniżenie progu do 7 u wszystkich kobiet i u mężczyzn po 65. roku życia zwiększa czułość w tych grupach (Babor i in., 2001). Jednocześnie autorzy zaznaczają, że dane o kobietach są dość ograniczone, a wpływu wieku nie analizowano systematycznie: w jednym badaniu u osób po 65. roku życia czułość była niska, a swoistość wysoka.
Nowsze badania idą dalej. Reinert i Allen (2007) w przeglądzie badań stwierdzili, że do wykrywania picia ryzykownego oraz szkodliwego picia lub zależności u kobiet trzeba obniżyć próg poniżej pierwotnych 8 punktów. W hiszpańskiej próbie 1309 studentów najlepszy próg picia wysokiego ryzyka wyniósł 8 u mężczyzn i 6 u kobiet (García Carretero i in., 2016). Dla wersji AUDIT-C w badaniu Bradley i in. (2007) progi równoważące czułość i swoistość wyniosły ≥ 4 u mężczyzn i ≥ 3 u kobiet. Takie progi wyznacza się zwykle z krzywej ROC w konkretnej populacji, więc nie są uniwersalne. Wybierz próg przed analizą, podaj źródło i nie nazywaj wyniku dodatniego rozpoznaniem.
Przykład: AUDIT u 400 osób studiujących
Dane są symulowane: 240 kobiet i 160 mężczyzn, bez braków. Możesz je pobrać jako plik CSV (kolumny id, plec, a1–a10, pozycje 9 i 10 już zakodowane 0, 2, 4).
Rozkład wyniku
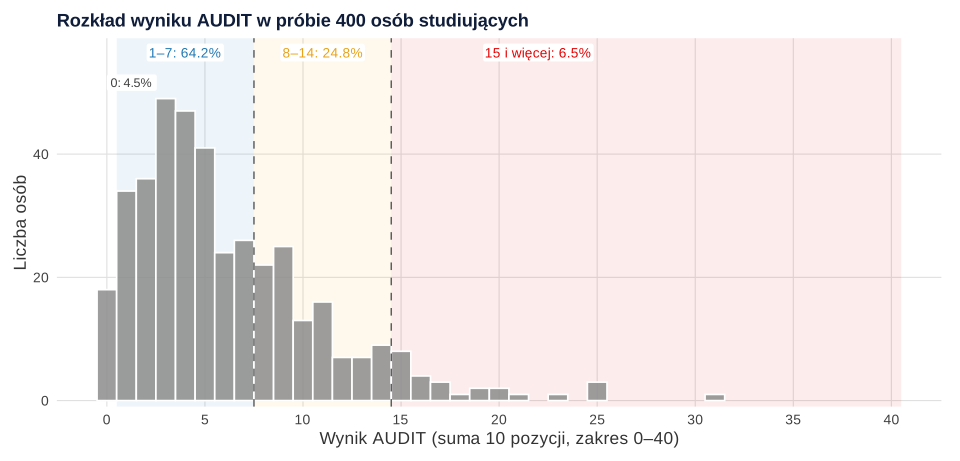
Średni wynik ogólny wyniósł M = 6.15 (SD = 4.84), a mediana 5, przy rozstępie ćwiartkowym od 3 do 9. Wyniki wahały się od 0 do 31. Rozkład jest wyraźnie prawostronnie skośny (skośność 1.45): większość osób ma niskie wyniki, a nieliczne bardzo wysokie (rysunek 1). Przy takim rozkładzie obok średniej podaj medianę i IQR. Suma pozycji 4–10 jest jeszcze bardziej skośna: ma medianę 2 i skośność 2.00. AUDIT-C miał M = 3.46 (SD = 2.29, Me = 3).
Odsetki w przedziałach
Wynik 0 miało 18 osób (4.5%, 95% CI [2.9, 7.0]). Wynik 1–7 miało 257 osób (64.2%, 95% CI [59.4, 68.8]), wynik 8–14 – 99 osób (24.8%, 95% CI [20.8, 29.2]), a 15 lub więcej – 26 osób (6.5%, 95% CI [4.5, 9.4]). Przedziały policzyliśmy metodą Wilsona (zob. przedział ufności dla proporcji).
Jak próg zmienia wynik
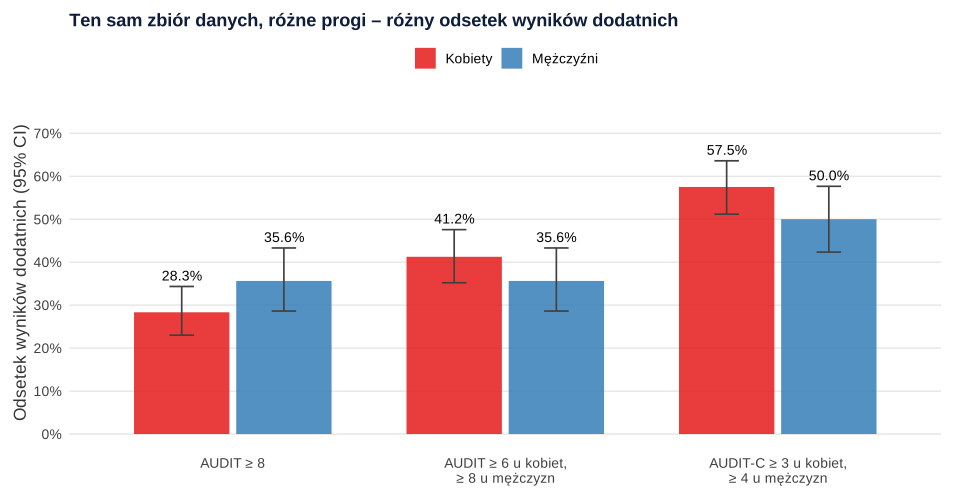
Przy jednym progu 8 dla wszystkich wynik dodatni miało 28.3% kobiet (95% CI [23.0, 34.3]) i 35.6% mężczyzn (95% CI [28.6, 43.3]). Po obniżeniu progu dla kobiet do 6 odsetek kobiet wzrósł do 41.2% (95% CI [35.2, 47.6]) i przewyższył odsetek mężczyzn. Według AUDIT-C z progami z pracy Bradley i in. (2007) było to 57.5% kobiet i 50.0% mężczyzn (rysunek 2). Te same dane dają więc odsetki od 28.3% do 57.5%, zależnie od reguły. To główny powód, by regułę podać w metodzie, a nie dobierać jej po obejrzeniu wyników.
Porównanie grup
Przy tak skośnym rozkładzie do porównania płci lepiej pasuje test Manna–Whitneya niż test t. Mediana wyniosła 4.5 u kobiet i 5 u mężczyzn. Różnica była istotna statystycznie, ale mała: W = 16628.5, p = .023, r = .11. Inne możliwości, np. regresję dla zliczeń, opisują wpisy testy nieparametryczne krok po kroku i regresja dla zliczeń.
Rzetelność i struktura
Alfa Cronbacha dla 10 pozycji wyniosła α = .78, 95% CI [.75, .81], a dla AUDIT-C α = .75. Omega dla wyniku ogólnego z modelu dwuczynnikowego wyniosła ω = .82 (zob. omega McDonalda). Shevlin i Smith (2007) w reprezentatywnej próbie brytyjskiej najlepiej opisali AUDIT dwoma czynnikami: spożyciem i problemami. W przykładzie porządkowa CFA dała podobny obraz. Model jednoczynnikowy miał CFI = .915 i RMSEA = .087, a dwuczynnikowy CFI = .986 i RMSEA = .036, przy korelacji czynników .67. Dane symulowaliśmy z dwóch czynników, więc ten wynik ma charakter ilustracyjny. W pracy możesz raportować wynik ogólny, a AUDIT-C i sumę pozycji 4–10 traktować jako uzupełnienie.
Jak opisać AUDIT w pracy
Schemat opisu dowolnego narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a zasady opisu rozkładów w tekście statystyki opisowe w pracy.
Polska wersja, licencja i etyka
Według strony AUDIT test zatwierdzony przez WHO jest w domenie publicznej. Do użytku niekomercyjnego nie potrzeba zgody, jeśli test nie zostanie istotnie zmieniony (AUDIT Screen, b.d.). Strona udostępnia ponad 40 wersji językowych, w tym polskie: samoopisową i do wywiadu. Nie podaje jednak, kto je przygotował ani jak zostały zwalidowane. Te informacje i ewentualne polskie progi bierz z publikacji o polskiej wersji, a nie z tego wpisu.
Pytania o alkohol to dane wrażliwe. Zadbaj o anonimowość (zob. anonimizacja i pseudonimizacja danych) i ustal z promotorem albo komisją etyczną, czy i jak przekazać uczestnikom informację o możliwości uzyskania pomocy. Indywidualnej informacji zwrotnej o wyniku nie dawaj bez procedury zaakceptowanej przez komisję. Gdzie szukać narzędzi i jak sprawdzić warunki użycia, opisuje poradnik gdzie znaleźć kwestionariusze psychologiczne.
AUDIT w R: wynik, progi i rzetelność
Kod odtwarza liczby z tekstu i zapisuje plik CSV. Najważniejsza jest kontrola, czy pozycje 9 i 10 mają wartości 0, 2 i 4. Przedziały Wilsona daje prop.test() bez poprawki, alfę – pakiet psych, CFA – lavaan, a omegę – compRelSEM() z semTools. Ostatni krok pokazuje skutek błędnego kodowania pozycji 9 i 10.
Wynik AUDIT krok po kroku
R
# B100 – AUDIT: wynik ogólny 0–40, AUDIT-C, przedziały ryzyka, progi według płci, rzetelność (dane symulowane, set.seed(10010)).
# 400 osób studiujących (240 kobiet, 160 mężczyzn); pozycje a1–a8 punktowane 0–4, pozycje a9 i a10 – 0, 2 albo 4.
# Zasady liczenia: Saunders i in. (1993); strona AUDIT (auditscreen.org). Treści pozycji nie podajemy.
suppressPackageStartupMessages({ library(MASS); library(psych); library(lavaan); library(semTools) })
set.seed(10010)
n <- 400
plec <- factor(rep(c("K", "M"), c(240, 160)))
lat <- mvrnorm(n, c(0, 0), matrix(c(1, .65, .65, 1), 2))
lat[plec == "M", ] <- lat[plec == "M", ] + 0.35                     # mężczyźni piją średnio więcej
lam <- c(.80, .72, .78, .62, .60, .55, .66, .64, .58, .52)
progi <- list(c(-1.1, -0.1, 0.9, 1.9), c(0.0, 1.0, 1.8, 2.5), c(-0.2, 0.8, 1.6, 2.4),   # a1–a3: spożycie
              c(0.7, 1.5, 2.1, 2.6), c(0.6, 1.4, 2.0, 2.6), c(1.3, 1.9, 2.4, 2.8),     # a4–a6
              c(0.5, 1.3, 2.0, 2.6), c(0.4, 1.2, 1.9, 2.5),                           # a7–a8
              c(1.3, 2.2), c(1.5, 2.3))                                               # a9–a10: trzy kategorie
odp <- sapply(1:10, function(j) {
  z <- lam[j] * lat[, if (j <= 3) 1 else 2] + rnorm(n, 0, sqrt(1 - lam[j]^2))
  k <- findInterval(z, progi[[j]])
  if (j >= 9) k * 2 else k                                          # a9 i a10: 0, 2 albo 4
})
colnames(odp) <- paste0("a", 1:10)
dane <- data.frame(id = 1:n, plec, odp)
write.csv(dane, "../audit-dane-przyklad.csv", row.names = FALSE)   # plik do pobrania

# Krok 1. Kontrola zakresu: a1–a8 tylko 0–4, a9 i a10 tylko 0, 2, 4
c(a1_a8 = all(as.matrix(dane[, paste0("a", 1:8)]) %in% 0:4),
  a9_a10 = all(as.matrix(dane[, c("a9", "a10")]) %in% c(0, 2, 4)))

# Krok 2. Wynik ogólny (0–40), AUDIT-C (pozycje 1–3, 0–12) i suma pozycji 4–10 (0–28)
dane$AUDIT <- rowSums(dane[, paste0("a", 1:10)])
dane$AUDIT_C <- rowSums(dane[, paste0("a", 1:3)])
dane$AUDIT_4_10 <- rowSums(dane[, paste0("a", 4:10)])
opis <- function(v) round(c(M = mean(v), SD = sd(v), Me = median(v), Q1 = unname(quantile(v, .25)),
                            Q3 = unname(quantile(v, .75)), min = min(v), max = max(v), skosnosc = psych::skew(v)), 2)
rbind(AUDIT = opis(dane$AUDIT), AUDIT_C = opis(dane$AUDIT_C), AUDIT_4_10 = opis(dane$AUDIT_4_10))
c(wynik_0 = sum(dane$AUDIT == 0), proc_0 = round(100 * mean(dane$AUDIT == 0), 1))

# Krok 3. Przedziały ze strony AUDIT: 0, 1–7, 8–14, 15 i więcej; odsetki z 95% CI Wilsona
dane$przedzial <- cut(dane$AUDIT, c(-1, 0, 7, 14, 40), labels = c("0", "1-7", "8-14", "15+"))
wilson <- function(k, m) { t <- prop.test(k, m, correct = FALSE)
  round(c(n = k, proc = 100 * k / m, lo = 100 * t$conf.int[1], hi = 100 * t$conf.int[2]), 1) }
t(sapply(levels(dane$przedzial), function(l) wilson(sum(dane$przedzial == l), n)))

# Krok 4. Wynik dodatni według płci przy różnych progach (odsetki z 95% CI)
progi_tab <- function(war, nazwa) t(sapply(c("K", "M"), function(g) wilson(sum(war[plec == g]), sum(plec == g))))
list(AUDIT_8_wszyscy = progi_tab(dane$AUDIT >= 8),
     AUDIT_6_kobiety = progi_tab(dane$AUDIT >= 6)["K", ],
     AUDIT_C_4M_3K = progi_tab(ifelse(plec == "M", dane$AUDIT_C >= 4, dane$AUDIT_C >= 3)))

# Krok 5. Porównanie płci: mediany i test Manna–Whitneya z r = Z / √N
tapply(dane$AUDIT, plec, median)
w <- wilcox.test(AUDIT ~ plec, data = dane, exact = FALSE)
z <- qnorm(w$p.value / 2)
round(c(W = unname(w$statistic), p = w$p.value, r = abs(z) / sqrt(n)), 3)

# Krok 6. Rzetelność i struktura: alfa, omega, CFA jedno- i dwuczynnikowa (spożycie vs pozycje 4–10)
pozycje <- dane[, paste0("a", 1:10)]
a <- alpha(pozycje, warnings = FALSE)
round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]]), 3)
round(alpha(dane[, paste0("a", 1:3)], warnings = FALSE)$total$raw_alpha, 3)          # alfa AUDIT-C
m1 <- cfa("A =~ a1 + a2 + a3 + a4 + a5 + a6 + a7 + a8 + a9 + a10",
          data = pozycje, ordered = TRUE, estimator = "WLSMV", std.lv = TRUE)
m2 <- cfa("SPOZ =~ a1 + a2 + a3\nPROB =~ a4 + a5 + a6 + a7 + a8 + a9 + a10",
          data = pozycje, ordered = TRUE, estimator = "WLSMV", std.lv = TRUE)
wsk <- c("chisq.scaled", "df.scaled", "cfi.scaled", "tli.scaled", "rmsea.scaled", "srmr")
noquote(rbind(jeden = formatC(fitMeasures(m1, wsk), format = "f", digits = 3),
              dwa = formatC(fitMeasures(m2, wsk), format = "f", digits = 3)))
std <- standardizedSolution(m2)
round(std$est.std[std$op == "~~" & std$lhs == "SPOZ" & std$rhs == "PROB"], 2)
m2c <- cfa("SPOZ =~ a1 + a2 + a3\nPROB =~ a4 + a5 + a6 + a7 + a8 + a9 + a10", data = pozycje, std.lv = TRUE)
round(unlist(compRelSEM(m2c, return.total = TRUE)), 3)

# Krok 7. Typowy błąd: pozycje 9 i 10 zakodowane jako 0, 1, 2 zamiast 0, 2, 4
zle <- dane$AUDIT - dane$a9 / 2 - dane$a10 / 2
c(roznica_M = round(mean(dane$AUDIT) - mean(zle), 2), max_roznica = max(dane$AUDIT - zle),
  dodatnie_dobrze = sum(dane$AUDIT >= 8), dodatnie_zle = sum(zle >= 8))
Wynik w R
 a1_a8 a9_a10
  TRUE   TRUE
              M   SD Me Q1 Q3 min max skosnosc
AUDIT      6.15 4.84  5  3  9   0  31     1.45
AUDIT_C    3.46 2.29  3  2  5   0  11     0.56
AUDIT_4_10 2.69 3.38  2  0  4   0  22     2.00
wynik_0  proc_0
   18.0     4.5
       n proc   lo   hi
0     18  4.5  2.9  7.0
1-7  257 64.2 59.4 68.8
8-14  99 24.8 20.8 29.2
15+   26  6.5  4.5  9.4
$AUDIT_8_wszyscy
   n proc   lo   hi
K 68 28.3 23.0 34.3
M 57 35.6 28.6 43.3

$AUDIT_6_kobiety
   n proc   lo   hi
99.0 41.2 35.2 47.6

$AUDIT_C_4M_3K
    n proc   lo   hi
K 138 57.5 51.2 63.6
M  80 50.0 42.3 57.7

  K   M
4.5 5.0
        W         p         r
16628.500     0.023     0.114
 alfa    lo    hi
0.781 0.747 0.811
[1] 0.748
      chisq.scaled df.scaled cfi.scaled tli.scaled rmsea.scaled srmr
jeden 139.987      35.000    0.915      0.891      0.087        0.084
dwa   51.477       34.000    0.986      0.981      0.036        0.055
[1] 0.67
   SPOZ    PROB .TOTAL.
  0.752   0.722   0.819
      roznica_M     max_roznica dodatnie_dobrze    dodatnie_zle
           0.27            4.00          125.00          121.00
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy AUDIT
- Pozycje 9 i 10 zakodowane 0, 1, 2. W przykładzie zaniżyło to średnią o 0.27 punktu, a u niektórych osób wynik nawet o 4 punkty. Liczba wyników ≥ 8 spadła wtedy ze 125 do 121.
- Kodowanie 1–5 z formularza bez przekodowania. Jeśli pozycje 1–8 zapisano jako 1–5, każdy wynik rośnie o 8 punktów, więc już osoba z minimalnymi odpowiedziami „przekracza” próg 8.
- Próg dobrany po obejrzeniu danych. Regułę (8 dla wszystkich, niższa dla kobiet albo AUDIT-C) podaj w metodzie i uzasadnij źródłem.
- Przedziały ryzyka z przypadkowej strony internetowej. Bierz je ze źródła, które cytujesz, i nie mieszaj podziałów z różnych źródeł.
- „Uzależnienie u 6.5% studentów”. AUDIT jest testem przesiewowym, a wynik 15 i więcej oznacza prawdopodobieństwo, nie rozpoznanie.
- Sama średnia przy skośnym rozkładzie. Podaj medianę i IQR oraz odsetki w przedziałach.
Jeśli chcesz sprawdzić kodowanie AUDIT i dobór analiz w swojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak punktuje się pytania 9 i 10 w teście AUDIT?
Pytania 9 i 10 mają trzy odpowiedzi punktowane 0, 2 albo 4, a nie 0, 1, 2. Pozostałe osiem pytań punktuje się od 0 do 4. Formularze online często zapisują trzy opcje jako 1, 2, 3, więc przed sumowaniem przekoduj je, inaczej wynik ogólny będzie zaniżony.
Od ilu punktów AUDIT wskazuje na picie ryzykowne?
Klasyczny próg to 8 punktów: w badaniu rozwojowym 92% osób z piciem ryzykownym lub szkodliwym miało co najmniej 8 punktów (Saunders i in., 1993). Podręcznik WHO dzieli wynik na strefy 0–7, 8–15, 16–19 i 20–40, od edukacji po skierowanie do specjalisty (Babor i in., 2001), a strona AUDIT opisuje 8–14 jako picie ryzykowne lub szkodliwe i 15 lub więcej jako prawdopodobną zależność. To wyniki przesiewowe, nie rozpoznanie.
Czy dla kobiet próg w AUDIT jest niższy?
Podręcznik WHO podaje, że obniżenie progu do 7 u wszystkich kobiet i u mężczyzn po 65. roku życia zwiększa czułość w tych grupach (Babor i in., 2001). Przegląd Reinerta i Allena (2007) też wskazuje na niższy próg dla kobiet, a w badaniu hiszpańskich studentów najlepszy próg picia wysokiego ryzyka wyniósł 6 u kobiet i 8 u mężczyzn. Którą regułę przyjmujesz, ustal przed analizą i podaj źródło.
Czym różni się AUDIT-C od pełnego testu AUDIT?
AUDIT-C to trzy pierwsze pytania AUDIT, dotyczące spożycia, z wynikiem 0–12. W badaniach z podstawowej opieki zdrowotnej wykrywał nadużywanie alkoholu podobnie jak pełny test, przy progach ≥ 4 u mężczyzn i ≥ 3 u kobiet (Bradley i in., 2007). Pełny AUDIT daje dodatkowo informację o zależności i szkodach.
Czy test AUDIT można wykorzystać w pracy bez zgody autorów?
Według strony AUDIT test zatwierdzony przez WHO jest w domenie publicznej i do użytku niekomercyjnego nie wymaga zgody, jeśli nie zostanie istotnie zmieniony. W pracy zacytuj źródło i wersję językową, a właściwości polskiej wersji bierz z jej publikacji.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikWHO-5 – jak policzyć wynik
Skala 0–5, suma 0–25 razy 4, próg ≤ 50 w przesiewie depresji i zmiana o 10 punktów – z przykładem w R, PPV i wzorem opisu w pracy.
Czytaj →PoradnikTesty nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikTest Fagerströma (FTND) – jak policzyć wynik
Sześć pozycji, suma punktów, HSI, braki i rzetelność – z przykładem w R, omegą i wzorem opisu w pracy, bez etykiet uzależnienia.
Czytaj →Masz wyniki AUDIT i nie wiesz, który próg przyjąć?
Sprawdzimy kodowanie testu, dobór progów i analiz w Twojej próbie oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- AUDIT Screen. (b.d.). AUDIT: Alcohol Use Disorders Identification Test. Pobrano 1 listopada 2026 z https://auditscreen.org/about/scoring-audit/ ● Otwarty dostęp
- Babor, T. F., Higgins-Biddle, J. C., Saunders, J. B., & Monteiro, M. G. (2001). AUDIT: The Alcohol Use Disorders Identification Test. Guidelines for use in primary care (2nd ed.). World Health Organization. https://iris.who.int/handle/10665/67205 ● Otwarty dostęp: pełny tekst
- Bradley, K. A., DeBenedetti, A. F., Volk, R. J., Williams, E. C., Frank, D., & Kivlahan, D. R. (2007). AUDIT-C as a brief screen for alcohol misuse in primary care. Alcoholism: Clinical and Experimental Research, 31(7), 1208–1217. https://doi.org/10.1111/j.1530-0277.2007.00403.x
- García Carretero, M. Á., Novalbos Ruiz, J. P., Martínez Delgado, J. M., & O'Ferrall González, C. (2016). Validation of the Alcohol Use Disorders Identification Test in university students: AUDIT and AUDIT-C. Adicciones, 28(4), 194–204. https://doi.org/10.20882/adicciones.775 ● Otwarty dostęp
- Reinert, D. F., & Allen, J. P. (2007). The Alcohol Use Disorders Identification Test: An update of research findings. Alcoholism: Clinical and Experimental Research, 31(2), 185–199. https://doi.org/10.1111/j.1530-0277.2006.00295.x
- Saunders, J. B., Aasland, O. G., Babor, T. F., de la Fuente, J. R., & Grant, M. (1993). Development of the Alcohol Use Disorders Identification Test (AUDIT): WHO collaborative project on early detection of persons with harmful alcohol consumption–II. Addiction, 88(6), 791–804. https://doi.org/10.1111/j.1360-0443.1993.tb02093.x
- Shevlin, M., & Smith, G. W. (2007). The factor structure and concurrent validity of the alcohol use disorder identification test based on a nationally representative UK sample. Alcohol and Alcoholism, 42(6), 582–587. https://doi.org/10.1093/alcalc/agm045 ● Otwarty dostęp
Cytowania BibTeX
@misc{auditscreennd, author={{AUDIT Screen}}, title={{AUDIT: Alcohol Use Disorders Identification Test}}, url={https://auditscreen.org/about/scoring-audit/}}@techreport{babor2001audit, author={Babor, Thomas F. and Higgins-Biddle, John C. and Saunders, John B. and Monteiro, Maristela G.}, title={{AUDIT: The Alcohol Use Disorders Identification Test. Guidelines for use in primary care (2nd ed.)}}, year={2001}, institution={World Health Organization}, url={https://iris.who.int/handle/10665/67205}}@article{bradley2007auditc, author={Bradley, Katharine A. and DeBenedetti, Anna F. and Volk, Robert J. and Williams, Emily C. and Frank, Danielle and Kivlahan, Daniel R.}, title={{AUDIT-C as a brief screen for alcohol misuse in primary care}}, journal={Alcoholism: Clinical and Experimental Research}, year={2007}, volume={31}, number={7}, pages={1208--1217}, doi={10.1111/j.1530-0277.2007.00403.x}}@article{garciacarretero2016validation, author={García Carretero, Miguel Ángel and Novalbos Ruiz, José Pedro and Martínez Delgado, José Manuel and O'Ferrall González, Cristina}, title={{Validation of the Alcohol Use Disorders Identification Test in university students: AUDIT and AUDIT-C}}, journal={Adicciones}, year={2016}, volume={28}, number={4}, pages={194--204}, doi={10.20882/adicciones.775}}@article{reinert2007alcohol, author={Reinert, Duane F. and Allen, John P.}, title={{The Alcohol Use Disorders Identification Test: An update of research findings}}, journal={Alcoholism: Clinical and Experimental Research}, year={2007}, volume={31}, number={2}, pages={185--199}, doi={10.1111/j.1530-0277.2006.00295.x}}@article{saunders1993development, author={Saunders, John B. and Aasland, Olaf G. and Babor, Thomas F. and de la Fuente, Juan R. and Grant, Marcus}, title={{Development of the Alcohol Use Disorders Identification Test (AUDIT): WHO collaborative project on early detection of persons with harmful alcohol consumption–II}}, journal={Addiction}, year={1993}, volume={88}, number={6}, pages={791--804}, doi={10.1111/j.1360-0443.1993.tb02093.x}}@article{shevlin2007factor, author={Shevlin, Mark and Smith, Gillian W.}, title={{The factor structure and concurrent validity of the alcohol use disorder identification test based on a nationally representative UK sample}}, journal={Alcohol and Alcoholism}, year={2007}, volume={42}, number={6}, pages={582--587}, doi={10.1093/alcalc/agm045}}