Kim był Milton Friedman?
Milton Friedman (1912–2006) był amerykańskim ekonomistą, laureatem Nagrody Nobla z ekonomii za 1976 r. Zanim stał się znany jako ekonomista, zostawił w statystyce dwa trwałe ślady: nieparametryczny test Friedmana (1937) i udział w narodzinach analizy sekwencyjnej w czasie II wojny światowej. Żył od 31 lipca 1912 r. do 16 listopada 2006 r. (Who Was Who, 2007).
Ukończył Rutgers University (B.A., 1932), uzyskał magisterium na University of Chicago (1933) i doktorat na Columbia University (1946). Od 1937 r. współpracował z National Bureau of Economic Research, w latach 1946–1976 wykładał w Chicago, a od 1977 r. był pracownikiem naukowym Hoover Institution na Uniwersytecie Stanforda (Hoover Institution, b.d.). Teira (2007) pokazuje, że w swojej edukacji statystycznej zetknął się z trzema podejściami do wnioskowania – Fishera, Neymana i Savage’a.
Najważniejsze pomysły
- Test Friedmana (1937). W artykule w „Journal of the American Statistical Association” zaproponował porównywanie kilku warunków na podstawie rang nadawanych osobno w każdym bloku (osobie, miejscu, sędziemu), tak by nie zakładać normalności rozkładu, jak robi to analiza wariancji (Friedman, 1937). Statystyka testu jest prostą funkcją współczynnika zgodności W Kendalla: W = χ²F / [n(k − 1)].
- Statistical Research Group (SRG). W czasie wojny pracował w działającej na Columbia University grupie, która rozwiązywała problemy statystyczne dla wojska (Wallis, 1980; Wald, 1947).
- Analiza sekwencyjna. W marcu 1943 r. Friedman i W. Allen Wallis zaproponowali Abrahamowi Waldowi problem testu, który decyduje po każdej kolejnej obserwacji. Wald podziękował im w przedmowie książki „Sequential Analysis”: to ich jasne sformułowanie problemu dało mu impuls do badań, z których powstał sekwencyjny test ilorazu wiarygodności (Wald, 1947).
- Ekonomia. Friedman kierował chicagowską szkołą ekonomii monetarnej, która podkreślała rolę ilości pieniądza w wahaniach koniunktury i inflacji; napisał m.in. „A Monetary History of the United States” (z Anną J. Schwartz) oraz, z żoną Rose D. Friedman, „Capitalism and Freedom” i „Free to Choose” (Hoover Institution, b.d.). Tych poglądów nie oceniamy – to hasło dotyczy jego statystyki.
Ciekawostka
Test, który zaczął się od uwagi oficera marynarki. Według relacji Walda (1947) problem analizy sekwencyjnej pojawił się w SRG po uwagach kapitana G. L. Schuylera z Biura Uzbrojenia Marynarki Wojennej USA. Friedman i Wallis przypuszczali, że da się zbudować test, który – sprawdzając wynik po każdej obserwacji – kontroluje błędy tak samo jak najlepszy test o z góry ustalonej liczbie obserwacji, a potrzebuje ich średnio znacznie mniej. Pokazali kilka przykładów, a potem przekazali problem Waldowi.
Ze względu na znaczenie dla prób sprzętu wojskowego metodę utajniono: Wald przedstawił ją we wrześniu 1943 r. w raporcie z klauzulą „Restricted”. Sam Friedman nie zniknął z tej historii – w 1944 r. niezależnie od George’a W. Browna (a nieco później niż C. M. Stockman w Anglii) wyznaczył krzywą operacyjno-charakterystyczną testu sekwencyjnego dla rozkładu dwumianowego (Wald, 1947).
Przykład na historycznych danych
Pakiet MASS zawiera zbiór immer: plony pięciu odmian jęczmienia (Manchuria, Svansota, Velvet, Trebi, Peatland) w sześciu miejscowościach w latach 1931 i 1932, z pracy Immera, Hayesa i Powersa (1934), wykorzystywane też przez Fishera w „The Design of Experiments”. Miejscowość to naturalny blok: gleby i pogoda różnią się między nimi bardziej niż odmiany. Test Friedmana porównuje odmiany wyłącznie na podstawie ich kolejności w każdej miejscowości.
W 1931 r. średnie rangi wyniosły: Trebi 4.50, Peatland 3.50, Velvet 2.83, Manchuria 2.50 i Svansota 1.67. Statystyka Friedmana χ²F(4) = 10.93, p = .027, a W Kendalla = .456 (umiarkowana zgodność miejscowości w uszeregowaniu odmian). Przy sześciu blokach przybliżenie rozkładem chi-kwadrat jest zgrubne, więc policzyliśmy też test permutacyjny: 20 000 losowych przetasowań rang w każdym bloku (ziarno 1937) dało p = .018 (błąd Monte Carlo .001). Dwuczynnikowa ANOVA na surowych plonach (blok + odmiana) daje F(4, 20) = 4.23, p = .012. Dla plonów z 1932 r. test Friedmana daje χ²F(4) = 8.40, p = .078.
Na rysunku
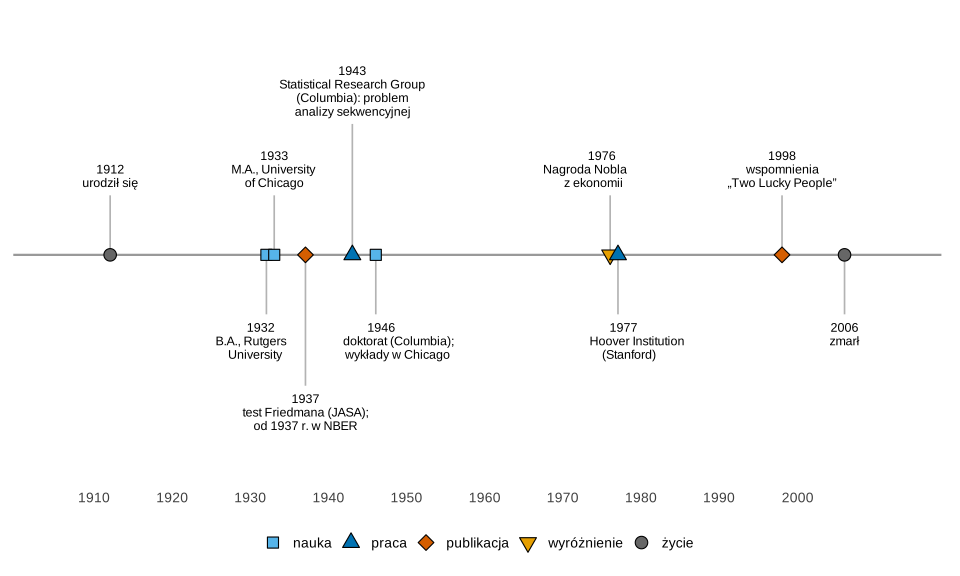
Co widać. Statystyczne prace Friedmana mieszczą się w pierwszych kilkunastu latach jego kariery, przed długim okresem w Chicago i Hoover Institution.
Na co uważać. Źródła różnią się w datach: profil Hoover Institution podaje wykłady w Chicago w latach 1946–1976 i przejście do Hoover Institution w 1977 r., a Who Was Who (2007) – profesurę w latach 1948–1982 i pracę w Hoover Institution od 1976 r.
Podpis do pracy:
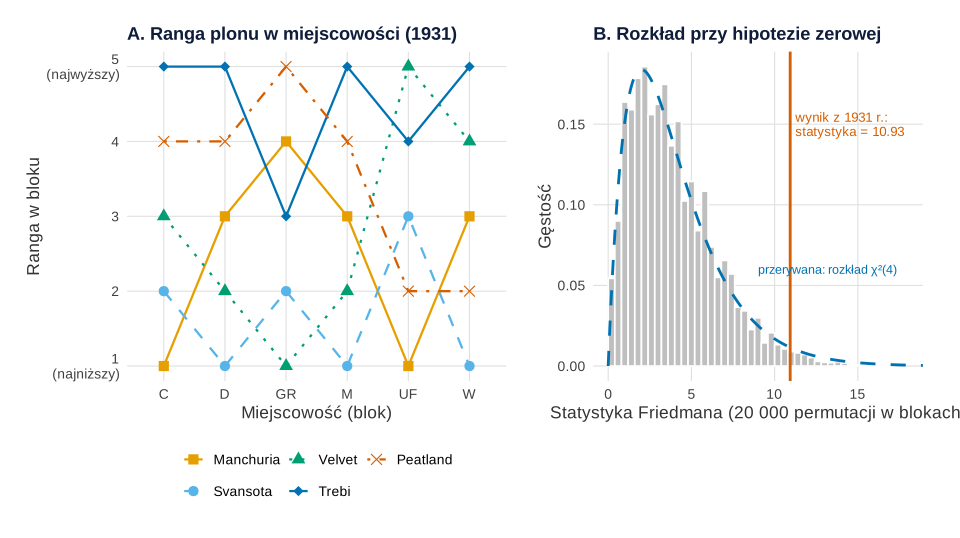
Co widać. Trebi wypada najlepiej w czterech z sześciu miejscowości, a Svansota najgorzej w trzech, ale żadna kolejność nie powtarza się wszędzie. Wynik 10.93 leży w prawym ogonie rozkładu permutacyjnego; krzywa chi-kwadrat przybliża ten rozkład tylko z grubsza, bo statystyka przy sześciu blokach przyjmuje niewiele wartości.
Na co uważać. Test Friedmana pokazuje tylko, że odmiany różnią się kolejnością, a nie które i o ile – to wymaga porównań post hoc. Rangi gubią wielkość różnic: w miejscowości, w której plony prawie się nie różnią, ranga 5 waży tyle samo co w miejscowości z dużymi różnicami.
Podpis do pracy:
Gdzie spotkasz Friedmana w swojej pracy
- Gdy te same osoby oceniają trzy lub więcej warunków na skali porządkowej albo rozkład wyników jest silnie skośny, test Friedmana zastępuje ANOVA z powtarzanymi pomiarami; krok po kroku opisuje to wpis testy nieparametryczne krok po kroku.
- Po istotnym wyniku sprawdzasz pary warunków, np. testem Nemenyiego albo testem Conovera; gdy bloki wyraźnie różnią się rozstępem wyników, rozważ test Quade’a.
- Jako miarę wielkości efektu podajesz W Kendalla, a w raporcie: χ²F(df), liczbę bloków i p, przy małej liczbie bloków najlepiej z wartością p dokładną lub permutacyjną.
- Pomysł analizy sekwencyjnej wraca w badaniach z analizami pośrednimi i w testach A/B z granicami zatrzymania (zob. wpis sekwencyjny test A/B).
Spory, mity i trudne strony
- Kto wymyślił analizę sekwencyjną? Wald (1947) przypisuje sformułowanie problemu Friedmanowi i Wallisowi, a rozwinięcie teorii – własnym badaniom, ale wymienia też poprzedników: wieloetapowe doświadczenia omawiane przez Harolda Hotellinga, kolejne spisy próbne Mahalanobisa w Bengalu i schemat wielokrotnego pobierania próby Bartky’ego, opublikowany prawie rok później i wtedy Friedmanowi i Wallisowi nieznany.
- Statystyk czy ekonomista? Teira (2007) twierdzi, że podejścia Fishera, Neymana i Savage’a inaczej oceniają prognozy statystyczne i że w tym świetle teza metodologicznego eseju Friedmana z 1953 r. jest w dużej mierze nieuzasadniona. To spór historyków metodologii ekonomii; nie rozstrzygamy go tutaj.
Test Friedmana w R
Kod wczytuje zbiór immer z pakietu MASS, nadaje rangi odmianom w każdej miejscowości, liczy statystykę Friedmana ręcznie i funkcją friedman.test(), W Kendalla, wartość p z 20 000 permutacji w blokach (ziarno 1937) i dla porównania dwuczynnikową ANOVA, a na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne.
1. Rangi w blokach i test Friedmana: rysunek 2
Kod R rysunku 2
# Milton Friedman: test Friedmana na plonach jęczmienia (Immer i in., 1934; MASS::immer) – rangi w blokach
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c("#E69F00", "#56B4E9", "#009E73", "#0072B2", "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(immer, package = "MASS")        # 5 odmian jęczmienia (Var) w 6 miejscowościach (Loc); plon w 1931 (Y1) i 1932 r. (Y2)
odmiany <- c(M = "Manchuria", S = "Svansota", V = "Velvet", T = "Trebi", P = "Peatland")
plon <- xtabs(Y1 ~ Loc + Var, data = immer)          # macierz 6 bloków × 5 odmian, rok 1931
plon <- plon[, names(odmiany)]
rangi <- t(apply(plon, 1, rank))                     # rangi w obrębie każdej miejscowości (1 = najniższy plon)
rangi
colMeans(rangi)                                      # średnia ranga odmiany

# Statystyka Friedmana policzona ręcznie i funkcją friedman.test()
n <- nrow(rangi); k <- ncol(rangi)
chi_F <- 12 / (n * k * (k + 1)) * sum(colSums(rangi)^2) - 3 * n * (k + 1)
round(c(chi_F = chi_F, df = k - 1, p_chi2 = pchisq(chi_F, k - 1, lower.tail = FALSE)), 4)
friedman.test(plon)
round(c(W_Kendalla = chi_F / (n * (k - 1))), 3)                # zgodność miejscowości w uszeregowaniu odmian

# p permutacyjne: tasujemy rangi niezależnie w każdym bloku (hipoteza zerowa: odmiany wymienialne)
set.seed(1937)
statystyka <- function(r) 12 / (n * k * (k + 1)) * sum(colSums(r)^2) - 3 * n * (k + 1)
perm <- replicate(20000, statystyka(t(apply(rangi, 1, sample))))
p_perm <- mean(perm >= chi_F - 1e-9)                 # tolerancja na błąd zaokrąglenia przy równych wartościach
round(c(p_permutacyjne = p_perm, blad_MC = sqrt(p_perm * (1 - p_perm) / 20000)), 4)

# Dla porównania: dwuczynnikowa ANOVA na surowych plonach (bloki + odmiany)
d1931 <- data.frame(plon = as.vector(plon), Loc = factor(rep(rownames(plon), k)), Var = factor(rep(colnames(plon), each = n)))
summary(aov(plon ~ Loc + Var, data = d1931))
# I ten sam test dla plonów z 1932 r.
friedman.test(xtabs(Y2 ~ Loc + Var, data = immer)[, names(odmiany)])

# Rysunek 2A: ranga każdej odmiany w każdej miejscowości
dr <- data.frame(Loc = rep(rownames(rangi), k), odmiana = factor(rep(odmiany[colnames(rangi)], each = n), levels = odmiany),
                 ranga = as.vector(rangi))
dr$Loc <- factor(dr$Loc, levels = rownames(rangi))
pA <- ggplot(dr, aes(Loc, ranga, group = odmiana, colour = odmiana, shape = odmiana, linetype = odmiana)) +
  geom_line(linewidth = 0.8) +
  geom_point(size = 3.2) +
  scale_colour_manual(values = setNames(oi, odmiany), name = NULL) +
  scale_shape_manual(values = setNames(c(15, 16, 17, 18, 4), odmiany), name = NULL) +
  scale_linetype_manual(values = setNames(c("solid", "dashed", "dotted", "solid", "dotdash"), odmiany), name = NULL) +
  scale_y_continuous(breaks = 1:5, labels = c("1\n(najniższy)", "2", "3", "4", "5\n(najwyższy)")) +
  labs(title = "A. Ranga plonu w miejscowości (1931)", x = "Miejscowość (blok)", y = "Ranga w bloku") +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  motyw
# Rysunek 2B: rozkład permutacyjny statystyki Friedmana i przybliżenie chi-kwadrat
siatka <- data.frame(x = seq(0, 20, by = 0.05))
siatka$gestosc <- dchisq(siatka$x, df = k - 1)
pB <- ggplot(data.frame(chi = perm), aes(chi)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 0.4, boundary = 0, fill = "grey75", colour = "white") +
  geom_line(data = siatka, aes(x, gestosc), colour = "#0072B2", linewidth = 1, linetype = "dashed") +
  geom_vline(xintercept = chi_F, colour = "#D55E00", linewidth = 1) +
  annotate("text", x = chi_F + 0.3, y = 0.15, label = sprintf("wynik z 1931 r.:\nstatystyka = %.2f", chi_F), hjust = 0, size = 3.5,
           colour = "#D55E00", lineheight = 0.9) +
  annotate("text", x = 9, y = 0.06, label = "przerywana: rozkład χ²(4)", hjust = 0, size = 3.3, colour = "#0072B2") +
  coord_cartesian(xlim = c(0, 18)) +
  labs(title = "B. Rozkład przy hipotezie zerowej", x = "Statystyka Friedmana (20 000 permutacji w blokach)", y = "Gęstość") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.15, 1))
p2
Wynik w R
    Var
Loc  M S V T P
  C  1 2 3 5 4
  D  3 1 2 5 4
  GR 4 2 1 3 5
  M  3 1 2 5 4
  UF 1 3 5 4 2
  W  3 1 4 5 2
       M        S        V        T        P
2.500000 1.666667 2.833333 4.500000 3.500000
  chi_F      df  p_chi2
10.9333  4.0000  0.0273

	Friedman rank sum test

data:  plon
Friedman chi-squared = 10.933, df = 4, p-value = 0.02732

W_Kendalla
     0.456
p_permutacyjne        blad_MC
        0.0176         0.0009
            Df Sum Sq Mean Sq F value   Pr(>F)
Loc          5  17830    3566  21.892 1.75e-07 ***
Var          4   2757     689   4.231   0.0121 *
Residuals   20   3258     163
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

	Friedman rank sum test

data:  xtabs(Y2 ~ Loc + Var, data = immer)[, names(odmiany)]
Friedman chi-squared = 8.4, df = 4, p-value = 0.07798
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Milton Friedman, 1912–2006 – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1912, 1932, 1933, 1937, 1943, 1946, 1976, 1977, 1998, 2006),
  opis = c("urodził się", "B.A., Rutgers\nUniversity", "M.A., University\nof Chicago",
           "test Friedmana (JASA);\nod 1937 r. w NBER", "Statistical Research Group\n(Columbia): problem\nanalizy sekwencyjnej",
           "doktorat (Columbia);\nwykłady w Chicago", "Nagroda Nobla\nz ekonomii", "Hoover Institution\n(Stanford)",
           "wspomnienia\n„Two Lucky People”", "zmarł"),
  rodzaj = c("życie", "nauka", "nauka", "publikacja", "praca", "nauka", "wyróżnienie", "praca", "publikacja", "życie"))
# Etykiety na przemian nad (1) i pod (−1) osią; gęste lata 1932–1946 i 1976–1977 na dwóch wysokościach
zdarzenia$strona     <- c(1, -1, 1, -1, 1, -1, 1, -1, 1, -1)
zdarzenia$poziom     <- c(0.5, 0.5, 0.5, 1.1, 1.1, 0.5, 0.5, 0.5, 0.5, 0.5)
zdarzenia$wyrownanie <- c(0.5, 0.7, 0.5, 0.5, 0.5, 0.3, 0.8, 0.3, 0.5, 0.5)
ksztalty <- c("życie" = 21, "nauka" = 22, "praca" = 24, "publikacja" = 23, "wyróżnienie" = 25)
kolory <- c("życie" = "grey40", "nauka" = "#56B4E9", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#E69F00")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = (poziom + 0.07) * strona, label = paste0(rok, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie),
            size = 3.3, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1905, 2013), breaks = seq(1910, 2000, by = 10)) +
  scale_y_continuous(limits = c(-1.75, 1.85)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test Friedmana – funkcja friedman.test(), ANOVA – aov() z pakietu stats; dane – pakiet MASS; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czy test Friedmana wymyślił Milton Friedman, ekonomista?
Tak. Test opisał w 1937 r. w „Journal of the American Statistical Association” jako sposób porównania kilku warunków na podstawie rang nadawanych w każdym bloku, bez założenia normalności (Friedman, 1937). Ten sam Friedman otrzymał później Nagrodę Nobla z ekonomii za 1976 r. (Hoover Institution, b.d.).
Jaki był udział Friedmana w powstaniu analizy sekwencyjnej?
W marcu 1943 r. w Statistical Research Group na Columbia University Friedman i W. Allen Wallis sformułowali problem testu decydującego po każdej obserwacji i przekazali go Abrahamowi Waldowi, który zbudował sekwencyjny test ilorazu wiarygodności (Wald, 1947).
Jak test Friedmana wiąże się z W Kendalla?
Statystyka Friedmana i współczynnik zgodności W Kendalla to dwie strony tego samego rachunku: W = χ²F / [n(k − 1)], gdzie n to liczba bloków, a k – liczba warunków. W przykładzie z plonami jęczmienia χ²F(4) = 10.93 odpowiada W = .456.
Kiedy żył Milton Friedman?
Od 31 lipca 1912 r. do 16 listopada 2006 r. (Who Was Who, 2007). Studiował na Rutgers, w Chicago i na Columbii (doktorat 1946), wykładał w Chicago, a od 1977 r. pracował w Hoover Institution na Uniwersytecie Stanforda (Hoover Institution, b.d.).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Testy nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikSekwencyjny test A/B i granice zatrzymania
Gazeta cyfrowa testuje paywall z 4 analizami pośrednimi: granice O’Briena–Fleminga i Pococka, fałszywe alarmy, czas testu i zawyżony efekt – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Friedman, M. (1937). The use of ranks to avoid the assumption of normality implicit in the analysis of variance. Journal of the American Statistical Association, 32(200), 675–701. https://doi.org/10.1080/01621459.1937.10503522
- Hoover Institution. (b.d.). Milton Friedman. Hoover Institution – Profiles. Pobrano 19 listopada 2026 z https://www.hoover.org/profiles/milton-friedman ● Otwarty dostęp
- Teira, D. (2007). Milton Friedman, the statistical methodologist. History of Political Economy, 39(3), 511–527. https://doi.org/10.1215/00182702-2007-020 ● Otwarty dostęp: pełny tekst
- Wald, A. (1947). Sequential analysis. Wiley.
- Wallis, W. A. (1980). The Statistical Research Group, 1942–1945. Journal of the American Statistical Association, 75(370), 320–330. https://doi.org/10.1080/01621459.1980.10477469
- Who Was Who. (2007). Friedman, Prof. Milton, (31 July 1912–16 Nov. 2006), Economist, USA; Senior Research Fellow, Hoover Institution, Stanford University, since 1976; Professor Emeritus of Economics, University of Chicago, since 1982 (Professor of Economics, 1948–82); Member of Research Staff, National Bureau of Economic Research, 1948–81; Economic Columnist, Newsweek, 1966–84. In Who was who. Oxford University Press. https://doi.org/10.1093/ww/9780199540884.013.u16489
Cytowania BibTeX
@article{friedman1937use, author={Friedman, Milton}, title={{The use of ranks to avoid the assumption of normality implicit in the analysis of variance}}, journal={Journal of the American Statistical Association}, year={1937}, volume={32}, number={200}, pages={675--701}, doi={10.1080/01621459.1937.10503522}}@misc{hooverndfriedman, author={{Hoover Institution}}, title={{Milton Friedman}}, howpublished={Hoover Institution – Profiles}, publisher={Stanford University}, url={https://www.hoover.org/profiles/milton-friedman}}@article{teira2007milton, author={Teira, David}, title={{Milton Friedman, the statistical methodologist}}, journal={History of Political Economy}, year={2007}, volume={39}, number={3}, pages={511--527}, doi={10.1215/00182702-2007-020}}@book{wald1947sequential, author={Wald, Abraham}, title={{Sequential analysis}}, year={1947}, publisher={Wiley}, url={https://lccn.loc.gov/47004257}}@article{wallis1980statistical, author={Wallis, W. Allen}, title={{The Statistical Research Group, 1942–1945}}, journal={Journal of the American Statistical Association}, year={1980}, volume={75}, number={370}, pages={320--330}, doi={10.1080/01621459.1980.10477469}}@incollection{whowaswho2007friedman, author={{Who Was Who}}, title={{Friedman, Prof. Milton, (31 July 1912–16 Nov. 2006), Economist, USA; Senior Research Fellow, Hoover Institution, Stanford University, since 1976; Professor Emeritus of Economics, University of Chicago, since 1982 (Professor of Economics, 1948–82); Member of Research Staff, National Bureau of Economic Research, 1948–81; Economic Columnist, Newsweek, 1966–84}}, booktitle={Who was who}, year={2007}, publisher={Oxford University Press}, doi={10.1093/ww/9780199540884.013.u16489}}