Abstract do pracy: tłumaczysz terminy, a nie zdania
Streszczenie po polsku jest gotowe, a regulamin wymaga jeszcze wersji angielskiej. Większość problemów z tą wersją nie wynika ze słabej gramatyki, tylko z terminów statystycznych przetłumaczonych dosłownie: „probe” zamiast sample, „examined persons” zamiast participants, „significant influence” w badaniu ankietowym z jednym pomiarem.
Ten wpis jest węższy niż poradnik o abstrakcie strukturalnym i strukturze IMRAD. Tam znajdziesz układ abstraktu, proporcje części i kontrolę zgodności z wynikami. Tutaj dostajesz narzędzia do samego przekładu: tabelę 57 terminów polsko-angielskich, listę „fałszywych przyjaciół”, zasady zapisu liczb w wersji angielskiej, szablon streszczenia strukturalnego z gotowymi zdaniami i krótki kod R, który te same wyniki wypisuje w zapisie polskim i angielskim.
Przykład przewodni (wymyślony, dane symulowane). Studentka pielęgniarstwa przeprowadziła przekrojowe badanie online wśród 236 studentów I i III roku dobranych celowo. Sprawdzała, czy praca zarobkowa w trakcie studiów wiąże się z poziomem stresu (skala 1–5) i z jakością snu. Wszystkie liczby w zdaniach i w przykładowym abstrakcie pochodzą z kodu R na końcu wpisu.
Tabela terminów polsko-angielskich
Tabele obejmują terminy, które najczęściej trafiają do streszczeń prac z psychologii, pielęgniarstwa, zdrowia publicznego i pedagogiki. Kolumna „Uwaga” podpowiada, gdzie łatwo o błąd. Nazwy angielskie są w formie, w jakiej występują w tekście (małe litery, bez przedimka). Pełną listę możesz pobrać jako plik CSV: slownik-terminow-statystycznych-pl-en.csv (57 terminów w czterech grupach).
Schemat badania i próba
| Po polsku | Po angielsku | Uwaga |
|---|---|---|
| badanie przekrojowe | cross-sectional study | nazwij schemat już w Methods |
| badanie podłużne | longitudinal study | kilka pomiarów tych samych osób |
| badanie kohortowe | cohort study | |
| eksperyment, badanie eksperymentalne | experiment, experimental study | tylko przy losowym przydziale |
| badanie quasi-eksperymentalne | quasi-experimental study | grupy bez losowania |
| badanie ankietowe (sondaż) | survey | survey = całe badanie |
| kwestionariusz, ankieta (narzędzie) | questionnaire | questionnaire = arkusz pytań |
| próba | sample | nie „probe” ani „trial” |
| dobór celowy | purposive sampling | dobór według ustalonych cech |
| dobór wygodny (dostępnościowy) | convenience sampling | np. ankieta w mediach społecznościowych |
| dobór losowy | random sampling | nie myl z „random assignment” |
| losowy przydział do grup | random assignment, randomization | |
| osoby badane, badani | participants; respondents (ankieta) | nie „examined persons” |
| kryteria włączenia i wyłączenia | inclusion and exclusion criteria | |
| grupa kontrolna | control group | |
| pomiar wyjściowy i końcowy | baseline and follow-up (posttest) |
Zmienne, pomiar i statystyki opisowe
| Po polsku | Po angielsku | Uwaga |
|---|---|---|
| zmienna zależna | dependent variable; outcome | outcome – częściej w medycynie |
| zmienna niezależna | independent variable; predictor; exposure | predictor – w regresji |
| zmienna pośrednicząca | mediator | |
| zmienna moderująca | moderator | |
| zmienna kontrolna | covariate; control variable | |
| pozycja skali (pytanie) | item | |
| wynik ogólny skali | total score; scale score | |
| rzetelność; spójność wewnętrzna | reliability; internal consistency | |
| trafność | validity | |
| średnia | mean (M) | nie „average” w wynikach |
| odchylenie standardowe | standard deviation (SD) | |
| mediana | median (Mdn) | |
| rozstęp międzykwartylowy | interquartile range (IQR) | |
| liczebność; odsetek | frequency (n); percentage | „percent” tylko z liczbą |
| rozkład normalny | normal distribution |
Testy i modele
| Po polsku | Po angielsku | Uwaga |
|---|---|---|
| test t dla prób niezależnych | independent-samples t test | Welch’s t test – wersja Welcha |
| test t dla prób zależnych | paired-samples t test | |
| jednoczynnikowa analiza wariancji | one-way analysis of variance (ANOVA) | |
| analiza wariancji z powtarzanymi pomiarami | repeated-measures ANOVA | |
| porównania post hoc | post hoc comparisons | |
| test U Manna–Whitneya | Mann–Whitney U test | |
| test Kruskala–Wallisa | Kruskal–Wallis test | |
| test chi-kwadrat niezależności | chi-square test of independence | χ²(df, N = …) = … |
| dokładny test Fishera | Fisher’s exact test | |
| korelacja Pearsona; Spearmana | Pearson correlation; Spearman’s rank correlation | |
| regresja liniowa wieloraka | multiple linear regression | |
| regresja logistyczna | logistic regression |
Wnioskowanie i wielkość efektu
| Po polsku | Po angielsku | Uwaga |
|---|---|---|
| istotny statystycznie | statistically significant | zawsze ze słowem „statistically” |
| nieistotny statystycznie | not statistically significant; nonsignificant | nie „insignificant” |
| „tendencja statystyczna” | brak odpowiednika – podaj p, efekt i CI | nie „trend towards significance” |
| poziom istotności | significance level (α) | „at the .05 level” |
| hipoteza zerowa | null hypothesis | |
| hipoteza potwierdziła się | the hypothesis was supported | nie „was proved” |
| przedział ufności | confidence interval (CI) | 95% CI [a, b] |
| wielkość efektu | effect size | |
| iloraz szans | odds ratio (OR) | „higher odds”, nie „higher risk” |
| stopnie swobody | degrees of freedom (df) | |
| błąd standardowy | standard error (SE) | |
| moc testu | statistical power | |
| model wyjaśniał [x]% wariancji | the model explained [x]% of the variance | |
| istotność kliniczna | clinical significance; clinically important difference | osobno od istotności statystycznej |
Dwie zasady pomagają w przypadkach, których nie ma w tabeli. Po pierwsze, nazwę testu lub schematu sprawdź w angielskim podręczniku albo artykule, a nie w słowniku ogólnym. Po drugie, raz wybranego terminu używaj konsekwentnie: jeśli w Methods piszesz participants, nie zmieniaj go w Results na subjects i respondents na zmianę. Słowa kluczowe (Keywords) wybieraj według tych samych terminów – jak je dobrać, opisuje hasło słowa kluczowe.
Fałszywi przyjaciele i typowe błędy
Najgroźniejsze są słowa, które wyglądają znajomo i są poprawnym angielskim, ale znaczą co innego niż w polskim zdaniu. Tabela zbiera te, które najczęściej pojawiają się w streszczeniach prac dyplomowych.
| Po polsku | Częsty błąd | Lepiej |
|---|---|---|
| istotny (różnica, wynik) | a significant improvement (bez dopowiedzenia) | a statistically significant improvement; o znaczeniu praktycznym: clinically important, meaningful |
| „tendencja statystyczna”, „na granicy istotności” | a trend towards significance, a tendency | the difference was not statistically significant, p = [dokładna wartość] + różnica i 95% CI |
| korelacja była dodatnia | the correlation was positive (bez kierunku zmiennych) | higher stress was associated with shorter sleep, r = −.48 |
| wpływ X na Y (badanie przekrojowe) | the influence / impact / effect of X on Y | the association between X and Y; X was associated with Y |
| zależność między zmiennymi | dependence (też: uzależnienie) | relationship, association |
| próba | probe, trial | sample (trial tylko o badaniu klinicznym) |
| badania (wiele badań) | researches | studies; research jest niepoliczalne |
| osoby badane | examined persons, the examined | participants; w ankiecie także respondents |
| stwierdzono, że… | it was stated that… | we found that…; X was higher in… |
| hipoteza potwierdziła się | the hypothesis was proved / confirmed | the hypothesis was supported |
| średnia | average (w wynikach) | mean, M |
| dane pokazują | the data shows | the data show (w stylu APA data to liczba mnoga) |
| aktualny; ewentualnie | actual; eventually | current; possibly, alternatively |
| na poziomie istotności 0.05 | on the significance level 0.05 | at the .05 level; with α = .05 |
| w niniejszej pracy | in the present work | in this study; in this thesis |
„Significant” bez „statistically”
Po angielsku significant znaczy też „ważny, znaczący”. Zdanie the training led to a significant reduction in anxiety czytelnik z medycyny lub pielęgniarstwa zrozumie jako „redukcję istotną dla pacjentów”, choć autor miał na myśli tylko p < .05. Oświadczenie Amerykańskiego Towarzystwa Statystycznego przypomina, że wartość p nie mierzy wielkości efektu ani ważności wyniku (Wasserstein i Lazar, 2016). Dlatego pisz statistically significant, a o znaczeniu praktycznym mów osobno – przez wielkość efektu albo minimalną różnicę ważną dla pacjenta (MCID). Wynik nieistotny to not statistically significant lub nonsignificant, nigdy insignificant (to słowo znaczy „błahy”).
„Tendencja statystyczna” nie ma dobrego przekładu
W polskich pracach często pojawia się „tendencja statystyczna” przy p między .05 a .10. Angielskie a trend towards significance jest równie mylące: Wood i in. (2014) pokazali, że takie opisy dają złudne wrażenie, jakby wynik „prawie” był istotny i wystarczyło dołożyć danych. Zamiast tego podaj dokładne p, kierunek i wielkość różnicy z przedziałem ufności. Szerzej o tym problemie piszemy w haśle o marginalnej istotności i we wpisie jak opisać wynik nieistotny.
„Influence” i „effect” w badaniu przekrojowym
„Wpływ” to w polskich pracach często skrót myślowy. Po angielsku influence, impact, effect of X on Y i X increases Y brzmią jednoznacznie przyczynowo. W badaniu przekrojowym z jednym pomiarem pisz association, was associated with, correlated with, predicted (w regresji, bez sugestii przyczynowości). W przeglądzie 50 najczęściej udostępnianych artykułów naukowych o zdrowiu recenzenci uznali język 34% z nich za zbyt mocny w stosunku do siły wnioskowania przyczynowego (Haber i in., 2018). To samo dotyczy streszczenia pracy dyplomowej. Granice wnioskowania z różnych schematów opisuje hasło korelacja a przyczynowość, a polskie zdania do dyskusji – wpis jak napisać dyskusję wyników.
Zapis liczb w wersji angielskiej
W języku polskim separatorem dziesiętnym jest przecinek, a w angielskim – kropka. Na metodolog.pl stosujemy kropkę także w polskim tekście, zgodnie z konwencją APA; wiele uczelni wymaga jednak w polskiej części pracy przecinka. Niezależnie od tego, co stosujesz po polsku, w angielskim streszczeniu używaj kropki, a reszty zapisu – według stylu APA (American Psychological Association, 2020). Przewodnik APA po liczbach i statystykach zaleca m.in. dokładne wartości p z dwoma lub trzema miejscami po przecinku, zapis p < .001 dla mniejszych wartości, pomijanie zera przed kropką dla statystyk, które nie mogą przekroczyć 1, i kursywę dla symboli statystycznych (American Psychological Association, 2024).
| Co zapisujesz | Polski tekst (przecinek) | Angielski (APA) |
|---|---|---|
| separator dziesiętny | 3,46 | 3.46 |
| tysiące | 1 250 (spacja) | 1,250 (przecinek) |
| miary do 1: p, r, α, R² | zwykle z zerem: 0,38 | bez zera: .38 |
| miary bez ograniczenia: M, SD, t, d, OR | 0,41 | 0.41 (z zerem) |
| bardzo małe p | „p < 0,001” | p < .001 (nigdy „.000”) |
| granice przedziału ufności | [−0,12; 0,45] – średnik | [−0.12, 0.45] – przecinek |
| odsetek | 45,2% | 45.2% |
| liczba ujemna | −2,46 | −2.46 (znak minus, nie łącznik) |
Najwięcej kłopotu sprawia przedział ufności. Przy przecinku dziesiętnym zapis „[0,12, 0,45]” jest nieczytelny, dlatego w polskim tekście granice rozdziela się średnikiem. Po przełożeniu na angielski średnik musi zniknąć: 95% CI [0.12, 0.45]. Jak raportować przedziały dla różnych miar, pokazuje wpis przedziały ufności w pracy, a wszystkie zasady zapisu wyników – poradnik jak opisać wyniki w stylu APA.
W kodzie R (przepis 1) obie wersje powstają z tych samych liczb funkcją formatC() z argumentami decimal.mark i big.mark. Funkcja format() też je ma, ale sama dobiera liczbę cyfr i wyrównuje szerokość, więc do zdań lepsza jest formatC(x, format = "f", digits = 2). Uwaga na „piątki”: formatC() zaokrągla dokładną wartość binarną liczby, więc 0.125 daje 0.12, a 0.135 – 0.14. Jeśli liczba leży na granicy zaokrąglenia, przepisuj ją z wydruku programu, a nie zaokrąglaj w pamięci.
Szablon streszczenia strukturalnego po angielsku
Abstrakt strukturalny ma nagłówki, zwykle Background, Objective (lub Aim), Methods, Results i Conclusions. W porównaniu z tradycyjnym jest dłuższy, ale zawiera więcej informacji i łatwiej go czytać i przeszukiwać (Hartley, 2014). Nawet jeśli uczelnia wymaga jednego akapitu bez nagłówków, napisz najpierw wersję z nagłówkami i usuń je na końcu – kolejność treści zostaje ta sama. Definicję i warianty znajdziesz w haśle abstrakt strukturalny.
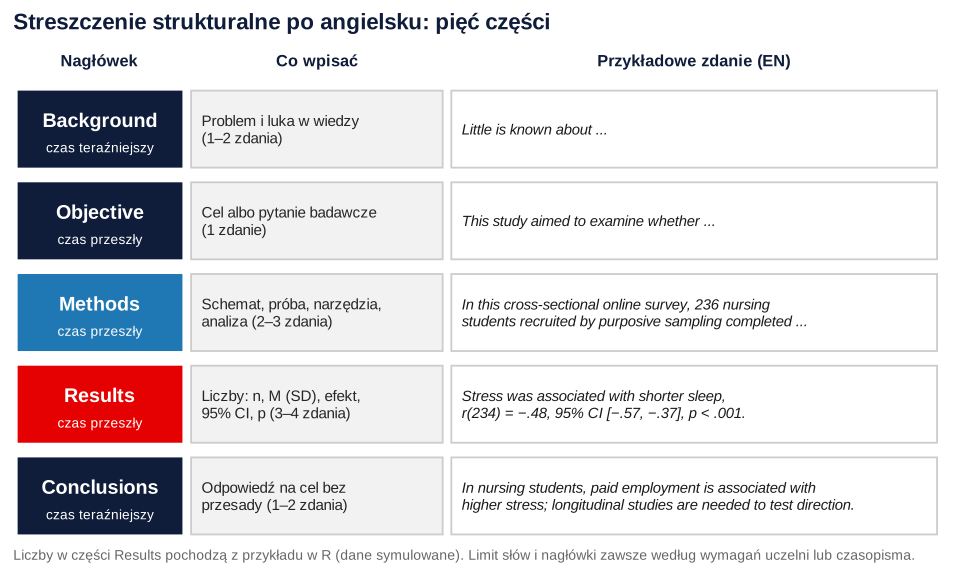
Czasy gramatyczne. To, co zrobiłeś(-aś) i co wyszło w Twoim badaniu (Methods, Results), opisuj w czasie przeszłym: participants completed, stress was higher. To, co jest ogólną wiedzą lub wnioskiem (Background, Conclusions), w czasie teraźniejszym: little is known, these findings suggest. Strona bierna (data were collected) i pierwsza osoba (we collected) są dopuszczalne – w pracy jednego autora wybierz jedno i trzymaj się go.
Methods: schemat i dobór próby nazwij wprost. Pierwszy punkt listy STROBE dla badań obserwacyjnych dotyczy tytułu i streszczenia (von Elm i in., 2007) – czytelnik ma od razu wiedzieć, czy było to badanie przekrojowe, kohortowe czy eksperyment. Nie zastępuj nazwy schematu ogólnikiem a study was conducted.
Zdania do każdej części
| Część | Początki zdań |
|---|---|
| Background | Little is known about…; Previous studies have focused on…, but…; [Problem] is common among… (tylko ze źródłem w tekście pracy) |
| Objective | This study aimed to examine whether…; The aim of this study was to assess…; We hypothesized that… |
| Methods | In this cross-sectional online survey, [N] [participants] recruited by purposive / convenience sampling completed…; [Variable] was measured with…; Data were analysed using… |
| Results | [Group A] reported higher [Y] than [Group B]…; [X] was associated with [Y], r = …; [Y] did not differ significantly between…; After adjustment for…, [X] was associated with higher odds of… |
| Conclusions | In this sample, [X] was associated with…; These findings suggest that…; Because the design was cross-sectional, the direction of… cannot be established. |
Przykładowy abstrakt z liczbami z R
Wzór na podstawie przykładu przewodniego. Wszystkie liczby pochodzą z przepisu 2. Zamień nawiasy kwadratowe i zdania na własne, zachowując układ.
Zwróć uwagę na trzy rzeczy. Wynik nieistotny (stres na I i III roku) nie trafił do abstraktu, bo nie dotyczył celu – gdyby dotyczył, musiałby się znaleźć niezależnie od p. Conclusions nie mówią employment causes stress. Liczby są identyczne jak w rozdziale wyników; jak to sprawdzić przed oddaniem, pokazuje wpis o kontroli spójności liczb w pracy.
Zdania wyników po polsku i po angielsku
Poniższe pary zdań wypisał przepis 2 z tej samej analizy. Wersja polska ma przecinek dziesiętny – tak, jak wymaga tego wiele uczelni – a angielska zapis APA. Porównaj je, zanim przetłumaczysz własne wyniki: zmienia się nie tylko separator, ale też zero wiodące przy r i p oraz separator granic przedziału.
| Analiza | Po polsku | Po angielsku |
|---|---|---|
| Test t Welcha | Studenci pracujący zarobkowo deklarowali wyższy poziom stresu (M = 3,14, SD = 0,59) niż niepracujący (M = 2,86, SD = 0,62), t(233,66) = 3,64, p < 0,001, d = 0,47. | Students in paid employment reported higher stress (M = 3.14, SD = 0.59) than those not employed (M = 2.86, SD = 0.62), t(233.66) = 3.64, p < .001, d = 0.47. |
| Korelacja Pearsona | Wyższy poziom stresu wiązał się z krótszym snem, r(234) = −0,48, 95% CI [−0,57; −0,37], p < 0,001. | Higher stress was associated with shorter sleep, r(234) = −.48, 95% CI [−.57, −.37], p < .001. |
| Wynik nieistotny | Poziom stresu nie różnił się istotnie między studentami I i III roku, t(230,73) = −1,51, p = 0,132; różnica średnich = −0,12, 95% CI [−0,28; 0,04]. | Stress did not differ significantly between first- and third-year students, t(230.73) = −1.51, p = .132; mean difference = −0.12, 95% CI [−0.28, 0.04]. |
| Regresja logistyczna | Po uwzględnieniu poziomu stresu praca zarobkowa wiązała się z większymi szansami złej jakości snu, OR = 2,72, 95% CI [1,54; 4,87], p < 0,001. | After adjustment for stress, paid employment was associated with higher odds of poor sleep quality, OR = 2.72, 95% CI [1.54, 4.87], p < .001. |
Trzy szczegóły językowe z tych zdań. Wynik nieistotny opisuj jako did not differ significantly i dodaj przedział – nie there was no difference, bo brak istotności nie dowodzi braku różnicy (przedział [−0.28, 0.04] obejmuje zarówno zero, jak i różnice rzędu jednej czwartej punktu). Przy ilorazie szans pisz higher odds, a nie higher risk – to inne miary. Gotowe polskie zdania dla innych testów zebraliśmy w poradniku o zdaniach APA i w generatorze opisu wyników APA; wzory angielskich odpowiedzi na uwagi do statystyki – we wpisie odpowiedź recenzentom.
Najczęstsze błędy
- Przecinek dziesiętny w angielskim tekście. „M = 3,14” po angielsku czyta się jak dwie liczby. Zmień separator w całym abstrakcie, także w tabelach i podpisach rysunków, jeśli są po angielsku.
- Średnik w przedziale ufności po przekładzie. „[0.13; 0.44]” to ślad polskiej wersji; po angielsku – przecinek.
- „p = .000”. Program wypisał zaokrąglenie, a nie zero; pisz p < .001. Sens wartości p przypomina wpis wartość p – interpretacja.
- „Significant” bez „statistically”. W tekście o zdrowiu czytelnik zrozumie to jako ważność kliniczną.
- Język przyczynowy w badaniu przekrojowym. Influence, impact, effect – zamień na association.
- Nazwa schematu i doboru próby pominięta. Napisz cross-sectional i purposive albo convenience sampling; nie „random”, jeśli nikt nie losował.
- Różne liczby w streszczeniu polskim, angielskim i w wynikach. Poprawiłeś(-aś) analizę po uwagach promotora, a abstrakt został stary.
- Przekład zdanie po zdaniu bez sprawdzenia terminów. Tłumaczenie ręczne lub automatyczne bez tabeli terminów daje „probe”, „researches” i „examined persons”.
Jeśli chcesz, żeby ktoś sprawdził z Tobą wyniki i ich zapis w obu wersjach streszczenia, zobacz pomoc w analizie dla studentów.
Liczby po polsku i po angielsku w R
Dwa krótkie przepisy w bazowym R. Pierwszy definiuje funkcje zapisu liczb w wersji polskiej (przecinek dziesiętny, spacja w tysiącach) i angielskiej (APA) i pokazuje je na tabeli wyników. Drugi tworzy symulowane dane przykładu przewodniego, liczy cztery analizy i wypisuje każde zdanie wyników w dwóch językach – z tych liczb powstał przykładowy abstrakt. Rysunek 1 przygotowano w osobnym skrypcie (ggplot2).
Funkcje zapisu liczb: przecinek i kropka, zero wiodące, przedział ufności
R
# B441 – te same liczby w zapisie polskim i angielskim (APA)
# Tylko bazowy R: format(), formatC(), sprintf().

# Liczba z ustaloną liczbą miejsc po przecinku: wersja PL (przecinek) i EN (kropka)
num_pl <- function(x, d = 2) formatC(x, format = "f", digits = d, big.mark = " ", decimal.mark = ",")
num_en <- function(x, d = 2) formatC(x, format = "f", digits = d, big.mark = ",", decimal.mark = ".")

# Minus typograficzny zamiast łącznika
minus <- function(s) sub("^-", "−", s)

# Bez zera wiodącego (EN, APA): tylko dla miar, które nie mogą przekroczyć 1 (p, r, alfa, R2)
bez_zera_en <- function(x, d = 2) minus(sub("^(-?)0\\.", "\\1.", num_en(x, d)))

# Wartość p: trzy miejsca, poniżej .001 zapis „< .001”
p_en <- function(p) if (p < .001) "p < .001" else paste("p =", bez_zera_en(p, 3))
p_pl <- function(p) if (p < .001) "p < 0,001" else paste("p =", num_pl(p, 3))

# Przedział ufności: EN rozdziela granice przecinkiem, PL (przecinek dziesiętny) – średnikiem
ci_en <- function(lo, hi, d = 2) sprintf("95%% CI [%s, %s]", minus(num_en(lo, d)), minus(num_en(hi, d)))
ci_pl <- function(lo, hi, d = 2) sprintf("95%% CI [%s; %s]", minus(num_pl(lo, d)), minus(num_pl(hi, d)))

# 1. format() a formatC(): format() dobiera liczbę cyfr sam, formatC(format = "f") – tyle, ile każesz
x <- c(1234.5, 0.5, -0.25)
cat("format(), PL:  ", format(x, decimal.mark = ",", big.mark = " ", nsmall = 2), "\n")
cat("formatC(), PL: ", num_pl(x), "\n")
cat("formatC(), EN: ", num_en(x), "\n\n")

# 2. Tabela tych samych wyników w obu zapisach
wyniki <- data.frame(
  wielkosc = c("liczebność próby", "średnia (M)", "odchylenie (SD)", "t", "d Cohena",
               "r Pearsona", "R kwadrat", "odsetek", "p (małe)", "p (bardzo małe)"),
  wartosc = c(1250, 3.4567, 0.8123, -2.4561, 0.4129, 0.3812, 0.1453, 45.238, 0.0312, 0.00004),
  cyfry = c(0, 2, 2, 2, 2, 2, 2, 1, 3, 3),
  do_jedynki = c(FALSE, FALSE, FALSE, FALSE, FALSE, TRUE, TRUE, FALSE, TRUE, TRUE)
)
wyniki$PL <- mapply(function(w, d) minus(num_pl(w, d)), wyniki$wartosc, wyniki$cyfry)
wyniki$EN <- mapply(function(w, d, j) if (j) bez_zera_en(w, d) else minus(num_en(w, d)),
                    wyniki$wartosc, wyniki$cyfry, wyniki$do_jedynki)
wyniki$PL[9:10] <- sapply(wyniki$wartosc[9:10], p_pl)
wyniki$EN[9:10] <- sapply(wyniki$wartosc[9:10], p_en)
wyniki$PL[8] <- paste0(wyniki$PL[8], "%")
wyniki$EN[8] <- paste0(wyniki$EN[8], "%")
print(wyniki[, c("wielkosc", "PL", "EN")], row.names = FALSE)

# 3. Przedział ufności – separator granic zależy od separatora dziesiętnego
cat("\nPL:", ci_pl(-0.12, 0.45), "\n")
cat("EN:", ci_en(-0.12, 0.45), "\n")

# 4. Pułapka zaokrąglania: formatC() zaokrągla dokładną wartość binarną liczby,
#    więc „piątka na końcu” nie zawsze idzie w górę – sprawdzaj wartości na granicy
cat("\nformatC(0.125, digits = 2):", num_en(0.125), " | formatC(0.135, digits = 2):", num_en(0.135), "\n")
Wynik w R
format(), PL:   1 234,50     0,50    -0,25
formatC(), PL:  1 234,50 0,50 -0,25
formatC(), EN:  1,234.50 0.50 -0.25

         wielkosc        PL       EN
 liczebność próby     1 250    1,250
      średnia (M)      3,46     3.46
  odchylenie (SD)      0,81     0.81
                t     −2,46    −2.46
         d Cohena      0,41     0.41
       r Pearsona      0,38      .38
        R kwadrat      0,15      .15
          odsetek     45,2%    45.2%
         p (małe) p = 0,031 p = .031
  p (bardzo małe) p < 0,001 p < .001

PL: 95% CI [−0,12; 0,45]
EN: 95% CI [−0.12, 0.45]

formatC(0.125, digits = 2): 0.12  | formatC(0.135, digits = 2): 0.14
Zdania wyników w dwóch językach z jednej analizy
R
# B441 – zdania wyników po polsku i po angielsku z jednej analizy
# Dane symulowane: przekrojowe badanie online studentów pielęgniarstwa (dobór celowy).
# Funkcje zapisu liczb jak w przepisie 1 (bazowy R).
num_pl <- function(x, d = 2) formatC(x, format = "f", digits = d, big.mark = " ", decimal.mark = ",")
num_en <- function(x, d = 2) formatC(x, format = "f", digits = d, big.mark = ",", decimal.mark = ".")
minus <- function(s) sub("^-", "\u2212", s)
bz_en <- function(x, d = 2) minus(sub("^(-?)0\\.", "\\1.", num_en(x, d)))
p_en <- function(p) if (p < .001) "p < .001" else paste("p =", bz_en(p, 3))
p_pl <- function(p) if (p < .001) "p < 0,001" else paste("p =", num_pl(p, 3))
ci_en <- function(lo, hi, d = 2) sprintf("95%% CI [%s, %s]", minus(num_en(lo, d)), minus(num_en(hi, d)))
ci_pl <- function(lo, hi, d = 2) sprintf("95%% CI [%s; %s]", minus(num_pl(lo, d)), minus(num_pl(hi, d)))
ci_r_en <- function(lo, hi, d = 2) sprintf("95%% CI [%s, %s]", bz_en(lo, d), bz_en(hi, d))  # granice r bez zera

set.seed(4411)
n <- 236
praca <- rbinom(n, 1, 0.45)                       # praca zarobkowa w trakcie studiów (1 = tak)
rok <- sample(c("I", "III"), n, replace = TRUE)   # rok studiów
stres <- pmin(pmax(round(2.9 + 0.35 * praca + rnorm(n, 0, 0.62), 1), 1), 5)  # skala 1–5
sen <- round(7.6 - 0.55 * stres + rnorm(n, 0, 0.75), 1)                     # godziny snu
zly_sen <- rbinom(n, 1, plogis(-3.6 + 0.55 * praca + 0.95 * stres))        # zła jakość snu (1 = tak)
d <- data.frame(praca, rok, stres, sen, zly_sen)

cat(sprintf("N = %d; pracuje: %d (%.1f%%)\n\n", n, sum(praca), 100 * mean(praca)))

# 1. Stres: pracujący a niepracujący (test t Welcha, różnica średnich, d Cohena)
tt <- t.test(stres ~ factor(praca, levels = c(1, 0)), data = d)
m1 <- mean(d$stres[d$praca == 1]); s1 <- sd(d$stres[d$praca == 1])
m0 <- mean(d$stres[d$praca == 0]); s0 <- sd(d$stres[d$praca == 0])
n1 <- sum(d$praca == 1); n0 <- sum(d$praca == 0)
sp <- sqrt(((n1 - 1) * s1^2 + (n0 - 1) * s0^2) / (n1 + n0 - 2))
dc <- (m1 - m0) / sp
cat("PL: Studenci pracujący zarobkowo deklarowali wyższy poziom stresu (M = ", num_pl(m1), ", SD = ", num_pl(s1),
    ") niż niepracujący (M = ", num_pl(m0), ", SD = ", num_pl(s0), "), t(", num_pl(tt$parameter, 2), ") = ",
    num_pl(tt$statistic), ", ", p_pl(tt$p.value), ", d = ", num_pl(dc), ".\n", sep = "")
cat("EN: Students in paid employment reported higher stress (M = ", num_en(m1), ", SD = ", num_en(s1),
    ") than those not employed (M = ", num_en(m0), ", SD = ", num_en(s0), "), t(", num_en(tt$parameter, 2), ") = ",
    num_en(tt$statistic), ", ", p_en(tt$p.value), ", d = ", num_en(dc), "; mean difference = ",
    num_en(m1 - m0), ", ", ci_en(tt$conf.int[1], tt$conf.int[2]), ".\n\n", sep = "")

# 2. Stres a długość snu (korelacja Pearsona)
ct <- cor.test(d$stres, d$sen)
cat("PL: Wyższy poziom stresu wiązał się z krótszym snem, r(", ct$parameter, ") = ", minus(num_pl(ct$estimate)),
    ", ", ci_pl(ct$conf.int[1], ct$conf.int[2]), ", ", p_pl(ct$p.value), ".\n", sep = "")
cat("EN: Higher stress was associated with shorter sleep, r(", ct$parameter, ") = ", bz_en(ct$estimate),
    ", ", ci_r_en(ct$conf.int[1], ct$conf.int[2]),
    ", ", p_en(ct$p.value), ".\n\n", sep = "")

# 3. Wynik nieistotny: stres na I i III roku
tr <- t.test(stres ~ rok, data = d)
cat("PL: Poziom stresu nie różnił się istotnie między studentami I i III roku, t(", num_pl(tr$parameter, 2), ") = ",
    minus(num_pl(tr$statistic)), ", ", p_pl(tr$p.value), "; różnica średnich = ", minus(num_pl(-diff(tr$estimate))),
    ", ", ci_pl(tr$conf.int[1], tr$conf.int[2]), ".\n", sep = "")
cat("EN: Stress did not differ significantly between first- and third-year students, t(", num_en(tr$parameter, 2),
    ") = ", minus(num_en(tr$statistic)), ", ", p_en(tr$p.value), "; mean difference = ", minus(num_en(-diff(tr$estimate))),
    ", ", ci_en(tr$conf.int[1], tr$conf.int[2]), ".\n\n", sep = "")

# 4. Zła jakość snu: regresja logistyczna (OR z przedziałem z profilu wiarygodności)
cat(sprintf("Zła jakość snu: %d osób (%.1f%%)\n", sum(d$zly_sen), 100 * mean(d$zly_sen)))
mod <- glm(zly_sen ~ praca + stres, family = binomial, data = d)
or <- exp(coef(mod)); ci <- exp(suppressMessages(confint(mod)))
pv <- summary(mod)$coefficients[, 4]
cat("PL: Po uwzględnieniu poziomu stresu praca zarobkowa wiązała się z większymi szansami złej jakości snu, OR = ",
    num_pl(or["praca"]), ", ", ci_pl(ci["praca", 1], ci["praca", 2]), ", ", p_pl(pv["praca"]), ".\n", sep = "")
cat("EN: After adjustment for stress, paid employment was associated with higher odds of poor sleep quality, OR = ",
    num_en(or["praca"]), ", ", ci_en(ci["praca", 1], ci["praca", 2]), ", ", p_en(pv["praca"]), ".\n", sep = "")
cat("EN (stress, per 1 point): OR = ", num_en(or["stres"]), ", ", ci_en(ci["stres", 1], ci["stres", 2]), ", ",
    p_en(pv["stres"]), ".\n", sep = "")
Wynik w R
N = 236; pracuje: 118 (50.0%)

PL: Studenci pracujący zarobkowo deklarowali wyższy poziom stresu (M = 3,14, SD = 0,59) niż niepracujący (M = 2,86, SD = 0,62), t(233,66) = 3,64, p < 0,001, d = 0,47.
EN: Students in paid employment reported higher stress (M = 3.14, SD = 0.59) than those not employed (M = 2.86, SD = 0.62), t(233.66) = 3.64, p < .001, d = 0.47; mean difference = 0.29, 95% CI [0.13, 0.44].

PL: Wyższy poziom stresu wiązał się z krótszym snem, r(234) = −0,48, 95% CI [−0,57; −0,37], p < 0,001.
EN: Higher stress was associated with shorter sleep, r(234) = −.48, 95% CI [−.57, −.37], p < .001.

PL: Poziom stresu nie różnił się istotnie między studentami I i III roku, t(230,73) = −1,51, p = 0,132; różnica średnich = −0,12, 95% CI [−0,28; 0,04].
EN: Stress did not differ significantly between first- and third-year students, t(230.73) = −1.51, p = .132; mean difference = −0.12, 95% CI [−0.28, 0.04].

Zła jakość snu: 90 osób (38.1%)
PL: Po uwzględnieniu poziomu stresu praca zarobkowa wiązała się z większymi szansami złej jakości snu, OR = 2,72, 95% CI [1,54; 4,87], p < 0,001.
EN: After adjustment for stress, paid employment was associated with higher odds of poor sleep quality, OR = 2.72, 95% CI [1.54, 4.87], p < .001.
EN (stress, per 1 point): OR = 2.67, 95% CI [1.64, 4.50], p < .001.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko pakiety bazowe); rysunek przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed oddaniem angielskiego streszczenia sprawdź…
- Czy schemat badania i sposób doboru próby są nazwane terminem z tabeli (cross-sectional, purposive sampling)?
- Czy każde significant ma przy sobie statistically, a znaczenie praktyczne opisujesz wielkością efektu?
- Czy w badaniu bez manipulacji nie ma słów influence, impact, effect of?
- Czy wszędzie jest kropka dziesiętna, p i r bez zera wiodącego, a przedziały mają format 95% CI [a, b]?
- Czy nie ma „p = .000” ani „trend towards significance”?
- Czy Methods i Results są w czasie przeszłym, a Background i Conclusions w teraźniejszym?
- Czy liczby w streszczeniu polskim, angielskim i w rozdziale wyników są identyczne?
- Czy słowa kluczowe po angielsku odpowiadają terminom użytym w abstrakcie i mieszczą się w limicie uczelni?
Najczęstsze pytania
Jak przetłumaczyć „istotny statystycznie” na angielski – czy wystarczy „significant”?
Pisz statistically significant. Samo significant znaczy po angielsku także „ważny”, więc w pracy z nauk o zdrowiu czytelnik może je odczytać jako ważność kliniczną. Wynik nieistotny to not statistically significant albo nonsignificant – nie insignificant, które znaczy „błahy”.
Czy w angielskim streszczeniu pracy pisać kropkę dziesiętną, jeśli w polskim tekście jest przecinek?
Tak. Po angielsku separatorem dziesiętnym jest kropka, niezależnie od wymagań dla polskiej części pracy. Zmień też separator granic przedziału ufności: polskie [0,13; 0,44] po angielsku to 95% CI [0.13, 0.44], a p i r zapisuj bez zera wiodącego (p = .132, r = −.48).
Jak po angielsku opisać wynik „na granicy istotności”?
Nie używaj trend towards significance ani tendency. Napisz, że różnica nie była istotna statystycznie, podaj dokładne p, kierunek różnicy i przedział ufności, np. Stress did not differ significantly between groups, p = .132; mean difference = −0.12, 95% CI [−0.28, 0.04]. Przedział pokazuje, jakie różnice są zgodne z danymi.
Czy w abstrakcie po angielsku można napisać „influence”, jeśli badanie było przekrojowe?
Lepiej nie. Influence, impact i effect of X on Y sugerują związek przyczynowy, którego jeden pomiar nie pozwala ustalić. Pisz X was associated with Y albo the association between X and Y, a w regresji – X predicted Y, bez wniosków o przyczynie.
Jak po angielsku nazwać dobór celowy i dobór wygodny w streszczeniu pracy?
Dobór celowy to purposive sampling, dobór wygodny (dostępnościowy) – convenience sampling. W Methods napisz np. 236 nursing students recruited by purposive sampling completed…. Nie używaj słowa random, jeśli nikt nie losował osób do próby.
Powiązane hasła
Przeczytaj też
Abstrakt strukturalny i IMRAD
Trzy wzory abstraktu (przekrojowe, RCT, przegląd) z liczbami z R, słowa kluczowe, spin i kontrola zgodności abstraktu z wynikami.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikKontrola spójności liczb przed oddaniem pracy
Osiem kontroli: N i sumy w tabelach, procenty, p a statystyka testu, df, przedziały ufności, GRIM i te same liczby w całej pracy – z kodem w R.
Czytaj →Piszesz angielskie streszczenie do pracy?
Sprawdzimy analizy i to, czy wyniki w streszczeniu polskim, angielskim i w rozdziale wyników mówią to samo – w R lub SPSS, z wyjaśnieniem, które pozwoli Ci samodzielnie obronić każdą liczbę.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (2024). APA Style numbers and statistics guide. APA Style. https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf ● Otwarty dostęp
- Haber, N., Smith, E. R., Moscoe, E., Andrews, K., Audy, R., Bell, W., Brennan, A. T., Breskin, A., Kane, J. C., Karra, M., McClure, E. S., Suarez, E. A., & CLAIMS Research Team. (2018). Causal language and strength of inference in academic and media articles shared in social media (CLAIMS): A systematic review. PLOS ONE, 13(5), Article e0196346. https://doi.org/10.1371/journal.pone.0196346 ● Otwarty dostęp
- Hartley, J. (2014). Current findings from research on structured abstracts: An update. Journal of the Medical Library Association, 102(3), 146–148. https://doi.org/10.3163/1536-5050.102.3.002 ● Otwarty dostęp
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
- Wood, J., Freemantle, N., King, M., & Nazareth, I. (2014). Trap of trends to statistical significance: Likelihood of near significant P value becoming more significant with extra data. BMJ, 348, Article g2215. https://doi.org/10.1136/bmj.g2215 ● Otwarty dostęp
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@misc{apa2024numbers, author={{American Psychological Association}}, title={{APA Style numbers and statistics guide}}, howpublished={APA Style}, year={2024}, publisher={American Psychological Association}, url={https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf}}@article{haber2018causal, author={Haber, Noah and Smith, Emily R. and Moscoe, Ellen and Andrews, Kathryn and Audy, Robin and Bell, Winnie and Brennan, Alana T. and Breskin, Alexander and Kane, Jeremy C. and Karra, Mahesh and McClure, Elizabeth S. and Suarez, Elizabeth A. and {CLAIMS Research Team}}, title={{Causal language and strength of inference in academic and media articles shared in social media (CLAIMS): A systematic review}}, journal={PLOS ONE}, year={2018}, volume={13}, number={5}, eid={e0196346}, doi={10.1371/journal.pone.0196346}}@article{hartley2014current, author={Hartley, James}, title={{Current findings from research on structured abstracts: An update}}, journal={Journal of the Medical Library Association}, year={2014}, volume={102}, number={3}, pages={146--148}, doi={10.3163/1536-5050.102.3.002}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}@article{wood2014trap, author={Wood, John and Freemantle, Nick and King, Michael and Nazareth, Irwin}, title={{Trap of trends to statistical significance: Likelihood of near significant P value becoming more significant with extra data}}, journal={BMJ}, year={2014}, volume={348}, eid={g2215}, doi={10.1136/bmj.g2215}}