Czym jest GSE i skąd się wzięła
Skala Uogólnionej Własnej Skuteczności (General Self-Efficacy Scale, GSE) mierzy ogólne przekonanie, że poradzisz sobie z trudnymi, nowymi i stresującymi wymaganiami. Opracowali ją po niemiecku Matthias Jerusalem i Ralf Schwarzer. Strona autorów podaje jako początek prac rok 1979 w opisie skali, a rok 1981 na stronie głównej. Wersję angielską autorzy opublikowali w 1995 roku i to ją wskazują do cytowania (Schwarzer i Jerusalem, 1995). Według strony autorów skala jest dostępna w ponad 30 językach, w tym po polsku (Schwarzer i Jerusalem, b.d.).
Konstrukt wywodzi się z teorii społeczno-poznawczej Bandury. Luszczynska, Gutiérrez-Doña i Schwarzer (2005) odróżniają ogólną własną skuteczność, czyli przekonanie o kompetencji w szerokim zakresie sytuacji, od skuteczności specyficznej, ograniczonej do jednego zadania. W pięciu krajach, także w Polsce, wynik GSE najsilniej wiązał się dodatnio z optymizmem, samoregulacją i samooceną, a ujemnie z depresją i lękiem. Autorzy skali podkreślają, że mierzy ona sprawczość, czyli przekonanie, że to własne działania prowadzą do sukcesu (Schwarzer i Jerusalem, b.d.).
W pracach dyplomowych GSE pojawia się jako predyktor (samoskuteczność a stres), moderator albo zmienna zależna w badaniach treningów. Ten wpis należy do serii o liczeniu wyników kwestionariuszy, razem z PSS-10, SWLS i Skalą Samooceny Rosenberga. Ogólne zasady liczenia wyników opisuje poradnik jak policzyć wynik kwestionariusza.
Budowa skali i odpowiedzi
GSE ma 10 pozycji i jeden wynik ogólny. Każda pozycja opisuje skuteczne radzenie sobie, np. z nieoczekiwanymi zdarzeniami albo z problemami, które wymagają wysiłku. Osoba badana ocenia, na ile dane stwierdzenie jest prawdziwe w odniesieniu do niej. Odpowiada na czterostopniowej skali, która w wersji angielskiej ma etykiety od Not at all true (1) do Exactly true (4). W pracy po polsku użyj etykiet z polskiej wersji. Treści pozycji tu nie podajemy. Zasady ich przedruku opisuje stanowisko International Test Commission (2014).
| Cecha | GSE | Źródło |
|---|---|---|
| Liczba pozycji | 10 | Schwarzer i Jerusalem (b.d.) |
| Skala odpowiedzi | 1–4 (od Not at all true do Exactly true) | Schwarzer i Jerusalem (b.d.) |
| Pozycje odwrócone | brak – bez przekodowania | Schwarzer i Jerusalem (b.d.) |
| Wynik i zakres | suma 10 pozycji, 10–40; wyższy = silniejsze przekonanie o własnej skuteczności | Schwarzer i Jerusalem (b.d.) |
| Struktura | jeden wymiar | Scholz i in. (2002); Schwarzer i Jerusalem (b.d.) |
| Dla kogo | dorośli i młodzież, nie osoby poniżej 12 lat | Schwarzer i Jerusalem (b.d.) |
| Punkty odcięcia | autorzy ich nie podają | Schwarzer i Jerusalem (b.d.) |
Autorzy zalecają, by pozycje GSE wmieszać w większą pulę pozycji o tym samym formacie odpowiedzi. Wypełnienie skali zajmuje średnio 4 minuty (Schwarzer i Jerusalem, b.d.).
Jak policzyć wynik GSE krok po kroku
Krok 1. Sprawdź kodowanie 1–4
Odpowiedzi muszą mieć wartości 1–4. Formularz online może zapisać je jako 0–3, jako tekst albo, gdy dodasz opcję „trudno powiedzieć”, jako pięć kategorii. Takiej opcji w GSE nie ma i nie należy jej dodawać. Kontrolę wartości niemożliwych opisuje hasło rekodowanie.
Krok 2. Zsumuj 10 pozycji
Autorzy piszą wprost: zsumuj odpowiedzi na wszystkie 10 pozycji, bez przekodowania. Wynik mieści się w zakresie 10–40 (Schwarzer i Jerusalem, b.d.). Wszystkie pozycje są sformułowane w tym samym kierunku, więc niczego nie odwracasz. To ułatwia liczenie, ale ma też koszt. Osoby, które zgadzają się ze wszystkim niezależnie od treści, zawyżą swój wynik, a w danych nie da się tego łatwo wykryć (zob. tendencja do zgadzania się). Sumę możesz też policzyć w kalkulatorze wyniku skali.
Krok 3. Suma czy średnia?
Standardem jest suma 10–40, bo tak raportuje się GSE w literaturze. Średnia z pozycji (1–4) to ta sama informacja podzielona przez 10. W korelacjach i porównaniach grup da te same wnioski, ale utrudni porównanie z innymi badaniami. Jeśli ją wybierzesz, napisz o tym (zob. wynik skali: średnia czy suma).
Krok 4. Braki danych
Opis skali na stronie autorów nie podaje reguły dla pojedynczych braków. Jeśli używasz reguły proporcjonalnej, sprawdź, czy autorzy nie opisali jej w swoich materiałach, np. w FAQ. Zapisz ją przed analizą i podaj w pracy, ilu osób dotyczyła. Najprostsze rozwiązanie to liczyć wynik tylko dla osób z kompletem odpowiedzi. Przy kilku brakach na kilkaset osób nie zmienia to wniosków (zob. braki danych MCAR, MAR i MNAR).
Interpretacja bez punktów odcięcia
Wyższy wynik oznacza silniejsze przekonanie o własnej skuteczności. Opis skali na stronie autorów nie podaje punktów odcięcia ani przedziałów „niska, przeciętna, wysoka samoskuteczność”. Jeśli spotkasz takie przedziały w pracach dyplomowych, sprawdź, skąd pochodzą. Często są to podziały teoretyczne albo normy konkretnej adaptacji, a nie zasada skali. Wady takich podziałów omawia poradnik niski, przeciętny, wysoki wynik.
Ostrożnie porównuj też średnie między krajami i wersjami językowymi. Scholz i in. (2002) potwierdzili na 19 120 osobach z 25 krajów, że skala jest wszędzie jednowymiarowa. Ujawnili jednak różnice międzykulturowe. Schwarzer i in. (1997) stwierdzili w trzech wersjach językowych różnice średnich sum, a równoważność wzorca pozycji między językami była tylko umiarkowana. Wynik polskiej próby porównuj więc z danymi polskiej wersji, a porównania międzynarodowe opieraj na sprawdzonej inwariancji pomiaru.
Autorzy zwracają też uwagę na ograniczenie GSE: jako miara ogólna nie mówi nic o konkretnym zachowaniu. Jeśli badasz np. samoskuteczność w aktywności fizycznej albo w rzucaniu palenia, zalecają dodać kilka pozycji specyficznych dla tematu (Schwarzer i Jerusalem, b.d.).
Przykład: samoskuteczność i stres u 240 osób studiujących
Wyobraź sobie badanie 240 osób studiujących, które wypełniły GSE i PSS-10. Dane są symulowane i możesz je pobrać jako plik CSV (kolumny id, g1–g10 z odpowiedziami 1–4 oraz PSS10 z gotowym wynikiem 0–40). Dwie osoby pominęły pozycję 2. Nie policzyliśmy dla nich wyniku, więc analizujemy 238 osób.
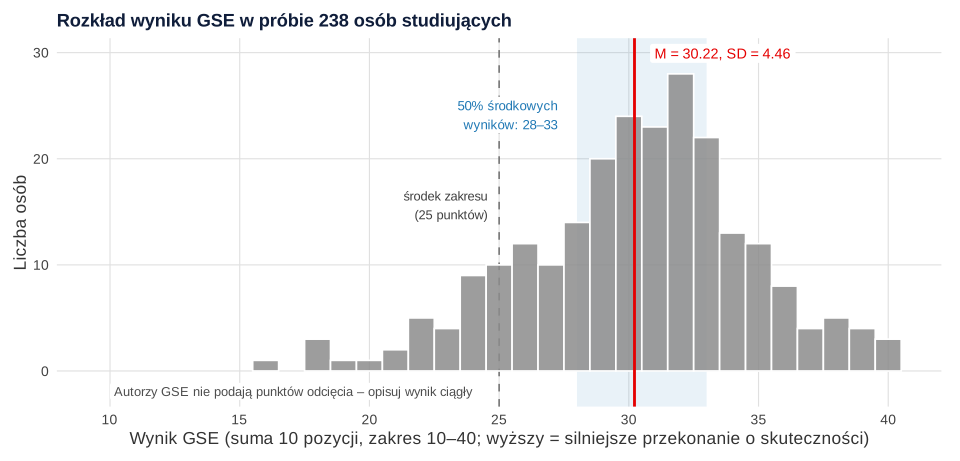
Średni wynik GSE wyniósł M = 30.22 (SD = 4.46), mediana 31, a połowa osób miała od 28 do 33 punktów. W przeliczeniu na średnią z pozycji daje to 3.02 (SD = 0.45). Rozkład jest lekko lewostronnie skośny (skośność −0.40), a wyniki mieszczą się w przedziale 16–40 (rysunek 1). Maksymalny wynik 40 miały 3 osoby (1.3%), a minimalnego 10 nie miał nikt. Wyraźnego efektu sufitu więc nie ma, choć większość wyników leży powyżej środka zakresu.
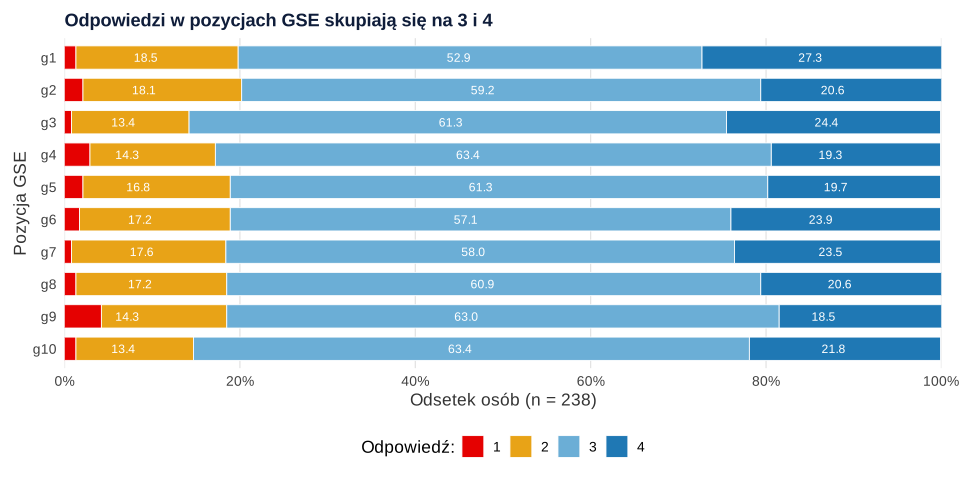
Skąd takie przesunięcie w górę? W każdej pozycji od 79.8% do 85.7% osób wybrało odpowiedź 3 albo 4 (rysunek 2). Odpowiedź 1 była rzadka. To typowy obraz skal opisujących cechy pożądane, ale warto go pokazać, bo przy skośnym rozkładzie pozycji lepiej sprawdzają się metody dla danych porządkowych.
Rzetelność i jednowymiarowość
Spójność wewnętrzna wyniosła α = .86, 95% CI [.83, .88], a skorygowane korelacje pozycja–reszta od .49 do .62. Autorzy podają, że w próbach z 23 krajów α wynosiła od .76 do .90 (Schwarzer i Jerusalem, b.d.), a Schwarzer i in. (1997) uzyskali w trzech próbach studentów .81–.91. Wynik z przykładu mieści się w tych przedziałach. Alfa ma założenia, które rzadko są spełnione (McNeish, 2018), więc podaj też omegę McDonalda, która wyniosła ω = .86.
Jednowymiarowość sprawdziliśmy jednoczynnikową konfirmacyjną analizą czynnikową na pozycjach porządkowych (estymator WLSMV). Model był dobrze dopasowany: χ²(35) = 38.39, p = .318, CFI = .998, TLI = .997, RMSEA = .020, SRMR = .039, a ładunki wynosiły od .59 do .75. Dane symulowaliśmy z modelu jednoczynnikowego, więc prawdziwe dane zwykle dopasowują się gorzej. Całą procedurę pokazuje poradnik analiza czynnikowa EFA i CFA.
Związek ze stresem
Wynik GSE korelował ujemnie z wynikiem PSS-10: r(236) = −.47, 95% CI [−.57, −.37], p < .001. Osoby z silniejszym przekonaniem o własnej skuteczności oceniały swoje życie jako mniej stresujące. Kierunek jest zgodny z tym, co autorzy skali opisują jako dowody trafności teoretycznej: ujemne związki ze stresem, lękiem i depresją (Schwarzer i Jerusalem, b.d.). Spójne związki GSE z innymi zmiennymi w kilku krajach opisali też Luszczynska, Scholz i Schwarzer (2005). To jednak korelacja z badania przekrojowego, a nie dowód, że samoskuteczność obniża stres.
Jak opisać GSE w rozdziale metodologicznym
Wzór poniżej zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane polskiej wersji. Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór.
W rozdziale z wynikami opisz rozkład i związki z innymi zmiennymi:
Gotowe zdania o rzetelności znajdziesz we wzorze raportowania alfy Cronbacha.
Polska wersja i zgoda na użycie
Na stronie autorów skali jest wersja polska, opisana jako opracowana przez Schwarzera, Jerusalema i Zygfryda Juczyńskiego (Schwarzer i Jerusalem, b.d.). Luszczynska, Scholz i Schwarzer (2005) oraz Luszczynska, Gutiérrez-Doña i Schwarzer (2005) badali GSE także w próbach polskich. Właściwości psychometryczne i ewentualne normy bierz z publikacji polskiej adaptacji, a nie z tego poradnika. Warunki użycia, zwłaszcza w ankiecie online, sprawdź u autorów adaptacji albo u wydawcy, który ją rozpowszechnia. Nie zamieszczaj pozycji w aneksie, jeśli warunki na to nie pozwalają (International Test Commission, 2014). Jak szukać narzędzi i prosić o zgodę, opisuje poradnik gdzie znaleźć kwestionariusze psychologiczne.
GSE w R: wynik, rzetelność i struktura
Kod odtwarza wszystkie liczby z tekstu i rysunków, a na początku zapisuje plik CSV do pobrania. Wynik to jedna linia: rowSums() z 10 pozycji, bez przekodowania. Alfę z przedziałem Feldta liczy pakiet psych, CFA i omegę pakiety lavaan i semTools. Na własnych danych zmień tylko nazwy kolumn.
Wynik GSE krok po kroku
R
# B102 – GSE: liczenie wyniku, rozkład, rzetelność, jednowymiarowość i związek ze stresem (dane symulowane, set.seed(10210)).
# 240 osób studiujących; odpowiedzi 1–4 na 10 pozycji GSE (g1–g10) oraz wynik PSS-10 (0–40).
# Zasady liczenia (Schwarzer i Jerusalem, strona autorów): suma 10 pozycji, zakres 10–40, bez przekodowania.
# Treści pozycji nie podajemy – w danych są tylko numery.
suppressPackageStartupMessages({ library(MASS); library(psych); library(lavaan); library(semTools) })
set.seed(10210)
n <- 240
L <- mvrnorm(n, c(0, 0), matrix(c(1, -.45, -.45, 1), 2))          # samoskuteczność i stres (korelacja ujemna)
lam <- c(.66, .58, .64, .72, .70, .62, .68, .71, .73, .69)
progi <- c(-2.1, -0.95, 0.75)
odp <- sapply(lam, function(l) findInterval(l * L[, 1] + rnorm(n, 0, sqrt(1 - l^2)), progi) + 1)
colnames(odp) <- paste0("g", 1:10)
dane <- data.frame(id = 1:n, odp, PSS10 = pmin(40, pmax(0, round(20 + 5.8 * L[, 2]))))
dane$g2[c(58, 177)] <- NA                                            # dwie osoby pominęły pozycję 2
write.csv(dane, "../gse-dane-przyklad.csv", row.names = FALSE)       # plik do pobrania

# Krok 1. Kontrola kodowania: tylko 1–4 albo brak
gse <- paste0("g", 1:10)
sapply(dane[, gse], function(x) all(x %in% c(1:4, NA)))
colSums(is.na(dane[, gse]))[colSums(is.na(dane[, gse])) > 0]

# Krok 2. Wynik: suma 10 pozycji (10–40), bez odwracania; średnia z pozycji (1–4) jako wariant
dane$GSE <- rowSums(dane[, gse])
dane$GSE_sr <- dane$GSE / 10
c(z_wynikiem = sum(!is.na(dane$GSE)), bez_wyniku = sum(is.na(dane$GSE)))
pel <- dane[!is.na(dane$GSE), ]
x <- pel$GSE
round(c(M = mean(x), SD = sd(x), Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)),
        min = min(x), max = max(x), skosnosc = psych::skew(x), M_sr = mean(pel$GSE_sr), SD_sr = sd(pel$GSE_sr)), 2)
c(n_40 = sum(x == 40), proc_40 = round(100 * mean(x == 40), 1), n_10 = sum(x == 10))

# Krok 3. Rozkład odpowiedzi w pozycjach (odsetki 1–4)
rozk <- t(sapply(pel[, gse], function(v) round(100 * prop.table(table(factor(v, levels = 1:4))), 1)))
rozk
round(range(rozk[, "3"] + rozk[, "4"]), 1)                         # odsetek odpowiedzi 3 lub 4 w pozycjach

# Krok 4. Rzetelność: alfa (95% CI Feldta), korelacje pozycja–reszta, omega
a <- alpha(pel[, gse], check.keys = FALSE, warnings = FALSE)
round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]]), 3)
round(range(a$item.stats$r.drop), 2)
m_ciagly <- cfa(paste("GSE =~", paste(gse, collapse = " + ")), data = pel[, gse], std.lv = TRUE)
round(unlist(compRelSEM(m_ciagly))[[1]], 3)

# Krok 5. Jednowymiarowość: CFA jednoczynnikowa na pozycjach porządkowych (WLSMV)
m1 <- cfa(paste("GSE =~", paste(gse, collapse = " + ")), data = pel[, gse], ordered = TRUE, estimator = "WLSMV", std.lv = TRUE)
wsk <- c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.scaled", "tli.scaled", "rmsea.scaled", "srmr")
round(fitMeasures(m1, wsk), 3)
std <- standardizedSolution(m1)
round(range(std$est.std[std$op == "=~"]), 2)

# Krok 6. Związek ze stresem (PSS-10): korelacja Pearsona z 95% CI
ct <- cor.test(pel$GSE, pel$PSS10)
round(c(r = unname(ct$estimate), lo = ct$conf.int[1], hi = ct$conf.int[2], t = unname(ct$statistic), df = unname(ct$parameter)), 3)
format.pval(ct$p.value, digits = 3)

# Wartości w zapisie do tekstu
bz <- function(v) sub("^(-?)0\\.", "\\1.", formatC(v, format = "f", digits = 2))
noquote(c(alfa = bz(a$total$raw_alpha), lo = bz(a$feldt$lower.ci[[1]]), hi = bz(a$feldt$upper.ci[[1]]),
          omega = bz(unlist(compRelSEM(m_ciagly))[[1]]), CFI = bz(fitMeasures(m1, "cfi.scaled")),
          RMSEA = bz(fitMeasures(m1, "rmsea.scaled")), SRMR = bz(fitMeasures(m1, "srmr")),
          r = bz(ct$estimate), r_lo = bz(ct$conf.int[1]), r_hi = bz(ct$conf.int[2])))
Wynik w R
  g1   g2   g3   g4   g5   g6   g7   g8   g9  g10
TRUE TRUE TRUE TRUE TRUE TRUE TRUE TRUE TRUE TRUE
g2
 2
z_wynikiem bez_wyniku
       238          2
       M       SD       Me       Q1       Q3      min      max skosnosc     M_sr    SD_sr
   30.22     4.46    31.00    28.00    33.00    16.00    40.00    -0.40     3.02     0.45
   n_40 proc_40    n_10
    3.0     1.3     0.0
      1    2    3    4
g1  1.3 18.5 52.9 27.3
g2  2.1 18.1 59.2 20.6
g3  0.8 13.4 61.3 24.4
g4  2.9 14.3 63.4 19.3
g5  2.1 16.8 61.3 19.7
g6  1.7 17.2 57.1 23.9
g7  0.8 17.6 58.0 23.5
g8  1.3 17.2 60.9 20.6
g9  4.2 14.3 63.0 18.5
g10 1.3 13.4 63.4 21.8
[1] 79.8 85.7
 alfa    lo    hi
0.857 0.829 0.883
[1] 0.49 0.62
[1] 0.858
 chisq.scaled     df.scaled pvalue.scaled    cfi.scaled    tli.scaled  rmsea.scaled          srmr
       38.392        35.000         0.318         0.998         0.997         0.020         0.039
[1] 0.59 0.75
      r      lo      hi       t      df
 -0.473  -0.566  -0.368  -8.254 236.000
[1] "1.09e-14"
              alfa                 lo                 hi              omega     CFI.cfi.scaled
               .86                .83                .88                .86               1.00
RMSEA.rmsea.scaled          SRMR.srmr              r.cor               r_lo               r_hi
               .02                .04               -.47               -.57               -.37
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy GSE
- Odwracanie pozycji, których nie trzeba odwracać. Autorzy piszą: bez przekodowania. Jeśli po „odwróceniu” alfa spadła, a korelacje pozycja–reszta są ujemne, cofnij ten krok.
- Kodowanie 0–3 zamiast 1–4. Zakres przesuwa się wtedy do 0–30 i wyniku nie da się porównać z literaturą.
- Progi „niska, przeciętna, wysoka samoskuteczność” bez źródła. Autorzy ich nie podają. Opisuj wynik ciągły albo podaj, czyje normy stosujesz.
- Dodanie odpowiedzi środkowej. Skala ma cztery stopnie. Piąta opcja zmienia narzędzie.
- Porównywanie średnich z innymi krajami bez zastrzeżenia o różnicach między wersjami językowymi.
- Wnioski przyczynowe z korelacji. Ujemny związek ze stresem nie mówi, co jest przyczyną, a co skutkiem.
Jeśli chcesz sprawdzić, czy dobrze policzyłeś wynik GSE i jak opisać go w swojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć wynik w skali GSE?
Sprawdź, czy odpowiedzi mają wartości 1–4, i zsumuj wszystkie 10 pozycji. Niczego nie odwracasz, bo autorzy piszą wprost, że skala nie wymaga przekodowania. Wynik mieści się w zakresie 10–40, a wyższy oznacza silniejsze przekonanie o własnej skuteczności (Schwarzer i Jerusalem, b.d.).
Czy skala GSE ma pozycje odwrócone?
Nie. Wszystkie 10 pozycji opisuje skuteczne radzenie sobie, więc sumujesz je bez przekodowania. Skutkiem ubocznym jest podatność na tendencję do zgadzania się: osoby, które odpowiadają „tak” niezależnie od treści, zawyżają wynik.
Jaki wynik GSE oznacza wysokie poczucie własnej skuteczności?
Opis skali na stronie autorów nie podaje punktów odcięcia ani przedziałów niski–wysoki. Opisuj wynik ciągły (średnią, odchylenie, zakres), a jeśli potrzebujesz poziomów, podaj, z jakich norm polskiej wersji pochodzą. Średnich z różnych krajów nie porównuj bez zastrzeżeń, bo wersje językowe różnią się poziomem wyników (Schwarzer i in., 1997).
Czy wynik GSE to suma czy średnia?
Autorzy podają sumę 10–40 i tak raportuje się skalę w literaturze. Średnia z pozycji (1–4) to ta sama informacja podzielona przez 10, więc nie zmienia wyników korelacji ani porównań grup. Jeśli jej użyjesz, napisz o tym w opisie narzędzia.
Jaka jest rzetelność skali GSE?
Według autorów α w próbach z 23 krajów wynosiła od .76 do .90 (Schwarzer i Jerusalem, b.d.). Podaj jednak α z 95% przedziałem ufności i omegę z własnej próby, bo rzetelność zależy od badanej grupy.
Powiązane hasła
Przeczytaj też
PSS-10 – jak policzyć wynik
Skala 0–4, pozycje odwrócone 4, 5, 7 i 8, suma 0–40, brak punktów odcięcia, rzetelność i struktura – z przykładem w R i wzorem opisu w pracy.
Czytaj →PoradnikJak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikOpis narzędzia badawczego – wzór
Dziesięć elementów opisu i cztery wzory: kwestionariusz z adaptacją, ankieta własna, test wiedzy i skala kliniczna – z rzetelnością z własnej próby.
Czytaj →Badasz poczucie własnej skuteczności skalą GSE?
Sprawdzimy liczenie wyniku, rzetelność i strukturę skali w Twojej próbie oraz wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- International Test Commission. (2014). ITC statement on the use of tests and other assessment instruments for research purposes (Version 1.2). https://www.intestcom.org/files/statement_using_tests_for_research.pdf ● Otwarty dostęp
- Luszczynska, A., Gutiérrez-Doña, B., & Schwarzer, R. (2005). General self-efficacy in various domains of human functioning: Evidence from five countries. International Journal of Psychology, 40(2), 80–89. https://doi.org/10.1080/00207590444000041
- Luszczynska, A., Scholz, U., & Schwarzer, R. (2005). The General Self-Efficacy Scale: Multicultural validation studies. The Journal of Psychology, 139(5), 439–457. https://doi.org/10.3200/jrlp.139.5.439-457
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Scholz, U., Gutiérrez Doña, B., Sud, S., & Schwarzer, R. (2002). Is general self-efficacy a universal construct? Psychometric findings from 25 countries. European Journal of Psychological Assessment, 18(3), 242–251. https://doi.org/10.1027//1015-5759.18.3.242
- Schwarzer, R., & Jerusalem, M. (1995). Generalized Self-Efficacy scale. In J. Weinman, S. Wright, & M. Johnston (Eds.), Measures in health psychology: A user’s portfolio. Causal and control beliefs (pp. 35–37). NFER-NELSON.
- Schwarzer, R., & Jerusalem, M. (b.d.). The General Self-Efficacy Scale (GSE). Freie Universität Berlin. Pobrano 26 października 2026 z http://userpage.fu-berlin.de/~health/engscal.htm ● Otwarty dostęp
- Schwarzer, R., Bäßler, J., Kwiatek, P., Schröder, K., & Zhang, J. X. (1997). The assessment of optimistic self-beliefs: Comparison of the German, Spanish, and Chinese versions of the General Self-efficacy Scale. Applied Psychology, 46(1), 69–88. https://doi.org/10.1111/j.1464-0597.1997.tb01096.x
Cytowania BibTeX
@techreport{itc2014statement, author={{International Test Commission}}, title={{ITC statement on the use of tests and other assessment instruments for research purposes}}, year={2014}, institution={International Test Commission}, url={https://www.intestcom.org/files/statement_using_tests_for_research.pdf}}@article{luszczynska2005various, author={Luszczynska, Aleksandra and Gutiérrez-Doña, Benicio and Schwarzer, Ralf}, title={{General self-efficacy in various domains of human functioning: Evidence from five countries}}, journal={International Journal of Psychology}, year={2005}, volume={40}, number={2}, pages={80--89}, doi={10.1080/00207590444000041}}@article{luszczynska2005general, author={Luszczynska, Aleksandra and Scholz, Urte and Schwarzer, Ralf}, title={{The General Self-Efficacy Scale: Multicultural validation studies}}, journal={The Journal of Psychology}, year={2005}, volume={139}, number={5}, pages={439--457}, doi={10.3200/jrlp.139.5.439-457}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{scholz2002general, author={Scholz, Urte and Gutiérrez Doña, Benicio and Sud, Shonali and Schwarzer, Ralf}, title={{Is general self-efficacy a universal construct? Psychometric findings from 25 countries}}, journal={European Journal of Psychological Assessment}, year={2002}, volume={18}, number={3}, pages={242--251}, doi={10.1027//1015-5759.18.3.242}}@incollection{schwarzer1995generalized, author={Schwarzer, Ralf and Jerusalem, Matthias}, title={{Generalized Self-Efficacy scale}}, booktitle={Measures in health psychology: A user’s portfolio. Causal and control beliefs}, year={1995}, pages={35--37}, publisher={NFER-NELSON}}@misc{schwarzergseweb, author={Schwarzer, Ralf and Jerusalem, Matthias}, title={{The General Self-Efficacy Scale (GSE)}}, publisher={Freie Universität Berlin}, url={http://userpage.fu-berlin.de/~health/engscal.htm}}@article{schwarzer1997assessment, author={Schwarzer, Ralf and Bäßler, Judith and Kwiatek, Patricia and Schröder, Kerstin and Zhang, Jian Xin}, title={{The assessment of optimistic self-beliefs: Comparison of the German, Spanish, and Chinese versions of the General Self-efficacy Scale}}, journal={Applied Psychology}, year={1997}, volume={46}, number={1}, pages={69--88}, doi={10.1111/j.1464-0597.1997.tb01096.x}}