Plakat to ilustrowany abstrakt, a nie skrócony rozdział
Na sesji plakatowej ludzie przechodzą między tablicami i w kilka sekund decydują, czy podejść bliżej. Erren i Bourne (2007) radzą, by plakat „sprzedał” pracę w dziesięć sekund i był punktem wyjścia do rozmowy, a nie streszczeniem artykułu do czytania na stojąco. Persky (2016) zauważa, że większość plakatów projektuje się jak rękopis, a nie z myślą o czytelniku i o warunkach sesji. Proponuje traktować plakat jak ilustrowany abstrakt.
Dwa badania Rowe’a i Ilica wyjaśniają, dlaczego to ważne. W ankiecie wśród autorów plakatów 94% osób zgodziło się, że uwagę oglądających przyciąga przede wszystkim obraz. Respondenci uważali też, że plakat dobrze przekazuje treść dopiero wtedy, gdy stoi przy nim autor (Rowe i Ilic, 2009). W przeglądzie badań nad skutecznością plakatów ci sami autorzy znaleźli tylko 15 prac spełniających kryteria. Najczęstszy wniosek brzmiał, że plakaty działają najlepiej w połączeniu z innymi formami przekazu (Ilic i Rowe, 2013). Dlatego na dobrym plakacie są trzy elementy: wynik widoczny z daleka, autor gotowy do rozmowy i odsyłacz do pełnych materiałów.
Slajdy na obronę omawiamy osobno we wpisie o prezentacji wyników na obronie, a strukturę streszczenia – we wpisie abstrakt strukturalny i IMRAD. Plakat warto budować właśnie z abstraktu.
Przykład: jedno pytanie, jeden wynik główny
Liczby w tym wpisie pochodzą z jednego badania na danych symulowanych (plik CSV). 180 osób studiujących prowadziło przez tydzień dzienniczek snu. Pytaliśmy, czy długość snu w dni powszednie różni się w zależności od liczby godzin pracy zarobkowej. Osoby podzielono na trzy grupy: niepracujące (n = 70), pracujące do 20 godzin w tygodniu (n = 60) i ponad 20 godzin (n = 50).
- Średnia długość snu wyniosła 7.12 h, 95% CI [6.93, 7.32], 6.94 h [6.73, 7.16] i 6.46 h [6.22, 6.69].
- ANOVA Welcha: F(2, 112.67) = 9.62, p < .001, η² = .10, 95% CI [.03, .19].
- Różnica między pracującymi ponad 20 h a niepracującymi: −0.67 h, 95% CI [−0.97, −0.36], czyli około 40 minut, t(104.40) = −4.34, p < .001, d = −0.81, 95% CI [−1.18, −0.43].
W pracy dyplomowej takie badanie miałoby zapewne kilka analiz: opis próby, rzetelność narzędzi, analizy dodatkowe (zob. ile analiz w pracy magisterskiej). Na plakat trafia jeden wynik główny, ten, który odpowiada na pytanie badawcze. Tu jest nim różnica 40 minut snu. Reszta zmieści się pod kodem QR.
Układ: skrócony IMRAD w kolumnach
Faulkes (2023) przeanalizował nagrodzone plakaty z pięciu lat konferencji dużego towarzystwa naukowego. Około trzech czwartych miało układ wprowadzenie–metoda–wyniki–dyskusja, jak artykuł, a około dwóch trzecich – układ w kolumnach. Niewiele stosowało jednak zasady projektowania graficznego, więc na wielu powstawała „ściana tekstu”. Gundogan i in. (2016) zalecają kolumny czytane z góry na dół: od celu przez metodę i wyniki do wniosków, w tej samej kolejności co w abstrakcie. Erren i Bourne (2007) dodają, że wzrok trzeba prowadzić od ramki do ramki i zostawić puste miejsce.
Skrócony IMRAD nie oznacza jednak, że każda część dostaje tyle samo miejsca. Ważna jest hierarchia: najpierw tytuł z wnioskiem, potem duży wykres wyniku głównego, wnioski, a dopiero na końcu metoda i bibliografia. Według Errena i Bourne’a (2007) przechodzień po abstrakcie patrzy najpierw na wnioski, potem na wyniki, a na metodę na końcu.
| Część plakatu | Co w niej umieścić | Miejsce na plakacie |
|---|---|---|
| Tytuł i autorzy | Wniosek jednym zdaniem, autorzy, afiliacja, kontakt | Pas u góry, największa czcionka |
| Pytanie albo cel | Jedno pytanie badawcze lub hipoteza; jedno zdanie, po co je zadano | Początek pierwszej kolumny |
| Metoda | Kto i ile osób, jak mierzono, jaka analiza – w punktach; ewentualnie mały model konceptualny | Pierwsza kolumna, pod pytaniem |
| Wynik główny | Jeden duży wykres i jedna linijka statystyk z wielkością efektu | Środek, największy blok |
| Wnioski | 2–3 punkty, w tym ograniczenie, które zmienia interpretację | Obok wykresu albo pod nim |
| Więcej informacji | Kod QR do pakietu danych, 2–3 kluczowe pozycje bibliografii | Dół plakatu, mniejsza czcionka |
Przegląd literatury, który w pracy zajmuje rozdział, na plakacie mieści się w jednym zdaniu nad pytaniem. Przy kilku hipotezach wybierz tę, która odpowiada na pytanie główne, a pozostałe przenieś pod kod QR.
Ile tekstu: mniej, niż się wydaje
Gundogan i in. (2016) podają orientacyjnie około 100 słów na sekcję i radzą pisać hasłami, a nie pełnymi zdaniami. Erren i Bourne (2007) piszą o oszczędności słów jako cesze dobrego raportu naukowego, szczególnie ważnej na plakacie, bo miejsca jest mało. Prawy szkic na rysunku 1 ma łącznie 102 słowa (bez opisów osi i stopki). To wystarcza, żeby podać pytanie, metodę, wynik, wnioski i ograniczenie.
Najprościej zacząć od gotowego abstraktu i z każdego zdania zostawić tylko to, czego nie pokazuje wykres. Zdanie „Przeprowadzono badanie z udziałem 180 osób studiujących, które przez siedem dni wypełniały dzienniczek snu” zamienia się w dwa punkty: „180 osób studiujących” i „dzienniczek snu, 7 dni”. Jeśli tekst nadal nie mieści się w kolumnie, nie zmniejszaj czcionki. Usuń zdanie.
Wykres zamiast tabeli
Erren i Bourne (2007) piszą, że jeden starannie przygotowany wykres mówi często więcej niż setki słów. Na plakacie tabela przegrywa z wykresem podwójnie: liczby trzeba czytać z bliska, a porównanie trzeba zrobić samemu. Cleveland i McGill (1984) uporządkowali zadania percepcyjne według dokładności odczytu. Najlepiej wypadło porównanie położenia na wspólnej skali, dlatego dobrym wyborem na plakat są punkty na jednej osi. Weissgerber i in. (2015) pokazali, że różne rozkłady mogą dawać ten sam wykres słupkowy. Dla zmiennej ilościowej lepiej więc pokazać wyniki osób i średnie z przedziałem ufności, jak w szkicu „dobrze”, albo wykres raincloud. Wykres słupkowy zostaw dla liczebności i odsetków. Przy pozycjach skali Likerta sprawdzą się słupki rozbieżne opisane we wpisie odpowiedzi Likerta w raporcie.
Ogólne zasady doboru wykresu i jego podpisu omawia wpis wykresy w pracy dyplomowej, a przygotowanie rysunków do publikacji – tabele i rysunki do artykułu naukowego. Na plakacie zmieniają się trzy rzeczy:
- Nagłówek wykresu jest wnioskiem („Mniej snu przy dłuższej pracy”), a pod nim jest jedna linijka objaśnienia: co oznaczają punkty i odcinki.
- Kolor tylko dla tego, o czym mówisz. Wystarczą szare dane i jeden kolor akcentu. Tęczowe i czerwono-zielone palety zniekształcają dane i są nieczytelne dla osób z zaburzeniami widzenia barw (Crameri i in., 2020).
- Statystyki w jednej linijce pod wykresem: test, p i wielkość efektu z przedziałem ufności. Gotowy zapis łatwo przygotować w generatorze opisu wyników APA. Jeśli wynik główny jest nieistotny, pokaż go tak samo, z przedziałem ufności, i opisz zgodnie z zasadami z wpisu jak opisać wynik nieistotny.
Ten sam rysunek bywa różnie odbierany w zależności od tego, kto na niego patrzy (Rougier i in., 2014). Pokaż szkic komuś spoza tematu i poproś o jedno zdanie, co wynika z wykresu.
Wielkość liter: co mówią źródła i jak to sprawdzić
Zalecenia co do czcionki są w literaturze dość zgodne, ale ogólne. Erren i Bourne (2007) piszą, by nigdy nie schodzić poniżej 24 punktów, a główne treści umieszczać na wysokości oczu. Gundogan i in. (2016) podają, że zwykle stosuje się 24 pt dla tekstu i 32 pt dla nagłówków, a tytuł ma mieć największą czcionkę na plakacie. Ich zdaniem plakat powinien być czytelny z odległości 1 m. Najpierw jednak obowiązują wymagania organizatora konferencji. Osobnego rozmiaru dla odległości 2 m w tych źródłach nie ma, więc go nie podajemy, ale czytelność łatwo sprawdzić.
| Stopień czcionki | Wysokość stopnia | Na wydruku kontrolnym A4 |
|---|---|---|
| 24 pt | 8.5 mm | 6 pt |
| 32 pt | 11.3 mm | 8 pt |
| 48 pt | 16.9 mm | 12 pt |
| 72 pt | 25.4 mm | 18 pt |
| 96 pt | 33.9 mm | 24 pt |
Punkt typograficzny to 1/72 cala, a stopień czcionki opisuje wysokość całego „pudełka” znaku, więc same litery są niższe niż podane milimetry. Arkusz A4 ma 210 mm szerokości, a A0 – 841 mm, więc plakat A0 wydrukowany na A4 jest pomniejszony do 25% (dokładnie 0.2497). Litera pomniejszona czterokrotnie i oglądana z czterokrotnie mniejszej odległości daje ten sam kąt widzenia. Tekst 24 pt na A0 oglądany z 2 m ma 14.55 minuty kątowej, tyle samo co jego wersja na A4 oglądana z około 50 cm. Wydrukuj więc plakat na kartce A4 i odsuń się na pół metra: czego nie przeczytasz na kartce, tego nikt nie przeczyta z dwóch metrów. Dotyczy to też opisów osi, dlatego wykres rób od razu w docelowym rozmiarze.
Wymiary i eksport do PDF
Rozmiar i orientację plakatu podaje organizator. Często jest to A0 w pionie, czyli 841 × 1189 mm, ale bywają też formaty poziome, A1 (594 × 841 mm) albo e-plakaty wyświetlane na ekranach, które Gundogan i in. (2016) opisują jako coraz częstsze. Ustaw ten rozmiar strony w programie od początku. Plakat zaprojektowany na A4 i powiększony w drukarni ma zbyt cienkie linie i rozmyte wykresy.
Do druku wyślij PDF wektorowy. Tekst, osie i punkty zapisane wektorowo skalują się bez utraty ostrości. Ten sam plakat jako obraz rastrowy przy 300 dpi miałby 9933 × 14043 piksele, czyli 139.5 megapiksela. Wykresy z R zapisuj więc jako PDF (urządzenie cairo_pdf, które poprawnie zapisuje polskie znaki) albo SVG i wstawiaj je do plakatu bez zrzutów ekranu. Szczegóły eksportu z R opisaliśmy we wpisie o tabelach i rysunkach do artykułu. Przed wysłaniem otwórz PDF w powiększeniu 100%, sprawdź, czy czcionki są osadzone, a polskie znaki i półpauzy wyglądają poprawnie. Gundogan i in. (2016) radzą też sprawdzić kolory w miejscu druku, bo mogą wyjść inaczej niż na ekranie.
Kod QR do pakietu danych
Skoro plakaty działają najlepiej razem z innymi formami przekazu (Ilic i Rowe, 2013), kod QR jest najprostszym sposobem, by z plakatu prowadziła droga dalej. Pod kodem może być pełna tabela wyników, analizy dodatkowe, kwestionariusz, skrypt i pakiet replikacyjny z danymi i kodem.
- Kod prowadzi do stałego adresu: strony projektu w repozytorium z DOI albo preprintu, a nie do pliku na prywatnym dysku, który za miesiąc zmieni adres.
- Pod kodem dopisz krótki adres dla osób, które nie zeskanują kodu, i jedno zdanie, co jest pod nim („Dane, kod i pełne wyniki”).
- Sprawdź kod przed drukiem z wydruku kontrolnego i z odległości, z której ludzie będą skanować, dwoma różnymi telefonami. Kod na szkicu ma 43 × 43 moduły i bok 15 cm na arkuszu A0.
- Udostępniaj tylko dane po anonimizacji i tylko w zakresie, na który pozwala zgoda uczestników, razem z książką kodową. Jeśli danych udostępnić nie możesz, pod kodem wystarczą pełne wyniki i skrypt.
Szkic plakatu: źle i dobrze
Rysunek 1 pokazuje ten sam wynik na dwóch szkicach plakatu A0 w pionie. Czerwone numery na lewym szkicu wskazują najczęstsze błędy.
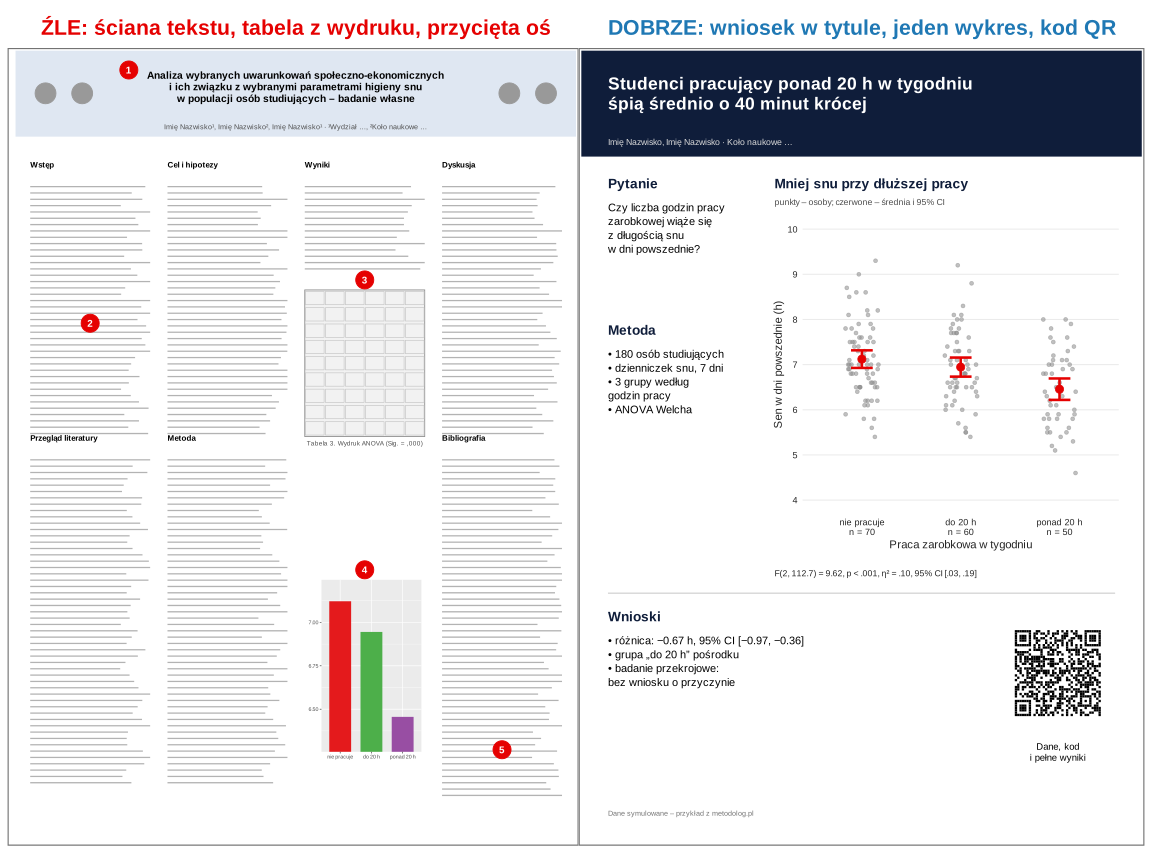
- Tytuł opisuje temat, a nie wynik, ma trzy wiersze i konkuruje z czterema logotypami.
- Ściana tekstu: osiem sekcji, w tym przegląd literatury, w czterech wąskich kolumnach. Taki plakat to rozdział pracy w innym formacie.
- Tabela z wydruku z przecinkami dziesiętnymi i „Sig. = ,000”, której nie da się odczytać z odległości.
- Słupki średnich na osi od 6.3, bez przedziałów ufności i bez liczebności, w trzech przypadkowych kolorach. Słupek niepracujących jest 5.3 razy wyższy niż słupek pracujących ponad 20 h, choć różnica średnich to 40 minut.
- Długa bibliografia zajmuje całą kolumnę, którą można było oddać wynikowi.
Na prawym szkicu tytuł mówi, co wyszło. Wykres jest największym blokiem (32% powierzchni pod pasem tytułu) i pokazuje dane wszystkich osób. Wnioski zawierają ograniczenie, które zmienia interpretację: w badaniu przekrojowym nie wiadomo, czy praca skraca sen, czy osoby, które mniej śpią, częściej podejmują pracę.
Typowe błędy na plakacie naukowym
- Kilka wyników „po równo”, każdy z wykresem tej samej wielkości. Oglądający nie wie, od czego zacząć.
- Czcionka zmniejszana do zmieszczenia tekstu. Poniżej 24 pt schodzić nie należy (Erren i Bourne, 2007). Dotyczy to również opisów osi i legend.
- Wniosek przyczynowy z badania korelacyjnego, np. „praca skraca sen”.
- Inne liczby na plakacie niż w abstrakcie i pracy, zwykle po poprawkach. Sprawdź każdą wartość z wynikiem analizy.
- Pominięcie wymagań organizatora co do formatu, orientacji albo szablonu. Według Gundogan i in. (2016) może to wykluczyć plakat z konkursu na najlepszy plakat.
- Nieprzetestowany kod QR albo kod prowadzący do strony, która wymaga logowania.
Przy plakacie: krótkie streszczenie na głos
Skoro plakat najlepiej działa z autorem obok (Rowe i Ilic, 2009), przygotuj trzydziestosekundowe streszczenie dla osób, które się zatrzymają. Nie czytaj plakatu na głos, tylko powiedz to, czego na nim brakuje: dlaczego pytanie jest ciekawe i jak rozumieć wykres. Wzór poniżej możesz dopasować do swojego badania:
Miej pod ręką ograniczenia badania i odpowiedź na pytanie o wielkość efektu. Plan analiz od hipotez do prezentacji wyników opisuje przewodnik po statystyce w pracy dyplomowej.
Liczby i szkic plakatu w R
Przepis 1 tworzy dane przykładu, liczy wynik główny plakatu (średnie z 95% CI, ANOVA Welcha, η² z CI i różnicę skrajnych grup) oraz wszystkie liczby o formacie, czcionkach i wydruku kontrolnym. Przepis 2 rysuje oba szkice z rysunku 1 w ggplot2, generuje kod QR pakietem qrcode i łączy szkice pakietem patchwork. Zapisany SVG albo PDF wstawisz do plakatu bez utraty ostrości.
1. Wynik główny i geometria plakatu
R
# B317 – liczby do wpisu /blog/plakat-naukowy-z-wynikami/
# Część A: przykładowe badanie na danych symulowanych (set.seed(3170)) – wynik główny plakatu.
# Część B: geometria plakatu – formaty A, punkty typograficzne, piksele, wydruk kontrolny.
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b317-1-liczby.R
suppressPackageStartupMessages(library(effectsize))

# ---------- A. Badanie: praca zarobkowa w trakcie studiów a długość snu
# 180 osób studiujących; godziny pracy zarobkowej w tygodniu (3 grupy) i średnia długość snu
# w dni powszednie z tygodniowego dzienniczka (godziny).
set.seed(3170)
n_gr <- c("nie pracuje" = 70, "do 20 h" = 60, "ponad 20 h" = 50)
praca <- factor(rep(names(n_gr), n_gr), levels = names(n_gr))
sr_pop <- c(7.2, 7.0, 6.4)[as.integer(praca)]
sen <- round(pmin(10, pmax(4, rnorm(sum(n_gr), sr_pop, 0.85))), 1)
dane <- data.frame(praca, sen)
write.csv(dane, "../plakat-dane-przyklad.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Średnie z 95% CI w grupach
opis <- do.call(rbind, lapply(split(dane$sen, dane$praca), function(y) {
  ci <- t.test(y)$conf.int
  data.frame(n = length(y), M = mean(y), SD = sd(y), CI_dol = ci[1], CI_gor = ci[2])
}))
print(round(opis, 2))

# Test główny: ANOVA Welcha i eta kwadrat z 95% CI (z klasycznej ANOVA)
welch <- oneway.test(sen ~ praca, data = dane)
round(c(F = unname(welch$statistic), df1 = unname(welch$parameter[1]),
        df2 = unname(welch$parameter[2]), p = welch$p.value), 3)
format.pval(welch$p.value, digits = 2)
eta <- eta_squared(aov(sen ~ praca, data = dane), ci = 0.95, alternative = "two.sided")
print(eta, digits = 3)

# Różnica, która trafia do tytułu plakatu: „ponad 20 h” minus „nie pracuje” (test Welcha)
tt <- t.test(dane$sen[dane$praca == "ponad 20 h"], dane$sen[dane$praca == "nie pracuje"])
d <- cohens_d(dane$sen[dane$praca == "ponad 20 h"], dane$sen[dane$praca == "nie pracuje"], ci = 0.95)
round(c(roznica_h = unname(tt$estimate[1] - tt$estimate[2]), CI_dol = tt$conf.int[1], CI_gor = tt$conf.int[2],
        roznica_min = unname(tt$estimate[1] - tt$estimate[2]) * 60, CI_min_dol = tt$conf.int[1] * 60,
        CI_min_gor = tt$conf.int[2] * 60,
        t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value,
        d = d$Cohens_d, d_dol = d$CI_low, d_gor = d$CI_high), 3)
format.pval(tt$p.value, digits = 2)

# ---------- B. Geometria plakatu
# Format A: arkusz A0 ma pole 1 m² i boki w proporcji 1 : √2 (841 × 1189 mm po zaokrągleniu);
# każdy kolejny format powstaje przez przecięcie poprzedniego na pół (wymiary zaokrąglane w dół).
formaty <- matrix(NA, 5, 2, dimnames = list(paste0("A", 0:4), c("szer_mm", "wys_mm")))
formaty[1, ] <- round(1000 * 2^(-1 / 4) * c(1, sqrt(2)))
for (k in 2:5) formaty[k, ] <- c(floor(formaty[k - 1, 2] / 2), formaty[k - 1, 1])
print(formaty)

# Punkt typograficzny = 1/72 cala = 25.4/72 mm (wysokość „stopnia” czcionki, nie samej litery)
pt_mm <- function(pt) pt * 25.4 / 72
stopnie <- c(24, 32, 48, 72, 96)
skala <- formaty["A4", "szer_mm"] / formaty["A0", "szer_mm"]   # wydruk kontrolny: A0 → A4
print(round(data.frame(pt = stopnie, mm = pt_mm(stopnie), pt_na_A4 = stopnie * skala), 1), row.names = FALSE)

# Ile pikseli ma A0 jako obraz rastrowy przy 300 dpi (stąd wektorowy PDF zamiast PNG)
px <- round(formaty["A0", ] / 25.4 * 300)
c(px, megapiksele = round(prod(px) / 1e6, 1))

# Wydruk kontrolny: skala liniowa A0 → A4
round(unname(skala), 4)
# Ten sam kąt widzenia: tekst 4× mniejszy oglądany z 4× mniejszej odległości
kat <- function(wys_mm, odl_m) 2 * atan(wys_mm / 2 / (odl_m * 1000)) * 180 / pi * 60   # minuty kątowe
odl_A4 <- 2 * unname(skala)   # z jakiej odległości (m) oglądać wydruk A4, by odpowiadał A0 z 2 m
round(c(odl_A4_m = odl_A4, A0_z_2m = kat(pt_mm(24), 2), A4_z_odl = kat(pt_mm(24) * skala, odl_A4)), 2)
Wynik w R
             n    M   SD CI_dol CI_gor
nie pracuje 70 7.12 0.82   6.93   7.32
do 20 h     60 6.94 0.82   6.73   7.16
ponad 20 h  50 6.46 0.84   6.22   6.69
      F     df1     df2       p
  9.619   2.000 112.668   0.000
[1] "0.00014"
For one-way between subjects designs, partial eta squared is equivalent to eta squared.
  Returning eta squared.
# Effect Size for ANOVA

Parameter |  Eta2 |         95% CI
----------------------------------
praca     | 0.100 | [0.028, 0.186]
  roznica_h      CI_dol      CI_gor roznica_min  CI_min_dol  CI_min_gor           t          df
     -0.665      -0.970      -0.361     -39.926     -58.174     -21.677      -4.338     104.404
          p           d       d_dol       d_gor
      0.000      -0.806      -1.182      -0.427
[1] "3.3e-05"
   szer_mm wys_mm
A0     841   1189
A1     594    841
A2     420    594
A3     297    420
A4     210    297
 pt   mm pt_na_A4
 24  8.5        6
 32 11.3        8
 48 16.9       12
 72 25.4       18
 96 33.9       24
    szer_mm      wys_mm megapiksele
     9933.0     14043.0       139.5
[1] 0.2497
odl_A4_m  A0_z_2m A4_z_odl
    0.50    14.55    14.55
2. Rysunek: dwa szkice plakatu „źle / dobrze”
R
# B317 – rysunek do wpisu /blog/plakat-naukowy-z-wynikami/
# Dwa szkice plakatu A0 (pion, 841 × 1189 mm) z tym samym wynikiem: „źle” i „dobrze”.
# Uruchomienie z folderu kod/:
#   PNG_DIR=<katalog podglądu> LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b317-rysunki.R > b317-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(patchwork); library(svglite); library(qrcode) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", granat = "#0f1d3a", dane = "grey55")
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: width=\"%d\" height=\"%d\"\n", plik, round(szer * 100), round(wys * 100)))
  png_dir <- Sys.getenv("PNG_DIR")
  if (nzchar(png_dir) && requireNamespace("magick", quietly = TRUE)) {
    magick::image_write(magick::image_read_svg(plik, width = 1400),
                        file.path(png_dir, sub("\\.svg$", ".png", basename(plik))), format = "png")
  }
}
# Płótno plakatu w milimetrach: x 0–841, y 0–1189
plotno <- function() {
  ggplot() + coord_fixed(xlim = c(0, 841), ylim = c(0, 1189), expand = FALSE) + theme_void() +
    theme(plot.background = element_rect(fill = "white", colour = "grey45", linewidth = 0.8),
          plot.margin = margin(2, 2, 2, 2))
}
# Blok „tekstu” narysowany szarymi liniami (wiersze akapitu)
linie <- function(x0, x1, y_gora, n, odstep = 9.5, grubosc = 2.2) {
  set.seed(round(x0 + y_gora))
  data.frame(x = x0, xend = x0 + (x1 - x0) * pmin(1, runif(n, 0.75, 1.05)),
             y = y_gora - (seq_len(n) - 1) * odstep, lw = grubosc)
}
napis <- function(etykieta, kolor) {
  ggplot() + annotate("text", x = 0, y = 0.5, label = etykieta, hjust = 0, fontface = "bold", colour = kolor, size = 5.6) +
    xlim(0, 1) + theme_void() + theme(plot.margin = margin(0, 0, 0, 6))
}

dane <- read.csv("../plakat-dane-przyklad.csv", fileEncoding = "UTF-8")
dane$praca <- factor(dane$praca, levels = c("nie pracuje", "do 20 h", "ponad 20 h"))
sr <- do.call(rbind, lapply(split(dane$sen, dane$praca), function(y) {
  ci <- t.test(y)$conf.int; data.frame(n = length(y), M = mean(y), dol = ci[1], gor = ci[2]) }))
sr$praca <- factor(rownames(sr), levels = levels(dane$praca))

# ---------- ŹLE: długi tytuł, ściana tekstu w czterech kolumnach, tabela z wydruku, słupki na przyciętej osi
slupki <- ggplot(sr, aes(praca, M, fill = praca)) + geom_col(width = 0.7) +
  scale_fill_manual(values = c("#e41a1c", "#4daf4a", "#984ea3")) +
  coord_cartesian(ylim = c(6.3, 7.2)) + labs(x = NULL, y = NULL) +
  theme_grey(base_size = 5) + theme(legend.position = "none", axis.text = element_text(size = 4))
kol_x <- c(22, 228, 434, 640); szer_kol <- 180
naglowki <- data.frame(x = rep(kol_x, each = 2), y = rep(c(1000, 590), 4),
  lab = c("Wstęp", "Przegląd literatury", "Cel i hipotezy", "Metoda", "Wyniki", "", "Dyskusja", "Bibliografia"))
bloki <- rbind(linie(22, 202, 985, 40), linie(22, 202, 575, 52),
               linie(228, 408, 985, 40), linie(228, 408, 575, 52),
               linie(434, 614, 985, 14), linie(640, 820, 985, 40), linie(640, 820, 575, 54))
tabela <- expand.grid(w = 1:9, k = 1:6)
zle <- plotno() +
  annotate("rect", xmin = 0, xmax = 841, ymin = 1060, ymax = 1189, fill = "#dfe7f2") +
  annotate("point", x = c(45, 100, 741, 796), y = 1125, size = 7, colour = "grey60") +
  annotate("text", x = 420, y = 1135, size = 2.7, fontface = "bold", lineheight = 0.95,
           label = "Analiza wybranych uwarunkowań społeczno-ekonomicznych\ni ich związku z wybranymi parametrami higieny snu\nw populacji osób studiujących – badanie własne") +
  annotate("text", x = 420, y = 1075, size = 1.9, colour = "grey30",
           label = "Imię Nazwisko¹, Imię Nazwisko², Imię Nazwisko¹ · ¹Wydział …, ²Koło naukowe …") +
  geom_text(data = naglowki, aes(x, y + 18, label = lab), hjust = 0, size = 2.1, fontface = "bold") +
  geom_segment(data = bloki, aes(x = x, xend = xend, y = y, yend = y), linewidth = 0.45, colour = "grey70") +
  annotate("rect", xmin = 434, xmax = 614, ymin = 610, ymax = 830, fill = "grey95", colour = "grey55", linewidth = 0.3) +
  geom_tile(data = tabela, aes(x = 434 + (k - 0.5) * 30, y = 830 - (w - 0.5) * (220 / 9)), width = 28, height = 20,
            fill = NA, colour = "grey75", linewidth = 0.2) +
  annotate("text", x = 524, y = 600, label = "Tabela 3. Wydruk ANOVA (Sig. = ,000)", size = 1.7, colour = "grey30") +
  annotation_custom(ggplotGrob(slupki), xmin = 434, xmax = 614, ymin = 120, ymax = 400) +
  annotate("point", x = c(170, 112, 524, 524, 730), y = c(1160, 780, 845, 410, 140),
           size = 6, colour = KOLORY[["akcent"]]) +
  annotate("text", x = c(170, 112, 524, 524, 730), y = c(1160, 780, 845, 410, 140),
           label = 1:5, colour = "white", fontface = "bold", size = 2.6)

# ---------- DOBRZE: tytuł-wniosek, trzy kolumny, jeden duży wykres z danymi osób, wnioski i kod QR
glowny <- ggplot(dane, aes(praca, sen)) +
  geom_point(position = position_jitter(width = 0.17, height = 0, seed = 3170), colour = KOLORY[["dane"]],
             alpha = 0.55, size = 1.1) +
  geom_errorbar(data = sr, aes(y = M, ymin = dol, ymax = gor), width = 0.22, linewidth = 0.9, colour = KOLORY[["akcent"]]) +
  geom_point(data = sr, aes(y = M), size = 2.6, colour = KOLORY[["akcent"]]) +
  scale_y_continuous(limits = c(4, 10), breaks = 4:10) +
  scale_x_discrete(labels = sprintf("%s\nn = %d", levels(dane$praca), sr$n)) +
  labs(x = "Praca zarobkowa w tygodniu", y = "Sen w dni powszednie (h)") +
  theme_minimal(base_size = 8.5) +
  theme(panel.grid.minor = element_blank(), panel.grid.major.x = element_blank(),
        axis.text = element_text(colour = "grey15"), axis.title = element_text(colour = "grey15"))
qr <- qr_code("https://www.metodolog.pl/blog/plakat-naukowy-z-wynikami/plakat-dane-przyklad.csv", ecl = "M")
qm <- as.matrix(unclass(qr)); kw <- 150 / ncol(qm)
qr_df <- subset(expand.grid(r = seq_len(nrow(qm)), k = seq_len(ncol(qm))), qm[cbind(r, k)])
teksty_dobrze <- c(
  tytul = "Studenci pracujący ponad 20 h w tygodniu\nśpią średnio o 40 minut krócej",
  autorzy = "Imię Nazwisko, Imię Nazwisko · Koło naukowe …",
  pyt_h = "Pytanie",
  pyt = "Czy liczba godzin pracy\nzarobkowej wiąże się\nz długością snu\nw dni powszednie?",
  met_h = "Metoda",
  met = "• 180 osób studiujących\n• dzienniczek snu, 7 dni\n• 3 grupy według\n  godzin pracy\n• ANOVA Welcha",
  wyk_h = "Mniej snu przy dłuższej pracy",
  wyk_p = "punkty – osoby; czerwone – średnia i 95% CI",
  stat = "F(2, 112.7) = 9.62, p < .001, η² = .10, 95% CI [.03, .19]",
  wn_h = "Wnioski",
  wn = "• różnica: −0.67 h, 95% CI [−0.97, −0.36]\n• grupa „do 20 h” pośrodku\n• badanie przekrojowe:\n  bez wniosku o przyczynie",
  qr_h = "Dane, kod\ni pełne wyniki")
dobrze <- plotno() +
  annotate("rect", xmin = 0, xmax = 841, ymin = 1030, ymax = 1189, fill = KOLORY[["granat"]]) +
  annotate("text", x = 40, y = 1125, label = teksty_dobrze[["tytul"]], hjust = 0, colour = "white",
           fontface = "bold", size = 4.6, lineheight = 0.95) +
  annotate("text", x = 40, y = 1052, label = teksty_dobrze[["autorzy"]], hjust = 0, colour = "grey85", size = 2.3) +
  annotate("text", x = 40, y = 990, label = teksty_dobrze[["pyt_h"]], hjust = 0, fontface = "bold", size = 3.6,
           colour = KOLORY[["granat"]]) +
  annotate("text", x = 40, y = 960, label = teksty_dobrze[["pyt"]], hjust = 0, vjust = 1, size = 2.9, lineheight = 1.05) +
  annotate("text", x = 40, y = 770, label = teksty_dobrze[["met_h"]], hjust = 0, fontface = "bold", size = 3.6,
           colour = KOLORY[["granat"]]) +
  annotate("text", x = 40, y = 740, label = teksty_dobrze[["met"]], hjust = 0, vjust = 1, size = 2.9, lineheight = 1.05) +
  annotate("text", x = 290, y = 990, label = teksty_dobrze[["wyk_h"]], hjust = 0, fontface = "bold", size = 3.6,
           colour = KOLORY[["granat"]]) +
  annotate("text", x = 290, y = 962, label = teksty_dobrze[["wyk_p"]], hjust = 0, size = 2.3, colour = "grey30") +
  annotation_custom(ggplotGrob(glowny), xmin = 280, xmax = 815, ymin = 430, ymax = 950) +
  annotate("text", x = 290, y = 405, label = teksty_dobrze[["stat"]], hjust = 0, size = 2.3, colour = "grey15") +
  annotate("segment", x = 40, xend = 801, y = 375, yend = 375, colour = "grey80", linewidth = 0.4) +
  annotate("text", x = 40, y = 340, label = teksty_dobrze[["wn_h"]], hjust = 0, fontface = "bold", size = 3.6,
           colour = KOLORY[["granat"]]) +
  annotate("text", x = 40, y = 310, label = teksty_dobrze[["wn"]], hjust = 0, vjust = 1, size = 2.9, lineheight = 1.05) +
  geom_tile(data = qr_df, aes(x = 640 + (k - 0.5) * kw, y = 330 - (r - 0.5) * kw), width = kw, height = kw,
            fill = "black") +
  annotate("text", x = 715, y = 150, label = teksty_dobrze[["qr_h"]], size = 2.5, lineheight = 0.95, vjust = 1) +
  annotate("text", x = 40, y = 45, label = "Dane symulowane – przykład z metodolog.pl", hjust = 0, size = 1.9, colour = "grey45")

rys <- (napis("ŹLE: ściana tekstu, tabela z wydruku, przycięta oś", KOLORY[["akcent"]]) |
          napis("DOBRZE: wniosek w tytule, jeden wykres, kod QR", KOLORY[["drugi"]])) /
  (zle | dobrze) + plot_layout(heights = c(0.05, 1))
zapisz_svg(rys, "../plakat-szkic-zle-dobrze.svg", szer = 12, wys = 8.9)

# Ile słów jest na szkicu „dobrze” (bez osi wykresu i stopki)
slowa <- function(x) length(strsplit(trimws(gsub("[•\n]", " ", x)), "\\s+")[[1]])
cat("Słów na plakacie „dobrze”:", sum(sapply(teksty_dobrze, slowa)), "\n")
cat("Słupki od 6.3: wysokość „nie pracuje” / „ponad 20 h” =", round((sr$M[1] - 6.3) / (sr$M[3] - 6.3), 1), "\n")
cat("Wykres główny zajmuje", round(100 * (815 - 280) * (950 - 430) / (841 * 1030)), "% powierzchni pod pasem tytułu\n")
cat("Moduły kodu QR:", ncol(qm), "× ", nrow(qm), "; bok kodu na plakacie A0:", round(150 / 10), "cm\n")
Wynik w R
Zapisano ../plakat-szkic-zle-dobrze.svg: width="1200" height="890"
Słów na plakacie „dobrze”: 102
Słupki od 6.3: wysokość „nie pracuje” / „ponad 20 h” = 5.3
Wykres główny zajmuje 32 % powierzchni pod pasem tytułu
Moduły kodu QR: 43 ×  43 ; bok kodu na plakacie A0: 15 cm
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek powstał w pakietach ggplot2, patchwork, svglite i qrcode. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- qrcode (wersja 0.3.0): Onkelinx, T., & Teh, V. (2024). qrcode: Generate QRcodes with R (Version 0.3.0) [R package]. https://doi.org/10.5281/zenodo.5040088
Najczęstsze pytania
Jaki rozmiar czcionki wybrać na plakat naukowy?
Najpierw sprawdź wymagania konferencji. Erren i Bourne (2007) radzą nie schodzić poniżej 24 pt, a Gundogan i in. (2016) podają, że zwykle stosuje się 24 pt dla tekstu i 32 pt dla nagłówków, z tytułem największą czcionką na plakacie. Czytelność sprawdzisz, drukując plakat A0 na kartce A4: ta kartka oglądana z około 50 cm wygląda tak samo jak plakat z 2 m.
Ile tekstu powinien mieć plakat konferencyjny?
Mniej niż rozdział pracy i mniej niż abstrakt w pełnych zdaniach. Gundogan i in. (2016) podają orientacyjnie około 100 słów na sekcję i radzą pisać hasłami. Szkic „dobrze” w tym wpisie ma łącznie 102 słowa: pytanie, metodę w punktach, linijkę statystyk, wnioski i ograniczenie. Jeśli tekst się nie mieści, usuń zdanie zamiast zmniejszać czcionkę.
Czy na plakat można wstawić tabelę z wynikami?
Można, ale tylko wtedy, gdy oglądający potrzebuje dokładnych wartości, i to w kilku wierszach z dużą czcionką. Wynik główny lepiej pokazać na wykresie, bo porównanie położenia punktów na wspólnej osi odczytuje się dokładniej niż liczby (Cleveland i McGill, 1984). Pełną tabelę umieść w materiałach pod kodem QR, a nie zrzut z wydruku programu na plakacie.
W jakim formacie wysłać plakat do druku?
Jako PDF w docelowym rozmiarze, zwykle A0 (841 × 1189 mm), o ile organizator nie podał innego. Tekst i wykresy powinny być wektorowe, bo ten sam plakat jako obraz przy 300 dpi miałby 139.5 megapiksela. Przed wysłaniem otwórz PDF w powiększeniu 100%, sprawdź osadzenie czcionek i polskie znaki, a w drukarni zapytaj o próbkę kolorów.
Czy na plakacie naukowym trzeba podawać bibliografię?
Zwykle wystarczą 2–3 kluczowe pozycje mniejszą czcionką na dole plakatu, chyba że organizator wymaga więcej. Gundogan i in. (2016) radzą cytować tylko źródła niezbędne dla badania, bo bibliografia zajmuje dużo miejsca. Pełną listę literatury możesz dołączyć do materiałów pod kodem QR razem z wynikami i danymi.
Powiązane hasła
Przeczytaj też
Prezentacja wyników na obronie
Ile slajdów i liczb, wykres zamiast tabeli z SPSS, wynik nieistotny jako efekt z przedziałem ufności – z dwiema parami slajdów „źle / dobrze” zrobionych w R.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikPakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →Przygotowujesz plakat z wynikami na konferencję?
Sprawdzimy, czy liczby na plakacie zgadzają się z analizą, pomożemy wybrać wynik główny i wykres, który go pokazuje, oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je przedstawić przy plakacie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Crameri, F., Shephard, G. E., & Heron, P. J. (2020). The misuse of colour in science communication. Nature Communications, 11(1), Article 5444. https://doi.org/10.1038/s41467-020-19160-7 ● Otwarty dostęp
- Erren, T. C., & Bourne, P. E. (2007). Ten simple rules for a good poster presentation. PLoS Computational Biology, 3(5), Article e102. https://doi.org/10.1371/journal.pcbi.0030102 ● Otwarty dostęp
- Faulkes, Z. (2023). The “wall of text” visual structure of academic conference posters. Frontiers in Communication, 8, Article 1063345. https://doi.org/10.3389/fcomm.2023.1063345 ● Otwarty dostęp
- Gundogan, B., Koshy, K., Kurar, L., & Whitehurst, K. (2016). How to make an academic poster. Annals of Medicine and Surgery, 11, 69–71. https://doi.org/10.1016/j.amsu.2016.09.001 ● Otwarty dostęp
- Ilic, D., & Rowe, N. (2013). What is the evidence that poster presentations are effective in promoting knowledge transfer? A state of the art review. Health Information & Libraries Journal, 30(1), 4–12. https://doi.org/10.1111/hir.12015 ● Otwarty dostęp
- Persky, A. M. (2016). Scientific posters: A plea from a conference attendee. American Journal of Pharmaceutical Education, 80(10), Article 162. https://doi.org/10.5688/ajpe8010162 ● Otwarty dostęp
- Rougier, N. P., Droettboom, M., & Bourne, P. E. (2014). Ten simple rules for better figures. PLoS Computational Biology, 10(9), Article e1003833. https://doi.org/10.1371/journal.pcbi.1003833 ● Otwarty dostęp
- Rowe, N., & Ilic, D. (2009). What impact do posters have on academic knowledge transfer? A pilot survey on author attitudes and experiences. BMC Medical Education, 9(1), Article 71. https://doi.org/10.1186/1472-6920-9-71 ● Otwarty dostęp
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{crameri2020misuse, author={Crameri, Fabio and Shephard, Grace E. and Heron, Philip J.}, title={{The misuse of colour in science communication}}, journal={Nature Communications}, year={2020}, volume={11}, number={1}, eid={5444}, doi={10.1038/s41467-020-19160-7}}@article{erren2007ten, author={Erren, Thomas C. and Bourne, Philip E.}, title={{Ten simple rules for a good poster presentation}}, journal={PLoS Computational Biology}, year={2007}, volume={3}, number={5}, eid={e102}, doi={10.1371/journal.pcbi.0030102}}@article{faulkes2023wall, author={Faulkes, Zen}, title={{The “wall of text” visual structure of academic conference posters}}, journal={Frontiers in Communication}, year={2023}, volume={8}, eid={1063345}, doi={10.3389/fcomm.2023.1063345}}@article{gundogan2016how, author={Gundogan, Buket and Koshy, Kiron and Kurar, Langhit and Whitehurst, Katharine}, title={{How to make an academic poster}}, journal={Annals of Medicine and Surgery}, year={2016}, volume={11}, pages={69--71}, doi={10.1016/j.amsu.2016.09.001}}@article{ilic2013what, author={Ilic, Dragan and Rowe, Nicholas}, title={{What is the evidence that poster presentations are effective in promoting knowledge transfer? A state of the art review}}, journal={Health Information \& Libraries Journal}, year={2013}, volume={30}, number={1}, pages={4--12}, doi={10.1111/hir.12015}}@article{persky2016scientific, author={Persky, Adam M.}, title={{Scientific posters: A plea from a conference attendee}}, journal={American Journal of Pharmaceutical Education}, year={2016}, volume={80}, number={10}, eid={162}, doi={10.5688/ajpe8010162}}@article{rougier2014ten, author={Rougier, Nicolas P. and Droettboom, Michael and Bourne, Philip E.}, title={{Ten simple rules for better figures}}, journal={PLoS Computational Biology}, year={2014}, volume={10}, number={9}, eid={e1003833}, doi={10.1371/journal.pcbi.1003833}}@article{rowe2009what, author={Rowe, Nicholas and Ilic, Dragan}, title={{What impact do posters have on academic knowledge transfer? A pilot survey on author attitudes and experiences}}, journal={BMC Medical Education}, year={2009}, volume={9}, number={1}, eid={71}, doi={10.1186/1472-6920-9-71}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}