Czym metodologia Q różni się od ankiety
W zwykłym badaniu kwestionariuszowym korelujesz pozycje albo skale, a osoby są tylko replikacjami. Analiza czynnikowa szuka wtedy wymiarów, na które rozkładają się zmienne. W 1935 roku William Stephenson zaproponował odwrócenie tej logiki: korelować osoby zamiast testów (Stephenson, 1935). Tak powstała metodologia Q. Każdy uczestnik układa te same stwierdzenia od „najmniej” do „najbardziej się zgadzam”. Korelacja dwóch ułożeń mówi, jak podobnie dwie osoby widzą temat. Czynnik to grupa osób o zbliżonym punkcie widzenia.
Wynikiem nie jest średnia w populacji, tylko kilka spójnych perspektyw opisanych przez to, jak „typowa osoba” z danej perspektywy ułożyłaby karty. Watts i Stenner (2005) przedstawiają metodę psychologom zainteresowanym badaniami jakościowymi i porównują ją z innymi metodami jakościowymi. Dlatego badanie Q często pełni rolę ogniwa w badaniach mieszanych: dane są liczbowe, ale pytanie i interpretacja są jakościowe.
Metoda Q nie jest analizą skupień ani segmentacją respondentów na podstawie wyników skal. Tam grupujesz ludzi według poziomu cech. W Q porównujesz całościowe układy priorytetów jednej osoby. Każde ułożenie jest ipsatywne: karta wyżej oznacza, że inna musi trafić niżej. Jest tak samo jak w skali ipsatywnej z wymuszonym wyborem, tylko tu ta właściwość jest zamierzona.
Od concourse do Q-setu
Zabala i in. (2018) dzielą badanie Q na cztery etapy: projekt, zbieranie danych, analizę i interpretację. Projekt zaczyna się od concourse, czyli możliwie pełnego zbioru wypowiedzi o temacie. Zbierasz je z wywiadów, prasy, forów, literatury i od ekspertów, a cały proces dokumentujesz. Z concourse wybierasz Q-set, czyli próbkę stwierdzeń do sortowania. Często dzielisz stwierdzenia na podtematy i bierzesz z każdego podobną liczbę. Autorzy ostrzegają, że dobór stwierdzeń silnie zależy od badacza, więc ma być systematyczny, wyczerpujący i jawny.
- Warunek instrukcji. Jedno zdanie, według którego osoba sortuje, np. „od najmniej do najbardziej zgodnego z tym, co myślę”.
- Stwierdzenia. Jedna myśl w zdaniu, język uczestników, bez podwójnych przeczeń. Sprawdź je w wywiadzie poznawczym.
- Liczba kart. Większy Q-set lepiej oddaje temat, ale męczy uczestnika (Zabala i in., 2018). Pilotaż pokaże, ile kart da się rzetelnie ułożyć.
P-set i rozkład wymuszony
P-set to uczestnicy. Celem jest różnorodność poglądów, a nie ich częstość. Dlatego dobór jest zwykle celowy (dobór celowy lub kula śnieżna), a duża próba nie jest tu zaletą sama w sobie. W przeglądzie 52 badań Zabali i in. (2018) liczba respondentów wynosiła zwykle od 26 do 46. Dlatego wyniku nie wolno uogólniać na populację ani szacować odsetka osób o danej perspektywie. Do tego potrzebna jest osobna, reprezentatywna próba.
Uczestnik układa karty na siatce o kształcie zbliżonym do dzwonu. W rozkładzie wymuszonym liczba miejsc w każdej kolumnie jest stała, więc wszystkie ułożenia mają tę samą średnią i to samo odchylenie. W rozkładzie niewymuszonym liczby w kolumnach mogą się różnić. Po sortowaniu zapytaj, dlaczego skrajne karty trafiły na skraje. Te wypowiedzi są potem kluczowe w interpretacji (Zabala i in., 2018).
| Kolumna | −4 | −3 | −2 | −1 | 0 | +1 | +2 | +3 | +4 |
|---|---|---|---|---|---|---|---|---|---|
| Liczba kart | 2 | 3 | 3 | 4 | 6 | 4 | 3 | 3 | 2 |
Przykład: jak terapeuci widzą terapię online
Zespół chce poznać perspektywy psychoterapeutów na terapię online. Q-set ma 30 stwierdzeń, np. „Bez wspólnej przestrzeni relacja terapeutyczna jest płytsza” albo „Forma terapii zależy od problemu, z którym przychodzi klient”. P-set to 24 terapeutów (T01–T24). Każdy układa karty na siatce z tabeli wyżej. Dane są symulowane (set.seed(3241)) z trzech ukrytych perspektyw i dwóch osób o poglądach mieszanych. Plik z 30 stwierdzeniami i 24 sortowaniami możesz pobrać jako CSV. Kod jest w sekcji Przykład w R.
Analiza czynnikowa osób i liczba czynników
Macierz danych ma 30 wierszy (stwierdzenia) i 24 kolumny (osoby). Liczysz korelacje Pearsona między kolumnami, czyli macierz 24 × 24. W przykładzie wahają się od −.57 do .82. Z tej macierzy wyodrębniasz czynniki. Zabala i Pascual (2016) wskazują dwie metody stosowane w Q: analizę głównych składowych i analizę centroidalną. Pakiet qmethod domyślnie używa PCA (Zabala, 2014). Różnicę PCA i analizy czynnikowej omawia wpis PCA czy analiza czynnikowa?
Liczba czynników to kluczowa decyzja. Zabala i in. (2018) piszą, że większość badań łączy dwa lub więcej kryteriów, i odsyłają po ich opis do podręcznika Wattsa i Stennera (2012). Obok zwykłych kryteriów analizy czynnikowej liczy się też wstępna interpretacja: czynnik, który nie tworzy sensownej perspektywy albo powtarza inny, odrzucasz. W przykładzie zestawiamy trzy kryteria:
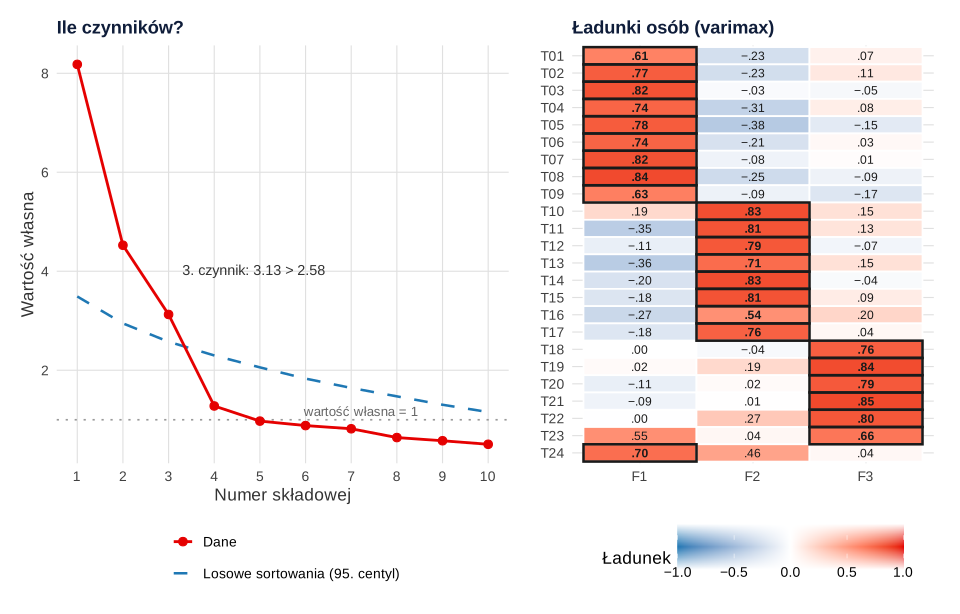
- Analiza równoległa (Horn, 1965). Wartości własne porównujesz z 95. centylem wartości z 1000 losowych sortowań o tym samym rozkładzie wymuszonym. Trzy pierwsze wartości (8.18, 4.53, 3.13) przekraczają progi losowe (3.49, 2.95, 2.58). Czwarta (1.28) jest niższa niż jej próg 2.30.
- Kryterium Kaisera. Wartość własna większa od 1 dałaby cztery czynniki.
- Osoby definiujące i sens. W rozwiązaniu czteroczynnikowym czwarty czynnik nie ma żadnej osoby definiującej, a jego najwyższy ładunek to .55. Nie da się więc zbudować dla niego tablicy czynnikowej.
Wybieramy trzy czynniki. Razem wyjaśniają 66.0% wariancji sortowań (po rotacji 26.7%, 22.9% i 16.3%). Wykres osypiska z progiem losowym widać na rysunku 1.
Rotacja varimax i osoby definiujące
Czynniki obracasz, żeby każda osoba ładowała możliwie wyraźnie jeden z nich. Zabala i Pascual (2016) podają dwie drogi: rotację matematyczną, zwykle varimax (Kaiser, 1958), albo rotację ręczną, gdy badacz ma uzasadnioną wiedzę o konkretnych osobach. Ładunek to korelacja sortowania osoby z czynnikiem.
Następnie wybierasz osoby definiujące (ang. flagging), czyli sortowania najbardziej typowe dla czynnika. Tylko one budują tablicę czynnikową. Zabala i Pascual (2016) opisują dwa kryteria automatycznego wstępnego oznaczania. Ładunek musi być istotnie wysoki, a jego kwadrat większy niż suma kwadratów ładunków tej osoby na pozostałych czynnikach. W kodzie pakietu qmethod (Zabala, 2014) pierwszy warunek ma postać |a| > 1.96 / √N, gdzie N to liczba stwierdzeń. Dla 30 stwierdzeń próg wynosi .358.
W przykładzie czynnik F1 definiuje 10 osób (T01–T09 i T24), F2 – 8 osób (T10–T17), a F3 – 6 osób (T18–T23). Dwie osoby wymagają uwagi. T23 ma ładunki .55 na F1 i .66 na F3. Spełnia oba kryteria dla F3, ale jest blisko sortowania mieszanego (ang. confounded), czyli istotnie związanego z więcej niż jednym czynnikiem. T24 ładuje .70 na F1 i .46 na F2. Automatyczne oznaczenie to tylko punkt wyjścia. Zabala i Pascual (2016) piszą, że oznaczenia można ręcznie dodawać i usuwać po obejrzeniu ładunków. Każdą taką decyzję opisz w artykule.
Z-score'y i tablica czynnikowa
Z-score stwierdzenia w czynniku to średnia ważona ocen, które dały mu osoby definiujące (Zabala i Pascual, 2016). W kodzie qmethod waga osoby zależy od jej ładunku a (Zabala, 2014):
W F1 osoba z ładunkiem .84 waży 2.95, a osoba z ładunkiem .61 – 0.98. Dla każdego stwierdzenia sumujesz oceny osób definiujących pomnożone przez wagi, a sumy standaryzujesz w obrębie czynnika (do średniej 0 i SD 1). Na koniec porządkujesz stwierdzenia według z-score'u i wkładasz je z powrotem do siatki: dwa najwyższe trafiają do kolumny +4, trzy następne do +3 i tak dalej. Tak powstaje tablica czynnikowa (ang. factor array), czyli ułożenie kart przez hipotetyczną typową osobę z danego czynnika (rysunek 2). Nie myl jej z wynikami czynnikowymi osób w zwykłej analizie czynnikowej.
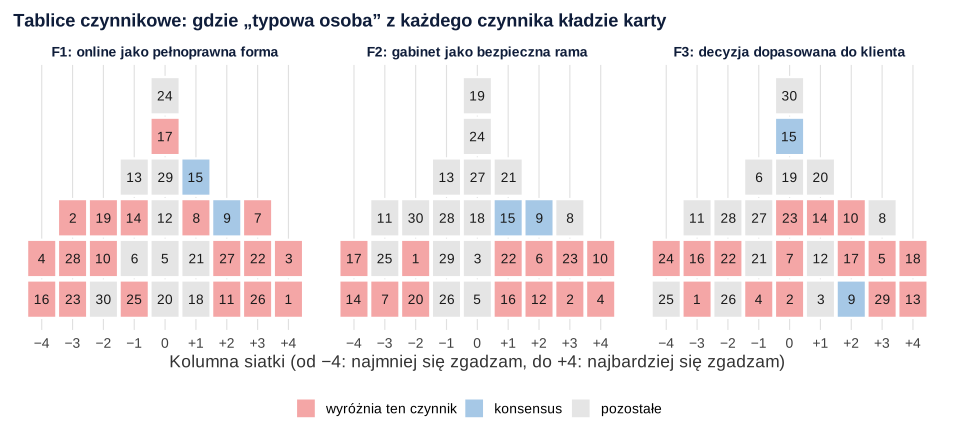
Które różnice między czynnikami są istotne? Procedurę opisaną przez Browna (1980) streszczają Zabala i Pascual (2016). Rzetelność złożona czynnika wynosi 0.8p / [1 + 0.8(p − 1)], gdzie p to liczba osób definiujących, a 0.8 to umowna rzetelność jednego sortowania. Z niej liczysz błąd standardowy z-score'ów i błąd standardowy różnicy dwóch czynników (SED). Stwierdzenie różni czynniki, gdy różnica z-score'ów przekracza 1.96 × SED (p < .05). Stwierdzenie wyróżniające różni dany czynnik od wszystkich pozostałych. Stwierdzenie konsensusowe nie różni żadnej pary. W przykładzie SE wyniosły 0.156, 0.174 i 0.200, a progi dla par czynników od 0.458 do 0.520. Konsensusowe są tylko dwa stwierdzenia: 9 („Brak dojazdu daje klientowi więcej czasu dla siebie”, we wszystkich czynnikach +2) i 15 („Po dniu sesji online jestem bardziej zmęczony(-a)”). Zabala i Pascual (2016) zauważają, że te miary zależą głównie od liczby osób definiujących, i proponują bootstrap jako uzupełnienie.
| Nr | Stwierdzenie | F1 | F2 | F3 | Status |
|---|---|---|---|---|---|
| 1 | Terapia online jest równie skuteczna jak terapia w gabinecie | +4 (2.00) | −2 (−0.56) | −3 (−1.27) | różni wszystkie |
| 3 | Sesje online pozwalają dotrzeć do osób z małych miejscowości | +4 (1.63) | 0 (−0.02) | +1 (0.45) | wyróżnia F1 |
| 4 | Bez wspólnej przestrzeni relacja terapeutyczna jest płytsza | −4 (−1.89) | +4 (1.87) | −1 (−0.26) | różni wszystkie |
| 10 | Mowa ciała to dla mnie kluczowe źródło informacji | −2 (−0.68) | +4 (1.70) | +2 (0.62) | różni wszystkie |
| 17 | Ośrodki powinny finansować szkolenia z pracy online | 0 (−0.09) | −4 (−1.83) | +2 (0.76) | różni wszystkie |
| 13 | Forma terapii zależy od problemu, z którym przychodzi klient | −1 (−0.27) | −1 (−0.48) | +4 (2.01) | wyróżnia F3 |
| 18 | Wolę łączyć sesje w gabinecie i online | +1 (0.22) | 0 (−0.02) | +4 (1.58) | wyróżnia F3 |
| 24 | Sesja online powinna być tańsza | 0 (−0.12) | 0 (−0.18) | −4 (−2.13) | wyróżnia F3 |
| 8 | W kryzysie suicydalnym wolę mieć klienta w gabinecie | +1 (0.17) | +3 (1.30) | +3 (1.26) | wyróżnia F1 |
| 9 | Brak dojazdu daje klientowi więcej czasu dla siebie | +2 (0.49) | +2 (0.78) | +2 (0.80) | konsensus |
W komórkach: kolumna siatki i z-score w nawiasie. „Różni wszystkie” – stwierdzenie różni każdą parę czynników.
Interpretacja jakościowa
Liczby kończą się na tablicy czynnikowej. Interpretacja łączy wyniki stwierdzeń z wypowiedziami uczestników i znajomością kontekstu (Zabala i in., 2018). Najwięcej mówią stwierdzenia, które są jednocześnie wyróżniające i leżą na skrajach siatki. Pytasz, dlaczego typowa osoba położyła je właśnie tam, i sięgasz po wypowiedzi uczestników o skrajnych kartach. Analizujesz je podobnie jak w analizie tematycznej. Każdej perspektywie nadaj krótką nazwę i opisz ją narracyjnie.
- F1 – „online jako pełnoprawna forma”. Skuteczność i dostępność na szczycie (1, 3, 26), zarzut płytszej relacji i „rozwiązania tymczasowego” na dnie (4, 16). Ta perspektywa nie odrzuca jednak gabinetu w kryzysie suicydalnym (8: +1).
- F2 – „gabinet jako bezpieczna rama”. Relacja, mowa ciała i bezpieczna rama gabinetu (4, 10, 23) na szczycie. Szkolenia z pracy online i superwizja online (17, 14) na dnie.
- F3 – „decyzja dopasowana do klienta”. Forma zależy od problemu i jest ustalana z klientem (13, 29, 5), dobrze sprawdza się łączenie form (18). Argumenty rynkowe i cenowe są na dnie (24, 25).
Stwierdzenia konsensusowe pokazują wspólny grunt. Wszyscy uznają, że brak dojazdu daje klientom czas. Korelacje z-score'ów między czynnikami (F1–F2: −.37, F1–F3: −.02, F2–F3: .19) pokazują, że perspektywy F1 i F2 są częściowo przeciwstawne, ale nie są dwoma końcami jednej osi. O jakości interpretacji przeczytasz w haśle wiarygodność w badaniach jakościowych.
Jak opisać badanie Q w artykule
Dziopa i Ahern (2011) w przeglądzie 14 badań Q znaleźli dużą niespójność terminologii, budowy narzędzia i analizy czynnikowej. Uznali, że odstępstwa od klasycznej metodologii Q są nieuniknione, ale każde trzeba jawnie uzasadnić. Zabala i in. (2018) proponują listę kontrolną raportowania. Podaj:
- źródła concourse, liczbę stwierdzeń w concourse i w Q-secie oraz sposób wyboru;
- warunek instrukcji, kształt siatki (rozkład wymuszony czy nie) i sposób zbierania danych;
- sposób doboru P-setu i jego liczebność;
- współczynnik korelacji, metodę ekstrakcji i rotacji oraz kryteria liczby czynników;
- regułę oznaczania osób definiujących i każdą ręczną zmianę;
- tablice czynnikowe wszystkich stwierdzeń, stwierdzenia wyróżniające i konsensusowe oraz próg istotności.
Jeśli planujesz badanie Q i chcesz omówić dobór stwierdzeń albo analizę, zajrzyj do oferty analiz statystycznych dla badaczy.
Przykład w R
Pierwszy przepis tworzy dane, zapisuje plik metodologia-q-dane.csv (możesz go pobrać tutaj) i liczy całą analizę funkcjami podstawowego R oraz psych::principal(). Oznaczanie osób definiujących, wagi, z-score'y i progi SED odtwarzają reguły z kodu pakietu qmethod. Drugi przepis pokazuje tę samą analizę w pakiecie qmethod. Nie był wykonany, bo pakietu nie było w naszym środowisku.
1. Analiza Q od sortowań do tablic czynnikowych
R
# Dane symulowane: badanie Q – jak psychoterapeuci postrzegają terapię online.
# Q-set: 30 stwierdzeń, P-set: 24 terapeutów, rozkład wymuszony od −4 do +4.
suppressPackageStartupMessages(library(psych))
set.seed(3241)

stwierdzenia <- c(
  "Terapia online jest równie skuteczna jak terapia w gabinecie",
  "Przez ekran trudniej mi wyczuć emocje klienta",
  "Sesje online pozwalają dotrzeć do osób z małych miejscowości",
  "Bez wspólnej przestrzeni relacja terapeutyczna jest płytsza",
  "Wybór formy terapii powinien należeć do klienta",
  "Problemy techniczne psują przebieg sesji",
  "Online łatwiej utrzymać regularność spotkań",
  "W kryzysie suicydalnym wolę mieć klienta w gabinecie",
  "Brak dojazdu daje klientowi więcej czasu dla siebie",
  "Mowa ciała to dla mnie kluczowe źródło informacji",
  "Klienci w domu mówią swobodniej niż w gabinecie",
  "Trudno zadbać o poufność, gdy klient jest w domu z rodziną",
  "Forma terapii zależy od problemu, z którym przychodzi klient",
  "Superwizja powinna obejmować pracę online",
  "Po dniu sesji online jestem bardziej zmęczony(-a)",
  "Terapia online to rozwiązanie tymczasowe",
  "Ośrodki powinny finansować szkolenia z pracy online",
  "Wolę łączyć sesje w gabinecie i online",
  "Przy pracy z dziećmi forma online się nie sprawdza",
  "Szkolenie terapeutyczne nie przygotowało mnie do pracy online",
  "Online łatwiej przerwać terapię bez pożegnania",
  "Badania nad terapią online są przekonujące",
  "Gabinet daje klientowi poczucie bezpiecznej ramy",
  "Sesja online powinna być tańsza",
  "Pracuję online, bo tego oczekuje rynek",
  "Terapia online zwiększa dostępność pomocy dla osób z niepełnosprawnościami",
  "W sesji online łatwiej mi pilnować czasu",
  "Klienci traktują sesje online mniej poważnie",
  "O formie terapii decyduję z klientem po konsultacji",
  "Przepisy dotyczące terapii online są niejasne")
n_stw <- length(stwierdzenia)

# Rozkład wymuszony: liczba kart w kolumnach od −4 do +4 (razem 30)
kolumny <- -4:4
liczby_kart <- c(2, 3, 3, 4, 6, 4, 3, 3, 2)
rozklad <- rep(kolumny, liczby_kart)

# Trzy perspektywy (prototypy) – wartości od −4 do +4 dla wybranych stwierdzeń, reszta 0
prototyp <- function(wartosci) { v <- numeric(n_stw); v[as.integer(names(wartosci))] <- wartosci; v }
A <- prototyp(c("1" = 4, "22" = 4, "3" = 3, "26" = 3, "11" = 2, "7" = 2, "9" = 2, "27" = 1,
                "4" = -4, "16" = -4, "28" = -3, "23" = -3, "10" = -2, "2" = -2, "19" = -1))
B <- prototyp(c("4" = 4, "23" = 4, "10" = 3, "2" = 3, "8" = 2, "12" = 2, "6" = 2, "21" = 1,
                "17" = -4, "14" = -4, "25" = -3, "11" = -3, "20" = -2, "7" = -2, "30" = -1))
C <- prototyp(c("13" = 4, "29" = 4, "5" = 3, "18" = 3, "14" = 2, "17" = 2, "8" = 2, "20" = 1,
                "25" = -4, "24" = -4, "16" = -3, "1" = -3, "28" = -2, "11" = -2, "4" = -1))

# Sortowanie jednej osoby: prototyp + szum, potem wymuszony rozkład (kolejność → kolumny siatki)
sortuj <- function(proto, sila) {
  wynik <- sila * proto / sd(proto) + sqrt(1 - sila^2) * rnorm(n_stw)
  rozklad[rank(wynik, ties.method = "random")]
}
grupa <- c(rep("A", 9), rep("B", 8), rep("C", 5), "A+C", "A+B")
sila <- runif(24, 0.70, 0.88)
dane <- sapply(seq_along(grupa), function(i) switch(grupa[i],
  A = sortuj(A, sila[i]), B = sortuj(B, sila[i]), C = sortuj(C, sila[i]),
  "A+C" = sortuj(A / sd(A) + C / sd(C), sila[i]), "A+B" = sortuj(A / sd(A) + 0.6 * B / sd(B), sila[i])))
colnames(dane) <- sprintf("T%02d", 1:24)
rownames(dane) <- sprintf("S%02d", 1:n_stw)
write.csv(data.frame(nr = 1:n_stw, stwierdzenie = stwierdzenia, dane), "metodologia-q-dane.csv", row.names = FALSE)

# Kontrola: czy każde sortowanie ma ten sam rozkład wymuszony
all(apply(dane, 2, function(x) all(sort(x) == sort(rozklad))))
dim(dane)

# Krok 1. Korelacje między osobami (kolumny = osoby, czyli macierz „odwrócona”)
R <- cor(dane)
round(range(R[upper.tri(R)]), 2)

# Krok 2. Liczba czynników: wartości własne i analiza równoległa na losowych sortowaniach z tym samym rozkładem
wartosci_wlasne <- eigen(R, only.values = TRUE)$values
losowe <- replicate(1000, eigen(cor(replicate(24, sample(rozklad))), only.values = TRUE)$values)
prog_95 <- apply(losowe, 1, quantile, probs = .95)
print(round(data.frame(skladowa = 1:6, wartosc_wlasna = wartosci_wlasne[1:6], losowe_95 = prog_95[1:6]), 2),
      row.names = FALSE)

# Krok 3. Ekstrakcja składowych głównych i rotacja varimax (3 czynniki)
pca <- principal(R, nfactors = 3, rotate = "varimax")
L <- unclass(pca$loadings)
colnames(L) <- c("F1", "F2", "F3")
round(100 * colSums(L^2) / ncol(dane), 1)   # % wyjaśnionej wariancji po rotacji
round(100 * sum(L^2) / ncol(dane), 1)        # razem

# Dla porównania: rozwiązanie z 4 czynnikami (kryterium Kaisera) – ile osób definiuje każdy czynnik?
L4 <- unclass(principal(R, nfactors = 4, rotate = "varimax")$loadings)
colSums(abs(L4) > 1.96 / sqrt(n_stw) & L4^2 > (rowSums(L4^2) - L4^2))
round(apply(abs(L4), 2, max), 2)   # najwyższy ładunek w każdym czynniku

# Krok 4. Osoby definiujące: |ładunek| > 1.96 / √(liczba stwierdzeń) i ładunek² > suma kwadratów pozostałych ładunków
prog <- 1.96 / sqrt(n_stw)
round(prog, 3)
definiujace <- abs(L) > prog & L^2 > (rowSums(L^2) - L^2)
tab_ladunki <- data.frame(round(L, 2), definiuje = apply(definiujace, 1, function(x) paste(colnames(L)[x], collapse = "")),
                          grupa_symulacji = grupa)
tab_ladunki$definiuje[tab_ladunki$definiuje == ""] <- "–"
print(tab_ladunki)
colSums(definiujace)

# Krok 5. Wagi osób definiujących w = a / (1 − a²) i z-score'y stwierdzeń dla każdego czynnika
z_czynnik <- function(k) {
  a <- L[definiujace[, k], k]
  w <- a / (1 - a^2)
  suma <- dane[, definiujace[, k], drop = FALSE] %*% w
  as.vector((suma - mean(suma)) / sd(suma))
}
Z <- sapply(1:3, z_czynnik)
dimnames(Z) <- list(rownames(dane), colnames(L))
round(w_przyklad <- L[definiujace[, 1], 1] / (1 - L[definiujace[, 1], 1]^2), 2)  # wagi dla F1

# Krok 6. Tablica czynnikowa: stwierdzenia uporządkowane wg z-score'u wracają do siatki rozkładu wymuszonego
tablica <- apply(Z, 2, function(z) sort(rozklad)[rank(z, ties.method = "first")])
dimnames(tablica) <- dimnames(Z)

# Krok 7. Stwierdzenia wyróżniające i konsensusowe (rzetelność złożona, SE, SED, próg 1.96 × SED)
p_def <- colSums(definiujace)
rzetelnosc <- 0.8 * p_def / (1 + (p_def - 1) * 0.8)
SE <- apply(Z, 2, sd) * sqrt(1 - rzetelnosc)
print(round(rbind(osoby_definiujace = p_def, rzetelnosc = rzetelnosc, SE = SE), 3))
pary <- combn(3, 2)
istotne <- sapply(1:ncol(pary), function(j) {
  i <- pary[1, j]; k <- pary[2, j]
  abs(Z[, i] - Z[, k]) > 1.96 * sqrt(SE[i]^2 + SE[k]^2)
})
colnames(istotne) <- apply(pary, 2, function(p) paste0("F", p, collapse = "-"))
SED <- apply(pary, 2, function(p) sqrt(SE[p[1]]^2 + SE[p[2]]^2)); names(SED) <- colnames(istotne)
round(rbind(SED = SED, prog_05 = 1.96 * SED), 3)
wyroznia <- sapply(1:3, function(k) apply(istotne[, grepl(k, colnames(istotne)), drop = FALSE], 1, all))
konsensus <- rowSums(istotne) == 0
status <- ifelse(konsensus, "konsensus",
          apply(wyroznia, 1, function(x) if (all(x)) "wyróżnia każdy" else if (any(x)) paste0("wyróżnia F", which(x)) else ""))

wynik <- data.frame(nr = 1:n_stw, round(Z, 2), tablica, status, stwierdzenie = stwierdzenia)
names(wynik)[2:7] <- c("z_F1", "z_F2", "z_F3", "F1", "F2", "F3")
print(wynik[order(-wynik$z_F1), 1:8], row.names = FALSE)
cat("Stwierdzenia konsensusowe:", which(konsensus), "\n")
table(status)

# Krótkie zestawienia do interpretacji: dwa najwyżej i dwa najniżej ocenione stwierdzenia w każdym czynniku
for (k in 1:3) {
  o <- order(-Z[, k])
  cat(sprintf("F%d  +4: %s | −4: %s\n", k, paste(o[1:2], collapse = ", "), paste(rev(tail(o, 2)), collapse = ", ")))
}
# Korelacje z-score'ów między czynnikami
round(cor(Z), 2)
Wynik w R
[1] TRUE
[1] 30 24
[1] -0.57  0.82
 skladowa wartosc_wlasna losowe_95
        1           8.18      3.49
        2           4.53      2.95
        3           3.13      2.58
        4           1.28      2.30
        5           0.97      2.06
        6           0.88      1.83
  F1   F2   F3
26.7 22.9 16.3
[1] 66
RC1 RC3 RC2 RC4
 10   7   6   0
 RC1  RC3  RC2  RC4
0.82 0.83 0.86 0.55
[1] 0.358
       F1    F2    F3 definiuje grupa_symulacji
T01  0.61 -0.23  0.07        F1               A
T02  0.77 -0.23  0.11        F1               A
T03  0.82 -0.03 -0.05        F1               A
T04  0.74 -0.31  0.08        F1               A
T05  0.78 -0.38 -0.15        F1               A
T06  0.74 -0.21  0.03        F1               A
T07  0.82 -0.08  0.01        F1               A
T08  0.84 -0.25 -0.09        F1               A
T09  0.63 -0.09 -0.17        F1               A
T10  0.19  0.83  0.15        F2               B
T11 -0.35  0.81  0.13        F2               B
T12 -0.11  0.79 -0.07        F2               B
T13 -0.36  0.71  0.15        F2               B
T14 -0.20  0.83 -0.04        F2               B
T15 -0.18  0.81  0.09        F2               B
T16 -0.27  0.54  0.20        F2               B
T17 -0.18  0.76  0.04        F2               B
T18  0.00 -0.04  0.76        F3               C
T19  0.02  0.19  0.84        F3               C
T20 -0.11  0.02  0.79        F3               C
T21 -0.09  0.01  0.85        F3               C
T22  0.00  0.27  0.80        F3               C
T23  0.55  0.04  0.66        F3             A+C
T24  0.70  0.46  0.04        F1             A+B
F1 F2 F3
10  8  6
 T01  T02  T03  T04  T05  T06  T07  T08  T09  T24
0.98 1.90 2.45 1.64 1.97 1.67 2.47 2.95 1.03 1.37
                      F1    F2   F3
osoby_definiujace 10.000 8.000 6.00
rzetelnosc         0.976 0.970 0.96
SE                 0.156 0.174 0.20
        F1-F2 F1-F3 F2-F3
SED     0.234 0.254 0.265
prog_05 0.458 0.497 0.520
 nr  z_F1  z_F2  z_F3 F1 F2 F3         status
  1  2.00 -0.56 -1.27  4 -2 -3 wyróżnia każdy
  3  1.63 -0.02  0.45  4  0  1    wyróżnia F1
 26  1.56 -0.27 -0.50  3 -1 -2    wyróżnia F1
 22  1.54  0.30 -0.65  3  1 -2 wyróżnia każdy
  7  1.27 -0.85 -0.01  3 -3  0 wyróżnia każdy
 11  0.98 -1.66 -1.29  2 -3 -3    wyróżnia F1
 27  0.56 -0.10 -0.32  2  0 -1    wyróżnia F1
  9  0.49  0.78  0.80  2  2  2      konsensus
 18  0.22 -0.02  1.58  1  0  4    wyróżnia F3
 21  0.22  0.18 -0.30  1  1 -1
  8  0.17  1.30  1.26  1  3  3    wyróżnia F1
 15  0.10  0.27 -0.12  1  1  0      konsensus
 20  0.09 -0.54  0.14  0 -2  1    wyróżnia F2
  5  0.06  0.03  1.43  0  0  3    wyróżnia F3
 12  0.00  1.00  0.42  0  2  1    wyróżnia F2
 29 -0.03 -0.28  1.47  0 -1  3    wyróżnia F3
 17 -0.09 -1.83  0.76  0 -4  2 wyróżnia każdy
 24 -0.12 -0.18 -2.13  0  0 -4    wyróżnia F3
 25 -0.20 -1.62 -1.87 -1 -3 -4    wyróżnia F1
  6 -0.21  0.87 -0.41 -1  2 -1    wyróżnia F2
 14 -0.25 -1.80  0.36 -1 -4  1 wyróżnia każdy
 13 -0.27 -0.48  2.01 -1 -1  4    wyróżnia F3
 30 -0.30 -0.75 -0.18 -2 -2  0
 10 -0.68  1.70  0.62 -2  4  2 wyróżnia każdy
 19 -0.79 -0.21 -0.07 -2  0  0    wyróżnia F1
 23 -1.36  1.32 -0.04 -3  3  0 wyróżnia każdy
 28 -1.42 -0.28 -0.69 -3 -1 -2    wyróżnia F1
  2 -1.45  1.41  0.05 -3  3  0 wyróżnia każdy
 16 -1.83  0.41 -1.27 -4  1 -3 wyróżnia każdy
  4 -1.89  1.87 -0.26 -4  4 -1 wyróżnia każdy
Stwierdzenia konsensusowe: 9 15
status
                    konsensus    wyróżnia F1    wyróżnia F2    wyróżnia F3
             2              2              8              3              5
wyróżnia każdy
            10
F1  +4: 1, 3 | −4: 4, 16
F2  +4: 4, 10 | −4: 17, 14
F3  +4: 13, 18 | −4: 24, 25
      F1    F2    F3
F1  1.00 -0.37 -0.02
F2 -0.37  1.00  0.19
F3 -0.02  0.19  1.00
2. To samo w pakiecie qmethod (wymaga pakietu qmethod, niewykonany)
R
# Wymaga pakietu qmethod – kod NIEWYKONANY (pakietu nie było w naszym środowisku), dlatego na stronie nie ma jego wyników.
# Te same kroki co w przepisie 1: PCA na korelacjach między osobami, varimax, automatyczne oznaczanie osób
# definiujących, z-score'y, tablice czynnikowe oraz stwierdzenia wyróżniające i konsensusowe.
library(qmethod)
dane_q <- read.csv("metodologia-q-dane.csv")
sortowania <- dane_q[, -(1:2)]                 # kolumny T01–T24: jedna kolumna = jedno sortowanie
rownames(sortowania) <- sprintf("S%02d", dane_q$nr)

wynik_q <- qmethod(sortowania, nfactors = 3, extraction = "PCA", rotation = "varimax",
                   forced = TRUE, cor.method = "pearson")
summary(wynik_q)            # charakterystyka czynników i tablice czynnikowe
loa.and.flags(wynik_q)      # ładunki z zaznaczonymi osobami definiującymi
wynik_q$zsc                 # z-score'y stwierdzeń
wynik_q$zsc_n               # tablice czynnikowe (wartości od −4 do +4)
wynik_q$qdc                 # stwierdzenia wyróżniające i konsensusowe
plot(wynik_q)               # z-score'y stwierdzeń we wszystkich czynnikach
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje cor(), eigen(), replicate()) i pakietu psych (principal()); rysunki przygotowano w pakietach ggplot2 i patchwork. Kod pakietu qmethod nie był wykonany.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Uogólnianie na populację. Q pokazuje, jakie perspektywy istnieją, a nie jak często występują. Zdanie „40% terapeutów uważa…” nie wynika z badania Q.
- Korelowanie stwierdzeń zamiast osób. To zwykła analiza czynnikowa EFA na pozycjach. Q wymaga macierzy odwróconej: jedna kolumna to jedna osoba.
- Liczba czynników tylko z kryterium Kaisera. W przykładzie dałoby ono czynnik bez żadnej osoby definiującej. Łącz kryteria i opisz, dlaczego wybrałeś(-aś) dane rozwiązanie.
- Ukryte ręczne zmiany oznaczeń. Ręczne oznaczanie jest dopuszczalne, ale każdą decyzję, np. wykluczenie sortowania mieszanego, trzeba podać.
- Interpretacja z samych liczb. Bez wypowiedzi uczestników o skrajnych kartach nazwy czynników są domysłem badacza.
- Traktowanie z-score'ów jak wyników testu. Z-score stwierdzenia opisuje jego miejsce w perspektywie, a nie poziom cechy osoby. Do pomiaru poziomu cech służą skale Likerta i klasyczna psychometria.
Najczęstsze pytania
Jak duży P-set wybrać w badaniu Q?
Badanie Q nie szacuje częstości poglądów, więc duża próba nie jest celem. Liczy się różnorodność uczestników dobranych celowo. W przeglądzie 52 badań Zabali i in. (2018) liczba respondentów wynosiła zwykle od 26 do 46. Ważniejsze od liczby jest to, czy każdy interpretowany czynnik ma kilka osób definiujących.
Dlaczego w badaniu Q koreluje się osoby, a nie pozycje?
W zwykłej analizie czynnikowej korelujesz pozycje kwestionariusza i szukasz wymiarów, na które się rozkładają. W metodologii Q korelujesz całe ułożenia kart przez różne osoby, więc czynnik to grupa osób o podobnej perspektywie. Wynikiem jest tablica czynnikowa, czyli ułożenie stwierdzeń przez typową osobę z czynnika, a nie wyniki osób na skali.
Jak wybrać liczbę czynników w metodologii Q?
Połącz kilka kryteriów: analizę równoległą z losowymi sortowaniami o tym samym rozkładzie, wartości własne, liczbę osób definiujących i wstępną interpretację. Czynnik bez osób definiujących nie da tablicy czynnikowej, a czynnik powtarzający inną perspektywę lepiej połączyć. Decyzję i kryteria opisz w artykule.
Co to są osoby definiujące (flagging) w badaniu Q?
To sortowania najbardziej typowe dla czynnika, z których buduje się jego tablicę czynnikową. Automatycznie oznacza się sortowania z istotnie wysokim ładunkiem, np. powyżej 1.96/√N przy N stwierdzeniach, których kwadrat ładunku przewyższa sumę kwadratów pozostałych ładunków. Oznaczenia można potem zmieniać ręcznie, ale każdą zmianę trzeba opisać.
Czy rozkład w Q-sorcie musi być wymuszony?
Nie. Zabala i in. (2018) opisują rozkład wymuszony, w którym liczba miejsc w kolumnach jest stała, i niewymuszony, w którym może się różnić. Rozkład wymuszony ułatwia porównanie sortowań, bo wszystkie mają tę samą średnią i to samo odchylenie. Przy niewymuszonym pilnuj, by uczestnik nie zgrupował kart w kilku kolumnach.
Powiązane hasła
Przeczytaj też
Analiza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikBadania mieszane (mixed methods)
Trzy podstawowe schematy, cele łączenia metod, integracja na trzech poziomach, joint display i wzory opisu dla doktoratu, wniosku i artykułu.
Czytaj →PoradnikAnaliza tematyczna krok po kroku
Sześć faz według Braun i Clarke, podejście refleksyjne a książka kodowa, przykład kodowania „fragment → kod → temat”, typowe błędy i wzór opisu.
Czytaj →Planujesz badanie metodą Q i nie wiesz, jak przeprowadzić analizę?
Pomożemy zaplanować Q-set i siatkę, przeprowadzić analizę czynnikową osób, uzasadnić liczbę czynników i oznaczenia oraz opisać wyniki tak, żebyś mógł(a) samodzielnie obronić każdą decyzję przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Brown, S. R. (1980). Political subjectivity: Applications of Q methodology in political science. Yale University Press.
- Dziopa, F., & Ahern, K. (2011). A systematic literature review of the applications of Q-technique and its methodology. Methodology, 7(2), 39–55. https://doi.org/10.1027/1614-2241/a000021
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Kaiser, H. F. (1958). The varimax criterion for analytic rotation in factor analysis. Psychometrika, 23(3), 187–200. https://doi.org/10.1007/bf02289233
- Stephenson, W. (1935). Correlating persons instead of tests. Journal of Personality, 4(1), 17–24. https://doi.org/10.1111/j.1467-6494.1935.tb02022.x
- Watts, S., & Stenner, P. (2005). Doing Q methodology: Theory, method and interpretation. Qualitative Research in Psychology, 2(1), 67–91. https://doi.org/10.1191/1478088705qp022oa
- Watts, S., & Stenner, P. (2012). Doing Q methodological research: Theory, method and interpretation. SAGE Publications. https://doi.org/10.4135/9781446251911
- Zabala, A. (2014). qmethod: A package to explore human perspectives using Q methodology. The R Journal, 6(2), 163–173. https://doi.org/10.32614/rj-2014-032 ● Otwarty dostęp
- Zabala, A., & Pascual, U. (2016). Bootstrapping Q methodology to improve the understanding of human perspectives. PLOS ONE, 11(2), Article e0148087. https://doi.org/10.1371/journal.pone.0148087 ● Otwarty dostęp
- Zabala, A., Sandbrook, C., & Mukherjee, N. (2018). When and how to use Q methodology to understand perspectives in conservation research. Conservation Biology, 32(5), 1185–1194. https://doi.org/10.1111/cobi.13123 ● Otwarty dostęp
Cytowania BibTeX
@book{brown1980political, author={Brown, Steven R.}, title={{Political subjectivity: Applications of Q methodology in political science}}, year={1980}, publisher={Yale University Press}, url={https://openlibrary.org/works/OL4446808W}}@article{dziopa2011systematic, author={Dziopa, Fiona and Ahern, Kathy}, title={{A systematic literature review of the applications of Q-technique and its methodology}}, journal={Methodology}, year={2011}, volume={7}, number={2}, pages={39--55}, doi={10.1027/1614-2241/a000021}}@article{horn1965rationale, author={Horn, John L.}, title={{A rationale and test for the number of factors in factor analysis}}, journal={Psychometrika}, year={1965}, volume={30}, number={2}, pages={179--185}, doi={10.1007/bf02289447}}@article{kaiser1958varimax, author={Kaiser, Henry F.}, title={{The varimax criterion for analytic rotation in factor analysis}}, journal={Psychometrika}, year={1958}, volume={23}, number={3}, pages={187--200}, doi={10.1007/bf02289233}}@article{stephenson1935correlating, author={Stephenson, William}, title={{Correlating persons instead of tests}}, journal={Journal of Personality}, year={1935}, volume={4}, number={1}, pages={17--24}, doi={10.1111/j.1467-6494.1935.tb02022.x}}@article{watts2005doing, author={Watts, Simon and Stenner, Paul}, title={{Doing Q methodology: Theory, method and interpretation}}, journal={Qualitative Research in Psychology}, year={2005}, volume={2}, number={1}, pages={67--91}, doi={10.1191/1478088705qp022oa}}@book{watts2012doing, author={Watts, Simon and Stenner, Paul}, title={{Doing Q methodological research: Theory, method and interpretation}}, year={2012}, publisher={SAGE Publications}, doi={10.4135/9781446251911}}@article{zabala2014qmethod, author={Zabala, Aiora}, title={{qmethod: A package to explore human perspectives using Q methodology}}, journal={The R Journal}, year={2014}, volume={6}, number={2}, pages={163--173}, doi={10.32614/rj-2014-032}}@article{zabala2016bootstrapping, author={Zabala, Aiora and Pascual, Unai}, title={{Bootstrapping Q methodology to improve the understanding of human perspectives}}, journal={PLOS ONE}, year={2016}, volume={11}, number={2}, eid={e0148087}, doi={10.1371/journal.pone.0148087}}@article{zabala2018when, author={Zabala, Aiora and Sandbrook, Chris and Mukherjee, Nibedita}, title={{When and how to use Q methodology to understand perspectives in conservation research}}, journal={Conservation Biology}, year={2018}, volume={32}, number={5}, pages={1185--1194}, doi={10.1111/cobi.13123}}