Kim byli Samuel Shapiro i Martin Wilk?
Martin Bradbury Wilk (1922–2013) urodził się w Montrealu i zaczynał jako inżynier chemik: po studiach w McGill (1945) przez pięć lat pracował w kanadyjskim projekcie atomowym National Research Council. Statystyki uczył się w Iowa State (magisterium 1953, doktorat 1955), a po rocznym stażu u Johna Tukeya w Princeton spędził 14 lat w Bell Laboratories (1956–1969), w latach 1959–1963 łącząc tę pracę z profesurą w Rutgers (Genest i Brackstone, 2010). Promotorem jego doktoratu był Oscar Kempthorne (Brillinger i Gentleman, b.d.). Od 1970 r. pracował w kierownictwie AT&T, a w 1980 r. wrócił do Kanady jako główny statystyk kraju – pierwszy zawodowy statystyk na tym stanowisku.
Samuel S. Shapiro był studentem na zajęciach Wilka w Rutgers; Wilk zgodził się prowadzić jego rozprawę i współpraca trwała jeszcze kilka lat (Genest i Brackstone, 2010). Shapiro jest pierwszym autorem pracy o teście W (Shapiro i Wilk, 1965), dużego porównania testów normalności (Shapiro i in., 1968) i uproszczonej wersji testu dla dużych prób (Shapiro i Francia, 1972). Cytowane źródła nie podają dat jego życia, dlatego ich tu nie wpisujemy.
Najważniejsze pomysły
- Test W (1965). W artykule „An analysis of variance test for normality (complete samples)” w Biometrice Shapiro i Wilk (1965) zaproponowali test Shapiro–Wilka: statystyka W porównuje uporządkowane wyniki próby z wartościami oczekiwanymi przy rozkładzie normalnym. Im bliżej 1, tym lepsza zgodność.
- Porównanie testów (1968). Shapiro, Wilk i Chen (1968) sprawdzili symulacyjnie dziewięć procedur na 45 rozkładach alternatywnych. W okazała się ogólnie najczulsza, a testy odległości – m.in. Kołmogorowa–Smirnowa i Cramera–von Misesa – zwykle mało czułe. To od tej pracy test W ma opinię testu o dużej mocy.
- W′ dla dużych prób (1972). Oryginalne współczynniki W podano dla prób do 50 obserwacji. Shapiro i Francia (1972) zastąpili je współczynnikami opartymi tylko na oczekiwanych kwantylach rozkładu normalnego; W′ to w praktyce kwadrat korelacji punktów na wykresie Q–Q.
- Wykresy prawdopodobieństwa (1968). Wilk i Gnanadesikan (1968) opisali wykresy kwantyl–kwantyl i procent–procent do porównywania próby z rozkładem teoretycznym oraz prób między sobą.
Sam Wilk opowiadał, że pomysł testu był jego, ale to Shapiro rozwinął go o porównania mocy i przybliżenia rozkładu statystyki, którą konsekwentnie nazywał W (Genest i Brackstone, 2010).
Ciekawostka
Najbardziej dramatyczny rozdział kariery Wilka nie dotyczył testów, tylko spisu powszechnego. Jak opowiadał w wywiadzie (Genest i Brackstone, 2010), gdy nowy rząd Kanady szukał w 1984 r. oszczędności, minister odpowiedzialny za urząd statystyczny bez konsultacji z Wilkiem zgłosił odwołanie spisu z 1986 r. Wilk powołał wewnętrzny zespół, który sprawdzał, co trzeba zrobić, gdyby spis jednak miał się odbyć, i zachęcił instytucje korzystające z danych, by same powiedziały, co straciłyby bez spisu. Okazało się też, że prawo wymagało spisu w 1986 r. w prowincjach preriowych.
Spis przywrócono, ale urząd miał w zamian zaoszczędzić 100 mln dolarów – według Wilka może nawet jedną trzecią budżetu. Część kwoty zaliczono z wcześniejszych oszczędności, a resztę złożono z cięć własnych urzędu, wpłat resortów zainteresowanych spisem i kredytu na zatrudnienie studentów do prac spisowych. Wilk przyznał, że z nerwów się rozchorował, a po przywróceniu spisu uznał, że to dobry moment na odejście; zrezygnował ze stanowiska w styczniu 1986 r. (Brillinger i Gentleman, b.d.).
Przykład na historycznych danych
Zbiór morley z pakietu datasets to – według pliku pomocy – pomiary prędkości światła wykonane przez Michelsona w 1879 r.: pięć eksperymentów po 20 kolejnych przebiegów, zapisanych w km/s po odjęciu 299 000.
Wszystkie 100 pomiarów razem (M = 852.40, SD = 79.01) daje W = 0.988, p = .51, a W′ – kwadrat korelacji punktów wykresu Q–Q – wynosi 0.987. Test nie ma podstaw do odrzucenia normalności. Osobno wygląda to inaczej: średnie eksperymentów wahają się od 820.5 do 909.0 (ANOVA: F(4, 95) = 4.29, p = .003), a w eksperymencie 3 W = 0.837, p = .003. W pozostałych czterech W mieści się między 0.920 a 0.961, przy p od .099 do .567.
Wniosek: normalność „całej zmiennej” to inne pytanie niż normalność w grupach albo reszt modelu (zob. ANOVA). Uwaga też na zaokrąglenia: wszystkie wyniki są wielokrotnościami 10 i jest tylko 30 różnych wartości, a remisy obniżają W.
Na rysunku
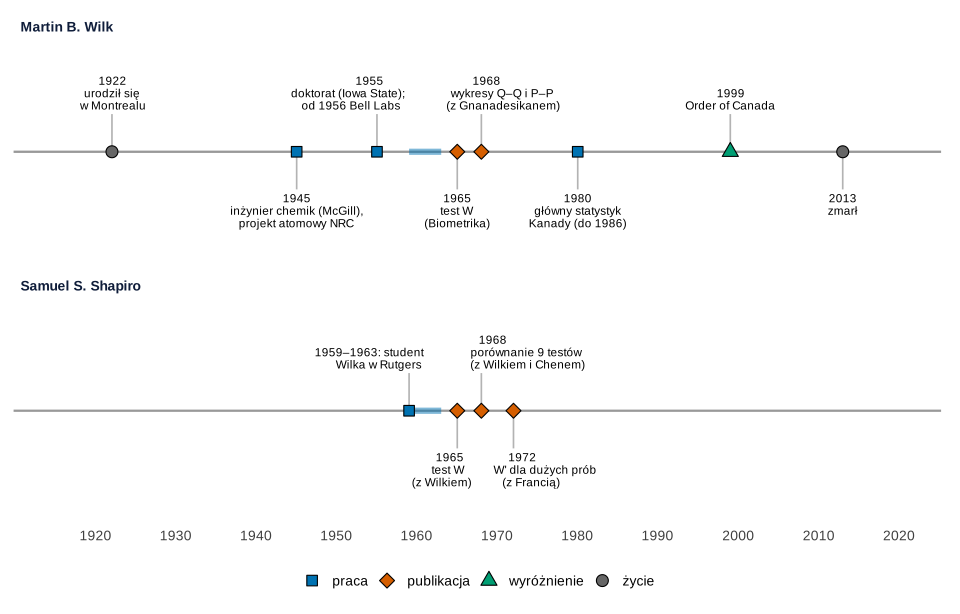
Co widać. Wszystkie prace o teście W powstały w czasie, gdy Wilk był w Bell Labs, a Shapiro – najpierw jego studentem w Rutgers. Potem Wilk przechodzi do zarządzania, a Shapiro dalej rozwija test (1972).
Na co uważać. Pas Shapiro jest krótki, bo cytowane źródła mówią o nim prawie wyłącznie przez wspólne publikacje; nie dopisujemy dat ani miejsc pracy, których w nich nie ma.
Podpis do pracy:
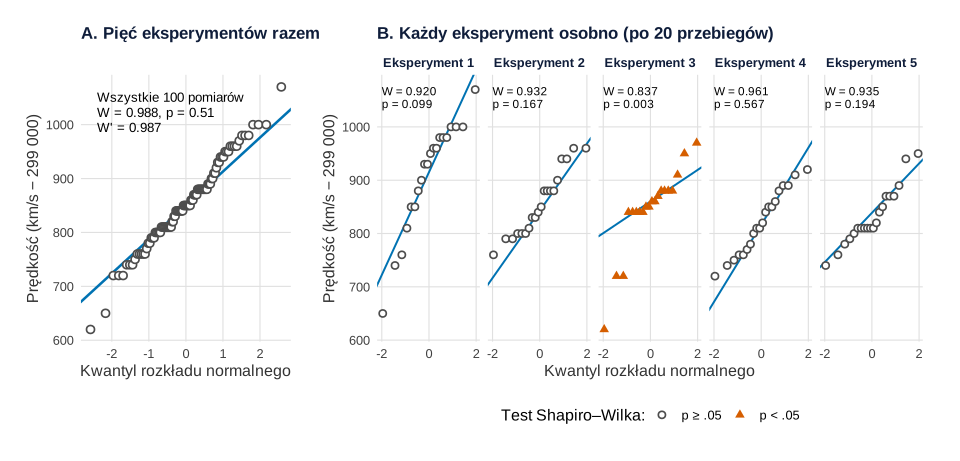
datasets::morley): wykres Q–Q dla wszystkich pomiarów (A) i dla każdego eksperymentu (B). Obliczenia i rysunek: R, pakiety ggplot2 i patchwork (dane historyczne, bez losowania).Co widać. W panelu A punkty układają się wzdłuż prostej i test nie widzi problemu. Panel B pokazuje, że prosta „całości” powstała z pięciu prób o różnych położeniach, a w eksperymencie 3 trzy najniższe pomiary odstają od reszty – tylko tam W spada wyraźnie poniżej pozostałych.
Na co uważać. Przy 20 obserwacjach test ma małą moc, więc p > .05 w eksperymentach 1, 2, 4 i 5 nie dowodzi normalności. Schodki na wykresach to skutek zaokrąglenia do 10 km/s, nie cecha zjawiska.
Podpis do pracy:
Gdzie spotkasz Shapiro i Wilka w swojej pracy
Najczęściej przy sprawdzaniu założeń testu t, ANOVA czy regresji liniowej – wiele programów podaje test Shapiro–Wilka domyślnie. Na co zwracać uwagę:
- sprawdzaj normalność w każdej grupie albo reszt modelu, nie całej zmiennej – przykład Michelsona pokazuje dlaczego; więcej we wpisie Normalność reszt czy zmiennych?;
- raportuj statystykę i p, np. W = 0.837, p = .003, i zawsze dołącz wykres Q–Q – kroki zebrano we wpisie Jak sprawdzić normalność rozkładu;
- przy bardzo dużych próbach test odrzuca normalność z powodu drobnych odchyleń; wtedy liczy się kształt wykresu i odporność metody, a przy ciężkich ogonach pomocny bywa też test Andersona–Darlinga.
Spory, mity i trudne strony
- Wilk to nie Wilks. Genest i Brackstone (2010) zauważają, że wiele osób myli Martina Wilka z Samuelem Wilksem, od którego pochodzi lambda Wilksa. To dwie różne osoby; Wilk żartował, że on sam nigdy nie miał z tym problemu.
- Twórca testu o testach. Wilk nie uważał testu W za wielkie osiągnięcie: mówił, że testy istotności to zajęcie na czas, zanim wymyśli się coś sensownego (Genest i Brackstone, 2010).
- „Najlepszy test normalności”. Przewaga W w badaniu z 1968 r. dotyczyła zestawu rozkładów i liczebności z tamtej symulacji (Shapiro i in., 1968). Żaden test nie jest najlepszy wobec każdego odchylenia, a test Kołmogorowa z parametrami oszacowanymi z próby wymaga poprawki – to test Lillieforsa.
Test Shapiro–Wilka na danych Michelsona w R
Kod wczytuje pomiary prędkości światła z pakietu datasets, liczy test Shapiro–Wilka i W′ dla wszystkich pomiarów i dla każdego eksperymentu, porównuje średnie eksperymentów (ANOVA) i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Test W i wykresy Q–Q na danych morley: rysunek 2
Kod R rysunku 2
# Shapiro i Wilk: test W na pomiarach prędkości światła Michelsona z 1879 r. (datasets::morley)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(linia = "#0072B2", wyroznienie = "#D55E00", dane = "grey30")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(morley, package = "datasets")
# Speed – pomiar prędkości światła (km/s minus 299 000); Expt – numer eksperymentu (1–5); Run – przebieg (1–20)
v <- morley$Speed
round(c(n = length(v), M = mean(v), SD = sd(v), rozne_wartosci = length(unique(v)),
        wielokrotnosci_10 = sum(v %% 10 == 0)), 2)

# 1. Test Shapiro–Wilka dla wszystkich 100 pomiarów
sw <- shapiro.test(v)
round(c(W = unname(sw$statistic), p = sw$p.value), 4)
# W' (Shapiro i Francia, 1972): kwadrat korelacji uporządkowanych wyników z kwantylami normalnymi,
# czyli „jak prosty jest wykres Q–Q”
r2_qq <- function(z) cor(sort(z), qnorm(ppoints(length(z))))^2
round(c(W_prim = r2_qq(v)), 4)

# 2. To samo osobno dla każdego z pięciu eksperymentów (po 20 przebiegów)
po_eksp <- t(sapply(split(v, morley$Expt), function(z) {
  s <- shapiro.test(z)
  c(n = length(z), M = mean(z), SD = sd(z), W = unname(s$statistic), p = s$p.value, W_prim = r2_qq(z))
}))
round(po_eksp, 3)
# Różnica średnich eksperymentów: ANOVA jednoczynnikowa
summary(aov(Speed ~ factor(Expt), data = morley))

# Dane do wykresów Q–Q: wynik uporządkowany vs kwantyl rozkładu normalnego
qq_dane <- function(z) data.frame(kwantyl = qnorm(ppoints(length(z))), wynik = sort(z))
linia_kwartyli <- function(z) {                       # prosta przez 1. i 3. kwartyl (jak qqline)
  y <- quantile(z, c(.25, .75)); x <- qnorm(c(.25, .75))
  b <- diff(y) / diff(x); c(a = unname(y[1] - b * x[1]), b = unname(b))
}
lA <- linia_kwartyli(v)
pA <- ggplot(qq_dane(v), aes(kwantyl, wynik)) +
  geom_abline(intercept = lA[["a"]], slope = lA[["b"]], colour = kol[["linia"]], linewidth = 0.9) +
  geom_point(shape = 21, fill = "white", colour = kol[["dane"]], size = 2.2, stroke = 0.9) +
  annotate("text", x = -2.4, y = 1060, hjust = 0, vjust = 1, size = 3.5, lineheight = 0.95,
           label = sprintf("Wszystkie 100 pomiarów\nW = %.3f, p = %.2f\nW' = %.3f", sw$statistic, sw$p.value, r2_qq(v))) +
  labs(title = "A. Pięć eksperymentów razem", x = "Kwantyl rozkładu normalnego", y = "Prędkość (km/s − 299 000)") +
  motyw

eksp <- do.call(rbind, lapply(split(v, morley$Expt), qq_dane))
eksp$Expt <- rep(names(split(v, morley$Expt)), each = 20)
linie <- do.call(rbind, lapply(split(v, morley$Expt), function(z) as.data.frame(t(linia_kwartyli(z)))))
linie$Expt <- rownames(linie)
etykiety <- data.frame(Expt = rownames(po_eksp),
                       opis = sprintf("W = %.3f\np = %.3f", po_eksp[, "W"], po_eksp[, "p"]),
                       ponizej = po_eksp[, "p"] < .05)
eksp$ponizej <- etykiety$ponizej[match(eksp$Expt, etykiety$Expt)]
pB <- ggplot(eksp, aes(kwantyl, wynik)) +
  geom_abline(data = linie, aes(intercept = a, slope = b), colour = kol[["linia"]], linewidth = 0.7) +
  geom_point(aes(shape = ponizej, colour = ponizej), size = 1.9, stroke = 0.9, fill = "white") +
  geom_text(data = etykiety, aes(x = -2, y = 1075, label = opis), hjust = 0, vjust = 1, size = 3.1, lineheight = 0.9) +
  facet_wrap(~ Expt, nrow = 1, labeller = labeller(Expt = function(e) paste("Eksperyment", e))) +
  scale_shape_manual(values = c(`FALSE` = 21, `TRUE` = 17), labels = c("p ≥ .05", "p < .05"), name = "Test Shapiro–Wilka:") +
  scale_colour_manual(values = c(`FALSE` = kol[["dane"]], `TRUE` = kol[["wyroznienie"]]), labels = c("p ≥ .05", "p < .05"),
                      name = "Test Shapiro–Wilka:") +
  scale_x_continuous(breaks = c(-2, 0, 2)) +
  labs(title = "B. Każdy eksperyment osobno (po 20 przebiegów)", x = "Kwantyl rozkładu normalnego", y = "Prędkość (km/s − 299 000)") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 2.6))
p2
Wynik w R
                n                 M                SD    rozne_wartosci
           100.00            852.40             79.01             30.00
wielokrotnosci_10
           100.00
     W      p
0.9881 0.5137
W_prim
0.9866
   n     M      SD     W     p W_prim
1 20 909.0 104.926 0.920 0.099  0.918
2 20 856.0  61.164 0.932 0.167  0.942
3 20 845.0  79.107 0.837 0.003  0.826
4 20 820.5  60.042 0.961 0.567  0.972
5 20 831.5  54.219 0.935 0.194  0.935
             Df Sum Sq Mean Sq F value  Pr(>F)
factor(Expt)  4  94514   23628   4.288 0.00311 **
Residuals    95 523510    5511
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Martin B. Wilk (1922–2013) i Samuel S. Shapiro – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1922, 1945, 1955, 1965, 1968, 1980, 1999, 2013,
          1959, 1965, 1968, 1972),
  osoba = c(rep("Martin B. Wilk", 8), rep("Samuel S. Shapiro", 4)),
  opis = c("urodził się\nw Montrealu", "inżynier chemik (McGill),\nprojekt atomowy NRC",
           "doktorat (Iowa State);\nod 1956 Bell Labs",
           "test W\n(Biometrika)", "wykresy Q–Q i P–P\n(z Gnanadesikanem)",
           "główny statystyk\nKanady (do 1986)", "Order of Canada", "zmarł",
           "1959–1963: student\nWilka w Rutgers", "test W\n(z Wilkiem)", "porównanie 9 testów\n(z Wilkiem i Chenem)",
           "W' dla dużych prób\n(z Francią)"),
  rodzaj = c("życie", "praca", "praca", "publikacja", "publikacja", "praca", "wyróżnienie", "życie",
             "praca", "publikacja", "publikacja", "publikacja"),
  strona = c(1, -1, 1, -1, 1, -1, 1, -1,
             1, -1, 1, -1),
  wyrownanie = c(0.5, 0.5, 0.75, 0.5, 0.3, 0.5, 0.5, 0.5,
                 0.85, 0.75, 0.1, 0.2))   # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- ifelse(zdarzenia$rok == 1959 & zdarzenia$osoba == "Samuel S. Shapiro",
                             zdarzenia$opis, paste0(zdarzenia$rok, "\n", zdarzenia$opis))
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("Martin B. Wilk", "Samuel S. Shapiro"))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  annotate("segment", x = 1959, xend = 1963, y = 0, yend = 0, linewidth = 2.2, colour = "#0072B2", alpha = 0.5) +   # Rutgers 1959–1963
  geom_segment(aes(xend = rok, y = 0, yend = 0.5 * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = 0.56 * strona, label = etykieta, vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1915, 2020), breaks = seq(1920, 2020, by = 10)) +
  scale_y_continuous(limits = c(-1.35, 1.35)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test Shapiro–Wilka – funkcja shapiro.test(), ANOVA – aov() z pakietu stats; dane – pakiet datasets; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim byli Samuel Shapiro i Martin Wilk?
Autorami testu normalności W z 1965 r. Martin B. Wilk (1922–2013) był kanadyjskim statystykiem: pracował w Bell Labs i Rutgers, potem w AT&T, a w latach 1980–1986 był głównym statystykiem Kanady. Samuel S. Shapiro był jego studentem w Rutgers i doktorantem; to on rozwinął test w kolejnych pracach (1968, 1972).
Dlaczego test Shapiro–Wilka uchodzi za mocny test normalności?
Bo w porównaniu symulacyjnym Shapiro, Wilka i Chena (1968) – dziewięć procedur, 45 rozkładów alternatywnych – statystyka W okazała się ogólnie najczulszą miarą nienormalności, a testy odległości, jak Kołmogorowa–Smirnowa, zwykle mało czułe. Ta przewaga dotyczy jednak zestawu rozkładów z tamtej symulacji.
Czy Wilk z testu Shapiro–Wilka to ten sam Wilks co w lambdzie Wilksa?
Nie. Test normalności pochodzi od Martina B. Wilka, a lambda Wilksa (MANOVA) od Samuela S. Wilksa. Genest i Brackstone (2010) zwracają uwagę, że te dwie osoby są często mylone.
Skąd się wzięły wykresy Q–Q i P–P?
Wilk i Gnanadesikan (1968) opisali w Biometrice wykresy kwantyl–kwantyl i procent–procent jako metody porównywania próby z rozkładem teoretycznym oraz prób między sobą. Wilk wspominał, że właściwości statystyk porządkowych służyły im zarówno do budowy wykresów Q–Q, jak i testów zgodności.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikNormalność reszt czy zmiennych?
Dlaczego w regresji i ANOVA sprawdzasz reszty, a nie surową zmienną: przykład w R z dwugarbnym rozkładem, wykres Q-Q reszt i wpływ liczebności próby.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Brillinger, D. R., & Gentleman, J. F. (b.d.). Martin Bradbury Wilk, Honorary Member 1988 (1922–2013). Statistical Society of Canada. Pobrano 18 listopada 2026 z https://ssc.ca/en/node/6635 ● Otwarty dostęp
- Genest, C., & Brackstone, G. (2010). A conversation with Martin Bradbury Wilk. Statistical Science, 25(2), 258–273. https://doi.org/10.1214/08-sts272 ● Otwarty dostęp
- Shapiro, S. S., & Francia, R. S. (1972). An approximate analysis of variance test for normality. Journal of the American Statistical Association, 67(337), 215–216. https://doi.org/10.1080/01621459.1972.10481232
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3-4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Shapiro, S. S., Wilk, M. B., & Chen, H. J. (1968). A comparative study of various tests for normality. Journal of the American Statistical Association, 63(324), 1343–1372. https://doi.org/10.1080/01621459.1968.10480932
- Wilk, M. B., & Gnanadesikan, R. (1968). Probability plotting methods for the analysis of data. Biometrika, 55(1), 1–17. https://doi.org/10.1093/biomet/55.1.1
Cytowania BibTeX
@misc{brillingerndwilk, author={Brillinger, David R. and Gentleman, Jane F.}, title={{Martin Bradbury Wilk, Honorary Member 1988 (1922–2013)}}, howpublished={Statistical Society of Canada}, url={https://ssc.ca/en/node/6635}}@article{genest2010conversation, author={Genest, Christian and Brackstone, Gordon}, title={{A conversation with Martin Bradbury Wilk}}, journal={Statistical Science}, year={2010}, volume={25}, number={2}, pages={258--273}, doi={10.1214/08-sts272}}@article{shapiro1972approximate, author={Shapiro, S. S. and Francia, R. S.}, title={{An approximate analysis of variance test for normality}}, journal={Journal of the American Statistical Association}, year={1972}, volume={67}, number={337}, pages={215--216}, doi={10.1080/01621459.1972.10481232}}@article{shapiro1965analysis, author={Shapiro, S. S. and Wilk, M. B.}, title={{An analysis of variance test for normality (complete samples)}}, journal={Biometrika}, year={1965}, volume={52}, number={3-4}, pages={591--611}, doi={10.1093/biomet/52.3-4.591}}@article{shapiro1968comparative, author={Shapiro, S. S. and Wilk, M. B. and Chen, H. J.}, title={{A comparative study of various tests for normality}}, journal={Journal of the American Statistical Association}, year={1968}, volume={63}, number={324}, pages={1343--1372}, doi={10.1080/01621459.1968.10480932}}@article{wilk1968probability, author={Wilk, M. B. and Gnanadesikan, R.}, title={{Probability plotting methods for the analysis of data}}, journal={Biometrika}, year={1968}, volume={55}, number={1}, pages={1--17}, doi={10.1093/biomet/55.1.1}}