Kim jest Peter M. Bentler?
Peter M. Bentler jest profesorem psychologii i statystyki na Uniwersytecie Kalifornijskim w Los Angeles (UCLA). Zaczynał nie od matematyki, lecz od kliniki: doktorat z psychologii klinicznej uzyskał w 1964 r. na Stanford University. W 1982 r. był prezesem Psychometric Society. Jego zainteresowania badawcze obejmują osobowość i nadużywanie substancji, ale najszerzej znany jest z prac o metodach i zastosowaniach modelowania przyczynowego, czyli modelowania równań strukturalnych (SEM) (Wijsen, 2023).
W 2014 r. Psychometric Society przyznało mu nagrodę za całokształt kariery – wyróżnienie dla osób, których dorobek miał szeroki wpływ na psychometrię (Psychometric Society, b.d.). Na tej samej liście laureatów są m.in. Karl G. Jöreskog (2008) i Kenneth A. Bollen (2018).
Najważniejsze pomysły
- Model zerowy jako punkt odniesienia (1980). Bentler i Bonett (1980) zauważyli, że test chi-kwadrat porównujący model z modelem bez ograniczeń nie wystarcza: w dużych próbach odrzuca niemal każdy model, a w małych przepuszcza wiele konkurencyjnych. Zaproponowali, by porównywać model także z modelem zerowym, w którym wszystkie zmienne są nieskorelowane, i podali indeks normowany NFI oraz nienormowany NNFI – ten drugi znamy dziś zwykle jako TLI.
- CFI (1990). W „Psychological Bulletin” Bentler (1990) opisał porównawczy indeks dopasowania CFI. Mierzy on, o ile model zmniejsza niecentralność rozkładu chi-kwadrat względem modelu zerowego, i nie zaniża dopasowania w małych próbach, jak robi to NFI. Bentler wskazał też, że w dużych próbach CFI, NFI i indeks Bollena mierzą to samo.
- Poprawka Satorry–Bentlera. Z A. Satorrą zaproponował w 1994 r. rodzinę poprawek skalujących statystykę chi-kwadrat w małych próbach, dużych modelach i przy danych nienormalnych; w 2001 r. podali prosty sposób skalowania testu różnicy dwóch modeli zagnieżdżonych (Satorra i Bentler, 2001). Opisujemy to w hasłach skalowany chi-kwadrat Satorry–Bentlera i test różnicy chi-kwadrat.
Ciekawostka
Artykuł o dopasowaniu modeli trafił do grona najczęściej cytowanych prac czasopisma psychologicznego. W 1992 r. Bentler opisał na łamach „Psychological Bulletin”, że 7 z 10 najczęściej cytowanych artykułów tego pisma dotyczy metodologii – a jednym z nich jest jego praca z Bonettem z 1980 r. o ocenie dopasowania modeli struktur kowariancji (Bentler, 1992).
Zamiast poprzestać na liczbach, przedstawił kontekst popularności tego tekstu i przeprowadził własną analizę cytowań artykułów metodologicznych publikowanych w „Bulletin” od 1978 r. Wniosek: prace o planowaniu badań, pomiarze i statystyce pozostają dla psychologów ważne, a czasopismo powinno pomagać udostępniać im nowe metody.
Przykład na prawdziwych danych
Zbiór Thurstone.33 z pakietu psych to – według pliku pomocy – macierz korelacji dziewięciu testów zdolności (m.in. definicje, zadania arytmetyczne, antonimy, szeregi liczbowe, czytanie ze zrozumieniem) u 4175 studentów, opublikowana przez C. Brighama w 1932 r. i przypisywana L. L. Thurstone’owi. Dopasowaliśmy trzy modele CFA: M1 z jednym czynnikiem, M2 z czynnikiem werbalnym (siedem testów) i liczbowym (dwa testy) oraz M3 – M2 z kowariancją reszt antonimów i czytania, dopisaną po fakcie, bo oba testy opierają się na słownictwie.
Indeksy ręcznie. Model zerowy ma χ²(36) = 20249.16. M1: χ²(27) = 2398.20, NFI = .882, TLI = .844, CFI = .883. M2: χ²(26) = 1547.40, NFI = .924, TLI = .896, CFI = .925. M3: χ²(25) = 921.27, NFI = .955, TLI = .936, CFI = .956. Wartości liczone wzorami Bentlera i Boneta (1980) oraz Bentlera (1990) zgadzają się co do trzeciego miejsca z fitMeasures() z lavaan. Każdy model test chi-kwadrat odrzuca (p < .001), a CFI modelu M3 przekracza często stosowany próg .95.
Rola liczebności. Gdy tę samą macierz korelacji potraktujemy tak, jakby pochodziła z mniejszej próby, chi-kwadrat modelu M3 maleje proporcjonalnie do N: przy N = 100 wynosi 22.1 (p = .632, CFI = 1.000), przy N = 200 – 44.1 (p = .011, CFI = .980), przy N = 400 – 88.3 (p < .001, CFI = .967). Od kilkuset osób CFI prawie się nie zmienia, a wartość p spada do zera – dokładnie problem, od którego zaczynali Bentler i Bonett.
Na rysunku
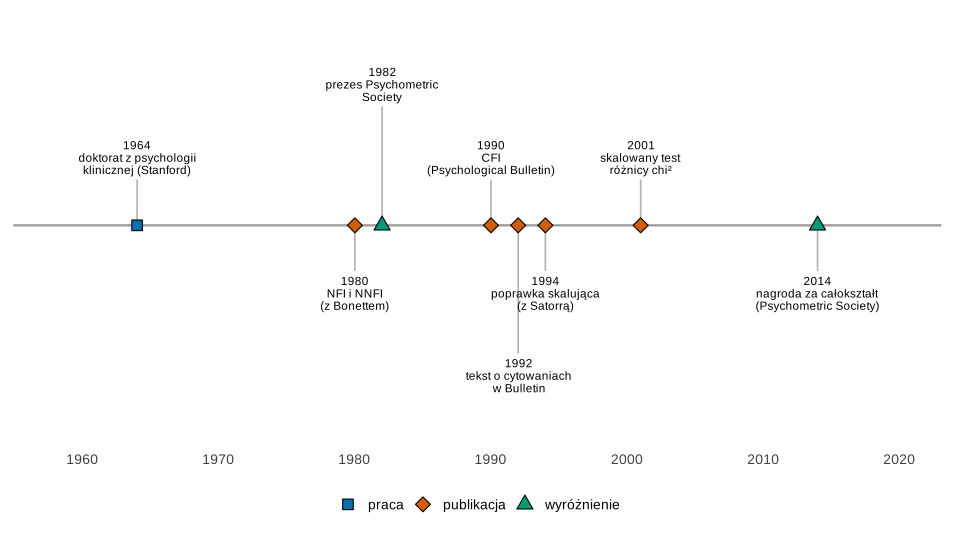
Co widać. Najważniejsze prace o dopasowaniu modeli powstały w ciągu dwudziestu lat – od 1980 do 2001 r.
Na co uważać. Na osi nie ma roku urodzenia ani początku pracy na UCLA – cytowane źródła ich nie podają.
Podpis do pracy:
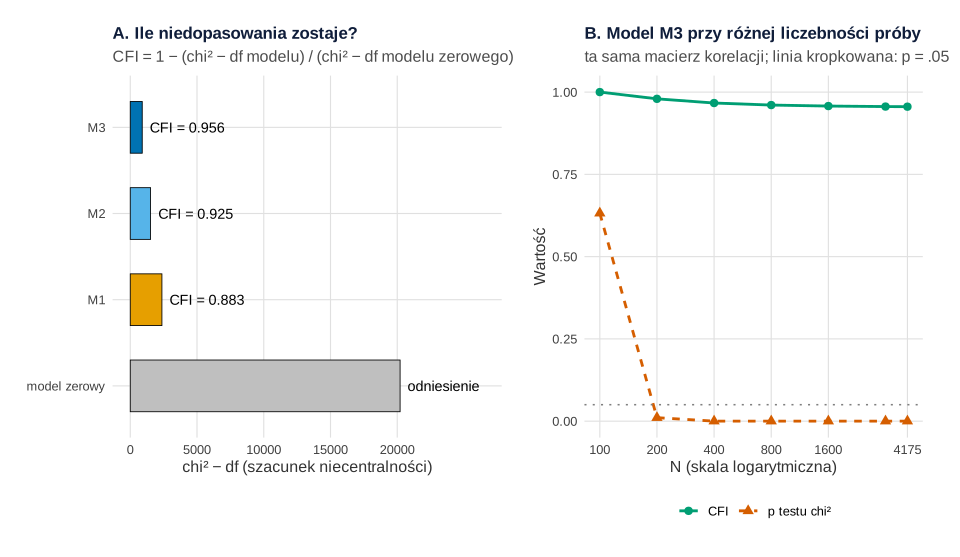
psych::Thurstone.33, N = 4175): niecentralność trzech modeli CFA na tle modelu zerowego (A) oraz CFI i wartość p testu chi-kwadrat modelu M3 przy różnej przyjętej liczebności próby (B). Obliczenia i rysunek: R, pakiety lavaan, ggplot2 i patchwork.Co widać. W panelu A CFI to jeden minus stosunek długości słupka modelu do długości słupka modelu zerowego: nawet słupek M1 jest krótki względem niedopasowania modelu bez korelacji. W panelu B wartość p spada do zera już przy kilkuset osobach, a CFI zmienia się w trzecim miejscu po przecinku.
Na co uważać. Panel B nie pokazuje nowych prób – to ta sama macierz korelacji z inną deklarowaną liczebnością. Wysoki CFI nie oznacza też, że model M3 jest prawdziwy: kowariancję reszt dopisano po obejrzeniu danych.
Podpis do pracy:
Gdzie spotkasz Bentlera w swojej pracy
Prawie w każdej pracy z CFA lub SEM:
- w tabeli dopasowania – CFI i TLI stoją tam obok chi-kwadrat, RMSEA (od Jamesa Steigera) i SRMR; wzór tabeli znajdziesz w haśle tabela dopasowania modelu CFA w APA;
- przy odpowiedziach na skalach porządkowych lub skośnych rozkładach – estymator MLM w lavaan to właśnie poprawka Satorry–Bentlera, a przy brakach danych jej odpowiednikiem jest MLR;
- gdy recenzent pyta, dlaczego model „nie przeszedł” testu chi-kwadrat przy dużej próbie – odpowiedzią jest argument Bentlera i Boneta (1980), poparty indeksami porównawczymi, ale nie zastępujący oceny reszt (zob. poradnik CB-SEM w R).
Spory, mity i trudne strony
- Progi to nie prawa natury. Granice typu „CFI ≥ .95” traktuje się często jak zero-jedynkowy test. W przykładzie model M3 przekracza .95, choć ma dopisaną po fakcie kowariancję reszt, a model M2 o sensownej teorii – nie.
- CFI zależy od modelu zerowego. Indeks porównuje model z modelem nieskorelowanych zmiennych. Gdy zmienne korelują słabo, model zerowy jest „mało zły” i CFI wychodzi niski nawet przy małym niedopasowaniu; gdy korelują silnie – jak w danych Brighama – łatwo o wysoki CFI.
- NFI czy CFI? Sam Bentler (1990) uzasadniał CFI tym, że NFI zaniża dopasowanie w małych próbach; w dużych oba indeksy są bliskie, co widać w przykładzie (.955 i .956).
NFI, TLI i CFI w R
Kod wczytuje macierz korelacji z pakietu psych, dopasowuje trzy modele CFA w lavaan, liczy NFI, TLI i CFI ręcznie z chi-kwadrat modelu i modelu zerowego, porównuje je z fitMeasures(), a potem powtarza obliczenia dla modelu M3 przy różnych deklarowanych liczebnościach próby i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu. Kod nie losuje niczego, więc nie ma ziarna.
1. Indeksy dopasowania ręcznie: rysunek 2
Kod R rysunku 2
# Bentler: NFI, TLI (NNFI) i CFI policzone ręcznie z chi-kwadrat modelu i modelu zerowego
# Dane: psych::Thurstone.33 – korelacje 9 testów zdolności, 4175 studentów (dane C. Brighama z 1932 r.)
suppressPackageStartupMessages({library(lavaan); library(ggplot2); library(patchwork)})
kol <- c(M1 = "#E69F00", M2 = "#56B4E9", M3 = "#0072B2", chi = "#D55E00", cfi = "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(Thurstone.33, package = "psych")
R <- Thurstone.33
skroty <- c("DEF", "ARY", "KLA", "SZT", "ANT", "SZE", "ANA", "LOG", "CZY")
cbind(skrot = skroty, test = colnames(R))
dimnames(R) <- list(skroty, skroty)
N <- 4175

# Trzy modele CFA (M3 = M2 + kowariancja reszt antonimów i czytania – poprawka dopisana po fakcie)
modele <- list(
  M1 = "g =~ DEF + ARY + KLA + SZT + ANT + SZE + ANA + LOG + CZY",
  M2 = "werbalny =~ DEF + KLA + SZT + ANT + ANA + LOG + CZY
        liczbowy =~ ARY + SZE",
  M3 = "werbalny =~ DEF + KLA + SZT + ANT + ANA + LOG + CZY
        liczbowy =~ ARY + SZE
        ANT ~~ CZY")
dopasuj <- function(m, n) cfa(m, sample.cov = R, sample.nobs = n)
fity <- lapply(modele, dopasuj, n = N)

# Ręcznie: chi-kwadrat i df modelu (m) oraz modelu zerowego – niezależności (0)
indeksy <- function(f) {
  fm <- fitMeasures(f, c("chisq", "df", "baseline.chisq", "baseline.df"))
  chi_m <- fm[["chisq"]]; df_m <- fm[["df"]]; chi_0 <- fm[["baseline.chisq"]]; df_0 <- fm[["baseline.df"]]
  c(chi_m = chi_m, df_m = df_m, p = pchisq(chi_m, df_m, lower.tail = FALSE), chi_0 = chi_0, df_0 = df_0,
    NFI = (chi_0 - chi_m) / chi_0,                                              # Bentler i Bonett (1980)
    TLI = ((chi_0 / df_0) - (chi_m / df_m)) / ((chi_0 / df_0) - 1),             # NNFI w języku Bentlera i Boneta
    CFI = 1 - max(chi_m - df_m, 0) / max(chi_0 - df_0, chi_m - df_m, 0))        # Bentler (1990)
}
tab <- t(sapply(fity, indeksy))
round(tab, 3)
# kontrola: te same indeksy z lavaan
round(t(sapply(fity, fitMeasures, fit.measures = c("nfi", "tli", "cfi"))), 3)

# Ta sama macierz korelacji, ale udajemy, że pochodzi z mniejszej próby: chi-kwadrat rośnie z N, CFI prawie nie
proby <- c(100, 200, 400, 800, 1600, 3200, 4175)
wg_n <- do.call(rbind, lapply(proby, function(n) {
  x <- indeksy(dopasuj(modele$M3, n))
  data.frame(N = n, chi_m = x[["chi_m"]], p = x[["p"]], CFI = x[["CFI"]])
}))
wg_n$p <- signif(wg_n$p, 3)
transform(wg_n, chi_m = round(chi_m, 1), CFI = round(CFI, 3))

# Rysunek: A – chi-kwadrat minus df (niecentralność) modeli na tle modelu zerowego; B – p i CFI w funkcji N
nc <- data.frame(model = factor(c("model zerowy", rownames(tab)), levels = c("model zerowy", rownames(tab))),
                 nc = c(tab[1, "chi_0"] - tab[1, "df_0"], tab[, "chi_m"] - tab[, "df_m"]))
nc$etykieta <- c("odniesienie", sprintf("CFI = %.3f", tab[, "CFI"]))
pA <- ggplot(nc, aes(nc, model)) +
  geom_col(aes(fill = model), width = 0.6, colour = "black", linewidth = 0.3) +
  geom_text(aes(label = etykieta), hjust = -0.1, size = 3.8) +
  scale_fill_manual(values = c("grey75", unname(kol[c("M1", "M2", "M3")])), guide = "none") +
  scale_x_continuous(limits = c(0, 26500), breaks = seq(0, 20000, 5000)) +
  labs(title = "A. Ile niedopasowania zostaje?",
       subtitle = "CFI = 1 − (chi² − df modelu) / (chi² − df modelu zerowego)",
       x = "chi² − df (szacunek niecentralności)", y = NULL) +
  motyw
pB <- ggplot(wg_n, aes(N)) +
  geom_line(aes(y = CFI, colour = "CFI", linetype = "CFI"), linewidth = 1) +
  geom_point(aes(y = CFI, colour = "CFI", shape = "CFI"), size = 2.6) +
  geom_line(aes(y = pmin(p, 1), colour = "p testu chi²", linetype = "p testu chi²"), linewidth = 1) +
  geom_point(aes(y = pmin(p, 1), colour = "p testu chi²", shape = "p testu chi²"), size = 2.6) +
  geom_hline(yintercept = 0.05, colour = "grey50", linetype = "dotted") +
  scale_x_log10(breaks = c(100, 200, 400, 800, 1600, 4175)) +
  scale_colour_manual(values = c("CFI" = kol[["cfi"]], "p testu chi²" = kol[["chi"]]), name = NULL) +
  scale_linetype_manual(values = c("CFI" = "solid", "p testu chi²" = "22"), name = NULL) +
  scale_shape_manual(values = c("CFI" = 16, "p testu chi²" = 17), name = NULL) +
  labs(title = "B. Model M3 przy różnej liczebności próby",
       subtitle = "ta sama macierz korelacji; linia kropkowana: p = .05",
       x = "N (skala logarytmiczna)", y = "Wartość") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.15, 1))
p2
Wynik w R
      skrot test
 [1,] "DEF" "Definitions"
 [2,] "ARY" "Arithmetical_Problems"
 [3,] "KLA" "Classification"
 [4,] "SZT" "Artificial_Languange"
 [5,] "ANT" "Antonyms"
 [6,] "SZE" "Number_Series_Completion"
 [7,] "ANA" "Analogies"
 [8,] "LOG" "Logical_Inference"
 [9,] "CZY" "Paragraph_Reading"
      chi_m df_m p    chi_0 df_0   NFI   TLI   CFI
M1 2398.200   27 0 20249.16   36 0.882 0.844 0.883
M2 1547.403   26 0 20249.16   36 0.924 0.896 0.925
M3  921.267   25 0 20249.16   36 0.955 0.936 0.956
     nfi   tli   cfi
M1 0.882 0.844 0.883
M2 0.924 0.896 0.925
M3 0.955 0.936 0.956
     N chi_m         p   CFI
1  100  22.1  6.32e-01 1.000
2  200  44.1  1.05e-02 0.980
3  400  88.3  5.48e-09 0.967
4  800 176.5  9.27e-25 0.961
5 1600 353.1  1.16e-59 0.958
6 3200 706.1 7.02e-133 0.956
7 4175 921.3 2.84e-178 0.956
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Peter M. Bentler – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1964, 1980, 1982, 1990, 1992, 1994, 2001, 2014),
  opis = c("doktorat z psychologii\nklinicznej (Stanford)", "NFI i NNFI\n(z Bonettem)", "prezes Psychometric\nSociety",
           "CFI\n(Psychological Bulletin)", "tekst o cytowaniach\nw Bulletin", "poprawka skalująca\n(z Satorrą)",
           "skalowany test\nróżnicy chi²", "nagroda za całokształt\n(Psychometric Society)"),
  rodzaj = c("praca", "publikacja", "wyróżnienie", "publikacja", "publikacja", "publikacja", "publikacja", "wyróżnienie"),
  poziom = c(0.5, -0.5, 1.3, 0.5, -1.4, -0.5, 0.5, -0.5),                  # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty[-1], name = NULL) +
  scale_fill_manual(values = kolory[-1], name = NULL) +
  scale_x_continuous(limits = c(1958, 2020), breaks = seq(1960, 2020, by = 10)) +
  scale_y_continuous(limits = c(-2.2, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (modele CFA – pakiet lavaan; dane – pakiet psych; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest Peter Bentler?
To amerykański psycholog i statystyk, profesor psychologii i statystyki na UCLA. Doktorat z psychologii klinicznej zrobił na Stanford University w 1964 r., a w 1982 r. był prezesem Psychometric Society. Zajmuje się osobowością, nadużywaniem substancji i – przede wszystkim – metodami modelowania przyczynowego, czyli SEM (Wijsen, 2023).
Co Bentler wniósł do oceny dopasowania modeli SEM?
Razem z D. G. Bonettem (1980) zaproponował porównywanie modelu z modelem zerowym, w którym zmienne są nieskorelowane, oraz indeksy NFI i NNFI (dziś zwykle TLI). W 1990 r. opisał CFI, który mierzy względny spadek niecentralności i nie zaniża dopasowania w małych próbach tak jak NFI. Z A. Satorrą rozwinął też poprawkę skalującą chi-kwadrat dla danych nienormalnych.
Jak policzyć CFI ręcznie?
Potrzebujesz chi-kwadrat i df modelu oraz modelu zerowego: CFI = 1 − max(χ²_M − df_M, 0) / max(χ²_0 − df_0, χ²_M − df_M, 0). W przykładzie z hasła model z dwoma czynnikami i jedną kowariancją reszt ma χ²(25) = 921.27, model zerowy χ²(36) = 20249.16, więc CFI = .956 – tyle samo, ile podaje lavaan.
Dlaczego CFI i test chi-kwadrat dają różne wnioski?
Statystyka chi-kwadrat rośnie proporcjonalnie do liczebności próby, więc przy kilku tysiącach osób odrzuca prawie każdy model – na to zwracali uwagę już Bentler i Bonett (1980). CFI porównuje niedopasowanie modelu z niedopasowaniem modelu zerowego i przy dużych N zmienia się niewiele. W przykładzie ta sama macierz daje p = .63 przy N = 100 i p < .001 przy N = 200, a CFI spada tylko z 1.000 do .980.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikCB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bentler, P. M. (1990). Comparative fit indexes in structural models. Psychological Bulletin, 107(2), 238–246. https://doi.org/10.1037/0033-2909.107.2.238
- Bentler, P. M. (1992). On the fit of models to covariances and methodology to the Bulletin. Psychological Bulletin, 112(3), 400–404. https://doi.org/10.1037/0033-2909.112.3.400
- Bentler, P. M., & Bonett, D. G. (1980). Significance tests and goodness of fit in the analysis of covariance structures. Psychological Bulletin, 88(3), 588–606. https://doi.org/10.1037/0033-2909.88.3.588
- Psychometric Society. (b.d.). Career Award for Lifetime Achievement. Pobrano 22 listopada 2026 z https://www.psychometricsociety.org/career-award ● Otwarty dostęp
- Satorra, A., & Bentler, P. M. (2001). A scaled difference chi-square test statistic for moment structure analysis. Psychometrika, 66(4), 507–514. https://doi.org/10.1007/bf02296192
- Wijsen, L. D. (2023). Peter Bentler. In Twenty interviews with Psychometric Society presidents (pp. 21–33). Springer. https://doi.org/10.1007/978-3-031-34858-7_3
Cytowania BibTeX
@article{bentler1990comparative, author={Bentler, P. M.}, title={{Comparative fit indexes in structural models}}, journal={Psychological Bulletin}, year={1990}, volume={107}, number={2}, pages={238--246}, doi={10.1037/0033-2909.107.2.238}}@article{bentler1992fit, author={Bentler, Peter M.}, title={{On the fit of models to covariances and methodology to the Bulletin}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={3}, pages={400--404}, doi={10.1037/0033-2909.112.3.400}}@article{bentler1980significance, author={Bentler, P. M. and Bonett, Douglas G.}, title={{Significance tests and goodness of fit in the analysis of covariance structures}}, journal={Psychological Bulletin}, year={1980}, volume={88}, number={3}, pages={588--606}, doi={10.1037/0033-2909.88.3.588}}@misc{psychometricsocietycareeraward, author={{Psychometric Society}}, title={{Career Award for Lifetime Achievement}}, url={https://www.psychometricsociety.org/career-award}}@article{satorra2001scaled, author={Satorra, Albert and Bentler, Peter M.}, title={{A scaled difference chi-square test statistic for moment structure analysis}}, journal={Psychometrika}, year={2001}, volume={66}, number={4}, pages={507--514}, doi={10.1007/bf02296192}}@incollection{wijsen2023bentler, author={Wijsen, Lisa D.}, title={{Peter Bentler}}, booktitle={Twenty interviews with Psychometric Society presidents}, year={2023}, pages={21--33}, publisher={Springer}, doi={10.1007/978-3-031-34858-7_3}}