Kim jest Kenneth A. Bollen?
Kenneth A. Bollen pracuje na University of North Carolina at Chapel Hill (UNC), gdzie zajmuje katedrę imienia Henry’ego Rudolpha Immerwahra, z afiliacją w zakładach psychologii i neuronauki oraz socjologii. Jest też fellow Carolina Population Center i członkiem L.L. Thurstone Psychometric Laboratory. Rozwija metody ilościowe dla nauk społecznych i badań populacyjnych – estymatory, statystyki dopasowania i narzędzia diagnostyczne dla modeli ze zmiennymi latentnymi, błędem pomiaru i danymi podłużnymi – a w ostatnich latach stosuje je głównie w badaniach zdrowia. W 2025 r. został wybrany do American Academy of Arts and Sciences (American Academy of Arts and Sciences, b.d.).
W 2018 r. dostał nagrodę Psychometric Society za całokształt kariery – tę samą, którą wcześniej otrzymali m.in. Karl G. Jöreskog (2008) i Peter M. Bentler (2014) (Psychometric Society, b.d.).
Najważniejsze pomysły
- Pomiar demokracji (1980). W „American Sociological Review” Bollen (1980) wytknął istniejącym indeksom demokracji politycznej wątpliwą trafność wskaźników, nieznaną rzetelność i małe próby. Zaproponował poprawiony indeks, sprawdził jego wskaźniki konfirmacyjną analizą czynnikową i ocenił jego rzetelność.
- Podręcznik (1989). Structural Equations with Latent Variables (Bollen, 1989) to wykład modelowania równań strukturalnych krok po kroku: od notacji, przyczynowości i analizy ścieżek (metody zapoczątkowanej przez Sewalla Wrighta), przez modele ze zmiennymi obserwowalnymi i skutki błędu pomiaru, po modele pomiarowe, konfirmacyjną analizę czynnikową i ogólny model łączący zmienne latentne z pomiarem. W tym ostatnim kontekście pojawia się też problem identyfikacji modelu.
- Wskaźniki efektu i przyczynowe (1991). Bollen i Lennox (1991) pokazali, że reguły takie jak wymóg wysokiej spójności wewnętrznej wskaźników obowiązują tylko wtedy, gdy wskaźniki są skutkami zmiennej latentnej. Jako alternatywę opisali model wskaźników przyczynowych, które współtworzą pojęcie (zob. modele refleksyjne i formatywne).
- MIIV-2SLS (1996). W „Psychometrice” Bollen (1996) zaproponował nieiteracyjny estymator dwustopniowej MNK dla równań ze zmiennymi latentnymi, liczony równanie po równaniu. Jest zgodny, dopuszcza rozkłady nienormalne, ma znane błędy standardowe i diagnostykę instrumentów.
Ciekawostka
Jeśli uczysz się SEM w R, możesz już znać dane Bollena. Plik pomocy pakietu lavaan nazywa zbiór PoliticalDemocracy „słynnym” i podaje, że dane o industrializacji i demokracji politycznej w 75 krajach rozwijających się są używane w całej książce Bollena z 1989 r. – w rozdziałach 2, 7 i 8. Te same dane są w pakietach sem (jako Bollen) i OpenMx, który wskazuje tabelę 9.4 na s. 428 podręcznika.
Autor pakietu sem odnotował w pomocy, że dostał je od Bollena drogą prywatnej korespondencji, a OpenMx przejął je z pakietu sem. Wszystkie trzy pliki pomocy odsyłają też do prac Bollena o pomiarze demokracji w „American Sociological Review”, m.in. z 1980 r.
Przykład na prawdziwych danych
Danych PoliticalDemocracy nie używamy – są w wielu hasłach serwisu. Zamiast tego pokazujemy pomysł Bollena z 1996 r. na zbiorze DavisThin z pakietu carData: według pliku pomocy to siedem pozycji skali „dążenia do szczupłości” z badania C. Davis i współpracowników z 1997 r. nad zaburzeniami odżywiania, 191 osób, odpowiedzi 0–3 (bez braków). Rozkłady są silnie skośne: w pozycji DT1 aż 137 osób odpowiedziało 0.
ML. Jednoczynnikowy model metodą największej wiarygodności (ładunek DT6 = 1) daje χ²(14) = 41.25, p < .001, CFI = .963. Test mówi, że coś jest nie tak, ale nie mówi gdzie.
MIIV-2SLS. Skoro DT6 = F + e6, to F = DT6 − e6 i każdą inną pozycję można zapisać jako regresję na DT6 z błędem złożonym. DT6 jest skorelowany z tym błędem, ale pięć pozostałych pozycji – według modelu – nie, więc są instrumentami. Ładunki MIIV-2SLS są bliskie ML: od 0.357 (DT1; ML 0.370) do 0.994 (DT3; ML 1.009). Test Sargana w każdym równaniu (df = 4, wartość krytyczna 9.49) wskazuje trzy podejrzane równania: DT7 (29.60, p < .001), DT2 (14.23, p = .007) i DT4 (10.12, p = .038). Największy indeks modyfikacji modelu ML dotyczy tej samej okolicy – kowariancji reszt DT2 i DT7 (15.58).
Na rysunku
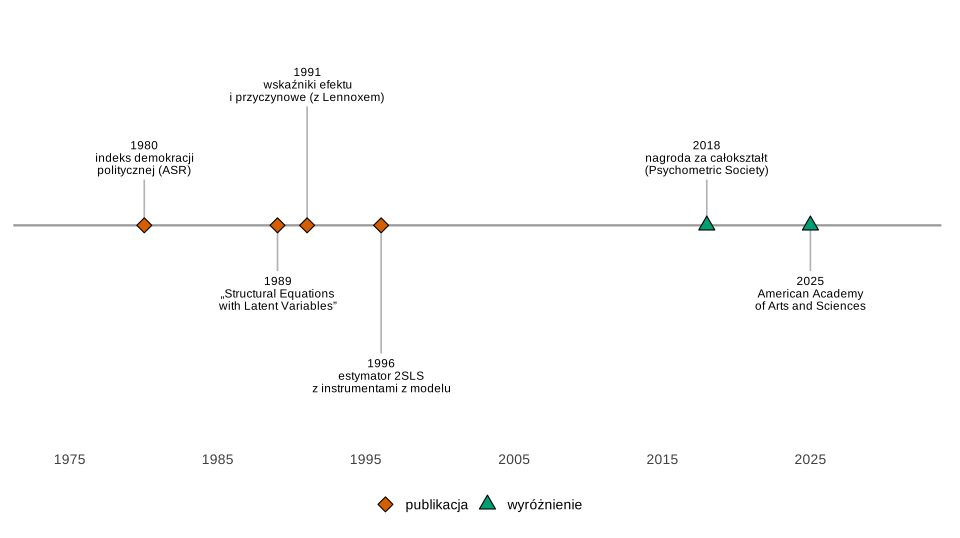
Co widać. Trzon dorobku metodologicznego powstał w latach 1980–1996, a wyróżnienia za całokształt przyszły ponad dwadzieścia lat później.
Na co uważać. Na osi nie ma dat studiów ani stanowisk – nie znaleźliśmy ich w dostępnych źródłach, które cytujemy.
Podpis do pracy:
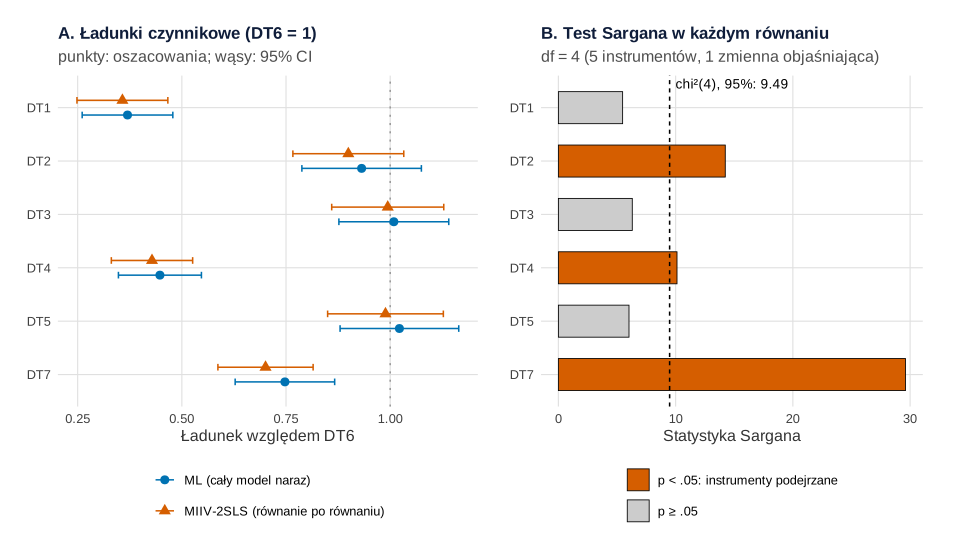
carData::DavisThin, N = 191): ładunki z metody największej wiarygodności i z estymatora MIIV-2SLS (A) oraz test Sargana w każdym równaniu MIIV-2SLS (B). Obliczenia i rysunek: R, pakiety lavaan, ggplot2 i patchwork.Co widać. Obie metody dają prawie te same ładunki, ale MIIV-2SLS dodaje coś, czego ML nie daje: osobny test dla każdego równania. Trzy słupki za linią przerywaną mówią, w których pozycjach instrumenty „nie pasują” – najmocniej przy DT7.
Na co uważać. Odpowiedzi 0–3 traktujemy tu jak zmienne ciągłe. Wynik testu Sargana zależy też od wyboru wskaźnika skalującego: odrzucenie mówi, że któryś instrument w danym równaniu koliduje z modelem, a nie który.
Podpis do pracy:
Gdzie spotkasz Bollena w swojej pracy
- W przykładach SEM – dane o industrializacji i demokracji z jego książki są w plikach pomocy lavaan, sem i OpenMx (zob. poradnik CB-SEM – założenia i interpretacja).
- Gdy budujesz wskaźnik złożony, np. statusu społeczno-ekonomicznego, zadaj pytanie Bollena i Lennoxa: czy pozycje są skutkami cechy, czy ją tworzą? Od odpowiedzi zależy, czy alfa Cronbacha w ogóle ma sens (formatywna zmienna latentna).
- Gdy model ML jest odrzucany, a indeksy modyfikacji kuszą dopisywaniem kowariancji, MIIV-2SLS daje test lokalny w każdym równaniu – to samo myślenie co w zmiennych instrumentalnych w ekonometrii.
Spory, mity i trudne strony
- Wskaźniki formatywne. Model wskaźników przyczynowych opisany przez Bollena i Lennoxa (1991) jest trudniejszy w użyciu niż refleksyjny: sama zmienna latentna z samymi wskaźnikami przyczynowymi nie jest zidentyfikowana – potrzebuje zmiennych, na które wpływa, a oszacowania wag zależą od tego, jakie to zmienne. Szczegóły w haśle o modelach refleksyjnych i formatywnych.
- ML czy 2SLS? Bollen (1996) zaczyna od stwierdzenia, że estymację SEM zdominowała metoda ML, i proponuje estymator, który ją uzupełnia: liczy równania osobno i nie wymaga normalności. W przykładzie obie metody dają podobne ładunki, a różnią się tym, co mówią o niedopasowaniu.
- Słynne dane, słynny problem. Dane o demokracji krążą w samouczkach od dziesięcioleci; to wygodne, ale 75 krajów to stosunkowo mała próba dla modelu z jedenastoma wskaźnikami i warto o tym pamiętać, zanim przeniesie się ustawienia z samouczka na własne dane.
MIIV-2SLS i test Sargana w R
Kod wczytuje dane z pakietu carData, dopasowuje model jednoczynnikowy metodą największej wiarygodności w lavaan, liczy ręcznie estymator MIIV-2SLS (macierzowo, dwa etapy MNK) i test Sargana dla każdej pozycji, wypisuje największe indeksy modyfikacji i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu. Kod nie losuje niczego, więc nie ma ziarna.
1. ML, MIIV-2SLS i test Sargana: rysunek 2
Kod R rysunku 2
# Bollen: estymator MIIV-2SLS (zmienne instrumentalne wynikające z modelu) vs ML w jednoczynnikowej CFA
# Dane: carData::DavisThin – 7 pozycji skali „dążenie do szczupłości” (0–3), N = 191
suppressPackageStartupMessages({library(lavaan); library(ggplot2); library(patchwork)})
kol <- c(ml = "#0072B2", miiv = "#D55E00", ok = "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(DavisThin, package = "carData")
d <- DavisThin
n <- nrow(d)
c(N = n, braki = sum(is.na(d)))
sapply(d, function(x) table(factor(x, levels = 0:3)))    # liczebności odpowiedzi 0–3 w każdej pozycji

# 1. Metoda największej wiarygodności (ML): jeden czynnik, skala ustalona ładunkiem DT6 = 1
f_ml <- cfa("F =~ DT6 + DT1 + DT2 + DT3 + DT4 + DT5 + DT7", data = d)
round(fitMeasures(f_ml, c("chisq", "df", "pvalue", "cfi", "rmsea")), 3)
pe <- parameterEstimates(f_ml)
ml <- pe[pe$op == "=~" & pe$rhs != "DT6", c("rhs", "est", "se")]

# 2. MIIV-2SLS (Bollen, 1996): DT6 = F + e6, więc F = DT6 − e6, a dla każdej innej pozycji j:
#    DTj = a + lambda_j * DT6 + (ej − lambda_j * e6). DT6 jest skorelowany z błędem, ale pozostałe
#    pozycje (bez DT6 i DTj) według modelu nie są – to one są instrumentami. Każde równanie liczy się osobno.
miiv <- function(j, skal = "DT6") {
  inst <- setdiff(names(d), c(skal, j))                  # 5 instrumentów wynikających z modelu
  Z <- cbind(1, as.matrix(d[inst])); X <- cbind(1, d[[skal]]); y <- d[[j]]
  X_hat <- Z %*% solve(crossprod(Z), crossprod(Z, X))    # etap 1: DT6 przewidziany z instrumentów
  b <- solve(crossprod(X_hat, X), crossprod(X_hat, y))   # etap 2: MNK z przewidzianym DT6
  u <- y - X %*% b                                       # reszty liczone z prawdziwym DT6
  se <- sqrt(sum(u^2) / (n - 2) * solve(crossprod(X_hat))[2, 2])
  sargan <- n * summary(lm(u ~ Z[, -1]))$r.squared       # test Sargana: czy instrumenty są „czyste”
  c(lambda = b[2], se = se, sargan = sargan, df = length(inst) - 1,
    p = pchisq(sargan, length(inst) - 1, lower.tail = FALSE))
}
wyn <- data.frame(pozycja = ml$rhs, lambda_ml = ml$est, se_ml = ml$se, t(sapply(ml$rhs, miiv)))
names(wyn)[4:8] <- c("lambda_miiv", "se_miiv", "sargan", "df", "p_sargan")
rownames(wyn) <- NULL
cbind(wyn[1], round(wyn[-1], 3))
# największe indeksy modyfikacji w modelu ML – dla porównania z testami Sargana
head(modindices(f_ml, sort. = TRUE)[, c("lhs", "op", "rhs", "mi")], 3)

# Rysunek: A – ładunki ML i MIIV-2SLS z 95% CI; B – test Sargana dla każdego równania
dl <- rbind(data.frame(pozycja = wyn$pozycja, metoda = "ML (cały model naraz)", est = wyn$lambda_ml, se = wyn$se_ml),
            data.frame(pozycja = wyn$pozycja, metoda = "MIIV-2SLS (równanie po równaniu)", est = wyn$lambda_miiv,
                       se = wyn$se_miiv))
dl$metoda <- factor(dl$metoda, levels = c("ML (cały model naraz)", "MIIV-2SLS (równanie po równaniu)"))
dl$pozycja <- factor(dl$pozycja, levels = rev(wyn$pozycja))
pA <- ggplot(dl, aes(est, pozycja, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 1, colour = "grey60", linetype = "dotted") +
  geom_errorbar(aes(xmin = est - 1.96 * se, xmax = est + 1.96 * se), width = 0.25, orientation = "y",
                 position = position_dodge(width = 0.55)) +
  geom_point(size = 2.8, position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = unname(kol[c("ml", "miiv")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(title = "A. Ładunki czynnikowe (DT6 = 1)", subtitle = "punkty: oszacowania; wąsy: 95% CI",
       x = "Ładunek względem DT6", y = NULL) +
  motyw + guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1))
wyn$ocena <- ifelse(wyn$p_sargan < 0.05, "p < .05: instrumenty podejrzane", "p ≥ .05")
kryt <- qchisq(0.95, 4)
pB <- ggplot(wyn, aes(sargan, factor(pozycja, levels = rev(pozycja)), fill = ocena)) +
  geom_col(width = 0.6, colour = "black", linewidth = 0.3) +
  geom_vline(xintercept = kryt, linetype = "22", colour = "black") +
  annotate("text", x = kryt + 0.5, y = 6.45, label = sprintf("chi²(4), 95%%: %.2f", kryt), hjust = 0, size = 3.6) +
  scale_fill_manual(values = c("p < .05: instrumenty podejrzane" = kol[["miiv"]], "p ≥ .05" = "grey80"), name = NULL) +
  labs(title = "B. Test Sargana w każdym równaniu", subtitle = "df = 4 (5 instrumentów, 1 zmienna objaśniająca)",
       x = "Statystyka Sargana", y = NULL) +
  motyw + guides(fill = guide_legend(ncol = 1))
p2 <- pA + pB + plot_layout(widths = c(1.1, 1))
p2
Wynik w R
    N braki
  191     0
  DT1 DT2 DT3 DT4 DT5 DT6 DT7
0 137 109 112 158 104 114 142
1  27  14  16   9  14  15  13
2  19  23  22  16  21  23  13
3   8  45  41   8  52  39  23
 chisq     df pvalue    cfi  rmsea
41.248 14.000  0.000  0.963  0.101
  pozycja lambda_ml se_ml lambda_miiv se_miiv sargan df p_sargan
1     DT1     0.370 0.055       0.357   0.056  5.479  4    0.242
2     DT2     0.931 0.073       0.900   0.068 14.234  4    0.007
3     DT3     1.009 0.067       0.994   0.069  6.303  4    0.178
4     DT4     0.447 0.051       0.428   0.050 10.118  4    0.038
5     DT5     1.022 0.073       0.989   0.071  6.023  4    0.197
6     DT7     0.747 0.061       0.701   0.058 29.603  4    0.000
   lhs op rhs     mi
30 DT2 ~~ DT7 15.575
33 DT3 ~~ DT7 11.497
18 DT6 ~~ DT3 10.084
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Kenneth A. Bollen – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1980, 1989, 1991, 1996, 2018, 2025),
  opis = c("indeks demokracji\npolitycznej (ASR)", "„Structural Equations\nwith Latent Variables”",
           "wskaźniki efektu\ni przyczynowe (z Lennoxem)", "estymator 2SLS\nz instrumentami z modelu",
           "nagroda za całokształt\n(Psychometric Society)", "American Academy\nof Arts and Sciences"),
  rodzaj = c("publikacja", "publikacja", "publikacja", "publikacja", "wyróżnienie", "wyróżnienie"),
  poziom = c(0.5, -0.5, 1.3, -1.4, 0.5, -0.5),                              # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("publikacja" = "#D55E00", "wyróżnienie" = "#009E73")                                       # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1974, 2031), breaks = seq(1975, 2025, by = 10)) +
  scale_y_continuous(limits = c(-2.2, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (model ML – pakiet lavaan; 2SLS i test Sargana – algebra macierzy i funkcja lm() z pakietu stats; dane – pakiet carData; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- carData (wersja 3.0.6): Fox, J., Weisberg, S., & Price, B. (2022). carData: Companion to Applied Regression data sets [R package]. https://doi.org/10.32614/CRAN.package.carData
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest Kenneth Bollen?
To amerykański metodolog z University of North Carolina at Chapel Hill, profesor w katedrze imienia Henry’ego Rudolpha Immerwahra, z afiliacją w psychologii i neuronauce oraz socjologii. Rozwija metody dla nauk społecznych i badań populacyjnych: estymatory, statystyki dopasowania i diagnostykę modeli ze zmiennymi latentnymi. W 2025 r. został wybrany do American Academy of Arts and Sciences.
Skąd pochodzą dane PoliticalDemocracy z lavaan?
Z podręcznika Bollena Structural Equations with Latent Variables (1989). Według pliku pomocy lavaan to 75 krajów rozwijających się, cztery wskaźniki demokracji z 1960 i 1965 r. i trzy wskaźniki industrializacji z 1960 r.; te same dane są w pakietach sem i OpenMx, a autor pakietu sem otrzymał je od Bollena prywatnie.
Czym jest estymator MIIV-2SLS Bollena?
To dwustopniowa metoda najmniejszych kwadratów zastosowana do modeli ze zmiennymi latentnymi. Zmienną latentną zastępuje się jej wskaźnikiem skalującym, a jako instrumenty bierze się te zmienne obserwowalne, które według modelu nie korelują z błędem danego równania. Estymator liczy każde równanie osobno, nie wymaga normalności i daje test Sargana dla każdego równania.
Czym różnią się wskaźniki refleksyjne od formatywnych według Bollena?
Wskaźniki refleksyjne (efektu) są skutkami zmiennej latentnej, więc powinny ze sobą korelować. Wskaźniki przyczynowe, zwane też formatywnymi, współtworzą pojęcie i nie muszą być ze sobą spójne. Bollen i Lennox (1991) pokazali, że reguły takie jak wymóg wysokiej spójności wewnętrznej obowiązują tylko przy pierwszym modelu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikRegresja nieciągła (RDD) i zmienne instrumentalne
Próg w regule przydziału i zmienna instrumentalna: założenia, lokalna regresja liniowa, testy, 2SLS w R z poprawnym SE i wzór opisu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Academy of Arts and Sciences. (b.d.). Kenneth A. Bollen. Pobrano 22 listopada 2026 z https://www.amacad.org/person/kenneth-bollen ● Otwarty dostęp
- Bollen, K. A. (1980). Issues in the comparative measurement of political democracy. American Sociological Review, 45(3), 370–390. https://doi.org/10.2307/2095172
- Bollen, K. A. (1989). Structural equations with latent variables. Wiley. https://doi.org/10.1002/9781118619179
- Bollen, K. A. (1996). An alternative two stage least squares (2SLS) estimator for latent variable equations. Psychometrika, 61(1), 109–121. https://doi.org/10.1007/bf02296961
- Bollen, K., & Lennox, R. (1991). Conventional wisdom on measurement: A structural equation perspective. Psychological Bulletin, 110(2), 305–314. https://doi.org/10.1037/0033-2909.110.2.305
- Psychometric Society. (b.d.). Career Award for Lifetime Achievement. Pobrano 22 listopada 2026 z https://www.psychometricsociety.org/career-award ● Otwarty dostęp
Cytowania BibTeX
@misc{amacadbollen, author={{American Academy of Arts and Sciences}}, title={{Kenneth A. Bollen}}, url={https://www.amacad.org/person/kenneth-bollen}}@article{bollen1980issues, author={Bollen, Kenneth A.}, title={{Issues in the comparative measurement of political democracy}}, journal={American Sociological Review}, year={1980}, volume={45}, number={3}, pages={370--390}, doi={10.2307/2095172}}@book{bollen1989structural, author={Bollen, Kenneth A.}, title={{Structural equations with latent variables}}, year={1989}, publisher={Wiley}, doi={10.1002/9781118619179}}@article{bollen1996alternative, author={Bollen, Kenneth A.}, title={{An alternative two stage least squares (2SLS) estimator for latent variable equations}}, journal={Psychometrika}, year={1996}, volume={61}, number={1}, pages={109--121}, doi={10.1007/bf02296961}}@article{bollen1991conventional, author={Bollen, Kenneth and Lennox, Richard}, title={{Conventional wisdom on measurement: A structural equation perspective}}, journal={Psychological Bulletin}, year={1991}, volume={110}, number={2}, pages={305--314}, doi={10.1037/0033-2909.110.2.305}}@misc{psychometricsocietycareeraward, author={{Psychometric Society}}, title={{Career Award for Lifetime Achievement}}, url={https://www.psychometricsociety.org/career-award}}