Kim był Emanuel Parzen?
Emanuel Parzen (1929–2016) był amerykańskim statystykiem, autorem estymatora jądrowego gęstości, jednym z czołowych badaczy szeregów czasowych i propagatorem kwantylowego spojrzenia na dane. Urodził się 21 kwietnia 1929 r. w Nowym Jorku i chodził do Bronx High School of Science. Licencjat z matematyki uzyskał na Harvardzie (1949), a magisterium (1951) i doktorat z matematyki i statystyki (1953) – w Berkeley (Newton, 2002).
W latach 1953–1956 pracował w Hudson Laboratories przy wydziale fizyki Columbia University, gdzie w ostatnim roku był też adiunktem statystyki matematycznej. W 1956 r. przeszedł do Stanford, w 1970 r. – do State University of New York w Buffalo, gdzie kierował wydziałem statystyki, a w 1978 r. – do Texas A&M University, gdzie jako Distinguished Professor pracował do 2009 r. Napisał ponad 100 prac i sześć książek, był członkiem (fellow) ASA, IMS i AAAS, a w 1994 r. dostał od American Statistical Association Medal Wilksa (Newton, 2002; Texas A&M University, 2016). Zmarł 6 lutego 2016 r. w Boca Raton na Florydzie, w wieku 86 lat (Texas A&M University, 2016).
Najważniejsze pomysły
- Estymator gęstości i mody (1962). Gęstość szacuje się jako średnią z „górek” – jąder K – ustawionych nad każdą obserwacją: f(x) = 1/(nh) · Σ K((x − Xj)/h). Parzen podał warunki na jądro (nieujemne, ograniczone, o polu 1) i na szerokość pasma h, która ma maleć wraz ze wzrostem n, pokazał, że taki estymator jest zgodny i asymptotycznie normalny, i zastosował go do szacowania mody (Parzen, 1962; Wahba, 2018). Tak powstał estymator jądrowy gęstości, nazywany też oknem Parzena (Texas A&M University, 2016).
- Szeregi czasowe i analiza spektralna. Był jedną z głównych postaci tej dziedziny: zajmował się estymacją gęstości spektralnej (periodogram i jego wygładzanie) i kryteriami wyboru modelu szeregu czasowego (kryterium CATS) (Wahba, 2018).
- Przestrzenie Hilberta z jądrem reprodukującym (RKHS). Według Wahby (2018) był prawdopodobnie pierwszym statystykiem, który poważnie wprowadził je do statystyki. Na tym narzędziu wyrosły później splajny wygładzające jego doktorantki Grace Wahby i maszyny wektorów nośnych.
- Kwantylowe modelowanie danych (1979). Zaproponował, by najpierw sprawdzić, czy dane pasują do rodziny rozkładów o danym kształcie, a jeśli nie – oszacować nieparametrycznie funkcję gęstość-kwantyl. W tej samej pracy wprowadził m.in. wykresy kwantyl-pudełko (quantile-box plots), nawiązujące do wykresu pudełkowego (Parzen, 1979).
- Podręczniki. Modern Probability Theory and Its Applications (1960) uchodzi za klasyczny podręcznik rachunku prawdopodobieństwa (Texas A&M University, 2016).
Ciekawostka
Najbarwniej opisała Parzena jego doktorantka Grace Wahba. W 1962 r. pracowała w instytucie badawczym pod Waszyngtonem, czytała jego podręczniki i marzyła o doktoracie u niego w Stanford. Udało się okrężną drogą: dostała pracę w zespole IBM, który wkrótce przeniesiono w okolice San Francisco, a z firmowego programu łączenia pracy ze studiami trafiła do Stanford jako piąta doktorantka Parzena. W ładne dni prowadził zajęcia z szeregów czasowych na trawniku przed starą Sequoia Hall – tam po raz pierwszy usłyszała o RKHS, które kilka lat później stały się podstawą jej najważniejszych prac (Wahba, 2018).
Po jej doktoracie (1966) Parzen obdzwonił znajomych, m.in. George’a Boxa w Madison. Skończyło się serią zaproszeń na wykłady i ośmioma ofertami pracy (Wahba, 2018). Współpracownicy z Texas A&M zapamiętali jego ulubione powiedzenie: „Busy people have time” – zapracowani ludzie mają czas (Texas A&M University, 2016).
Przykład: ile skupisk galaktyk widać w danych?
Zbiór galaxies z pakietu MASS zawiera prędkości 82 galaktyk z przeglądu obszaru Corona Borealis; według opisu w pakiecie wielomodalność takich danych świadczy o pustkach i supergromadach we Wszechświecie. Opis podaje też literówkę w obserwacji 78 (26690 zamiast 26960 km/s), którą poprawiamy. Prędkości mieszczą się między 9.17 a 34.28 tys. km/s.
Estymator policzony ręcznie. Sumę jąder normalnych przy szerokości pasma z reguły bw.nrd0() (h = 1.00) porównaliśmy z funkcją density(): na siatce 701 punktów różnią się najwyżej o 0.00003, a pole pod krzywą wynosi 1.0000. Dla jądra prostokątnego (okno o stałej wysokości) różnica jest większa (0.0057), bo density() według dokumentacji najpierw rozkłada dane na siatkę i splata je z jądrem metodą szybkiej transformaty Fouriera, co przy nieciągłym jądrze daje widoczne przybliżenie.
Liczba mód zależy od h. Przy h = 0.5 krzywa ma 7 lokalnych maksimów, przy paśmie Sheathera–Jonesa (h = 0.64) – także 7, przy h = 1.00 – 3, przy h = 2 – 3, a przy h = 3 – 2. Najwyższy szczyt przesuwa się tylko z 19.85 do 21.25 tys. km/s. Przy h = 0.2 maksimów jest 16, od h = 0.94 najwyżej 3, a jedna moda zostaje dopiero od h = 3.08.
Na rysunku
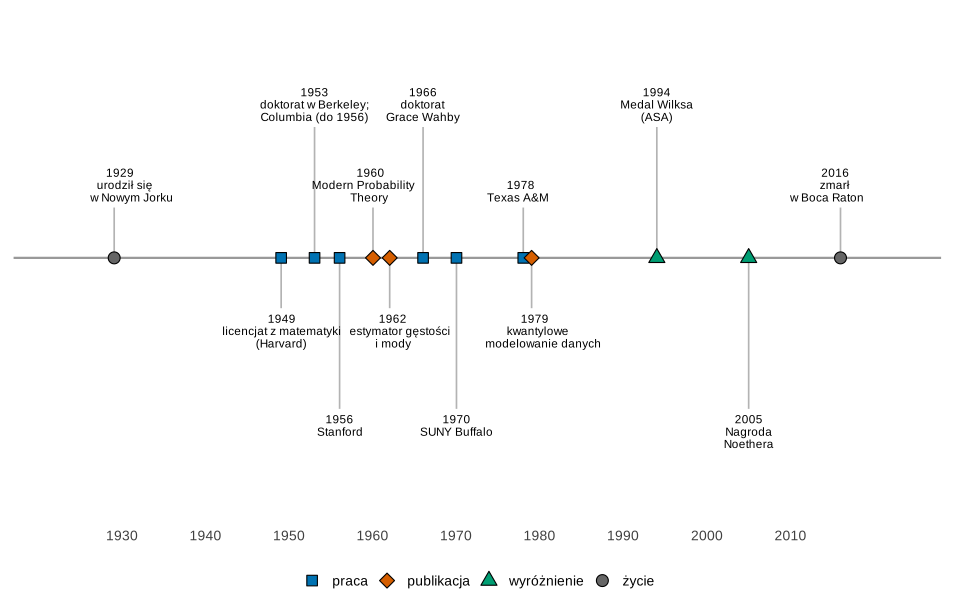
Co widać. Trzy etapy kariery: Stanford, Buffalo i Texas A&M.
Na co uważać. Oś pokazuje tylko wybrane prace; prace o szeregach czasowych i RKHS z lat 60. i 70. nie mają tu osobnych znaczników.
Podpis do pracy:
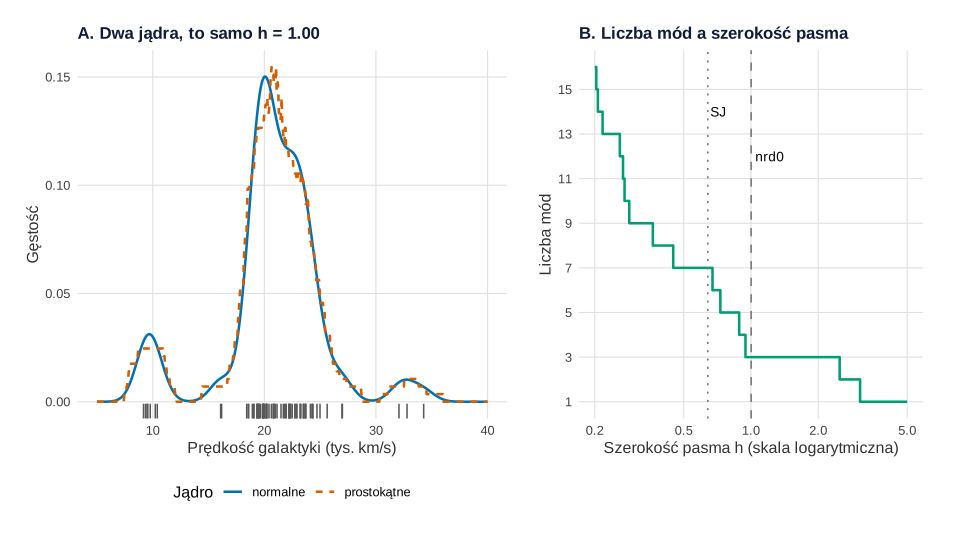
galaxies z pakietu MASS, obserwacja 78 poprawiona według pliku pomocy): dwa jądra przy tym samym h (A) i liczba mód w funkcji szerokości pasma (B). Obliczenia i rysunek: R, pakiety ggplot2 i patchwork.Co widać. Jądro normalne i prostokątne o tym samym odchyleniu standardowym dają prawie ten sam kształt – prostokątne tylko „schodkuje”. Liczba mód zależy natomiast silnie od h: między dwiema popularnymi regułami wyboru pasma jest różnica 7 i 3 szczytów.
Na co uważać. Liczba lokalnych maksimów to nie liczba skupisk. Przy małym h pojedyncze galaktyki tworzą własne „szczyty”, a każda reguła wyboru pasma odpowiada na trochę inne pytanie.
Podpis do pracy:
Gdzie spotkasz Parzena w swojej pracy
- Wykresy gęstości. Każda gładka krzywa rozkładu – w wykresie skrzypcowym, wykresie grzbietowym czy nad histogramem – to estymator Parzena. W pracy podawaj jądro i szerokość pasma.
- Wysokość krzywej. Estymator przybliża funkcję gęstości: pole pod nim wynosi 1, a wysokość nie jest odsetkiem osób.
- Kwantyle. Kwartyle, wykres pudełkowy i wykres kwantylowy Q-Q to opis rozkładu przez funkcję kwantylową – podejście, które Parzen rozwijał od 1979 r.
- Szeregi czasowe. Wygładzony periodogram i okna spektralne pojawiają się w analizie cykliczności, a z Hirotugu Akaikem, twórcą AIC, łączyło Parzena zainteresowanie modelowaniem szeregów czasowych – w 1984 r. Akaike zorganizował wokół tej grupy konferencję w Tokio (Wahba, 2018).
Spory, mity i trudne strony
- Kto pierwszy? Sześć lat przed Parzenem Murray Rosenblatt opisał pewną klasę nieparametrycznych estymatorów gęstości, pokazał, że przy łagodnych warunkach każdy estymator gęstości jest obciążony, i policzył asymptotyczny błąd średniokwadratowy (Rosenblatt, 1956). Parzen (1962) skupił się na zgodności, asymptotycznej normalności i estymacji mody. Estymator nie jest więc „wynalazkiem jednej osoby”, a nazwa „okno Parzena” to skrót.
Estymator Parzena w R
Kod liczy estymator gęstości ręcznie jako sumę jąder, porównuje go z density(), zlicza mody przy różnych szerokościach pasma i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje, więc nie ma ziarna.
1. Estymator jądrowy gęstości policzony ręcznie: rysunek 2
Kod R rysunku 2
# Estymator Parzena (1962) policzony ręcznie: prędkości 82 galaktyk z pakietu MASS
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(MASS)})
kol <- c("#0072B2", "#D55E00", "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

data(galaxies, package = "MASS")
v <- galaxies
v[78] <- 26960            # literówkę w obserwacji 78 (26690) poprawiamy według pliku pomocy ?galaxies
v <- v / 1000             # tysiące km/s
c(n = length(v), min = min(v), max = max(v))

# Estymator Parzena: f(x) = 1/(n·h) · Σ K((x − X_j) / h); h to odchylenie standardowe jądra (jak w density())
jadra <- list(normalne = dnorm,
              prostokatne = function(u) ifelse(abs(u) <= sqrt(3), 1 / (2 * sqrt(3)), 0))
parzen <- function(x, dane, h, K) sapply(x, function(x0) sum(K((x0 - dane) / h)) / (length(dane) * h))
siatka <- seq(5, 40, length.out = 701)
krok <- diff(siatka)[1]
liczba_mod <- function(f) sum(diff(sign(diff(f))) == -2)   # lokalne maksima na siatce

# 1. Ręczna suma jąder a funkcja density() przy tym samym h
h0 <- bw.nrd0(v)
for (j in names(jadra)) {
  f_recznie <- parzen(siatka, v, h0, jadra[[j]])
  f_r <- density(v, bw = h0, kernel = c(normalne = "gaussian", prostokatne = "rectangular")[[j]],
                 from = 5, to = 40, n = 701)$y
  cat(sprintf("jądro %-11s h = %.3f  największa różnica z density(): %.5f  pole pod krzywą: %.4f\n",
              j, h0, max(abs(f_recznie - f_r)), sum(f_recznie) * krok))
}

# 2. Liczba mód i położenie najwyższej mody przy różnych h (jądro normalne)
pasma <- c(h_0.5 = 0.5, SJ = bw.SJ(v), nrd0 = h0, h_2 = 2, h_3 = 3)
tab <- t(sapply(pasma, function(h) {
  f <- parzen(siatka, v, h, dnorm)
  c(h = h, mody = liczba_mod(f), moda = siatka[which.max(f)], f_max = max(f))
}))
round(tab, 3)

# 3. Liczba mód w funkcji h: od jakiego h zostaje jedna moda?
h_siatka <- exp(seq(log(0.2), log(5), length.out = 200))
mody_h <- sapply(h_siatka, function(h) liczba_mod(parzen(siatka, v, h, dnorm)))
c(mody_przy_h_0.2 = mody_h[1],
  najmniejsze_h_z_1_moda = round(min(h_siatka[mody_h == 1]), 2),
  najmniejsze_h_z_3_modami = round(min(h_siatka[mody_h <= 3]), 2))

# Rysunek: A – dwa jądra przy tym samym h; B – liczba mód w funkcji h
dA <- rbind(data.frame(x = siatka, f = parzen(siatka, v, h0, jadra$normalne), jadro = "normalne"),
            data.frame(x = siatka, f = parzen(siatka, v, h0, jadra$prostokatne), jadro = "prostokątne"))
pA <- ggplot(dA, aes(x, f, colour = jadro, linetype = jadro)) +
  geom_line(linewidth = 0.9) +
  geom_rug(data = data.frame(x = v), aes(x = x), inherit.aes = FALSE, colour = "grey35", length = unit(0.04, "npc")) +
  scale_colour_manual(values = kol[1:2], name = "Jądro") +
  scale_linetype_manual(values = c("solid", "22"), name = "Jądro") +
  labs(title = sprintf("A. Dwa jądra, to samo h = %.2f", h0), x = "Prędkość galaktyki (tys. km/s)", y = "Gęstość") +
  motyw
pB <- ggplot(data.frame(h = h_siatka, mody = mody_h), aes(h, mody)) +
  geom_step(colour = kol[3], linewidth = 0.9) +
  geom_vline(xintercept = pasma[c("SJ", "nrd0")], colour = "grey45", linetype = c("dotted", "dashed")) +
  annotate("text", x = pasma[c("SJ", "nrd0")], y = c(14, 12), label = c("SJ", "nrd0"), hjust = -0.15, size = 3.6) +
  scale_x_log10(breaks = c(0.2, 0.5, 1, 2, 5)) +
  scale_y_continuous(breaks = seq(1, 21, by = 2)) +
  labs(title = "B. Liczba mód a szerokość pasma", x = "Szerokość pasma h (skala logarytmiczna)", y = "Liczba mód") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.25, 1))
p2
Wynik w R
     n    min    max
82.000  9.172 34.279
jądro normalne    h = 1.002  największa różnica z density(): 0.00003  pole pod krzywą: 1.0000
jądro prostokatne h = 1.002  największa różnica z density(): 0.00567  pole pod krzywą: 1.0003
          h mody  moda f_max
h_0.5 0.500    7 19.85 0.201
SJ    0.641    7 19.90 0.183
nrd0  1.002    3 20.05 0.150
h_2   2.000    3 21.05 0.117
h_3   3.000    2 21.25 0.094
         mody_przy_h_0.2   najmniejsze_h_z_1_moda najmniejsze_h_z_3_modami
                   16.00                     3.08                     0.94
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Emanuel Parzen (1929–2016) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1929, 1949, 1953, 1956, 1960, 1962, 1966, 1970, 1978, 1979, 1994, 2005, 2016),
  opis = c("urodził się\nw Nowym Jorku", "licencjat z matematyki\n(Harvard)", "doktorat w Berkeley;\nColumbia (do 1956)",
           "Stanford", "Modern Probability\nTheory", "estymator gęstości\ni mody", "doktorat\nGrace Wahby",
           "SUNY Buffalo", "Texas A&M", "kwantylowe\nmodelowanie danych", "Medal Wilksa\n(ASA)",
           "Nagroda\nNoethera", "zmarł\nw Boca Raton"),
  rodzaj = c("życie", "praca", "praca", "praca", "publikacja", "publikacja", "praca", "praca", "praca",
             "publikacja", "wyróżnienie", "wyróżnienie", "życie"),
  poziom = c(0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3, -1.5, 0.5),   # wysokość etykiety
  wyrownanie = c(0.3, 0.5, 0.5, 0.5, 0.6, 0.4, 0.5, 0.5, 0.6, 0.4, 0.5, 0.5, 0.7))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1922, 2023), breaks = seq(1930, 2010, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (estymator gęstości – density(), reguły pasma – bw.nrd0() i bw.SJ() z pakietu stats; dane – pakiet MASS; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Emanuel Parzen?
Amerykańskim statystykiem (1929–2016) z Nowego Jorku. Studiował na Harvardzie i w Berkeley (doktorat 1953), pracował w Columbia, Stanford (1956–1970), SUNY Buffalo (1970–1978) i Texas A&M (od 1978). Najbardziej znany z estymatora jądrowego gęstości z 1962 r. (Newton, 2002; Texas A&M University, 2016).
Co to jest okno Parzena?
Potoczna nazwa estymatora jądrowego gęstości: nad każdą obserwacją ustawia się jądro – „okno” o polu 1 i szerokości h – i uśrednia je. Parzen (1962) podał warunki na jądro i na malejące wraz z n pasmo, przy których estymator jest zgodny i asymptotycznie normalny.
Dlaczego liczba szczytów na wykresie gęstości zależy od szerokości pasma?
Bo przy małym h każda obserwacja lub para bliskich obserwacji tworzy własną górkę, a przy dużym h górki zlewają się w jedną. Dla prędkości 82 galaktyk estymator ma 16 maksimów przy h = 0.2, 7 przy h = 0.5, 3 przy h = 1.00 i jedno dopiero od h = 3.08.
Kto był uczniem Emanuela Parzena?
Między innymi Grace Wahba – jego piąta doktorantka (doktorat w Stanford w 1966 r.), później twórczyni splajnów wygładzających w RKHS i uogólnionej walidacji krzyżowej – oraz H. Joseph Newton, doktor z SUNY Buffalo, a potem dziekan w Texas A&M (Wahba, 2018; Texas A&M University, 2016).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Newton, H. J. (2002). A conversation with Emanuel Parzen. Statistical Science, 17(3), 357–378. https://doi.org/10.1214/ss/1042727944 ● Otwarty dostęp
- Parzen, E. (1962). On estimation of a probability density function and mode. The Annals of Mathematical Statistics, 33(3), 1065–1076. https://doi.org/10.1214/aoms/1177704472 ● Otwarty dostęp
- Parzen, E. (1979). Nonparametric statistical data modeling. Journal of the American Statistical Association, 74(365), 105–121. https://doi.org/10.1080/01621459.1979.10481621
- Rosenblatt, M. (1956). Remarks on some nonparametric estimates of a density function. The Annals of Mathematical Statistics, 27(3), 832–837. https://doi.org/10.1214/aoms/1177728190 ● Otwarty dostęp
- Texas A&M University. (2016). Loss of a legend. Texas A&M Stories. https://stories.tamu.edu/news/2016/02/08/loss-of-a-legend ● Otwarty dostęp
- Wahba, G. (2018). Emanuel Parzen: A memorial, and a model with the two kernels that he championed. arXiv. https://arxiv.org/abs/1803.05555 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{newton2002conversation, author={Newton, H. Joseph}, title={{A conversation with Emanuel Parzen}}, journal={Statistical Science}, year={2002}, volume={17}, number={3}, pages={357--378}, doi={10.1214/ss/1042727944}}@article{parzen1962estimation, author={Parzen, Emanuel}, title={{On estimation of a probability density function and mode}}, journal={The Annals of Mathematical Statistics}, year={1962}, volume={33}, number={3}, pages={1065--1076}, doi={10.1214/aoms/1177704472}}@article{parzen1979nonparametric, author={Parzen, Emanuel}, title={{Nonparametric statistical data modeling}}, journal={Journal of the American Statistical Association}, year={1979}, volume={74}, number={365}, pages={105--121}, doi={10.1080/01621459.1979.10481621}}@article{rosenblatt1956remarks, author={Rosenblatt, Murray}, title={{Remarks on some nonparametric estimates of a density function}}, journal={The Annals of Mathematical Statistics}, year={1956}, volume={27}, number={3}, pages={832--837}, doi={10.1214/aoms/1177728190}}@misc{tamu2016loss, author={{Texas A\&M University}}, title={{Loss of a legend}}, howpublished={Texas A\&M Stories}, year={2016}, publisher={Texas A\&M University}, url={https://stories.tamu.edu/news/2016/02/08/loss-of-a-legend}}@techreport{wahba2018emanuel, author={Wahba, Grace}, title={{Emanuel Parzen: A memorial, and a model with the two kernels that he championed}}, year={2018}, institution={arXiv}, url={https://arxiv.org/abs/1803.05555}}