Kim był Hirotugu Akaike?
Hirotugu Akaike (1927–2009) urodził się 5 listopada 1927 r. w Fujinomiya w prefekturze Shizuoka. Uczył się w Akademii Marynarki Wojennej – gdzie, jak wspominał, zetknął się ze statystyką, np. z dopasowaniem prostej metodą najmniejszych kwadratów – potem w Pierwszej Szkole Wyższej i na Uniwersytecie Tokijskim, który w 1952 r. ukończył z matematyki. Statystyki uczył się tam niewiele: na seminarium przeczytał książkę Haralda Craméra o zmiennych losowych i rozkładach prawdopodobieństwa (Findley i Parzen, 1995).
Jeszcze w 1952 r. zaczął pracę w Instytucie Matematyki Statystycznej w Tokio i został w nim do emerytury: w latach 1973–1985 kierował wydziałem szeregów czasowych i sterowania, od 1987 r. był dyrektorem generalnym, a na emeryturę przeszedł 31 marca 1994 r. W latach 1966–1967 gościł w Princeton na zaproszenie Johna Tukeya (Findley i Parzen, 1995). Zmarł 4 sierpnia 2009 r.; trzy lata wcześniej otrzymał Nagrodę Kioto za kryterium AIC (Konishi i Kitagawa, 2010).
Najważniejsze pomysły
- Modele dla prawdziwych procesów. Akaike zaczynał od praktycznych problemów: przędzenia jedwabiu z kokonów, drgań zawieszenia samochodu, a w latach 60. – sterowania obrotowym piecem cementowym w firmie Chichibu Cement razem z Toichiro Nakagawą. Efektem były ich wspólna książka z 1972 r. i Nagroda Ishikawy (1972); podobne sterowanie zastosowano potem w elektrowniach (Findley i Parzen, 1995).
- Modele autoregresyjne i FPE. Inżynierowie z cementowni wciąż pytali go, jak dobrać rząd modelu, czyli liczbę uwzględnianych opóźnień. Odpowiedzią było kryterium FPE (końcowy błąd prognozy): rząd, przy którym oczekiwany błąd prognozy na jeden krok jest najmniejszy (Findley i Parzen, 1995). To bezpośredni przodek dzisiejszego wyboru rzędu w modelach ARIMA i w modelach VAR.
- AIC. Kryterium AIC = −2 log(maksymalna wiarygodność) + 2 × (liczba szacowanych parametrów) pozwala porównywać modele konkurencyjne – wybiera się ten o najmniejszej wartości (Akaike, 1974). Uzasadnieniem jest związek oczekiwanego logarytmu wiarygodności z dywergencją Kullbacka–Leiblera. Procedura minimum AIC dała półautomatyczny sposób modelowania, wolny od niejednoznaczności testowania hipotez (Konishi i Kitagawa, 2010).
- Oprogramowanie. Pakiety TIMSAC do analizy i sterowania szeregami czasowymi udostępniały jego metody praktykom (Konishi i Kitagawa, 2010).
Ciekawostka
Akaike opowiadał, że kluczowy pomysł przyszedł mu w marcu 1971 r., gdy stał w pociągu z domu do instytutu. Był wtedy pod dużą presją i, jak mówił, nocami budził się z myślami o problemie, a w dzień był niemal senny. Zrozumiał, że dopasowany rozkład jest prognozą dla kolejnych podobnych danych, a trafność tej prognozy mierzy oczekiwany logarytm wiarygodności. Jedną–dwie linijki rozwiązania zapisał w notesie i po latach wciąż miał tę stronę (Findley i Parzen, 1995).
Sama nazwa ma jeszcze skromniejszą historię. Akaike pisał po prostu IC – information criterion. Gdy przygotowywał artykuł do IEEE Transactions on Automatic Control, jego asystentka, panna Arahata, programowała obliczenia w FORTRAN-ie i potrzebowała innej pierwszej litery, bo wartość kryterium nie jest liczbą całkowitą. Dopisała więc A. Akaike uznał, że AIC nadal sugeruje an information criterion; wcześniej Dick Jones nazwał jego kryterium „Akaike selection criterion”, co autorowi wydawało się mało stosowne (Findley i Parzen, 1995).
Przykład na historycznych danych
Akaike wymyślił swoje kryteria, wybierając rząd autoregresji, więc tak też je pokazujemy. Zbiór LakeHuron z pakietu datasets to roczne pomiary poziomu jeziora Huron w stopach z lat 1875–1972 (98 lat; średnia 579.00, SD = 1.32). Dopasowaliśmy metodą największej wiarygodności modele AR(p) dla p = 0, …, 8 i dla każdego policzyliśmy AIC.
Najmniejsze AIC = 215.27 ma model AR(2). AR(1) jest gorszy o 3.93, AR(3) – tylko o 0.77, a AR(8) – o 9.47; model bez autoregresji, AR(0), przegrywa o 120.00. Ten sam rząd wybiera automatycznie funkcja ar() – zarówno metodą największej wiarygodności, jak i domyślną metodą Yule’a–Walkera. Współczynniki AR(2) wynoszą 1.044 (SE = 0.098) i −0.249 (SE = 0.101): tegoroczny poziom zależy dodatnio od zeszłorocznego i nieco ujemnie od tego sprzed dwóch lat. W resztach nie zostało wyraźnej autokorelacji (test Ljunga–Boxa do opóźnienia 10: χ²(8) = 5.95, p = .653). To nasze obliczenia na współczesnym zbiorze, nie analiza Akaikego.
Na rysunku
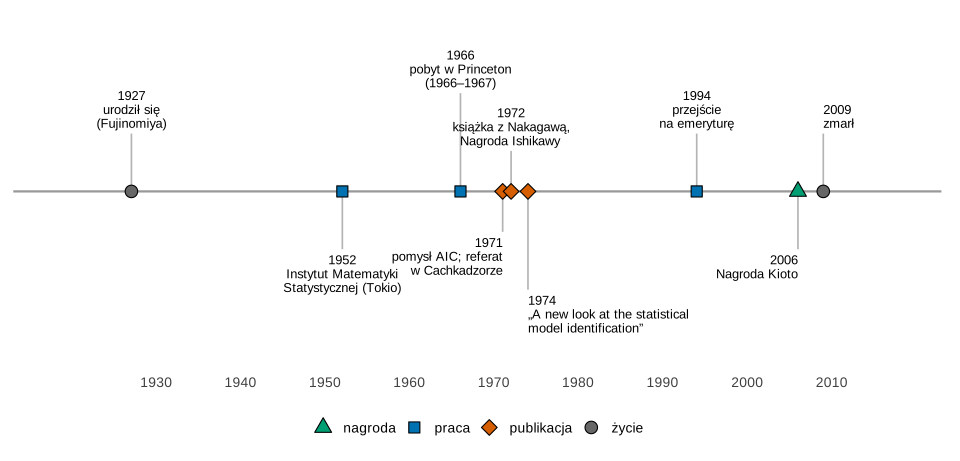
Co widać. Droga do AIC trwała prawie dwie dekady: od przyjścia do instytutu w 1952 r. przez prace nad sterowaniem procesami do pomysłu z 1971 r. i artykułu z 1974 r.
Na co uważać. Oś pokazuje tylko lata podane w cytowanych źródłach. Pomija np. kierowanie wydziałem (1973–1985) i instytutem (od 1987 r.).
Podpis do pracy:
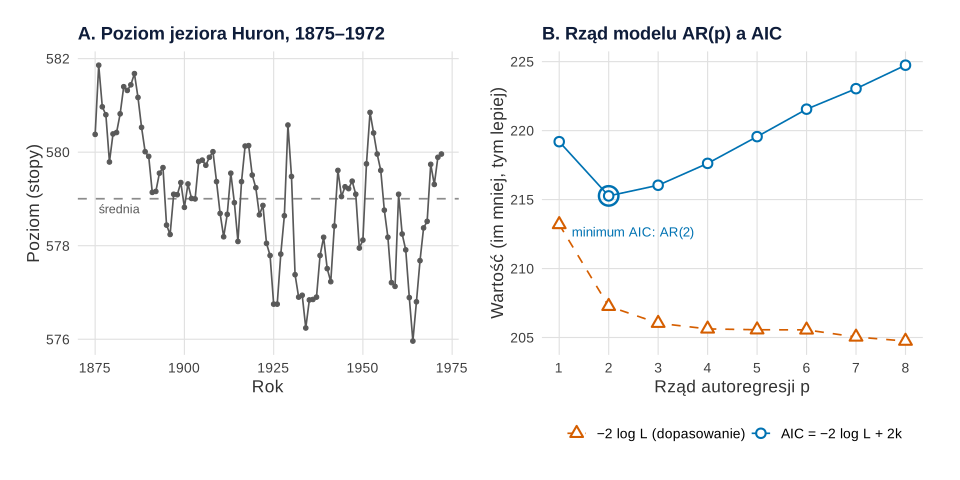
datasets::LakeHuron; obliczenia i rysunek: R, pakiety stats, ggplot2 i patchwork.Co widać. Panel A pokazuje, że poziom jeziora zmienia się powoli – rok wysoki zwykle sąsiaduje z wysokim – czyli szereg ma silną autokorelację. Na panelu B każdy dodatkowy parametr poprawia dopasowanie (−2 log L spada), ale od rzędu 2 już tylko o ułamki. AIC dolicza karę 2 za każdy parametr, więc krzywa ma minimum przy AR(2): tu dalsze komplikowanie modelu przestaje się opłacać.
Na co uważać. Różnica AIC między AR(2) a AR(3) wynosi tylko 0.77, więc oba modele są wspierane przez dane podobnie; AIC wskazuje model najlepiej przewidujący z porównywanych, a nie „prawdziwy”. Szereg ma też lekki trend spadkowy (ok. −0.024 stopy na rok), a modele zakładają stałą średnią; model z trendem mógłby wybrać inny rząd. Model AR(0) pominęliśmy na wykresie, bo jego wartości (331.3 i 335.3) wychodzą daleko poza skalę.
Podpis do pracy:
Gdzie spotkasz Akaikego w swojej pracy
Prawie wszędzie tam, gdzie porównujesz kilka modeli dopasowanych do tych samych danych:
- w regresji, gdy decydujesz, ile predyktorów zostawić – zob. AIC i BIC w regresji; AIC chroni przed przeuczeniem, ale go nie wyklucza;
- gdy zamiast wskazywać jeden zwycięski model przeliczasz różnice AIC na wagi Akaikego, interpretowane jako względne poparcie modeli (Wagenmakers i Farrell, 2004), a przy małych próbach używasz poprawki AICc;
- w modelach równań strukturalnych, gdy porównujesz modele niezagnieżdżone – zob. AIC i BIC w SEM;
- w szeregach czasowych, gdy dobierasz rząd modelu ARIMA – krok po kroku pokazuje to wpis Szeregi czasowe i ARIMA w praktyce.
Spory, mity i trudne strony
- „A” jak Akaike? Autor nie nazwał kryterium swoim nazwiskiem – litera A pojawiła się przy programowaniu w FORTRAN-ie (Findley i Parzen, 1995). Nazwa „kryterium informacyjne Akaikego” jest jednak utrwalona i poprawna.
- Nieufność statystyków. Akaike zauważał, że AIC szybciej przyjęli inżynierowie i badacze z innych dziedzin niż statystycy. Krytykom zarzucał, że rzadko pracują z prawdziwymi problemami i bez pytań przyjmują estymację największej wiarygodności, choć nie znają „prawdziwej” postaci rozkładu (Findley i Parzen, 1995). To jego relacja, nie rozstrzygnięcie sporu.
- AIC to nie test. AIC nie daje wartości p ani „istotności” różnicy modeli; porównuje się tylko modele dopasowane do tych samych obserwacji tej samej zmiennej zależnej.
Wybór rzędu autoregresji według AIC w R
Kod wczytuje zbiór LakeHuron, dopasowuje metodą największej wiarygodności modele AR(p) dla p = 0–8 funkcją arima(), liczy −2 log L, karę 2k i AIC, porównuje wybór z automatycznym ar(), a dla wybranego modelu podaje współczynniki i test Ljunga–Boxa. Zakres rzędów (do 8) ustaliliśmy z góry. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne.
1. AIC dla modeli AR(p): rysunek 2
Kod R rysunku 2
# Hirotugu Akaike: wybór rzędu modelu autoregresyjnego AR(p) według AIC – poziom jeziora Huron 1875–1972
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(AIC = "#0072B2", dopasowanie = "#D55E00", szereg = "grey35")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(LakeHuron, package = "datasets")   # roczny poziom jeziora Huron w stopach, 1875–1972 (n = 98)
y <- LakeHuron
c(n = length(y), od = start(y)[1], do = end(y)[1], srednia = round(mean(y), 2), sd = round(sd(y), 2))

# Modele AR(p) dla p = 0, 1, ..., 8 metodą największej wiarygodności (ten sam szereg, stała średnia)
# k = p współczynników + średnia + wariancja szumu; AIC = −2 log L + 2k
p_max <- 8
tab <- do.call(rbind, lapply(0:p_max, function(p) {
  m <- arima(y, order = c(p, 0, 0), method = "ML")
  k <- length(coef(m)) + 1
  data.frame(p = p, k = k, minus2logL = -2 * m$loglik, kara = 2 * k, AIC = AIC(m))
}))
tab$dAIC <- tab$AIC - min(tab$AIC)
print(transform(tab, minus2logL = round(minus2logL, 2), AIC = round(AIC, 2), dAIC = round(dAIC, 2)), row.names = FALSE)
p_aic <- tab$p[which.min(tab$AIC)]
p_aic

# To samo automatycznie: funkcja ar() wybiera rząd o najmniejszym AIC
ar_mle <- ar(y, aic = TRUE, order.max = p_max, method = "mle")
ar_mle$order
round(ar_mle$ar, 3)
ar_yw <- ar(y, aic = TRUE, order.max = p_max)   # domyślnie równania Yule’a–Walkera
ar_yw$order

# Wybrany model: współczynniki z błędami standardowymi
m_aic <- arima(y, order = c(p_aic, 0, 0), method = "ML")
round(cbind(wsp = coef(m_aic), SE = sqrt(diag(m_aic$var.coef))), 3)
# Czy w resztach została autokorelacja? Test Ljunga–Boxa do opóźnienia 10
Box.test(residuals(m_aic), lag = 10, type = "Ljung-Box", fitdf = p_aic)
# Szereg ma trend spadkowy: nachylenie prostej (stopy na rok)
round(coef(lm(as.numeric(y) ~ as.numeric(time(y))))[2], 4)

# Rysunek 2A: szereg czasowy
dane <- data.frame(rok = as.numeric(time(y)), poziom = as.numeric(y))
pA <- ggplot(dane, aes(rok, poziom)) +
  geom_hline(yintercept = mean(y), linetype = "dashed", colour = "grey55") +
  geom_line(colour = kol[["szereg"]]) +
  geom_point(size = 1.2, colour = kol[["szereg"]]) +
  annotate("text", x = 1876, y = mean(y) - 0.12, label = "średnia", hjust = 0, vjust = 1, size = 3.3, colour = "grey35") +
  labs(title = "A. Poziom jeziora Huron, 1875–1972", x = "Rok", y = "Poziom (stopy)") +
  motyw
# Rysunek 2B: −2 log L maleje z każdym parametrem, AIC dodaje karę 2k i ma minimum
# (AR(0) pomijamy na wykresie: jego wartości, 331.3 i 335.3, leżą daleko poza skalą pozostałych modeli)
tb <- tab[tab$p >= 1, ]
dlugie <- rbind(data.frame(p = tb$p, wartosc = tb$minus2logL, miara = "−2 log L (dopasowanie)"),
                data.frame(p = tb$p, wartosc = tb$AIC, miara = "AIC = −2 log L + 2k"))
dlugie$miara <- factor(dlugie$miara, levels = c("−2 log L (dopasowanie)", "AIC = −2 log L + 2k"))
pB <- ggplot(dlugie, aes(p, wartosc, colour = miara, shape = miara, linetype = miara)) +
  geom_line() +
  geom_point(size = 2.6, fill = "white", stroke = 1.1) +
  annotate("point", x = p_aic, y = min(tab$AIC), shape = 21, size = 6, colour = kol[["AIC"]], stroke = 1.3) +
  annotate("text", x = p_aic, y = min(tab$AIC) - 2.6, label = sprintf("minimum AIC: AR(%d)", p_aic),
           hjust = 0.3, size = 3.5, colour = kol[["AIC"]]) +
  scale_x_continuous(breaks = 1:p_max) +
  scale_colour_manual(values = c(kol[["dopasowanie"]], kol[["AIC"]]), name = NULL) +
  scale_shape_manual(values = c(24, 21), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  labs(title = "B. Rząd modelu AR(p) a AIC", x = "Rząd autoregresji p", y = "Wartość (im mniej, tym lepiej)") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1))
p2
Wynik w R
      n      od      do srednia      sd
  98.00 1875.00 1972.00  579.00    1.32
 p  k minus2logL kara    AIC   dAIC
 0  2     331.27    4 335.27 120.00
 1  3     213.20    6 219.20   3.93
 2  4     207.27    8 215.27   0.00
 3  5     206.04   10 216.04   0.77
 4  6     205.62   12 217.62   2.36
 5  7     205.56   14 219.56   4.30
 6  8     205.55   16 221.55   6.29
 7  9     205.04   18 223.04   7.77
 8 10     204.74   20 224.74   9.47
[1] 2
[1] 2
[1]  1.044 -0.250
[1] 2
              wsp    SE
ar1         1.044 0.098
ar2        -0.249 0.101
intercept 579.047 0.332

	Box-Ljung test

data:  residuals(m_aic)
X-squared = 5.9457, df = 8, p-value = 0.6533

as.numeric(time(y))
            -0.0242
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Hirotugu Akaike, 1927–2009 – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1927, 1952, 1966, 1971, 1972, 1974, 1994, 2006, 2009),
  opis = c("urodził się\n(Fujinomiya)", "Instytut Matematyki\nStatystycznej (Tokio)", "pobyt w Princeton\n(1966–1967)",
           "pomysł AIC; referat\nw Cachkadzorze", "książka z Nakagawą,\nNagroda Ishikawy", "„A new look at the statistical\nmodel identification”",
           "przejście\nna emeryturę", "Nagroda Kioto", "zmarł"),
  rodzaj = c("życie", "praca", "praca", "publikacja", "publikacja", "publikacja", "praca", "nagroda", "życie"))
zdarzenia$wysokosc <- c(0.5, -0.5, 0.85, -0.35, 0.35, -0.85, 0.5, -0.5, 0.5)   # nad (+) i pod (−) osią; dwa poziomy dla bliskich lat
zdarzenia$wyrownanie <- c(0.5, 0.5, 0.5, 1, 0.5, 0, 0.5, 1, 0)                 # etykiety bliskich lat rozsunięte na boki
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "nagroda" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "nagroda" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = wysokosc), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = wysokosc + 0.05 * sign(wysokosc), label = paste0(rok, "\n", opis), vjust = ifelse(wysokosc > 0, 0, 1),
                hjust = wyrownanie),
            size = 3.4, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1918, 2018), breaks = seq(1930, 2010, by = 10)) +
  scale_y_continuous(limits = c(-1.4, 1.4)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (modele – funkcje arima(), ar() i Box.test() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Hirotugu Akaike?
Japońskim statystykiem (1927–2009), który od 1952 r. pracował w Instytucie Matematyki Statystycznej w Tokio, a w latach 1987–1994 nim kierował. Zajmował się szeregami czasowymi i statystycznym sterowaniem procesami przemysłowymi, a światową sławę przyniosło mu kryterium informacyjne AIC; w 2006 r. otrzymał Nagrodę Kioto.
Co oznacza skrót AIC?
Akaike nazywał swoje kryterium po prostu IC (information criterion). Literę A dopisała jego asystentka, gdy programowała obliczenia w FORTRAN-ie i potrzebowała innej pierwszej litery nazwy; Akaike uznał, że AIC nadal kojarzy się z „an information criterion”. Dziś skrót czyta się zwykle jako kryterium informacyjne Akaikego.
Jak Akaike wpadł na pomysł AIC?
Według jego relacji w marcu 1971 r., gdy stał w pociągu z domu do instytutu. Zrozumiał wtedy, że dopasowany rozkład to prognoza dla nowych danych, której trafność mierzy oczekiwany logarytm wiarygodności, powiązany z informacją Kullbacka. Ideę przedstawił latem i jesienią 1971 r., a opublikował w 1973 i 1974 r.
Jak wybrać rząd modelu autoregresyjnego według AIC w R?
Najprościej funkcją ar(), która dla rzędów od 0 do order.max liczy AIC i zwraca model o najmniejszej wartości (pole $order, różnice AIC w polu $aic). Można też dopasować kolejne modele arima(y, order = c(p, 0, 0)) i porównać AIC(m) – rząd, przy którym AIC jest najmniejsze, uznaje się za najlepiej przewidujący.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/tac.1974.1100705 ● Otwarty dostęp: pełny tekst
- Findley, D. F., & Parzen, E. (1995). A conversation with Hirotugu Akaike. Statistical Science, 10(1), 104–117. https://doi.org/10.1214/ss/1177010133 ● Otwarty dostęp
- Konishi, S., & Kitagawa, G. (2010). Preface: Special issue in honor of Dr. Hirotugu Akaike. Annals of the Institute of Statistical Mathematics, 62(1), 1–2. https://doi.org/10.1007/s10463-009-0269-6
- Wagenmakers, E.-J., & Farrell, S. (2004). AIC model selection using Akaike weights. Psychonomic Bulletin & Review, 11(1), 192–196. https://doi.org/10.3758/bf03206482 ● Otwarty dostęp
Cytowania BibTeX
@article{akaike1974new, author={Akaike, Hirotugu}, title={{A new look at the statistical model identification}}, journal={IEEE Transactions on Automatic Control}, year={1974}, volume={19}, number={6}, pages={716--723}, doi={10.1109/tac.1974.1100705}}@article{findley1995conversation, author={Findley, David F. and Parzen, Emanuel}, title={{A conversation with Hirotugu Akaike}}, journal={Statistical Science}, year={1995}, volume={10}, number={1}, pages={104--117}, doi={10.1214/ss/1177010133}}@article{konishi2010preface, author={Konishi, Sadanori and Kitagawa, Genshiro}, title={{Preface: Special issue in honor of Dr. Hirotugu Akaike}}, journal={Annals of the Institute of Statistical Mathematics}, year={2010}, volume={62}, number={1}, pages={1--2}, doi={10.1007/s10463-009-0269-6}}@article{wagenmakers2004aic, author={Wagenmakers, Eric-Jan and Farrell, Simon}, title={{AIC model selection using Akaike weights}}, journal={Psychonomic Bulletin \& Review}, year={2004}, volume={11}, number={1}, pages={192--196}, doi={10.3758/bf03206482}}