Kim byli Solomon Kullback i Richard Leibler?
Solomon Kullback zaczynał jako nauczyciel matematyki w szkole średniej, a karierę zakończył jako profesor George Washington University (McIntire, 2021). Pomiędzy tymi etapami był kryptologiem w służbie rządu USA. Gdy w 1930 r. William Friedman ogłosił nabór trzech „matematyków rządowych” do mało znanej agencji armii USA, wybrał właśnie Kullbacka, obok Franka Rowletta i Abrahama Sinkova (Grajek, 2020). Doktorat z matematyki Kullback obronił w 1934 r. na George Washington University – rozprawę o zastosowaniu funkcji charakterystycznych do rozkładów statystyk napisał pod kierunkiem Franka M. Weidy (Mathematics Genealogy Project, 2026).
Richard Arthur Leibler był matematykiem z wykształcenia: doktorat uzyskał w 1939 r. na University of Illinois za pracę o nieliniowych osobliwych układach równań różniczkowych, pisaną u Waldemara Trjitzinsky’ego (Mathematics Genealogy Project, 2026). Źródła, do których dotarliśmy, mówią o jego dalszej karierze niewiele, dlatego opisujemy go przede wszystkim jako współautora pracy z 1951 r.
Najważniejsze pomysły
- Dywergencja Kullbacka–Leiblera (1951). W krótkim artykule „On Information and Sufficiency” w The Annals of Mathematical Statistics autorzy zaproponowali miarę informacji, która służy do odróżniania dwóch rozkładów prawdopodobieństwa (Kullback i Leibler, 1951). Dziś to dywergencja KL, zwana też entropią względną: D(P ‖ Q) = Σ p ln(p/q). Jest nieujemna, równa zeru tylko dla identycznych rozkładów i niesymetryczna.
- Teoria informacji w statystyce. W książce „Information Theory and Statistics” (Kullback, 1959), wydanej przez Wileya, a potem wznawianej przez Dover (1968 i 1997), Kullback rozwinął związki statystyki z teorią informacji Claude’a Shannona, w której centralne są entropia i informacja wzajemna.
- Pomost do wyboru modeli. Minimalizowanie dywergencji KL między danymi a modelem to to samo, co maksymalizowanie wiarygodności (pokazujemy to niżej). Na tej obserwacji Hirotugu Akaike oparł swoje kryterium AIC.
Ciekawostka
Współautor jednej z najważniejszych miar teorii informacji przez lata łamał szyfry. Grajek (2020) przytacza wspomnienia pierwszej trójki ludzi Friedmana: przez pierwsze lata ich zajęcia były dość dalekie od matematyki, choć zatrudniono ich właśnie jako matematyków. W czasie wojny Kullback został na trzy miesiące oddelegowany do Bletchley Park, gdzie poznał brytyjskie prace nad Enigmą i szyfrem Tunny; Shiu (2025) zalicza go – obok Edwarda Simpsona – do kryptologów, którzy później stali się znanymi statystykami.
Nic dziwnego, że artykuł McIntire (2021) o jego życiu nosi tytuł „The Secret Career of Solomon Kullback” – sekretna kariera.
Przykład: dni nieobecności w szkole
Zbiór quine z pakietu MASS opisuje 146 dzieci z Walgett w Nowej Południowej Walii (Australia): dla każdego zapisano liczbę dni nieobecności w szkole w jednym roku szkolnym (opis w pliku pomocy). Średnia to 16.46 dnia, a wariancja 264.17 – szesnaście razy większa, czyli silna nadmierna dyspersja. Metodą największej wiarygodności dopasowaliśmy rozkład Poissona (λ = 16.46) i ujemny dwumianowy (size = 1.067, μ = 16.459).
Dywergencja rozkładu empirycznego od modelu wynosi 5.604 nata dla Poissona i 0.318 nata dla ujemnego dwumianowego. Odwrotny kierunek, KL(model ‖ dane), jest nieskończony: model daje dodatnie prawdopodobieństwo np. 26 dniom nieobecności, których nie miało żadne dziecko. Różnica dywergencji pomnożona przez n = 146 daje 771.87 – dokładnie tyle samo, co różnica logarytmów wiarygodności obu modeli. AIC spada z 2664.01 (Poisson) do 1122.27 (ujemny dwumianowy). Także między samymi modelami widać asymetrię: KL(ujemny dwumianowy ‖ Poisson) = 5.292, a KL(Poisson ‖ ujemny dwumianowy) = 0.983 nata.
Na rysunku
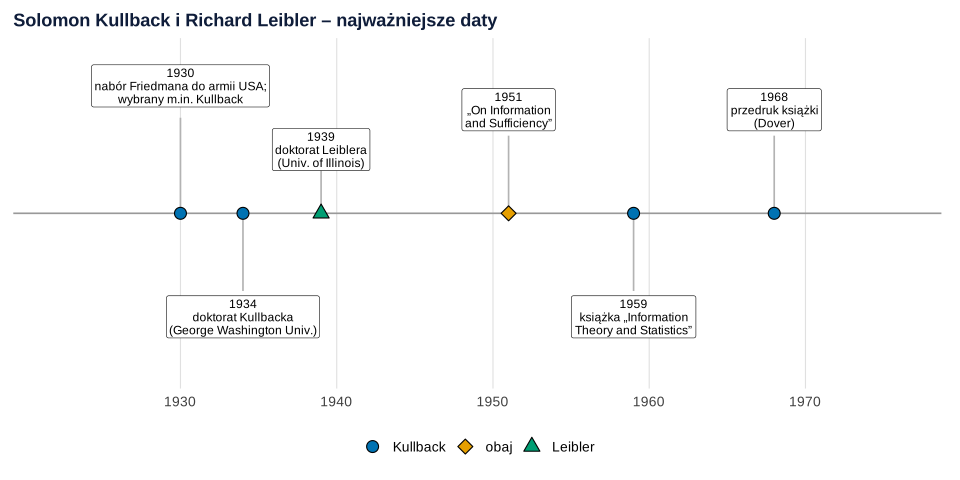
Co widać. Obaj doszli do statystyki z matematyki czystej; jedyna wspólna publikacja, z 1951 r., stoi pośrodku osi. Kullback rozwijał jej idee przez następne dekady.
Na co uważać. Oś zawiera tylko daty z cytowanych źródeł. Nie zaznaczamy dat urodzenia i śmierci ani etapów pracy w wywiadzie, bo nie potwierdziliśmy ich w źródłach, które przeczytaliśmy; rok 1930 to rok naboru ogłoszonego przez Friedmana.
Podpis do pracy:
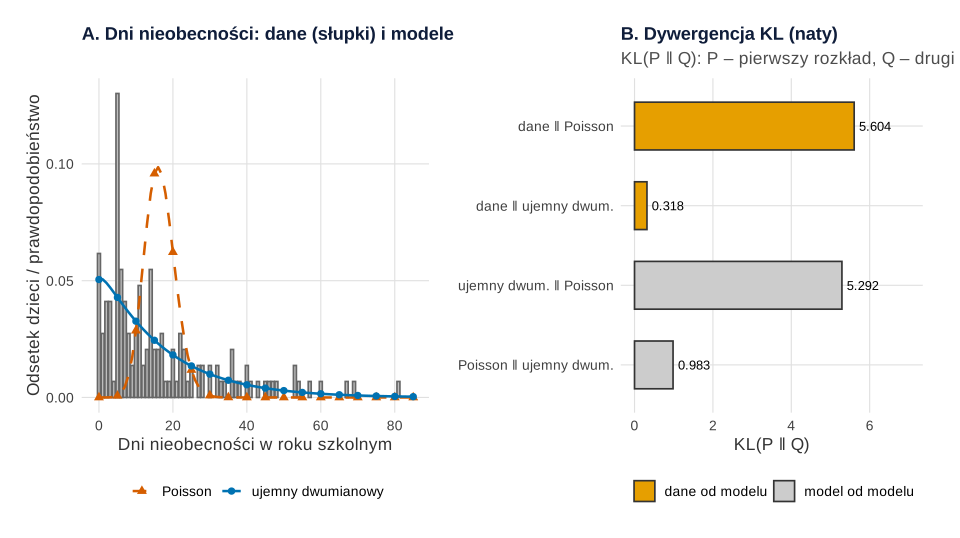
MASS::quine) z dopasowanymi rozkładami Poissona i ujemnym dwumianowym (A) oraz dywergencja Kullbacka–Leiblera w obu kierunkach (B). Obliczenia i rysunek: R, pakiety MASS, ggplot2 i patchwork (bez losowania).Co widać. Rozkład Poissona skupia prawie całą masę między 8 a 25 dniami, a dane mają dużo dzieci z kilkoma dniami nieobecności i długi ogon do 81 dni – stąd ogromna dywergencja. Ujemny dwumianowy oddaje kształt znacznie lepiej. Panel B pokazuje asymetrię: przybliżanie szerokiego rozkładu wąskim (ujemny dwumianowy ‖ Poisson) kosztuje ponad pięć razy więcej niż odwrotnie.
Na co uważać. Dywergencja danych od modelu zależy od tego, jak szczegółowo pogrupujesz wartości; tu każda liczba dni to osobna kategoria, więc nawet dobry model ma dywergencję wyraźnie większą od zera. Do porównania modeli wystarcza różnica dywergencji (czyli różnica wiarygodności), a jej istotność sprawdza test ilorazu wiarygodności. Kierunek KL(model ‖ dane) z rozkładem empirycznym zwykle nie ma sensu, bo wychodzi nieskończony.
Podpis do pracy:
Gdzie spotkasz Kullbacka i Leiblera w swojej pracy
- Wybór modelu. AIC i wagi Akaikego szacują względną utratę informacji w sensie KL – im niższe AIC, tym bliżej (w przybliżeniu) prawdziwego rozkładu.
- Dane zliczeniowe. Wybierając między regresją Poissona a regresją ujemną dwumianową, porównujesz w istocie dywergencje obu modeli od danych.
- Tabele i informacja. Informacja wzajemna to dywergencja KL rozkładu łącznego od iloczynu rozkładów brzegowych, a statystyka G – ta sama wielkość razy 2N.
Spory, mity i trudne strony
- To nie jest odległość. Mimo potocznej nazwy „odległość Kullbacka–Leiblera” miara jest niesymetryczna i nie spełnia nierówności trójkąta; trzeba zawsze podać kierunek.
- Dwie biografie, nierówne źródła. O Kullbacku piszą historycy kryptologii (Grajek, 2020; Shiu, 2025) i statystyki (McIntire, 2021). O Leiblerze w recenzowanych źródłach jest bardzo mało, więc nie powtarzamy niesprawdzonych informacji o jego karierze.
- Tajność. Część pracy Kullbacka była objęta tajemnicą, a o jego pobycie w Bletchley Park Shiu (2025) pisze na podstawie wywiadu, którego Kullback udzielił w 1982 r.
Kullback i Leibler w R
Kod rysuje oś czasu, dopasowuje do liczby dni nieobecności rozkład Poissona i ujemny dwumianowy, liczy dywergencję KL rozkładu empirycznego od obu modeli i w odwrotnym kierunku, sprawdza związek z wiarygodnością i AIC oraz liczy dywergencję między modelami w obu kierunkach. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
liczebność, średnią i wariancję, parametry ujemnego rozkładu dwumianowego, dywergencje KL w natach, różnicę logarytmów wiarygodności, AIC obu modeli i dywergencje między modelami.
Kod R rysunków 1 i 2
# Kullback i Leibler: oś czasu i dywergencja KL między rozkładem empirycznym a modelami Poissona i ujemnym dwumianowym (MASS::quine)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(MASS)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Grajka 2020, Mathematics Genealogy Project, Kullbacka i Leiblera 1951 oraz katalogu wydań książki Kullbacka)
zdarzenia <- data.frame(
  rok = c(1930, 1934, 1939, 1951, 1959, 1968),
  osoba = c("Kullback", "Kullback", "Leibler", "obaj", "Kullback", "Kullback"),
  opis = c("nabór Friedmana do armii USA;\nwybrany m.in. Kullback", "doktorat Kullbacka\n(George Washington Univ.)", "doktorat Leiblera\n(Univ. of Illinois)",
           "„On Information\nand Sufficiency”", "książka „Information\nTheory and Statistics”", "przedruk książki\n(Dover)"))
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("Kullback", "obaj", "Leibler"))
zdarzenia$y <- c(1.6, -1.3, 0.8, 1.3, -1.3, 1.3)    # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.75), colour = "grey70") +
  geom_point(aes(shape = osoba, fill = osoba), size = 3.8) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.2, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c(Kullback = 21, obaj = 23, Leibler = 24), name = NULL) +
  scale_fill_manual(values = c(Kullback = oi[["niebieski"]], obaj = oi[["pomaranczowy"]], Leibler = oi[["zielony"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1930, 1970, 10), limits = c(1922, 1976)) + scale_y_continuous(limits = c(-2, 2)) +
  labs(title = "Solomon Kullback i Richard Leibler – najważniejsze daty", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: liczba dni nieobecności w szkole (146 dzieci z Walgett, Nowa Południowa Walia)
data(quine, package = "MASS")
dni <- quine$Days
n <- length(dni)
c(n = n, srednia = round(mean(dni), 2), wariancja = round(var(dni), 2), zera = sum(dni == 0))
# Dopasowanie metodą największej wiarygodności
lambda <- mean(dni)                                      # Poisson: ML to średnia
nb <- suppressWarnings(fitdistr(dni, "negative binomial"))   # ujemny dwumianowy: size i mu (ostrzeżenia z kroków optymalizacji pominięte)
round(nb$estimate, 3)

# 3. Dywergencja KL(P || Q) = sum p * log(p / q) w natach; P – rozkład empiryczny
licz <- table(dni); k <- as.numeric(names(licz)); p_emp <- as.numeric(licz) / n
f_pois <- dpois(k, lambda)
f_nb <- dnbinom(k, size = nb$estimate[["size"]], mu = nb$estimate[["mu"]])
KL <- function(p, q) sum(ifelse(p > 0, p * log(p / q), 0))
KL_emp_pois <- KL(p_emp, f_pois); KL_emp_nb <- KL(p_emp, f_nb)
round(c(KL_emp_Poisson = KL_emp_pois, KL_emp_ujemny_dwumianowy = KL_emp_nb), 4)
# Odwrotny kierunek KL(model || empiryczny): model daje szansę dniom, których nikt nie miał (np. 26), więc wynik jest nieskończony
siatka <- 0:400
p_emp_siatka <- tabulate(dni + 1, nbins = length(siatka)) / n
KL(dpois(siatka, lambda), p_emp_siatka)
# Związek z wiarygodnością: n * [KL(emp || Poisson) - KL(emp || NB)] = logL(NB) - logL(Poisson)
logL_pois <- sum(dpois(dni, lambda, log = TRUE)); logL_nb <- nb$loglik
round(c(n_razy_roznica_KL = n * (KL_emp_pois - KL_emp_nb), roznica_logL = logL_nb - logL_pois,
        AIC_Poisson = -2 * logL_pois + 2 * 1, AIC_ujemny_dwumianowy = -2 * logL_nb + 2 * 2), 2)
# Asymetria między dwoma dopasowanymi modelami (oba mają masę na całej siatce 0–400).
# Liczymy na logarytmach gęstości, bo daleko w ogonie prawdopodobieństwa Poissona są mniejsze niż najmniejsza liczba w komputerze.
KL_log <- function(lp, lq) sum(exp(lp) * (lp - lq))
lq_pois <- dpois(siatka, lambda, log = TRUE)
lq_nb <- dnbinom(siatka, size = nb$estimate[["size"]], mu = nb$estimate[["mu"]], log = TRUE)
KL_nb_pois <- KL_log(lq_nb, lq_pois); KL_pois_nb <- KL_log(lq_pois, lq_nb)
round(c(KL_NB_od_Poissona = KL_nb_pois, KL_Poisson_od_NB = KL_pois_nb), 3)

# Rysunek 2A: rozkład empiryczny i dwa modele
krzywe <- rbind(data.frame(dni = 0:85, p = dpois(0:85, lambda), model = "Poisson"),
                data.frame(dni = 0:85, p = dnbinom(0:85, size = nb$estimate[["size"]], mu = nb$estimate[["mu"]]), model = "ujemny dwumianowy"))
pA <- ggplot() +
  geom_col(data = data.frame(dni = k, p = p_emp), aes(dni, p), fill = "grey75", colour = "grey40", width = 0.8) +
  geom_line(data = krzywe, aes(dni, p, colour = model, linetype = model), linewidth = 0.9) +
  geom_point(data = krzywe[krzywe$dni %% 5 == 0, ], aes(dni, p, colour = model, shape = model), size = 2.2) +
  scale_colour_manual(values = c(Poisson = oi[["cynober"]], "ujemny dwumianowy" = oi[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c(Poisson = "dashed", "ujemny dwumianowy" = "solid"), name = NULL) +
  scale_shape_manual(values = c(Poisson = 17, "ujemny dwumianowy" = 16), name = NULL) +
  labs(title = "A. Dni nieobecności: dane (słupki) i modele", x = "Dni nieobecności w roku szkolnym", y = "Odsetek dzieci / prawdopodobieństwo") +
  motyw + theme(legend.position = "bottom")
# Rysunek 2B: wartości dywergencji w obu kierunkach
kl_tab <- data.frame(
  para = factor(c("dane ‖ Poisson", "dane ‖ ujemny dwum.", "ujemny dwum. ‖ Poisson", "Poisson ‖ ujemny dwum."),
                levels = rev(c("dane ‖ Poisson", "dane ‖ ujemny dwum.", "ujemny dwum. ‖ Poisson", "Poisson ‖ ujemny dwum."))),
  KL = c(KL_emp_pois, KL_emp_nb, KL_nb_pois, KL_pois_nb),
  rodzaj = c("dane od modelu", "dane od modelu", "model od modelu", "model od modelu"))
pB <- ggplot(kl_tab, aes(KL, para, fill = rodzaj)) +
  geom_col(width = 0.6, colour = "grey20") +
  geom_text(aes(label = sprintf("%.3f", KL)), hjust = -0.15, size = 3.4) +
  scale_fill_manual(values = c("dane od modelu" = oi[["pomaranczowy"]], "model od modelu" = "grey80"), name = NULL) +
  scale_x_continuous(limits = c(0, max(kl_tab$KL) * 1.25)) +
  labs(title = "B. Dywergencja KL (naty)", subtitle = "KL(P ‖ Q): P – pierwszy rozkład, Q – drugi", x = "KL(P ‖ Q)", y = NULL) +
  motyw + theme(legend.position = "bottom")
p_metoda <- pA + pB + plot_layout(widths = c(1.15, 1))
p_os
p_metoda
Wynik w R
        n   srednia wariancja      zera
   146.00     16.46    264.17      9.00
  size     mu
 1.067 16.459
          KL_emp_Poisson KL_emp_ujemny_dwumianowy
                  5.6044                   0.3176
[1] Inf
    n_razy_roznica_KL          roznica_logL           AIC_Poisson
               771.87                771.87               2664.01
AIC_ujemny_dwumianowy
              1122.27
KL_NB_od_Poissona  KL_Poisson_od_NB
            5.292             0.983
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dane i dopasowanie rozkładu ujemnego dwumianowego – pakiet MASS, funkcja fitdistr(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim byli Kullback i Leibler?
Amerykańskimi matematykami. Solomon Kullback zaczynał jako nauczyciel, w 1930 r. trafił do zespołu kryptologów Williama Friedmana, a karierę zakończył jako profesor George Washington University. Richard Leibler obronił doktorat z matematyki na University of Illinois w 1939 r. W 1951 r. wspólnie opisali miarę nazywaną dziś dywergencją Kullbacka–Leiblera.
Skąd nazwa „dywergencja Kullbacka–Leiblera”?
Od nazwisk autorów artykułu „On Information and Sufficiency” z 1951 r., opublikowanego w czasopiśmie The Annals of Mathematical Statistics. Zaproponowali w nim miarę informacji służącą do odróżniania dwóch rozkładów prawdopodobieństwa. Ta sama wielkość bywa nazywana entropią względną.
Dlaczego dywergencja KL nie jest odległością?
Bo jest niesymetryczna: KL(P ‖ Q) zwykle różni się od KL(Q ‖ P), i nie spełnia nierówności trójkąta. W przykładzie z dniami nieobecności w szkole KL(ujemny dwumianowy ‖ Poisson) = 5.29, a w odwrotnym kierunku 0.98 nata.
Co łączy pracę Kullbacka i Leiblera z kryterium Akaikego?
Dopasowanie modelu metodą największej wiarygodności minimalizuje dywergencję KL rozkładu empirycznego od modelu: różnica dywergencji dwóch modeli razy n to różnica ich logarytmów wiarygodności. Akaike oparł na tej idei swoje kryterium AIC, które szacuje względną utratę informacji przez model.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Grajek, M. (2020). Dawn of mathematical cryptology: Probabilists vs algebraists; algebraists and probabilists? In Proceedings of the 3rd International Conference on Historical Cryptology HistoCrypt 2020 (pp. 70–76). Linköping University Electronic Press. https://doi.org/10.3384/ecp2020171010 ● Otwarty dostęp: pełny tekst
- Kullback, S. (1959). Information theory and statistics. Wiley.
- Kullback, S., & Leibler, R. A. (1951). On information and sufficiency. The Annals of Mathematical Statistics, 22(1), 79–86. https://doi.org/10.1214/aoms/1177729694 ● Otwarty dostęp
- Mathematics Genealogy Project. (2026). Solomon Kullback; Richard Arthur Leibler. North Dakota State University, Department of Mathematics. https://mathgenealogy.org/id.php?id=13292 ● Otwarty dostęp
- McIntire, B. (2021). The secret career of Solomon Kullback. CHANCE, 34(2), 18–23. https://doi.org/10.1080/09332480.2021.1915029
- Shiu, D. (2025). The influence of Bletchley Park on UK mathematics. Cryptologia, 49(4), 372–387. https://doi.org/10.1080/01611194.2025.2457086 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@inproceedings{grajek2020dawn, author={Grajek, Marek}, title={{Dawn of mathematical cryptology: Probabilists vs algebraists; algebraists and probabilists?}}, booktitle={Proceedings of the 3rd International Conference on Historical Cryptology HistoCrypt 2020}, year={2020}, pages={70--76}, publisher={Linköping University Electronic Press}, doi={10.3384/ecp2020171010}}@book{kullback1959information, author={Kullback, Solomon}, title={{Information theory and statistics}}, year={1959}, publisher={Wiley}, url={https://lccn.loc.gov/59005881}}@article{kullback1951information, author={Kullback, S. and Leibler, R. A.}, title={{On information and sufficiency}}, journal={The Annals of Mathematical Statistics}, year={1951}, volume={22}, number={1}, pages={79--86}, doi={10.1214/aoms/1177729694}}@misc{mgp2026kullbackleibler, author={{Mathematics Genealogy Project}}, title={{Solomon Kullback; Richard Arthur Leibler}}, year={2026}, publisher={North Dakota State University, Department of Mathematics}, url={https://mathgenealogy.org/id.php?id=13292}}@article{mcintire2021secret, author={McIntire, B.}, title={{The secret career of Solomon Kullback}}, journal={CHANCE}, year={2021}, volume={34}, number={2}, pages={18--23}, doi={10.1080/09332480.2021.1915029}}@article{shiu2025influence, author={Shiu, Daniel}, title={{The influence of Bletchley Park on UK mathematics}}, journal={Cryptologia}, year={2025}, volume={49}, number={4}, pages={372--387}, doi={10.1080/01611194.2025.2457086}}