Kim był Edward Simpson?
Edward Hugh Simpson (1922–2019) był brytyjskim statystykiem, kryptologiem z Bletchley Park i wysokim urzędnikiem państwowym. Jego nazwisko nosi paradoks Simpsona – odwrócenie kierunku związku po podziale danych na podgrupy – a w ekologii także indeks różnorodności. Statystyce poświęcił jednak tylko kilka lat: większość życia zawodowego spędził w administracji oświatowej (Erskine, 2019).
Urodził się 10 grudnia 1922 r. Pierwsze lata spędził w Belgii, gdzie jego ojciec pracował jako inżynier Imperial War Graves Commission; w 1925 r. rodzina wróciła do Ballymeny w Irlandii Północnej. W szkole najbardziej lubił francuski, ale w połowie 1939 r. dyrektor doradził mu, by wcześniej skończył szkołę i studiował matematykę, bo kraj będzie potrzebował matematyków. Na Queen’s University Belfast poszedł w wieku 16 lat, a w 1942 r. ukończył studia z najwyższym wyróżnieniem (Erskine, 2019).
W październiku 1942 r. trafił do włoskiej sekcji morskiej brytyjskiej służby łamania szyfrów w Bletchley Park. Po kapitulacji Włoch we wrześniu 1943 r. – mając 20 lat – pokierował zespołem atakującym JN-25, główny kod japońskiej marynarki. Po wojnie zaczął doktorat z matematyki w Christ’s College w Cambridge, ale go nie dokończył: w 1947 r. wstąpił do służby cywilnej, najpierw w ministerstwie skarbu. Większość kariery spędził w Department of Education and Science, gdzie doszedł do stanowiska zastępcy sekretarza (Deputy Secretary). W latach 1960–1962 był wicedyrektorem Commonwealth Education Liaison Unit, w 1976 r. otrzymał Order Łaźni (CB) za zasługi dla oświaty, a w 1982 r. przeszedł na emeryturę. Zmarł 5 lutego 2019 r. w wieku 96 lat (Erskine, 2019).
Najważniejsze pomysły
- Interakcja w tabelach krzyżowych (1951). W krótkim artykule w Journal of the Royal Statistical Society Simpson przyjął definicję interakcji drugiego rzędu w tabeli krzyżowej 2 × 2 × 2 podaną przez Bartletta. Na przykładzie pokazał jednak, że brak takiej interakcji nie uprawnia do mechanicznego zsumowania danych do tabel 2 × 2 i testowania każdej z nich osobno (Simpson, 1951). Zjawisko odwrócenia związku po zsumowaniu tabel nazwano później jego nazwiskiem (Erskine, 2019).
- Miara różnorodności (1949). W liście do Nature zaproponował miarę różnorodności zbiorowości, znaną dziś jako indeks Simpsona (Erskine, 2019). W najprostszej postaci to prawdopodobieństwo, że dwa losowo wybrane osobniki należą do tej samej kategorii – im jest mniejsze, tym zbiorowość bardziej zróżnicowana. Bliskimi krewnymi tej miary są indeks Giniego i entropia Shannona.
- Kryptoanaliza. Zespół JN-25 pod jego kierunkiem – w końcu ok. 40 osób – zdejmował z przechwyconych depesz losowe „dodatki” nakładane na pięciocyfrowe grupy kodowe i statystycznie oceniał, które kandydujące dodatki są prawdziwe, a które przypadkowe. Po wojnie napisał dwie oficjalne historie tych prac (Erskine, 2019).
Ciekawostka
Indeks różnorodności z 1949 r. wyrósł – według nekrologu w Journal of the Royal Statistical Society – z pracy w Bletchley Park, tyle że Simpson nie mógł o tym napisać ze względu na tajemnicę wojskową. O tym, że indeks nosi jego nazwisko, dowiedział się dopiero po 50 latach i uważał to za dziwne, bo istniała już nazwa „charakterystyka Yule’a” (Erskine, 2019).
Ten sam nekrolog odnotowuje, że w 1956 r., podczas dziewięciomiesięcznego stypendium Harknessa w USA, Simpson w Waszyngtonie opowiadał senatorowi Johnowi F. Kennedy’emu o brytyjskiej oświacie (Erskine, 2019).
Przykład na historycznych danych
Paradoks Simpsona najłatwiej zrozumieć na prawdziwych liczbach. Zbiór Titanic z pakietu datasets to tabela 2201 osób na pokładzie: klasa (1., 2., 3., załoga), płeć, wiek (dziecko, dorosły) i to, czy przeżyły. Według pliku pomocy dane zebrała brytyjska komisja Board of Trade badająca katastrofę, a zbiór opracował Dawson (1995); źródła pierwotne nie zgadzają się co do dokładnych liczb. Hasło o paradoksie i wpis z wizualizacjami używają danych fikcyjnych; tu porównujemy załogę z 3. klasą.
Łącznie przeżyło 24.0% członków załogi i 25.2% pasażerów 3. klasy – załoga wypada odrobinę gorzej (iloraz szans przeżycia 0.93). Wśród mężczyzn jest odwrotnie: 22.3% w załodze wobec 17.3% w 3. klasie. Wśród kobiet też: 87.0% wobec 45.9%. Załoga wygrywa w obu podgrupach, a przegrywa w sumie. Powód to skład grup: kobiety stanowiły 2.6% załogi i 27.8% pasażerów 3. klasy, a kobiety przeżywały znacznie częściej. Odsetek łączny jest średnią ważoną odsetków kobiet i mężczyzn, więc zależy od tych udziałów. Iloraz szans Mantela–Haenszela, liczony w warstwach płci (test CMH), wynosi 1.55, 95% CI [1.19, 2.04]. Gdyby obie grupy miały ten sam skład płci (łączny skład obu grup), przeżyłoby 31.2% załogi i 21.2% pasażerów 3. klasy. To nasza analiza – Simpson tych danych nie analizował.
Na rysunku
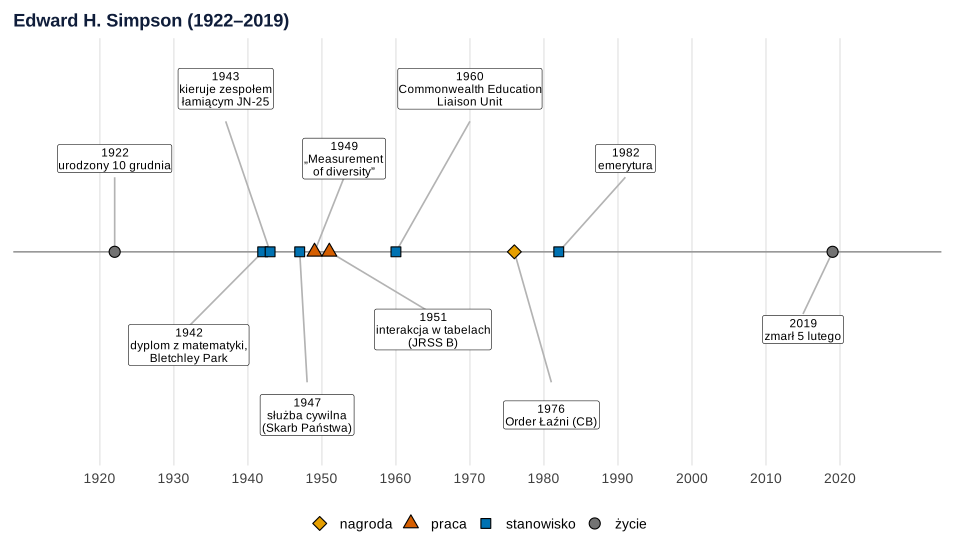
Co widać. Cały dorobek statystyczny Simpsona mieści się w dziesięcioleciu 1942–1951: kryptoanaliza, a zaraz potem dwie krótkie publikacje. Kolejne kwadraty to już kariera w administracji oświatowej.
Na co uważać. To wybór dziesięciu zdarzeń. Etykiety przesunięto w bok, żeby się nie nakładały – rok wskazuje punkt na osi, nie ramka.
Podpis do pracy:
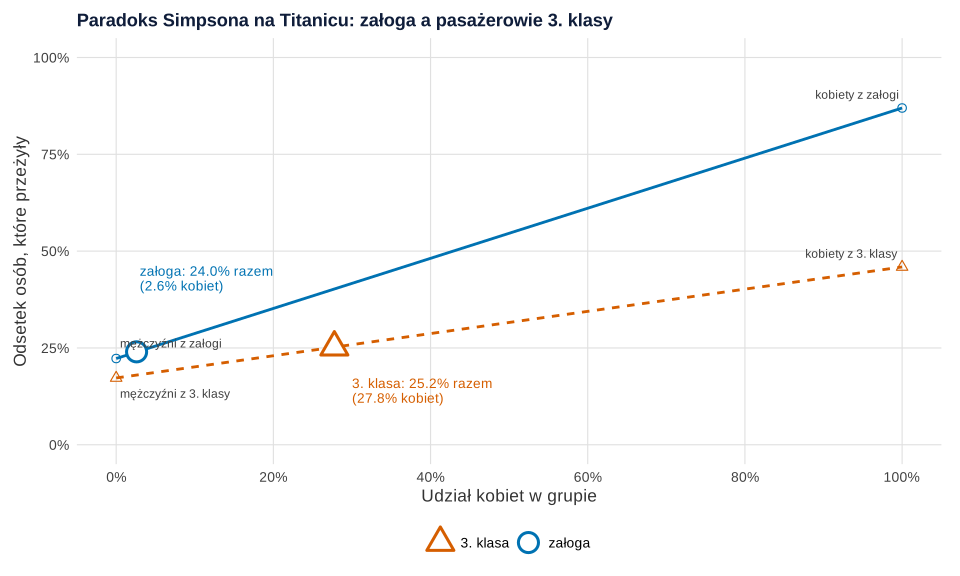
datasets::Titanic (Dawson, 1995, według pliku pomocy). Rysunek: R, pakiet ggplot2.Co widać. Każda linia to wszystkie możliwe odsetki łączne danej grupy przy różnym udziale kobiet: lewy koniec to sami mężczyźni, prawy – same kobiety. Linia załogi leży nad linią 3. klasy na całej długości, czyli przy tym samym składzie załoga zawsze wypadałaby lepiej. Duże symbole stoją jednak w różnych miejscach osi: załoga przy 2.6% kobiet, 3. klasa przy 27.8%. Dlatego trójkąt 3. klasy wypada odrobinę wyżej niż koło załogi.
Na co uważać. W załodze było tylko 23 kobiety, więc prawy koniec niebieskiej linii jest niepewny. Wykres pomija wiek: w 3. klasie podróżowało 79 dzieci, w załodze nie było żadnego. Nie mówi też, dlaczego płeć różnicowała szanse przeżycia – której liczbie wierzyć, rozstrzyga wiedza o przyczynach, a nie sam wykres (por. zmienna zakłócająca, diagram przyczynowy).
Podpis do pracy:
Gdzie spotkasz Simpsona w swojej pracy
- Tabele krzyżowe z trzecią zmienną. Zanim zsumujesz tabelę po płci, wieku czy ośrodku, porównaj odsetki w warstwach. Jeśli się różnią, podaj wynik warstwowy, np. iloraz szans Mantela–Haenszela.
- Porównania grup w badaniach obserwacyjnych. Różny skład porównywanych grup to najczęstsza przyczyna paradoksu. Pomaga standaryzacja do wspólnego składu albo model z kowariantami.
- Wnioski między poziomami. Związek w całej populacji nie musi obowiązywać w podgrupach ani u pojedynczych osób (Kievit i in., 2013) – to bliski krewny błędu ekologicznego.
Spory, mity i trudne strony
„Simpson odkrył paradoks”. Nie jako pierwszy. Kievit i in. (2013) przypominają, że tę samą obserwację – mniej wprost – poczynili wcześniej Karl Pearson ze współpracownikami (1899) i George Udny Yule (1903). Stąd nazwa „efekt Yule’a–Simpsona”. Nazwisko Simpsona przylgnęło do zjawiska później; kto użył go pierwszy, wykracza poza źródła tego hasła.
„Paradoks to błąd w danych”. Liczby są poprawne: odsetek łączny i odsetki w warstwach odpowiadają na różne pytania. Sama statystyka nie rozstrzyga, która odpowiedź jest właściwa – potrzebna jest wiedza o tym, czy trzecia zmienna jest zakłócająca, czy leży na drodze przyczynowej (Kievit i in., 2013).
Simpson w R
Kod rysuje oś czasu, liczy odsetki przeżyć w załodze i w 3. klasie w warstwach płci i łącznie, skład grup, iloraz szans łączny i Mantela–Haenszela oraz odsetki standaryzowane do wspólnego składu płci. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Oś czasu i paradoks Simpsona na danych Titanic
Kod R rysunków 1 i 2
# Edward Simpson: oś czasu i paradoks Simpsona na danych Titanic (załoga vs pasażerowie 3. klasy)
suppressPackageStartupMessages(library(ggplot2))
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (daty według nekrologu: Erskine 2019)
zdarzenia <- data.frame(
  rok = c(1922, 1942, 1943, 1947, 1949, 1951, 1960, 1976, 1982, 2019),
  opis = c("urodzony 10 grudnia", "dyplom z matematyki,\nBletchley Park", "kieruje zespołem\nłamiącym JN-25",
           "służba cywilna\n(Skarb Państwa)", "„Measurement\nof diversity”", "interakcja w tabelach\n(JRSS B)",
           "Commonwealth Education\nLiaison Unit", "Order Łaźni (CB)", "emerytura", "zmarł 5 lutego"),
  rodzaj = c("życie", "stanowisko", "stanowisko", "stanowisko", "praca", "praca", "stanowisko", "nagroda",
             "stanowisko", "życie"))
zdarzenia$y <- c(1.2, -1.2, 2.1, -2.1, 1.2, -1, 2.1, -2.1, 1.2, -1)           # wysokość etykiet
zdarzenia$x_etykiety <- c(1922, 1932, 1937, 1948, 1953, 1965, 1970, 1981, 1991, 2015)  # przesunięcie, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = x_etykiety, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(x = x_etykiety, y = y, label = paste0(rok, "\n", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "stanowisko" = 22, "praca" = 24, "nagroda" = 23), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "stanowisko" = oi[["niebieski"]], "praca" = oi[["cynober"]],
                               "nagroda" = oi[["pomaranczowy"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1920, 2020, 10), limits = c(1914, 2028)) + scale_y_continuous(limits = c(-2.5, 2.5)) +
  labs(title = "Edward H. Simpson (1922–2019)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: 2201 osób na pokładzie Titanica (klasa, płeć, wiek, przeżycie), Dawson 1995
data(Titanic, package = "datasets")
tab <- apply(Titanic, c(1, 2, 4), sum)[c("Crew", "3rd"), , ]          # klasa × płeć × przeżycie
dimnames(tab)$Class <- c("załoga", "3. klasa")
dimnames(tab)$Sex <- c("mężczyźni", "kobiety")
ftable(tab, row.vars = 1:2)
# Odsetek przeżyć w podgrupach płci i łącznie
w_podgrupach <- round(100 * prop.table(tab, c(1, 2))[, , "Yes"], 1)
lacznie <- round(100 * prop.table(apply(tab, c(1, 3), sum), 1)[, "Yes"], 1)
cbind(w_podgrupach, razem = lacznie)
# Skład grup: udział kobiet w załodze i w 3. klasie
sklad <- prop.table(apply(tab, 1:2, sum), 1)[, "kobiety"]
round(100 * sklad, 1)
# Iloraz szans przeżycia (załoga vs 3. klasa): łącznie i w warstwach płci (Mantel–Haenszel)
t2 <- apply(tab, c(1, 3), sum)
or_lacznie <- (t2["załoga", "Yes"] * t2["3. klasa", "No"]) / (t2["załoga", "No"] * t2["3. klasa", "Yes"])
round(or_lacznie, 2)
mh <- mantelhaen.test(aperm(tab, c(1, 3, 2))[, c("Yes", "No"), ])   # warstwy = płeć
round(c(OR_MH = unname(mh$estimate), dolna = mh$conf.int[1], gorna = mh$conf.int[2]), 2)
# Standaryzacja: odsetek przeżyć, gdyby obie grupy miały ten sam skład płci (łączny skład obu grup)
w_wspolny <- prop.table(apply(tab, 2, sum))
round(100 * drop(prop.table(tab, c(1, 2))[, , "Yes"] %*% w_wspolny), 1)

# Rysunek: odsetek łączny = średnia ważona odsetków kobiet i mężczyzn (wagą jest udział kobiet)
p_m <- prop.table(tab, c(1, 2))[, "mężczyźni", "Yes"]; p_k <- prop.table(tab, c(1, 2))[, "kobiety", "Yes"]
linie <- do.call(rbind, lapply(names(p_m), function(g) data.frame(grupa = g, udzial = c(0, 1), odsetek = 100 * c(p_m[g], p_k[g]))))
punkty <- data.frame(grupa = names(sklad), udzial = unname(sklad), odsetek = unname(lacznie))
p_metoda <- ggplot(linie, aes(udzial, odsetek, colour = grupa, linetype = grupa)) +
  geom_line(linewidth = 1) +
  geom_point(aes(shape = grupa), size = 2.6) +
  geom_point(data = punkty, aes(shape = grupa), size = 6, stroke = 1.6, fill = "white") +
  geom_text(data = punkty, aes(x = c(0.03, 0.30), y = c(43, 14),
            label = paste0(grupa, ": ", sprintf("%.1f", odsetek), "% razem\n(", sprintf("%.1f", 100 * udzial), "% kobiet)")),
            hjust = 0, size = 3.6, lineheight = 0.9, show.legend = FALSE) +
  annotate("text", x = 0.005, y = 100 * p_m + c(4, -4), label = c("mężczyźni z załogi", "mężczyźni z 3. klasy"),
           hjust = 0, size = 3.2, colour = "grey25") +
  annotate("text", x = 0.995, y = 100 * p_k + 3.5, label = c("kobiety z załogi", "kobiety z 3. klasy"),
           hjust = 1, size = 3.2, colour = "grey25") +
  scale_colour_manual(values = c("załoga" = oi[["niebieski"]], "3. klasa" = oi[["cynober"]]), name = NULL) +
  scale_linetype_manual(values = c("załoga" = "solid", "3. klasa" = "22"), name = NULL) +
  scale_shape_manual(values = c("załoga" = 21, "3. klasa" = 24), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%"), breaks = seq(0, 1, 0.2)) +
  scale_y_continuous(limits = c(0, 100), labels = function(x) paste0(x, "%")) +
  labs(title = "Paradoks Simpsona na Titanicu: załoga a pasażerowie 3. klasy",
       x = "Udział kobiet w grupie", y = "Odsetek osób, które przeżyły") +
  motyw + theme(legend.position = "bottom")
p_os
p_metoda
Wynik w R
                   Survived  No Yes
Class    Sex
załoga   mężczyźni          670 192
         kobiety              3  20
3. klasa mężczyźni          422  88
         kobiety            106  90
         mężczyźni kobiety razem
załoga        22.3    87.0  24.0
3. klasa      17.3    45.9  25.2
  załoga 3. klasa
     2.6     27.8
[1] 0.93
OR_MH dolna gorna
 1.55  1.19  2.04
  załoga 3. klasa
    31.2     21.2
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tabele i odsetki – funkcje bazowe apply(), prop.table(), ftable(); iloraz szans Mantela–Haenszela – mantelhaen.test(); rysunki – pakiet ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Kim był Edward Simpson?
Brytyjskim statystykiem i urzędnikiem (1922–2019). W czasie wojny łamał szyfry w Bletchley Park – mając 20 lat, kierował zespołem pracującym nad japońskim kodem JN-25. Po wojnie zaczął doktorat w Cambridge, ale w 1947 r. przeszedł do służby cywilnej i większość kariery spędził w brytyjskim ministerstwie oświaty.
Dlaczego paradoks nazywa się paradoksem Simpsona?
Bo zjawisko kojarzy się z jego artykułem z 1951 r. w Journal of the Royal Statistical Society. Pokazał w nim na przykładzie tabeli 2 × 2 × 2, że mechaniczne sumowanie tabel krzyżowych może prowadzić do mylnych wniosków. Nazwę nadali zjawisku później inni autorzy.
Czy Simpson pierwszy opisał paradoks Simpsona?
Nie. Podobną obserwację – mniej wprost – poczynili wcześniej Karl Pearson ze współpracownikami (1899) i George Udny Yule (1903). Dlatego używa się też nazwy efekt Yule’a–Simpsona.
Co to jest indeks Simpsona?
Miara różnorodności zaproponowana przez Simpsona w 1949 r. w Nature. Opiera się na prawdopodobieństwie, że dwa losowo wybrane osobniki należą do tej samej kategorii: im jest mniejsze, tym zbiorowość bardziej zróżnicowana. Według nekrologu pomysł wyrósł z jego pracy w Bletchley Park.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dawson, R. J. M. (1995). The “unusual episode” data revisited. Journal of Statistics Education, 3(3). https://doi.org/10.1080/10691898.1995.11910499 ● Otwarty dostęp
- Erskine, R. (2019). Edward Hugh Simpson, 1922–2019. Journal of the Royal Statistical Society: Series A (Statistics in Society), 182(4), 1633–1634. https://doi.org/10.1111/rssa.12514 ● Otwarty dostęp
- Kievit, R. A., Frankenhuis, W. E., Waldorp, L. J., & Borsboom, D. (2013). Simpson's paradox in psychological science: A practical guide. Frontiers in Psychology, 4, Article 513. https://doi.org/10.3389/fpsyg.2013.00513 ● Otwarty dostęp
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
Cytowania BibTeX
@article{dawson1995unusual, author={Dawson, Robert J. MacG.}, title={{The “unusual episode” data revisited}}, journal={Journal of Statistics Education}, year={1995}, volume={3}, number={3}, doi={10.1080/10691898.1995.11910499}}@article{erskine2019edward, author={Erskine, Ralph}, title={{Edward Hugh Simpson, 1922–2019}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2019}, volume={182}, number={4}, pages={1633--1634}, doi={10.1111/rssa.12514}}@article{kievit2013simpson, author={Kievit, Rogier A. and Frankenhuis, Willem E. and Waldorp, Lourens J. and Borsboom, Denny}, title={{Simpson's paradox in psychological science: A practical guide}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={513}, doi={10.3389/fpsyg.2013.00513}}@article{simpson1951interpretation, author={Simpson, E. H.}, title={{The interpretation of interaction in contingency tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1951}, volume={13}, number={2}, pages={238--241}, doi={10.1111/j.2517-6161.1951.tb00088.x}}