Kim był George E. P. Box?
George Edward Pelham Box (1919–2013) był brytyjskim statystykiem przemysłowym i akademickim, który większość kariery spędził w Stanach Zjednoczonych. Jego nazwisko noszą transformacja Boxa–Coxa, test Ljunga–Boxa, test M Boxa i podejście Boxa–Jenkinsa do szeregów czasowych. Wspomnienie biograficzne Royal Society wymienia jako jego główne pola kontrolę jakości, analizę szeregów czasowych i planowanie eksperymentów (Smith, 2015).
Nie miał typowej drogi akademickiej. Szkołę skończył w wieku 16 lat, pracował w oczyszczalni ścieków i zaocznie studiował chemię na Uniwersytecie Londyńskim, ale po wybuchu II wojny światowej wstąpił do wojska i przerwał studia. Po wojnie zrobił licencjat z matematyki i statystyki w University College London. W latach 1948–1956 był statystykiem w koncernie chemicznym Imperial Chemical Industries (ICI), z rocznym pobytem jako profesor wizytujący w North Carolina State University w Raleigh (1953). W 1956 r. objął w Princeton kierownictwo Statistical Techniques Research Group, w 1959 r. przeniósł się na University of Wisconsin–Madison, gdzie w 1960 r. założył wydział statystyki. Na emeryturę przeszedł w 1991 r., zmarł 28 marca 2013 r. (Smith, 2015).
Najważniejsze pomysły
- Szukanie optimum w eksperymencie. Z K. B. Wilsonem opisał, jak doświadczalnie dochodzić do najlepszych warunków procesu (Box i Wilson, 1951) – to początek metody powierzchni odpowiedzi. Pokrewną analizę dla danych z badań ankietowych opisuje wpis Analiza powierzchni odpowiedzi (RSA).
- Transformacje. Z Davidem Coxem zaproponował rodzinę przekształceń zmiennej zależnej, po których model liniowy z normalnymi resztami o stałej wariancji lepiej pasuje do danych (Box i Cox, 1964). W praktyce to transformacja Boxa–Coxa.
- Szeregi czasowe. Książka z Gwilymem Jenkinsem (Box i Jenkins, 1970) uporządkowała budowę modeli ARIMA w cykl: rozpoznanie modelu, estymacja, diagnoza reszt i dopiero potem prognoza. Do diagnozy służy test Ljunga–Boxa (Ljung i Box, 1978) – poprawiona wersja wcześniejszego testu Boxa i Pierce’a.
- Porównywanie macierzy kowariancji. Jego nazwisko nosi test M Boxa, sprawdzany przed MANOVA i analizą dyskryminacyjną.
- Statystyka a nauka. W artykule z 1976 r. opisał metodę naukową jako iterację, w której teoria i praktyka na zmianę się konfrontują, a statystyk ma budować modele oszczędne, ale skuteczne, i martwić się wybiórczo tymi niedopasowaniami, które mają znaczenie. Ilustrował to pracą Ronalda Fishera w Rothamsted (Box, 1976).
Ciekawostka
Do statystyki Box trafił przez gaz musztardowy. Jak podaje wspomnienie Royal Society (Smith, 2015), w wojsku powierzono mu biochemiczne doświadczenia nad skutkami tego gazu bojowego. Szybko zrozumiał, że w takich badaniach najbardziej potrzebna jest wiedza statystyka, a nie chemika – i po wojnie poszedł studiować statystykę.
Wcześniej jego „laboratorium” była miejska oczyszczalnia ścieków: jako szesnastolatek po szkole został asystentem chemika, który nią kierował, i stamtąd zapisał się na zaoczne studia chemiczne. Autor późniejszych prac o planowaniu eksperymentów zaczynał więc od eksperymentów robionych bez statystyki.
Przykład na historycznych danych
Zbiór AirPassengers z pakietu datasets to miesięczna liczba pasażerów międzynarodowych linii lotniczych (w tysiącach) z lat 1949–1960. Plik pomocy nazywa go klasycznymi danymi lotniczymi Boxa i Jenkinsa i podaje jako źródło ich książkę (seria G w wydaniu z 1976 r.). Dopasowujemy do nich tzw. model lotniczy z przykładu w pliku pomocy: logarytm, różnicowanie zwykłe i sezonowe oraz po jednym wyrazie średniej ruchomej w każdej części – ARIMA(0,1,1)(0,1,1)12. To inny model niż wygładzanie wykładnicze Holta–Wintersa, które na tych samych danych pokazuje osobne hasło.
Dlaczego logarytm? Wahania sezonowe rosną z poziomem: w 1949 r. różnica między najlepszym a najgorszym miesiącem wynosiła 44 tys. pasażerów, w 1960 r. – 232 tys. Profil wiarygodności Boxa–Coxa w prostym modelu trendu z miesiącami wskazuje λ = 0.20 (95% przedział 0.11–0.28), czyli przekształcenie nieco łagodniejsze niż logarytm (λ = 0). Zostajemy przy logarytmie, bo daje interpretację w procentach i reszty modelu przechodzą diagnozę. Oszacowania: θ = −0.40 (SE = 0.09) dla części zwykłej i Θ = −0.56 (SE = 0.07) dla sezonowej, wariancja reszt 0.001348. Test Ljunga–Boxa dla 24 opóźnień: Q(22) = 26.45, p = .233 – nie ma podstaw, by odrzucić hipotezę, że reszty są białym szumem. Prognoza na lipiec 1961 r. to 670.0 tys. pasażerów (95% przedział 589.7–761.2), na lipiec 1962 r. – 737.7 tys. (584.3–931.3). Nie twierdzimy, że Box i Jenkins uzyskali dokładnie te liczby – to nasza analiza w ich stylu.
Na rysunku
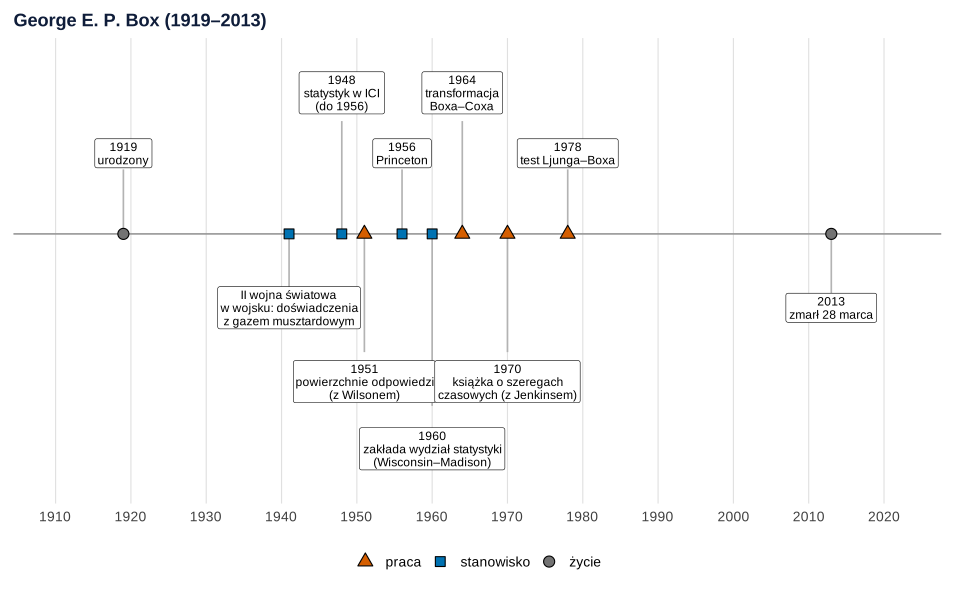
Co widać. Przez pierwsze 30 lat życia Box nie był statystykiem: oczyszczalnia ścieków, wojsko, studia. Najbardziej znane prace powstały dopiero w przemyśle i na uniwersytecie – od eksperymentów w ICI po szeregi czasowe w Wisconsin.
Na co uważać. Punkt „II wojna światowa” ma datę przybliżoną: źródło mówi tylko, że wstąpił do wojska wkrótce po wybuchu wojny. Rok przy pomyśle to rok publikacji, nie powstania idei.
Podpis do pracy:
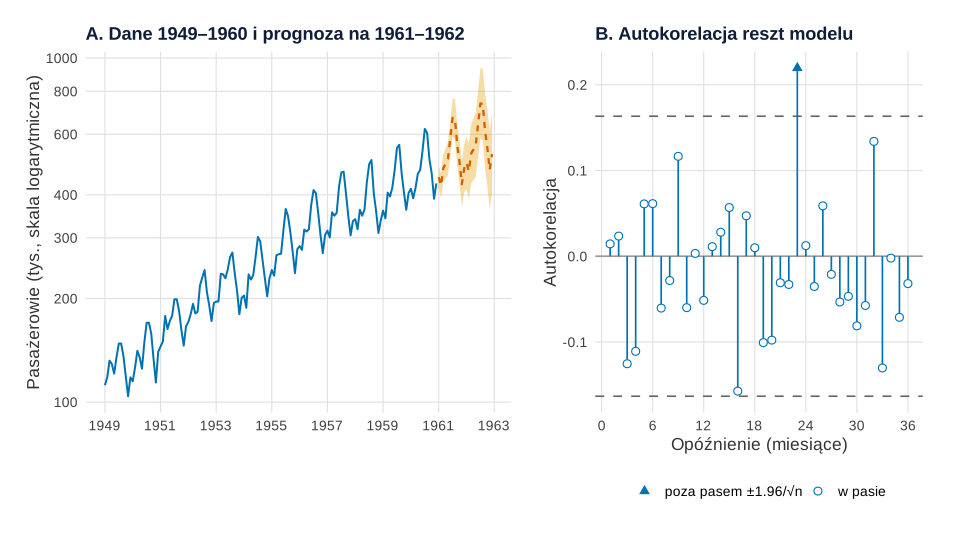
datasets::AirPassengers (seria G z książki Boxa, Jenkinsa i Reinsela, wyd. 3 z 1976 r., według pliku pomocy). Rysunek: R, pakiety ggplot2 i patchwork.Co widać. Na panelu A model przedłuża trend i sezonowy wzór; pas niepewności rośnie z horyzontem – względna szerokość przedziału to 14% prognozy po miesiącu i 55% po dwóch latach. Na panelu B tylko 1 z 36 autokorelacji reszt wychodzi poza pas ±1.96/√n, czyli mniej więcej tyle, ile przy 5% oczekiwalibyśmy przypadkiem.
Na co uważać. Prognoza zakłada, że lata 1961–1962 będą wyglądać jak 1949–1960. Przedział dotyczy tylko losowości modelu, a nie zmian, których model nie zna. Pojedynczy słupek poza pasem (opóźnienie 23) to nie powód do komplikowania modelu – patrz łącznie na test Ljunga–Boxa i wykres.
Podpis do pracy:
Gdzie spotkasz Boxa w swojej pracy
- Analiza szeregów czasowych. Każda praca z modelem ARIMA powtarza cykl Boxa–Jenkinsa: stacjonarność, wybór rzędów, diagnoza autokorelacji reszt. Krok po kroku pokazuje to wpis Szeregi czasowe i ARIMA w praktyce.
- Skośne zmienne zależne. Gdy reszty regresji mają rosnącą wariancję, sięgasz po transformację Boxa–Coxa albo prostszą transformację logarytmiczną.
- MANOVA i analiza dyskryminacyjna. Test M Boxa w wydruku SPSS sprawdza równość macierzy kowariancji w grupach.
- Planowanie eksperymentów. Schematy czynnikowe i powierzchnie odpowiedzi w badaniach przemysłowych i laboratoryjnych.
Spory, mity i trudne strony
„Box powiedział, że modele są bezużyteczne”. Przeciwnie. Z Boxem kojarzy się myśl, że wszystkie modele są błędne, ale niektóre użyteczne; w cytowanym tu artykule z 1976 r. przekonywał, że trzeba budować modele oszczędne i martwić się tylko tymi niedopasowaniami, które mają znaczenie (Box, 1976). Dokładnego brzmienia i pierwszego wystąpienia powiedzenia w naszych źródłach nie sprawdziliśmy, więc go nie cytujemy.
„Box–Jenkins to automatyczny dobór modelu”. Funkcje typu auto.arima() automatyzują wybór rzędów, ale podejście Boxa i Jenkinsa to cykl, w którym badacz sam ogląda reszty i poprawia model.
„Box–Cox zawsze wskaże logarytm”. Na danych lotniczych profil wiarygodności wskazał λ = 0.20, nie 0. Wybór logarytmu to decyzja interpretacyjna, którą warto uzasadnić w pracy.
Box w R
Kod rysuje oś czasu, liczy profil Boxa–Coxa, dopasowuje model lotniczy ARIMA(0,1,1)(0,1,1)12, wykonuje test Ljunga–Boxa i prognozuje 24 miesiące naprzód. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Oś czasu i model lotniczy na danych AirPassengers
Kod R rysunków 1 i 2
# George E. P. Box: oś czasu i model „lotniczy” ARIMA(0,1,1)(0,1,1)[12] na danych AirPassengers
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Smitha 2015 oraz dat publikacji cytowanych prac)
zdarzenia <- data.frame(
  rok = c(1919, 1941, 1948, 1951, 1956, 1960, 1964, 1970, 1978, 2013),
  opis = c("urodzony", "w wojsku: doświadczenia\nz gazem musztardowym", "statystyk w ICI\n(do 1956)",
           "powierzchnie odpowiedzi\n(z Wilsonem)", "Princeton", "zakłada wydział statystyki\n(Wisconsin–Madison)",
           "transformacja\nBoxa–Coxa", "książka o szeregach\nczasowych (z Jenkinsem)", "test Ljunga–Boxa",
           "zmarł 28 marca"),
  rodzaj = c("życie", "stanowisko", "stanowisko", "praca", "stanowisko", "stanowisko", "praca", "praca", "praca", "życie"))
zdarzenia$etykieta <- ifelse(zdarzenia$rok == 1941, "II wojna światowa", zdarzenia$rok)   # data przybliżona
zdarzenia$y <- c(1.2, -1.1, 2.1, -2.2, 1.2, -3.2, 2.1, -2.2, 1.2, -1.1)   # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(etykieta, "\n", opis)), size = 3.2, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "stanowisko" = 22, "praca" = 24), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "stanowisko" = oi[["niebieski"]], "praca" = oi[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1910, 2020, 10), limits = c(1910, 2022)) + scale_y_continuous(limits = c(-3.7, 2.6)) +
  labs(title = "George E. P. Box (1919–2013)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: miesięczna liczba pasażerów międzynarodowych linii lotniczych (tys.), 1949–1960 – seria G Boxa i Jenkinsa
data(AirPassengers, package = "datasets")
y <- AirPassengers
# Rozrzut sezonowy rośnie z poziomem: rozstęp w roku 1949 i 1960 (tys. pasażerów)
c(rok1949 = diff(range(window(y, 1949, c(1949, 12)))), rok1960 = diff(range(window(y, 1960, c(1960, 12)))))
# Box–Cox: profil wiarygodności λ w prostym modelu trend + miesiąc
d <- data.frame(pasazerowie = as.numeric(y), t = seq_along(y), miesiac = factor(cycle(y)))
bc <- MASS::boxcox(lm(pasazerowie ~ t + miesiac, data = d), lambda = seq(-1, 1, 0.01), plotit = FALSE)
c(lambda_max = bc$x[which.max(bc$y)], range(bc$x[bc$y > max(bc$y) - qchisq(0.95, 1) / 2]))
# Model „lotniczy”: logarytm, różnica zwykła i sezonowa, po jednym wyrazie MA w każdej części
model <- arima(log(y), order = c(0, 1, 1), seasonal = list(order = c(0, 1, 1), period = 12))
model
# Diagnoza: czy reszty są białym szumem? Test Ljunga–Boxa dla 24 opóźnień (2 parametry modelu)
reszty <- residuals(model)
Box.test(reszty, lag = 24, type = "Ljung-Box", fitdf = 2)
# Prognoza na 1961–1962 z 95% przedziałem, z powrotem w tysiącach pasażerów
pr <- predict(model, n.ahead = 24)
prognoza <- data.frame(czas = as.numeric(time(pr$pred)), prognoza = exp(pr$pred),
                       dolna = exp(pr$pred - 1.96 * pr$se), gorna = exp(pr$pred + 1.96 * pr$se))
round(prognoza[c(1, 7, 12, 19, 24), ], 1)
# Szerokość przedziału względem prognozy: po 1 i po 24 miesiącach
round(with(prognoza[c(1, 24), ], (gorna - dolna) / prognoza), 3)

dane <- data.frame(czas = as.numeric(time(y)), pasazerowie = as.numeric(y))
p_szereg <- ggplot() +
  geom_ribbon(data = prognoza, aes(czas, ymin = dolna, ymax = gorna), fill = oi[["pomaranczowy"]], alpha = 0.35) +
  geom_line(data = dane, aes(czas, pasazerowie), colour = oi[["niebieski"]], linewidth = 0.7) +
  geom_line(data = prognoza, aes(czas, prognoza), colour = oi[["cynober"]], linewidth = 0.8, linetype = "22") +
  scale_y_log10(breaks = c(100, 200, 300, 400, 600, 800, 1000)) + scale_x_continuous(breaks = seq(1949, 1963, 2)) +
  labs(title = "A. Dane 1949–1960 i prognoza na 1961–1962", x = NULL,
       y = "Pasażerowie (tys., skala logarytmiczna)") + motyw
acf_r <- acf(reszty, lag.max = 36, plot = FALSE)
acf_df <- data.frame(opoznienie = round(acf_r$lag[-1] * 12), r = acf_r$acf[-1])
granica <- 1.96 / sqrt(length(reszty))
acf_df$poza <- ifelse(abs(acf_df$r) > granica, "poza pasem ±1.96/√n", "w pasie")
table(acf_df$poza)
round(granica, 3)
acf_df[acf_df$opoznienie %in% c(1, 12, 24) | acf_df$poza != "w pasie", ]
p_acf <- ggplot(acf_df, aes(opoznienie, r)) +
  geom_hline(yintercept = c(-granica, granica), linetype = "dashed", colour = "grey40") +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = opoznienie, yend = 0), colour = oi[["niebieski"]]) +
  geom_point(aes(shape = poza), size = 2.4, colour = oi[["niebieski"]], fill = "white") +
  scale_shape_manual(values = c("poza pasem ±1.96/√n" = 17, "w pasie" = 21), name = NULL) +
  scale_x_continuous(breaks = seq(0, 36, 6)) +
  labs(title = "B. Autokorelacja reszt modelu", x = "Opóźnienie (miesiące)", y = "Autokorelacja") +
  motyw + theme(legend.position = "bottom")
p_metoda <- p_szereg + p_acf + plot_layout(widths = c(1.3, 1))
p_os
p_metoda
Wynik w R
rok1949 rok1960
     44     232
lambda_max
      0.20       0.11       0.28

Call:
arima(x = log(y), order = c(0, 1, 1), seasonal = list(order = c(0, 1, 1), period = 12))

Coefficients:
          ma1     sma1
      -0.4018  -0.5569
s.e.   0.0896   0.0731

sigma^2 estimated as 0.001348:  log likelihood = 244.7,  aic = -483.4

	Box-Ljung test

data:  reszty
X-squared = 26.446, df = 22, p-value = 0.233

     czas prognoza dolna gorna
1  1961.0    450.4 419.1 484.0
7  1961.5    670.0 589.7 761.2
12 1961.9    477.2 406.7 560.0
19 1962.5    737.7 584.3 931.3
24 1962.9    525.5 400.6 689.3
[1] 0.144 0.549

poza pasem ±1.96/√n             w pasie
                  1                  35
[1] 0.163
   opoznienie           r                poza
1           1  0.01443882             w pasie
12         12 -0.05146339             w pasie
23         23  0.21962228 poza pasem ±1.96/√n
24         24  0.01236360             w pasie
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (model ARIMA, prognoza i test Ljunga–Boxa – funkcje bazowe arima(), predict(), Box.test(), acf(); profil Boxa–Coxa – MASS::boxcox(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był George Box?
Brytyjskim statystykiem (1919–2013), który większość kariery spędził w USA. Po wojnie skończył matematykę i statystykę w University College London, pracował w koncernie chemicznym ICI, krótko w Princeton, a od 1959 r. na University of Wisconsin–Madison, gdzie w 1960 r. założył wydział statystyki.
Co wymyślił George Box?
Najbardziej znane są: transformacja Boxa–Coxa (1964, wspólnie z Davidem Coxem), podejście Boxa–Jenkinsa do budowy modeli ARIMA (książka z 1970 r.), test Ljunga–Boxa do diagnozy reszt (1978, wspólnie z Gretą Ljung), metoda powierzchni odpowiedzi (1951, wspólnie z K. B. Wilsonem) i test M Boxa równości macierzy kowariancji.
Co to jest model Boxa–Jenkinsa?
To podejście do modeli ARIMA opisane przez Boxa i Jenkinsa w 1970 r.: najpierw rozpoznajesz rzędy modelu z wykresów autokorelacji, potem szacujesz parametry, sprawdzasz reszty (np. testem Ljunga–Boxa) i dopiero dobry model używasz do prognozy. Gdy reszty nie są białym szumem, wracasz do pierwszego kroku.
Skąd pochodzą dane AirPassengers?
Według pliku pomocy R to klasyczne dane lotnicze Boxa i Jenkinsa – miesięczna liczba pasażerów międzynarodowych linii lotniczych w latach 1949–1960 (w tysiącach), seria G w ich książce o szeregach czasowych. Na tych danych pokazuje się tzw. model lotniczy ARIMA(0,1,1)(0,1,1)12 na logarytmie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Box, G. E. P. (1976). Science and statistics. Journal of the American Statistical Association, 71(356), 791–799. https://doi.org/10.1080/01621459.1976.10480949
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Box, G. E. P., & Jenkins, G. M. (1970). Time series analysis: Forecasting and control. Holden-Day.
- Box, G. E. P., & Wilson, K. B. (1951). On the experimental attainment of optimum conditions. Journal of the Royal Statistical Society: Series B (Methodological), 13(1), 1–38. https://doi.org/10.1111/j.2517-6161.1951.tb00067.x
- Ljung, G. M., & Box, G. E. P. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297–303. https://doi.org/10.1093/biomet/65.2.297
- Smith, A. F. M. (2015). George Edward Pelham Box. 10 October 1919 — 28 March 2013. Biographical Memoirs of Fellows of the Royal Society, 61, 23–37. https://doi.org/10.1098/rsbm.2015.0015 ● Otwarty dostęp
Cytowania BibTeX
@article{box1976science, author={Box, George E. P.}, title={{Science and statistics}}, journal={Journal of the American Statistical Association}, year={1976}, volume={71}, number={356}, pages={791--799}, doi={10.1080/01621459.1976.10480949}}@article{box1964analysis, author={Box, George E. P. and Cox, David R.}, title={{An analysis of transformations}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1964}, volume={26}, number={2}, pages={211--243}, doi={10.1111/j.2517-6161.1964.tb00553.x}}@book{box1970time, author={Box, George E. P. and Jenkins, Gwilym M.}, title={{Time series analysis: Forecasting and control}}, year={1970}, publisher={Holden-Day}, url={https://openlibrary.org/books/OL4564956M}}@article{box1951experimental, author={Box, G. E. P. and Wilson, K. B.}, title={{On the experimental attainment of optimum conditions}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1951}, volume={13}, number={1}, pages={1--38}, doi={10.1111/j.2517-6161.1951.tb00067.x}}@article{ljung1978measure, author={Ljung, Greta M. and Box, George E. P.}, title={{On a measure of lack of fit in time series models}}, journal={Biometrika}, year={1978}, volume={65}, number={2}, pages={297--303}, doi={10.1093/biomet/65.2.297}}@article{smith2015george, author={Smith, A. F. M.}, title={{George Edward Pelham Box. 10 October 1919 — 28 March 2013}}, journal={Biographical Memoirs of Fellows of the Royal Society}, year={2015}, volume={61}, pages={23--37}, doi={10.1098/rsbm.2015.0015}}