Czym jest TSES
TSES (Teachers’ Sense of Efficacy Scale) mierzy poczucie skuteczności nauczyciela, czyli przekonanie, że potrafi on poradzić sobie z typowymi zadaniami w klasie. Skalę opracowały Megan Tschannen-Moran i Anita Woolfolk Hoy. W artykule z 2001 roku autorki przejrzały wcześniejsze miary skuteczności nauczyciela i wskazały ich słabości. Zaproponowały nową skalę, wtedy nazwaną Ohio State Teacher Efficacy Scale, i przedstawiły dane o jej trafności i rzetelności z trzech badań (Tschannen-Moran i Woolfolk Hoy, 2001). Na stronie autorki skala występuje już jako TSES i tej nazwy autorki wolą używać (Woolfolk Hoy, b.d.).
TSES najczęściej pojawia się w pracach z pedagogiki, psychologii edukacji i dydaktyk przedmiotowych. Typowe pytania badawcze to porównanie nauczycieli o różnym stażu, związek poczucia skuteczności z wypaleniem albo satysfakcją z pracy oraz zmiana u studentów po praktykach. Ogólny plan analiz w takich pracach opisuje wpis statystyka w pracy z pedagogiki, a w pracach psychologicznych – statystyka dla psychologa. TSES nie jest skalą ogólnej własnej skuteczności. Jeśli badasz przekonania niezwiązane z nauczaniem, zajrzyj do wpisu o skali GSE.
Budowa: 24 albo 12 pozycji i trzy podskale
Pełna wersja TSES ma 24 pozycje, a krótka 12. Obie mierzą trzy powiązane obszary (Woolfolk Hoy, b.d.):
| Podskala | Przekonanie, że nauczyciel potrafi… | Pozycje: długa / krótka | α autorek: długa / krótka |
|---|---|---|---|
| Zaangażowanie uczniów | zaangażować uczniów w naukę | 8 / 4 | .87 / .81 |
| Strategie nauczania | skutecznie dobierać i stosować metody nauczania | 8 / 4 | .91 / .86 |
| Zarządzanie klasą | kierować klasą i utrzymywać w niej porządek | 8 / 4 | .90 / .86 |
| Wynik ogólny | wszystkie trzy obszary łącznie | 24 / 12 | .94 / .90 |
Druga kolumna to nasze ogólne streszczenie nazw podskal, a nie brzmienie pozycji. Pozycje mają postać pytań o to, ile nauczyciel jest w stanie zrobić w danej sytuacji. Odpowiedź zaznacza się na 9-stopniowej skali od 1 („nic”) do 9 („bardzo dużo”). Tak opisują oryginał Salas-Rodríguez i in. (2021). Opisy pośrednich stopni sprawdź w formularzu autorek. Alfy w tabeli pochodzą z badania z 2001 roku i są podane na stronie autorki (Woolfolk Hoy, b.d.). Formularze obu wersji i instrukcję punktowania pobierzesz z tej strony. Numerów pozycji należących do podskal nie podajemy. Weź je z instrukcji autorek, bo pozycje podskal są w formularzu wymieszane.
Jak policzyć wynik TSES krok po kroku
Krok 1. Sprawdź kodowanie 1–9
W danych powinny być tylko liczby od 1 do 9. Formularz online może zapisać odpowiedzi jako 0–8 albo jako tekst kotwicy. Wtedy przekoduj je przed liczeniem. W opisie TSES na stronie autorki nie ma pozycji odwróconych. Instrukcja odwracania pozycji dotyczy tam starszej skali TES. Sprawdź to jednak w instrukcji punktowania wersji, której używasz.
Krok 2. Policz średnią pozycji każdej podskali
Autorki liczą wynik podskali jako nieważoną średnią pozycji, które ładują dany czynnik (Woolfolk Hoy, b.d.). Średnia zostaje na skali odpowiedzi, więc wynik 7 znaczy przeciętną odpowiedź „7” w danej podskali. Sumy nie są błędem, ale utrudniają porównanie z literaturą, w której podaje się średnie. Pojedynczy wynik sprawdzisz w kalkulatorze wyniku skali.
Krok 3. Wynik ogólny
Wynik ogólny to średnia wszystkich pozycji. Każda podskala ma tyle samo pozycji, więc to samo daje średnia trzech podskal, jak opisują to Salas-Rodríguez i in. (2021). Kiedy używać wyniku ogólnego, a kiedy podskal, wyjaśnia hasło podskala i wynik ogólny.
Krok 4. Ustal regułę dla braków przed analizą
Strona autorki nie podaje reguły dla braków odpowiedzi. Ustal ją sam(a) przed analizą i opisz w pracy. Przykładowa reguła to średnia z dostępnych pozycji, gdy w podskali brakuje najwyżej jednej. To jednak decyzja badacza, a nie zasada autorek. Inne podejścia omawia wpis braki danych w ankiecie.
Interpretacja: podskale czy wynik ogólny?
Wyższy wynik oznacza silniejsze przekonanie o własnej skuteczności. TSES nie ma progów ani kategorii typu „niski” czy „wysoki” i nie ma polskich norm. Średnie z tabeli autorek, ok. 7 na skali 1–9, pochodzą z próby amerykańskiej. Możesz je przytoczyć jako punkt odniesienia z literatury, ale nie jako normy. Jeśli promotor prosi o poziomy wyników, przeczytaj najpierw wpis niski, przeciętny, wysoki wynik.
Ważniejsza decyzja to wybór między podskalami a wynikiem ogólnym. Zależy on od tego, kogo badasz:
- Czynni nauczyciele. Trzy czynniki są umiarkowanie skorelowane, a ich skład może się nieco różnić między próbami (Woolfolk Hoy, b.d.). Fives i Buehl (2009) potwierdzili strukturę trzech czynników u 102 nauczycieli. Klassen i in. (2009) wykazali inwariancję pomiaru w pięciu krajach i podobny związek TSES z satysfakcją z pracy.
- Studenci i osoby przygotowujące się do zawodu. U nich struktura czynników jest mniej wyraźna. Autorki zalecają więc wynik z całej skali i własną analizę czynnikową (Woolfolk Hoy, b.d.). U 270 przyszłych nauczycieli najlepiej pasował jeden czynnik (Fives i Buehl, 2009). Duffin i in. (2012) uzyskali tak wysokie korelacje czynników, że wsparły one model jednowymiarowy. Osoby bez doświadczenia w nauczaniu nie odróżniają więc obszarów, które TSES rozdziela.
Nowsze analizy dużych prób wskazują silny czynnik ogólny także u czynnych nauczycieli. W próbie 1406 nauczycieli z Chile najlepiej dopasowany był model bifactor ESEM z czynnikiem ogólnym i trzema resztowymi. Skala zachowała przy tym ścisłą inwariancję względem płci (Gálvez-Nieto i in., 2023). Na czym polegają takie modele, wyjaśnia wpis model bifactor i ESEM. W pracy dyplomowej wystarczy zwykle sprawdzić korelacje podskal i dopasowanie CFA.
Przykład: 200 nauczycieli i 150 studentów pedagogiki
Dane są symulowane i możesz je pobrać jako plik CSV. Kolumny z1–z8, s1–s8 i k1–k8 są już nazwane według podskal, a kolumna grupa rozróżnia nauczycieli i studentów. W prawdziwych danych przypiszesz pozycje według instrukcji autorek. Dane są kompletne, więc reguła dla braków nie była potrzebna.
| Wynik (1–9) | Nauczyciele M (SD) | Studenci M (SD) | α [95% CI] | ω |
|---|---|---|---|---|
| Zaangażowanie uczniów | 7.19 (0.93) | 6.70 (1.07) | .90 [.88, .91] | .90 |
| Strategie nauczania | 7.34 (0.97) | 6.64 (1.09) | .92 [.90, .93] | .92 |
| Zarządzanie klasą | 6.93 (0.93) | 6.17 (1.10) | .90 [.89, .92] | .90 |
| Wynik ogólny | 7.15 (0.76) | 6.50 (1.03) | .95 [.94, .96] | .95 |
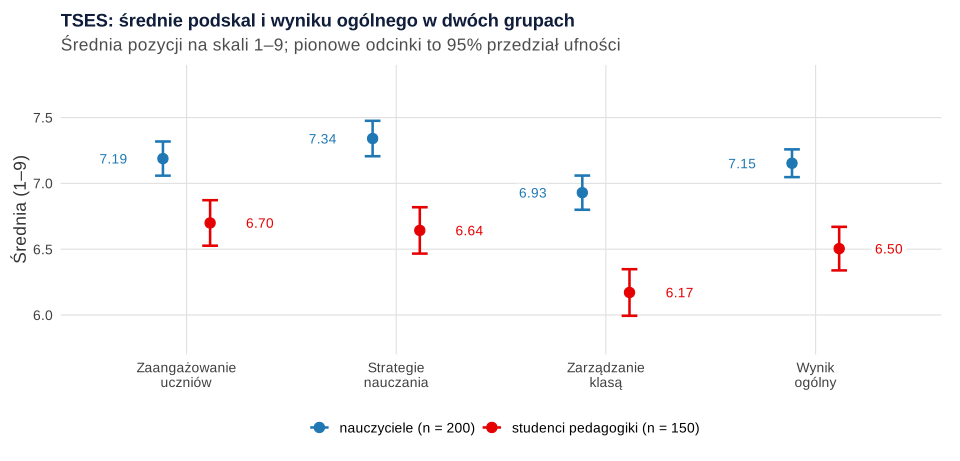
W całej próbie średni wynik ogólny wyniósł 6.87 (SD = 0.94). Rozkłady były lekko lewostronnie skośne (skośność od −0.42 do −0.31), co jest typowe dla skal przekonań o sobie. Najniżej obie grupy oceniły zarządzanie klasą. Różnice między grupami widać na rysunku 1.
Rzetelność
Alfa Cronbacha podskal wyniosła od .90 do .92, a wyniku ogólnego .95. Alfa zakłada równe ładunki pozycji (McNeish, 2018). Dlatego obok niej podaliśmy omegę McDonalda z jednoczynnikowej CFA dla każdej podskali. Tu omegi niemal pokrywają się z alfami, bo w symulacji ładunki pozycji były do siebie zbliżone. Omegę z gotowych ładunków policzysz też w kalkulatorze alfy i omegi. Wysoka alfa wyniku ogólnego nie dowodzi, że skala jest jednowymiarowa. Rośnie ona z liczbą pozycji, a tu jest ich 24.
Struktura w każdej grupie
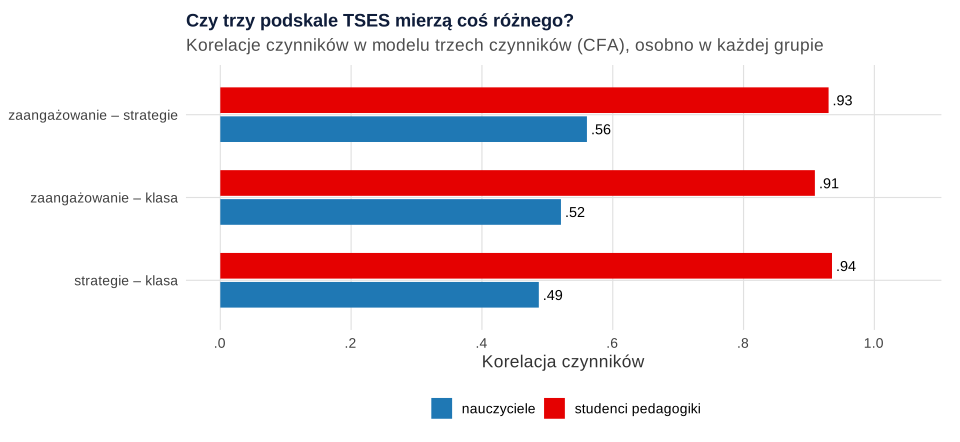
Modele CFA dopasowaliśmy osobno w każdej grupie, bo struktura może się w nich różnić. U nauczycieli model trzech czynników był dobrze dopasowany: χ²(249) = 287.43, CFI = .982, RMSEA = .028, SRMR = .046. Model jednego czynnika pasował źle: χ²(252) = 986.23, CFI = .661, RMSEA = .121. Różnica była istotna, Δχ²(3) = 698.81, p < .001. Korelacje czynników wyniosły od .49 do .56. Trzy podskale niosą tu więc różną informację.
U studentów oba modele były dobrze dopasowane. Model trzech czynników: χ²(249) = 260.28, CFI = .995, RMSEA = .017. Model jednego czynnika: χ²(252) = 315.12, CFI = .972, RMSEA = .041. Test ilorazu wiarygodności także faworyzował trzy czynniki, Δχ²(3) = 54.84, p < .001. Korelacje czynników wyniosły jednak od .91 do .94 (rysunek 2). Tak wysokie korelacje oznaczają, że studenci prawie nie rozróżniają trzech obszarów. To ten sam wzór, który opisali Duffin i in. (2012). Istotny test różnicy dopasowania nie wystarcza więc do raportowania podskal. W tej grupie rozsądniejszy jest wynik ogólny, zgodnie z zaleceniem autorek.
Porównanie grup
Wynik ogólny porównaliśmy testem t Welcha, bo grupy różniły się liczebnością i rozproszeniem. Nauczyciele mieli wyższe poczucie skuteczności niż studenci, t(262.36) = 6.53, p < .001. Różnica średnich wyniosła 0.65 punktu, 95% CI [0.45, 0.84], a d Cohena = 0.74, 95% CI [0.52, 0.96]. Porównanie podskal między grupami ma sens dopiero wtedy, gdy podskale mierzą to samo w obu grupach. Tutaj u studentów podskale prawie się nie różnią. Takie założenie sprawdza procedura opisana we wpisie inwariancja pomiaru krok po kroku.
Jak opisać TSES w pracy
Wzór zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane swojej wersji.
Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a zdania o rzetelności we wzorze raportowania alfy Cronbacha.
Licencja i polska wersja
Na stronie autorki są do pobrania formularze obu wersji, instrukcja punktowania i list ze zgodą na użycie TSES. Udostępniono tam też wersje turecką i hiszpańską (Woolfolk Hoy, b.d.). Sama strona nie zawiera osobnych warunków licencji. Treść listu ze zgodą sprawdź przed badaniem, dołącz go do dokumentacji projektu i zacytuj artykuł z 2001 roku. Jeśli planujesz publikację albo badanie komercyjne, skontaktuj się z autorkami.
Nie zweryfikowaliśmy opublikowanej polskiej adaptacji TSES. Jeśli korzystasz z polskiego tłumaczenia, podaj jego źródło. Gdy tłumaczysz skalę sam(a), opisz procedurę przekładu i nie przypisuj swojej wersji właściwości oryginału. Jak to zrobić rzetelnie, opisuje wpis adaptacja kulturowa kwestionariusza. Gdzie szukać opublikowanych wersji narzędzi, podpowiada poradnik gdzie znaleźć kwestionariusze.
TSES w R: wyniki, rzetelność, struktura i porównanie grup
Kod odtwarza liczby z tekstu i zapisuje plik CSV z danymi. Wyniki podskal to średnie pozycji, tak jak w instrukcji autorek. Alfę z przedziałem Feldta liczy pakiet psych, omegę i modele CFA – lavaan. Struktura jest sprawdzana osobno w każdej grupie.
Wynik TSES krok po kroku
R
# B260 – TSES (wersja długa, 24 pozycje): wyniki podskal, wynik ogólny, rzetelność, CFA w dwóch grupach
# i porównanie nauczycieli z osobami studiującymi pedagogikę (dane symulowane, set.seed(26024)).
# Pozycje nazwano według podskal: z1–z8 (zaangażowanie uczniów), s1–s8 (strategie nauczania),
# k1–k8 (zarządzanie klasą). W prawdziwych danych przypisz numery pozycji według instrukcji autorów.
# Treści pozycji nie podajemy. Zasada autorów: wynik podskali = nieważona średnia jej pozycji.
suppressPackageStartupMessages({ library(psych); library(lavaan) })
set.seed(26024)
poz <- list(Z = paste0("z", 1:8), S = paste0("s", 1:8), K = paste0("k", 1:8))
symuluj <- function(n, R, srednie) {
  F <- matrix(rnorm(n * 3), n, 3) %*% chol(R)                    # trzy skorelowane czynniki
  lam <- runif(24, .65, .80)
  y <- sapply(1:24, function(j) { f <- ceiling(j / 8)
    srednie[f] + 1.35 * (lam[j] * F[, f] + rnorm(n, 0, sqrt(1 - lam[j]^2))) })
  odp <- pmin(pmax(round(y), 1), 9)                              # odpowiedzi 1–9
  colnames(odp) <- unlist(poz); odp }
R_n <- matrix(c(1, .60, .55, .60, 1, .58, .55, .58, 1), 3)       # nauczyciele: czynniki umiarkowanie skorelowane
R_p <- matrix(c(1, .92, .90, .92, 1, .93, .90, .93, 1), 3)       # studenci: czynniki prawie nierozróżnialne
dane <- rbind(data.frame(grupa = "nauczyciele", symuluj(200, R_n, c(7.2, 7.3, 6.9))),
              data.frame(grupa = "studenci", symuluj(150, R_p, c(6.8, 6.7, 6.3))))
dane <- data.frame(id = seq_len(nrow(dane)), dane)
write.csv(dane, "../tses-dane-przyklad.csv", row.names = FALSE)   # plik do pobrania

# Krok 1. Kontrola kodowania: tylko 1–9, bez braków
all(sapply(dane[, unlist(poz)], function(x) all(x %in% 1:9)))
table(dane$grupa)

# Krok 2. Wyniki: średnia pozycji podskali (1–9) i wynik ogólny = średnia 24 pozycji
for (s in names(poz)) dane[[s]] <- rowMeans(dane[, poz[[s]]])
dane$TSES <- rowMeans(dane[, unlist(poz)])
opis <- function(x) round(c(M = mean(x), SD = sd(x), min = min(x), max = max(x), skosnosc = psych::skew(x)), 2)
t(sapply(dane[, c("Z", "S", "K", "TSES")], opis))
aggregate(cbind(Z, S, K, TSES) ~ grupa, dane, function(x) round(c(M = mean(x), SD = sd(x)), 2))
# Wynik ogólny jako średnia trzech podskal daje to samo, bo podskale mają po 8 pozycji
all.equal(dane$TSES, rowMeans(dane[, c("Z", "S", "K")]))

# Krok 3. Rzetelność w całej próbie: alfa z 95% CI Feldta i omega total z jednoczynnikowej CFA (MLR)
omega_cfa <- function(p, d) { f <- cfa(paste("F =~", paste(p, collapse = " + ")), data = d, std.lv = TRUE, estimator = "MLR")
  L <- standardizedSolution(f); l <- L$est.std[L$op == "=~"]; e <- L$est.std[L$op == "~~" & L$lhs %in% p & L$lhs == L$rhs]
  sum(l)^2 / (sum(l)^2 + sum(e)) }
rzet <- function(p, d) { a <- alpha(d[, p], warnings = FALSE)
  round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]], omega = omega_cfa(p, d)), 3) }
rbind(Z = rzet(poz$Z, dane), S = rzet(poz$S, dane), K = rzet(poz$K, dane), TSES = rzet(unlist(poz), dane))

# Krok 4. Struktura osobno w grupach: trzy skorelowane czynniki a jeden czynnik (ML, test ilorazu wiarygodności)
m3 <- paste("Zaang =~", paste(poz$Z, collapse = " + "), "\nStrat =~", paste(poz$S, collapse = " + "),
            "\nKlasa =~", paste(poz$K, collapse = " + "))
m1 <- paste("Ogolny =~", paste(unlist(poz), collapse = " + "))
ind <- c("chisq", "df", "cfi", "rmsea", "srmr", "aic")
for (g in c("nauczyciele", "studenci")) {
  d <- dane[dane$grupa == g, ]
  f3 <- cfa(m3, data = d, std.lv = TRUE); f1 <- cfa(m1, data = d, std.lv = TRUE)
  cat("\n==", g, "(n =", nrow(d), ")\n")
  print(round(rbind(trzy_czynniki = fitMeasures(f3, ind), jeden_czynnik = fitMeasures(f1, ind)), 3))
  print(lavTestLRT(f1, f3)[2, c("Chisq diff", "Df diff", "Pr(>Chisq)")])
  print(round(lavInspect(f3, "cor.lv"), 2))
  print(round(cor(d[, c("Z", "S", "K")]), 2))
}

# Krok 5. Porównanie grup w wyniku ogólnym: test t Welcha i d Cohena z 95% CI
t.test(TSES ~ grupa, data = dane)
round(cohen.d(TSES ~ grupa, data = dane[, c("TSES", "grupa")])$cohen.d, 2)
Wynik w R
[1] TRUE

nauczyciele    studenci
        200         150
        M   SD  min  max skosnosc
Z    6.98 1.02 4.38 9.00    -0.33
S    7.04 1.08 4.00 9.00    -0.33
K    6.60 1.07 3.38 8.88    -0.31
TSES 6.87 0.94 4.08 8.83    -0.42
        grupa  Z.M Z.SD  S.M S.SD  K.M K.SD TSES.M TSES.SD
1 nauczyciele 7.19 0.93 7.34 0.97 6.93 0.93   7.15    0.76
2    studenci 6.70 1.07 6.64 1.09 6.17 1.10   6.50    1.03
[1] TRUE
      alfa    lo    hi omega
Z    0.899 0.883 0.914 0.900
S    0.916 0.902 0.929 0.916
K    0.904 0.888 0.919 0.905
TSES 0.952 0.945 0.959 0.952

== nauczyciele (n = 200 )
                chisq  df   cfi rmsea  srmr      aic
trzy_czynniki 287.425 249 0.982 0.028 0.046 13782.65
jeden_czynnik 986.234 252 0.661 0.121 0.113 14475.46
   Chisq diff Df diff Pr(>Chisq)
f1     698.81       3  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
      Zaang Strat Klasa
Zaang  1.00
Strat  0.56  1.00
Klasa  0.52  0.49  1.00
     Z    S    K
Z 1.00 0.49 0.46
S 0.49 1.00 0.44
K 0.46 0.44 1.00

== studenci (n = 150 )
                chisq  df   cfi rmsea  srmr      aic
trzy_czynniki 260.277 249 0.995 0.017 0.036 10356.87
jeden_czynnik 315.116 252 0.972 0.041 0.040 10405.71
   Chisq diff Df diff Pr(>Chisq)
f1      54.84       3  7.429e-12 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
      Zaang Strat Klasa
Zaang  1.00
Strat  0.93  1.00
Klasa  0.91  0.94  1.00
     Z    S    K
Z 1.00 0.84 0.82
S 0.84 1.00 0.85
K 0.82 0.85 1.00

	Welch Two Sample t-test

data:  TSES by grupa
t = 6.525, df = 262.36, p-value = 3.488e-10
alternative hypothesis: true difference in means between group nauczyciele and group studenci is not equal to 0
95 percent confidence interval:
 0.4528314 0.8442519
sample estimates:
mean in group nauczyciele    mean in group studenci
                 7.152708                  6.504167

     lower effect upper
TSES -0.96  -0.74 -0.52
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy TSES
- Trzy podskale u studentów bez sprawdzenia struktury. U osób bez doświadczenia w nauczaniu podskale zwykle zlewają się w jeden czynnik. Gdy podskale korelują bardzo wysoko, opisuj wynik ogólny, jak zalecają autorki.
- Sumy zamiast średnich. Wynik 56 w podskali nie da się porównać ze średnimi 1–9 z literatury. Podawaj średnią pozycji, tak jak autorki.
- Mieszanie wersji. Wyników wersji długiej i krótkiej nie łącz w jednej analizie bez opisu. Alf wersji o różnej długości też nie porównuj bezpośrednio.
- Własne „poziomy” skuteczności. Przedziały z kwartyli próby nie są normami. TSES nie ma oficjalnych progów.
- Złe przypisanie pozycji. Pozycje podskal są w formularzu wymieszane. Sprawdź przypisanie z instrukcją autorek i porównaj korelacje pozycji z podskalami.
- Tłumaczenie bez opisu. Własny przekład bez procedury adaptacji osłabia trafność wniosków.
Pełną ścieżkę analizy narzędzia, od kodowania po strukturę czynnikową, porządkuje przewodnik po analizie kwestionariusza. Jeśli chcesz, żeby ktoś sprawdził liczenie wyników TSES i strukturę skali w Twojej bazie, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć wynik podskali TSES: suma czy średnia?
Autorki liczą wynik podskali jako nieważoną średnią pozycji, które do niej należą, więc zostaje on na skali odpowiedzi 1–9. Wynik ogólny to średnia wszystkich pozycji. Suma nie zmienia korelacji ani wyników testów, ale utrudnia porównanie z literaturą, w której podaje się średnie.
Czy u studentów pedagogiki można analizować trzy podskale TSES?
Można, ale najpierw sprawdź strukturę. Według autorek u osób przygotowujących się do zawodu czynniki są mniej wyraźne i zalecany jest wynik ogólny. Badania Fives i Buehl (2009) oraz Duffin i in. (2012) potwierdziły u przyszłych nauczycieli strukturę jednoczynnikową albo bardzo wysokie korelacje podskal.
Wersja długa czy krótka TSES – którą wybrać do pracy dyplomowej?
Obie mają te same trzy podskale: wersja długa po 8 pozycji, krótka po 4. Fives i Buehl (2009) uzyskali w obu podobne średnie i rzetelność. Krótka wersja skraca ankietę, ale ma niższe alfy podskal. Przy małej próbie i wielu innych narzędziach często wystarcza, a przy analizie struktury lepsza jest wersja długa.
Czy TSES ma polskie normy albo progi niskiego i wysokiego wyniku?
Nie podajemy polskich norm, a autorki nie publikują progów ani kategorii wyników. Średnie z badania autorek, ok. 7 na skali 1–9, pochodzą z próby amerykańskiej i mogą służyć tylko jako punkt odniesienia. W pracy analizuj wyniki jako zmienne ciągłe.
Skąd wziąć numery pozycji podskal TSES?
Z instrukcji punktowania udostępnionej przez autorki razem z formularzami na stronie Anity Woolfolk Hoy. Pozycje podskal są w formularzu wymieszane, a w wersji krótkiej inne niż w długiej, dlatego nie przepisuj przypisania z innych prac bez sprawdzenia w instrukcji.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z pedagogiki
Ankiety wśród nauczycieli i rodziców: skala Likerta, chi-kwadrat i test Fishera, testy rangowe z korektą Holma, procenty w tabelach i uczniowie w klasach.
Czytaj →PoradnikJak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikModel bifactor i ESEM
Od CFA do bifactor-ESEM na jednym kwestionariuszu: ładunki krzyżowe, czynnik ogólny, omega H, ECV, trafność podskal, tabela APA i kod lavaan.
Czytaj →PoradnikMSLQ – jak policzyć wynik
Motywacja i strategie uczenia się: 15 podskal bez wyniku ogólnego, wybór podskal, średnie pozycji i klucz z podręcznika – z przykładem w R i wzorem opisu.
Czytaj →Badasz poczucie skuteczności nauczycieli?
Sprawdzimy liczenie podskal TSES, rzetelność i strukturę skali w Twojej próbie oraz wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Duffin, L. C., French, B. F., & Patrick, H. (2012). The Teachers' Sense of Efficacy Scale: Confirming the factor structure with beginning pre-service teachers. Teaching and Teacher Education, 28(6), 827–834. https://doi.org/10.1016/j.tate.2012.03.004
- Fives, H., & Buehl, M. M. (2009). Examining the factor structure of the Teachers’ Sense of Efficacy Scale. The Journal of Experimental Education, 78(1), 118–134. https://doi.org/10.1080/00220970903224461
- Gálvez-Nieto, J. L., Salvo-Garrido, S., Domínguez-Lara, S., Polanco-Levicán, K., & Mieres-Chacaltana, M. (2023). Psychometric properties of the Teachers’ Sense of Efficacy Scale in a sample of Chilean public school teachers. Frontiers in Psychology, 14, Article 1272548. https://doi.org/10.3389/fpsyg.2023.1272548 ● Otwarty dostęp
- Klassen, R. M., Bong, M., Usher, E. L., Chong, W. H., Huan, V. S., Wong, I. Y. F., & Georgiou, T. (2009). Exploring the validity of a teachers’ self-efficacy scale in five countries. Contemporary Educational Psychology, 34(1), 67–76. https://doi.org/10.1016/j.cedpsych.2008.08.001
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Salas-Rodríguez, F., Lara, S., & Martínez, M. (2021). Spanish version of the Teachers’ Sense of Efficacy Scale: An adaptation and validation study. Frontiers in Psychology, 12, Article 714145. https://doi.org/10.3389/fpsyg.2021.714145 ● Otwarty dostęp
- Tschannen-Moran, M., & Woolfolk Hoy, A. (2001). Teacher efficacy: Capturing an elusive construct. Teaching and Teacher Education, 17(7), 783–805. https://doi.org/10.1016/s0742-051x(01)00036-1
- Woolfolk Hoy, A. (b.d.). Instruments. Anita Woolfolk Hoy – strona autorki. Pobrano 1 listopada 2026 z https://anitawoolfolkhoy.com/research/instruments/ ● Otwarty dostęp
Cytowania BibTeX
@article{duffin2012teachers, author={Duffin, Lisa C. and French, Brian F. and Patrick, Helen}, title={{The Teachers' Sense of Efficacy Scale: Confirming the factor structure with beginning pre-service teachers}}, journal={Teaching and Teacher Education}, year={2012}, volume={28}, number={6}, pages={827--834}, doi={10.1016/j.tate.2012.03.004}}@article{fives2009examining, author={Fives, Helenrose and Buehl, Michelle M.}, title={{Examining the factor structure of the Teachers’ Sense of Efficacy Scale}}, journal={The Journal of Experimental Education}, year={2009}, volume={78}, number={1}, pages={118--134}, doi={10.1080/00220970903224461}}@article{galveznieto2023psychometric, author={Gálvez-Nieto, José Luis and Salvo-Garrido, Sonia and Domínguez-Lara, Sergio and Polanco-Levicán, Karina and Mieres-Chacaltana, Manuel}, title={{Psychometric properties of the Teachers’ Sense of Efficacy Scale in a sample of Chilean public school teachers}}, journal={Frontiers in Psychology}, year={2023}, volume={14}, eid={1272548}, doi={10.3389/fpsyg.2023.1272548}}@article{klassen2009exploring, author={Klassen, Robert M. and Bong, Mimi and Usher, Ellen L. and Chong, Wan Har and Huan, Vivien S. and Wong, Isabella Y. F. and Georgiou, Tasos}, title={{Exploring the validity of a teachers’ self-efficacy scale in five countries}}, journal={Contemporary Educational Psychology}, year={2009}, volume={34}, number={1}, pages={67--76}, doi={10.1016/j.cedpsych.2008.08.001}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{salasrodriguez2021spanish, author={Salas-Rodríguez, Fátima and Lara, Sonia and Martínez, Martín}, title={{Spanish version of the Teachers’ Sense of Efficacy Scale: An adaptation and validation study}}, journal={Frontiers in Psychology}, year={2021}, volume={12}, eid={714145}, doi={10.3389/fpsyg.2021.714145}}@article{tschannenmoran2001teacher, author={Tschannen-Moran, Megan and Woolfolk Hoy, Anita}, title={{Teacher efficacy: Capturing an elusive construct}}, journal={Teaching and Teacher Education}, year={2001}, volume={17}, number={7}, pages={783--805}, doi={10.1016/s0742-051x(01)00036-1}}@misc{woolfolkhoyinstrumentsnd, author={Woolfolk Hoy, Anita}, title={{Instruments}}, publisher={Anita Woolfolk Hoy – strona autorki}, url={https://anitawoolfolkhoy.com/research/instruments/}}