Co to jest podejście Cohen i Cohen?
Podejście Cohen i Cohen to w praktyce test łącznej istotności (ang. joint significance test) – sposób sprawdzania mediacji, w którym o efekcie pośrednim wnioskuje się wtedy, gdy istotne są obie jego składowe: ścieżka a (X → M) i ścieżka b (M → Y przy kontroli X). W odróżnieniu od podejścia Barona i Kenny’ego procedura nie wymaga istotnego efektu całkowitego ani spadku efektu X po dodaniu mediatora.
Skąd nazwa? MacKinnon i in. (2002) opisują test łącznej istotności jako trzeci wariant podejścia kroków przyczynowych i jako przykład jego stosowania wskazują podręcznik regresji wielokrotnej Jacoba i Patricii Cohenów z 1983 roku (s. 366). Wspominają też, że podobny test opisał Allison, a Kenny, Kashy i Bolger uznali testy ścieżek a i b za kluczowe dla wykazania mediacji. Samego podręcznika Cohenów nie cytujemy bezpośrednio: opis procedury na tej stronie opiera się na zestawieniu MacKinnona i in. (2002) oraz na pracach, które tę metodę testowały. W literaturze anglojęzycznej szukaj jej pod nazwą joint significance test (Fritz i MacKinnon, 2007; Yzerbyt i in., 2018).
Jak przeprowadzić test łącznej istotności?
- Ścieżka a: regresja mediatora M na X i test istotności współczynnika X.
- Ścieżka b: regresja Y na X i M jednocześnie i test współczynnika M. Ścieżka b to związek M z Y przy kontroli X – nie zastąpisz jej korelacją M z Y.
- Decyzja: jeśli obie ścieżki są istotne (zwykle na poziomie .05) i mają znaki zgodne z hipotezą, uznajesz efekt pośredni za istotny. O wyniku decyduje więc większa z dwóch wartości p.
- Wielkość efektu: test daje tylko odpowiedź „tak/nie”, dlatego osobno oblicz ab i jego przedział ufności – najlepiej bootstrapowy.
Dwa testy nie wymagają korekty Bonferroniego: aby uznać mediację, oba muszą być istotne, więc błąd I rodzaju nie rośnie. Gdy w populacji obie ścieżki są zerowe, jest wręcz bardzo mały – MacKinnon i in. (2002) uzyskali odsetki fałszywych alarmów zgodne z wartością .05² = .0025, a gdy zerowa była tylko jedna ścieżka, a druga duża – bliskie nominalnemu .05.
Przykład: informacja zwrotna, poczucie kompetencji i wytrwałość
W eksperymencie (dane symulowane) 80 studentów rozwiązywało zadania logiczne; połowa dostała neutralną, a połowa pozytywną informację zwrotną. Następnie mierzono poczucie kompetencji (1–7) i czas dobrowolnej pracy nad dodatkowymi zadaniami (w minutach). W grupie z neutralną informacją średnie wyniosły M = 4.03 (SD = 0.93) dla kompetencji i M = 7.08 min (SD = 3.32) dla czasu, a w grupie z pozytywną – M = 5.08 (SD = 0.95) i M = 8.97 min (SD = 3.43).
- Ścieżka a: pozytywna informacja zwrotna podniosła poczucie kompetencji o 1.045 punktu, t(78) = 4.97, p < .001.
- Ścieżka b: przy tym samym warunku każdy punkt kompetencji wiązał się z pracą dłuższą o 1.031 min, t(77) = 2.63, p = .010.
- Decyzja: obie ścieżki są istotne, więc według testu łącznej istotności efekt pośredni jest istotny (decyduje p = .010).
- Wielkość: ab = 1.078 min, bootstrapowy 95% CI [0.262, 2.055] – to 57% efektu całkowitego c = 1.887, p = .015. Efekt bezpośredni nie był istotny, c′ = 0.810, p = .335.
Test łącznej istotności i bootstrap prowadzą tu do tego samego wniosku. Test Sobela również jest istotny, z = 2.33, p = .020, ale – jak pokazuje rysunek 1 – w słabszych danych to on najczęściej „odpada” pierwszy.
Dlaczego test łącznej istotności ma większą moc niż test Sobela?
Statystykę Sobela można zapisać przez statystyki obu ścieżek: z = tatb / √(ta² + tb²). Taki iloraz jest zawsze mniejszy od mniejszej z dwóch statystyk t. Jeśli więc test Sobela jest istotny, obie ścieżki muszą być istotne – ale nie odwrotnie. W przykładzie: ta = 4.97 i tb = 2.63 dają z = 2.33. Gdyby obie ścieżki miały t = 2.5, test łącznej istotności wskazałby mediację, a Sobel nie (z = 1.77).
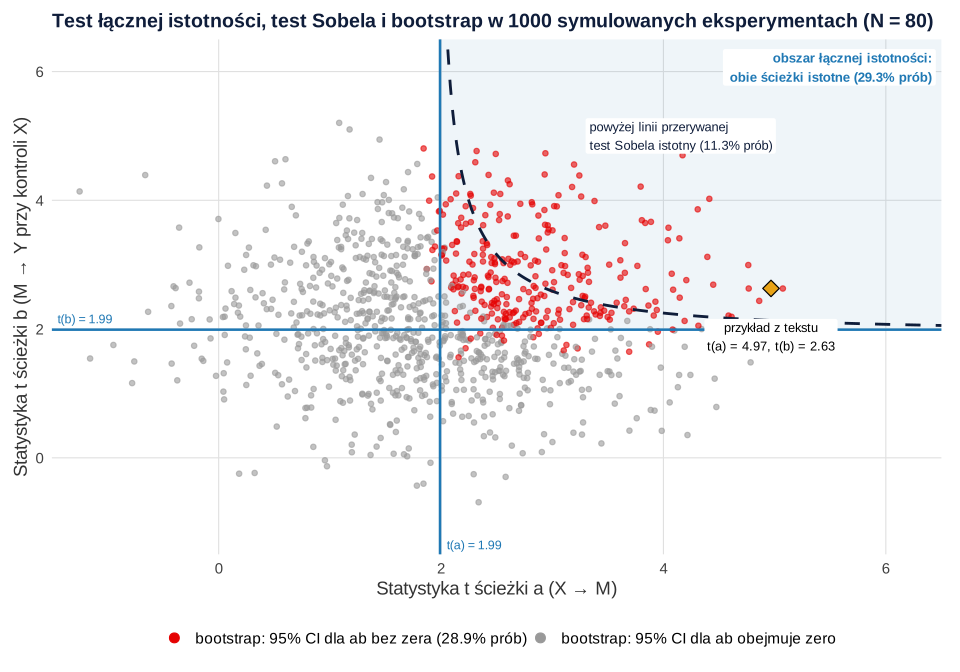
W symulacji test łącznej istotności wskazał mediację w 29.3% eksperymentów, bootstrap percentylowy w 28.9%, a test Sobela tylko w 11.3%. Bootstrap i test łącznej istotności dały tę samą decyzję w 94.6% prób, a test Sobela ani razu nie był istotny, gdy którakolwiek ze ścieżek była nieistotna. Podobnie wypadły tabele Fritza i MacKinnona (2007): test łącznej istotności miał większą moc niż test Sobela we wszystkich warunkach – przy małych ścieżkach do osiągnięcia mocy .80 wystarczało mu 530 osób, testowi Sobela potrzeba było 667, a bootstrapowi percentylowemu 558.
Test łącznej istotności czy bootstrap?
| Kryterium | Test łącznej istotności | Bootstrap percentylowy |
|---|---|---|
| Co sprawdza | Czy obie ścieżki, a i b, różnią się od zera | Czy efekt pośredni ab różni się od zera |
| Oszacowanie efektu pośredniego | Brak – tylko decyzja | ab z 95% przedziałem ufności |
| Moc | Duża, zbliżona do bootstrapu | Duża |
| Błąd I rodzaju | Dobrze kontrolowany | W części warunków wyższy niż w teście łącznej istotności |
| Założenia | Założenia regresji dla obu równań | Nie wymaga normalności rozkładu ab; wynik zależy od losowania prób |
| Obliczenia | Dwie regresje w dowolnym programie | Tysiące prób (PROCESS, lavaan, kod R) |
Literatura nie wskazuje jednego zwycięzcy. MacKinnon i in. (2002) uznali test łącznej istotności za metodę o najlepszej równowadze błędu I rodzaju i mocy, ale podkreślili, że nie daje on ani oszacowania efektu pośredniego, ani przedziału ufności. Leth-Steensen i Gallitto (2016) w symulacjach pełnych modeli SEM ze zmiennymi latentnymi stwierdzili, że test łącznej istotności miał większą moc niż bootstrap z korekcją obciążenia i rozsądniejszy poziom błędu I rodzaju. Yzerbyt i in. (2018) pokazali, że najczęściej stosowane testy samego wskaźnika ab grożą zawyżonym błędem I rodzaju, i zalecają: o istnieniu efektu pośredniego wnioskuj z testów obu ścieżek, a jego wielkość szacuj innymi zalecanymi metodami. Wśród metod opartych na przedziałach ufności Biesanz i in. (2010) najlepiej ocenili – obok bayesowskiej metody MCMC – bootstrap percentylowy, a odradzali bootstrap BCa.
Dlatego współcześnie standardem pozostaje bootstrapowy przedział ufności dla ab – w odróżnieniu od testu łącznej istotności mówi, jak duży jest efekt pośredni i z jaką precyzją go oszacowano, a przy tym nie zakłada normalności rozkładu iloczynu. Test łącznej istotności warto podać obok niego: kosztuje dwie regresje, pokazuje, czy obie składowe efektu pośredniego są istotne, i chroni przed wnioskiem opartym wyłącznie na jednym wskaźniku.
Jak opisać wynik w pracy (APA)
Podaj obie ścieżki z testami, regułę decyzji oraz efekt pośredni z przedziałem ufności. Wzór dla przykładu:
Ścieżki i efekty wygodnie zebrać w tabeli – wzór znajdziesz w haśle tabela mediacji w APA, a całą procedurę z PROCESS i lavaan w poradniku analiza mediacji krok po kroku.
Przykład w R
Kod tworzy dane z eksperymentu, wykonuje test łącznej istotności, oblicza dla porównania statystykę Sobela i szacuje efekt pośredni z bootstrapowym przedziałem ufności. Liczby w tekście pochodzą z tego kodu.
Test łącznej istotności i bootstrap efektu pośredniego
R
# Dane symulowane: eksperyment z informacją zwrotną, N = 80 (po 40 osób w warunku)
set.seed(88)
n <- 80
warunek <- rep(0:1, each = n / 2)                     # 0 = neutralna, 1 = pozytywna informacja zwrotna
kompetencje <- pmin(pmax(round(4.2 + (0.65 * warunek + rnorm(n)), 1), 1), 7)   # poczucie kompetencji (1–7)
z_kom <- (kompetencje - 4.2) / 1.0
czas <- pmin(pmax(round(8 + 3.5 * (0.10 * (warunek - 0.5) * 2 + 0.30 * z_kom + rnorm(n, sd = 0.93)), 1), 0), 20)  # wytrwałość (min)
dane <- data.frame(warunek, kompetencje, czas)
aggregate(cbind(kompetencje, czas) ~ warunek, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))

# Dwie regresje: ścieżka a (M na X) oraz ścieżki b i c' (Y na X i M); dla porównania efekt całkowity c
m_a <- lm(kompetencje ~ warunek, data = dane)
m_b <- lm(czas ~ warunek + kompetencje, data = dane)
m_c <- lm(czas ~ warunek, data = dane)
sciezki <- rbind(a      = coef(summary(m_a))["warunek", ],
                 b      = coef(summary(m_b))["kompetencje", ],
                 c_prim = coef(summary(m_b))["warunek", ],
                 c      = coef(summary(m_c))["warunek", ])
round(sciezki, 4)

# Test łącznej istotności: efekt pośredni uznajemy, gdy obie ścieżki są istotne
p_a <- sciezki["a", "Pr(>|t|)"]; p_b <- sciezki["b", "Pr(>|t|)"]
cat("p(a) =", signif(p_a, 3), "| p(b) =", signif(p_b, 3), "| obie < .05:", p_a < .05 & p_b < .05, "\n")

# Dla porównania: test Sobela zapisany przez statystyki z obu ścieżek
t_a <- sciezki["a", "t value"]; t_b <- sciezki["b", "t value"]
z_sobel <- t_a * t_b / sqrt(t_a^2 + t_b^2)
round(c(z_sobel = z_sobel, p_sobel = 2 * pnorm(-abs(z_sobel))), 3)

# Wielkość efektu pośredniego: ab z bootstrapowym (percentylowym) 95% CI, 5000 prób
ab <- coef(m_a)["warunek"] * coef(m_b)["kompetencje"]
set.seed(2026)
ab_boot <- replicate(5000, {
  d <- dane[sample(nrow(dane), replace = TRUE), ]
  coef(lm(kompetencje ~ warunek, d))["warunek"] * coef(lm(czas ~ warunek + kompetencje, d))["kompetencje"]
})
round(c(ab = unname(ab), quantile(ab_boot, c(.025, .975))), 3)
Wynik w R
  warunek kompetencje.M kompetencje.SD czas.M czas.SD
1       0          4.03           0.93   7.08    3.32
2       1          5.08           0.95   8.97    3.43
       Estimate Std. Error t value Pr(>|t|)
a        1.0450     0.2104  4.9675   0.0000
b        1.0311     0.3918  2.6314   0.0103
c_prim   0.8100     0.8353  0.9697   0.3352
c        1.8875     0.7552  2.4994   0.0145
p(a) = 3.92e-06 | p(b) = 0.0103 | obie < .05: TRUE
z_sobel p_sobel
  2.325   0.020
   ab  2.5% 97.5%
1.078 0.262 2.055
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Mylenie z krokami Barona i Kenny’ego. Test łącznej istotności nie wymaga istotnego efektu całkowitego c ani spadku c do c′.
- Ścieżka b bez kontroli X. Istotna korelacja mediatora z Y to jeszcze nie ścieżka b; ta pochodzi z regresji Y na X i M.
- Raport bez wielkości efektu. Sama informacja „obie ścieżki istotne” nie mówi, jak duży jest efekt pośredni – dodaj ab z 95% CI.
- Ignorowanie kierunku ścieżek. Istotne, ale przeciwne do hipotezy znaki a lub b oznaczają inny mechanizm, niż zakładano – opisz to wprost.
- Wnioski przyczynowe bez uzasadnienia. Losowy przydział do warunków chroni ścieżkę a, ale ścieżka b pozostaje korelacyjna i mogą ją zniekształcać zmienne zakłócające (zob. schemat eksperymentalny).
Najczęstsze pytania
Na czym polega podejście Cohen i Cohen w mediacji?
To test łącznej istotności: oszacuj ścieżkę a (regresja M na X) i ścieżkę b (regresja Y na X i M). Jeśli obie są istotne i mają oczekiwane znaki, efekt pośredni uznaje się za istotny. MacKinnon i in. (2002) opisują tę procedurę jako wariant kroków przyczynowych i łączą ją z podręcznikiem Cohenów z 1983 roku.
Czym różni się test łącznej istotności od metody Barona i Kenny’ego?
Test łącznej istotności sprawdza tylko ścieżki a i b. Nie wymaga istotnego efektu całkowitego c ani spadku efektu X po dodaniu mediatora, dlatego ma znacznie większą moc. Według Fritza i MacKinnona (2007) przy małych ścieżkach do mocy .80 potrzebuje 530 osób, a cztery kroki Barona i Kenny’ego (przy c′ = 0) – 20 886.
Czy przy dwóch testach trzeba stosować korektę Bonferroniego?
Nie. Aby uznać mediację, oba testy muszą być istotne, więc prawdopodobieństwo fałszywego alarmu nie przekracza przyjętego poziomu α. Gdy obie ścieżki są w populacji zerowe, odsetek fałszywych alarmów jest bliski .05² = .0025 (MacKinnon i in., 2002).
Czy test łącznej istotności wystarczy w pracy magisterskiej?
Jako jedyny wynik – raczej nie, bo nie podaje wielkości efektu pośredniego ani przedziału ufności. Podaj go obok efektu pośredniego ab z bootstrapowym 95% przedziałem ufności. Takie połączenie – testy ścieżek do wniosku o istnieniu efektu i osobna metoda do oszacowania jego wielkości – zalecają Yzerbyt i in. (2018).
Co zrobić, gdy test łącznej istotności i bootstrap dają różne wyniki?
Zdarza się to głównie przy wynikach granicznych, gdy jedna ze ścieżek ma p bliskie .05. Opisz oba wyniki, podaj przedział ufności dla ab i wielkości obu ścieżek, a wniosek sformułuj ostrożnie. Metodę wnioskowania ustal przed analizą – nie wybieraj jej po tym, jak zobaczysz wyniki.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikStatystyka do pracy magisterskiej: od planu do raportu
Kompletny proces analizy statystycznej do pracy magisterskiej: plan, przygotowanie danych, psychometria, modele, interpretacja i materiały do obrony.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Biesanz, J. C., Falk, C. F., & Savalei, V. (2010). Assessing mediational models: Testing and interval estimation for indirect effects. Multivariate Behavioral Research, 45(4), 661–701. https://doi.org/10.1080/00273171.2010.498292
- Fritz, M. S., & MacKinnon, D. P. (2007). Required sample size to detect the mediated effect. Psychological Science, 18(3), 233–239. https://doi.org/10.1111/j.1467-9280.2007.01882.x ● Otwarty dostęp: pełny tekst
- Leth-Steensen, C., & Gallitto, E. (2016). Testing mediation in structural equation modeling: The effectiveness of the test of joint significance. Educational and Psychological Measurement, 76(2), 339–351. https://doi.org/10.1177/0013164415593777 ● Otwarty dostęp: pełny tekst
- MacKinnon, D. P., Lockwood, C. M., Hoffman, J. M., West, S. G., & Sheets, V. (2002). A comparison of methods to test mediation and other intervening variable effects. Psychological Methods, 7(1), 83–104. https://doi.org/10.1037/1082-989x.7.1.83 ● Otwarty dostęp: pełny tekst
- Yzerbyt, V., Muller, D., Batailler, C., & Judd, C. M. (2018). New recommendations for testing indirect effects in mediational models: The need to report and test component paths. Journal of Personality and Social Psychology, 115(6), 929–943. https://doi.org/10.1037/pspa0000132 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{biesanz2010assessing, author={Biesanz, Jeremy C. and Falk, Carl F. and Savalei, Victoria}, title={{Assessing mediational models: Testing and interval estimation for indirect effects}}, journal={Multivariate Behavioral Research}, year={2010}, volume={45}, number={4}, pages={661--701}, doi={10.1080/00273171.2010.498292}}@article{fritz2007required, author={Fritz, Matthew S. and MacKinnon, David P.}, title={{Required sample size to detect the mediated effect}}, journal={Psychological Science}, year={2007}, volume={18}, number={3}, pages={233--239}, doi={10.1111/j.1467-9280.2007.01882.x}}@article{lethsteensen2016testing, author={Leth-Steensen, Craig and Gallitto, Elena}, title={{Testing mediation in structural equation modeling: The effectiveness of the test of joint significance}}, journal={Educational and Psychological Measurement}, year={2016}, volume={76}, number={2}, pages={339--351}, doi={10.1177/0013164415593777}}@article{mackinnon2002comparison, author={MacKinnon, David P. and Lockwood, Chondra M. and Hoffman, Jeanne M. and West, Stephen G. and Sheets, Virgil}, title={{A comparison of methods to test mediation and other intervening variable effects}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={83--104}, doi={10.1037/1082-989x.7.1.83}}@article{yzerbyt2018new, author={Yzerbyt, Vincent and Muller, Dominique and Batailler, Cédric and Judd, Charles M.}, title={{New recommendations for testing indirect effects in mediational models: The need to report and test component paths}}, journal={Journal of Personality and Social Psychology}, year={2018}, volume={115}, number={6}, pages={929--943}, doi={10.1037/pspa0000132}}