Kim jest John Ioannidis?
John P. A. Ioannidis (ur. 1965) jest lekarzem i epidemiologiem, profesorem medycyny oraz epidemiologii i zdrowia populacji na Uniwersytecie Stanforda. Zajmuje się metabadaniami – badaniem tego, jak prowadzi się, raportuje i weryfikuje badania naukowe. Urodził się w 1965 r. w Nowym Jorku, a wychował w Atenach. W 1984 r. ukończył z pierwszą lokatą Athens College, w 1990 r. – również z pierwszą lokatą – studia lekarskie na Uniwersytecie Narodowym w Atenach, gdzie w 1996 r. uzyskał też stopień doktora nauk (DSc) z biopatologii (Stanford University, b.d.).
Szkolił się z chorób wewnętrznych na Harvardzie (rezydentura, 1993) i z chorób zakaźnych w Tufts (1996). Pracował w National Institutes of Health, na Uniwersytecie Johnsa Hopkinsa i w Tufts. W latach 1999–2010 kierował Katedrą Higieny i Epidemiologii Wydziału Lekarskiego Uniwersytetu w Ioanninie w Grecji. W 2010 r. przeniósł się do Stanforda jako dyrektor Stanford Prevention Research Center; w latach 2010–2019 był redaktorem naczelnym „European Journal of Clinical Investigation”, a w latach 2023–2024 prezesem Association of American Physicians (Stanford University, b.d.).
Najważniejsze pomysły
- „Why most published research findings are false” (2005). Esej w „PLoS Medicine”, napisany w czasie pracy w Ioanninie i w Tufts, opisuje wynik badania jak wynik testu diagnostycznego. Prawdopodobieństwo, że istotny wynik jest prawdziwy (wartość predykcyjna dodatnia, PPV), zależy od mocy, poziomu istotności i od stosunku R prawdziwych do nieprawdziwych związków wśród tych, które dziedzina sprawdza. Autor dodał do modelu stronniczość u i liczbę zespołów badających to samo pytanie, a z modelu wyprowadził sześć wniosków: wynik jest mniej wiarygodny, gdy badania i efekty są małe, gdy testuje się wiele związków, gdy plany i analizy są elastyczne, gdy w grę wchodzą interesy finansowe lub uprzedzenia i gdy dziedzina jest „gorąca” (Ioannidis, 2005b).
- Sprzeczne wyniki głośnych badań (2005). W tym samym roku w „JAMA” sprawdził 49 badań klinicznych cytowanych ponad 1000 razy. Z 45, które ogłosiły skuteczność interwencji, 7 (16%) później podważono, w 7 kolejnych późniejsze badania wykazały słabsze efekty, a 20 (44%) się powtórzyło. Podważano zwłaszcza badania nierandomizowane, ale także małe badania z randomizacją (Ioannidis, 2005a).
- Zawyżone efekty (2008). Gdy odkrycie ogłasza się po przekroczeniu progu istotności w badaniu o małej mocy, opublikowany efekt jest z reguły zawyżony – to zjawisko opisuje hasło klątwa zwycięzcy (Ioannidis, 2008).
- Metabadania i METRICS. Na Stanfordzie współprowadzi Meta-Research Innovation Center at Stanford (METRICS). Wraz ze współpracownikami opisał metabadania jako dziedzinę, która ocenia i ulepsza praktyki badawcze w pięciu obszarach: metody, raportowanie, odtwarzalność, ocena i system zachęt (Ioannidis i in., 2015).
Ciekawostka
Zanim został lekarzem, wyróżnił się jako matematyk: w 1984 r., w roku matury, dostał krajową nagrodę Greckiego Towarzystwa Matematycznego. Tę matematyczną żyłkę widać w eseju z 2005 r., którego rdzeniem są trzy tabele czteropolowe i wzory na PPV (Stanford University, b.d.; Ioannidis, 2005b).
Mniej znana jest jego druga twórczość. Według biogramu na stronie Stanforda jest autorem dziesięciu książek literackich, z których trzy znalazły się w finale nagród „Anagnostis” dla najlepszej książki roku w Grecji (Stanford University, b.d.).
Przykład: ile istotnych wyników jest prawdziwych?
Bez stronniczości PPV = (1 − β)R/(R − βR + α), gdzie 1 − β to moc. Ze stronniczością u – odsetkiem analiz, które byłyby nieistotne, a zostały pokazane jako istotne – wzór się wydłuża (Ioannidis, 2005b). Funkcja ppv() w kodzie odtwarza wszystkie dziewięć wartości z tabeli 4 eseju, np. 0.85 dla randomizowanego badania z mocą 80%, R = 1:1 i u = 0.10, 0.20 dla eksploracyjnego badania epidemiologicznego z mocą 80%, R = 1:10 i u = 0.30 oraz 0.0015 dla masowego testowania z R = 1:1000.
Moc i R. Bez stronniczości, przy R = 1:4 (jeden na pięć badanych związków jest prawdziwy) i mocy 20% połowa istotnych wyników jest fałszywa (PPV = .500); przy mocy 80% – .800. Przy R = 1:10 te same moce dają .286 i .615. Gdy to samo pytanie bada niezależnie 10 zespołów, a liczy się choć jeden istotny wynik, PPV spada z .615 do .199 (R = 1:10, moc 80%).
Symulacja. Wzór sprawdziliśmy na 20 000 symulowanych porównaniach dwóch grup po 20 osób (set.seed(2005); w 20% porównań prawdziwy efekt d = 0.5, czyli R = 1:4 – parametry dobrane przez nas). Moc testu t wynosi .338. Istotnych wyników było 2066, z tego 1290 prawdziwych: PPV = .624, a wzór daje .628.
Na rysunku
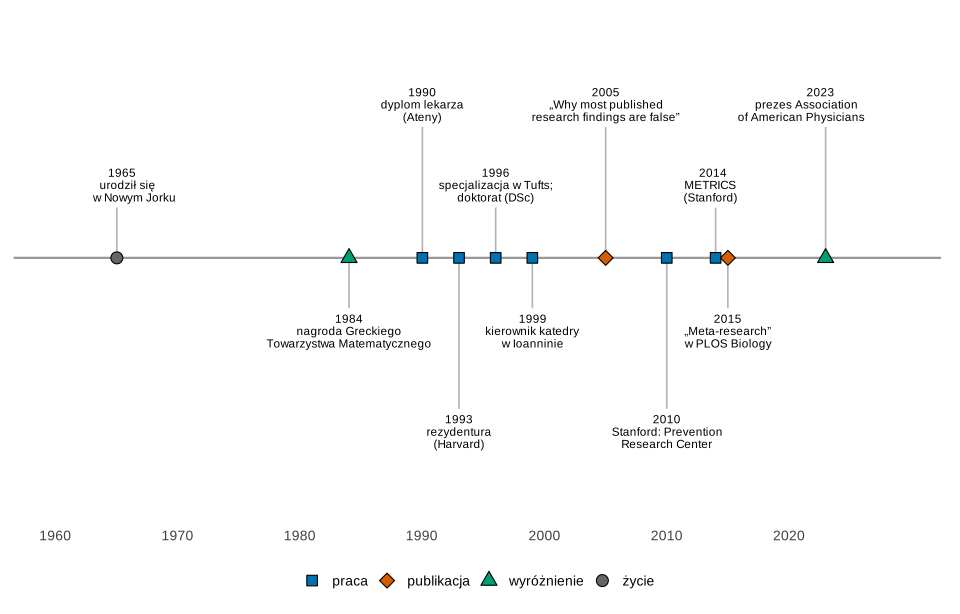
Co widać. Od medycyny klinicznej przez epidemiologię w Ioanninie do metabadań na Stanfordzie.
Na co uważać. Biogram na stronie Stanforda podaje, że METRICS powstał w 2014 r., a wykaz stanowisk na tej samej stronie – że Ioannidis jest jego współdyrektorem od 2013 r. Na osi podajemy rok z biogramu.
Podpis do pracy:
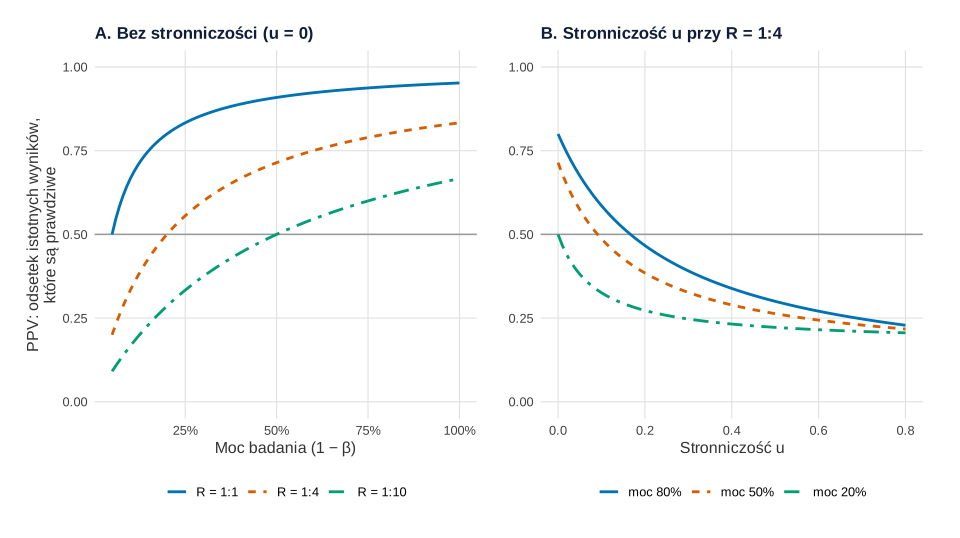
Co widać. Moc pomaga tym bardziej, im rzadsze są prawdziwe związki w dziedzinie. Stronniczość działa mocniej niż mała moc: przy R = 1:4 i u = 0.2 nawet badania z mocą 80% dają PPV = .467, a przy u = 0.8 moc prawie przestaje mieć znaczenie (PPV od .206 do .229).
Na co uważać. To model, nie pomiar. Wartości R i u dla konkretnej dziedziny zwykle nie są znane, a wzór zakłada jeden próg istotności i niezależne testy.
Podpis do pracy:
Gdzie spotkasz Ioannidisa w swojej pracy
- Wstęp i dyskusja o kryzysie replikacyjnym. Esej z 2005 r. jest standardowym źródłem, gdy piszesz, dlaczego pojedynczy istotny wynik nie przesądza sprawy i po co replikacje.
- Planowanie badania. Mała moc obniża nie tylko szansę wykrycia efektu (błąd II rodzaju), ale też wiarygodność wyników, które wyjdą istotne. To argument za analizą mocy i prerejestracją, która ogranicza elastyczność analiz (p-hacking, ogród rozwidlających się ścieżek).
- Wiele testów. Testowanie „wszystkiego ze wszystkim” to małe R; zobacz kalkulator fałszywych alarmów.
- Metaanaliza. Metaanaliza małych, niejednoznacznych badań ma w modelu PPV tylko .41 – wynik metaanalizy jest tak dobry jak badania i jak publikacja wszystkich wyników (efekt szuflady).
Spory, mity i trudne strony
- „Większość wyników jest fałszywa” – zawsze? Nie. Tytuł mówi o wielu dziedzinach i układach badań, ale w tabeli 4 eseju dobrze zaplanowane badanie z randomizacją i metaanaliza dobrych badań mają PPV = 0.85. Wniosek zależy od R, mocy i stronniczości (Ioannidis, 2005b).
- PPV to nie wartość p. Wartość p = .04 nie znaczy, że wynik jest prawdziwy z prawdopodobieństwem .96; to częsty błąd, który opisuje hasło wartość p.
Wzory Ioannidisa w R
Kod definiuje wzory na PPV z eseju z 2005 r. (bez stronniczości, ze stronniczością u i dla wielu zespołów), przelicza tabelę 4, sprawdza wzór symulacją testów t i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Ziarno: set.seed(2005).
1. PPV w funkcji mocy, R i stronniczości: rysunek 2
Kod R rysunku 2
# Ioannidis (2005): jak często „istotny” wynik jest prawdziwy? PPV w funkcji mocy, R i stronniczości u
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("#0072B2", "#D55E00", "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# R – stosunek prawdziwych do nieprawdziwych związków wśród testowanych, moc = 1 − beta,
# u – odsetek analiz, które dzięki stronniczości „stają się” istotne, choć nie powinny
ppv <- function(moc, R, alfa = 0.05, u = 0) {
  beta <- 1 - moc
  ((1 - beta) * R + u * beta * R) / (R + alfa - beta * R + u - u * alfa + u * beta * R)
}
# n niezależnych zespołów bada to samo pytanie; liczy się, że choć jeden uzyskał wynik istotny (bez stronniczości)
ppv_zespoly <- function(moc, R, n, alfa = 0.05) {
  beta <- 1 - moc
  R * (1 - beta^n) / (R + 1 - (1 - alfa)^n - R * beta^n)
}

# 1. Tabela 4 z pracy Ioannidisa (2005) – przeliczona wzorem
tab4 <- data.frame(
  przyklad = c("RCT o dobrej mocy, mała stronniczość", "metaanaliza dobrych RCT", "metaanaliza małych badań",
               "mała moc, RCT fazy I/II dobrze prowadzone", "mała moc, RCT fazy I/II źle prowadzone",
               "eksploracyjne epidemiologiczne, dobra moc", "eksploracyjne epidemiologiczne, mała moc",
               "masowe testowanie, duża stronniczość", "masowe testowanie, mniejsza stronniczość"),
  moc = c(0.80, 0.95, 0.80, 0.20, 0.20, 0.80, 0.20, 0.20, 0.20),
  R = c(1, 2, 1/3, 1/5, 1/5, 1/10, 1/10, 1/1000, 1/1000),
  u = c(0.10, 0.30, 0.40, 0.20, 0.80, 0.30, 0.30, 0.80, 0.20))
tab4$PPV <- format(signif(ppv(tab4$moc, tab4$R, u = tab4$u), 2), drop0trailing = TRUE)
tab4$R <- c("1:1", "2:1", "1:3", "1:5", "1:5", "1:10", "1:10", "1:1000", "1:1000")
print(tab4, row.names = FALSE)

# 2. Bez stronniczości: moc 80% i moc 20% przy różnych R
siatka <- expand.grid(moc = c(0.2, 0.5, 0.8), R = c(1, 1/4, 1/10))
siatka$PPV <- round(ppv(siatka$moc, siatka$R), 3)
xtabs(PPV ~ moc + R, siatka)

# PPV na krańcach mocy (bez stronniczości) i przy stronniczości u = 0.2 i 0.8 (R = 1:4)
round(c(R1_moc5 = ppv(0.05, 1), R1_moc100 = ppv(1, 1), R4_moc5 = ppv(0.05, 1/4), R4_moc100 = ppv(1, 1/4),
        R10_moc5 = ppv(0.05, 1/10), R10_moc100 = ppv(1, 1/10)), 3)
round(sapply(c(u0 = 0, u0.2 = 0.2, u0.8 = 0.8), function(u) ppv(c(moc80 = 0.8, moc50 = 0.5, moc20 = 0.2), 1/4, u = u)), 3)

# 3. Wiele zespołów, ten sam problem (R = 1:10, moc 80%)
round(sapply(c(1, 2, 5, 10, 20), function(n) ppv_zespoly(0.8, 1/10, n)), 3)

# 4. Sprawdzenie symulacją: 20 000 hipotez, test t dla dwóch grup po 20 osób
set.seed(2005)
K <- 20000; R <- 1/4; n <- 20; d <- 0.5
prawdziwa <- runif(K) < R / (R + 1)              # odsetek prawdziwych = R / (R + 1) = 0.2
p <- vapply(seq_len(K), function(k) {
  x <- rnorm(n); y <- rnorm(n, mean = if (prawdziwa[k]) d else 0)
  t.test(y, x, var.equal = TRUE)$p.value
}, numeric(1))
istotne <- p < 0.05
moc_tt <- power.t.test(n = n, delta = d, sd = 1, sig.level = 0.05)$power
c(moc_teoretyczna = round(moc_tt, 3), istotnych = sum(istotne),
  w_tym_prawdziwych = sum(istotne & prawdziwa),
  PPV_symulacja = round(mean(prawdziwa[istotne]), 3), PPV_wzor = round(ppv(moc_tt, R), 3))

# Rysunek: A – PPV a moc przy trzech wartościach R (u = 0); B – PPV a stronniczość u (R = 1:4)
dA <- expand.grid(moc = seq(0.05, 1, by = 0.01), R = c(1, 1/4, 1/10))
dA$PPV <- ppv(dA$moc, dA$R)
dA$R_et <- factor(dA$R, c(1, 1/4, 1/10), c("R = 1:1", "R = 1:4", "R = 1:10"))
pA <- ggplot(dA, aes(moc, PPV, colour = R_et, linetype = R_et)) +
  geom_hline(yintercept = 0.5, colour = "grey60") +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c("solid", "22", "4212"), name = NULL) +
  scale_x_continuous(labels = function(v) paste0(100 * v, "%")) + coord_cartesian(ylim = c(0, 1)) +
  labs(title = "A. Bez stronniczości (u = 0)", x = "Moc badania (1 − β)", y = "PPV: odsetek istotnych wyników,\nktóre są prawdziwe") +
  motyw
dB <- expand.grid(u = seq(0, 0.8, by = 0.01), moc = c(0.8, 0.5, 0.2))
dB$PPV <- ppv(dB$moc, 1/4, u = dB$u)
dB$moc_et <- factor(dB$moc, c(0.8, 0.5, 0.2), c("moc 80%", "moc 50%", "moc 20%"))
pB <- ggplot(dB, aes(u, PPV, colour = moc_et, linetype = moc_et)) +
  geom_hline(yintercept = 0.5, colour = "grey60") +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c("solid", "22", "4212"), name = NULL) +
  coord_cartesian(ylim = c(0, 1)) +
  labs(title = "B. Stronniczość u przy R = 1:4", x = "Stronniczość u", y = NULL) +
  motyw
p2 <- pA + pB
p2
Wynik w R
                                  przyklad  moc      R   u    PPV
      RCT o dobrej mocy, mała stronniczość 0.80    1:1 0.1   0.85
                   metaanaliza dobrych RCT 0.95    2:1 0.3   0.85
                  metaanaliza małych badań 0.80    1:3 0.4   0.41
 mała moc, RCT fazy I/II dobrze prowadzone 0.20    1:5 0.2   0.23
    mała moc, RCT fazy I/II źle prowadzone 0.20    1:5 0.8   0.17
 eksploracyjne epidemiologiczne, dobra moc 0.80   1:10 0.3    0.2
  eksploracyjne epidemiologiczne, mała moc 0.20   1:10 0.3   0.12
      masowe testowanie, duża stronniczość 0.20 1:1000 0.8  0.001
  masowe testowanie, mniejsza stronniczość 0.20 1:1000 0.2 0.0015
     R
moc     0.1  0.25     1
  0.2 0.286 0.500 0.800
  0.5 0.500 0.714 0.909
  0.8 0.615 0.800 0.941
   R1_moc5  R1_moc100    R4_moc5  R4_moc100   R10_moc5 R10_moc100
     0.500      0.952      0.200      0.833      0.091      0.667
         u0  u0.2  u0.8
moc80 0.800 0.467 0.229
moc50 0.714 0.385 0.217
moc20 0.500 0.273 0.206
[1] 0.615 0.496 0.306 0.199 0.135
  moc_teoretyczna         istotnych w_tym_prawdziwych     PPV_symulacja
            0.338          2066.000          1290.000             0.624
         PPV_wzor
            0.628
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: John P. A. Ioannidis (ur. 1965) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1965, 1984, 1990, 1993, 1996, 1999, 2005, 2010, 2014, 2015, 2023),
  opis = c("urodził się\nw Nowym Jorku", "nagroda Greckiego\nTowarzystwa Matematycznego", "dyplom lekarza\n(Ateny)",
           "rezydentura\n(Harvard)", "specjalizacja w Tufts;\ndoktorat (DSc)", "kierownik katedry\nw Ioanninie",
           "„Why most published\nresearch findings are false”", "Stanford: Prevention\nResearch Center", "METRICS\n(Stanford)",
           "„Meta-research”\nw PLOS Biology", "prezes Association\nof American Physicians"),
  rodzaj = c("życie", "wyróżnienie", "praca", "praca", "praca", "praca", "publikacja", "praca", "praca",
             "publikacja", "wyróżnienie"),
  poziom = c(0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3),   # wysokość etykiety
  wyrownanie = c(0.3, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.6, 0.5, 0.7))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1960, 2029), breaks = seq(1960, 2020, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test t – t.test(), moc – power.t.test(), losowanie – rnorm() i runif() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest John Ioannidis?
Lekarzem i epidemiologiem (ur. 1965 w Nowym Jorku), wychowanym w Atenach. W latach 1999–2010 kierował katedrą higieny i epidemiologii w Ioanninie, od 2010 r. jest profesorem na Uniwersytecie Stanforda, gdzie współprowadzi centrum metabadań METRICS (Stanford University, b.d.).
Co mówi artykuł „Why most published research findings are false”?
Że prawdopodobieństwo, iż istotny wynik jest prawdziwy (PPV), zależy od mocy, poziomu istotności, stosunku R prawdziwych do nieprawdziwych hipotez i stronniczości u. Przy małej mocy, małym R i elastycznych analizach PPV spada poniżej .5, ale dobre badanie z randomizacją może mieć PPV = 0.85 (Ioannidis, 2005b).
Jak obliczyć prawdopodobieństwo, że istotny wynik jest prawdziwy?
Bez stronniczości: PPV = (1 − β)R/(R − βR + α). Przy α = .05, mocy 80% i R = 1:4 PPV = .800, przy mocy 20% – .500. Wzór ze stronniczością i dla wielu zespołów oraz kod w R są w haśle.
Czym są metabadania?
Badaniami nad samymi badaniami: jak się je prowadzi, raportuje, powtarza, ocenia i nagradza. Ioannidis i współpracownicy z METRICS opisali je w 2015 r. w PLOS Biology jako dziedzinę, która ma oceniać i ulepszać praktyki badawcze.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kalkulator fałszywych alarmów przy wielu testach
Ryzyko choć jednego fałszywego alarmu, oczekiwana liczba, rozkład dwumianowy na wykresie, a po dodaniu mocy także odsetek fałszywych wśród wyników istotnych.
Czytaj →PoradnikJak zaplanować badanie replikacyjne
Rodzaj replikacji, materiały od autorów, liczebność przy zawyżonym efekcie, kryteria sukcesu i protokół registered report z kodem w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ioannidis, J. P. A. (2005a). Contradicted and initially stronger effects in highly cited clinical research. JAMA, 294(2), 218–228. https://doi.org/10.1001/jama.294.2.218
- Ioannidis, J. P. A. (2005b). Why most published research findings are false. PLoS Medicine, 2(8), Article e124. https://doi.org/10.1371/journal.pmed.0020124 ● Otwarty dostęp
- Ioannidis, J. P. A. (2008). Why most discovered true associations are inflated. Epidemiology, 19(5), 640–648. https://doi.org/10.1097/ede.0b013e31818131e7
- Ioannidis, J. P. A., Fanelli, D., Dunne, D. D., & Goodman, S. N. (2015). Meta-research: Evaluation and improvement of research methods and practices. PLOS Biology, 13(10), Article e1002264. https://doi.org/10.1371/journal.pbio.1002264 ● Otwarty dostęp
- Stanford University. (b.d.). John P.A. Ioannidis – Stanford Profiles. Stanford Profiles. Pobrano 22 listopada 2026 z https://profiles.stanford.edu/john-ioannidis ● Otwarty dostęp
Cytowania BibTeX
@article{ioannidis2005contradicted, author={Ioannidis, John P. A.}, title={{Contradicted and initially stronger effects in highly cited clinical research}}, journal={JAMA}, year={2005}, volume={294}, number={2}, pages={218--228}, doi={10.1001/jama.294.2.218}}@article{ioannidis2005why, author={Ioannidis, John P. A.}, title={{Why most published research findings are false}}, journal={PLoS Medicine}, year={2005}, volume={2}, number={8}, eid={e124}, doi={10.1371/journal.pmed.0020124}}@article{ioannidis2008why, author={Ioannidis, John P. A.}, title={{Why most discovered true associations are inflated}}, journal={Epidemiology}, year={2008}, volume={19}, number={5}, pages={640--648}, doi={10.1097/ede.0b013e31818131e7}}@article{ioannidis2015metaresearch, author={Ioannidis, John P. A. and Fanelli, Daniele and Dunne, Debbie Drake and Goodman, Steven N.}, title={{Meta-research: Evaluation and improvement of research methods and practices}}, journal={PLOS Biology}, year={2015}, volume={13}, number={10}, eid={e1002264}, doi={10.1371/journal.pbio.1002264}}@misc{stanfordioannidis, author={{Stanford University}}, title={{John P.A. Ioannidis – Stanford Profiles}}, howpublished={Stanford Profiles}, url={https://profiles.stanford.edu/john-ioannidis}}