Kim był Herman Chernoff?
Herman Chernoff (1923–2026) urodził się 1 lipca 1923 r. w Nowym Jorku. W 1943 r. ukończył matematykę (z fizyką jako przedmiotem dodatkowym) w City College of New York, a potem przez półtora roku pracował jako młodszy fizyk w marynarce wojennej USA. Studia z matematyki stosowanej w Brown University przerwała służba w armii; rozprawę doktorską przygotował na Columbii pod kierunkiem Abrahama Walda (Bather, 1996). Stopień nadał mu Brown – według biografii New England Statistical Society w 1948 r.
W latach 1947–1949 pracował w Cowles Commission w Chicago (m.in. z Kennethem Arrowem), a w latach 1949–1952 na University of Illinois (New England Statistical Society, b.d.). W 1952 r. przeszedł na stałe do Stanford, gdzie spędził 22 lata, od 1956 r. jako profesor zwyczajny, a przez pewien czas jako kierownik wydziału statystyki. W 1974 r. przeniósł się do MIT i założył tam Statistics Center, a w 1985 r. – na wydział statystyki Harvardu, z którego przeszedł na emeryturę w 1997 r. (Bather, 1996; Stanford University Department of Statistics, 2026). W 1967 r. był prezesem Institute of Mathematical Statistics; należał do National Academy of Sciences. Zmarł 6 lipca 2026 r. w wieku 103 lat.
Najważniejsze pomysły
- Efektywność testów i granica Chernoffa (1952). Chernoff (1952) porównywał testy oparte na sumie Sn niezależnych obserwacji. Kluczem był fakt, że prawdopodobieństwo P(Sn ≤ na) maleje w przybliżeniu jak mn, gdzie m to minimum funkcji tworzącej momenty zmiennej X − a. Stąd indeks efektywności: n obserwacji w jednym teście daje te same prawdopodobieństwa błędów co en w drugim. Ograniczenie ogona przez mn to dziś granica Chernoffa.
- Planowanie sekwencyjne. Udowodnił asymptotyczną optymalność procedury, która w kolejnych krokach losuje eksperyment i kieruje się informacją Kullbacka–Leiblera (New England Statistical Society, b.d.). Kontynuował tak test sekwencyjny Walda.
- Metody nieparametryczne i decyzje. Z Richardem Savage’em, zajmując się hipotezą Hodgesa i Lehmanna o nieparametrycznej alternatywie dla testu t, doszedł do twierdzenia Chernoffa–Savage’a (New England Statistical Society, b.d.), a z Lincolnem Mosesem napisał podręcznik Elementary Decision Theory (1959) (Stanford University Department of Statistics, 2026).
- Twarze Chernoffa (1973). Każdą obserwację z k zmiennymi (k ≤ 18) rysuje się jako schematyczną twarz, której cechy – np. długość nosa czy krzywizna ust – odpowiadają wartościom zmiennych. Oko ma szybko wychwycić regularności i odstępstwa (Chernoff, 1973).
Ciekawostka
Wynik z 1952 r., wyprowadzony przy porównywaniu testów, zrobił największą karierę poza statystyką. Według wspomnienia wydziału statystyki Stanford granica Chernoffa to standardowe narzędzie informatyki i elektrotechniki: ogranicza częstość błędów algorytmów losowych i jest szeroko cytowana w uczeniu maszynowym (Stanford University Department of Statistics, 2026).
Sam Chernoff w wywiadzie na setne urodziny nazwał siebie statystykiem stosowanym, którego teoria wyrastała z praktycznych problemów (Stanford University Department of Statistics, 2026). Na MIT pisał np. o grze liczbowej w Massachusetts i o loteriach (New England Statistical Society, b.d.).
Przykład: granica Chernoffa i twarze Chernoffa
Granica. Załóżmy, że w populacji 10% osób ma daną cechę. Jak prawdopodobne jest, że w próbie n osób odsetek wyniesie co najmniej 20%? Dokładną odpowiedź daje rozkład dwumianowy. Granica Chernoffa to exp(−n·KL), gdzie KL to dywergencja Kullbacka–Leiblera między 0.20 a 0.10 (tu 0.0444). Granica Hoeffdinga (1963) to exp(−2n(0.20 − 0.10)²), z wykładnikiem 0.0200. Minimum funkcji tworzącej momenty z pracy z 1952 r. daje numerycznie to samo: −log m = 0.0444.
Przy n = 100 dokładne prawdopodobieństwo wynosi .00198, granica Chernoffa – .0118, a Hoeffdinga – .135. Żeby prawdopodobieństwo spadło poniżej .001, potrzeba (w siatce co 10 osób) 120 osób według rachunku dokładnego, 160 według Chernoffa i 350 według Hoeffdinga. Hoeffding zna tylko zakres zmiennej, więc przy rzadkich cechach mocno przesadza; przy odsetku 50% oba wykładniki są prawie równe (0.02014 i 0.02000) – taki przykład, z nierównością Czebyszewa, pokazuje hasło o Hoeffdingu.
Twarze. Zbiór LifeCycleSavings z pakietu datasets zawiera – według pliku pomocy – średnie z lat 1960–1970 dla 50 krajów: stopę oszczędności, odsetek ludności poniżej 15 i powyżej 75 lat, dochód rozporządzalny na osobę i tempo jego wzrostu. Każdą zmienną zamieniliśmy na pozycję rangową wśród 50 krajów (0–1) i przypisaliśmy jednej cesze twarzy; rysujemy 9 krajów.
Na rysunku
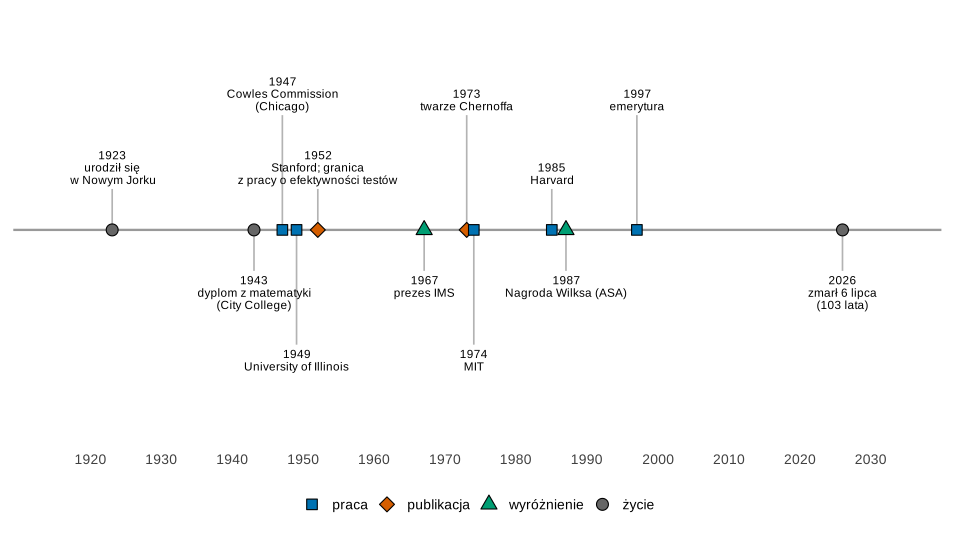
Co widać. Granica (1952) i twarze (1973) powstały w Stanford; do MIT Chernoff przeszedł, by zbudować program statystyki nastawiony na zastosowania (New England Statistical Society, b.d.).
Na co uważać. Rok przejścia na Harvard: Bather (1996) i wspomnienie Stanford podają 1985, biografia New England Statistical Society – 1984; na osi jest 1985.
Podpis do pracy:
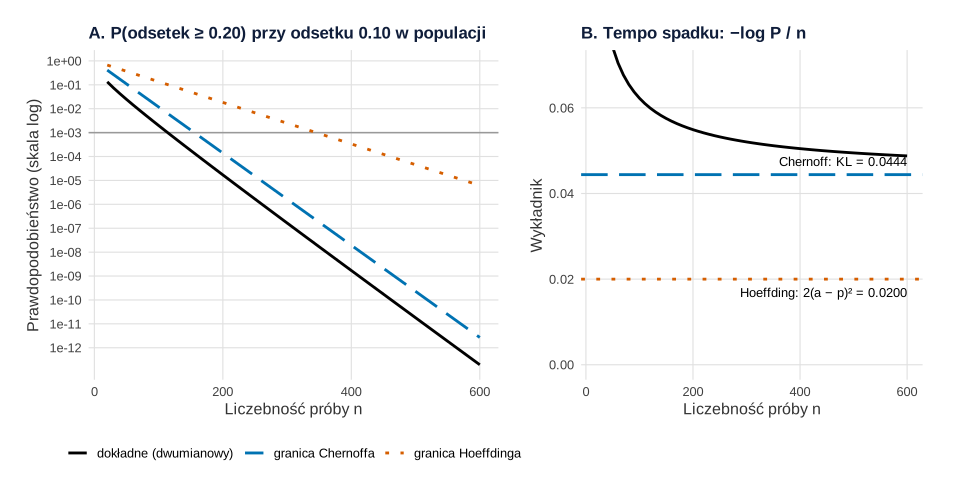
Co widać. W skali logarytmicznej linie są prawie proste, bo prawdopodobieństwo maleje wykładniczo. Linia Chernoffa biegnie równolegle do dokładnej, a Hoeffdinga opada ponad dwa razy wolniej. W panelu B wykładnik z rachunku dokładnego zbliża się do KL, nie do wykładnika Hoeffdinga.
Na co uważać. Granice to gwarancje „z góry”, nie przybliżenia: nawet Chernoff zawyża tu prawdopodobieństwo kilkukrotnie. Odsetek 0.10 i próg 0.20 wybraliśmy ręcznie, by pokazać rzadką cechę.
Podpis do pracy:
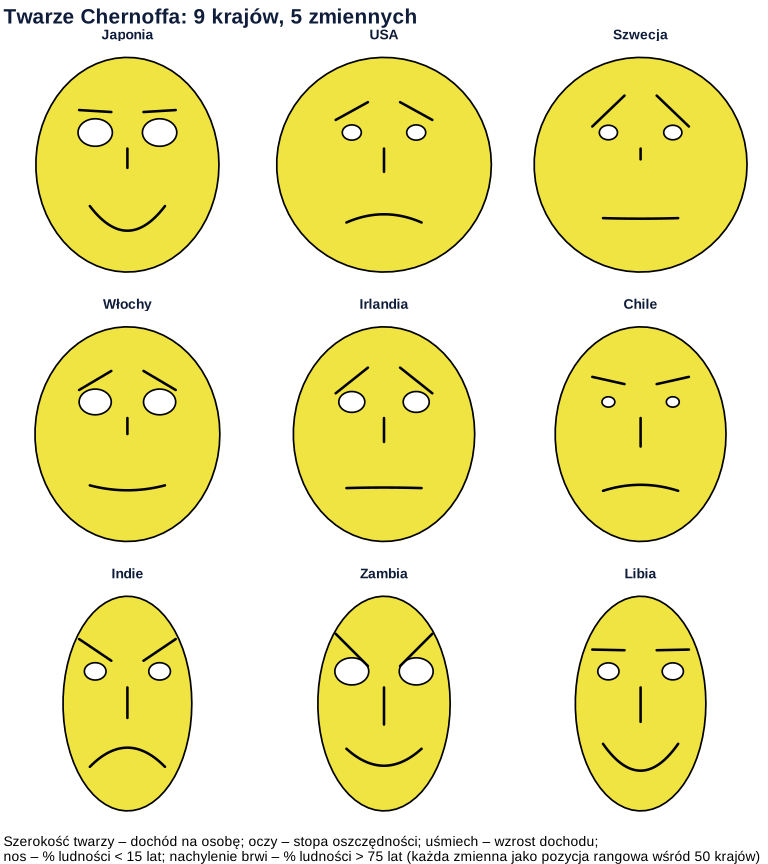
datasets::LifeCycleSavings (średnie z lat 1960–1970) jako pozycje rangowe wśród 50 krajów. Rysunek: R, pakiet ggplot2 (twarze rysowane od podstaw).Co widać. Kraje bogate (USA, Szwecja, Włochy, Irlandia) mają szerokie twarze, strome brwi i krótkie nosy: wysoki dochód idzie w parze z dużym odsetkiem starszych i małym dzieci. Indie, Zambia i Libia mają twarze wąskie i długie nosy, ale różne uśmiechy. Japonia ma największe oczy (najwyższa stopa oszczędności).
Na co uważać. Przypisanie cech zmiennym wybraliśmy ręcznie, a szerokość i uśmiech rzucają się w oczy bardziej niż kąt brwi. Twarze służą do wyszukania podobnych i nietypowych przypadków, nie do odczytu wartości; do tego lepsze są współrzędne równoległe albo wykres radarowy.
Podpis do pracy:
Gdzie spotkasz Chernoffa w swojej pracy
- Liczebność próby i rzadkie zdarzenia. Granice wykładnicze mówią, jak szybko maleje ryzyko dużego odchylenia wyniku z próby. Przy planowaniu badania liczy się jednak dokładnie albo symulacją (wpis Dobór liczebności próby).
- Porównywanie testów. Pytanie z 1952 r. – ile obserwacji potrzebuje jeden test, by dorównać drugiemu – wraca przy porównywaniu mocy testów.
- Wiele zmiennych naraz. W pracy dyplomowej zwykle lepiej sprawdzi się PCA albo analiza skupień, a twarze – jako ilustracja.
Spory, mity i trudne strony
- Czy twarze to poważna metoda? Sam Chernoff (1973) przedstawił je jako sposób na szybkie uchwycenie regularności i nieregularności w danych. Ich słabość to arbitralność przypisania zmiennych do cech (rysunek 3). Badania nad dokładnością odczytu wykresów, opisane w haśle o Williamie Clevelandzie, przemawiają raczej za położeniem punktów na wspólnej skali.
Granica Chernoffa i twarze Chernoffa w R
Kod liczy dywergencję Kullbacka–Leiblera i minimum funkcji tworzącej momenty, porównuje dokładny ogon rozkładu dwumianowego z granicami Chernoffa i Hoeffdinga (rysunek 2), a potem rysuje twarze Chernoffa dla 9 krajów (rysunek 3). Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1, p2 i p3, którym podmieniono tylko krój i tło na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Granice ogona i twarze: rysunki 2 i 3
Kod R rysunków 2 i 3
# Herman Chernoff: (1) granica Chernoffa vs Hoeffdinga vs dokładny ogon rozkładu dwumianowego,
# (2) twarze Chernoffa dla 9 krajów z danych datasets::LifeCycleSavings (rysowane w ggplot2). Kod nie losuje.
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(dokladne = "black", chernoff = "#0072B2", hoeffding = "#D55E00")    # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# --- Część 1. Rzadkie zdarzenie: odsetek sukcesów w populacji wynosi 0.10; jak prawdopodobne jest,
#     że w próbie n osób odsetek wyniesie co najmniej a = 0.20?
p <- 0.10; a <- 0.20
KL <- a * log(a / p) + (1 - a) * log((1 - a) / (1 - p))     # dywergencja Kullbacka–Leiblera KL(a || p)
# Chernoff (1952): P(S_n >= na) zachowuje się jak m^n, gdzie m = min_t E exp(t(X - a))
m <- optimize(function(t) (1 - p + p * exp(t)) * exp(-t * a), c(0, 10))$objective
round(c(KL = KL, minus_log_m = -log(m), wykladnik_Hoeffdinga = 2 * (a - p)^2), 5)

ogon <- data.frame(n = seq(20, 600, by = 10))
ogon$dokladne <- pbinom(ceiling(ogon$n * a) - 1, ogon$n, p, lower.tail = FALSE)   # P(X >= na)
ogon$chernoff <- exp(-ogon$n * KL)
ogon$hoeffding <- exp(-2 * ogon$n * (a - p)^2)
signif(ogon[ogon$n %in% c(50, 100, 200, 400), ], 3)

# Ile osób trzeba, żeby P(odsetek >= 0.20) było mniejsze niż 0.001?
n_ile <- function(f) min(ogon$n[f <= 0.001])
c(dokladnie = n_ile(ogon$dokladne), Chernoff = n_ile(ogon$chernoff), Hoeffding = n_ile(ogon$hoeffding))

# Porównanie: przy odsetku 0.5 i progu 0.6 oba wykładniki są prawie równe
round(c(KL_p05 = 0.6 * log(0.6 / 0.5) + 0.4 * log(0.4 / 0.5), Hoeffding_p05 = 2 * 0.1^2), 5)

dl <- rbind(data.frame(n = ogon$n, P = ogon$dokladne, metoda = "dokładne (dwumianowy)"),
            data.frame(n = ogon$n, P = ogon$chernoff, metoda = "granica Chernoffa"),
            data.frame(n = ogon$n, P = ogon$hoeffding, metoda = "granica Hoeffdinga"))
pA <- ggplot(dl, aes(n, P, colour = metoda, linetype = metoda)) +
  geom_hline(yintercept = 0.001, colour = "grey60") +
  geom_line(linewidth = 1) +
  scale_y_log10(breaks = 10^(-12:0), labels = function(x) format(x, scientific = TRUE)) +
  scale_colour_manual(values = unname(kol), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dotted"), name = NULL) +
  labs(title = "A. P(odsetek ≥ 0.20) przy odsetku 0.10 w populacji", x = "Liczebność próby n", y = "Prawdopodobieństwo (skala log)") +
  motyw
tempo <- data.frame(n = ogon$n, w = -log(ogon$dokladne) / ogon$n)
pB <- ggplot(tempo, aes(n, w)) +
  geom_hline(yintercept = KL, colour = kol[["chernoff"]], linetype = "longdash", linewidth = 1) +
  geom_hline(yintercept = 2 * (a - p)^2, colour = kol[["hoeffding"]], linetype = "dotted", linewidth = 1) +
  geom_line(linewidth = 1) +
  annotate("text", x = 600, y = KL + 0.002, hjust = 1, vjust = 0, size = 3.4, label = sprintf("Chernoff: KL = %.4f", KL)) +
  annotate("text", x = 600, y = 2 * (a - p)^2 - 0.002, hjust = 1, vjust = 1, size = 3.4,
           label = sprintf("Hoeffding: 2(a − p)² = %.4f", 2 * (a - p)^2)) +
  coord_cartesian(ylim = c(0, 0.07)) +
  labs(title = "B. Tempo spadku: −log P / n", x = "Liczebność próby n", y = "Wykładnik") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.2, 1))
p2

# --- Część 2. Twarze Chernoffa: 5 zmiennych z LifeCycleSavings (średnie z lat 1960–1970) dla 9 krajów
data(LifeCycleSavings, package = "datasets")
# sr – stopa oszczędności; pop15 i pop75 – % ludności poniżej 15 i powyżej 75 lat;
# dpi – dochód rozporządzalny na osobę; ddpi – tempo wzrostu dpi (%)
r01 <- function(x) (rank(x) - 1) / (length(x) - 1)        # pozycja rangowa 0–1 wśród 50 krajów
z <- as.data.frame(lapply(LifeCycleSavings, r01), row.names = rownames(LifeCycleSavings))
kraje <- c("Japan", "United States", "Sweden", "Italy", "Ireland", "Chile", "India", "Zambia", "Libya")
nazwy <- c("Japonia", "USA", "Szwecja", "Włochy", "Irlandia", "Chile", "Indie", "Zambia", "Libia")
round(LifeCycleSavings[kraje, ], 2)        # wartości
round(z[kraje, ], 2)                       # pozycje rangowe 0–1, które sterują rysunkiem

elipsa <- function(x0, y0, a, b, k = 60) { t <- seq(0, 2 * pi, length.out = k); data.frame(x = x0 + a * cos(t), y = y0 + b * sin(t)) }
twarz <- function(v, nazwa) {
  # v: szerokość twarzy <- dpi; oczy <- sr; uśmiech <- ddpi; nos <- pop15; brwi <- pop75
  szer <- 0.6 + 0.4 * v[["dpi"]]; oko <- 0.06 + 0.10 * v[["sr"]]
  usmiech <- -0.25 + 0.5 * v[["ddpi"]]; nos <- 0.10 + 0.30 * v[["pop15"]]; brew <- -0.15 + 0.30 * v[["pop75"]]
  xs <- seq(-0.35, 0.35, length.out = 30)
  rbind(
    cbind(elipsa(0, 0, szer, 1), czesc = "glowa"),
    cbind(elipsa(-0.3, 0.3, oko, oko * 0.8), czesc = "oko_l"),
    cbind(elipsa(0.3, 0.3, oko, oko * 0.8), czesc = "oko_p"),
    data.frame(x = c(0, 0), y = c(0.15, 0.15 - nos), czesc = "nos"),
    data.frame(x = xs, y = -0.5 + usmiech * ((xs / 0.35)^2 - 0.5), czesc = "usta"),   # kąciki w górę = uśmiech
    data.frame(x = c(-0.45, -0.15), y = c(0.5 - brew, 0.5 + brew), czesc = "brew_l"),
    data.frame(x = c(0.15, 0.45), y = c(0.5 + brew, 0.5 - brew), czesc = "brew_p")) |>
    transform(kraj = nazwa)
}
twarze <- do.call(rbind, Map(function(k, nz) twarz(unlist(z[k, ]), nz), kraje, nazwy))
twarze$kraj <- factor(twarze$kraj, levels = nazwy)
p3 <- ggplot(twarze, aes(x, y, group = czesc)) +
  geom_polygon(data = subset(twarze, czesc == "glowa"), fill = "#F0E442", colour = "black", linewidth = 0.6) +
  geom_polygon(data = subset(twarze, czesc %in% c("oko_l", "oko_p")), fill = "white", colour = "black") +
  geom_path(data = subset(twarze, !czesc %in% c("glowa", "oko_l", "oko_p")), linewidth = 0.9, lineend = "round") +
  facet_wrap(~ kraj, nrow = 3) +
  coord_equal(xlim = c(-1.05, 1.05), ylim = c(-1.05, 1.05)) +
  labs(title = "Twarze Chernoffa: 9 krajów, 5 zmiennych",
       caption = "Szerokość twarzy – dochód na osobę; oczy – stopa oszczędności; uśmiech – wzrost dochodu;\nnos – % ludności < 15 lat; nachylenie brwi – % ludności > 75 lat (każda zmienna jako pozycja rangowa wśród 50 krajów)") +
  theme_void(base_size = 13) +
  theme(strip.text = element_text(face = "bold"), plot.title = element_text(face = "bold"),
        plot.caption = element_text(hjust = 0))
p3
Wynik w R
                  KL          minus_log_m wykladnik_Hoeffdinga
              0.0444               0.0444               0.0200
     n dokladne chernoff hoeffding
4   50 2.45e-02 1.09e-01  0.368000
9  100 1.98e-03 1.18e-02  0.135000
19 200 1.70e-05 1.39e-04  0.018300
39 400 1.70e-09 1.93e-08  0.000335
dokladnie  Chernoff Hoeffding
      120       160       350
       KL_p05 Hoeffding_p05
      0.02014       0.02000
                 sr pop15 pop75     dpi  ddpi
Japan         21.10 27.01  1.91 1257.28  8.21
United States  7.56 29.81  3.43 4001.89  2.45
Sweden         6.86 21.44  4.54 3299.49  3.01
Italy         14.28 24.52  3.48 1390.00  3.54
Ireland       11.34 31.16  4.19 1139.95  2.99
Chile          0.60 39.74  1.34  662.86  2.67
India          9.00 41.31  0.96   88.94  1.54
Zambia        18.56 45.25  0.56  138.33  5.14
Libya          8.89 43.69  2.07  123.58 16.71
                sr pop15 pop75  dpi ddpi
Japan         1.00  0.27  0.47 0.63 0.96
United States 0.29  0.39  0.78 1.00 0.35
Sweden        0.24  0.00  0.98 0.98 0.51
Italy         0.90  0.16  0.80 0.65 0.59
Ireland       0.61  0.41  0.90 0.61 0.49
Chile         0.00  0.55  0.39 0.49 0.39
India         0.41  0.61  0.16 0.00 0.14
Zambia        0.98  0.82  0.00 0.04 0.82
Libya         0.39  0.73  0.49 0.02 1.00
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Herman Chernoff (1923–2026) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1923, 1943, 1947, 1949, 1952, 1967, 1973, 1974, 1985, 1987, 1997, 2026),
  opis = c("urodził się\nw Nowym Jorku", "dyplom z matematyki\n(City College)", "Cowles Commission\n(Chicago)",
           "University of Illinois", "Stanford; granica\nz pracy o efektywności testów", "prezes IMS",
           "twarze Chernoffa", "MIT", "Harvard", "Nagroda Wilksa (ASA)", "emerytura", "zmarł 6 lipca\n(103 lata)"),
  rodzaj = c("życie", "życie", "praca", "praca", "publikacja", "wyróżnienie",
             "publikacja", "praca", "praca", "wyróżnienie", "praca", "życie"),
  poziom = c(0.5, -0.5, 1.4, -1.4, 0.5, -0.5, 1.4, -1.4, 0.5, -0.5, 1.4, -0.5),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1915, 2034), breaks = seq(1920, 2030, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.4)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (rozkład dwumianowy i minimalizacja – funkcje pbinom() i optimize() z pakietu stats; dane – pakiet datasets; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Herman Chernoff?
Amerykańskim statystykiem (1923–2026) z Nowego Jorku. Rozprawę doktorską przygotował pod kierunkiem Abrahama Walda, pracował w Cowles Commission i na University of Illinois, przez 22 lata w Stanford, potem w MIT i od 1985 r. na Harvardzie. Był prezesem Institute of Mathematical Statistics i członkiem National Academy of Sciences.
Co to jest granica Chernoffa?
Górne ograniczenie prawdopodobieństwa, że suma n niezależnych zmiennych odchyli się od oczekiwanej o co najmniej ustaloną wartość. Maleje wykładniczo z n, a jego wykładnik to minimum funkcji tworzącej momenty – dla zmiennych 0–1 dywergencja Kullbacka–Leiblera. Pochodzi z pracy o efektywności testów z 1952 r.
Czym różni się granica Chernoffa od nierówności Hoeffdinga?
Hoeffding korzysta tylko z zakresu zmiennej, a Chernoff z całego rozkładu. Przy rzadkiej cesze (10% w populacji, próg 20%) przy n = 100 dokładne prawdopodobieństwo to .00198, granica Chernoffa .0118, a Hoeffdinga .135. Przy odsetku 50% obie granice są prawie takie same.
Co to są twarze Chernoffa?
Sposób rysowania danych wielowymiarowych, który Chernoff opisał w 1973 r.: każda obserwacja to schematyczna twarz, a jej cechy, np. szerokość, wielkość oczu czy krzywizna ust, odpowiadają wartościom zmiennych (do 18). Pomagają wyłowić podobne i nietypowe przypadki, ale ich odczyt zależy od przypisania zmiennych do cech.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bather, J. (1996). A conversation with Herman Chernoff. Statistical Science, 11(4), 335–350. https://doi.org/10.1214/ss/1032280306 ● Otwarty dostęp
- Chernoff, H. (1952). A measure of asymptotic efficiency for tests of a hypothesis based on the sum of observations. The Annals of Mathematical Statistics, 23(4), 493–507. https://doi.org/10.1214/aoms/1177729330 ● Otwarty dostęp
- Chernoff, H. (1973). The use of faces to represent points in k-dimensional space graphically. Journal of the American Statistical Association, 68(342), 361–368. https://doi.org/10.1080/01621459.1973.10482434
- Hoeffding, W. (1963). Probability inequalities for sums of bounded random variables. Journal of the American Statistical Association, 58(301), 13–30. https://doi.org/10.1080/01621459.1963.10500830
- New England Statistical Society. (b.d.). Herman Chernoff [biografia patrona nagrody]. Pobrano 20 listopada 2026 z https://nestat.org/about/bio/herman-bio/ ● Otwarty dostęp
- Stanford University Department of Statistics. (2026). Remembering Herman Chernoff (1923–2026). https://statistics.stanford.edu/news/remembering-herman-chernoff-1923-2026 ● Otwarty dostęp
Cytowania BibTeX
@article{bather1996conversation, author={Bather, John}, title={{A conversation with Herman Chernoff}}, journal={Statistical Science}, year={1996}, volume={11}, number={4}, pages={335--350}, doi={10.1214/ss/1032280306}}@article{chernoff1952measure, author={Chernoff, Herman}, title={{A measure of asymptotic efficiency for tests of a hypothesis based on the sum of observations}}, journal={The Annals of Mathematical Statistics}, year={1952}, volume={23}, number={4}, pages={493--507}, doi={10.1214/aoms/1177729330}}@article{chernoff1973use, author={Chernoff, Herman}, title={{The use of faces to represent points in k-dimensional space graphically}}, journal={Journal of the American Statistical Association}, year={1973}, volume={68}, number={342}, pages={361--368}, doi={10.1080/01621459.1973.10482434}}@article{hoeffding1963probability, author={Hoeffding, Wassily}, title={{Probability inequalities for sums of bounded random variables}}, journal={Journal of the American Statistical Association}, year={1963}, volume={58}, number={301}, pages={13--30}, doi={10.1080/01621459.1963.10500830}}@misc{nessbdchernoff, author={{New England Statistical Society}}, title={{Herman Chernoff [biografia patrona nagrody]}}, publisher={New England Statistical Society}, url={https://nestat.org/about/bio/herman-bio/}}@misc{stanford2026remembering, author={{Stanford University Department of Statistics}}, title={{Remembering Herman Chernoff (1923–2026)}}, year={2026}, publisher={Stanford University}, url={https://statistics.stanford.edu/news/remembering-herman-chernoff-1923-2026}}