Kim byli Daniel Kahneman i Amos Tversky?
Daniel Kahneman (1934–2024) i Amos Tversky (1937–1996) to dwaj psychologowie, którzy pokazali, że ludzkie oceny prawdopodobieństwa – także oceny zawodowych badaczy – mylą się w systematyczny i przewidywalny sposób. W 1971 r. obaj pracowali na Uniwersytecie Hebrajskim w Jerozolimie; tę afiliację podaje ich pierwszy wspólny artykuł (Tversky i Kahneman, 1971).
Tversky zaczynał od psychologii matematycznej: zajmował się teorią wyboru, podobieństwa i pomiaru. Shafir (2018) zalicza go do najważniejszych badaczy ludzkich sądów i decyzji oraz do współtwórców ekonomii behawioralnej. Zmarł w 1996 r. (Kahneman, 2003).
Kahneman doktoryzował się z psychologii na Uniwersytecie Kalifornijskim w Berkeley. W 1978 r. przeniósł się na University of British Columbia w Vancouver, potem pracował w Berkeley i w Princeton, gdzie został profesorem emerytowanym (UBC Department of Psychology, 2024). W 2002 r. otrzymał Nagrodę Nobla z ekonomii, wspólnie z Vernonem Smithem. Zmarł 27 marca 2024 r. w wieku 90 lat (UBC Department of Psychology, 2024; Fischhoff, 2024).
Najważniejsze pomysły
- „Wiara w prawo małych liczb” (1971). Ludzie traktują małą próbę losową tak, jakby była prawie wiernym obrazem populacji. Autorzy nazwali to ironicznie prawem małych liczb: intuicja zachowuje się tak, jakby prawo wielkich liczb działało już przy kilku obserwacjach. Ankieta pokazała, że psycholodzy przeceniają moc małych badań i szansę replikacji, a za wąsko wyobrażają sobie przedziały ufności (Tversky i Kahneman, 1971).
- Heurystyki i błędy (1974). W artykule w Science opisali trzy skróty myślowe w ocenie prawdopodobieństwa: reprezentatywność, dostępność i zakotwiczenie z dostosowaniem. Są oszczędne i zwykle skuteczne, ale prowadzą do systematycznych błędów (Tversky i Kahneman, 1974).
- Teoria perspektywy. Później zaproponowali opisową teorię wyboru w warunkach ryzyka, przełomową dla ekonomii behawioralnej (Shafir, 2018).
Ciekawostka
Ankietę do artykułu z 1971 r. rozdano na zjazdach Mathematical Psychology Group i Amerykańskiego Towarzystwa Psychologicznego. Pierwsze pytanie brzmiało tak: masz istotny wynik z badania na 20 osobach (z = 2.23), jaka jest szansa na istotny wynik w nowej grupie 10 osób? Mediana odpowiedzi wyniosła .85, a tylko 9 z 84 osób podało wartość między .40 a .60 – tam, gdzie leży rozsądna odpowiedź. Odpowiedzi uczestników zjazdu psychologów matematycznych praktycznie nie różniły się od odpowiedzi publiczności ogólnej sesji zjazdu APA. Wniosek autorów: znajomość rachunku prawdopodobieństwa nie gasi błędnych intuicji (Tversky i Kahneman, 1971).
Drobny szczegół z tego samego artykułu: w pierwszym przypisie autorzy zaznaczyli, że kolejność ich nazwisk jest losowa. W podziękowaniach wymienili m.in. Jacoba Cohena i Johna Tukeya (Tversky i Kahneman, 1971).
Przykład: ankieta z 1971 r. policzona w R
Liczymy odpowiedzi na pytania z ankiety tak, jak zaproponowali autorzy: prawdziwy efekt utożsamiamy z efektem z pierwszego badania i liczymy moc drugiego badania. Wszystkie liczby wejściowe (z, t, n, liczba korelacji) pochodzą z artykułu; symulacja ma ziarno set.seed(1971).
- Nowa grupa 10 osób. Efekt z pierwszego badania to 0.499 odchylenia standardowego na osobę, więc w grupie 10 osób oczekiwane z wynosi tylko 1.577 – mniej niż próg 1.645. Szansa na istotny wynik to .473, tyle samo co w artykule. Symulacja 20 000 replikacji dała .473 dla 10 osób, .719 dla 20 i .934 dla 40.
- Doktorant. Wynik t = 2.70 przy 40 zwierzętach (porównanie przed–po). Ankietowani radzili replikację na 20 zwierzętach; oczekiwane t wynosi wtedy 1.91 (w artykule 1.88), a szansa na istotny wynik – tylko .578. Żeby ryzyko t < 1.70 spadło do .10, potrzeba 50 zwierząt, a przy słabszym oryginale (t = 2.20) – 74; artykuł podaje około 50 i 75.
- „Nieudana” replikacja. Oryginał t = 2.46, replikacja t = 1.70, po 15 osób. Dane łącznie dają t ≈ 2.94, a różnica między badaniami ma t ≈ 0.54 – nie ma czego wyjaśniać.
- 27 istotnych korelacji. Przy N = 40 próg istotności to r = .312, a moc dla r = .31 wynosi .496. Powtórzy się więc około 13 korelacji z 27, a nie 18, jak sądziła mediana ankietowanych.
- Cztery z pięciorga niemowląt. Gdy 4 z 5 wybiera tę samą zabawkę, dwustronne p w rozkładzie dwumianowym wynosi .375 – dokładnie 3/8, jak w artykule.
Na rysunku
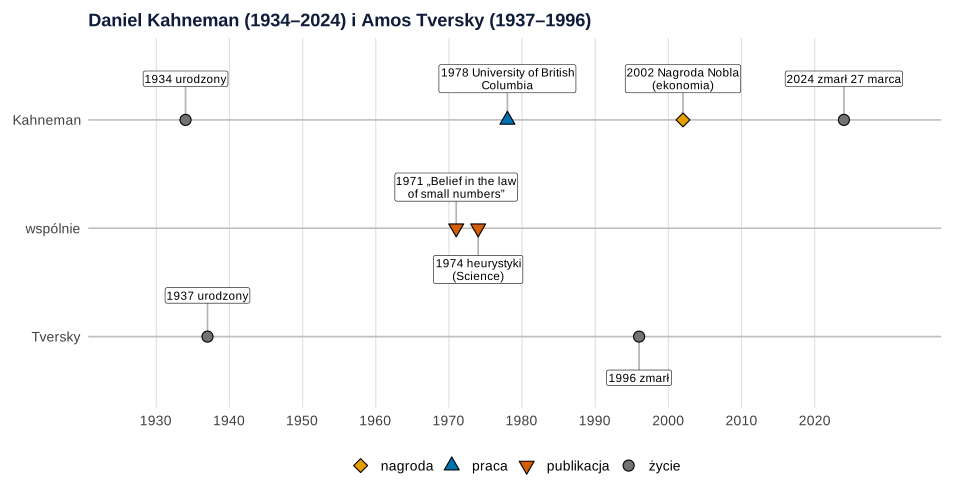
Co widać. Dwa najważniejsze dla statystyki artykuły powstały w ciągu czterech lat, na wspólnym pasie. Nagroda Nobla przyszła sześć lat po śmierci Tversky’ego.
Na co uważać. Oś zawiera tylko daty z cytowanych źródeł. Pominęliśmy m.in. lata studiów i początek współpracy, których nie potwierdziliśmy w dostępnych źródłach.
Podpis do pracy:
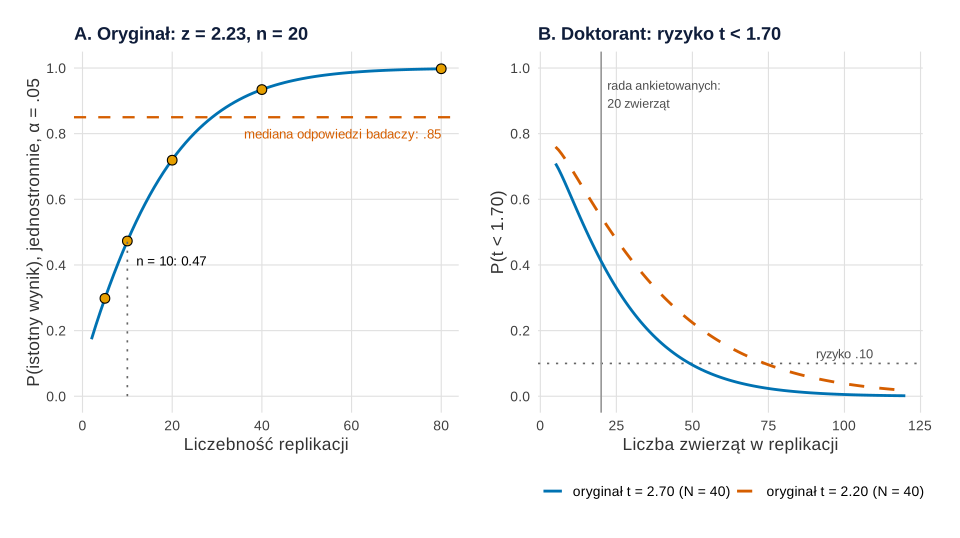
set.seed(1971)).Co widać. Intuicja ankietowanych (.85) odpowiadałaby replikacji na 28.9, czyli około 29 osobach, a nie na 10. W panelu B przy 20 zwierzętach, które radziła mediana ankietowanych, ryzyko słabego wyniku wynosi .412 przy mocniejszym oryginale i .547 przy słabszym. Stąd wniosek autorów: replikacja często powinna być większa niż oryginał.
Na co uważać. To rachunek optymistyczny: zakłada, że prawdziwy efekt jest równy efektowi z pierwszego badania. Gdy oryginał trafił do druku dlatego, że był istotny, jego efekt bywa zawyżony – zob. klątwa zwycięzcy – i prawdziwa szansa replikacji jest jeszcze mniejsza.
Podpis do pracy:
Gdzie spotkasz Kahnemana i Tversky’ego w swojej pracy
- Planowanie liczebności. Autorzy zalecali liczyć moc przed każdym badaniem, np. dla małego, średniego i dużego efektu w ujęciu Cohena – zob. moc testu i symulacyjna analiza mocy. Bez tego łatwo o błąd II rodzaju.
- Replikacje. Artykuł z 1971 r. wyprzedził dyskusję opisaną w hasłach kryzys replikacyjny w psychologii i replikowalność; praktyczne wskazówki znajdziesz we wpisie jak zaplanować badanie replikacyjne.
- Raportowanie. Autorzy proponowali podawać obok poziomu istotności wielkość efektu i przedział ufności. Różnicę między wielkością efektu a jego istotnością wyjaśnia hasło wartość p.
Spory, mity i trudne strony
- Czy to krytyka statystyki? Nie. Autorzy pisali, że testy istotności chronią przed pochopnym odrzucaniem hipotezy zerowej; krytykowali brak rachunku mocy i przedziałów ufności. Za lekarstwo uznali obliczenia zamiast wrażeń (Tversky i Kahneman, 1971).
- Nobel bez Tversky’ego. W opublikowanym wykładzie noblowskim Kahneman zaznaczył, że prace wyróżnione przez Komitet Noblowski powstały wspólnie z Tverskym w czasie długiej i bliskiej współpracy (Kahneman, 2003).
- Ekonomia. Wpływ tej pary na ekonomię pomijamy świadomie. O podobnych pułapkach myślenia badaczy pisał Paul Meehl.
Kahneman i Tversky w R
Kod rysuje oś czasu, a potem liczy odpowiedzi na pytania z ankiety z 1971 r.: moc replikacji z rozkładu normalnego i niecentralnego rozkładu t, symulację 20 000 replikacji, liczebność potrzebną do ryzyka .10, wynik łączny dwóch badań, próg istotności korelacji i dokładny test dwumianowy. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Oś czasu i pytania z ankiety o prawie małych liczb
Kod R rysunków 1 i 2 i obliczeń
# Kahneman i Tversky: oś czasu i pytania z ankiety „Belief in the law of small numbers” (1971) policzone w R
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu w trzech pasach (lata według cytowanych źródeł)
zdarzenia <- data.frame(
  rok = c(1934, 1978, 2002, 2024, 1937, 1971, 1974, 1996),
  pas = c(rep("Kahneman", 4), "Tversky", rep("wspólnie", 2), "Tversky"),
  opis = c("urodzony", "University of British\nColumbia", "Nagroda Nobla\n(ekonomia)", "zmarł 27 marca",
           "urodzony", "„Belief in the law\nof small numbers”", "heurystyki\n(Science)", "zmarł"),
  rodzaj = c("życie", "praca", "nagroda", "życie", "życie", "publikacja", "publikacja", "życie"))
zdarzenia$pas <- factor(zdarzenia$pas, levels = c("Tversky", "wspólnie", "Kahneman"))
zdarzenia$y <- as.numeric(zdarzenia$pas) + c(0.38, 0.38, 0.38, 0.38, 0.38, 0.38, -0.38, -0.38)
p_os <- ggplot(zdarzenia, aes(rok, as.numeric(pas))) +
  geom_hline(yintercept = 1:3, colour = "grey75") +
  geom_segment(aes(xend = rok, yend = y), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, " ", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "praca" = 24, "publikacja" = 25, "nagroda" = 23), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "praca" = oi[["niebieski"]], "publikacja" = oi[["cynober"]],
                               "nagroda" = oi[["pomaranczowy"]]), name = NULL) +
  scale_y_continuous(breaks = 1:3, labels = levels(zdarzenia$pas), limits = c(0.5, 3.6)) +
  scale_x_continuous(breaks = seq(1930, 2020, 10), limits = c(1926, 2032)) +
  labs(title = "Daniel Kahneman (1934–2024) i Amos Tversky (1937–1996)", x = NULL, y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Pytanie 1: z = 2.23 przy n = 20; jaka jest szansa na istotny wynik (test jednostronny, α = .05) w nowej grupie n = 10?
#    Jak w przypisie 2 artykułu: przyjmujemy, że prawdziwy efekt równa się efektowi z pierwszego badania.
z1 <- 2.23; n1 <- 20
delta <- z1 / sqrt(n1)                       # efekt w odchyleniach standardowych na osobę
moc_z <- function(n2) 1 - pnorm(qnorm(0.95) - delta * sqrt(n2))
round(c(delta = delta, oczekiwane_z_przy_n10 = delta * sqrt(10), szansa_n10 = moc_z(10)), 3)
set.seed(1971)
n_rep <- c(5, 10, 20, 40, 80)
symulacja <- sapply(n_rep, function(n2) {
  z <- replicate(20000, mean(rnorm(n2, mean = delta, sd = 1)) * sqrt(n2))
  mean(z > qnorm(0.95))
})
data.frame(n_replikacji = n_rep, symulacja = round(symulacja, 3), wzor = round(moc_z(n_rep), 3))
# Przy jakiej liczebności replikacji szansa dochodzi do mediany odpowiedzi ankietowanych (.85)?
round((qnorm(0.95) + qnorm(0.85))^2 / delta^2, 1)

# 3. Pytanie o doktoranta: t = 2.70 przy N = 40 (porównanie przed–po), replikacja na 20 zwierzętach
d_dokt <- 2.70 / sqrt(40)
moc_t <- function(n, d) 1 - pt(qt(0.95, n - 1), df = n - 1, ncp = d * sqrt(n))
round(c(oczekiwane_t_przy_n20 = d_dokt * sqrt(20), szansa_n20 = moc_t(20, d_dokt)), 3)
# Ilu zwierząt potrzeba, by ryzyko t < 1.70 w replikacji wynosiło najwyżej .10 (dla t = 2.70 i t = 2.20 przy N = 40)?
ryzyko <- function(n, t0) pt(1.70, df = n - 1, ncp = t0 / sqrt(40) * sqrt(n))
sapply(c(t_2.70 = 2.70, t_2.20 = 2.20), function(t0) min(which(sapply(1:200, function(n) n > 2 && ryzyko(n, t0) <= 0.10))))
round(c(ryzyko_n20_t2.70 = ryzyko(20, 2.70), ryzyko_n20_t2.20 = ryzyko(20, 2.20)), 3)   # rada ankietowanych: 20 zwierząt

# 4. Badanie oryginalne t = 2.46, replikacja t = 1.70 (po 15 osób): wynik łączny i test różnicy
round(c(t_laczne = (2.46 + 1.70) / sqrt(2), t_roznicy = (2.46 - 1.70) / sqrt(2)), 2)

# 5. 27 istotnych korelacji (średnio |r| = .31) przy N = 100; ile powtórzy się przy N = 40?
r_kryt_40 <- function(alfa = 0.05) { t <- qt(1 - alfa / 2, 38); t / sqrt(t^2 + 38) }
moc_r <- 1 - pnorm(qnorm(0.975) - atanh(0.31) * sqrt(40 - 3))
round(c(r_krytyczne_N40 = r_kryt_40(), moc_r = moc_r, oczekiwana_liczba = 27 * moc_r), 3)

# 6. Cztery z pięciorga niemowląt wybrały tę samą zabawkę: p dwustronne
binom.test(4, 5)$p.value   # hipoteza zerowa: brak preferencji

# Rysunek 2A: szansa istotnej replikacji a liczebność nowej grupy (pytanie 1)
krzywa <- data.frame(n = 2:80); krzywa$p <- moc_z(krzywa$n)
pA <- ggplot(krzywa, aes(n, p)) +
  geom_hline(yintercept = 0.85, colour = oi[["cynober"]], linetype = "dashed", linewidth = 0.8) +
  annotate("text", x = 58, y = 0.80, label = "mediana odpowiedzi badaczy: .85", colour = oi[["cynober"]], size = 3.5) +
  geom_line(colour = oi[["niebieski"]], linewidth = 1) +
  geom_point(data = data.frame(n = n_rep, p = symulacja), shape = 21, size = 3, fill = oi[["pomaranczowy"]]) +
  annotate("segment", x = 10, xend = 10, y = 0, yend = moc_z(10), colour = "grey40", linetype = "dotted") +
  annotate("text", x = 12, y = moc_z(10) - 0.06, label = sprintf("n = 10: %.2f", moc_z(10)), hjust = 0, size = 3.5) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  labs(title = "A. Oryginał: z = 2.23, n = 20", x = "Liczebność replikacji", y = "P(istotny wynik), jednostronnie, α = .05") +
  motyw
# Rysunek 2B: ryzyko wyniku t < 1.70 w replikacji doktoranta a liczba zwierząt
ryz <- expand.grid(n = 5:120, t0 = c(2.70, 2.20))
ryz$ryzyko <- mapply(ryzyko, ryz$n, ryz$t0)
ryz$oryginal <- factor(sprintf("oryginał t = %.2f (N = 40)", ryz$t0), levels = sprintf("oryginał t = %.2f (N = 40)", c(2.70, 2.20)))
pB <- ggplot(ryz, aes(n, ryzyko, colour = oryginal, linetype = oryginal)) +
  geom_hline(yintercept = 0.10, colour = "grey40", linetype = "dotted") +
  annotate("text", x = 100, y = 0.13, label = "ryzyko .10", size = 3.4, colour = "grey30") +
  geom_vline(xintercept = 20, colour = "grey60") +
  annotate("text", x = 22, y = 0.92, label = "rada ankietowanych:\n20 zwierząt", hjust = 0, size = 3.3, colour = "grey30") +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = c(oi[["niebieski"]], oi[["cynober"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  labs(title = "B. Doktorant: ryzyko t < 1.70", x = "Liczba zwierząt w replikacji", y = "P(t < 1.70)") +
  motyw + theme(legend.position = "bottom")
p_metoda <- pA + pB
p_os
p_metoda
Wynik w R
                delta oczekiwane_z_przy_n10            szansa_n10
                0.499                 1.577                 0.473
  n_replikacji symulacja  wzor
1            5     0.298 0.298
2           10     0.473 0.473
3           20     0.719 0.721
4           40     0.934 0.934
5           80     0.998 0.998
[1] 28.9
oczekiwane_t_przy_n20            szansa_n20
                1.909                 0.578
t_2.70 t_2.20
    50     74
ryzyko_n20_t2.70 ryzyko_n20_t2.20
           0.412            0.547
 t_laczne t_roznicy
     2.94      0.54
  r_krytyczne_N40             moc_r oczekiwana_liczba
            0.312             0.496            13.391
[1] 0.375
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (rozkłady, symulacja i test dwumianowy – pakiet stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim byli Daniel Kahneman i Amos Tversky?
Psychologami: Kahneman (1934–2024) i Tversky (1937–1996) badali, jak ludzie oceniają prawdopodobieństwo i podejmują decyzje. W 1971 r. pracowali na Uniwersytecie Hebrajskim w Jerozolimie. Kahneman w 2002 r. otrzymał Nagrodę Nobla z ekonomii za prace prowadzone wspólnie z Tverskym, który zmarł w 1996 r.
Co to jest prawo małych liczb?
Ironiczna nazwa błędnej intuicji: ludzie zachowują się tak, jakby prawo wielkich liczb działało już w małych próbach, czyli jakby kilka obserwacji wiernie odzwierciedlało populację. Tversky i Kahneman pokazali w 1971 r., że ulegają temu także psycholodzy znający statystykę – przeceniają moc małych badań i szansę replikacji.
Jaka jest szansa, że istotny wynik się powtórzy?
Zależy od mocy replikacji, a nie od tego, jak „mocny” wydaje się wynik. Badacze pytani przez Tversky’ego i Kahnemana oceniali ją medianą na .85 dla replikacji na 10 osobach po wyniku z = 2.23 na 20 osobach, a rachunek daje około .47 – i to przy optymistycznym założeniu, że efekt z oryginału jest prawdziwy.
Jakie heurystyki opisali Tversky i Kahneman?
W artykule w Science (1974) opisali trzy: reprezentatywność, dostępność oraz zakotwiczenie z dostosowaniem. To oszczędne skróty myślowe, które zwykle działają, ale prowadzą do systematycznych i przewidywalnych błędów w ocenie prawdopodobieństwa i w szacunkach liczbowych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zaplanować badanie replikacyjne
Rodzaj replikacji, materiały od autorów, liczebność przy zawyżonym efekcie, kryteria sukcesu i protokół registered report z kodem w R.
Czytaj →PoradnikMoc testu w obrazkach
Pola α, β i mocy na dwóch rozkładach, krzywe mocy z symulacją, klątwa zwycięzcy przy niskiej mocy i moc po fakcie – pięć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fischhoff, B. (2024). Daniel Kahneman (1934–2024). Science, 384(6695), 515. https://doi.org/10.1126/science.adp6405 ● Otwarty dostęp
- Kahneman, D. (2003). Maps of bounded rationality: Psychology for behavioral economics. American Economic Review, 93(5), 1449–1475. https://doi.org/10.1257/000282803322655392
- Shafir, E. (2018). Tversky, Amos (1937–1996). In The New Palgrave dictionary of economics (3rd ed.) (pp. 13937–13941). Palgrave Macmillan. https://doi.org/10.1057/978-1-349-95189-5_2018
- Tversky, A., & Kahneman, D. (1971). Belief in the law of small numbers. Psychological Bulletin, 76(2), 105–110. https://doi.org/10.1037/h0031322
- Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
- UBC Department of Psychology. (2024, 4 kwietnia). In memoriam: Dr. Daniel Kahneman. University of British Columbia. https://psych.ubc.ca/?p=37875 ● Otwarty dostęp
Cytowania BibTeX
@article{fischhoff2024daniel, author={Fischhoff, Baruch}, title={{Daniel Kahneman (1934–2024)}}, journal={Science}, year={2024}, volume={384}, number={6695}, pages={515}, doi={10.1126/science.adp6405}}@article{kahneman2003maps, author={Kahneman, Daniel}, title={{Maps of bounded rationality: Psychology for behavioral economics}}, journal={American Economic Review}, year={2003}, volume={93}, number={5}, pages={1449--1475}, doi={10.1257/000282803322655392}}@incollection{shafir2018tversky, author={Shafir, Eldar}, title={{Tversky, Amos (1937–1996)}}, booktitle={The New Palgrave dictionary of economics (3rd ed.)}, year={2018}, pages={13937--13941}, publisher={Palgrave Macmillan}, doi={10.1057/978-1-349-95189-5_2018}}@article{tversky1971belief, author={Tversky, Amos and Kahneman, Daniel}, title={{Belief in the law of small numbers}}, journal={Psychological Bulletin}, year={1971}, volume={76}, number={2}, pages={105--110}, doi={10.1037/h0031322}}@article{tversky1974judgment, author={Tversky, Amos and Kahneman, Daniel}, title={{Judgment under uncertainty: Heuristics and biases}}, journal={Science}, year={1974}, volume={185}, number={4157}, pages={1124--1131}, doi={10.1126/science.185.4157.1124}}@misc{ubc2024kahneman, author={{UBC Department of Psychology}}, title={{In memoriam: Dr. Daniel Kahneman}}, year={2024}, publisher={University of British Columbia}, url={https://psych.ubc.ca/?p=37875}}