Kim był Paul E. Meehl?
Paul Everett Meehl (1920–2003) był amerykańskim psychologiem klinicznym, przez całe życie zawodowe związanym z Uniwersytetem Minnesoty (Faust i Waller, 2004; Waller i Lilienfeld, 2005). Na uczelnię wstąpił w wieku 18 lat z zamiarem studiowania medycyny, ale przeszedł do psychologii. Pod kierunkiem Starke’a Hathawaya opracował w rozprawie doktorskiej skalę K do inwentarza MMPI; doktorat z psychologii klinicznej uzyskał w 1945 r., mając 25 lat (Waller i Lilienfeld, 2005).
W Minnesocie był profesorem psychologii, wykładał też w szkołach prawa i medycyny i należał do założycieli Minnesota Center for Philosophy of Science. W latach 1962–1963 przewodniczył Amerykańskiemu Towarzystwu Psychologicznemu (APA), w 1987 r. wszedł do National Academy of Sciences. Zmarł 14 lutego 2003 r. (Waller i Lilienfeld, 2005).
Najważniejsze pomysły
- Predykcja kliniczna a statystyczna. W książce „Clinical versus statistical prediction” (1954) Meehl zestawił przewidywania klinicystów z przewidywaniami z prostych reguł statystycznych, czyli aktuarialnych. Po trzydziestu latach uznał, że z książki trzeba by wycofać najwyżej 5% treści, a przewaga predykcji aktuarialnej jest mocno potwierdzona (Meehl, 1986). Dziś to pytanie o trafność prognostyczną.
- Trafność teoretyczna. Z Lee Cronbachem opisał w 1955 r. cztery rodzaje trafności testu: prognostyczną, diagnostyczną (równoczesną), treściową i teoretyczną (Cronbach i Meehl, 1955). Ta ostatnia jest potrzebna wtedy, gdy nie ma jednego kryterium, z którym można porównać wynik testu – trafność wykazuje się wtedy siecią przewidywań teorii, nazwaną przez autorów siecią nomologiczną.
- Ryzykowne testy zamiast gwiazdek. W 1978 r. dowodził, że teorie „miękkiej” psychologii nie są obalane ani potwierdzane, tylko zanikają, m.in. przez poleganie na testach istotności. Proponował zmodyfikowane podejście Poppera: teorie powinny przewidywać wartości liczbowe i narażać się na falsyfikację (Meehl, 1978).
- Czynnik „crud”. W 1990 r. nazwał tak prosty fakt: w naukach społecznych wszystko w jakimś stopniu koreluje ze wszystkim, więc przy dużej próbie prawie każda hipoteza zerowa o braku związku zostanie odrzucona (Meehl, 1990).
Ciekawostka
Meehl prowadził statystykę własnej lektury. Według list w arkuszach kalkulacyjnych, które prowadziła jego żona Leslie Yonce, w latach 1973–2003 przeczytał co najmniej 1227 powieści i innych książek beletrystycznych oraz 4078 książek niebeletrystycznych, czyli mniej więcej jedną książkę co dwa dni. Stosował regułę 25 stron: książkę, która do tego miejsca go nie wciągnęła, odkładał (Waller i Lilienfeld, 2005).
Dobrej beletrystyki szukał metodą losową: szedł do działu literatury w bibliotece, brał książkę z półki na chybił trafił i zaczynał czytać, a do domu zabierał ją tylko wtedy, gdy zaciekawiła go pierwsza strona. Biografowie, by sprawdzić, z jakich dziedzin czytał, też losowali – po 300 tytułów z każdej listy (Waller i Lilienfeld, 2005).
Przykład: czynnik „crud” na danych o osobowości
Meehl (1990) streścił niepublikowane badanie, które przeprowadził z Davidem Lykkenem. W 1966 r. ankietę o rodzinie, szkole i czasie wolnym wypełniło 57 000 maturzystów z Minnesoty. Wszystkie 105 tabel krzyżowych dla 15 zmiennych dało wynik istotny statystycznie, a przy 45 zmiennych i 990 tabelach istotnych było 92%. Meehl podkreślał, że to nie błędy I rodzaju, lecz prawdziwe powiązania.
Podobny rachunek zrobiliśmy w R na zbiorze bfi z pakietu psych (2800 osób, pozycje Wielkiej Piątki z projektu SAPA, płeć, wykształcenie i wiek). Wzięliśmy 20 pozycji ugodowości, sumienności, ekstrawersji i otwartości oraz trzy zmienne demograficzne i liczyliśmy tylko pary zmiennych z różnych grup, np. pozycję sumienności z wiekiem. Par jest 210, kompletne dane ma 2308 osób.
Wynik: 166 z 210 korelacji Pearsona (79.0%) jest istotnych na poziomie .05, a 64.3% nawet na poziomie .001. Mediana |r| wynosi tylko .093, ale przy tej liczebności istotne jest już |r| ≥ .041. W losowych podpróbach (po 500 dla każdej liczebności, ziarno 1954) istotnych było 12.3% par przy n = 25, 18.0% przy n = 50 i 49.9% przy n = 400.
Na koniec eksperyment myślowy Meehla o „garnku z teoriami”. Teoria bez żadnego związku z danymi przewiduje dla każdej pary losowo wybrany kierunek korelacji. „Potwierdzeniem” nazywamy wynik istotny o przewidzianym znaku. W pełnej próbie losowa teoria zostaje „potwierdzona” w 41.4% par, przy n = 50 – w 9.3%. Gdyby wszystkie hipotezy zerowe były prawdziwe, oczekiwalibyśmy 2.5%. Sama istotność nie mówi więc, czy teoria jest dobra.
Na rysunku
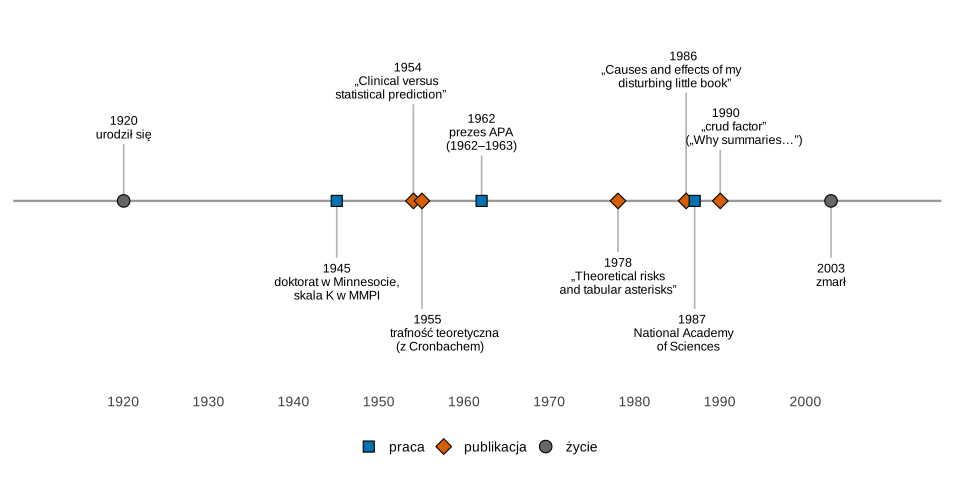
Co widać. Najważniejsze prace metodologiczne Meehla dzieli ponad trzydzieści lat: od książki o predykcji (1954) po artykuł o czynniku „crud” (1990).
Na co uważać. Oś pokazuje tylko wybrane daty z cytowanych źródeł; pomija np. prace o schizofrenii.
Podpis do pracy:
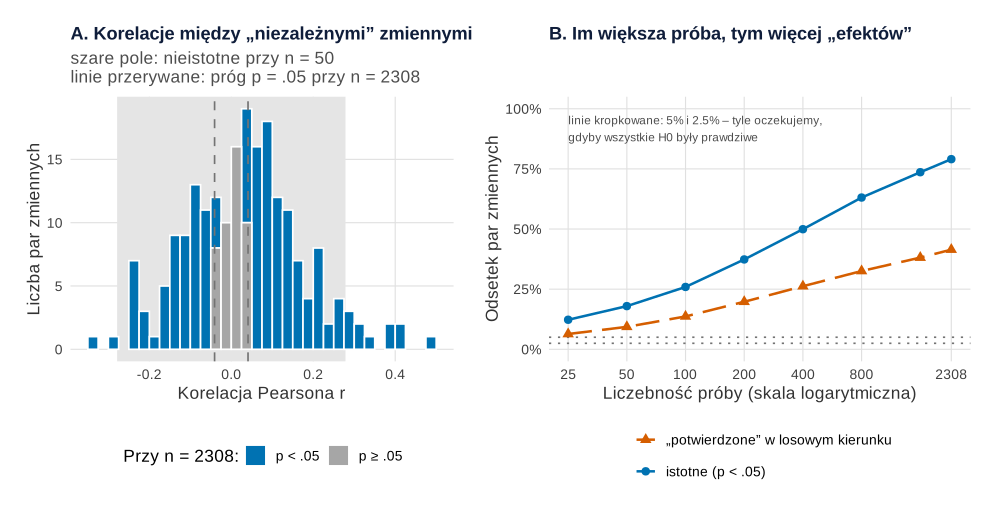
psych::bfi: rozkład korelacji między zmiennymi z różnych grup (A) i odsetek wyników istotnych oraz „potwierdzeń” teorii z losowym kierunkiem przewidywania w zależności od liczebności próby (B). Obliczenia i rysunek: R, pakiety psych, ggplot2 i patchwork (panel B: losowe podpróby, set.seed(1954)).Co widać. Na panelu A większość korelacji jest mała, ale prawie wszystkie wychodzą poza wąski pas nieistotności wyznaczony przy n = 2308. Panel B pokazuje, że odsetek „efektów” zależy przede wszystkim od liczebności próby.
Na co uważać. Cechy Wielkiej Piątki są względnie odrębne, a nie zupełnie niezwiązane, a odpowiedzi łączy też styl odpowiadania; próba SAPA nie jest losowa. Podpróby pochodzą z jednego zbioru, więc przy dużych n się pokrywają. Liczby Meehla i Lykkena dotyczą tabel krzyżowych, nasze – korelacji.
Podpis do pracy:
Gdzie spotkasz Meehla w swojej pracy
- W rozdziale o narzędziu badawczym, gdy uzasadniasz trafność skali – pojęcia trafności teoretycznej i sieci nomologicznej pochodzą z pracy Cronbacha i Meehla; rodzaje dowodów porządkuje wpis Rodzaje trafności – mapa dowodów.
- Gdy masz dużą próbę i „wszystko wychodzi istotne” – to właśnie czynnik „crud”. Podawaj wielkość efektu i przedział ufności, a nie same gwiazdki; jak czytać wartość p, wyjaśnia wpis Wartość p – interpretacja.
- Gdy planujesz liczebność próby – moc testu rośnie z n, ale przy dużej mocy hipoteza „jest jakiś związek” niewiele ryzykuje. Lepiej zapisać z góry, jak duży efekt przewidujesz, np. w prerejestracji, i nie szukać istotności po fakcie (p-hacking).
Spory, mity i trudne strony
- Czy Meehl był przeciwnikiem statystyki? Nie. Krytykował sposób, w jaki psychologia używa testów istotności do sprawdzania słabych teorii (Meehl, 1978, 1990), a jednocześnie ubolewał nad słabym wykształceniem matematycznym psychologów; sam przez lata po doktoracie chodził na kursy matematyki (Waller i Lilienfeld, 2005).
- Opór praktyków. Meehl (1986) wymienił siedem przyczyn, dla których praktycy nie stosują dobrze udokumentowanej przewagi predykcji aktuarialnej.
- Nietypowe tematy. Pisał też o parapsychologii (m.in. w „Science”) i statystycznie analizował dowody na rzecz teorii ewolucji, uznając je za niewystarczająco kompletne; biografowie zaznaczają, że nie wynikało to z kreacjonizmu, który odrzucał (Waller i Lilienfeld, 2005).
- Testy istotności dziś. Krytyka Meehla wraca w sporach o NHST; o złudzeniach co do małych prób – hasło o Kahnemanie i Tverskym.
Czynnik „crud” w R
Pierwszy przepis wczytuje zbiór bfi z pakietu psych, liczy korelacje dla wszystkich par zmiennych z różnych grup i ich istotność, a potem – w 500 losowych podpróbach dla każdej liczebności (set.seed(1954); liczbę podprób, liczebności i ziarno ustaliliśmy z góry) – odsetek wyników istotnych i „potwierdzeń” teorii z losowo przypisanym kierunkiem. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne.
1. Czynnik „crud” na danych o osobowości: rysunek 2
Kod R rysunku 2
# Paul E. Meehl: „crud factor” – czy w dużej próbie „wszystko koreluje ze wszystkim”? (psych::bfi)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(wszystkie = "#0072B2", kierunek = "#D55E00", h0 = "grey45")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
# 20 pozycji Wielkiej Piątki (ugodowość A, sumienność C, ekstrawersja E, otwartość O; bez neurotyczności N)
# oraz płeć, wykształcenie i wiek; analizujemy tylko pary zmiennych z RÓŻNYCH grup
data(bfi, package = "psych")
zmienne <- c(paste0("A", 1:5), paste0("C", 1:5), paste0("E", 1:5), paste0("O", 1:5), "gender", "education", "age")
grupa <- c(rep(c("A", "C", "E", "O"), each = 5), rep("demografia", 3))
d <- na.omit(bfi[, zmienne])
n <- nrow(d)
pary <- which(upper.tri(diag(length(zmienne))), arr.ind = TRUE)
pary <- pary[grupa[pary[, 1]] != grupa[pary[, 2]], ]          # tylko pary z różnych grup
r_par <- function(dane) cor(dane)[pary]
p_r <- function(r, n) 2 * pt(-abs(r * sqrt((n - 2) / (1 - r^2))), df = n - 2)   # test istotności r (H0: rho = 0)
r_pelne <- r_par(d)
p_pelne <- p_r(r_pelne, n)
c(n = n, liczba_par = length(r_pelne), istotne_05 = sum(p_pelne < .05), odsetek_05 = round(mean(p_pelne < .05), 3),
  odsetek_001 = round(mean(p_pelne < .001), 3), mediana_abs_r = round(median(abs(r_pelne)), 3),
  r_krytyczne = round(qt(.975, n - 2) / sqrt(n - 2 + qt(.975, n - 2)^2), 3))

# „Garnek z teoriami” (Meehl, 1990): teoria bez związku z danymi przewiduje dla każdej pary losowy kierunek korelacji;
# „potwierdzenie” = r istotne (p < .05) i o przewidzianym znaku. Ile potwierdzeń przy różnej liczebności próby?
set.seed(1954)
kierunek <- sample(c(-1, 1), length(r_pelne), replace = TRUE)   # losowo przypisany kierunek „hipotezy”
liczebnosci <- c(25, 50, 100, 200, 400, 800, 1600, n)
B <- 500                                                         # losowych podprób dla każdej liczebności
wyniki <- do.call(rbind, lapply(liczebnosci, function(m) {
  s <- replicate(B, {
    r_m <- if (m == n) r_pelne else r_par(d[sample(n, m), ])
    istotne <- p_r(r_m, m) < .05
    c(istotne = mean(istotne), potwierdzone = mean(istotne & sign(r_m) == kierunek))
  })
  data.frame(n = m, istotne = mean(s["istotne", ]), potwierdzone = mean(s["potwierdzone", ]))
}))
print(transform(wyniki, istotne = round(istotne, 3), potwierdzone = round(potwierdzone, 3)), row.names = FALSE)

# Rysunek 2A: rozkład korelacji między zmiennymi z różnych grup i progi istotności
gr_df <- data.frame(r = r_pelne, istotna = ifelse(p_pelne < .05, "p < .05", "p ≥ .05"))
r_kryt <- function(m) qt(.975, m - 2) / sqrt(m - 2 + qt(.975, m - 2)^2)
pA <- ggplot(gr_df, aes(r, fill = istotna)) +
  annotate("rect", xmin = -r_kryt(50), xmax = r_kryt(50), ymin = -Inf, ymax = Inf, fill = "grey90") +
  geom_histogram(binwidth = 0.025, boundary = 0, colour = "white") +
  geom_vline(xintercept = c(-1, 1) * r_kryt(n), linetype = "dashed", colour = kol[["h0"]]) +
  scale_fill_manual(values = c("p < .05" = kol[["wszystkie"]], "p ≥ .05" = "grey65"), name = sprintf("Przy n = %d:", n)) +
  labs(title = "A. Korelacje między „niezależnymi” zmiennymi",
       subtitle = sprintf("szare pole: nieistotne przy n = 50\nlinie przerywane: próg p = .05 przy n = %d", n),
       x = "Korelacja Pearsona r", y = "Liczba par zmiennych") +
  motyw
# Rysunek 2B: odsetek istotnych korelacji i „potwierdzeń” losowej teorii w funkcji n
dl <- rbind(data.frame(n = wyniki$n, odsetek = wyniki$istotne, co = "istotne (p < .05)"),
            data.frame(n = wyniki$n, odsetek = wyniki$potwierdzone, co = "„potwierdzone” w losowym kierunku"))
pB <- ggplot(dl, aes(n, odsetek, colour = co, shape = co, linetype = co)) +
  geom_hline(yintercept = c(.05, .025), colour = kol[["h0"]], linetype = "dotted") +
  annotate("text", x = 25, y = 0.97, hjust = 0, vjust = 1, size = 3.1, colour = "grey30",
           label = "linie kropkowane: 5% i 2.5% – tyle oczekujemy,\ngdyby wszystkie H0 były prawdziwe") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_x_log10(breaks = c(25, 50, 100, 200, 400, 800, n)) +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%"), limits = c(0, 1)) +
  scale_colour_manual(values = c("istotne (p < .05)" = kol[["wszystkie"]], "„potwierdzone” w losowym kierunku" = kol[["kierunek"]]), name = NULL) +
  scale_shape_manual(values = c("istotne (p < .05)" = 16, "„potwierdzone” w losowym kierunku" = 17), name = NULL) +
  scale_linetype_manual(values = c("istotne (p < .05)" = "solid", "„potwierdzone” w losowym kierunku" = "longdash"), name = NULL) +
  labs(title = "B. Im większa próba, tym więcej „efektów”", x = "Liczebność próby (skala logarytmiczna)",
       y = "Odsetek par zmiennych") +
  motyw + guides(colour = guide_legend(nrow = 2))
p2 <- pA + pB + plot_layout(widths = c(1, 1.1))
p2
Wynik w R
            n    liczba_par    istotne_05    odsetek_05   odsetek_001
     2308.000       210.000       166.000         0.790         0.643
mediana_abs_r   r_krytyczne
        0.093         0.041
    n istotne potwierdzone
   25   0.123        0.064
   50   0.180        0.093
  100   0.259        0.137
  200   0.374        0.198
  400   0.499        0.262
  800   0.631        0.325
 1600   0.736        0.381
 2308   0.790        0.414
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Paul E. Meehl, 1920–2003 – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1920, 1945, 1954, 1955, 1962, 1978, 1986, 1987, 1990, 2003),
  opis = c("urodził się", "doktorat w Minnesocie,\nskala K w MMPI", "„Clinical versus\nstatistical prediction”",
           "trafność teoretyczna\n(z Cronbachem)", "prezes APA\n(1962–1963)", "„Theoretical risks\nand tabular asterisks”",
           "„Causes and effects of my\ndisturbing little book”", "National Academy\nof Sciences", "„crud factor”\n(„Why summaries…”)",
           "zmarł"),
  rodzaj = c("życie", "praca", "publikacja", "publikacja", "praca", "publikacja", "publikacja", "praca", "publikacja", "życie"))
zdarzenia$wysokosc <- c(0.5, -0.5, 0.85, -0.95, 0.4, -0.45, 0.95, -0.95, 0.45, -0.5)   # nad (+) i pod (−) osią
zdarzenia$wyrownanie <- c(0.5, 0.5, 0.7, 0.3, 0.5, 0.5, 0.6, 0.6, 0.3, 0.5)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = wysokosc), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = wysokosc + 0.05 * sign(wysokosc), label = paste0(rok, "\n", opis), vjust = ifelse(wysokosc > 0, 0, 1),
                hjust = wyrownanie),
            size = 3.3, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1912, 2011), breaks = seq(1920, 2000, by = 10)) +
  scale_y_continuous(limits = c(-1.5, 1.5)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dane – pakiet psych; korelacje i testy – funkcje bazowe cor() i pt(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Paul E. Meehl?
Amerykańskim psychologiem klinicznym (1920–2003) z Uniwersytetu Minnesoty. Opracował skalę K do inwentarza MMPI, napisał książkę o predykcji klinicznej i statystycznej (1954), z Lee Cronbachem opisał trafność teoretyczną (1955), a w latach 1962–1963 był prezesem Amerykańskiego Towarzystwa Psychologicznego.
Co to jest crud factor według Meehla?
To jego nazwa na fakt, że w naukach społecznych wszystko w pewnym stopniu koreluje ze wszystkim. Przy dużej próbie prawie każda korelacja wychodzi więc istotna, a hipoteza „jest związek” prawie zawsze się „potwierdza”. W badaniu 57 000 maturzystów, które Meehl opisał w 1990 r., istotne były wszystkie 105 tabel krzyżowych dla 15 zmiennych.
Czego dowodził Meehl w książce o predykcji klinicznej i statystycznej?
Że prognozy oparte na prostych regułach statystycznych (aktuarialnych) są zwykle co najmniej tak trafne jak oceny klinicystów. Po 30 latach Meehl uznał, że z książki z 1954 r. trzeba by wycofać najwyżej 5% treści, a przewaga predykcji aktuarialnej jest mocno potwierdzona.
Dlaczego Meehl krytykował testy istotności w psychologii?
Bo odrzucenie hipotezy zerowej o braku związku słabo sprawdza teorię: przy dużej próbie zdarza się prawie zawsze. Meehl chciał, by teorie przewidywały konkretne wartości liczbowe i ryzykowały obalenie, jak postulował Karl Popper; sam statystykę cenił i zachęcał psychologów do nauki matematyki.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wartość p – interpretacja
Błędne odczytania p na jednym przykładzie, symulacja p pod H0 i H1, replikacje, p a przedział ufności i wielkość efektu – z kodem R.
Czytaj →PoradnikRodzaje trafności – mapa dowodów
Tradycyjne nazwy trafności na mapie pięciu źródeł dowodów (Standards, 2014): jak zebrać dowód, jaka analiza, jak opisać w pracy i które 2–3 rodzaje dowodów zaplanować.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cronbach, L. J., & Meehl, P. E. (1955). Construct validity in psychological tests. Psychological Bulletin, 52(4), 281–302. https://doi.org/10.1037/h0040957 ● Otwarty dostęp: pełny tekst
- Faust, D., & Waller, N. (2004). Paul E. Meehl (1920–2003). American Psychologist, 59(6), 557–558. https://doi.org/10.1037/0003-066x.59.6.557 ● Otwarty dostęp: pełny tekst
- Meehl, P. E. (1978). Theoretical risks and tabular asterisks: Sir Karl, Sir Ronald, and the slow progress of soft psychology. Journal of Consulting and Clinical Psychology, 46(4), 806–834. https://doi.org/10.1037/0022-006X.46.4.806
- Meehl, P. E. (1986). Causes and effects of my disturbing little book. Journal of Personality Assessment, 50(3), 370–375. https://doi.org/10.1207/s15327752jpa5003_6
- Meehl, P. E. (1990). Why summaries of research on psychological theories are often uninterpretable. Psychological Reports, 66(1), 195–244. https://doi.org/10.2466/pr0.1990.66.1.195
- Waller, N. G., & Lilienfeld, S. O. (2005). Paul Everett Meehl: The cumulative record. Journal of Clinical Psychology, 61(10), 1209–1229. https://doi.org/10.1002/jclp.20177
Cytowania BibTeX
@article{cronbach1955construct, author={Cronbach, Lee J. and Meehl, Paul E.}, title={{Construct validity in psychological tests}}, journal={Psychological Bulletin}, year={1955}, volume={52}, number={4}, pages={281--302}, doi={10.1037/h0040957}}@article{faust2004paul, author={Faust, David and Waller, Niels}, title={{Paul E. Meehl (1920–2003)}}, journal={American Psychologist}, year={2004}, volume={59}, number={6}, pages={557--558}, doi={10.1037/0003-066x.59.6.557}}@article{meehl1978theoretical, author={Meehl, Paul E.}, title={{Theoretical risks and tabular asterisks: Sir Karl, Sir Ronald, and the slow progress of soft psychology}}, journal={Journal of Consulting and Clinical Psychology}, year={1978}, volume={46}, number={4}, pages={806--834}, doi={10.1037/0022-006x.46.4.806}}@article{meehl1986causes, author={Meehl, Paul E.}, title={{Causes and effects of my disturbing little book}}, journal={Journal of Personality Assessment}, year={1986}, volume={50}, number={3}, pages={370--375}, doi={10.1207/s15327752jpa5003_6}}@article{meehl1990why, author={Meehl, Paul E.}, title={{Why summaries of research on psychological theories are often uninterpretable}}, journal={Psychological Reports}, year={1990}, volume={66}, number={1}, pages={195--244}, doi={10.2466/pr0.1990.66.1.195}}@article{waller2005paul, author={Waller, Niels G. and Lilienfeld, Scott O.}, title={{Paul Everett Meehl: The cumulative record}}, journal={Journal of Clinical Psychology}, year={2005}, volume={61}, number={10}, pages={1209--1229}, doi={10.1002/jclp.20177}}