Trzy liczby do ustalenia i jedna, której nie kontrolujesz
Planując badanie metodą próbkowania doświadczeń (ESM, inaczej EMA), ustalasz trzy liczby: ile osób zrekrutować, przez ile dni prowadzić pomiary i ile sygnałów wysyłać dziennie. Czwartą liczbę ustalą sami uczestnicy. To kompliancja (ang. compliance), czyli odsetek sygnałów, na które naprawdę odpowiedzą. W metaanalizie 477 artykułów średnia kompliancja wyniosła 79% (Wrzus i Neubauer, 2023), więc z 70 zaplanowanych pomiarów zostaje średnio około 55.
Recenzent pyta zwykle o jedno: skąd wiadomo, że taki plan wystarczy? Odpowiedź zależy od pytania badawczego. Ten wpis pokazuje, jak policzyć moc dla dwóch typowych hipotez ESM: efektu wewnątrzosobowego i interakcji międzypoziomowej. Analizę zebranych danych opisuje wpis badania dzienniczkowe i EMA – analiza danych, a ogólną pętlę symulacyjną dla modelu mieszanego – wpis analiza mocy dla modelu mieszanego. Tu dokładamy to, co swoiste dla ESM: dni i sygnały, spadek kompliancji, reguły wykluczania i obciążenie uczestnika.
Co zmienia każda decyzja
Każda z trzech liczb działa na inny składnik precyzji i każda kosztuje coś innego. Bolger i Laurenceau (2013) poświęcają mocy w badaniach intensywnie podłużnych osobny rozdział, a Myin-Germeys i in. (2018) traktują wybór schematu, budowę kwestionariusza i metody analizy jako część jednego planu. Najkrócej:
| Decyzja | Co poprawia | Koszt i ryzyko |
|---|---|---|
| Liczba osób | wszystkie efekty stałe, zwłaszcza efekty poziomu 2 i interakcje międzypoziomowe | rekrutacja, wynagrodzenia, czas zbierania danych |
| Liczba dni | precyzję nachylenia u każdej osoby, zakres sytuacji (dni robocze i weekend) | kompliancja spada z każdym dniem |
| Sygnały dziennie | liczbę odpowiedzi bez wydłużania badania, krótsze odstępy dla efektów opóźnionych | przerywanie codziennych czynności, reaktywność pomiaru |
| Długość ankiety | liczbę konstruktów i rzetelność skal | obciążenie, braki i nieuważne odpowiedzi |
Ostatni wiersz bywa ważniejszy od pozostałych. W eksperymencie Eisele i in. (2022) 163 studentów dostawało ankietę z 30 albo 60 pozycji 3, 6 lub 9 razy dziennie przez 14 dni. Dłuższa ankieta zwiększała odczuwane obciążenie i pogarszała ilość oraz jakość danych, łącznie z nieuważnymi odpowiedziami. Częstsze sygnały takich skutków nie miały. Podobnie w metaanalizie Wrzus i Neubauer (2023) liczba pomiarów nie przewidywała kompliancji, a wyższa była tam, gdzie płacono uczestnikom. Trull i Ebner-Priemer (2013) zaliczają akceptowalność procedury i kompliancję, obok prywatności i etyki, do głównych kwestii oceny ambulatoryjnej. Dlatego przed analizą mocy skróć ankietę, a liczbę sygnałów ustal według tego, jak szybko zmienia się badany stan.
Model populacyjny: zapisz go przed liczeniem
Przykład dotyczy reaktywności na stres. Pytamy, czy w chwilach silniejszego stresu niż zwykle u danej osoby rośnie negatywny afekt (NA). Druga hipoteza mówi, że ta reaktywność jest silniejsza u osób z wysokim neurotyzmem. Model analizy ma postać na ~ stres_cw * neur + stres_os_c + (1 + stres_cw | id). Stres jest wycentrowany w osobie, a jego średnia osoby wchodzi jako osobny predyktor, jak we wpisie efekty wewnątrz- i międzyosobowe. Losowe nachylenie stresu pozwala osobom różnić się reaktywnością.
Wszystkie wielkości wyrażamy w jednostkach wahań wewnątrzosobowych: SD reszty i SD odchyleń stresu wynoszą 1. Takie standaryzowane określenie modelu proponują Arend i Schäfer (2019) na wypadek, gdy nie ma surowych danych. Przyjęliśmy:
- efekt wewnątrzosobowy 0.10 jako najmniejszy interesujący efekt;
- interakcję z neurotyzmem 0.04 na 1 SD cechy;
- SD reaktywności niewyjaśnionej neurotyzmem 0.10;
- SD średnich poziomów NA 0.8, co daje ICC afektu około .39.
Kompliancję modelujemy jako spadającą z dnia na dzień, z trwałymi różnicami między osobami (losowy składnik na skali logitowej). Liczba sygnałów dziennie nie zmienia dziennego spadku, zgodnie z wynikami Eisele i in. (2022). W tym modelu braki są niezależne od afektu. Braki zależne od samego afektu, czyli typu MNAR (zob. MCAR, MAR i MNAR), obciążają oszacowania. Ich skutki opisuje wpis model autoregresyjny i braki danych w ESM.
Jeden zbiór z tego modelu (80 osób, 14 dni po 5 sygnałów) dobrze pokazuje problem. Kompliancja wyniosła 78.9%, u osób od 48.6% do 100%, średnio 55.2 odpowiedzi na osobę. Pierwszego dnia odebrano 86.8% sygnałów, siódmego 80.7%, a czternastego 71.5%. Efekt wewnątrzosobowy był wyraźny: b = 0.092, SE = 0.019, t(77.4) = 4.78, p < .001. Interakcja z neurotyzmem, choć istnieje w populacji, dała b = 0.025, SE = 0.018, t(72.1) = 1.40, p = .167. Pojedynczy wynik niczego nie przesądza, ale już tu widać, że błąd standardowy interakcji jest prawie tak duży jak efekt. Ile badań skończy się podobnie, mówi dopiero symulacja.
Mapa mocy: osoby × dni
Pętla jest taka sama jak we wpisie o analizie mocy dla modelu mieszanego: generujemy dane, dopasowujemy zaplanowany model i liczymy odsetek wyników p < .05. Wartości p pochodzą z testu t ze stopniami swobody Satterthwaite’a. Siatka objęła 40–160 osób i 7–28 dni po 5 sygnałów, po 300 badań na komórkę. Błąd Monte Carlo mocy wynosi tu najwyżej .029.
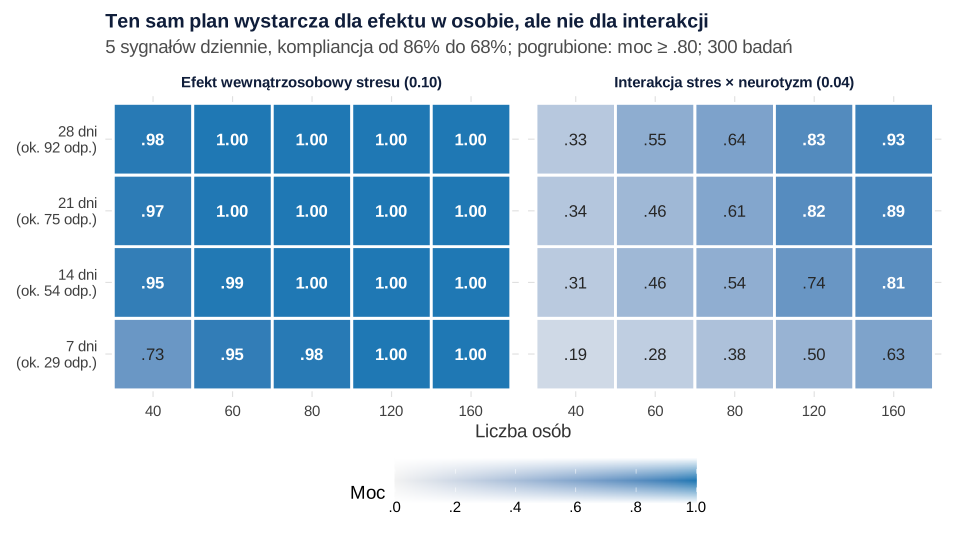
Dwa panele wyglądają jak dwa różne badania. Efekt wewnątrzosobowy ma moc .953 już przy 60 osobach i 7 dniach oraz .950 przy 40 osobach i 14 dniach. Najmniejszy plan, 40 osób przez 7 dni, dał .733, a 21.0% dopasowań było osobliwych (zob. model mieszany się nie zbiega). Interakcja przekracza .80 dopiero przy 160 osobach i 14 dniach (.807), 120 osobach i 21 dniach (.823) albo 120 osobach i 28 dniach (.833). Przy 40 osobach jej moc nie przekracza .343 bez względu na liczbę dni. Arend i Schäfer (2019) doszli do podobnego wniosku: przy typowych liczebnościach małych interakcji międzypoziomowych nie da się wykryć z mocą .80.
Skąd ta różnica? Nachylenie jednej osoby ma w przybliżeniu wariancję σ²/(nodp·SD²stresu) + τ². Pierwszy składnik to szum pomiaru, który maleje z liczbą odpowiedzi. Drugi, τ², to prawdziwe różnice reaktywności, których nie usunie żadna liczba dni. Przy 7 dniach (28.8 odpowiedzi) składnik pomiaru wynosi 0.0348, a składnik osób 0.0100, czyli 22.3% sumy. Przy 28 dniach (92.0 odpowiedzi) jest to już 0.0109 wobec 0.0100, a udział osób rośnie do 47.9%. Test interakcji porównuje nachylenia między osobami, więc gdy dominuje τ², pomaga już tylko rekrutacja kolejnych osób. To ten sam mechanizm, który we wpisie o mocy testu dla interakcji działa w zwykłej regresji, z tą różnicą, że tu efektywną liczebnością są osoby, a nie odpowiedzi.
Kompliancja: gorsza od niej bywa reguła wykluczania
Dla planu 80 osób × 70 sygnałów porównaliśmy sześć scenariuszy, po 500 badań na każdy. Przy umiarkowanym spadku kompliancja wynosi średnio 85.5% pierwszego dnia, 78.5% siódmego i 67.7% czternastego. Przy silnym spadku jest to 83.0%, 69.8% i 49.9%.
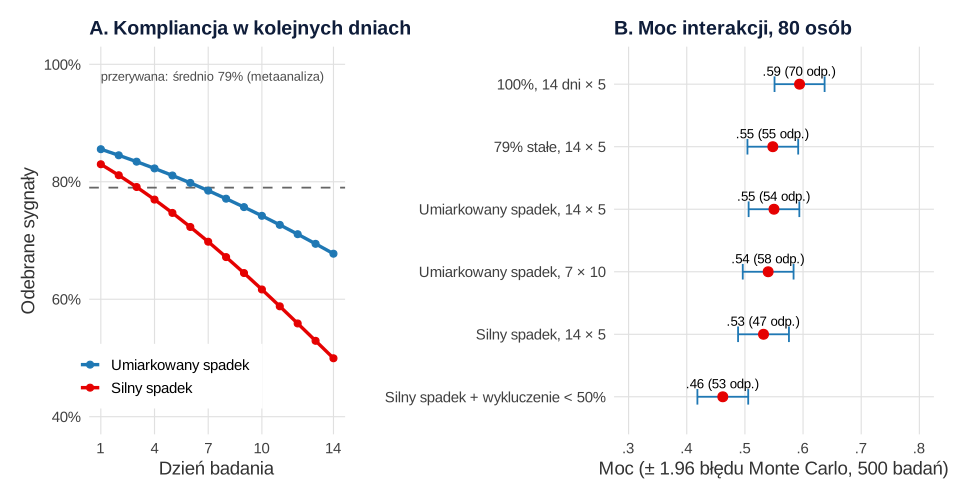
Wyniki są mniej oczywiste, niż mogłoby się wydawać. Przy pełnej kompliancji moc interakcji wyniosła .594. Przy stałych 79% spadła do .548, przy umiarkowanym spadku do .550, a przy silnym spadku (47.3 odpowiedzi na osobę) do .532. Błąd Monte Carlo każdej z tych wartości to .022, więc trzy scenariusze z brakami różnią się w granicach szumu. Utrata jednej czwartej sygnałów kosztuje mniej więcej .05 mocy, bo osoby z mniejszą liczbą odpowiedzi nadal wnoszą informację o swoich nachyleniach.
Dużo więcej kosztuje reguła „wyklucz osoby z kompliancją poniżej 50%”. Przy silnym spadku odpadało średnio 16 z 80 osób (w analizie zostawało 63.9), a moc spadła do .462. Model mieszany korzysta z każdej odpowiedzi, więc przed wpisaniem takiej reguły do planu sprawdź w symulacji, ile ona kosztuje. Jeśli ją zachowujesz, rekrutuj z zapasem: przy oczekiwanej utracie 20% osób planowane N podziel przez 0.8. Odejmowanie osób, które nie wróciły, to zwykła utrata uczestników, i o niej też trzeba pamiętać w planie.
Plan 7 dni × 10 sygnałów dał 57.5 odpowiedzi na osobę wobec 54.2 przy 14 dniach × 5. Krótsze badanie mniej traci na dziennym spadku kompliancji, ale moc interakcji była praktycznie taka sama (.540 wobec .550). O wyborze między tymi planami decydują więc inne względy: czy chcesz objąć dwa weekendy, jak szybko zmienia się badany stan i czy 10 przerw dziennie jest do przyjęcia w Twojej grupie.
Ten sam budżet: więcej osób czy więcej dni?
Załóżmy, że możesz opłacić 5600 zaplanowanych sygnałów. Porównaliśmy trzy podziały, po 1000 badań na każdy. Efekt wewnątrzosobowy miał moc co najmniej .994 we wszystkich trzech planach. Dla interakcji wybór miał znaczenie: 40 osób × 28 dni dało .361, 95% CI [.331, .391], 80 osób × 14 dni – .533 [.502, .564], a 160 osób × 7 dni – .621 [.591, .651].
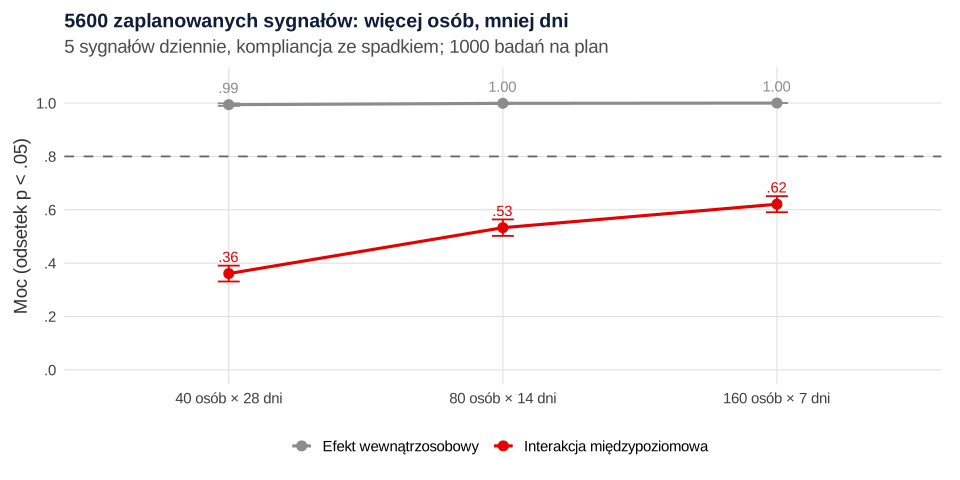
Nie wynika z tego, że 7 dni zawsze wystarczy. W naszym modelu nie ma zmienności między dniami ani autokorelacji reszt, a uczestnicy nie zmieniają się w trakcie badania. W prawdziwych danych tydzień obejmuje jeden weekend, a krótkie badanie słabo uchwyci rzadkie zdarzenia. Lafit i in. (2021) uwzględniają zależność czasową w modelach do analizy mocy przez autokorelację reszt albo efekty autoregresyjne i udostępniają do tego aplikację. Ich narzędzie zakłada stały protokół pomiarów i szuka liczby osób. Jeśli Twoja hipoteza dotyczy dynamiki, np. inercji emocjonalnej, liczba kolejnych sygnałów w dniu ma znaczenie, którego ta symulacja nie pokazuje.
Procedura w pięciu krokach
- Zapisz hipotezę i model analizy. Osobno dla efektu wewnątrzosobowego i dla interakcji, bo wymagają innych prób. Model wpisz do planu analizy.
- Ustal parametry. Wariancje i ICC weź z danych z podobnych badań albo z pilotażu wykonalności. Efekty ustal jako najmniejsze interesujące, nie jako oszacowania z pilotażu.
- Zamodeluj kompliancję. Spadek w czasie, różnice osób i regułę wykluczania, którą naprawdę zastosujesz.
- Policz siatkę i zawęź. Szybki przegląd z 200–300 badaniami na komórkę, a potem 1000 dla dwóch–trzech kandydatów. Zasady opisu takiej symulacji podaje wpis jak zaplanować badanie symulacyjne.
- Dodaj analizę wrażliwości. Sprawdź mniejszą kompliancję, większe SD reaktywności i mniejszy efekt.
Jak opisać analizę mocy
Przykład w R
Przepisy uruchamia się po kolei w jednej sesji, bo kroki 2–4 korzystają z funkcji z kroku 1 i 2. Odtwarzają wszystkie liczby z tekstu i zapisują wyniki do plików CSV, z których powstały rysunki. Potrzebne pakiety: lme4 i lmerTest; obliczenia równoległe korzystają z pakietu parallel z dystrybucji R (na Windows ustaw mc.cores = 1).
1. Model populacyjny i kompliancja
R
# Krok 1. Model populacyjny badania ESM i model kompliancji (dane symulowane)
# Pytanie: czy chwilowy stres podnosi negatywny afekt (NA) u tej samej osoby
# i czy ta reaktywność jest silniejsza u osób z wyższym neurotyzmem (interakcja międzypoziomowa)?
# Jednostki: NA i stres w SD wahań wewnątrzosobowych (σ reszty = 1, SD odchyleń stresu = 1),
# neurotyzm standaryzowany między osobami.
suppressPackageStartupMessages({library(lme4); library(lmerTest)})

par_esm <- list(b0 = 0, sd_u0 = 0.8,      # SD średnich poziomów NA między osobami (ICC NA ok. .39)
                b_w = 0.10,                 # efekt wewnątrzosobowy stresu (najmniejszy interesujący)
                b_int = 0.04,               # interakcja stres (w osobie) × neurotyzm
                sd_u1 = 0.10,               # SD reaktywności niewyjaśnionej neurotyzmem
                b_m = 0.30,                 # efekt między osobami: średni stres osoby
                sd_xm = 0.7,                # SD średnich poziomów stresu między osobami
                sigma = 1)

# Kompliancja: logit p(odpowiedź) = logit(.88) + spadek·(dzień − 1) + a_i, a_i ~ N(0, 0.8²);
# spadek dobrany tak, by bez różnic osób dzień 14 miał .70. Długość ankiety i liczba sygnałów
# dziennie nie wchodzą do modelu – dzienny spadek jest ten sam przy 3 i przy 10 sygnałach.
kompl_spadek <- list(start = .88, spadek = (qlogis(.70) - qlogis(.88)) / 13, sd_os = 0.8)

generuj_esm <- function(N, dni, sygn, par = par_esm, kompl = kompl_spadek, min_kompl = 0) {
  d <- expand.grid(sygnal = 1:sygn, dzien = 1:dni, id = 1:N)
  neur <- rnorm(N); u0 <- rnorm(N, 0, par$sd_u0); u1 <- rnorm(N, 0, par$sd_u1)
  xm <- rnorm(N, 0, par$sd_xm); a <- rnorm(N, 0, kompl$sd_os)
  i <- d$id
  d$neur <- neur[i]
  d$stres <- xm[i] + rnorm(nrow(d))
  d$odp <- runif(nrow(d)) < plogis(qlogis(kompl$start) + kompl$spadek * (d$dzien - 1) + a[i])
  d$na <- par$b0 + u0[i] + par$b_m * xm[i] +
          (par$b_w + par$b_int * d$neur + u1[i]) * (d$stres - xm[i]) + rnorm(nrow(d), 0, par$sigma)
  d <- d[d$odp, ]                                        # w analizie tylko odebrane sygnały
  k_os <- tapply(d$odp, factor(d$id, levels = 1:N), length) / (dni * sygn)
  k_os[is.na(k_os)] <- 0
  d <- d[d$id %in% which(k_os >= min_kompl), ]           # reguła wykluczania osób (domyślnie brak)
  d$stres_os <- ave(d$stres, d$id)                       # średnia osoby z odebranych sygnałów
  d$stres_cw <- d$stres - d$stres_os                     # centrowanie w osobie (CWC)
  d$stres_os_c <- d$stres_os - mean(tapply(d$stres, d$id, mean))
  d$id <- factor(d$id)
  attr(d, "kompl_os") <- k_os
  d
}

# Jeden przykładowy zbiór: 80 osób, 14 dni, 5 sygnałów dziennie (70 zaplanowanych pomiarów)
set.seed(3521)
d1 <- generuj_esm(N = 80, dni = 14, sygn = 5)
k <- attr(d1, "kompl_os")
round(c(kompl_srednia = mean(k), mediana = median(k), min = min(k), max = max(k),
        ponizej_50 = mean(k < .5), odp_na_osobe = nrow(d1) / 80), 3)
round(tapply(d1$sygnal, d1$dzien, length) / (80 * 5), 3)[c(1, 7, 14)]   # kompliancja w dniach 1, 7 i 14

m1 <- lmer(na ~ stres_cw * neur + stres_os_c + (1 + stres_cw | id), data = d1)
round(summary(m1)$coefficients, 3)
print(VarCorr(m1), comp = "Std.Dev.", digits = 3)
Wynik w R
kompl_srednia       mediana           min           max    ponizej_50  odp_na_osobe
        0.789         0.800         0.486         1.000         0.013        55.237
    1     7    14
0.868 0.807 0.715
              Estimate Std. Error     df t value Pr(>|t|)
(Intercept)      0.064      0.078 77.172   0.817    0.416
stres_cw         0.092      0.019 77.357   4.776    0.000
neur             0.005      0.075 76.977   0.068    0.946
stres_os_c       0.297      0.106 77.569   2.790    0.007
stres_cw:neur    0.025      0.018 72.147   1.396    0.167
 Groups   Name        Std.Dev. Corr
 id       (Intercept) 0.6757
          stres_cw    0.0989   0.38
 Residual             1.0055
2. Siatka mocy: osoby × dni
R
# Krok 2. Siatka mocy: liczba osób × liczba dni (5 sygnałów dziennie), kompliancja ze spadkiem
# (wymaga obiektów z kroku 1)
library(parallel)
ster <- lmerControl(calc.derivs = FALSE)   # szybciej: bez numerycznego sprawdzania gradientu

# Jedno badanie: dane z modelu populacyjnego, ZAPLANOWANY model, p dla obu efektów
jedno_badanie <- function(N, dni, sygn, ...) {
  d <- generuj_esm(N, dni, sygn, ...)
  m <- tryCatch(suppressMessages(suppressWarnings(
         lmer(na ~ stres_cw * neur + stres_os_c + (1 + stres_cw | id), data = d, control = ster))),
         error = function(e) NULL)
  if (is.null(m)) return(c(p_w = NA, p_int = NA, osobliwy = NA, n_odp = NA, n_os = NA))
  wsp <- summary(m)$coefficients
  c(p_w = wsp["stres_cw", "Pr(>|t|)"], p_int = wsp["stres_cw:neur", "Pr(>|t|)"],
    osobliwy = isSingular(m), n_odp = nrow(d), n_os = nlevels(d$id))
}

# Moc w komórce: R badań, własne ziarno komórki (wynik nie zależy od liczby rdzeni)
moc_komorki <- function(N, dni, sygn, R, ziarno, alfa = .05, ...) {
  set.seed(ziarno)
  dodatkowe <- list(...)                     # np. kompl = ..., min_kompl = ... (krok 3)
  w <- t(replicate(R, do.call(jedno_badanie, c(list(N, dni, sygn), dodatkowe))))
  w <- w[!is.na(w[, "p_w"]), , drop = FALSE]
  moc_w <- mean(w[, "p_w"] < alfa); moc_int <- mean(w[, "p_int"] < alfa)
  c(N = N, dni = dni, sygn = sygn, R = nrow(w),
    moc_w = moc_w, mcse_w = sqrt(moc_w * (1 - moc_w) / nrow(w)),
    moc_int = moc_int, mcse_int = sqrt(moc_int * (1 - moc_int) / nrow(w)),
    osoby = mean(w[, "n_os"]), odp_na_osobe = mean(w[, "n_odp"] / w[, "n_os"]), osobliwe = mean(w[, "osobliwy"]))
}

siatka <- expand.grid(N = c(40, 60, 80, 120, 160), dni = c(7, 14, 21, 28))
R_siatka <- 300
wyniki <- mclapply(seq_len(nrow(siatka)), function(i)      # na Windows ustaw mc.cores = 1
  moc_komorki(siatka$N[i], siatka$dni[i], sygn = 5, R = R_siatka, ziarno = 35220 + i),
  mc.cores = 4)
moc_siatka <- as.data.frame(do.call(rbind, wyniki))
moc_siatka$pomiary_plan <- moc_siatka$dni * moc_siatka$sygn
write.csv(moc_siatka, "moc-siatka-esm.csv", row.names = FALSE)
print(round(moc_siatka[, c("N", "dni", "pomiary_plan", "odp_na_osobe", "moc_w", "moc_int", "mcse_int", "osobliwe")], 3),
      row.names = FALSE)

# Dlaczego interakcja zależy głównie od liczby osób: wariancja nachylenia jednej osoby
# ≈ σ² / (liczba odpowiedzi × SD² stresu) + SD² reaktywności. Drugiego składnika nie zmniejszą kolejne dni.
odp <- tapply(moc_siatka$odp_na_osobe, moc_siatka$dni, mean)      # średnia liczba odpowiedzi na osobę
skladniki <- data.frame(dni = as.numeric(names(odp)), odp = as.numeric(odp),
                        skladnik_pomiaru = par_esm$sigma^2 / as.numeric(odp), skladnik_osob = par_esm$sd_u1^2)
skladniki$udzial_osob <- skladniki$skladnik_osob / (skladniki$skladnik_pomiaru + skladniki$skladnik_osob)
round(skladniki, 4)
Wynik w R
   N dni pomiary_plan odp_na_osobe moc_w moc_int mcse_int osobliwe
  40   7           35       28.764 0.733   0.193    0.023    0.210
  60   7           35       28.764 0.953   0.283    0.026    0.137
  80   7           35       28.752 0.980   0.383    0.028    0.100
 120   7           35       28.754 1.000   0.500    0.029    0.053
 160   7           35       28.759 1.000   0.633    0.028    0.013
  40  14           70       54.134 0.950   0.313    0.027    0.050
  60  14           70       54.242 0.993   0.460    0.029    0.027
  80  14           70       54.311 1.000   0.540    0.029    0.010
 120  14           70       54.147 1.000   0.737    0.025    0.000
 160  14           70       54.194 1.000   0.807    0.023    0.000
  40  21          105       75.419 0.967   0.343    0.027    0.023
  60  21          105       75.418 0.997   0.460    0.029    0.007
  80  21          105       75.540 1.000   0.607    0.028    0.003
 120  21          105       75.569 1.000   0.823    0.022    0.000
 160  21          105       75.423 1.000   0.890    0.018    0.000
  40  28          140       91.907 0.980   0.330    0.027    0.010
  60  28          140       91.884 1.000   0.550    0.029    0.003
  80  28          140       91.996 1.000   0.640    0.028    0.000
 120  28          140       92.097 1.000   0.833    0.022    0.000
 160  28          140       92.041 1.000   0.927    0.015    0.000
  dni     odp skladnik_pomiaru skladnik_osob udzial_osob
1   7 28.7588           0.0348          0.01      0.2234
2  14 54.2056           0.0184          0.01      0.3515
3  21 75.4737           0.0132          0.01      0.4301
4  28 91.9848           0.0109          0.01      0.4791
3. Scenariusze kompliancji przy 80 osobach
R
# Krok 3. Ta sama liczba zaplanowanych pomiarów (70), różna kompliancja (wymaga obiektów z kroków 1–2)
kompl_pelna  <- list(start = 1,   spadek = 0, sd_os = 0)                 # wszystkie sygnały odebrane
kompl_stala  <- list(start = .79, spadek = 0, sd_os = 0)                 # 79% bez spadku i bez różnic osób
kompl_silny  <- list(start = .88, spadek = (qlogis(.50) - qlogis(.88)) / 13, sd_os = 1.2)

scen <- list(
  list(nazwa = "100%, 14 × 5",                  dni = 14, sygn = 5,  kompl = kompl_pelna,  min_kompl = 0),
  list(nazwa = "79% stałe, 14 × 5",             dni = 14, sygn = 5,  kompl = kompl_stala,  min_kompl = 0),
  list(nazwa = "spadek do .70, 14 × 5",         dni = 14, sygn = 5,  kompl = kompl_spadek, min_kompl = 0),
  list(nazwa = "spadek do .70, 7 × 10",         dni = 7,  sygn = 10, kompl = kompl_spadek, min_kompl = 0),
  list(nazwa = "silny spadek do .50, 14 × 5",   dni = 14, sygn = 5,  kompl = kompl_silny,  min_kompl = 0),
  list(nazwa = "silny spadek + wykluczenie < 50%", dni = 14, sygn = 5, kompl = kompl_silny, min_kompl = .5))

wyniki3 <- mclapply(seq_along(scen), function(i) {
  s <- scen[[i]]
  moc_komorki(N = 80, dni = s$dni, sygn = s$sygn, R = 500, ziarno = 35300 + i,
              kompl = s$kompl, min_kompl = s$min_kompl)
}, mc.cores = 4)
moc_scen <- data.frame(scenariusz = sapply(scen, `[[`, "nazwa"), do.call(rbind, wyniki3))
write.csv(moc_scen, "moc-scenariusze-kompliancji.csv", row.names = FALSE)
print(cbind(moc_scen["scenariusz"], round(moc_scen[, c("odp_na_osobe", "osoby", "moc_w", "mcse_w",
                                                        "moc_int", "mcse_int")], 3)), row.names = FALSE)

# Oczekiwana kompliancja w kolejnych dniach (średnia po osobach, 10^5 losowań różnic osób)
set.seed(35307)
krzywa <- do.call(rbind, lapply(list(spadek = kompl_spadek, silny = kompl_silny), function(k) {
  a <- rnorm(1e5, 0, k$sd_os)
  data.frame(dzien = 1:14, kompl = sapply(1:14, function(t) mean(plogis(qlogis(k$start) + k$spadek * (t - 1) + a))))
}))
krzywa$model <- rep(c("spadek do .70", "silny spadek do .50"), each = 14)
write.csv(krzywa, "kompliancja-dni.csv", row.names = FALSE)
round(sapply(split(krzywa$kompl, krzywa$model), function(x)
  c(dzien1 = x[1], dzien7 = x[7], dzien14 = x[14], srednia = mean(x))), 3)
Wynik w R
                       scenariusz odp_na_osobe  osoby moc_w mcse_w moc_int mcse_int
                     100%, 14 × 5       70.000 80.000 1.000  0.000   0.594    0.022
                79% stałe, 14 × 5       55.317 80.000 1.000  0.000   0.548    0.022
            spadek do .70, 14 × 5       54.171 80.000 0.998  0.002   0.550    0.022
            spadek do .70, 7 × 10       57.528 80.000 1.000  0.000   0.540    0.022
      silny spadek do .50, 14 × 5       47.322 79.996 0.996  0.003   0.532    0.022
 silny spadek + wykluczenie < 50%       53.127 63.940 0.998  0.002   0.462    0.022
        silny spadek do .50 spadek do .70
dzien1                0.830         0.855
dzien7                0.698         0.785
dzien14               0.499         0.677
srednia               0.677         0.774
4. Ten sam budżet sygnałów
R
# Krok 4. Ten sam budżet 5600 zaplanowanych pomiarów, różny podział osoby × dni (wymaga kroków 1–2)
plany <- data.frame(N = c(40, 80, 160), dni = c(28, 14, 7))
plany$pomiary_lacznie <- plany$N * plany$dni * 5
wyniki4 <- mclapply(seq_len(nrow(plany)), function(i)
  moc_komorki(plany$N[i], plany$dni[i], sygn = 5, R = 1000, ziarno = 35400 + i), mc.cores = 4)
moc_budzet <- cbind(pomiary_lacznie = plany$pomiary_lacznie, as.data.frame(do.call(rbind, wyniki4)))
moc_budzet$ci_int_dolna <- moc_budzet$moc_int - 1.96 * moc_budzet$mcse_int
moc_budzet$ci_int_gorna <- moc_budzet$moc_int + 1.96 * moc_budzet$mcse_int
write.csv(moc_budzet, "moc-ten-sam-budzet.csv", row.names = FALSE)
print(round(moc_budzet[, c("N", "dni", "pomiary_lacznie", "odp_na_osobe", "moc_w", "moc_int",
                           "ci_int_dolna", "ci_int_gorna")], 3), row.names = FALSE)
Wynik w R
   N dni pomiary_lacznie odp_na_osobe moc_w moc_int ci_int_dolna ci_int_gorna
  40  28            5600       92.124 0.994   0.361        0.331        0.391
  80  14            5600       54.171 0.999   0.533        0.502        0.564
 160   7            5600       28.774 1.000   0.621        0.591        0.651
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–4 w R 4.5.3 z pakietami lme4 i lmerTest (obliczenia równoległe: pakiet parallel z dystrybucji R); rysunki przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Jedna analiza mocy dla całego badania. Plan, który z zapasem wystarcza dla efektu wewnątrzosobowego, może mieć moc .30–.50 dla interakcji międzypoziomowej.
- Liczenie mocy na zaplanowanych sygnałach. Symuluj odpowiedzi po kompliancji i po regule wykluczania, a nie liczbę sygnałów z protokołu.
- Dokładanie dni zamiast osób. Gdy osoby naprawdę różnią się reaktywnością, kolejne dni poprawiają moc interakcji coraz mniej.
- Długa ankieta „bo i tak pytamy”. Długość kwestionariusza obciąża uczestników bardziej niż liczba sygnałów i pogarsza jakość danych.
- Reguła wykluczania wybrana po zebraniu danych. Ustal ją w planie analizy i uwzględnij w symulacji, bo może kosztować więcej mocy niż same braki.
Najczęstsze pytania
Ile osób potrzeba do badania ESM?
To zależy od hipotezy. W naszej symulacji efekt wewnątrzosobowy 0.10 SD miał moc ≥ .95 przy 60 osobach i 7 dniach po 5 sygnałów, ale interakcja międzypoziomowa 0.04 osiągała .80 dopiero przy 160 osobach i 14 dniach albo 120 osobach i 21 dniach. Policz moc symulacją dla własnego modelu i hipotezy, której najbardziej Ci zależy.
Lepiej więcej dni czy więcej uczestników w badaniu EMA?
Dla efektów wewnątrzosobowych oba sposoby działają. Dla interakcji z cechą osoby liczba osób jest ważniejsza, bo prawdziwych różnic reaktywności nie zmniejszą kolejne dni. Przy 5600 zaplanowanych sygnałach moc interakcji wyniosła .36 dla 40 osób × 28 dni, .53 dla 80 × 14 i .62 dla 160 × 7.
Jak kompliancja wpływa na moc w ESM?
Mniej, niż się zwykle zakłada, jeśli braki nie zależą od mierzonego stanu. Przy 80 osobach utrata ok. jednej czwartej sygnałów obniżyła moc interakcji z .59 do ok. .55. Znacznie więcej kosztowało wykluczenie osób z kompliancją poniżej 50%: moc spadła do .46, bo z analizy wypadało średnio 16 osób.
Ile sygnałów dziennie w badaniu ESM?
Liczbę sygnałów dobierz do tempa zmian badanego stanu i obciążenia uczestników. W eksperymencie Eisele i in. (2022) częstsze sygnały (3, 6 lub 9 dziennie) nie pogarszały kompliancji ani jakości danych, a dłuższa ankieta – tak. Skróć więc kwestionariusz, zanim ograniczysz liczbę sygnałów.
Jak opisać analizę mocy dla badania ESM w artykule?
Podaj model analizy, wartości parametrów i ich źródło, założony model kompliancji i regułę wykluczania osób, liczbę powtórzeń symulacji oraz moc z błędem Monte Carlo dla każdej hipotezy osobno. Dodaj wyniki analizy wrażliwości, np. dla mniejszej kompliancji albo mniejszego efektu.
Powiązane hasła
Przeczytaj też
Badania dzienniczkowe i EMA – analiza danych
Compliance, ICC, centrowanie w osobie, opóźnienia w obrębie dnia, reaktywność afektywna w lme4 i rzetelność zmiany – z kodem R i wzorem opisu.
Czytaj →PoradnikAnaliza mocy dla modelu mieszanego
Własna pętla symulacyjna w lme4: parametry z pilotażu, siatka osób i prób, krzywa mocy, błąd Monte Carlo i analiza wrażliwości.
Czytaj →PoradnikEfekty wewnątrz- i międzyosobowe
Centrowanie w osobie, model Mundlaka, losowe nachylenie i rzetelność średniej osoby – na danych dzienniczkowych o śnie i stresie w lme4.
Czytaj →Planujesz badanie ESM i musisz uzasadnić liczbę osób i pomiarów?
Pomożemy zapisać model populacyjny, zamodelować kompliancję i policzyć moc symulacją dla Twoich hipotez, a potem przygotować opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Arend, M. G., & Schäfer, T. (2019). Statistical power in two-level models: A tutorial based on Monte Carlo simulation. Psychological Methods, 24(1), 1–19. https://doi.org/10.1037/met0000195
- Bolger, N., & Laurenceau, J.-P. (2013). Intensive longitudinal methods: An introduction to diary and experience sampling research. Guilford Press.
- Eisele, G., Vachon, H., Lafit, G., Kuppens, P., Houben, M., Myin-Germeys, I., & Viechtbauer, W. (2022). The effects of sampling frequency and questionnaire length on perceived burden, compliance, and careless responding in experience sampling data in a student population. Assessment, 29(2), 136–151. https://doi.org/10.1177/1073191120957102 ● Otwarty dostęp: pełny tekst
- Lafit, G., Adolf, J. K., Dejonckheere, E., Myin-Germeys, I., Viechtbauer, W., & Ceulemans, E. (2021). Selection of the number of participants in intensive longitudinal studies: A user-friendly Shiny app and tutorial for performing power analysis in multilevel regression models that account for temporal dependencies. Advances in Methods and Practices in Psychological Science, 4(1), Article 2515245920978738. https://doi.org/10.1177/2515245920978738 ● Otwarty dostęp
- Myin-Germeys, I., Kasanova, Z., Vaessen, T., Vachon, H., Kirtley, O., Viechtbauer, W., & Reininghaus, U. (2018). Experience sampling methodology in mental health research: New insights and technical developments. World Psychiatry, 17(2), 123–132. https://doi.org/10.1002/wps.20513 ● Otwarty dostęp
- Trull, T. J., & Ebner-Priemer, U. (2013). Ambulatory assessment. Annual Review of Clinical Psychology, 9(1), 151–176. https://doi.org/10.1146/annurev-clinpsy-050212-185510 ● Otwarty dostęp: pełny tekst
- Wrzus, C., & Neubauer, A. B. (2023). Ecological momentary assessment: A meta-analysis on designs, samples, and compliance across research fields. Assessment, 30(3), 825–846. https://doi.org/10.1177/10731911211067538 ● Otwarty dostęp
Cytowania BibTeX
@article{arend2019statistical, author={Arend, Matthias G. and Schäfer, Thomas}, title={{Statistical power in two-level models: A tutorial based on Monte Carlo simulation}}, journal={Psychological Methods}, year={2019}, volume={24}, number={1}, pages={1--19}, doi={10.1037/met0000195}}@book{bolger2013intensive, author={Bolger, Niall and Laurenceau, Jean-Philippe}, title={{Intensive longitudinal methods: An introduction to diary and experience sampling research}}, year={2013}, publisher={Guilford Press}}@article{eisele2022effects, author={Eisele, Gudrun and Vachon, Hugo and Lafit, Ginette and Kuppens, Peter and Houben, Marlies and Myin-Germeys, Inez and Viechtbauer, Wolfgang}, title={{The effects of sampling frequency and questionnaire length on perceived burden, compliance, and careless responding in experience sampling data in a student population}}, journal={Assessment}, year={2022}, volume={29}, number={2}, pages={136--151}, doi={10.1177/1073191120957102}}@article{lafit2021selection, author={Lafit, Ginette and Adolf, Janne K. and Dejonckheere, Egon and Myin-Germeys, Inez and Viechtbauer, Wolfgang and Ceulemans, Eva}, title={{Selection of the number of participants in intensive longitudinal studies: A user-friendly Shiny app and tutorial for performing power analysis in multilevel regression models that account for temporal dependencies}}, journal={Advances in Methods and Practices in Psychological Science}, year={2021}, volume={4}, number={1}, eid={2515245920978738}, doi={10.1177/2515245920978738}}@article{myingermeys2018experience, author={Myin-Germeys, Inez and Kasanova, Zuzana and Vaessen, Thomas and Vachon, Hugo and Kirtley, Olivia and Viechtbauer, Wolfgang and Reininghaus, Ulrich}, title={{Experience sampling methodology in mental health research: New insights and technical developments}}, journal={World Psychiatry}, year={2018}, volume={17}, number={2}, pages={123--132}, doi={10.1002/wps.20513}}@article{trull2013ambulatory, author={Trull, Timothy J. and Ebner-Priemer, Ulrich}, title={{Ambulatory assessment}}, journal={Annual Review of Clinical Psychology}, year={2013}, volume={9}, number={1}, pages={151--176}, doi={10.1146/annurev-clinpsy-050212-185510}}@article{wrzus2023ecological, author={Wrzus, Cornelia and Neubauer, Andreas B.}, title={{Ecological momentary assessment: A meta-analysis on designs, samples, and compliance across research fields}}, journal={Assessment}, year={2023}, volume={30}, number={3}, pages={825--846}, doi={10.1177/10731911211067538}}