Najpierw cel analizy, potem zmienne
W bazie z ankiety masz często kilkanaście zmiennych: wiek, płeć, kierunek, godziny pracy, sen, kawę, wsparcie, objawy, oceny. Kusi, żeby wrzucić je wszystkie do regresji wielorakiej i zostawić te „istotne”. To odwrócona kolejność. Zanim wybierzesz choćby jedną zmienną, odpowiedz na pytanie, po co Ci model. Shmueli (2010) pokazuje, że wyjaśnianie i przewidywanie to dwa różne cele, a model, który dobrze wyjaśnia, nie musi dobrze przewidywać. Każdy z tych celów wymaga innego doboru zmiennych.
| Cel | Przykładowe pytanie | Skąd zmienne | Czym oceniasz model |
|---|---|---|---|
| Wyjaśnianie (efekt jednej zmiennej) | Czy krótszy sen zwiększa stres? | Hipoteza + zmienne zakłócające z literatury i grafu przyczynowego | Współczynnik ekspozycji z 95% CI, analiza wrażliwości |
| Predykcja | Kto będzie miał wysoki stres w sesji? | Wszystkie sensowne i dostępne predyktory, selekcja przez karę (LASSO) | Trafność w nowych danych lub w walidacji krzyżowej |
| Opis | Czym różnią się studenci z wysokim i niskim stresem? | Zmienne ustalone z góry w pytaniach badawczych | Przejrzyste zestawienie związków, bez języka przyczynowego |
W pracy dyplomowej najczęściej chodzi o pierwszy cel: hipotezy mówią, że coś „wpływa”, „wiąże się po kontroli” albo „przewiduje ponad” inne zmienne. Wtedy dobór zmiennych to decyzja merytoryczna, którą podejmujesz przed analizą, a nie wynik algorytmu.
Dlaczego nie metoda krokowa i nie wybór według p
Jak działa metoda krokowa i jak niestabilny bywa jej wynik, opisujemy w haśle słownika. Tu wystarczy sedno. Każda procedura, która zostawia zmienne dlatego, że w Twojej próbie wypadły „istotnie”, ma te same wady. Dotyczy to selekcji krokowej, eliminacji wstecznej i wstępnego sita z korelacji. Heinze i in. (2018) podsumowują je tak: dobór zmiennych w modelu wyjaśniającym może naruszać stabilność modelu i nieobciążoność współczynników oraz trafność wartości p i przedziałów ufności. Whittingham i in. (2006) wymieniają obciążone oszacowania, problem wielokrotnego testowania i poleganie na jednym „najlepszym” modelu. Smith (2018) dodaje, że prawdziwe predyktory mogą wypaść jako nieistotne, a przypadkowe zmienne jako istotne, i to tym częściej, im więcej jest kandydatów.
Najłatwiej zobaczyć to na danych, w których z definicji nie ma czego znaleźć. Zasymulowaliśmy 1000 badań po 120 osób z 15 kandydatami na predyktory, z których żaden nie wpływał na wynik. W każdym badaniu uruchomiliśmy metodę krokową z progami takimi jak w SPSS (wejście p < .05, usunięcie p > .10):
- w 52.3% badań w modelu końcowym został co najmniej jeden „istotny” predyktor (jeden w 32.4%, dwa w 15.5%, trzy lub więcej w 4.4%);
- w każdym z tych modeli test F całego modelu dawał p < .05, choć prawdziwe R² wynosiło 0;
- średnia bezwzględna wartość wybranych współczynników wyniosła 0.212 odchylenia standardowego wyniku, a prawdziwa – zero;
- mediana R² w próbie, na której wybierano zmienne, wynosiła .055, a w nowej próbie z tej samej populacji −.080, czyli model przewidywał gorzej niż sama średnia.
Dla porównania regresja LASSO z 10-krotną walidacją krzyżową (reguła jednego błędu standardowego) zostawiła jakąkolwiek zmienną tylko w 0.4% tych samych badań (Rysunek 1).
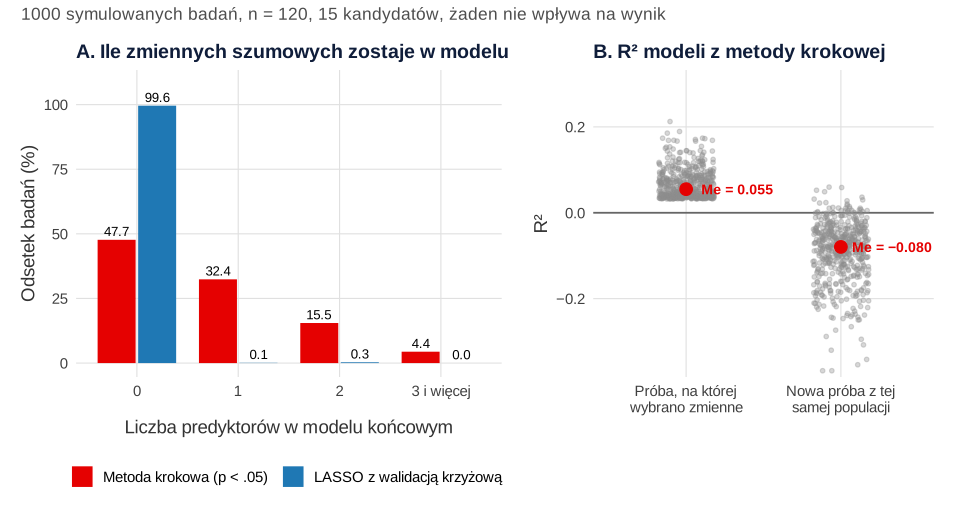
To nie znaczy, że LASSO jest „lepszą metodą krokową” do testowania hipotez. Pokazuje tylko, że wybór według p w danych, z których potem raportujesz p, produkuje odkrycia z niczego. Babyak (2004) zalicza automatyczny dobór zmiennych i wstępne testowanie kandydatów do głównych źródeł przeuczenia. Daje on wyniki, które nie powtarzają się w nowych próbach.
Przykład: sen i stres – jeden zbiór, dwa cele
Studentka psychologii zbadała 250 studentów (dane symulowane, plik CSV). Wynikiem jest stres w skali PSS-10 (M = 24.72, SD = 5.52), a hipoteza brzmi: krótszy sen zwiększa stres (sen: M = 6.31 h, SD = 0.98). W bazie jest jeszcze dziewięć zmiennych. Ponieważ dane wygenerowaliśmy sami, znamy ich role:
- godziny pracy zarobkowej skracają sen i same podnoszą stres – to zmienna zakłócająca;
- zmęczenie leży na drodze od snu do stresu – to mediator;
- objawy somatyczne są wspólnym skutkiem krótkiego snu i stresu – to zmienna zderzeniowa;
- wsparcie społeczne wpływa tylko na stres, a kawa tylko na sen;
- wiek, liczba rodzeństwa, czas dojazdu i średnia ocen nie mają związku z niczym.
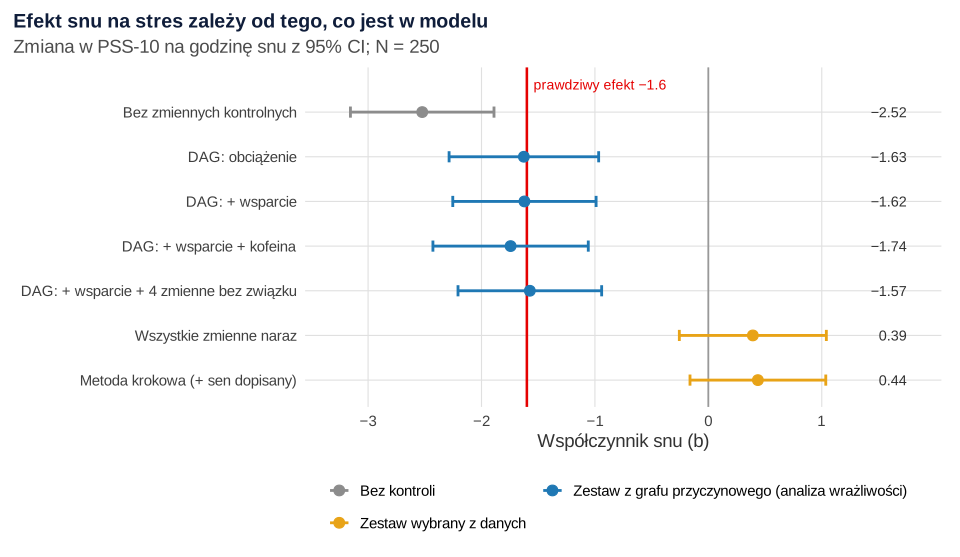
Prawdziwy efekt całkowity snu wynosi −1.6 punktu PSS na godzinę: −0.8 bezpośrednio i −0.8 przez zmęczenie. Metoda krokowa uruchomiona na wszystkich dziesięciu kandydatach wybrała objawy, zmęczenie, wsparcie, godziny pracy i czas dojazdu. Snu, czyli zmiennej z hipotezy, w modelu nie było. Studentka napisałaby, że sen nie ma znaczenia. Gdy dopisać sen do modelu krokowego, jego współczynnik wynosi b = 0.44, 95% CI [−0.16, 1.04], p = .152. Model ze wszystkimi zmiennymi naraz daje prawie to samo: b = 0.39, 95% CI [−0.26, 1.04], p = .234.
To nie pech jednej próby. W 1000 powtórzeniach badania metoda krokowa wybrała sen tylko w 5.2% przypadków, a zmęczenie i objawy w 100%. Średni współczynnik snu w modelu krokowym (z dopisanym snem) wyniósł 0.018, w modelu ze wszystkimi zmiennymi 0.013, a w modelu z zestawem z grafu przyczynowego −1.591. Mediator i zmienna zderzeniowa najsilniej wiążą się z wynikiem, więc każda selekcja według p chętnie je zostawia. W modelu wyjaśniającym to jednak dwie zmienne, których nie wolno kontrolować.
Model wyjaśniający: literatura, DAG i analiza wrażliwości
Gdy celem jest efekt jednej zmiennej, postępuj tak:
- Zapisz pytanie jako efekt X na Y. Tu: efekt snu na stres.
- Zbierz z literatury zmienne, które mogą być przyczynami X lub Y. Nie szukaj zmiennych „skorelowanych z wynikiem”, tylko mechanizmów.
- Narysuj graf przyczynowy i wyznacz zestaw zmiennych kontrolnych, który zamyka ścieżki zakłócające. Krok po kroku pokazujemy to we wpisie grafy przyczynowe (DAG), a krótszą wersję dla zmiennych demograficznych – we wpisie czy kontrolować wiek i płeć. Wysocki i in. (2022) podkreślają, że kontrola statystyczna wymaga uzasadnienia przyczynowego. Przy złym doborze oszacowanie bywa bardziej obciążone niż bez żadnej kontroli.
- Nie kontroluj mediatorów ani wspólnych skutków. W przykładzie wyklucza to zmęczenie i objawy.
- Wprowadź zmienne naraz (metoda wprowadzania) albo blokami w kolejności z hipotez (regresja hierarchiczna) i nie usuwaj niczego po obejrzeniu p.
W przykładzie graf wskazuje jedną zmienną zakłócającą: godziny pracy. Model ze snem i godzinami pracy daje b = −1.63, 95% CI [−2.29, −0.97]. Bez żadnej kontroli wynik byłby zawyżony (−2.52), bo pracujący więcej śpią krócej i mają więcej stresu z innych powodów.
Graf to założenie, więc sprawdź, czy wniosek przetrwa inne rozsądne decyzje. To jest analiza wrażliwości. Steegen i in. (2016) proponują w tym celu analizę wieloświatową, czyli powtórzenie analizy dla wszystkich rozsądnych wariantów decyzji. W przykładzie dodanie wsparcia (zmienna związana tylko z wynikiem) dało −1.62 [−2.25, −0.99]. Dodanie kawy (związanej tylko ze snem) dało −1.74 [−2.43, −1.06] z nieco szerszym przedziałem. Dodanie czterech zmiennych bez związku dało −1.57 [−2.21, −0.94]. Wniosek się nie zmienia. Rozbudowaną wersję tej strategii opisuje wpis analiza multiverse i krzywa specyfikacji.
Zostaje pytanie, ile zmiennych zmieści się w modelu. W regresji logistycznej liczy się liczba zdarzeń, a nie całe N (zob. EPV). Reguły i kryteria minimalnej liczebności omawiamy we wpisie ile predyktorów w regresji. Jeśli lista zmiennych z grafu jest za długa, nie skracaj jej według p. Połącz podobne zmienne w jeden wskaźnik albo zostaw te, które według literatury są najważniejszymi zmiennymi zakłócającymi. Takie zabezpieczenia wymienia Babyak (2004), a całą strategię budowy modelu wielozmiennowego szczegółowo omawia podręcznik Harrella (2015).
Model predykcyjny: LASSO i ocena na nowych danych
Załóżmy teraz, że poradnia uczelniana chce wskazać studentów z wysokim stresem. Wtedy nie pytasz, co jest przyczyną, tylko co pomaga przewidywać. Zmęczenie i objawy somatyczne, zakazane w modelu wyjaśniającym, są tu cennymi predyktorami. Do selekcji użyj metody z karą. LASSO ściąga współczynniki w stronę zera i część z nich zeruje (Tibshirani, 1996). Siłę kary dobiera walidacja krzyżowa.
W przykładzie LASSO (λ = 0.604) zostawiło godziny pracy, zmęczenie, wsparcie i objawy. Wyzerowało sen, kawę i wszystkie cztery zmienne bez związku. Sen nie zniknął dlatego, że nie działa. Jego informacja o stresie jest już zawarta w zmęczeniu i objawach. Tak wygląda trafność modeli w nowej próbie 5000 osób z tej samej populacji:
| Model | R² w próbie uczącej (N = 250) | R² w nowej próbie (N = 5000) |
|---|---|---|
| Zestaw z grafu (sen, praca, wsparcie) | .362 | .343 |
| Wszystkie 10 zmiennych | .611 | .543 |
| Metoda krokowa (z dopisanym snem) | .609 | .547 |
| LASSO z walidacją krzyżową | – | .518 |
Dwie lekcje. Po pierwsze, model dobry do wyjaśniania jest tu najsłabszy w przewidywaniu, a modele przewidujące najlepiej dają najbardziej mylący współczynnik snu – dokładnie tak, jak opisuje Shmueli (2010). Po drugie, przy 250 osobach i tylko 10 kandydatach różnice między metodami predykcyjnymi są małe. Tu metoda krokowa przewidywała nawet minimalnie lepiej niż LASSO, choć wciągnęła do modelu czas dojazdu, który nie ma związku ze stresem. Przewaga kary rośnie, gdy kandydatów jest dużo w stosunku do liczby osób – jak w Rysunku 1. Niezależnie od metody trafność oceniaj poza próbą, na której wybierałeś zmienne. Jak to zrobić walidacją krzyżową i jak sprawdzić kalibrację, pokazuje wpis modele predykcyjne: walidacja i kalibracja. Współczynniki z LASSO nie mają zwykłych p ani przedziałów ufności, więc nie testuj nimi hipotez.
Jak opisać dobór zmiennych w pracy
W rozdziale metodologicznym napisz, jaki był cel modelu, skąd wzięły się zmienne i których celowo nie uwzględniono. Jeśli plan analizy powstał przed zebraniem danych, wspomnij o tym (zob. plan analizy i prerejestracja). Tabelę wyników opisuj tak, jak radzimy we wpisie o błędzie tabeli 2: interpretuj współczynnik ekspozycji, a nie każdy wiersz.
Najczęstsze błędy
- „Do modelu wprowadzono zmienne istotne w analizie jednoczynnikowej”. To selekcja według p w przebraniu. Ma te same wady co metoda krokowa.
- Usuwanie nieistotnych zmiennych kontrolnych. Zmienna zakłócająca nie musi być istotna, żeby zmieniać oszacowanie efektu.
- Mediator lub wspólny skutek jako „kontrola”. W przykładzie zmienił efekt snu z −1.6 na wartość bliską zera.
- Raportowanie p i R² z modelu po selekcji tak, jakby zestaw był znany z góry. Gdy selekcja była eksploracyjna, napisz to wprost i podaj jej stabilność (Heinze i in., 2018).
- Ocena modelu predykcyjnego na danych, na których go budowano. R² w próbie uczącej zawsze jest zbyt optymistyczne.
- Mylenie celów. Najlepszy predyktor nie jest „najważniejszą przyczyną”, a dobry model wyjaśniający nie musi dobrze przewidywać.
Jeśli promotor prosi o metodę krokową, pokaż mu Rysunek 2 i zaproponuj model z grafu z analizą wrażliwości. Jeśli chcesz, żeby ktoś sprawdził z Tobą graf i dobór zmiennych przed analizą, zobacz naszą pomoc w analizie dla studentów.
Dobór zmiennych w R: kod i wynik
Dwa przepisy liczą wszystkie wyniki z tekstu. Pierwszy to symulacja na samych zmiennych szumowych (zapisuje też plik z wynikami do rysunku). Drugi tworzy dane o śnie i stresie, zapisuje plik CSV w folderze nadrzędnym (../) i porównuje modele. Rysunki powstały w osobnym skrypcie na tych samych danych.
Metoda krokowa i LASSO na 15 zmiennych szumowych – 1000 badań
R
# B362 – metoda krokowa na samych zmiennych szumowych (dane symulowane)
# 1000 badań po 120 osób; 15 kandydatów na predyktory, ŻADEN nie wpływa na wynik.
suppressPackageStartupMessages(library(glmnet))
set.seed(362)
n <- 120; k <- 15; R <- 1000

# Metoda krokowa jak w SPSS: wejście p < .05, usunięcie p > .10
krokowa <- function(d, y = "y", wej = .05, usun = .10) {
  w <- character(0); kand <- setdiff(names(d), y)
  for (krok in 1:50) {
    zmiana <- FALSE
    poza <- setdiff(kand, w)
    if (length(poza) > 0) {
      p_wej <- sapply(poza, function(v) {
        m <- lm(reformulate(c(w, v), y), data = d); summary(m)$coefficients[v, 4] })
      if (min(p_wej) < wej) { w <- c(w, names(which.min(p_wej))); zmiana <- TRUE }
    }
    if (length(w) > 1) {
      p_w <- summary(lm(reformulate(w, y), data = d))$coefficients[w, 4]
      if (max(p_w) > usun) { w <- setdiff(w, names(which.max(p_w))); zmiana <- TRUE }
    }
    if (!zmiana) break
  }
  w
}
generuj <- function(n) {
  X <- as.data.frame(matrix(rnorm(n * k), n, k, dimnames = list(NULL, paste0("x", 1:k))))
  cbind(y = rnorm(n), X)                                        # y nie zależy od żadnego x
}
r2_nowe <- function(m, nowe) 1 - sum((nowe$y - predict(m, nowe))^2) / sum((nowe$y - mean(nowe$y))^2)

wyniki <- t(replicate(R, {
  d <- generuj(n); nowe <- generuj(n)
  w <- krokowa(d)
  lasso <- cv.glmnet(as.matrix(d[, -1]), d$y, nfolds = 10)
  n_lasso <- sum(coef(lasso, s = "lambda.1se")[-1] != 0)
  if (length(w) == 0) return(c(liczba = 0, p_F = NA, R2 = NA, R2_nowe = NA, b_abs = NA, n_lasso = n_lasso))
  m <- lm(reformulate(w, "y"), data = d); s <- summary(m)
  c(liczba = length(w), p_F = pf(s$fstatistic[1], s$fstatistic[2], s$fstatistic[3], lower.tail = FALSE),
    R2 = s$r.squared, R2_nowe = r2_nowe(m, nowe), b_abs = mean(abs(coef(m)[-1])), n_lasso = n_lasso)
}))
wyniki <- as.data.frame(wyniki)
write.csv(wyniki, "b362-szum-symulacja.csv", row.names = FALSE)   # do rysunku

cat("Metoda krokowa – liczba 'istotnych' predyktorów w modelu końcowym (odsetek z", R, "badań):\n")
print(round(100 * prop.table(table(factor(pmin(wyniki$liczba, 3), 0:3, c("0", "1", "2", "3+")))), 1))
cat(sprintf("Co najmniej jeden predyktor: %.1f%% badań\n", 100 * mean(wyniki$liczba > 0)))
z <- wyniki[wyniki$liczba > 0, ]
cat(sprintf("W tych badaniach: test F modelu p < .05 w %.1f%%; mediana R2 = %.3f; mediana R2 w nowej próbie = %.3f\n",
            100 * mean(z$p_F < .05), median(z$R2), median(z$R2_nowe)))
cat(sprintf("Średnia |b| wybranych zmiennych = %.3f (prawdziwe b = 0; SD wyniku = 1)\n", mean(z$b_abs)))
cat(sprintf("LASSO (10-krotna walidacja krzyżowa, lambda.1se): co najmniej jeden predyktor w %.1f%% badań\n",
            100 * mean(wyniki$n_lasso > 0)))
Wynik w R
Metoda krokowa – liczba 'istotnych' predyktorów w modelu końcowym (odsetek z 1000 badań):

   0    1    2   3+
47.7 32.4 15.5  4.4
Co najmniej jeden predyktor: 52.3% badań
W tych badaniach: test F modelu p < .05 w 100.0%; mediana R2 = 0.055; mediana R2 w nowej próbie = -0.080
Średnia |b| wybranych zmiennych = 0.212 (prawdziwe b = 0; SD wyniku = 1)
LASSO (10-krotna walidacja krzyżowa, lambda.1se): co najmniej jeden predyktor w 0.4% badań
Sen i stres: zestawy z grafu, metoda krokowa, LASSO i 1000 powtórzeń
R
# B362 – ten sam zbiór, dwa cele: efekt snu na stres (wyjaśnianie) i przewidywanie stresu (predykcja)
# Dane symulowane: 250 studentów; stres w skali PSS-10 (0–40). Znamy prawdziwy mechanizm.
suppressPackageStartupMessages(library(glmnet))
set.seed(3609)

generuj <- function(n) {
  obciazenie <- pmax(0, round(rnorm(n, 12, 6)))                 # godziny pracy zarobkowej / tydzień (zakłócacz)
  kofeina <- rpois(n, 2)                                        # kawy dziennie (wpływa tylko na sen)
  sen <- 7.6 - 0.06 * obciazenie - 0.25 * kofeina + rnorm(n, 0, 0.8)   # godziny snu (ekspozycja)
  zmeczenie <- 9 - 0.5 * sen + 0.05 * obciazenie + rnorm(n, 0, 1)      # mediator (0–10)
  wsparcie <- rnorm(n, 5, 1)                                    # wsparcie społeczne (wpływa tylko na stres)
  stres <- 20 - 0.8 * (sen - 7) + 1.6 * (zmeczenie - 5.5) + 0.25 * obciazenie - 1.5 * (wsparcie - 5) + rnorm(n, 0, 4)
  objawy <- 2 + 0.35 * stres - 0.9 * (sen - 7) + rnorm(n, 0, 2.5)    # objawy somatyczne – wspólny skutek snu i stresu
  data.frame(stres, sen, obciazenie, kofeina, zmeczenie, wsparcie, objawy,
             wiek = round(runif(n, 19, 26)), rodzenstwo = rpois(n, 1.2),      # cztery zmienne bez żadnego związku
             dojazd = round(rgamma(n, 4, 0.12)), oceny = round(rnorm(n, 4.1, 0.4), 2))
}
cat("Prawdziwy efekt całkowity snu: -0.8 + (-0.5 * 1.6) =", -0.8 + (-0.5 * 1.6), "pkt PSS na godzinę\n")
dane <- generuj(250)
write.csv(dane, "../jak-wybrac-zmienne-sen-stres-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
cat(sprintf("N = %d; stres M = %.2f, SD = %.2f; sen M = %.2f, SD = %.2f\n", nrow(dane),
            mean(dane$stres), sd(dane$stres), mean(dane$sen), sd(dane$sen)))

# Metoda krokowa jak w SPSS: wejście p < .05, usunięcie p > .10
krokowa <- function(d, y = "stres", wej = .05, usun = .10) {
  w <- character(0); kand <- setdiff(names(d), y)
  for (krok in 1:50) {
    zmiana <- FALSE
    poza <- setdiff(kand, w)
    if (length(poza) > 0) {
      p_wej <- sapply(poza, function(v) summary(lm(reformulate(c(w, v), y), data = d))$coefficients[v, 4])
      if (min(p_wej) < wej) { w <- c(w, names(which.min(p_wej))); zmiana <- TRUE }
    }
    if (length(w) > 1) {
      p_w <- summary(lm(reformulate(w, y), data = d))$coefficients[w, 4]
      if (max(p_w) > usun) { w <- setdiff(w, names(which.max(p_w))); zmiana <- TRUE }
    }
    if (!zmiana) break
  }
  w
}
wsp_sen <- function(f, d) {
  m <- lm(f, data = d); ci <- confint(m)["sen", ]
  c(b = coef(m)[["sen"]], dol = ci[[1]], gor = ci[[2]], p = summary(m)$coefficients["sen", 4])
}

# 1. Cel: wyjaśnianie. Zestawy zmiennych kontrolnych (analiza wrażliwości) a modele „z danych”
w_krok <- krokowa(dane)
cat("\nMetoda krokowa wybrała:", paste(w_krok, collapse = ", "), "\n")
f_krok <- reformulate(unique(c("sen", w_krok)), "stres")
modele <- list(
  DAG_minimalny   = stres ~ sen + obciazenie,
  DAG_wsparcie    = stres ~ sen + obciazenie + wsparcie,
  DAG_kofeina     = stres ~ sen + obciazenie + wsparcie + kofeina,
  DAG_szum        = stres ~ sen + obciazenie + wsparcie + wiek + rodzenstwo + dojazd + oceny,
  surowy          = stres ~ sen,
  wszystko        = stres ~ .,
  krokowa_plus_sen = f_krok)
tab <- t(sapply(modele, wsp_sen, d = dane))
print(round(tab, 3))

# 2. Cel: predykcja. Trafność w nowej próbie 5000 osób z tej samej populacji
nowe <- generuj(5000)
r2_nowe <- function(pred) 1 - sum((nowe$stres - pred)^2) / sum((nowe$stres - mean(nowe$stres))^2)
X <- as.matrix(dane[, -1]); Xn <- as.matrix(nowe[, -1])
lasso <- cv.glmnet(X, dane$stres, nfolds = 10)
cat(sprintf("\nLASSO: lambda.1se = %.3f; zostawione zmienne: %s\n", lasso$lambda.1se,
            paste(rownames(coef(lasso, s = "lambda.1se"))[-1][coef(lasso, s = "lambda.1se")[-1] != 0], collapse = ", ")))
print(round(coef(lasso, s = "lambda.1se")[, 1], 3))
r2 <- c(DAG_wsparcie = r2_nowe(predict(lm(modele$DAG_wsparcie, dane), nowe)),
        wszystko     = r2_nowe(predict(lm(stres ~ ., dane), nowe)),
        krokowa      = r2_nowe(predict(lm(f_krok, dane), nowe)),
        lasso_1se    = r2_nowe(predict(lasso, Xn, s = "lambda.1se")[, 1]))
r2_ucz <- c(summary(lm(modele$DAG_wsparcie, dane))$r.squared, summary(lm(stres ~ ., dane))$r.squared,
            summary(lm(f_krok, dane))$r.squared, NA)
print(round(data.frame(R2_uczaca = r2_ucz, R2_nowa_proba = r2), 3))

# 3. Czy to nie przypadek tej jednej próby? 1000 powtórzeń badania (N = 250)
pow <- t(replicate(1000, {
  d <- generuj(250); w <- krokowa(d)
  c(dag = coef(lm(modele$DAG_wsparcie, d))[["sen"]], wszystko = coef(lm(stres ~ ., d))[["sen"]],
    sen_w_krokowej = "sen" %in% w, krokowa = coef(lm(reformulate(unique(c("sen", w)), "stres"), d))[["sen"]],
    mediator_w_krokowej = "zmeczenie" %in% w, objawy_w_krokowej = "objawy" %in% w)
}))
cat("\nŚrednie współczynniki snu z 1000 powtórzeń (prawda: -1.6) i SD:\n")
print(round(rbind(srednia = colMeans(pow[, c("dag", "wszystko", "krokowa")]),
                  SD = apply(pow[, c("dag", "wszystko", "krokowa")], 2, sd)), 3))
cat(sprintf("Metoda krokowa: sen w modelu w %.1f%%, zmęczenie w %.1f%%, objawy w %.1f%% powtórzeń\n",
            100 * mean(pow[, "sen_w_krokowej"]), 100 * mean(pow[, "mediator_w_krokowej"]),
            100 * mean(pow[, "objawy_w_krokowej"])))
Wynik w R
Prawdziwy efekt całkowity snu: -0.8 + (-0.5 * 1.6) = -1.6 pkt PSS na godzinę
N = 250; stres M = 24.72, SD = 5.52; sen M = 6.31, SD = 0.98

Metoda krokowa wybrała: objawy, zmeczenie, wsparcie, obciazenie, dojazd
                      b    dol    gor     p
DAG_minimalny    -1.626 -2.286 -0.967 0.000
DAG_wsparcie     -1.621 -2.253 -0.989 0.000
DAG_kofeina      -1.743 -2.428 -1.059 0.000
DAG_szum         -1.574 -2.207 -0.941 0.000
surowy           -2.523 -3.155 -1.890 0.000
wszystko          0.392 -0.256  1.041 0.234
krokowa_plus_sen  0.437 -0.162  1.035 0.152

LASSO: lambda.1se = 0.604; zostawione zmienne: obciazenie, zmeczenie, wsparcie, objawy
(Intercept)         sen  obciazenie     kofeina   zmeczenie    wsparcie
     12.472       0.000       0.100       0.000       0.809      -0.321
     objawy        wiek  rodzenstwo      dojazd       oceny
      0.672       0.000       0.000       0.000       0.000
             R2_uczaca R2_nowa_proba
DAG_wsparcie     0.362         0.343
wszystko         0.611         0.543
krokowa          0.609         0.547
lasso_1se           NA         0.518

Średnie współczynniki snu z 1000 powtórzeń (prawda: -1.6) i SD:
           dag wszystko krokowa
srednia -1.591    0.013   0.018
SD       0.313    0.323   0.299
Metoda krokowa: sen w modelu w 5.2%, zmęczenie w 100.0%, objawy w 100.0% powtórzeń
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem glmnet; rysunki przygotowano w pakietach ggplot2, patchwork, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- glmnet (wersja 5.0): Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Czym zastąpić metodę krokową w pracy magisterskiej?
Jeśli testujesz hipotezy, wprowadź naraz zmienne wynikające z hipotez, literatury i grafu przyczynowego, a decyzje opisz w rozdziale metodologicznym. Jeśli budujesz model do przewidywania, użyj regresji z karą (np. LASSO) z walidacją krzyżową i sprawdź trafność na nowych danych lub przez walidację.
Czy można usunąć z regresji nieistotne zmienne kontrolne?
Zwykle nie. Zmienna kontrolna jest w modelu dlatego, że według założonej struktury przyczynowej zamyka ścieżkę zakłócającą, a nie dlatego, że ma małe p. Usunięcie jej po obejrzeniu wyników zmienia pytanie, na które odpowiada model, i sprawia, że raportowane p przestaje znaczyć to, co powinno.
Czy LASSO nadaje się do testowania hipotez?
Nie wprost. LASSO ściąga współczynniki w stronę zera, więc nie daje zwykłych błędów standardowych ani wartości p. Służy do budowy modeli predykcyjnych; jeśli pytasz o efekt konkretnej zmiennej, oszacuj go w modelu z zestawem zmiennych ustalonym z góry.
Czy dobór zmiennych do regresji na podstawie korelacji z wynikiem jest poprawny?
To ten sam problem co metoda krokowa: zmienne wybrane dlatego, że w Twojej próbie wypadły dobrze, mają przeciętnie zawyżone współczynniki i zbyt optymistyczne p. Korelacja nie odróżnia też zmiennej zakłócającej od mediatora ani od wspólnego skutku, a każda z nich wymaga innej decyzji.
Jak uzasadnić wybór zmiennych do modelu regresji w pracy?
Dla każdej zmiennej podaj powód włączenia: hipotezę, wynik wcześniejszych badań albo rolę w grafie przyczynowym (np. wspólna przyczyna predyktora i wyniku). Wymień też zmienne celowo pominięte, np. mediatory, i dodaj zdanie o analizie wrażliwości z innym rozsądnym zestawem zmiennych.
Powiązane hasła
Przeczytaj też
Ile predyktorów w regresji?
Reguła 10 zdarzeń na predyktor i jej słabości, minimalna liczebność według Rileya i in., regresja liniowa i logistyczna oraz symulacja przeuczenia w R.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →PoradnikBłąd tabeli 2
Dlaczego współczynniki zmiennych kontrolnych to nie efekty: palenie, nadciśnienie i udar w R, DAG, osobne modele i wzór opisu tabeli w pracy.
Czytaj →Nie wiesz, które zmienne wstawić do regresji?
Przejdziemy razem przez pytania badawcze i graf przyczynowy, dobierzemy zmienne, policzymy model w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie uzasadnić każdą decyzję na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Babyak, M. A. (2004). What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models. Psychosomatic Medicine, 66(3), 411–421. https://doi.org/10.1097/01.psy.0000127692.23278.a9 ● Otwarty dostęp
- Harrell, F. E., Jr. (2015). Regression modeling strategies: With applications to linear models, logistic and ordinal regression, and survival analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-19425-7
- Heinze, G., Wallisch, C., & Dunkler, D. (2018). Variable selection – A review and recommendations for the practicing statistician. Biometrical Journal, 60(3), 431–449. https://doi.org/10.1002/bimj.201700067 ● Otwarty dostęp
- Shmueli, G. (2010). To explain or to predict? Statistical Science, 25(3), 289–310. https://doi.org/10.1214/10-sts330 ● Otwarty dostęp
- Smith, G. (2018). Step away from stepwise. Journal of Big Data, 5(1), Article 32. https://doi.org/10.1186/s40537-018-0143-6 ● Otwarty dostęp
- Steegen, S., Tuerlinckx, F., Gelman, A., & Vanpaemel, W. (2016). Increasing transparency through a multiverse analysis. Perspectives on Psychological Science, 11(5), 702–712. https://doi.org/10.1177/1745691616658637
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Whittingham, M. J., Stephens, P. A., Bradbury, R. B., & Freckleton, R. P. (2006). Why do we still use stepwise modelling in ecology and behaviour? Journal of Animal Ecology, 75(5), 1182–1189. https://doi.org/10.1111/j.1365-2656.2006.01141.x ● Otwarty dostęp: pełny tekst
- Wysocki, A. C., Lawson, K. M., & Rhemtulla, M. (2022). Statistical control requires causal justification. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095823. https://doi.org/10.1177/25152459221095823 ● Otwarty dostęp
Cytowania BibTeX
@article{babyak2004what, author={Babyak, Michael A.}, title={{What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models}}, journal={Psychosomatic Medicine}, year={2004}, volume={66}, number={3}, pages={411--421}, doi={10.1097/01.psy.0000127692.23278.a9}}@book{harrell2015regression, author={Harrell, Jr., Frank E.}, title={{Regression modeling strategies: With applications to linear models, logistic and ordinal regression, and survival analysis}}, year={2015}, edition={2}, publisher={Springer}, doi={10.1007/978-3-319-19425-7}}@article{heinze2018variable, author={Heinze, Georg and Wallisch, Christine and Dunkler, Daniela}, title={{Variable selection – A review and recommendations for the practicing statistician}}, journal={Biometrical Journal}, year={2018}, volume={60}, number={3}, pages={431--449}, doi={10.1002/bimj.201700067}}@article{shmueli2010explain, author={Shmueli, Galit}, title={{To explain or to predict?}}, journal={Statistical Science}, year={2010}, volume={25}, number={3}, pages={289--310}, doi={10.1214/10-sts330}}@article{smith2018step, author={Smith, Gary}, title={{Step away from stepwise}}, journal={Journal of Big Data}, year={2018}, volume={5}, number={1}, eid={32}, doi={10.1186/s40537-018-0143-6}}@article{steegen2016increasing, author={Steegen, Sara and Tuerlinckx, Francis and Gelman, Andrew and Vanpaemel, Wolf}, title={{Increasing transparency through a multiverse analysis}}, journal={Perspectives on Psychological Science}, year={2016}, volume={11}, number={5}, pages={702--712}, doi={10.1177/1745691616658637}}@article{tibshirani1996regression, author={Tibshirani, Robert}, title={{Regression shrinkage and selection via the lasso}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1996}, volume={58}, number={1}, pages={267--288}, doi={10.1111/j.2517-6161.1996.tb02080.x}}@article{whittingham2006why, author={Whittingham, Mark J. and Stephens, Philip A. and Bradbury, Richard B. and Freckleton, Robert P.}, title={{Why do we still use stepwise modelling in ecology and behaviour?}}, journal={Journal of Animal Ecology}, year={2006}, volume={75}, number={5}, pages={1182--1189}, doi={10.1111/j.1365-2656.2006.01141.x}}@article{wysocki2022statistical, author={Wysocki, Anna C. and Lawson, Katherine M. and Rhemtulla, Mijke}, title={{Statistical control requires causal justification}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095823}, doi={10.1177/25152459221095823}}