BFI-2: skąd pochodzi i czym różni się od BFI
Big Five Inventory-2 (BFI-2) to następca popularnego 44-pozycyjnego Big Five Inventory. Soto i John (2017) opracowali go w trzech badaniach. Nowa wersja ma hierarchiczną strukturę: 15 aspektów (facets) zagnieżdżonych w pięciu domenach Wielkiej Piątki. Autorzy pokazali, że BFI-2 jest rzetelny i trafny, kontroluje indywidualne różnice w tendencji do zgadzania się i lepiej przewiduje kryteria niż pierwotny BFI, a przy tym pozostał krótki i zrozumiały.
Narzędzie ma 60 krótkich fraz opisujących zachowania i cechy. Domeny noszą nazwy Extraversion, Agreeableness, Conscientiousness, Negative Emotionality i Open-Mindedness (Berkeley Personality Lab, b.d.). Dwie ostatnie różnią się od nazw z innych kwestionariuszy. Negatywna emocjonalność odpowiada neurotyczności, a otwartość umysłu – otwartości na doświadczenie albo intelektowi z puli IPIP. Jeśli porównujesz wyniki z badaniami prowadzonymi innymi narzędziami, sprawdź, czy kierunek skali jest ten sam. Liczenie wyników darmowego Mini-IPIP opisujemy w osobnym wpisie o Mini-IPIP i IPIP.
Licencja i skąd wziąć klucz
BFI-2 nie jest w domenie publicznej. Prawa autorskie mają Christopher J. Soto i Oliver P. John. Według strony laboratorium osobowości w Berkeley narzędzie jest jednak bezpłatne do niekomercyjnych badań naukowych. Na użycie komercyjne trzeba uzyskać zgodę autorów (Berkeley Personality Lab, b.d.). Formularz i instrukcję punktacji pobiera się ze strony laboratorium po wypełnieniu krótkiej ankiety o tym, kim jesteś i do czego potrzebujesz narzędzia. Praca dyplomowa czy projekt badawczy na uczelni mieszczą się w użyciu niekomercyjnym. Warunki zawsze sprawdź jednak na stronie autorów, a w pracy podaj, skąd masz narzędzie.
Numery pozycji z kluczem odwróconym bierz wyłącznie z oficjalnego klucza. W tym wpisie ich nie podajemy, bo autorzy udostępniają klucz razem z formularzem. Nie przepisuj klucza z forów, prezentacji ani starszego BFI-44: to inne narzędzie z inną kolejnością pozycji.
Budowa: 5 domen, 15 aspektów, zrównoważony klucz
Każdą domenę mierzy 12 pozycji, a każdy aspekt – 4 pozycje. Odpowiedzi udziela się na pięciostopniowej skali od 1 (zdecydowanie się nie zgadzam) do 5 (zdecydowanie się zgadzam). W każdej domenie i w każdym aspekcie jest tyle samo pozycji z kluczem prostym, co z kluczem odwróconym (Yoshino i in., 2022). Domena ma więc 6 pozycji „+” i 6 „−”, a aspekt – po 2. Ta równowaga ułatwia kontrolę tendencji do zgadzania się, o czym piszemy niżej.
| Domena | Aspekty (nazwy oryginalne) | Opis roboczy |
|---|---|---|
| Ekstrawersja (Extraversion) | Sociability, Assertiveness, Energy Level | towarzyskość, asertywność, poziom energii |
| Ugodowość (Agreeableness) | Compassion, Respectfulness, Trust | współczucie, szacunek dla innych, zaufanie |
| Sumienność (Conscientiousness) | Organization, Productiveness, Responsibility | zorganizowanie, produktywność, odpowiedzialność |
| Negatywna emocjonalność (Negative Emotionality) | Anxiety, Depression, Emotional Volatility | lęk, przygnębienie, zmienność emocjonalna |
| Otwartość umysłu (Open-Mindedness) | Intellectual Curiosity, Aesthetic Sensitivity, Creative Imagination | ciekawość intelektualna, wrażliwość estetyczna, wyobraźnia twórcza |
Nazwy aspektów za Yoshino i in. (2022). Polskie opisy w trzeciej kolumnie są robocze. W pracy używaj nazw z wersji, której używasz.
Istnieją też dwie skrócone formy. BFI-2-S ma 30 pozycji i oprócz domen pozwala krótko oszacować trzy aspekty w każdej domenie. BFI-2-XS ma 15 pozycji i mierzy tylko domeny (Rammstedt i in., 2020). Krótsza forma oszczędza czas, ale ma swoją cenę. Bardzo krótkie miary Wielkiej Piątki mogą zaniżać związki osobowości z zachowaniem i zwiększać ryzyko błędów I i II rodzaju (Credé i in., 2012). Jeśli osobowość jest główną zmienną w Twojej pracy, wybierz pełną wersję.
Jak policzyć wynik BFI-2 krok po kroku
Krok 1. Sprawdź zakres odpowiedzi
W danych mogą być tylko wartości 1–5 albo braki. Formularze online często zapisują odpowiedzi jako 0–4 albo jako tekst, więc najpierw je przekoduj (zob. dane z Google Forms i LimeSurvey).
Krok 2. Odwróć pozycje z kluczem „−”
Przy skali 1–5 nowa wartość to 6 − odpowiedź: 1 staje się 5, 2 staje się 4, a 3 zostaje 3. Odwrócone wartości zapisz w nowych kolumnach i zostaw surowe dane bez zmian. Odpowiedzi środkowe liczy się normalnie. Autor BFI zwraca uwagę, że przy niektórych pozycjach odwróconych odpowiedź 3 jest wręcz informacyjna (Berkeley Personality Lab, b.d.).
Krok 3. Policz średnie aspektów i domen
Wynik aspektu to średnia jego czterech pozycji. Tak liczyli go m.in. Yoshino i in. (2022). Wynik domeny to średnia 12 pozycji, a przy kompletnych danych jest to ta sama liczba, co średnia trzech aspektów. Oba wyniki mieszczą się w zakresie 1–5, tak jak skala odpowiedzi. Średnią z pozycji zaleca też instrukcja dotycząca braków na stronie autorów. Dlaczego średnia jest tu wygodniejsza od sumy, wyjaśnia hasło wynik skali: średnia czy suma. Pojedyncze wyniki sprawdzisz w kalkulatorze wyniku skali.
Krok 4. Zaplanuj postępowanie z brakami
Na stronie autorów jest praktyczna rada. Przy kilku brakach (sześciu lub mniej) można wziąć odpowiedź na pozycję najbardziej podobną treściowo albo policzyć wynik skali jako średnią z pozostałych pozycji. Przy wielu brakach lepiej nie liczyć wyniku tej osoby (Berkeley Personality Lab, b.d.). Zapisz regułę przed analizą i podaj w pracy, ilu osób dotyczyła. Szerzej o tym we wpisie braki danych w ankiecie.
Interpretacja: brak norm i progów
BFI-2 nie ma oficjalnego podręcznika z normami ani punktów odcięcia. Strona autorów odsyła do pracy, która podaje średnie dorosłych Amerykanów w wieku 20–60 lat w metryce POMP, osobno dla płci i wieku (Berkeley Personality Lab, b.d.). Badanie to Srivastava i in. (2003) przeprowadzili na ponad 132 tysiącach osób. Wynikało z niego, że sumienność i ugodowość rosną przez wczesną i średnią dorosłość, a neurotyczność maleje u kobiet. To dane z innego kraju, zebrane przed powstaniem BFI-2, więc nie traktuj ich jak norm dla polskiej próby.
W pracy dyplomowej opisuj wyniki ciągłe: średnią, odchylenie standardowe i rozkład. Jeśli chcesz pokazać, gdzie na skali leży średnia, przelicz ją na POMP, czyli procent maksymalnego możliwego wyniku. Cohen i in. (1999) pokazali, że taki zapis często daje użyteczną informację:
POMP równy 65 oznacza, że średnia leży w 65% drogi między minimum a maksimum skali. Nie oznacza, że ktoś jest „bardziej ugodowy niż 65% ludzi”: do tego potrzebne byłyby normy. Jeśli promotor prosi o grupy „niskie – przeciętne – wysokie”, przeczytaj najpierw wpis niski, przeciętny, wysoki wynik.
Przykład: BFI-2 u 400 osób studiujących
Wyobraź sobie badanie 400 osób studiujących. Dane są symulowane i możesz je pobrać jako plik CSV (kolumny id i b1–b60, odpowiedzi 1–5 przed odwróceniem). Przypisanie numerów pozycji do aspektów i kierunek klucza w tym pliku są fikcyjne. Zachowują tylko proporcje BFI-2: 12 pozycji na domenę, 4 na aspekt i po połowie z każdym kluczem. Trzy osoby pominęły po jednej pozycji, więc ich wynik policzyliśmy jako średnią z pozostałych pozycji.
| Domena | M | SD | Min–maks | POMP | α [95% CI] | ω |
|---|---|---|---|---|---|---|
| Ekstrawersja | 3.18 | 0.63 | 1.58–4.83 | 54.5 | .81 [.78, .83] | .85 |
| Ugodowość | 3.61 | 0.58 | 1.83–5.00 | 65.2 | .80 [.77, .83] | .85 |
| Sumienność | 3.33 | 0.64 | 1.42–4.75 | 58.2 | .81 [.79, .84] | .85 |
| Negatywna emocjonalność | 3.01 | 0.65 | 1.25–4.67 | 50.3 | .82 [.79, .84] | .85 |
| Otwartość umysłu | 3.56 | 0.62 | 1.83–5.00 | 63.9 | .82 [.79, .85] | .86 |
Rozkłady wszystkich domen są zbliżone do symetrycznych: skośność mieści się między −0.25 a −0.04. Najwyższą średnią ma ugodowość (POMP = 65.2), a najniższą negatywna emocjonalność (POMP = 50.3). Takie porównanie domen w jednej próbie jest tylko opisem. Domeny mierzą różne cechy, więc wyższa średnia ugodowości nie znaczy, że badani są „bardziej ugodowi niż ekstrawertyczni”.
Rzetelność domen i aspektów
Alfa Cronbacha domen wyniosła od .80 do .82, a omega całkowita z modelu z czynnikiem ogólnym i trzema aspektami – od .85 do .86. Omega jest tu wyższa od alfy, bo pozycje domeny nie mierzą jednego jednolitego czynnika, tylko trzy powiązane aspekty. Flora (2020) pokazuje, jak dobrać odmianę omegi do takiej struktury. Aspekty, mierzone czterema pozycjami, miały wyraźnie niższą rzetelność: od .51 (Respectfulness, Responsibility) do .72 (Productiveness). Jedenaście z 15 aspektów miało alfę poniżej .70 (rysunek 1).
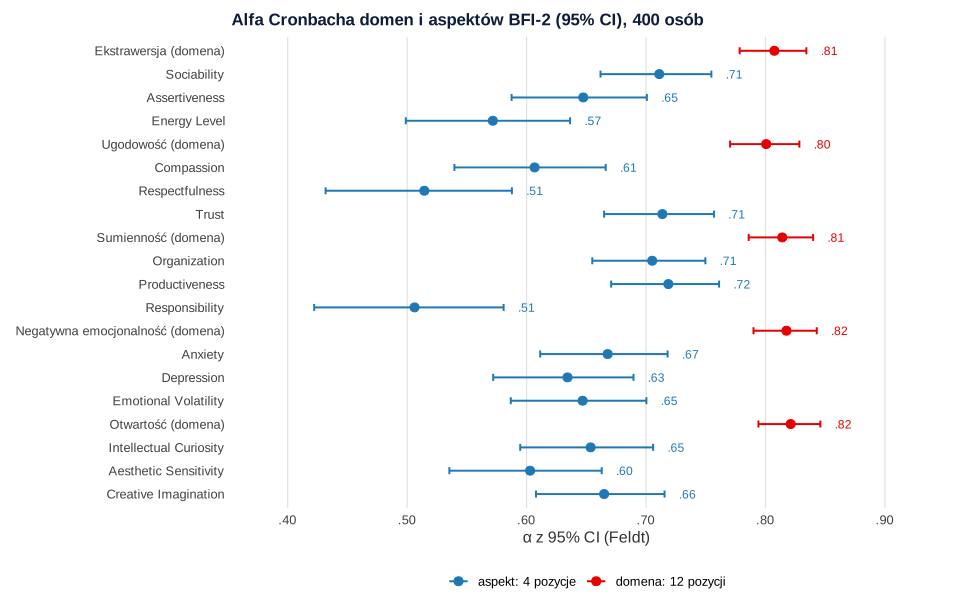
Podobny wzór widać w prawdziwych danych. W japońskiej adaptacji alfa i omega domen wynosiły około .80 lub więcej, a niektóre aspekty miały wartości poniżej .60 (Yoshino i in., 2022). Jeśli Twoja hipoteza dotyczy domen, analizuj domeny. Aspekty mają sens, gdy pytanie badawcze naprawdę ich dotyczy i gdy próba jest duża. Gotowe zdania o rzetelności znajdziesz we wzorze raportowania alfy Cronbacha, a tabelę – w haśle tabela rzetelności skal w APA.
Korelacje między domenami
Domeny korelowały słabo, od r = .04 do |r| = .31. Najsilniejszy był ujemny związek ekstrawersji z negatywną emocjonalnością, r(398) = −.31, 95% CI [−.39, −.22], p < .001. Pełną macierz przedstaw według wzoru z hasła tabela korelacji w APA.
Po co zrównoważony klucz: tendencja do zgadzania się
Niektórzy badani zgadzają się z większością twierdzeń niezależnie od ich treści. Gdy wszystkie pozycje skali mają ten sam kierunek, ta skłonność dodaje się do wyniku każdej domeny. Wtedy domeny korelują ze sobą silniej, niż powinny. W BFI-2 połowa pozycji każdej skali ma klucz odwrócony, więc po odwróceniu wpływ zgadzania się w dużej mierze się znosi.
W przykładzie policzyliśmy korelacje domen dwa razy: z pełnego klucza i tylko z sześciu pozycji „+” każdej domeny. Przy samych pozycjach „+” korelacje były średnio o 0.19 wyższe od korelacji cech zapisanych w symulacji. Przy pełnym kluczu różnica wyniosła średnio −0.02 (rysunek 2). Ujemny związek ekstrawersji z negatywną emocjonalnością prawie znikał (r = −.02 zamiast −.31).
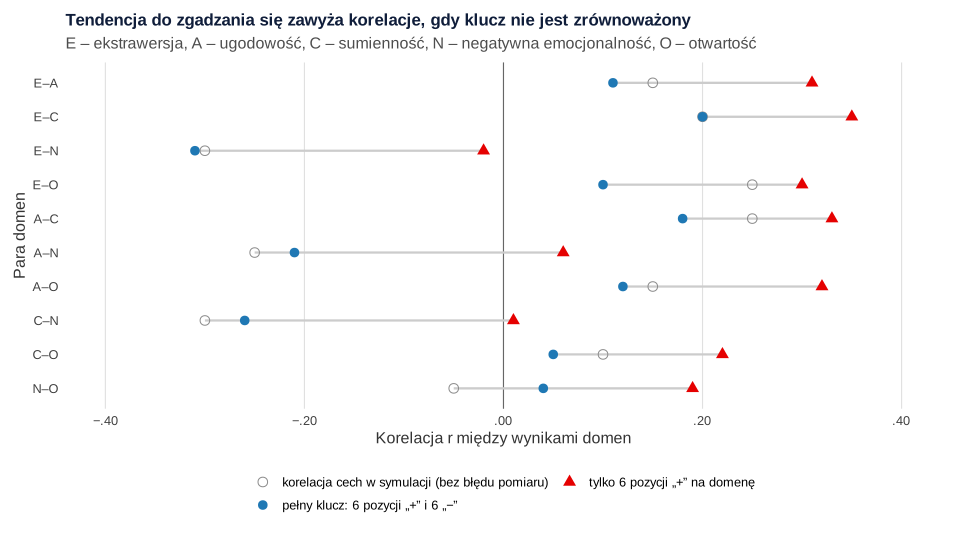
Zrównoważony klucz pozwala też oszacować samą tendencję: to średnia wszystkich 60 surowych odpowiedzi, przed odwróceniem. W przykładzie korelowała z wartością zapisaną w symulacji na poziomie r = .96. W analizach struktury badacze BFI-2 centrują odpowiedzi każdej osoby wokół jej średniej, żeby kontrolować ten styl (Yoshino i in., 2022). Ta technika to ipsatyzacja. W pracy licencjackiej czy magisterskiej zwykle wystarczy zwykły wynik domeny, ale warto wiedzieć, skąd bierze się przewaga zrównoważonego klucza. Pokrewne zjawiska opisuje hasło style odpowiedzi skrajnych i środkowych.
Jak opisać BFI-2 w pracy
Ogólny schemat opisu kwestionariusza znajdziesz we wpisie opis narzędzia badawczego – wzór.
Polska wersja BFI-2
Na stronie laboratorium w Berkeley jest lista przekładów formularza, w tym wersja polska (Berkeley Personality Lab, b.d.). Polską wersję BFI-2 przygotowano też w pilotażach międzynarodowego badania kompetencji dorosłych PIAAC. Tłumaczono ją centralnie, według tych samych procedur, co wersje francuską, niemiecką, hiszpańską i japońską. Rzetelność, struktura, trafność i inwariancja pomiaru były wysoce porównywalne z oryginałem (Rammstedt i in., 2026). Normy i właściwości polskiej wersji bierz wyłącznie z publikacji jej adaptacji. Własne tłumaczenie to jeszcze nie właściwa adaptacja. Jak szukać narzędzi z publikacją walidacyjną, opisuje poradnik gdzie znaleźć kwestionariusze psychologiczne.
BFI-2 w R: wyniki, rzetelność i tendencja do zgadzania się
Kod odtwarza wszystkie liczby z tekstu i rysunków, a na początku zapisuje plik CSV z danymi do pobrania. Klucz to ramka danych z kolumnami poz, domena, aspekt i znak. W przykładzie jest fikcyjny, więc na własnych danych wpisz w nim klucz od autorów. Odwracanie to 6 - x, a wyniki to średnie z pozycji. Alfę z przedziałem Feldta i omegę całkowitą liczy pakiet psych.
Wyniki BFI-2 krok po kroku
R
# B131 – BFI-2: wyniki pięciu domen i 15 aspektów, rzetelność, POMP, tendencja do zgadzania się (dane symulowane, set.seed(13125)).
# 400 osób studiujących; odpowiedzi 1–5 (od "zdecydowanie się nie zgadzam" do "zdecydowanie się zgadzam") na 60 pozycji b1–b60.
# Struktura (Soto i John, 2017; Yoshino i in., 2022): domena = 12 pozycji, aspekt = 4 pozycje, w każdym aspekcie 2 pozycje
# z kluczem prostym i 2 z kluczem odwróconym; wynik = średnia pozycji (1–5).
# UWAGA: przypisanie numerów pozycji do aspektów i kierunku klucza poniżej jest FIKCYJNE (ilustracja).
# Prawdziwy klucz pobierz ze strony autorów i wpisz go w ramce `klucz`.
suppressPackageStartupMessages({ library(MASS); library(psych); library(GPArotation) })
set.seed(13125)
n <- 400
dom <- c(E = "Ekstrawersja", A = "Ugodowość", C = "Sumienność", N = "Negatywna emocjonalność", O = "Otwartość")
asp <- list(E = c("Sociability", "Assertiveness", "Energy Level"), A = c("Compassion", "Respectfulness", "Trust"),
            C = c("Organization", "Productiveness", "Responsibility"), N = c("Anxiety", "Depression", "Emotional Volatility"),
            O = c("Intellectual Curiosity", "Aesthetic Sensitivity", "Creative Imagination"))
klucz <- data.frame(poz = paste0("b", 1:60), domena = rep(names(dom), 12))
klucz$k <- ave(seq_len(60), klucz$domena, FUN = seq_along)                 # która to pozycja danej domeny (1–12)
klucz$aspekt <- mapply(function(d, k) asp[[d]][(k - 1) %% 3 + 1], klucz$domena, klucz$k)
klucz$znak <- ifelse(ave(seq_len(60), klucz$aspekt, FUN = seq_along) %in% c(1, 4), "+", "-")
table(klucz$domena, klucz$znak); all(table(klucz$aspekt) == 4)

# Symulacja: domeny skorelowane, aspekty zagnieżdżone w domenach, do tego tendencja do zgadzania się (dodaje się do każdej odpowiedzi)
R5 <- matrix(c(1, .15, .20, -.30, .25,  .15, 1, .25, -.25, .15,  .20, .25, 1, -.30, .10,
               -.30, -.25, -.30, 1, -.05,  .25, .15, .10, -.05, 1), 5, dimnames = list(names(dom), names(dom)))
D <- mvrnorm(n, rep(0, 5), R5)
A_i <- rnorm(n, 0, 0.35)                                                     # tendencja do zgadzania się
Fa <- sapply(unname(unlist(asp)), function(a) { d <- names(asp)[sapply(asp, function(x) a %in% x)]; sqrt(.7) * D[, d] + sqrt(.3) * rnorm(n) })
progi <- c(-1.6, -0.6, 0.25, 1.15)
przes <- c(E = 0.15, A = 0.55, C = 0.35, N = 0.05, O = 0.55)                # przesunięcie średnich domen
odp <- sapply(1:60, function(j) {
  s <- ifelse(klucz$znak[j] == "+", 1, -1); lam <- runif(1, .55, .75)
  findInterval(s * (lam * Fa[, klucz$aspekt[j]] + przes[[klucz$domena[j]]]) + A_i + rnorm(n, 0, sqrt(1 - lam^2)) + 0.1, progi) + 1
})
colnames(odp) <- klucz$poz
dane <- data.frame(id = 1:n, odp)
dane$b17[c(12, 205)] <- NA; dane$b44[88] <- NA                               # trzy pojedyncze braki
write.csv(dane, "../bfi-2-dane-przyklad.csv", row.names = FALSE)

# Krok 1. Kontrola zakresu
all(sapply(dane[, -1], function(x) all(x %in% c(1:5, NA)))); sum(is.na(dane[, -1]))

# Krok 2. Odwrócenie pozycji z kluczem "-": 6 − odpowiedź
bfi <- dane[, klucz$poz]
ujemne <- klucz$poz[klucz$znak == "-"]
bfi[, ujemne] <- 6 - bfi[, ujemne]

# Krok 3. Wyniki: średnia z dostępnych pozycji (aspekt 1–5, domena 1–5)
wynik_dom <- sapply(names(dom), function(d) rowMeans(bfi[, klucz$poz[klucz$domena == d]], na.rm = TRUE))
wynik_asp <- sapply(unname(unlist(asp)), function(a) rowMeans(bfi[, klucz$poz[klucz$aspekt == a]], na.rm = TRUE))
pomp <- (wynik_dom - 1) / (5 - 1) * 100                                      # POMP: % maksymalnego wyniku
opis <- t(sapply(names(dom), function(d) c(M = mean(wynik_dom[, d]), SD = sd(wynik_dom[, d]), min = min(wynik_dom[, d]),
                                          max = max(wynik_dom[, d]), POMP = mean(pomp[, d]), skosnosc = psych::skew(wynik_dom[, d]))))
round(opis, 2)
# Domena = średnia trzech aspektów (przy kompletnych danych to ta sama liczba)
all.equal(unname(rowMeans(wynik_asp[, asp$E])), unname(wynik_dom[, "E"]))

# Krok 4. Rzetelność: domeny (12 pozycji) i aspekty (4 pozycje)
rz_dom <- t(sapply(names(dom), function(d) {
  p <- na.omit(bfi[, klucz$poz[klucz$domena == d]])
  a <- psych::alpha(p, warnings = FALSE)
  om <- suppressWarnings(psych::omega(p, nfactors = 3, plot = FALSE))     # omega całkowita (model z czynnikiem ogólnym i trzema aspektami)
  c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]],
    omega_t = om$omega.tot, r_sr = a$total$average_r)
}))
round(rz_dom, 2)
rz_asp <- t(sapply(unname(unlist(asp)), function(a) {
  al <- psych::alpha(na.omit(bfi[, klucz$poz[klucz$aspekt == a]]), warnings = FALSE)
  c(alfa = al$total$raw_alpha, lo = al$feldt$lower.ci[[1]], hi = al$feldt$upper.ci[[1]])
}))
round(rz_asp, 2)
round(range(rz_asp[, "alfa"]), 2); sum(rz_asp[, "alfa"] < .70)

# Krok 5. Korelacje domen
round(cor(wynik_dom), 2)
t_en <- cor.test(wynik_dom[, "E"], wynik_dom[, "N"])
round(c(r = unname(t_en$estimate), lo = t_en$conf.int[1], hi = t_en$conf.int[2], df = unname(t_en$parameter)), 3); signif(t_en$p.value, 3)

# Krok 6. Tendencja do zgadzania się: średnia 60 SUROWYCH odpowiedzi (przed odwróceniem). Przy zrównoważonym kluczu
# treść się znosi, a zostaje skłonność do zgadzania się.
akw <- rowMeans(dane[, klucz$poz], na.rm = TRUE)
round(c(M = mean(akw), SD = sd(akw), r_z_prawdziwa = cor(akw, A_i)), 2)
# Co by było, gdyby skala miała tylko pozycje z kluczem prostym? Korelacje domen z samych pozycji "+" vs. pełny klucz
tylko_plus <- sapply(names(dom), function(d) rowMeans(bfi[, klucz$poz[klucz$domena == d & klucz$znak == "+"]], na.rm = TRUE))
pary <- t(combn(names(dom), 2))
por <- data.frame(para = paste(pary[, 1], pary[, 2], sep = "–"),
                  r_pelny = apply(pary, 1, function(p) cor(wynik_dom[, p[1]], wynik_dom[, p[2]])),
                  r_plus = apply(pary, 1, function(p) cor(tylko_plus[, p[1]], tylko_plus[, p[2]])),
                  r_prawdziwa = apply(pary, 1, function(p) R5[p[1], p[2]]))
por[, -1] <- round(por[, -1], 2); por
round(c(sr_roznica_plus = mean(por$r_plus - por$r_prawdziwa), sr_roznica_pelny = mean(por$r_pelny - por$r_prawdziwa)), 2)

# Wartości w zapisie do tekstu
bz <- function(v) sub("^(-?)0\\.", "\\1.", formatC(v, format = "f", digits = 2))
noquote(apply(rz_dom[, c("alfa", "lo", "hi", "omega_t")], 2, bz))
Wynik w R
    - +
  A 6 6
  C 6 6
  E 6 6
  N 6 6
  O 6 6
[1] TRUE
[1] TRUE
[1] 3
     M   SD  min  max  POMP skosnosc
E 3.18 0.63 1.58 4.83 54.52    -0.04
A 3.61 0.58 1.83 5.00 65.18    -0.22
C 3.33 0.64 1.42 4.75 58.15    -0.25
N 3.01 0.65 1.25 4.67 50.32    -0.12
O 3.56 0.62 1.83 5.00 63.91    -0.14
[1] TRUE
  alfa   lo   hi omega_t r_sr
E 0.81 0.78 0.83    0.85 0.26
A 0.80 0.77 0.83    0.85 0.25
C 0.81 0.79 0.84    0.85 0.27
N 0.82 0.79 0.84    0.85 0.27
O 0.82 0.79 0.85    0.86 0.28
                       alfa   lo   hi
Sociability            0.71 0.66 0.75
Assertiveness          0.65 0.59 0.70
Energy Level           0.57 0.50 0.64
Compassion             0.61 0.54 0.67
Respectfulness         0.51 0.43 0.59
Trust                  0.71 0.66 0.76
Organization           0.71 0.65 0.75
Productiveness         0.72 0.67 0.76
Responsibility         0.51 0.42 0.58
Anxiety                0.67 0.61 0.72
Depression             0.63 0.57 0.69
Emotional Volatility   0.65 0.59 0.70
Intellectual Curiosity 0.65 0.59 0.71
Aesthetic Sensitivity  0.60 0.54 0.66
Creative Imagination   0.66 0.61 0.72
[1] 0.51 0.72
[1] 11
      E     A     C     N    O
E  1.00  0.11  0.20 -0.31 0.10
A  0.11  1.00  0.18 -0.21 0.12
C  0.20  0.18  1.00 -0.26 0.05
N -0.31 -0.21 -0.26  1.00 0.04
O  0.10  0.12  0.05  0.04 1.00
      r      lo      hi      df
 -0.307  -0.394  -0.216 398.000
[1] 3.35e-10
            M            SD r_z_prawdziwa
         3.29          0.36          0.96
   para r_pelny r_plus r_prawdziwa
1   E–A    0.11   0.31        0.15
2   E–C    0.20   0.35        0.20
3   E–N   -0.31  -0.02       -0.30
4   E–O    0.10   0.30        0.25
5   A–C    0.18   0.33        0.25
6   A–N   -0.21   0.06       -0.25
7   A–O    0.12   0.32        0.15
8   C–N   -0.26   0.01       -0.30
9   C–O    0.05   0.22        0.10
10  N–O    0.04   0.19       -0.05
 sr_roznica_plus sr_roznica_pelny
            0.19            -0.02
  alfa lo  hi  omega_t
E .81  .78 .83 .85
A .80  .77 .83 .85
C .81  .79 .84 .85
N .82  .79 .84 .85
O .82  .79 .85 .86
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3.1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy liczeniu BFI-2
- Klucz z innego narzędzia. BFI-44, BFI-2-S i BFI-2-XS mają inne pozycje i inną kolejność niż pełny BFI-2. Klucz bierz z wersji, którą badałeś.
- Brak odwrócenia połowy pozycji. Przy zrównoważonym kluczu pozycje „+” i „−” znoszą się wtedy nawzajem i wynik domeny traci sens.
- Jeden „wynik ogólny osobowości”. BFI-2 mierzy pięć odrębnych domen. Średnia ze wszystkich 60 pozycji nie jest miarą żadnej cechy.
- Analiza 15 aspektów w małej próbie. Skale czteropozycyjne mają niską rzetelność (rysunek 1), a 15 testów zwiększa ryzyko fałszywych odkryć (zob. poprawki na wielokrotne porównania).
- Pomylenie kierunku negatywnej emocjonalności. Wyższy wynik oznacza więcej negatywnych emocji, a nie większą stabilność.
- Typy osobowości z progów. Narzędzie nie ma punktów odcięcia, więc licz korelacje i regresje na wynikach ciągłych.
Jeśli chcesz sprawdzić, czy dobrze policzyłeś wyniki BFI-2 i jak je opisać, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć wynik BFI-2?
Odwróć pozycje z kluczem odwróconym według klucza autorów (przy skali 1–5: 6 − odpowiedź), a potem policz średnią 12 pozycji każdej domeny i średnią 4 pozycji każdego aspektu. Wszystkie wyniki mieszczą się w zakresie 1–5.
Ile pozycji odwróconych ma BFI-2?
Połowę: w każdej domenie 6 z 12, a w każdym aspekcie 2 z 4 (Yoshino i in., 2022). Numery tych pozycji podaje klucz, który autorzy udostępniają razem z formularzem na stronie laboratorium.
Czy BFI-2 jest darmowy do pracy magisterskiej?
Według strony laboratorium osobowości w Berkeley BFI-2 jest bezpłatny do niekomercyjnych badań naukowych, choć nie jest w domenie publicznej. Formularz i instrukcję punktacji pobiera się po wypełnieniu krótkiej ankiety. Do użycia komercyjnego potrzebna jest zgoda autorów.
Czy BFI-2 ma normy?
Nie ma oficjalnego podręcznika z normami ani punktów odcięcia (Berkeley Personality Lab, b.d.). Opisuj średnie i odchylenia standardowe z własnej próby, a położenie średniej na skali możesz pokazać jako POMP.
Czy w pracy analizować domeny, czy aspekty BFI-2?
Zwykle domeny. Aspekty mają tylko po cztery pozycje i niższą rzetelność, a 15 dodatkowych testów zwiększa ryzyko fałszywych wyników. Sięgaj po aspekty, gdy hipoteza ich dotyczy i próba jest duża.
Powiązane hasła
Przeczytaj też
Mini-IPIP i IPIP – jak policzyć wyniki
Odpowiedzi 1–5, pozycje „+” i „−”, suma 4–20, klucz IPIP-50, rzetelność krótkich skal i opis wyników bez progów – z przykładem w R.
Czytaj →PoradnikJak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikGrit-S – jak policzyć wynik
8 pozycji 1–5, odwracanie spójności zainteresowań, średnia i dwie podskale, rzetelność, CFA i opis wyników bez progów – z przykładem w R.
Czytaj →Liczysz wyniki BFI-2 i nie masz pewności, czy klucz jest dobrze wpisany?
Sprawdzimy odwracanie pozycji, wyniki domen i aspektów oraz ich rzetelność i wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Berkeley Personality Lab. (b.d.). Big Five Inventory (BFI-2). University of California, Berkeley. Pobrano 26 października 2026 z https://ocf.berkeley.edu/~johnlab/bfi.html ● Otwarty dostęp
- Cohen, P., Cohen, J., Aiken, L. S., & West, S. G. (1999). The problem of units and the circumstance for POMP. Multivariate Behavioral Research, 34(3), 315–346. https://doi.org/10.1207/s15327906mbr3403_2
- Credé, M., Harms, P., Niehorster, S., & Gaye-Valentine, A. (2012). An evaluation of the consequences of using short measures of the Big Five personality traits. Journal of Personality and Social Psychology, 102(4), 874–888. https://doi.org/10.1037/a0027403
- Flora, D. B. (2020). Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates. Advances in Methods and Practices in Psychological Science, 3(4), 484–501. https://doi.org/10.1177/2515245920951747 ● Otwarty dostęp
- Rammstedt, B., Danner, D., Soto, C. J., & John, O. P. (2020). Validation of the short and extra-short forms of the Big Five Inventory-2 (BFI-2) and their German adaptations. European Journal of Psychological Assessment, 36(1), 149–161. https://doi.org/10.1027/1015-5759/a000481
- Rammstedt, B., Roemer, L., Lechner, C. M., & Soto, C. J. (2026). Adapting the BFI-2 around the world – Coordinated translation and validation in five languages and cultural contexts. European Journal of Psychological Assessment, 42(2), 99–111. https://doi.org/10.1027/1015-5759/a000844 ● Otwarty dostęp
- Soto, C. J., & John, O. P. (2017). The next Big Five Inventory (BFI-2): Developing and assessing a hierarchical model with 15 facets to enhance bandwidth, fidelity, and predictive power. Journal of Personality and Social Psychology, 113(1), 117–143. https://doi.org/10.1037/pspp0000096 ● Otwarty dostęp: pełny tekst
- Srivastava, S., John, O. P., Gosling, S. D., & Potter, J. (2003). Development of personality in early and middle adulthood: Set like plaster or persistent change? Journal of Personality and Social Psychology, 84(5), 1041–1053. https://doi.org/10.1037/0022-3514.84.5.1041
- Yoshino, S., Shimotsukasa, T., Oshio, A., Hashimoto, Y., Ueno, Y., Mieda, T., Migiwa, I., Sato, T., Kawamoto, S., Soto, C. J., & John, O. P. (2022). A validation of the Japanese adaptation of the Big Five Inventory-2. Frontiers in Psychology, 13, Article 924351. https://doi.org/10.3389/fpsyg.2022.924351 ● Otwarty dostęp
Cytowania BibTeX
@misc{berkeleybfi2nd, author={{Berkeley Personality Lab}}, title={{Big Five Inventory (BFI-2)}}, publisher={University of California, Berkeley}, url={https://ocf.berkeley.edu/~johnlab/bfi.html}}@article{cohen1999problem, author={Cohen, Patricia and Cohen, Jacob and Aiken, Leona S. and West, Stephen G.}, title={{The problem of units and the circumstance for POMP}}, journal={Multivariate Behavioral Research}, year={1999}, volume={34}, number={3}, pages={315--346}, doi={10.1207/s15327906mbr3403_2}}@article{crede2012evaluation, author={Credé, Marcus and Harms, Peter and Niehorster, Sarah and Gaye-Valentine, Andrea}, title={{An evaluation of the consequences of using short measures of the Big Five personality traits}}, journal={Journal of Personality and Social Psychology}, year={2012}, volume={102}, number={4}, pages={874--888}, doi={10.1037/a0027403}}@article{flora2020your, author={Flora, David B.}, title={{Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={484--501}, doi={10.1177/2515245920951747}}@article{rammstedt2020validation, author={Rammstedt, Beatrice and Danner, Daniel and Soto, Christopher J. and John, Oliver P.}, title={{Validation of the short and extra-short forms of the Big Five Inventory-2 (BFI-2) and their German adaptations}}, journal={European Journal of Psychological Assessment}, year={2020}, volume={36}, number={1}, pages={149--161}, doi={10.1027/1015-5759/a000481}}@article{rammstedt2026adapting, author={Rammstedt, Beatrice and Roemer, Lena and Lechner, Clemens M. and Soto, Christopher J.}, title={{Adapting the BFI-2 around the world – Coordinated translation and validation in five languages and cultural contexts}}, journal={European Journal of Psychological Assessment}, year={2026}, volume={42}, number={2}, pages={99--111}, doi={10.1027/1015-5759/a000844}}@article{soto2017next, author={Soto, Christopher J. and John, Oliver P.}, title={{The next Big Five Inventory (BFI-2): Developing and assessing a hierarchical model with 15 facets to enhance bandwidth, fidelity, and predictive power}}, journal={Journal of Personality and Social Psychology}, year={2017}, volume={113}, number={1}, pages={117--143}, doi={10.1037/pspp0000096}}@article{srivastava2003development, author={Srivastava, Sanjay and John, Oliver P. and Gosling, Samuel D. and Potter, Jeff}, title={{Development of personality in early and middle adulthood: Set like plaster or persistent change?}}, journal={Journal of Personality and Social Psychology}, year={2003}, volume={84}, number={5}, pages={1041--1053}, doi={10.1037/0022-3514.84.5.1041}}@article{yoshino2022validation, author={Yoshino, Shinya and Shimotsukasa, Tadahiro and Oshio, Atsushi and Hashimoto, Yasuhiro and Ueno, Yuki and Mieda, Takahiro and Migiwa, Ifu and Sato, Tatsuya and Kawamoto, Shizuka and Soto, Christopher J. and John, Oliver P.}, title={{A validation of the Japanese adaptation of the Big Five Inventory-2}}, journal={Frontiers in Psychology}, year={2022}, volume={13}, eid={924351}, doi={10.3389/fpsyg.2022.924351}}