Kim był Zbigniew Pawłowski?
Zbigniew Maria Pawłowski urodził się 22 listopada 1930 r. we Lwowie. Po kilku latach rodzina przeniosła się do Poznania. W 1946 r. Pawłowski z rodzicami zamieszkał w Warszawie, gdzie w 1949 r. zdał maturę i zaczął studia w Szkole Głównej Planowania i Statystyki (SGPiS, dziś SGH). Od 1950 r. był tam asystentem w Katedrze Statystyki (Wywiał, 2018, 2020).
Doktorat obronił w 1957 r. Rozprawa dotyczyła sprawdzania pewnych klas hipotez złożonych testem sekwencyjnym w statystycznej kontroli jakości (zob. spory niżej). W latach 1957–1958 jako stypendysta Fundacji Forda pracował w Instytucie Statystyki Uniwersytetu w Uppsali pod kierunkiem Hermana Wolda, a w roku akademickim 1960/61 – w Department of Applied Economics w Cambridge u Richarda Stone’a, późniejszego noblisty. Tam uczestniczył w budowie pierwszego modelu ekonometrycznego gospodarki brytyjskiej. W 1962 r. habilitował się w SGPiS, m.in. na podstawie książki o ekonometrycznych metodach badania popytu konsumpcyjnego. Tytuł profesora nadzwyczajnego otrzymał w 1967 r., a zwyczajnego w 1972 r. (Wywiał, 2018, 2020).
Od 1962 r. pracował w Wyższej Szkole Ekonomicznej w Katowicach (dziś Uniwersytet Ekonomiczny): kierował Katedrą Statystyki, a od 1974 r. Instytutem Ekonometrii; w latach 1968–1974 był prorektorem. Zmarł 4 sierpnia 1981 r. w Katowicach, w wieku 50 lat; pochowano go na Powązkach w Warszawie (Wywiał, 2018, 2020).
Najważniejsze pomysły
Pawłowski opublikował około 200 prac, w tym 149 naukowych, 9 monografii i 4 podręczniki. Środowisko uważa go za jednego z pionierów ekonometrii w Polsce, a Zdzisław Hellwig nazwał go najbardziej konsekwentnym uczniem Oskara Langego (Wywiał, 2020).
- Podręczniki. Wstęp do statystyki matematycznej z 1965 r. ukazał się ze słowem wstępnym Langego i doczekał się przekładów na rosyjski i niemiecki. Ekonometria miała wiele wydań i przekład węgierski; do tego Statystyka matematyczna (1976) i podręcznik metody reprezentacyjnej (1972) (Pawłowski, 1965; Wywiał, 2020).
- Modele gospodarki. Kierował zespołem, który zbudował jeden z pierwszych modeli ekonometrycznych gospodarki polskiej (praca zbiorowa z 1968 r.) (Wywiał, 2018).
- Teoria prognozy. W Prognozach ekonometrycznych z 1973 r. i kolejnych książkach rozwijał m.in. prognozy optymistyczne i pesymistyczne (zależne od korzystnego albo niekorzystnego układu zmiennych objaśniających), giętkość predyktora, prognozy alternatywne i predykcję punktów zwrotnych za pomocą kart kontrolnych. Szczególnie cenił analizę ex post błędów prognoz – jako podstawę wyboru metody na kolejne okresy (Pawłowski, 1973; Wywiał, 2018).
- Testy. Zaproponował nieparametryczny test autokorelacji w szeregu czasowym (1973–1974) oraz test normalności oparty na twierdzeniu Geary’ego o niezależności średniej i wariancji z próby normalnej; moc tego testu ocenił analitycznie, a nie symulacyjnie (Wywiał, 2018).
Ciekawostka
W czasie wojny znalazł się z matką najpierw w Rumunii, a potem w Algierze, gdzie chodził do gimnazjum – najpierw polskiego, później francuskiego. Do kraju wrócił z rodzicami dopiero w 1946 r. (Wywiał, 2018).
Wywiał (2020) opisuje go jako poliglotę, który mówił po francusku, angielsku, rosyjsku i niemiecku, a wolny czas spędzał przy brydżu i szachach, na wędrówkach i przy muzyce klasycznej. Na zlecenie ONZ prowadził też cykl wykładów w instytucie statystyki w Rabacie.
Przykład: błędy ex post trzech prognoz
Pokazujemy pomysł, który Pawłowski cenił: prognozę z modelu oceniamy, gdy znamy już rzeczywiste wartości, i porównujemy z prostszymi metodami. Dane to kwartalne przychody Freeny’ego z pakietu datasets (39 kwartałów, 1962 Q2 – 1971 Q4) z czterema zmiennymi objaśniającymi: przychodem z poprzedniego kwartału, indeksem cen, poziomem dochodu i potencjałem rynku. Model regresji wielorakiej szacujemy na 31 kwartałach do końca 1969 r., a prognozujemy osiem kwartałów 1970–1971. To prognozy warunkowe: podstawiamy rzeczywiste wartości zmiennych objaśniających.
W okresie estymacji model pasuje znakomicie (R² = .998, błąd standardowy reszt 0.0138). Przychód maleje z indeksem cen (b = −0.889, p < .001) i rośnie z dochodem (b = 0.632, p < .001). Mimo to model przeszacowuje przychód w każdym z ośmiu kwartałów: średni błąd (ME) wynosi −0.0294 w 1970 r. i −0.0223 w 1971 r. Rzeczywista wartość mieści się w 95% przedziale predykcji w 6 kwartałach na 8.
Miary błędu prognozy zmieniają ranking metod z roku na rok. W 1970 r. najmniejszy średni błąd bezwzględny miała prognoza naiwna (MAE = 0.0174), przed trendem liniowym (0.0237) i modelem (0.0294). W 1971 r. wygrał model (MAE = 0.0223), a trend wypadł najgorzej (0.0567; MAPE 0.58%). Wybór na podstawie błędów z 1970 r. wskazałby prognozę naiwną (MAE w 1971 r. = 0.0269). Można też przesunąć prognozy modelu na 1971 r. o średni błąd z 1970 r.: MAE spada wtedy z 0.0223 do 0.0099, a MAPE z 0.23% do 0.10%. To prosta ilustracja, nie procedura z prac Pawłowskiego.
Na rysunku
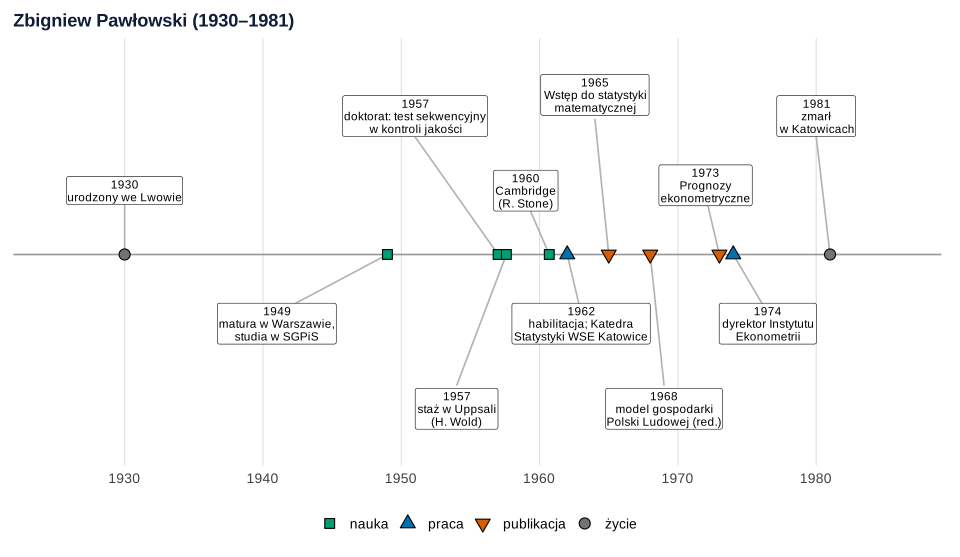
Co widać. Staże w Uppsali i Cambridge poprzedzają habilitację i przejście do Katowic; najważniejsze książki powstały w latach 1965–1973.
Na co uważać. Oś zawiera tylko daty z cytowanych źródeł. Etykiety są przesunięte – rok wskazuje znacznik na osi. Rok 1960 oznacza rok akademicki 1960/61.
Podpis do pracy:
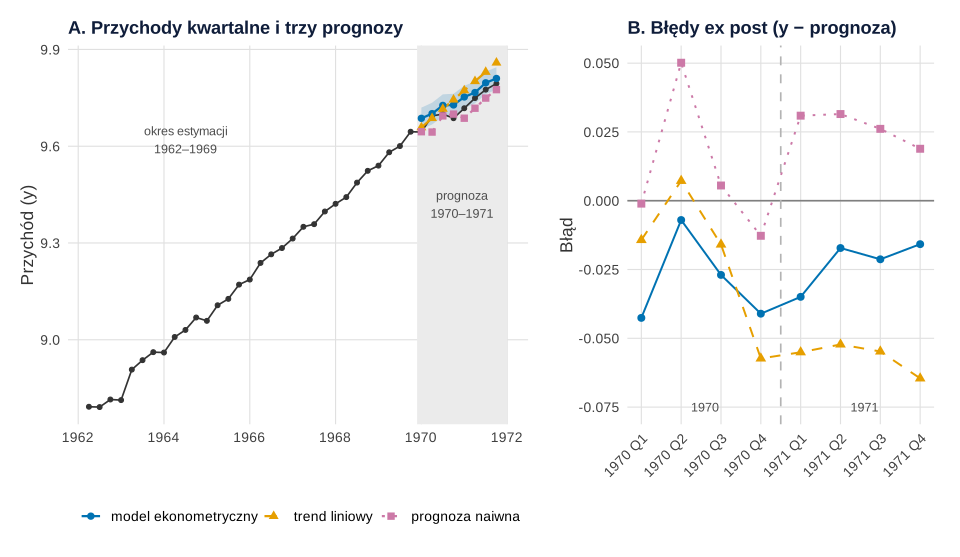
Co widać. W panelu A trzy prognozy wyglądają podobnie, ale panel B pokazuje różne błędy: model systematycznie przeszacowuje, trend coraz bardziej się rozjeżdża, a prognoza naiwna myli się w obie strony.
Na co uważać. Osiem kwartałów to za mało, by wybrać metodę. Model korzysta z rzeczywistych wartości zmiennych objaśniających; gdy trzeba je najpierw prognozować, błędy rosną. Skala w B jest rozciągnięta: największy błąd to około 0.5% przychodu.
Podpis do pracy:
Gdzie spotkasz Pawłowskiego w swojej pracy
- Ocena modelu prognostycznego. Dzieląc dane na część do estymacji i do sprawdzenia, robisz analizę ex post. Ta sama logika stoi za walidacją krzyżową i oceną prognoz sprzedaży.
- Przedział zamiast punktu. Prognozy optymistyczne i pesymistyczne to bliski krewny pasma predykcji: zamiast jednej liczby podajesz zakres możliwych wyników.
- Diagnostyka reszt. Gdy reszty modelu szeregu czasowego mogą być zależne, sprawdzasz autokorelację reszt.
- Badania sondażowe i kontrola jakości. Pawłowski napisał podręcznik metody reprezentacyjnej (zob. dobór losowy prosty), a doktorat poświęcił testom sekwencyjnym w kontroli jakości – zob. sekwencyjny test ilorazu wiarygodności.
Spory, mity i trudne strony
- Kontrowersyjna zasada predykcji. Pawłowski proponował, by w krótkim horyzoncie wyznaczać prognozę w pobliżu dominanty (wartości najbardziej prawdopodobnej) zmiennej prognozowanej. Wywiał (2018) zaznacza, że niektóre jego poglądy na podstawy teorii predykcji uważa się za kontrowersyjne.
- Wold czy Wald? Wywiał (2018, 2020) podaje tytuł doktoratu z „testem sekwencyjnym Wolda”. Sekwencyjny test ilorazu wiarygodności to jednak metoda Abrahama Walda, a Wold był opiekunem późniejszego stażu. Możliwe, że pomylono nazwiska; oryginału rozprawy nie sprawdziliśmy.
- Ile doktoratów? Biogram z 2018 r. podaje 14 wypromowanych doktorów, a artykuł z 2020 r. – 25 (Wywiał, 2018, 2020). Nie rozstrzygamy, która liczba jest pełna.
- Pierwsze wydanie „Ekonometrii”. Wywiał (2020) wymienia wydania z lat 1969–1980, a katalog Biblioteki Narodowej notuje wydanie pierwsze z 1966/67 r. i „wydanie 2 rozszerzone” z 1969 r.
Analiza ex post prognoz w R
Kod rysuje oś czasu, szacuje model regresji wielorakiej na danych Freeny’ego z lat 1962–1969, wyznacza prognozy z modelu, trendu liniowego i metody naiwnej na lata 1970–1971 oraz liczy ich błędy ex post. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
współczynniki modelu, miary błędów ex post w latach 1970 i 1971, liczba wartości w przedziałach predykcji i efekt poprawki o średni błąd.
Kod R rysunków 1 i 2
# Zbigniew Pawłowski: oś czasu i analiza ex post błędów prognoz z modelu ekonometrycznego
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73",
        fiolet = "#CC79A7", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Wywiała 2018 i 2020)
zdarzenia <- data.frame(
  rok = c(1930, 1949, 1957, 1957.6, 1960.7, 1962, 1965, 1968, 1973, 1974, 1981),
  opis = c("urodzony we Lwowie", "matura w Warszawie,\nstudia w SGPiS", "doktorat: test sekwencyjny\nw kontroli jakości",
           "staż w Uppsali\n(H. Wold)", "Cambridge\n(R. Stone)", "habilitacja; Katedra\nStatystyki WSE Katowice",
           "Wstęp do statystyki\nmatematycznej", "model gospodarki\nPolski Ludowej (red.)", "Prognozy\nekonometryczne",
           "dyrektor Instytutu\nEkonometrii", "zmarł\nw Katowicach"),
  rodzaj = c("życie", "nauka", "nauka", "nauka", "nauka", "praca", "publikacja", "publikacja", "publikacja",
             "praca", "życie"))
zdarzenia$y  <- c(1.2, -1.3, 2.6, -2.9, 1.2, -1.3, 3.0, -2.9, 1.3, -1.3, 2.6)       # wysokość etykiet
zdarzenia$xl <- c(1930, 1941, 1951, 1954, 1959, 1963, 1964, 1969, 1972, 1976.5, 1980) # położenie etykiet
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = xl, yend = y * 0.85), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(x = xl, y = y, label = paste0(floor(rok), "\n", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "nauka" = 22, "praca" = 24, "publikacja" = 25), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "nauka" = oi[["zielony"]], "praca" = oi[["niebieski"]],
                               "publikacja" = oi[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1930, 1980, 10), limits = c(1925, 1986)) + scale_y_continuous(limits = c(-3.6, 3.7)) +
  labs(title = "Zbigniew Pawłowski (1930–1981)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: kwartalne przychody i zmienne objaśniające (Freeny), 1962 Q2 – 1971 Q4
data(freeny, package = "datasets")
d <- data.frame(kwartal = as.numeric(time(freeny$y)), y = as.numeric(freeny$y), freeny[, -1])
d$t <- seq_len(nrow(d))
ucz  <- d[d$kwartal < 1970, ]    # okres estymacji: 1962 Q2 – 1969 Q4 (31 kwartałów)
test <- d[d$kwartal >= 1970, ]   # okres prognozy: 1970 Q1 – 1971 Q4 (8 kwartałów)
c(estymacja = nrow(ucz), prognoza = nrow(test))

# Model ekonometryczny: przychód zależy od przychodu z poprzedniego kwartału, ceny, dochodu i potencjału rynku
model <- lm(y ~ lag.quarterly.revenue + price.index + income.level + market.potential, data = ucz)
round(summary(model)$coefficients, 4)
round(c(s_e = summary(model)$sigma, R2 = summary(model)$r.squared), 4)

# Trzy predyktory: model ekonometryczny, trend liniowy, prognoza naiwna (wartość z poprzedniego kwartału)
trend <- lm(y ~ t, data = ucz)
pi95 <- predict(model, newdata = test, interval = "prediction", level = 0.95)
prognozy <- data.frame(kwartal = test$kwartal, y = test$y,
                       model = pi95[, "fit"], trend = predict(trend, newdata = test), naiwna = test$lag.quarterly.revenue)

# Błędy ex post (rzeczywistość minus prognoza) i ich miary w dwóch latach prognozy
miary <- function(e, y) c(ME = mean(e), MAE = mean(abs(e)), RMSE = sqrt(mean(e^2)), MAPE = 100 * mean(abs(e / y)))
metody <- c("model", "trend", "naiwna")
bledy_ex_post <- do.call(rbind, lapply(metody, function(m) {
  e <- prognozy$y - prognozy[[m]]; rok <- floor(prognozy$kwartal)
  rbind(data.frame(metoda = m, okres = "1970", t(miary(e[rok == 1970], prognozy$y[rok == 1970]))),
        data.frame(metoda = m, okres = "1971", t(miary(e[rok == 1971], prognozy$y[rok == 1971]))))
}))
bledy_ex_post[, 3:6] <- round(bledy_ex_post[, 3:6], 4)
bledy_ex_post

# Ile rzeczywistych wartości mieści się w 95% przedziałach predykcji modelu?
sum(test$y >= pi95[, "lwr"] & test$y <= pi95[, "upr"])

# Wykorzystanie informacji ex post: średni błąd modelu z 1970 r. jako poprawka prognoz na 1971 r.
poprawka <- mean((prognozy$y - prognozy$model)[floor(prognozy$kwartal) == 1970])
r71 <- floor(prognozy$kwartal) == 1971
round(rbind(bez_poprawki = miary(prognozy$y[r71] - prognozy$model[r71], prognozy$y[r71]),
            z_poprawka   = miary(prognozy$y[r71] - (prognozy$model[r71] + poprawka), prognozy$y[r71])), 4)

# Rysunek 2A: szereg i prognozy; 2B: błędy ex post w kolejnych kwartałach
dl <- data.frame(kwartal = rep(prognozy$kwartal, 3),
                 prognoza = c(prognozy$model, prognozy$trend, prognozy$naiwna),
                 metoda = factor(rep(c("model ekonometryczny", "trend liniowy", "prognoza naiwna"), each = nrow(prognozy)),
                                 levels = c("model ekonometryczny", "trend liniowy", "prognoza naiwna")))
dl$blad <- rep(prognozy$y, 3) - dl$prognoza
kolory  <- c(oi[["niebieski"]], oi[["pomaranczowy"]], oi[["fiolet"]])
ksztalt <- c(16, 17, 15)
pA <- ggplot() +
  annotate("rect", xmin = 1969.9, xmax = 1972, ymin = -Inf, ymax = Inf, fill = "grey92") +
  geom_ribbon(data = data.frame(kwartal = test$kwartal, lwr = pi95[, "lwr"], upr = pi95[, "upr"]),
              aes(kwartal, ymin = lwr, ymax = upr), fill = oi[["niebieski"]], alpha = 0.18) +
  geom_line(data = d, aes(kwartal, y), colour = "grey20") +
  geom_point(data = d, aes(kwartal, y), colour = "grey20", size = 1.3) +
  geom_line(data = dl, aes(kwartal, prognoza, colour = metoda, linetype = metoda), linewidth = 0.8) +
  geom_point(data = dl, aes(kwartal, prognoza, colour = metoda, shape = metoda), size = 2.2) +
  annotate("text", x = 1964.5, y = 9.62, label = "okres estymacji\n1962–1969", size = 3.3, colour = "grey30") +
  annotate("text", x = 1970.95, y = 9.42, label = "prognoza\n1970–1971", size = 3.3, colour = "grey30") +
  scale_colour_manual(values = kolory, name = NULL) + scale_shape_manual(values = ksztalt, name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotted"), name = NULL) +
  scale_x_continuous(breaks = seq(1962, 1972, 2)) +
  labs(title = "A. Przychody kwartalne i trzy prognozy", x = NULL, y = "Przychód (y)") +
  motyw + theme(legend.position = "bottom")
pB <- ggplot(dl, aes(kwartal, blad, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_vline(xintercept = 1970.875, colour = "grey70", linetype = "dashed") +
  geom_line(linewidth = 0.7) + geom_point(size = 2.4) +
  annotate("text", x = 1970.4, y = -0.075, label = "1970", size = 3.3, colour = "grey30") +
  annotate("text", x = 1971.4, y = -0.075, label = "1971", size = 3.3, colour = "grey30") +
  scale_colour_manual(values = kolory, name = NULL) + scale_shape_manual(values = ksztalt, name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotted"), name = NULL) +
  scale_x_continuous(breaks = test$kwartal, labels = paste0(floor(test$kwartal), " Q", (test$kwartal %% 1) * 4 + 1)) +
  labs(title = "B. Błędy ex post (y − prognoza)", x = NULL, y = "Błąd") +
  motyw + theme(legend.position = "none", axis.text.x = element_text(angle = 45, hjust = 1))
p_metoda <- pA + pB + plot_layout(widths = c(1.5, 1))
p_os
p_metoda
Wynik w R
estymacja  prognoza
       31         8
                      Estimate Std. Error t value Pr(>|t|)
(Intercept)            -9.7283     6.0886 -1.5978   0.1222
lag.quarterly.revenue   0.1317     0.1471  0.8951   0.3790
price.index            -0.8887     0.1678 -5.2958   0.0000
income.level            0.6315     0.1377  4.5845   0.0001
market.potential        1.3775     0.5192  2.6532   0.0134
   s_e     R2
0.0138 0.9976
  metoda okres      ME    MAE   RMSE   MAPE
1  model  1970 -0.0294 0.0294 0.0327 0.3040
2  model  1971 -0.0223 0.0223 0.0236 0.2287
3  trend  1970 -0.0201 0.0237 0.0308 0.2445
4  trend  1971 -0.0567 0.0567 0.0569 0.5806
5 naiwna  1970  0.0105 0.0174 0.0260 0.1792
6 naiwna  1971  0.0269 0.0269 0.0273 0.2753
[1] 6
                  ME    MAE   RMSE   MAPE
bez_poprawki -0.0223 0.0223 0.0236 0.2287
z_poprawka    0.0071 0.0099 0.0104 0.1011
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (regresja i prognozy – funkcje lm() i predict() z pakietu stats, dane – zbiór freeny z pakietu datasets; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Zbigniew Pawłowski?
Polskim ekonometrykiem i statystykiem (1930–1981). Urodził się we Lwowie, studiował w SGPiS w Warszawie, odbył staże u Hermana Wolda w Uppsali i Richarda Stone’a w Cambridge, a od 1962 r. pracował w Wyższej Szkole Ekonomicznej w Katowicach, gdzie kierował Katedrą Statystyki i Instytutem Ekonometrii. Zmarł w 1981 r. w Katowicach.
Jakie podręczniki napisał Zbigniew Pawłowski?
Najbardziej znane to „Wstęp do statystyki matematycznej” (PWN, 1965, ze słowem wstępnym Oskara Langego), „Ekonometria” (wiele wydań w PWN), „Statystyka matematyczna” (1976) i „Wstęp do statystycznej metody reprezentacyjnej” (1972). Część z nich przetłumaczono na rosyjski, niemiecki i węgierski.
Czym jest analiza ex post błędów prognozy?
To porównanie prognoz z wartościami, które już się zrealizowały, za pomocą miar takich jak średni błąd, MAE, RMSE czy MAPE. Pawłowski cenił ją jako podstawę wyboru metody prognozowania na kolejne okresy. Przykład na tej stronie pokazuje, że przy krótkim okresie sprawdzania ranking metod może się zmienić z roku na rok.
Czy Zbigniew Pawłowski był uczniem Oskara Langego?
Zdzisław Hellwig nazwał go najbardziej konsekwentnym uczniem Langego, kontynuatorem jego idei w metodach ilościowych w ekonomii (Wywiał, 2020). Lange napisał też słowo wstępne do jego „Wstępu do statystyki matematycznej” z 1965 r.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Pawłowski, Z. (1965). Wstęp do statystyki matematycznej. Państwowe Wydawnictwo Naukowe.
- Pawłowski, Z. (1973). Prognozy ekonometryczne. Państwowe Wydawnictwo Naukowe.
- Wywiał, J. L. (2018). Zbigniew Pawłowski (1930–1981). In M. Krzyśko, W. Adamczewski, J. Berger, E. Gołata, K. Kruszka, & B. Łazowska (Red.), Statystycy polscy. Biogramy (wyd. 2 uzup.) (pp. 297–302). Główny Urząd Statystyczny. https://bws.stat.gov.pl/BWS/Archiwum/gus_bws_67_Statystycy_polscy_Biogramy.pdf ● Otwarty dostęp
- Wywiał, J. L. (2020). Zbigniew Pawłowski’s 90th birth anniversary. Przegląd Statystyczny. Statistical Review, 67(3), 231–237. https://ps.stat.gov.pl/PS/2020/3/gus_ps_2020_03_janusz_leszek_wywial_zbigniew_pawlowski%E2%80%99s_90th_birth_anniversary.pdf ● Otwarty dostęp
Cytowania BibTeX
@book{pawlowski1965wstep, author={Pawłowski, Zbigniew}, title={{Wstęp do statystyki matematycznej}}, year={1965}, publisher={Państwowe Wydawnictwo Naukowe}, url={https://data.bn.org.pl/api/institutions/bibs.json?id=2119916}}@book{pawlowski1973prognozy, author={Pawłowski, Zbigniew}, title={{Prognozy ekonometryczne}}, year={1973}, publisher={Państwowe Wydawnictwo Naukowe}, url={https://data.bn.org.pl/api/institutions/bibs.json?id=1896262}}@incollection{wywial2018zbigniew, author={Wywiał, Janusz Leszek}, title={{Zbigniew Pawłowski (1930–1981)}}, booktitle={Statystycy polscy. Biogramy (wyd. 2 uzup.)}, year={2018}, pages={297--302}, publisher={Główny Urząd Statystyczny}, url={https://bws.stat.gov.pl/BWS/Archiwum/gus_bws_67_Statystycy_polscy_Biogramy.pdf}}@article{wywial2020zbigniew, author={Wywiał, Janusz Leszek}, title={{Zbigniew Pawłowski’s 90th birth anniversary}}, journal={Przegląd Statystyczny. Statistical Review}, year={2020}, volume={67}, number={3}, pages={231--237}, url={https://ps.stat.gov.pl/PS/2020/3/gus_ps_2020_03_janusz_leszek_wywial_zbigniew_pawlowski%E2%80%99s_90th_birth_anniversary.pdf}}