Kim jest James J. Heckman?
James J. Heckman (ur. 1944) to ekonomista i ekonometra z University of Chicago, laureat Nagrody Nobla z ekonomii z 2000 r. Urodził się w Chicago (Lindau Nobel Laureate Meetings, b.d.). Jako dziecko mieszkał około dwóch lat w Kentucky i Oklahomie, gdzie chodził do szkół z segregacją rasową (Clement, 2005).
Studiował matematykę w Colorado College (licencjat w 1965 r.), a ekonomię w Princeton – magisterium w 1968 r., doktorat w 1971 r. Na początku lat 70. uczył na Columbii, w 1973 r. przeszedł na University of Chicago (Clement, 2005), a w latach 1988–1990 pracował na Yale (Lindau Nobel Laureate Meetings, b.d.). W 2000 r. Królewska Szwedzka Akademia Nauk przyznała mu Nagrodę Nobla za teorię i metody analizy prób selektywnych; drugą połowę nagrody otrzymał Daniel McFadden za analizę wyborów dyskretnych (National Bureau of Economic Research, 2000).
Najważniejsze pomysły
- Błąd selekcji jako błąd specyfikacji (1979). Heckman (1979) pokazał, że szacowanie zależności na próbie dobranej nielosowo daje obciążenie takie jak pominięcie zmiennej w regresji. Zaproponował prosty, zgodny estymator dwukrokowy: najpierw regresja probitowa dla tego, czy obserwację widać, potem zwykła regresja z dodatkowym predyktorem – odwrotnym ilorazem Millsa. Wyprowadził też rozkład asymptotyczny tego estymatora. Szczegóły i założenia opisuje hasło model selekcji Heckmana.
- Mikroekonometria i heterogeniczność. W wykładzie noblowskim Heckman (2001) przekonywał, że analiza danych o pojedynczych osobach i rodzinach wymagała nowych narzędzi, a ważną regularnością, jaką wykryła, jest różnorodność zachowań ludzi. Ta heterogeniczność zmienia i teorię, i praktykę ekonometrii.
- Ewaluacja polityki publicznej. Badał skutki programów szkolenia zawodowego, dyskryminację rasową i zmiany po ustawach o prawach obywatelskich (Clement, 2005; National Bureau of Economic Research, 2000).
- Wczesne dzieciństwo. Z zespołem ponownie przeanalizował program przedszkolny Perry Preschool. Uwzględnił naruszenia protokołu randomizacji, podał błędy standardowe i analizy wrażliwości. Społeczna stopa zwrotu wyszła zwykle 7–10% rocznie – mniej, niż raportowano wcześniej, ale wyraźnie powyżej zera (Heckman i in., 2010).
Ciekawostka
Pod koniec 1963 r. student Heckman wyruszył na podróż po amerykańskim Południu z kolegą z pokoju w akademiku, Nigeryjczykiem. W Birmingham nocowali w YMCA dla czarnych, w Hattiesburgu w sylwestra zatrzymała ich policja i rozdzieliła do dwóch hoteli, a 1 stycznia w Nowym Orleanie sklepikarze na Bourbon Street zamykali przed nimi drzwi. Około siedmiu lat później przyjechał do Nowego Orleanu na swoją pierwszą konferencję naukową i zastał te same miejsca już bez segregacji (Clement, 2005).
Sam mówił w tym wywiadzie, że podróż i lata w Kentucky wzbudziły w nim trwałe zainteresowanie źródłami nierówności między czarnymi a białymi Amerykanami. Później badał je na danych z przemysłu tekstylnego Południa sięgających 1915 r. – i znalazł duże zmiany po wejściu w życie ustawy o prawach obywatelskich z 1964 r. (Clement, 2005).
Przykład na historycznych danych
Zbiór Mroz87 z pakietu sampleSelection to – według pliku pomocy – dane 753 zamężnych kobiet z amerykańskiego badania panelowego PSID, analizowane przez T. A. Mroza w „Econometrice” w 1987 r. W 1975 r. pracowało zarobkowo 428 z nich, a 325 nie. Płacę znamy więc tylko u 57% kobiet – to klasyczna sytuacja z pracy z 1979 r. Specyfikację modeli wzięliśmy z przykładu w pliku pomocy.
Krok 1. Probit udziału w rynku pracy na wszystkich 753 kobietach. Szansę pracy najsilniej obniżały małe dzieci (współczynnik przy liczbie dzieci do 5 lat −0.868, p < .001) i wiek (−0.053 na rok, p < .001); podnosiły ją wykształcenie (0.131) i staż pracy. Dochód pozostałych członków rodziny obniżał ją słabiej (−0.012 na tysiąc dolarów, p = .015), a starsze dzieci nie miały znaczenia (p = .414). Odwrotny iloraz Millsa (IMR) u pracujących wynosił od 0.050 do 2.070, średnio 0.530.
Krok 2. Regresja logarytmu płacy u 428 pracujących z IMR jako dodatkowym predyktorem. Współczynnik przy IMR wyniósł 0.032 (SE = 0.134, p = .81), a współczynnik przy latach nauki zmienił się niewiele: 0.1075 w zwykłej regresji na pracujących wobec 0.1091 po korekcie. Funkcja heckit() daje te same współczynniki z poprawionym błędem standardowym (0.0155 zamiast 0.0156), a metoda największej wiarygodności – 0.1084 i korelację błędów obu równań ρ = 0.027 (SE = 0.147). W tej specyfikacji dane nie wskazują więc na selekcję związaną z płacą przez czynniki niemierzone.
Na rysunku
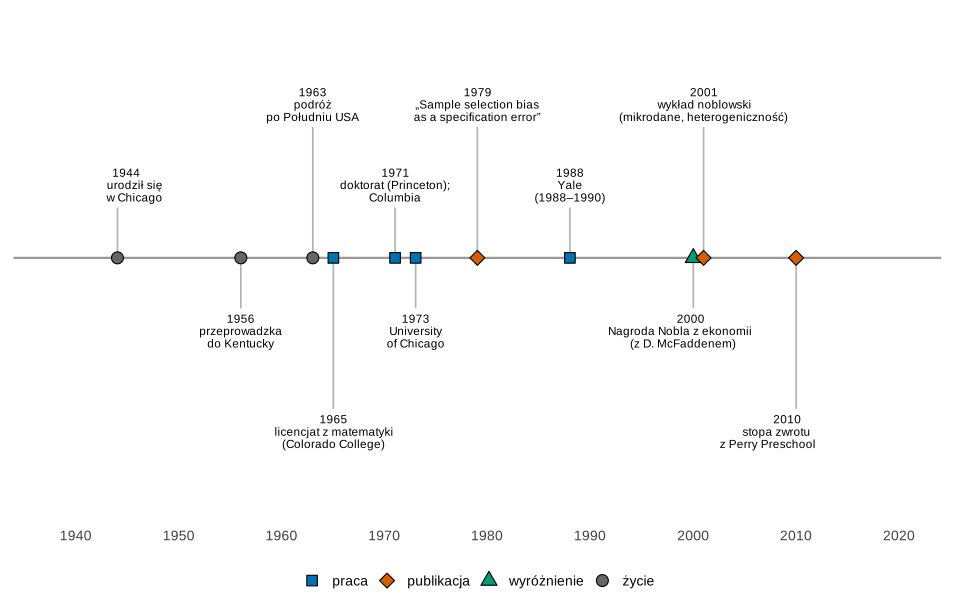
Co widać. Ponad pół wieku na University of Chicago, z krótką przerwą na Yale; praca o selekcji ukazała się osiem lat po doktoracie.
Na co uważać. Źródła różnią się w szczegółach: życiorys z Lindau podaje rok 1971 jako początek pracy na Columbii, a wywiad – lata 1970–74. Oś pokazuje rok doktoratu.
Podpis do pracy:
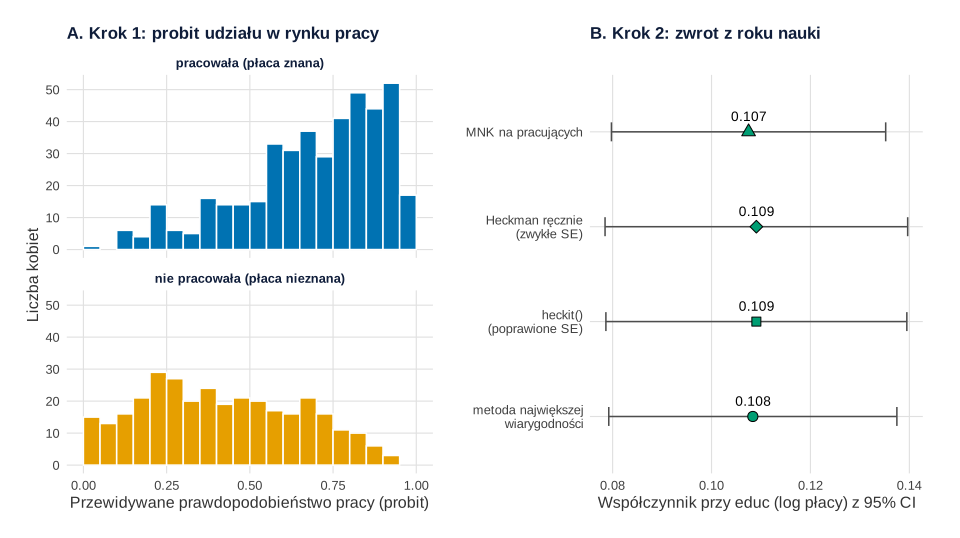
sampleSelection::Mroz87, N = 753): rozkład przewidywanego prawdopodobieństwa pracy u kobiet pracujących i niepracujących (A) oraz zwrot z roku nauki w czterech wersjach oszacowania (B). Obliczenia i rysunek: R, pakiety sampleSelection, ggplot2 i patchwork.Co widać. W panelu A obie grupy wyraźnie się różnią: model z kroku 1 dobrze odróżnia kobiety, które pracują, od tych, które nie pracują. To warunek, by IMR niósł jakąkolwiek informację. W panelu B cztery oszacowania zwrotu z roku nauki leżą obok siebie – korekta na selekcję prawie niczego tu nie zmienia.
Na co uważać. Brak różnicy nie dowodzi, że selekcji nie ma. Wynik zależy od założenia o normalnym rozkładzie błędów i od tego, że dzieci, wiek i dochód rodziny wpływają na decyzję o pracy, a nie na samą płacę (restrykcja wykluczająca). Przy innych założeniach korekta może wyjść inna.
Podpis do pracy:
Gdzie spotkasz Heckmana w swojej pracy
- Wynik znany tylko u części osób. Płacę znasz tylko u pracujących, ocenę – tylko u tych, którzy przystąpili do egzaminu, a odpowiedź – tylko od osób, które zwróciły ankietę. Jeśli o tym decyduje proces związany z wynikiem, masz błąd selekcji, a brakujące wyniki są brakami typu MNAR (braki danych).
- Wybór modelu. Model Heckmana odróżnij od modelu tobitowego Jamesa Tobina, w którym jeden proces decyduje i o obserwacji, i o wartości wyniku, oraz od danych uciętych, w których osób spoza progu w ogóle nie ma.
- Ewaluacja programów. Lekcja z Perry Preschool: nawet w badaniu z losowym przydziałem sprawdź, czy protokół randomizacji był przestrzegany, i raportuj błędy standardowe efektów.
Spory, mity i trudne strony
- „Korekta Heckmana naprawia każdą selekcję”. Nie: działa tylko przy spełnionych założeniach modelu. Krytykę i alternatywy omawia hasło o modelu selekcji.
- Wyniki programów społecznych. Ponowna analiza Perry Preschool dała stopy zwrotu niższe niż wcześniejsze szacunki, ale wciąż istotne (Heckman i in., 2010). Programy szkoleń zawodowych sam Heckman oceniał pesymistycznie (Clement, 2005).
Dwukrokowy model Heckmana w R
Kod szacuje probit udziału w rynku pracy, liczy odwrotny iloraz Millsa, szacuje równanie płacy bez korekty i z korektą, porównuje wyniki z funkcjami heckit() i selection() i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje, więc nie ma ziarna.
1. Dwa kroki Heckmana na danych Mroza: rysunek 2
Kod R rysunku 2
# Dwukrokowy estymator Heckmana „ręcznie” na danych Mroza (1987): płace zamężnych kobiet w USA w 1975 r.
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(sampleSelection)})
kol <- c("#E69F00", "#0072B2", "#009E73", "#CC79A7")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

data(Mroz87, package = "sampleSelection")   # 753 kobiety, PSID; płacę znamy tylko u 428 pracujących
d <- Mroz87
d$exper2 <- d$exper^2
table(pracowala = d$lfp)

# Krok 1: probit udziału w rynku pracy (wszystkie 753 kobiety)
krok1 <- glm(lfp ~ nwifeinc + educ + exper + exper2 + age + kids5 + kids618,
             family = binomial(link = "probit"), data = d)
round(coef(summary(krok1)), 4)
xb <- predict(krok1, type = "link")        # indeks z równania selekcji
d$imr <- dnorm(xb) / pnorm(xb)             # odwrotny iloraz Millsa
d$p_pracy <- pnorm(xb)
pracujace <- subset(d, lfp == 1)
round(summary(pracujace$imr), 3)

# Krok 2: równanie płacy u pracujących z IMR jako dodatkowym predyktorem
mnk <- lm(log(wage) ~ educ + exper + exper2, data = pracujace)
krok2 <- lm(log(wage) ~ educ + exper + exper2 + imr, data = pracujace)
round(coef(summary(mnk)), 4)
round(coef(summary(krok2)), 4)

# To samo funkcją heckit() (poprawione błędy standardowe) i metodą największej wiarygodności
f_sel <- lfp ~ nwifeinc + educ + exper + I(exper^2) + age + kids5 + kids618
f_wyn <- log(wage) ~ educ + exper + I(exper^2)
h2 <- heckit(f_sel, f_wyn, data = Mroz87, method = "2step")
ml <- selection(f_sel, f_wyn, data = Mroz87, method = "ml")
w2 <- coef(summary(h2), part = "outcome")
wml <- coef(summary(ml), part = "outcome")
round(w2, 4)
round(coef(summary(h2))[c("invMillsRatio", "sigma", "rho"), 1:2], 4)
round(wml["educ", 1:2], 4)
round(coef(summary(ml))[c("sigma", "rho"), 1:2], 4)

# Zwrot z roku nauki (współczynnik przy educ) w czterech wersjach
zwrot <- data.frame(
  metoda = c("MNK na pracujących", "Heckman ręcznie\n(zwykłe SE)", "heckit()\n(poprawione SE)", "metoda największej\nwiarygodności"),
  b = c(coef(mnk)["educ"], coef(krok2)["educ"], w2["educ", 1], wml["educ", 1]),
  se = c(coef(summary(mnk))["educ", 2], coef(summary(krok2))["educ", 2], w2["educ", 2], wml["educ", 2]))
zwrot$dolna <- zwrot$b - 1.96 * zwrot$se
zwrot$gorna <- zwrot$b + 1.96 * zwrot$se
zwrot$metoda <- factor(zwrot$metoda, levels = rev(zwrot$metoda))
print(data.frame(metoda = gsub("\n", " ", zwrot$metoda), round(zwrot[, -1], 4)), row.names = FALSE)

# Rysunek: A – przewidywane prawdopodobieństwo pracy w obu grupach; B – współczynnik przy educ z 95% CI
d$grupa <- factor(ifelse(d$lfp == 1, "pracowała (płaca znana)", "nie pracowała (płaca nieznana)"),
                  levels = c("pracowała (płaca znana)", "nie pracowała (płaca nieznana)"))
pA <- ggplot(d, aes(p_pracy, fill = grupa)) +
  geom_histogram(breaks = seq(0, 1, by = 0.05), colour = "white") +
  facet_wrap(~ grupa, ncol = 1) +
  scale_fill_manual(values = kol[2:1], guide = "none") +
  labs(title = "A. Krok 1: probit udziału w rynku pracy",
       x = "Przewidywane prawdopodobieństwo pracy (probit)", y = "Liczba kobiet") +
  motyw
pB <- ggplot(zwrot, aes(b, metoda)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = "grey30") +
  geom_point(aes(shape = metoda), size = 3.2, fill = kol[3], colour = "black") +
  scale_shape_manual(values = c(21, 22, 23, 24), guide = "none") +
  geom_text(aes(label = sprintf("%.3f", b)), vjust = -1.1, size = 3.6) +
  labs(title = "B. Krok 2: zwrot z roku nauki", x = "Współczynnik przy educ (log płacy) z 95% CI", y = NULL) +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.1, 1))
p2
Wynik w R
pracowala
  0   1
325 428
            Estimate Std. Error z value Pr(>|z|)
(Intercept)   0.2701     0.5081  0.5316   0.5950
nwifeinc     -0.0120     0.0049 -2.4343   0.0149
educ          0.1309     0.0254  5.1540   0.0000
exper         0.1233     0.0188  6.5755   0.0000
exper2       -0.0019     0.0006 -3.1455   0.0017
age          -0.0529     0.0085 -6.2456   0.0000
kids5        -0.8683     0.1184 -7.3352   0.0000
kids618       0.0360     0.0440  0.8177   0.4135
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
  0.050   0.259   0.452   0.530   0.691   2.070
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  -0.5220     0.1986 -2.6282   0.0089
educ          0.1075     0.0141  7.5983   0.0000
exper         0.0416     0.0132  3.1549   0.0017
exper2       -0.0008     0.0004 -2.0628   0.0397
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  -0.5781     0.3067 -1.8848   0.0601
educ          0.1091     0.0156  6.9871   0.0000
exper         0.0439     0.0164  2.6837   0.0076
exper2       -0.0009     0.0004 -1.9464   0.0523
imr           0.0323     0.1344  0.2401   0.8104
              Estimate Std. Error t value Pr(>|t|)
(Intercept)    -0.5781     0.3050 -1.8954   0.0584
educ            0.1091     0.0155  7.0261   0.0000
exper           0.0439     0.0163  2.6989   0.0071
I(exper^2)     -0.0009     0.0004 -1.9574   0.0507
invMillsRatio   0.0323     0.1336  0.2414   0.8093
              Estimate Std. Error
invMillsRatio   0.0323     0.1336
sigma           0.6636         NA
rho             0.0486         NA
  Estimate Std. Error
    0.1084     0.0149
      Estimate Std. Error
sigma   0.6634     0.0227
rho     0.0266     0.1471
                           metoda      b     se  dolna  gorna
               MNK na pracujących 0.1075 0.0141 0.0798 0.1352
      Heckman ręcznie (zwykłe SE) 0.1091 0.0156 0.0785 0.1397
         heckit() (poprawione SE) 0.1091 0.0155 0.0786 0.1395
 metoda największej wiarygodności 0.1084 0.0149 0.0792 0.1375
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: James J. Heckman (ur. 1944) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1944, 1956, 1963, 1965, 1971, 1973, 1979, 1988, 2000, 2001, 2010),
  opis = c("urodził się\nw Chicago", "przeprowadzka\ndo Kentucky", "podróż\npo Południu USA",
           "licencjat z matematyki\n(Colorado College)", "doktorat (Princeton);\nColumbia", "University\nof Chicago",
           "„Sample selection bias\nas a specification error”", "Yale\n(1988–1990)",
           "Nagroda Nobla z ekonomii\n(z D. McFaddenem)", "wykład noblowski\n(mikrodane, heterogeniczność)", "stopa zwrotu\nz Perry Preschool"),
  rodzaj = c("życie", "życie", "życie", "praca", "praca", "praca", "publikacja", "praca",
             "wyróżnienie", "publikacja", "publikacja"),
  poziom = c(0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3, 0.5, -0.5, 1.3, -1.5),   # wysokość etykiety
  wyrownanie = c(0.2, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.6, 0.5, 0.8))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1938, 2020), breaks = seq(1940, 2020, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (probit – glm(), regresja – lm() z pakietu stats; model selekcji i dane – pakiet sampleSelection; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sampleSelection (wersja 1.2.16): Toomet, O., & Henningsen, A. (2008). Sample selection models in R: Package sampleSelection. Journal of Statistical Software, 27(7), 1–23. https://doi.org/10.18637/jss.v027.i07
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest James Heckman?
Amerykańskim ekonomistą i ekonometrą (ur. 1944 w Chicago), od 1973 r. profesorem University of Chicago. Doktoryzował się z ekonomii w Princeton w 1971 r. W 2000 r. otrzymał Nagrodę Nobla z ekonomii za teorię i metody analizy prób selektywnych (Clement, 2005; National Bureau of Economic Research, 2000).
Za co James Heckman dostał Nagrodę Nobla?
Za rozwinięcie teorii i metod analizy prób selektywnych, czyli danych, w których to, kogo obserwujemy, nie jest losowe. Nagrodę z 2000 r. podzielił z Danielem McFaddenem, nagrodzonym za analizę wyborów dyskretnych (National Bureau of Economic Research, 2000).
Na czym polega dwukrokowa metoda Heckmana?
Najpierw regresja probitowa na wszystkich osobach szacuje, kto ma obserwowany wynik. Z niej liczy się odwrotny iloraz Millsa, który w drugim kroku trafia jako dodatkowy predyktor do regresji wyniku na obserwowanych osobach. Heckman (1979) pokazał, że tak skorygowany estymator jest zgodny.
Czego dowiedział się Heckman o programie Perry Preschool?
Że po uwzględnieniu naruszeń randomizacji i niepewności oszacowań społeczna stopa zwrotu z tego programu przedszkolnego wynosi zwykle 7–10% rocznie – mniej niż we wcześniejszych analizach, ale wciąż wyraźnie powyżej zera (Heckman i in., 2010).
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Clement, D. (2005). Interview with James Heckman. The Region (Federal Reserve Bank of Minneapolis). https://minneapolisfed.org/article/2005/interview-with-james-heckman ● Otwarty dostęp
- Heckman, J. J. (1979). Sample selection bias as a specification error. Econometrica, 47(1), 153. https://doi.org/10.2307/1912352
- Heckman, J. J. (2001). Micro data, heterogeneity, and the evaluation of public policy: Nobel lecture. Journal of Political Economy, 109(4), 673–748. https://doi.org/10.1086/322086
- Heckman, J. J., Moon, S. H., Pinto, R., Savelyev, P. A., & Yavitz, A. (2010). The rate of return to the HighScope Perry Preschool Program. Journal of Public Economics, 94(1–2), 114–128. https://doi.org/10.1016/j.jpubeco.2009.11.001 ● Otwarty dostęp: pełny tekst
- Lindau Nobel Laureate Meetings. (b.d.). James J. Heckman – curriculum vitae. Mediatheque of the Lindau Nobel Laureate Meetings. Pobrano 22 listopada 2026 z https://mediatheque.lindau-nobel.org/laureates/heckman/cv ● Otwarty dostęp
- National Bureau of Economic Research. (2000). James J. Heckman and Daniel L. McFadden won 2000 Nobel Prize for advancing the statistical analysis of microdata. NBER News. https://www.nber.org/news/james-j-heckman-and-daniel-l-mcfadden-won-2000-nobel-prize-advancing-statistical-analysis-microdata ● Otwarty dostęp
Cytowania BibTeX
@misc{clement2005heckman, author={Clement, Douglas}, title={{Interview with James Heckman}}, howpublished={The Region (Federal Reserve Bank of Minneapolis)}, year={2005}, url={https://minneapolisfed.org/article/2005/interview-with-james-heckman}}@article{heckman1979sample, author={Heckman, James J.}, title={{Sample selection bias as a specification error}}, journal={Econometrica}, year={1979}, volume={47}, number={1}, pages={153}, doi={10.2307/1912352}}@article{heckman2001micro, author={Heckman, James J.}, title={{Micro data, heterogeneity, and the evaluation of public policy: Nobel lecture}}, journal={Journal of Political Economy}, year={2001}, volume={109}, number={4}, pages={673--748}, doi={10.1086/322086}}@article{heckman2010perry, author={Heckman, James J. and Moon, Seong Hyeok and Pinto, Rodrigo and Savelyev, Peter A. and Yavitz, Adam}, title={{The rate of return to the HighScope Perry Preschool Program}}, journal={Journal of Public Economics}, year={2010}, volume={94}, number={1–2}, pages={114--128}, doi={10.1016/j.jpubeco.2009.11.001}}@misc{lindauheckman, author={{Lindau Nobel Laureate Meetings}}, title={{James J. Heckman – curriculum vitae}}, howpublished={Mediatheque of the Lindau Nobel Laureate Meetings}, url={https://mediatheque.lindau-nobel.org/laureates/heckman/cv}}@misc{nber2000heckman, author={{National Bureau of Economic Research}}, title={{James J. Heckman and Daniel L. McFadden won 2000 Nobel Prize for advancing the statistical analysis of microdata}}, howpublished={NBER News}, year={2000}, url={https://www.nber.org/news/james-j-heckman-and-daniel-l-mcfadden-won-2000-nobel-prize-advancing-statistical-analysis-microdata}}