Kim jest Daniel McFadden?
Daniel L. McFadden (ur. 1937) jest amerykańskim ekonometrykiem, autorem narzędzi do analizy wyborów między kilkoma możliwościami. W 2000 r. otrzymał Nagrodę Nobla z ekonomii wspólnie z Jamesem Heckmanem (McFadden, 2001).
Zaczynał od fizyki: licencjat zdobył na Uniwersytecie Minnesoty w 1957 r., a w latach 1959–1960 był asystentem w badaniach z psychologii społecznej. Doktorat z nauk o zachowaniu (w zakresie ekonomii) obronił w Minnesocie w 1962 r. Po roku w Pittsburghu przeszedł w 1963 r. na Uniwersytet Kalifornijski w Berkeley, gdzie w 1968 r. został profesorem. W latach 1978–1991 był profesorem w MIT, a od 1990 r. ponownie pracuje w Berkeley (McFadden, 2017). Do ekonomii przyciągnęli go – jak pisze – m.in. Leonid Hurwicz i Hirofumi Uzawa (McFadden, 2001).
Otrzymał Medal Johna Batesa Clarka (1975) i Medal Frischa (1986); w 1981 r. wybrano go do National Academy of Sciences, a w 1985 r. kierował Econometric Society (McFadden, 2017).
Najważniejsze pomysły
- Warunkowy logit (1965–1974). Prawdopodobieństwo wyboru możliwości i to exp(Vi) podzielone przez sumę exp(Vk) po wszystkich dostępnych możliwościach, a użyteczność V jest liniową funkcją ich cech (kosztu, czasu, długości trasy). Nazwa „warunkowy” wzięła się stąd, że model opisuje wybór przy danym zbiorze alternatyw, a przy dwóch możliwościach staje się regresją logistyczną. Dziś nazywa się go zwykle logitem wielomianowym; parametry szacuje się metodą największej wiarygodności (McFadden, 1974, 2001).
- Losowa użyteczność. Model wyrósł z psychologii: z prawa porównawczego osądu Thurstone’a (1927), modelu losowej użyteczności Marschaka i aksjomatu Luce’a. McFadden wykazał, że model Luce’a wynika z maksymalizacji użyteczności z niezależnymi składnikami losowymi wtedy i tylko wtedy, gdy mają one rozkład wartości ekstremalnych typu I – ten sam, który badał Emil Gumbel (McFadden, 2001).
- Logit zagnieżdżony i prognozy popytu na transport. W 1970 r. w MIT zbudował wersję modelu dla wyborów wielostopniowych, a od 1972 r. kierował w Berkeley projektem badań nad wyborami podróżnych (McFadden, 2001; zob. ciekawostka).
- Testy założenia IIA. Zaproponował – z Tye’em i Trainem (1978), a potem z Hausmanem (1984) – testy sprawdzające, czy model nie myli się tam, gdzie możliwości są bliskimi zamiennikami (McFadden, 2001).
Ciekawostka
Wszystko zaczęło się od cudzej pracy doktorskiej. W 1965 r. doktorantka z Berkeley Phoebe Cottingham poprosiła McFaddena o radę: jak analizować dane o tym, którą trasę nowej autostrady wybierał kalifornijski urząd drogowy? McFadden zaproponował model, w którym atrakcyjność trasy zależy od kosztu budowy, długości i zajętych terenów zielonych, i napisał program do jego oszacowania. Program ruszył, gdy Cottingham miała już obronioną pracę (McFadden, 2001).
Prawdziwy sprawdzian przyszedł z koleją BART w okolicach San Francisco. Zespół McFaddena zbadał w 1972 r. podróżnych, zanim kolej ruszyła, i na tej podstawie przewidział ich wybory po jej otwarciu. Wśród 631 osób przebadanych ponownie w 1975 r. model dawał kolei 6.3% dojazdów do pracy – faktycznie było to 6.2%. Oficjalna prognoza z 1973 r., oparta na zagregowanych modelach grawitacyjnych, zakładała 15%. McFadden przyznaje, że przy błędzie standardowym prognozy równym 2.5 punktu jego zespół miał szczęście, ale nawet po odliczeniu szczęścia wynik przemawiał za modelami opartymi na wyborach pojedynczych osób (McFadden, 2001).
Przykład: jak podróżni wybierają między samochodem, samolotem, pociągiem i autobusem
Zbiór TravelMode z pakietu AER to – według pliku pomocy – dane o wyborze środka transportu między Sydney a Melbourne (210 osób, cztery możliwości z czasem czekania i kosztami) z materiałów do podręcznika Greene’a (2003). Samochód wybrało 28.1% osób, samolot 27.6%, pociąg 30.0%, autobus 14.3%.
Użyteczność to stała dla środka transportu (dla samochodu 0) plus efekt kosztu uogólnionego i czasu czekania; model szacujemy wprost ze wzoru McFaddena funkcją optim(). Oba efekty są ujemne: b = −0.0158 (SE = 0.0044) dla kosztu i −0.0971 (0.0104) dla każdej minuty czekania. Minuta czekania „waży” więc tyle, co 6.15 jednostki kosztu uogólnionego. Logarytm wiarygodności wzrósł z −291.12 (wybór losowy, po 1/4) do −199.98, czyli R² McFaddena = .313. Ten sam model to warunkowa regresja logistyczna z osobami jako warstwami: survival::clogit() daje te same współczynniki (różnice na czwartym miejscu po przecinku).
W tabeli trafności prognoz (jak w wykładzie noblowskim) sumy kolumn (59, 58, 63, 30) równają się dokładnie liczbom faktycznych wyborów – to własność modelu ze stałymi dla każdej możliwości, więc trafność udziałów w próbie niczego nie dowodzi. Dlatego jak McFadden sprawdzamy prognozę na nowych osobach: model oszacowany na losowej połowie podróżnych (set.seed(1974)) przewiduje dla drugiej połowy udziały 27.7%, 32.0%, 26.3% i 13.9%, a faktyczne wynoszą 30.5%, 26.7%, 26.7% i 16.2%.
Scenariusz: czekanie na pociąg krótsze o 10 minut podnosi jego przewidywany udział z 30.0% do 45.0%. U każdej osoby pozostałe trzy środki tracą przy tym ten sam odsetek (u pierwszej po 37.84%) – to założenie IIA.
Na rysunku
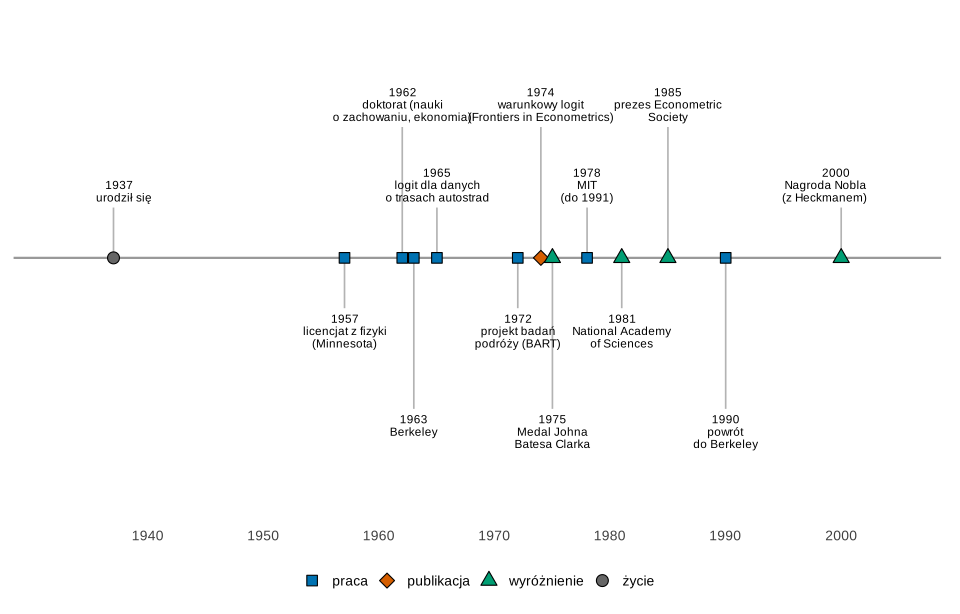
Co widać. Droga od fizyki do ekonometrii i dwa okresy w Berkeley przedzielone latami w MIT.
Na co uważać. Rok 1974 to data rozdziału w tomie pod redakcją Zarembki; analizę danych o trasach autostrad McFadden opublikował już w 1968 r. (McFadden, 2001).
Podpis do pracy:
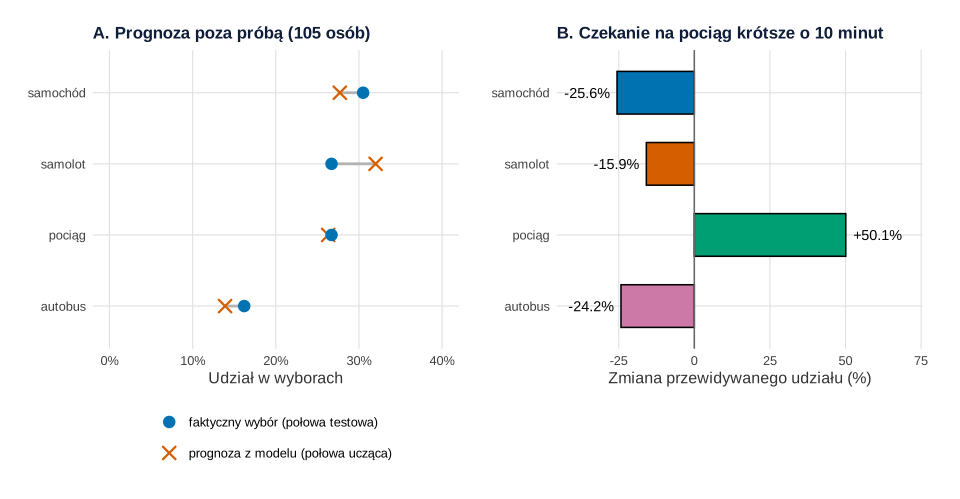
TravelMode, pakiet AER): prognoza dla osób spoza próby uczącej (A) i scenariusz krótszego czekania na pociąg (B). Obliczenia i rysunek: R, pakiety ggplot2 i patchwork (podział na połowy: set.seed(1974)).Co widać. W panelu A prognoza dla pociągu jest prawie dokładna, a dla samolotu wyraźnie zawyżona (32.0% wobec 26.7%). Panel B pokazuje, skąd model bierze nowych pasażerów pociągu.
Na co uważać. Różne spadki w panelu B wynikają tylko z sumowania po osobach; u każdej osoby pozostałe środki tracą ten sam odsetek. Przy bliskich zamiennikach to mylące (zob. niżej). Wykres nie pokazuje niepewności prognoz.
Podpis do pracy:
Gdzie spotkasz McFaddena w swojej pracy
- Badania wyborów konsumenckich. Wybory między wariantami produktu analizuje się warunkowym logitem – tak działa analiza conjoint w wersji wyborczej (zob. conjoint wyborczy CBC).
- Pseudo-R². Miara 1 − log L/log L0 występuje w programach statystycznych jako R² McFaddena; przykład wyżej pokazuje, jak ją policzyć.
- Epidemiologia. Ta sama funkcja wiarygodności służy w warunkowej regresji logistycznej dla dopasowanych par.
- Psychologia decyzji. Wśród osób, które najbardziej wpłynęły na jego pracę, McFadden wymienia Kahnemana i Tversky’ego; rozwój teorii wyboru wiązał z psychologią poznawczą (McFadden, 2001). Szerszy kontekst – w haśle ekonometria.
Spory, mity i trudne strony
- Czerwony i niebieski autobus. Gdy do wyboru „samochód albo czerwony autobus” dodać identyczny niebieski autobus, logit odbierze pasażerów także samochodowi, choć nowy autobus przejmie głównie pasażerów starego. McFadden sam przywołuje ten przykład: przy niespełnionym IIA prognozy bywają poważnie mylące, stąd testy IIA i modele zagnieżdżone (McFadden, 2001).
- Czy prognoza dla BART była tak dobra? Zbieżność 6.3% i 6.2% dotyczy dojazdów do pracy w badanej próbie. McFadden przyznaje też błędy: zespół przeszacował gotowość dojścia pieszo do stacji i nie docenił jazdy samochodem w pojedynkę (McFadden, 2001).
Warunkowy logit w R
Kod szacuje warunkowy logit na danych TravelMode wprost ze wzoru McFaddena (funkcja wiarygodności i optim()), sprawdza wynik funkcją survival::clogit(), buduje tabelę trafności prognoz, prognozuje udziały dla połowy osób spoza próby uczącej, liczy scenariusz krótszego czekania na pociąg i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Ziarno: set.seed(1974) (tylko losowy podział osób na połowy).
1. Warunkowy logit i prognozy: rysunek 2
Kod R rysunku 2
# Warunkowy logit McFaddena: wybór środka transportu między Sydney a Melbourne (AER::TravelMode)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(survival)})
kol <- c(car = "#0072B2", air = "#D55E00", train = "#009E73", bus = "#CC79A7")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

data("TravelMode", package = "AER")   # 210 podróżnych × 4 środki transportu (Greene, 2003)
tm <- TravelMode
tm$mode <- factor(tm$mode, levels = c("car", "air", "train", "bus"))
tm <- tm[order(tm$individual, tm$mode), ]
tm$y <- as.numeric(tm$choice == "yes")
round(c(prop.table(table(tm$mode[tm$y == 1]))), 3)         # wybory w próbie

# Użyteczność: V = stała środka (samochód = 0) + b_koszt · koszt uogólniony + b_czekanie · czas czekania na terminalu
X <- cbind(air = tm$mode == "air", train = tm$mode == "train", bus = tm$mode == "bus",
           gcost = tm$gcost, wait = tm$wait) * 1
# Wzór McFaddena: P(i) = exp(V_i) / suma exp(V_k) po środkach dostępnych danej osobie
prawd <- function(b, X, id) { V <- drop(X %*% b); eV <- exp(V); eV / ave(eV, id, FUN = sum) }
logL <- function(b, X, y, id) sum(y * log(prawd(b, X, id)))
dopasuj <- function(rows) {
  f <- optim(rep(0, ncol(X)), logL, X = X[rows, ], y = tm$y[rows], id = tm$individual[rows],
             method = "BFGS", hessian = TRUE, control = list(fnscale = -1, maxit = 1000, reltol = 1e-12))
  list(b = setNames(f$par, colnames(X)), se = sqrt(diag(solve(-f$hessian))), logL = f$value)
}
wsz <- seq_len(nrow(tm))
m <- dopasuj(wsz)
round(cbind(b = m$b, SE = m$se, z = m$b / m$se), 4)
c(logL = m$logL, logL_zero = 210 * log(1 / 4), pseudoR2_McFadden = 1 - m$logL / (210 * log(1 / 4)))

# Ten sam model jako warunkowa regresja logistyczna (warstwy = osoby) – identyczne oszacowania
m_cl <- clogit(y ~ air + train + bus + gcost + wait + strata(individual), data = cbind(tm, X[, 1:3]))
round(coef(m_cl), 4)

# Ile minut czekania na terminalu „kosztuje” tyle, co jedna jednostka kosztu uogólnionego?
unname(round(m$b["wait"] / m$b["gcost"], 2))

# Tabela trafności prognoz (jak tabela 1 w wykładzie noblowskim): sumy prawdopodobieństw wg faktycznego wyboru
tm$p <- prawd(m$b, X, tm$individual)
wybrany <- tm$mode[tm$y == 1]                              # jeden wybór na osobę (osoby w kolejności 1–210)
tm$faktyczny <- wybrany[as.integer(tm$individual)]
tab <- xtabs(p ~ faktyczny + mode, data = tm)
round(addmargins(tab), 1)   # wiersze: faktyczny wybór; kolumny: przewidywany środek

# Prognoza poza próbą: model z połowy osób, prognoza udziałów dla drugiej połowy
set.seed(1974)
uczace <- sample(levels(tm$individual), 105)
w_ucz <- which(tm$individual %in% uczace); w_test <- which(!tm$individual %in% uczace)
m_ucz <- dopasuj(w_ucz)
p_test <- prawd(m_ucz$b, X[w_test, ], tm$individual[w_test])
prog <- data.frame(srodek = levels(tm$mode),
                   prognoza = as.numeric(tapply(p_test, tm$mode[w_test], mean)),
                   faktycznie = as.numeric(tapply(tm$y[w_test], tm$mode[w_test], mean)))
prog[, 2:3] <- round(prog[, 2:3], 3)
prog

# Scenariusz: czekanie na dworcu kolejowym krótsze o 10 minut – skąd przyjdą nowi pasażerowie pociągu?
X2 <- X; X2[tm$mode == "train", "wait"] <- X2[tm$mode == "train", "wait"] - 10
tm$p2 <- prawd(m$b, X2, tm$individual)
scen <- data.frame(srodek = levels(tm$mode),
                   teraz = as.numeric(tapply(tm$p, tm$mode, mean)),
                   scenariusz = as.numeric(tapply(tm$p2, tm$mode, mean)))
scen$zmiana_proc <- 100 * (scen$scenariusz / scen$teraz - 1)
scen[, 2:4] <- round(scen[, 2:4], 3)
scen
# Niezależność od nieistotnych alternatyw (IIA): u każdej osoby pozostałe środki tracą ten sam odsetek
os1 <- tm[tm$individual == "1", ]
round(100 * (os1$p2 / os1$p - 1), 2)

# Rysunek: A – prognoza poza próbą a faktyczne udziały; B – scenariusz krótszego czekania na pociąg
nazwy <- c(car = "samochód", air = "samolot", train = "pociąg", bus = "autobus")
dA <- rbind(data.frame(srodek = prog$srodek, udzial = prog$prognoza, rodzaj = "prognoza z modelu (połowa ucząca)"),
            data.frame(srodek = prog$srodek, udzial = prog$faktycznie, rodzaj = "faktyczny wybór (połowa testowa)"))
dA$srodek <- factor(nazwy[dA$srodek], levels = rev(nazwy))
pA <- ggplot(dA, aes(udzial, srodek, shape = rodzaj, colour = rodzaj)) +
  geom_line(aes(group = srodek), colour = "grey70", linewidth = 1) +
  geom_point(size = 3.6, stroke = 1.2) +
  scale_shape_manual(values = c(16, 4), name = NULL) +
  scale_colour_manual(values = c("#0072B2", "#D55E00"), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(round(100 * x), "%"), limits = c(0, 0.4)) +
  guides(shape = guide_legend(nrow = 2), colour = guide_legend(nrow = 2)) +
  labs(title = "A. Prognoza poza próbą (105 osób)", x = "Udział w wyborach", y = NULL) +
  motyw
dB <- scen; dB$srodek <- factor(nazwy[dB$srodek], levels = rev(nazwy))
pB <- ggplot(dB, aes(zmiana_proc, srodek, fill = srodek)) +
  geom_col(width = 0.6, colour = "black", show.legend = FALSE) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_text(aes(label = sprintf("%+.1f%%", zmiana_proc), hjust = ifelse(zmiana_proc > 0, -0.15, 1.15)), size = 3.8) +
  scale_fill_manual(values = setNames(kol, nazwy)) +
  scale_x_continuous(limits = c(-40, 70)) +
  labs(title = "B. Czekanie na pociąg krótsze o 10 minut", x = "Zmiana przewidywanego udziału (%)", y = NULL) +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1))
p2
Wynik w R
  car   air train   bus
0.281 0.276 0.300 0.143
            b     SE       z
air    5.7767 0.6559  8.8073
train  3.9234 0.4420  8.8771
bus    3.2110 0.4496  7.1416
gcost -0.0158 0.0044 -3.6023
wait  -0.0971 0.0104 -9.3039
             logL         logL_zero pseudoR2_McFadden
     -199.9766240      -291.1218158         0.3130827
    air   train     bus   gcost    wait
 5.7764  3.9230  3.2107 -0.0158 -0.0971
[1] 6.15
         mode
faktyczny   car   air train   bus   Sum
    car    25.7  14.8  12.8   5.7  59.0
    air    13.4  31.8   8.1   4.7  58.0
    train  13.5   8.2  36.7   4.6  63.0
    bus     6.4   3.3   5.4  15.0  30.0
    Sum    59.0  58.0  63.0  30.0 210.0
  srodek prognoza faktycznie
1    car    0.277      0.305
2    air    0.320      0.267
3  train    0.263      0.267
4    bus    0.139      0.162
  srodek teraz scenariusz zmiana_proc
1    car 0.281      0.209     -25.554
2    air 0.276      0.232     -15.868
3  train 0.300      0.450      50.085
4    bus 0.143      0.108     -24.245
[1] -37.84 -37.84  64.12 -37.84
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Daniel McFadden (ur. 1937) – lata według jego CV i wykładu noblowskiego (McFadden, 2001)
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1937, 1957, 1962, 1963, 1965, 1972, 1974, 1975, 1978, 1981, 1985, 1990, 2000),
  opis = c("urodził się", "licencjat z fizyki\n(Minnesota)", "doktorat (nauki\no zachowaniu, ekonomia)",
           "Berkeley", "logit dla danych\no trasach autostrad", "projekt badań\npodróży (BART)",
           "warunkowy logit\n(Frontiers in Econometrics)", "Medal Johna\nBatesa Clarka", "MIT\n(do 1991)",
           "National Academy\nof Sciences", "prezes Econometric\nSociety", "powrót\ndo Berkeley",
           "Nagroda Nobla\n(z Heckmanem)"),
  rodzaj = c("życie", "praca", "praca", "praca", "praca", "praca", "publikacja", "wyróżnienie", "praca",
             "wyróżnienie", "wyróżnienie", "praca", "wyróżnienie"),
  poziom = c(0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3, -1.5, 0.5),   # wysokość etykiety
  wyrownanie = c(0.3, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.7))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1932, 2005), breaks = seq(1940, 2000, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (optymalizacja – optim(), losowanie – sample() z pakietów stats i base; warunkowa regresja logistyczna – pakiet survival; dane – pakiet AER; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- AER (wersja 1.2.17): Kleiber, C., & Zeileis, A. (2008). Applied econometrics with R. Springer. https://doi.org/10.1007/978-0-387-77318-6
- survival (wersja 3.8-6): Therneau, T. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest Daniel McFadden?
Amerykańskim ekonometrykiem (ur. 1937), który zbudował statystyczne narzędzia do analizy wyborów między kilkoma możliwościami, np. środkami transportu. Z wykształcenia fizyk, doktorat z nauk o zachowaniu (ekonomii) obronił w 1962 r. w Minnesocie, a pracował głównie w Berkeley i MIT. W 2000 r. otrzymał Nagrodę Nobla z ekonomii wspólnie z Jamesem Heckmanem (McFadden, 2001, 2017).
Co to jest warunkowy logit McFaddena?
Model, w którym prawdopodobieństwo wyboru możliwości i jest równe exp(V_i) podzielonemu przez sumę exp(V_k) po wszystkich dostępnych możliwościach, a użyteczność V zależy od cech tych możliwości, np. kosztu i czasu. McFadden nazwał go warunkowym, bo jest rozkładem wyboru przy danym zbiorze dostępnych alternatyw; dziś często nazywa się go logitem wielomianowym.
Czy McFadden trafnie przewidział popyt na kolej BART?
Tak, choć sam przyznał, że miał też szczęście. Model oszacowany na danych z 1972 r. przewidział, że BART przejmie 6.3% dojazdów do pracy badanych osób (błąd standardowy 2.5 punktu), a w 1975 r. faktycznie było to 6.2%. Oficjalna prognoza z 1973 r. zakładała 15% (McFadden, 2001).
Czym jest założenie IIA w modelu logitowym?
Niezależnością od nieistotnych alternatyw: stosunek prawdopodobieństw wyboru dwóch możliwości nie zależy od tego, jakie inne możliwości są dostępne. W efekcie poprawa jednej opcji odbiera wszystkim pozostałym ten sam odsetek ich udziału. Gdy opcje są bliskimi zamiennikami, prowadzi to do mylących prognoz – stąd testy IIA i modele zagnieżdżone.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Greene, W. H. (2003). Econometric analysis (5th ed.). Prentice Hall.
- McFadden, D. (1974). Conditional logit analysis of qualitative choice behavior. In P. Zarembka (Ed.), Frontiers in econometrics (pp. 105–142). Academic Press.
- McFadden, D. (2001). Economic choices. American Economic Review, 91(3), 351–378. https://doi.org/10.1257/aer.91.3.351 ● Otwarty dostęp: pełny tekst
- McFadden, D. (2017). Daniel L. McFadden: Curriculum vitae. University of California, Berkeley, Department of Economics. https://eml.berkeley.edu/~mcfadden/dlmcv10.html ● Otwarty dostęp
Cytowania BibTeX
@book{greene2003econometric, author={Greene, William H.}, title={{Econometric analysis}}, year={2003}, edition={5}, publisher={Prentice Hall}}@incollection{mcfadden1974conditional, author={McFadden, Daniel}, title={{Conditional logit analysis of qualitative choice behavior}}, booktitle={Frontiers in econometrics}, year={1974}, pages={105--142}, publisher={Academic Press}}@article{mcfadden2001economic, author={McFadden, Daniel}, title={{Economic choices}}, journal={American Economic Review}, year={2001}, volume={91}, number={3}, pages={351--378}, doi={10.1257/aer.91.3.351}}@misc{mcfadden2017curriculum, author={McFadden, Daniel}, title={{Daniel L. McFadden: Curriculum vitae}}, howpublished={University of California, Berkeley, Department of Economics}, year={2017}, publisher={University of California, Berkeley}, url={https://eml.berkeley.edu/~mcfadden/dlmcv10.html}}