Kim był Edwin Bidwell Wilson?
Edwin Bidwell Wilson (1879–1964) był amerykańskim matematykiem, fizykiem teoretykiem, statystykiem i ekonomistą. Studentom statystyki zostawił przede wszystkim przedział Wilsona dla odsetka. Według wspomnienia Hunsakera i Mac Lane’a (1973) urodził się 25 kwietnia 1879 r. w Hartford w stanie Connecticut, na Harvardzie ukończył z wyróżnieniem studia z matematyki (1899), a w 1901 r. obronił doktorat w Yale.
Uczył matematyki w Yale, a w 1907 r. przeszedł do Massachusetts Institute of Technology (MIT). Tam został profesorem (1911), a w 1917 r. kierownikiem wydziału fizyki. Zajmował się też dynamiką lotu. W 1922 r. został profesorem statystyki demograficznej (ang. vital statistics) w Harvard School of Public Health, gdzie pracował do emerytury (1945). Przez 50 lat, od pierwszego numeru z 1915 r. aż do śmierci, był redaktorem zarządzającym czasopisma Proceedings of the National Academy of Sciences (PNAS). W 1929 r. przewodniczył American Statistical Association. Zmarł 28 grudnia 1964 r.
Najważniejsze pomysły
- Przedział Wilsona (1927). Zwykły przedział dla odsetka liczy błąd standardowy z odsetka w próbie. Wilson zaproponował, żeby wyrazić go przez nieznany odsetek w populacji i rozwiązać powstałe równanie. Wychodzi przedział, który nie jest symetryczny wokół wyniku z próby, tylko wokół punktu nieco przesuniętego w stronę 0.5 (Wilson, 1927). Dziś nazywa się go przedziałem Wilsona albo przedziałem z odwrócenia testu score (zob. test score). Porównanie metod: hasło przedział ufności dla proporcji.
- Przybliżenie Wilsona–Hilferty’ego (1931). Razem z Margaret Hilferty przeanalizował ponownie dane Charlesa S. Peirce’a z 1873 r. o czasie reakcji. Z tej pracy wyrosło przybliżenie rozkładu chi-kwadrat przez przekształcenie zmiennej (Wilson i Hilferty, 1931). Hunsaker i Mac Lane (1973) uważają je za być może najbardziej znany wkład Wilsona w statystykę.
- Statystyka w zdrowiu publicznym. W Harvard School of Public Health badał przebieg epidemii, tabele 2 × 2 a z Jane Worcester przez lata rozwijał metody szacowania mediany dawki śmiertelnej (LD50).
- Podręczniki. Vector Analysis (1901) przez wiele lat był w USA standardowym podręcznikiem rachunku wektorowego; Wilson napisał też Advanced Calculus (1912) i Aeronautics (1920).
Ciekawostka
Pierwsza książka Wilsona nie była jego własnym pomysłem. Był ostatnim studentem fizyka Josiaha Willarda Gibbsa w Yale i w 1901 r. przekształcił jego wykłady o rachunku wektorowym w podręcznik Vector Analysis. Według wspomnienia Hunsakera i Mac Lane’a (1973) sam Gibbs nie chciał, żeby książka ukazała się bez jego bardziej oryginalnych, niepublikowanych prac o algebrze wielokrotnej. Zapis z pogrubionymi wektorami, kropką dla iloczynu skalarnego i krzyżykiem dla wektorowego z tego podręcznika jest w amerykańskiej fizyce w użyciu do dziś.
Ci sami autorzy opisują z humorem lato 1912 r. Dwaj studenci MIT utknęli na równaniach stabilności samolotu i przywieźli je profesorowi na wakacje. Żona Wilsona wynegocjowała cennik: za pintę dzikich truskawek studenci dostawali konsultację i dobrą kolację. Od tych wakacyjnych konsultacji zaczęły się poważne prace Wilsona o dynamice lotu.
Przykład na historycznych danych
Zbiór Arthritis z pakietu vcd pochodzi – według pliku pomocy – z podwójnie zaślepionego badania klinicznego nowego leczenia reumatoidalnego zapalenia stawów, opisanego przez G. Kocha i S. Edwardsa w 1988 r. Liczymy odsetek pacjentów z wyraźną poprawą (Improved == "Marked") w czterech grupach: placebo lub lek, kobiety lub mężczyźni. Każda grupa to próba z rozkładu dwumianowego. Małe podgrupy i odsetki bliskie zera to typowa sytuacja z pracy dyplomowej.
Wśród 11 mężczyzn z placebo wyraźną poprawę miał tylko 1 (9.1%). Podręcznikowy przedział Walda wynosi [−0.079, 0.261], czyli zawiera niemożliwy ujemny odsetek. Przedział Wilsona to [0.016, 0.377]: jest przesunięty w prawo i cały mieści się między 0 a 1. Ten sam wynik daje funkcja prop.test() bez poprawki na ciągłość. U kobiet leczonych (16 z 27) przedziały to [0.407, 0.778] według Walda i [0.407, 0.755] według Wilsona: gdy odsetek jest bliski 0.5, metody prawie się zgadzają. Nie twierdzimy, że Wilson analizował te dane – to nasz przykład jego metody.
Na rysunku
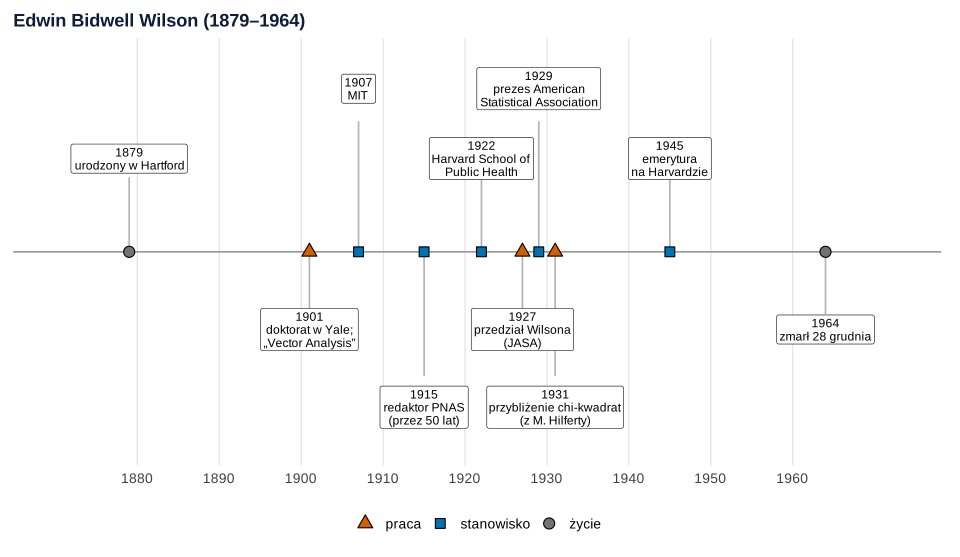
Co widać. Statystyka to trzecia kariera Wilsona – po matematyce i aerodynamice. Prace, z których znają go studenci (1927 i 1931), powstały, gdy miał prawie 50 lat.
Na co uważać. To wybór dziesięciu zdarzeń: oś pomija m.in. wybór do National Academy of Sciences (1919) i doradztwo dla marynarki wojennej po 1948 r.
Podpis do pracy:
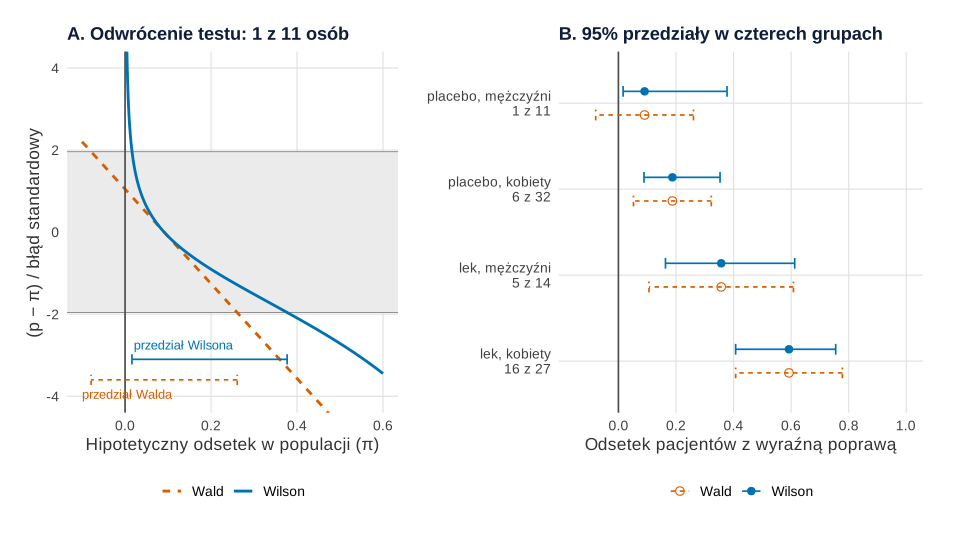
vcd::Arthritis (badanie Kocha i Edwardsa z 1988 r., według pliku pomocy). Rysunek: R, pakiety ggplot2 i patchwork; obliczenia bez losowania.Co widać. Panel A pokazuje pomysł Wilsona. Dla każdego kandydata na prawdziwy odsetek π liczymy, o ile błędów standardowych wynik z próby (1 z 11) od niego odbiega. Do przedziału trafiają te wartości π, przy których odchylenie mieści się w szarym pasie ±1.96. U Walda błąd standardowy jest stały (policzony z wyniku 1/11), więc krzywa jest prostą i bez przeszkód przechodzi na ujemne π. U Wilsona błąd standardowy zależy od π i maleje do zera przy π = 0, więc krzywa ucieka w górę i przedział nie może zejść poniżej zera. Panel B: im mniejsza grupa i odsetek bliższy 0, tym większa różnica.
Na co uważać. Przedział Wilsona nie naprawia małej próby – przy 11 osobach odsetek w populacji może wynosić równie dobrze 2%, jak 38%. Wykresu nie czytaj jako porównania leku z placebo – podgrupy płci są małe i nierówne.
Podpis do pracy:
Gdzie spotkasz Wilsona w swojej pracy
- Odsetki z przedziałem. Gdy w tabeli podajesz odsetek osób z objawem, rezygnacją lub odpowiedzią „tak”, przy małych grupach podaj przedział Wilsona. W R daje go
prop.test(x, n, correct = FALSE); Brown i in. (2001) zalecają go przy małym n. - Porównanie dwóch odsetków. Przedział Wilsona jest cegiełką przedziału Newcombe’a dla różnicy proporcji, który uzupełnia test dla dwóch proporcji.
- Opis metody. W sekcji wyników napisz, jaką metodą policzono przedział (np. „95% CI Wilsona”) – przy małych grupach metody dają wyraźnie różne granice.
Spory, mity i trudne strony
„Wilson wymyślił przedział ufności”. Hunsaker i Mac Lane (1973) piszą, że jego praca z 1927 r. trafnie uprzedziła ideę przedziału ufności, ale pełną teorię podali kilka lat później Jerzy Neyman i Egon Pearson (zob. przedział ufności). Gdy Neyman w 1952 r. przyznał Wilsonowi pierwszeństwo tej idei, Wilson odpowiedział w 1964 r., że sam by sobie tego nie przypisywał.
„Wald to standard, Wilson to egzotyka”. Jest odwrotnie: przedział Walda ma przy małych próbach zbyt niskie pokrycie, a przedział Wilsona trzyma się blisko nominalnych 95% (Agresti i Coull, 1998; Brown i in., 2001).
„Przedział Wilsona to przedział Agrestiego–Coulla”. Nie: Agresti i Coull (1998) zaproponowali prostszy przedział – Wald po dodaniu dwóch sukcesów i dwóch porażek. Ma pokrycie podobne do przedziału Wilsona, ale to inna metoda i daje nieco inne granice.
Przedział Wilsona w R
Kod rysuje oś czasu, liczy odsetki wyraźnej poprawy w czterech grupach badania Arthritis, przedziały Walda i Wilsona ze wzorów, sprawdza wynik funkcją prop.test() i rysuje oba panele rysunku 2. Kod nie losuje. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Oś czasu i przedziały Walda i Wilsona na danych Arthritis
Kod R rysunków 1 i 2
# Edwin Bidwell Wilson: oś czasu i przedział Wilsona (1927) dla odsetka „wyraźnej poprawy” w badaniu klinicznym
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Hunsakera i Mac Lane’a 1973)
zdarzenia <- data.frame(
  rok = c(1879, 1901, 1907, 1915, 1922, 1927, 1929, 1931, 1945, 1964),
  opis = c("urodzony w Hartford", "doktorat w Yale;\n„Vector Analysis”", "MIT", "redaktor PNAS\n(przez 50 lat)",
           "Harvard School of\nPublic Health", "przedział Wilsona\n(JASA)", "prezes American\nStatistical Association",
           "przybliżenie chi-kwadrat\n(z M. Hilferty)", "emerytura\nna Harvardzie", "zmarł 28 grudnia"),
  rodzaj = c("życie", "praca", "stanowisko", "stanowisko", "stanowisko", "praca", "stanowisko", "praca", "stanowisko", "życie"))
zdarzenia$y <- c(1.2, -1, 2.1, -2, 1.2, -1, 2.1, -2, 1.2, -1)   # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.2, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "stanowisko" = 22, "praca" = 24), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "stanowisko" = oi[["niebieski"]], "praca" = oi[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1880, 1960, 10), limits = c(1870, 1973)) + scale_y_continuous(limits = c(-2.5, 2.5)) +
  labs(title = "Edwin Bidwell Wilson (1879–1964)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: badanie kliniczne leczenia reumatoidalnego zapalenia stawów (Koch i Edwards 1988), 84 pacjentów
data(Arthritis, package = "vcd")
tab <- with(Arthritis, table(grupa = interaction(Treatment, Sex, sep = ", "), wyrazna = Improved == "Marked"))
tab
z <- qnorm(0.975)
d <- data.frame(grupa = rownames(tab), x = tab[, "TRUE"], n = rowSums(tab), row.names = NULL)
d$p <- d$x / d$n
# Przedział Walda: odsetek ± z · błąd standardowy policzony z odsetka w próbie
d$wald_d <- d$p - z * sqrt(d$p * (1 - d$p) / d$n); d$wald_g <- d$p + z * sqrt(d$p * (1 - d$p) / d$n)
# Przedział Wilsona: wszystkie wartości π, dla których |p − π| ≤ z · √(π(1 − π)/n) – rozwiązanie równania kwadratowego
srodek <- (d$x + z^2 / 2) / (d$n + z^2)
pol <- z * sqrt(d$n) / (d$n + z^2) * sqrt(d$p * (1 - d$p) + z^2 / (4 * d$n))
d$wilson_d <- srodek - pol; d$wilson_g <- srodek + pol
print(cbind(d[1:3], round(d[4:8], 3)), row.names = FALSE)
# To samo daje prop.test() bez poprawki na ciągłość – np. mężczyźni z placebo (1 z 11)
round(prop.test(1, 11, correct = FALSE)$conf.int, 3)

# Rysunek A: jak Wilson „odwraca” test – mężczyźni z placebo, 1 z 11 z wyraźną poprawą
x <- 1; n <- 11; p0 <- x / n
pi_wil <- seq(0.001, 0.6, by = 0.001)    # Wilson: błąd standardowy z hipotetycznego π (π musi być > 0)
pi_wal <- seq(-0.1, 0.6, by = 0.001)     # Wald: błąd standardowy z odsetka w próbie (wzór nie „wie”, że π ≥ 0)
dl <- rbind(data.frame(pi = pi_wil, stat = (p0 - pi_wil) / sqrt(pi_wil * (1 - pi_wil) / n), metoda = "Wilson"),
            data.frame(pi = pi_wal, stat = (p0 - pi_wal) / sqrt(p0 * (1 - p0) / n), metoda = "Wald"))
# Granice przedziału to punkty, w których krzywa przecina pas ±1.96
pm <- d[d$grupa == "Placebo, Male", ]
przedz <- data.frame(metoda = c("Wald", "Wilson"), dol = c(pm$wald_d, pm$wilson_d), gor = c(pm$wald_g, pm$wilson_g), y = c(-3.6, -3.1))
przedz[2:3] <- round(przedz[2:3], 3); przedz[1:3]
p_odwr <- ggplot(dl, aes(pi, stat, linetype = metoda, colour = metoda)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = -z, ymax = z, fill = "grey92") +
  geom_hline(yintercept = c(-z, z), colour = "grey50", linewidth = 0.3) +
  geom_line(linewidth = 1) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_errorbar(data = przedz, aes(y = y, xmin = dol, xmax = gor), inherit.aes = FALSE, width = 0.25, orientation = "y",
                colour = oi[c("cynober", "niebieski")], linetype = c("22", "solid")) +
  annotate("text", x = c(-0.1, 0.02), y = c(-3.95, -2.75), label = c("przedział Walda", "przedział Wilsona"), hjust = 0, size = 3.4,
           colour = oi[c("cynober", "niebieski")]) +
  scale_colour_manual(values = c(Wald = oi[["cynober"]], Wilson = oi[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c(Wald = "22", Wilson = "solid"), name = NULL) +
  coord_cartesian(xlim = c(-0.1, 0.6), ylim = c(-4, 4)) +
  labs(title = "A. Odwrócenie testu: 1 z 11 osób", x = "Hipotetyczny odsetek w populacji (π)",
       y = "(p − π) / błąd standardowy") + motyw + theme(legend.position = "bottom")

# Rysunek B: przedziały Walda i Wilsona dla czterech grup badania
pl <- c("Placebo, Female" = "placebo, kobiety", "Placebo, Male" = "placebo, mężczyźni",
        "Treated, Female" = "lek, kobiety", "Treated, Male" = "lek, mężczyźni")
d$etyk <- paste0(pl[d$grupa], "\n", d$x, " z ", d$n)
dd <- rbind(data.frame(etyk = d$etyk, p = d$p, dol = d$wald_d, gor = d$wald_g, metoda = "Wald"),
            data.frame(etyk = d$etyk, p = d$p, dol = d$wilson_d, gor = d$wilson_g, metoda = "Wilson"))
p_grupy <- ggplot(dd, aes(p, etyk, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_errorbar(aes(xmin = dol, xmax = gor), width = 0.25, orientation = "y", position = position_dodge(width = 0.55)) +
  geom_point(size = 2.6, position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = c(Wald = oi[["cynober"]], Wilson = oi[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(Wald = 1, Wilson = 16), name = NULL) +
  scale_linetype_manual(values = c(Wald = "22", Wilson = "solid"), name = NULL) +
  scale_x_continuous(limits = c(-0.15, 1), breaks = seq(0, 1, 0.2)) +
  labs(title = "B. 95% przedziały w czterech grupach", x = "Odsetek pacjentów z wyraźną poprawą", y = NULL) +
  motyw + theme(legend.position = "bottom")
p_metoda <- p_odwr + p_grupy + plot_layout(widths = c(1, 1.1))
p_os
p_metoda
Wynik w R
                 wyrazna
grupa             FALSE TRUE
  Placebo, Female    26    6
  Treated, Female    11   16
  Placebo, Male      10    1
  Treated, Male       9    5
           grupa  x  n     p wald_d wald_g wilson_d wilson_g
 Placebo, Female  6 32 0.188  0.052  0.323    0.089    0.353
 Treated, Female 16 27 0.593  0.407  0.778    0.407    0.755
   Placebo, Male  1 11 0.091 -0.079  0.261    0.016    0.377
   Treated, Male  5 14 0.357  0.106  0.608    0.163    0.612
[1] 0.016 0.377
attr(,"conf.level")
[1] 0.95
  metoda    dol   gor
1   Wald -0.079 0.261
2 Wilson  0.016 0.377
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przedziały – wzory w kodzie i funkcja prop.test() z pakietu stats; dane – pakiet vcd; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- vcd (wersja 1.4.13): Meyer, D., Zeileis, A., Hornik, K., & Friendly, M. (2024). vcd: Visualizing categorical data [R package]. https://doi.org/10.32614/CRAN.package.vcd
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Edwin Bidwell Wilson?
Amerykańskim matematykiem, fizykiem i statystykiem (1879–1964). Doktorat zrobił w Yale (1901), uczył w MIT, a od 1922 r. był profesorem statystyki demograficznej w Harvard School of Public Health. Przez 50 lat redagował czasopismo PNAS, a w 1929 r. przewodniczył American Statistical Association.
Na czym polega przedział Wilsona?
Zamiast liczyć błąd standardowy z odsetka w próbie, jak w przedziale Walda, Wilson wyraża go przez nieznany odsetek w populacji i wybiera te wartości, z którymi wynik z próby jest zgodny. Przedział jest niesymetryczny, nie wychodzi poza zakres od 0 do 1 i przy małych próbach ma pokrycie bliskie nominalnemu.
Jak policzyć przedział Wilsona w R?
Najprościej funkcją prop.test(x, n, correct = FALSE) – jej przedział ufności to przedział Wilsona. Dla 1 sukcesu na 11 prób daje [0.016, 0.377]. Z poprawką na ciągłość (ustawienie domyślne) wynik jest nieco szerszy.
Czy Wilson wymyślił przedział ufności?
Jego praca z 1927 r. uprzedziła tę ideę, ale pełną teorię przedziałów ufności podali kilka lat później Neyman i Pearson. Gdy Neyman przyznał Wilsonowi pierwszeństwo, Wilson odpowiedział, że sam by sobie tego nie przypisywał.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A., & Coull, B. A. (1998). Approximate is better than “exact” for interval estimation of binomial proportions. The American Statistician, 52(2), 119–126. https://doi.org/10.1080/00031305.1998.10480550
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Hunsaker, J., & Mac Lane, S. (1973). Edwin Bidwell Wilson, April 25, 1879–December 28, 1964. In Biographical memoirs: Volume 43 (pp. 285–320). National Academy of Sciences. https://www.nasonline.org/wp-content/uploads/2024/06/wilson-edwin-b.pdf
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212. https://doi.org/10.1080/01621459.1927.10502953
- Wilson, E. B., & Hilferty, M. M. (1931). The distribution of chi-square. Proceedings of the National Academy of Sciences of the United States of America, 17(12), 684–688. https://doi.org/10.1073/pnas.17.12.684 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{agresti1998approximate, author={Agresti, Alan and Coull, Brent A.}, title={{Approximate is better than “exact” for interval estimation of binomial proportions}}, journal={The American Statistician}, year={1998}, volume={52}, number={2}, pages={119--126}, doi={10.1080/00031305.1998.10480550}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@incollection{hunsaker1973wilson, author={Hunsaker, Jerome and Mac Lane, Saunders}, title={{Edwin Bidwell Wilson, April 25, 1879–December 28, 1964}}, booktitle={Biographical memoirs: Volume 43}, year={1973}, pages={285--320}, publisher={National Academy of Sciences}, url={https://www.nasonline.org/wp-content/uploads/2024/06/wilson-edwin-b.pdf}}@article{wilson1927probable, author={Wilson, Edwin B.}, title={{Probable inference, the law of succession, and statistical inference}}, journal={Journal of the American Statistical Association}, year={1927}, volume={22}, number={158}, pages={209--212}, doi={10.1080/01621459.1927.10502953}}@article{wilson1931distribution, author={Wilson, Edwin B. and Hilferty, Margaret M.}, title={{The distribution of chi-square}}, journal={Proceedings of the National Academy of Sciences of the United States of America}, year={1931}, volume={17}, number={12}, pages={684--688}, doi={10.1073/pnas.17.12.684}}