Do czego służy ta procedura w SPSS
Wielomianowa regresja logistyczna przewiduje zmienną o trzech lub więcej kategoriach bez naturalnego porządku (skala nominalna): wybór specjalności, rodzaj transportu, miejsce nauki. Model porównuje każdą kategorię z jedną kategorią odniesienia, więc przy trzech kategoriach dostajesz dwa równania (Kwak i Clayton-Matthews, 2002). Logikę modelu, ilorazy szans względem kategorii odniesienia i prawdopodobieństwa przewidywane omawia poradnik wielomianowa regresja logistyczna krok po kroku (z kodem w R). Tutaj pokazujemy tylko SPSS: okno, tabele wydruku i to, jak nie pomylić porównań.
W SPSS procedura jest w menu Analyze → Regression → Multinomial Logistic Regression..., a w polskiej dokumentacji IBM: Analiza → Regresja → Wielomianowa regresja logistyczna... (IBM Corp., b.d.-a). Według IBM wymaga edycji SPSS Statistics Standard albo opcji Regression. Nazwy okien i tabel podajemy po angielsku, za dokumentacją IBM. W polskiej wersji interfejsu mogą brzmieć inaczej. Ogólne zasady czytania wydruków wyjaśnia wpis jak czytać wyniki z SPSS, a binarną wersję modelu – regresja logistyczna w SPSS.
Przykład i pliki do pobrania
Przykład jest fikcyjny. 280 studentów podało, gdzie najczęściej uczy się przed sesją: w domu, w bibliotece albo razem z innymi. Pytanie: czy wybór zależy od ekstrawersji, odległości od uczelni i trybu studiów?
| Zmienna | Opis | M | SD |
|---|---|---|---|
miejsce | główne miejsce nauki: 1 = dom (102 osoby, 36.4%), 2 = biblioteka (101, 36.1%), 3 = nauka z innymi (77, 27.5%) | ||
ekstrawersja | średnia ze skali 1–5 | 3.05 | 0.79 |
odleglosc | odległość od uczelni w km | 12.23 | 8.65 |
stacjonarne | tryb studiów: 0 = niestacjonarne, 1 = stacjonarne | 0.62 | 0.49 |
Pobierz plik .sav (z etykietami zmiennych i wartości) albo ten sam zbiór jako plik CSV. Już średnie w grupach coś podpowiadają. Osoby uczące się z innymi mają najwyższą ekstrawersję (3.48 wobec 2.86 w domu i 2.92 w bibliotece). Do biblioteki chodzą częściej studenci stacjonarni (78% wobec 53% w dwóch pozostałych grupach) i mieszkający bliżej (10.12 km wobec 14.48 km u uczących się w domu).
Okno Multinomial Logistic Regression krok po kroku
- Zmienna zależna. Przenieś
miejscedo pola zmiennej zależnej. Okno przyjmuje jedną zmienną kategorialną (IBM Corp., b.d.-a). - Reference Category. Kliknij ten przycisk. Domyślnie kategorią odniesienia jest ostatnia kategoria, czyli tu „nauka z innymi”. Możesz wybrać pierwszą, ostatnią albo własną (Custom). Przy kolejności rosnącej (Ascending) pierwsza jest najniższa wartość (IBM Corp., b.d.-b). Wybierz First Category: odniesieniem będzie „dom”, czyli najczęstszy i najprostszy wybór.
- Factors i Covariates. Czynniki są opcjonalne i mogą być liczbowe lub tekstowe. Kowarianty też są opcjonalne, ale muszą być liczbowe (IBM Corp., b.d.-a). Przenieś
ekstrawersja,odlegloscistacjonarnedo kowariant. Zmienna 0/1 wpisana jako kowarianta daje jeden współczynnik „1 wobec 0”. Zmienną nominalną o trzech lub więcej kategoriach wstaw do czynników. SPSS sam utworzy wtedy zmienne zero-jedynkowe (zob. dummy coding). Która kategoria czynnika będzie odniesieniem, sprawdź w przypisie pod tabelą parametrów. - Model. Zostaw ustawienie domyślne, czyli efekty główne czynników i kowariant (IBM Corp., b.d.-a). Metody krokowe (Forward entry, Backward elimination i inne) dobierają predyktory za Ciebie. W pracy sprawdzającej hipotezy ich nie używaj.
- Statistics. Zaznacz Pseudo R-square, Model fitting information, Classification table, a w grupie Parameters: Estimates (poziom przedziału 95%) i Likelihood ratio test (IBM Corp., b.d.-c). Opcja Information criteria dodaje AIC i BIC (zob. AIC i BIC w regresji).
- Save (opcjonalnie). Estimated response probabilities zapisze prawdopodobieństwo każdej kategorii. Predicted category zapisze kategorię o największym przewidywanym prawdopodobieństwie (IBM Corp., b.d.-a).
Na koniec kliknij Paste zamiast OK. Polecenie NOMREG trafi do okna składni (pełną składnię znajdziesz niżej).
Model Fitting Information i Pseudo R-Square
| Model | −2 Log Likelihood | Chi-Square | df | Sig. |
|---|---|---|---|---|
| Intercept Only | 610.787 | |||
| Final | 544.280 | 66.507 | 6 | .000 |
| Pseudo R-Square: Cox and Snell .211; Nagelkerke .238; McFadden .109 | ||||
Model Fitting Information porównuje model z predyktorami z modelem z samym wyrazem wolnym (IBM Corp., b.d.-c). To test ilorazu wiarygodności: χ² to różnica −2LL obu modeli, 610.787 − 544.280 = 66.507. Stopni swobody jest 6, bo każdy z trzech predyktorów ma współczynnik w dwóch równaniach. Do pracy przepisz χ²(6) = 66.51, p < .001. „Sig. = .000” zapisz jako p < .001.
Pseudo R-Square podaje trzy miary: Coxa i Snella, Nagelkerkego i McFaddena (IBM Corp., b.d.-c). Nie są one odsetkiem wyjaśnionej wariancji (zob. pseudo-R²). Raportuj jedną, nazwaną: R² Nagelkerkego = .24.
Jeśli zaznaczysz Goodness-of-fit, SPSS policzy statystyki Pearsona i dewiancji dla wzorców wartości predyktorów (subpopulacji) (IBM Corp., b.d.-a, b.d.-c). W naszych danych każda z 280 osób ma własny wzorzec, bo predyktory są ciągłe. Takich statystyk tu nie raportuj.
Likelihood Ratio Tests: czy predyktor w ogóle działa
| Effect | −2 Log Likelihood of Reduced Model | Chi-Square | df | Sig. |
|---|---|---|---|---|
| ekstrawersja | 576.875 | 32.595 | 2 | .000 |
| odleglosc | 559.697 | 15.417 | 2 | .000 |
| stacjonarne | 563.844 | 19.564 | 2 | .000 |
Ta tabela zawiera testy efektów cząstkowych (IBM Corp., b.d.-d). Każdy wiersz porównuje model pełny z modelem bez jednego predyktora. Chi-Square to różnica −2LL, np. dla ekstrawersji 576.875 − 544.280 = 32.595. Test ma 2 stopnie swobody, bo predyktor jest usuwany z obu równań naraz. To główny test hipotezy „czy X wiąże się z wyborem miejsca nauki”, a nie pojedyncze wartości p z tabeli parametrów. Wszystkie trzy predyktory są tu istotne. Tabela nie mówi jednak, których porównań to dotyczy.
Parameter Estimates: dwa równania i Exp(B)
| miejsce | B | Std. Error | Wald | df | Sig. | Exp(B) | 95% CI dla Exp(B) | |
|---|---|---|---|---|---|---|---|---|
| biblioteka | Intercept | −.502 | .703 | .509 | 1 | .475 | ||
| ekstrawersja | .161 | .203 | .631 | 1 | .427 | 1.175 | .790–1.747 | |
| odleglosc | −.070 | .019 | 13.532 | 1 | .000 | .933 | .899–.968 | |
| stacjonarne | 1.311 | .325 | 16.249 | 1 | .000 | 3.711 | 1.961–7.020 | |
| nauka z innymi | Intercept | −3.606 | .803 | 20.188 | 1 | .000 | ||
| ekstrawersja | 1.133 | .227 | 24.981 | 1 | .000 | 3.103 | 1.991–4.838 | |
| odleglosc | −.028 | .018 | 2.344 | 1 | .126 | .972 | .938–1.008 | |
| stacjonarne | .194 | .327 | .351 | 1 | .553 | 1.214 | .639–2.305 |
Kategoria odniesienia nie ma własnych parametrów (IBM Corp., b.d.-d), dlatego wiersze „dom” nie występują. Dokumentacja opisuje zawartość tabeli ogólnie: oszacowania z przedziałem ufności o wybranym poziomie (IBM Corp., b.d.-c). Iloraz szans SPSS podaje jako exp(B) także w modelu wielomianowym (IBM Corp., 2026). Dokładnych podpisów kolumn nie potwierdziliśmy w dokumentacji, więc sprawdź je w swoim wydruku. Przedział dla Exp(B) to e do potęgi granic przedziału dla B. Wald to (B / SE)², czyli test Walda z 1 df.
Każdy blok czytaj jako osobne porównanie z kategorią odniesienia, przy stałych pozostałych predyktorach. Exp(B) to iloraz szans, ale szansa jest tu względna: P(biblioteka) / P(dom), a nie P(biblioteka) / P(nie biblioteka).
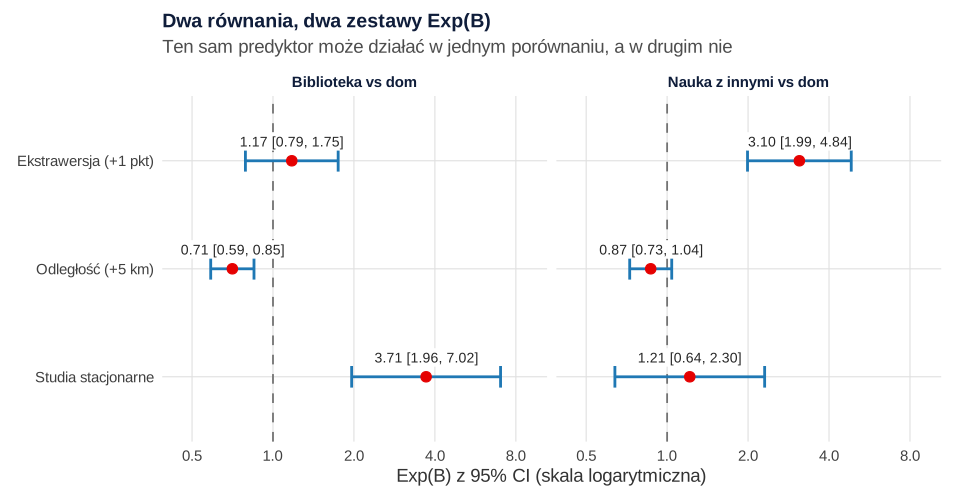
- Biblioteka vs dom. Studenci stacjonarni mają 3.71 raza większą szansę wyboru biblioteki zamiast domu, 95% CI [1.96, 7.02]. Każdy kilometr zmniejsza tę szansę (Exp(B) = 0.933). Na kilometr efekt wygląda mikro, więc przelicz go na 5 km: e5 × (−0.070) = 0.71, 95% CI [0.59, 0.85]. Ekstrawersja nie różnicuje biblioteki i domu (p = .427).
- Nauka z innymi vs dom. Każdy punkt ekstrawersji to 3.10 raza większa szansa nauki z innymi zamiast w domu, 95% CI [1.99, 4.84]. Odległość (0.87 na 5 km, 95% CI [0.73, 1.04]) i tryb studiów (p = .553) tego wyboru nie różnicują.
Rysunek 1 pokazuje to samo graficznie. Ten sam predyktor działa w jednym równaniu, a w drugim nie, i dlatego test z tabeli Likelihood Ratio Tests nie wystarczy do opisu.
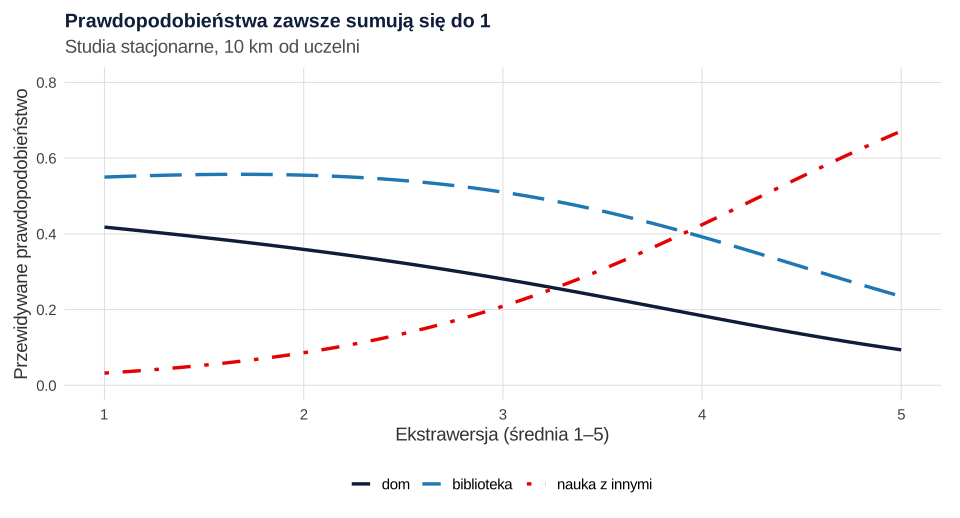
Exp(B) nie mówi wprost, jak zmienia się prawdopodobieństwo. Ekstrawersja nie różnicuje biblioteki i domu, a mimo to przewidywane prawdopodobieństwo biblioteki spada z .555 przy ekstrawersji 2 do .392 przy ekstrawersji 4 (studia stacjonarne, 10 km). Rośnie bowiem udział nauki z innymi: z .086 do .424 (rysunek 2). Prawdopodobieństwa zapiszesz w oknie Save.
Pułapka domyślnej kategorii odniesienia
Jeśli pominiesz krok 2, SPSS porówna wszystko z ostatnią kategorią, czyli z „nauką z innymi” (IBM Corp., b.d.-b). Model jest ten sam (−2LL = 544.280), ale tabela parametrów wygląda inaczej. W bloku „dom” ekstrawersja ma B = −1.133 i Exp(B) = 0.322, czyli dokładnie 1 / 3.103. To samo porównanie, tylko odwrócone. Kto przeoczy przypis z kategorią odniesienia, napisze, że ekstrawersja „zmniejsza szanse”.
Zmiana kategorii odniesienia daje też porównanie, którego nie było: biblioteka vs nauka z innymi. Ekstrawersja ma tu Exp(B) = 0.379, 95% CI [0.244, 0.587], p < .001, a studia stacjonarne – 3.057, 95% CI [1.546, 6.042], p = .001. Jeśli hipoteza dotyczy pary bez kategorii odniesienia, uruchom model drugi raz z inną kategorią. Nie wyliczaj takiego porównania „na oko” z dwóch Exp(B).
Classification: trafność bez złudzeń
| Observed | dom | biblioteka | nauka z innymi | Percent Correct |
|---|---|---|---|---|
| dom | 53 | 30 | 19 | 52.0% |
| biblioteka | 21 | 65 | 15 | 64.4% |
| nauka z innymi | 22 | 26 | 29 | 37.7% |
| Overall | 52.5% |
Tabela zestawia kategorie obserwowane z przewidywanymi (IBM Corp., b.d.-d). Model trafia w 52.5% przypadków. Punktem odniesienia jest 36.4%, czyli odsetek najliczniejszej kategorii. Tak trafiałby ktoś, kto zawsze zgaduje „dom”. Najsłabiej rozpoznawana jest najmniej liczna kategoria (37.7%). Trafność liczona na tej samej próbie, na której szacowano model, jest zawyżona. W małych i średnich próbach model wielomianowy łatwo się przeucza (de Jong i in., 2019; zob. EPV). Tabela klasyfikacji to dodatek, a nie dowód jakości modelu.
Wielomianowa czy porządkowa?
Decyduje zmienna zależna, a nie wynik testu.
- Kategorie bez porządku (dom, biblioteka, nauka z innymi) – tylko model wielomianowy. Model porządkowy narzuciłby kolejność, której nie ma.
- Kategorie uporządkowane (np. „słabo – średnio – dobrze”) – najpierw regresja porządkowa w SPSS (procedura Ordinal) albo regresja porządkowa w jamovi. Jest oszczędniejsza: przy trzech kategoriach i trzech predyktorach ma 2 progi i 3 współczynniki, czyli 5 parametrów. Model wielomianowy ma ich 8.
- Kategorie uporządkowane, ale z wyraźnie złamanym założeniem proporcjonalnych szans – model wielomianowy jest jedną z możliwości. Tracisz informację o porządku, ale zyskujesz osobne efekty dla każdej kategorii.
Model wielomianowy ma własne założenie. Iloraz szans dwóch kategorii nie zależy od pozostałych kategorii (IBM Corp., b.d.-a). To tak zwana niezależność od nieistotnych alternatyw (IIA). W opcjach okna, które opisuje dokumentacja, nie ma testu tego założenia. Testy IIA i tak sprawdzają się słabo. W symulacjach Cheng i Long (2007) często odrzucały IIA przy wyraźnie odrębnych kategoriach i nie odrzucały go przy bliskich substytutach. Lepiej uzasadnij merytorycznie, że kategorie są naprawdę różnymi wyborami. Dwóch prawie identycznych kategorii (np. „biblioteka uczelniana” i „biblioteka miejska”) nie zostawiaj osobno.
Zapis wyników w stylu APA
Podaj kategorię odniesienia, test modelu, nazwaną miarę pseudo-R², testy ilorazu wiarygodności predyktorów i Exp(B) z 95% CI dla każdego porównania. O tym, jak pisać o ilorazach szans, żeby nie pomylić ich z ryzykiem, piszemy we wpisie RR, OR i NNT w pracy.
Ostatnie zdanie dopasuj do programu i wersji, których naprawdę użyłeś (zob. jak cytować SPSS i R). Zdania do innych analiz złożysz w generatorze opisu wyników APA.
Składnia NOMREG i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według wykresu składni NOMREG i opisu podkomend w Command Syntax Reference (IBM Corp., b.d.-d), ale nie uruchamialiśmy jej w SPSS. Przepis 2 w R tworzy pliki do pobrania i liczy wszystkie liczby z tabel funkcją nnet::multinom(). Testy z tabeli Likelihood Ratio Tests liczymy ręcznie: dopasowujemy model bez każdego predyktora i porównujemy −2LL. Każda osoba ma tu własny wzorzec predyktorów, więc pełna log-wiarygodność i jej jądro są równe. Ziarno losowania (631) dobraliśmy właśnie tak, żeby nie było powtórzonych wzorców, a efekty przypominały założone w symulacji.
1. Składnia SPSS: NOMREG z kategorią odniesienia „dom”
SPSS
* Składnia zgodna z opisem NOMREG w Command Syntax Reference; nie była uruchamiana w SPSS.
* BASE=FIRST: kategoria odniesienia to pierwsza wartość (1 = dom); domyślnie byłaby ostatnia.
* Brak podkomendy MODEL: model domyślny (wyraz wolny, kowarianty, efekty główne czynników).
NOMREG miejsce (BASE=FIRST ORDER=ASCENDING) WITH ekstrawersja odleglosc stacjonarne
  /CRITERIA CIN(95)
  /INTERCEPT=INCLUDE
  /PRINT=CPS MFI SUMMARY LRT PARAMETER CLASSTABLE
  /SAVE=ESTPROB PREDCAT.
Czynniki dopisuje się po BY, a kowarianty po WITH, np. NOMREG miejsce (BASE=FIRST) BY wydzial WITH ekstrawersja. Zamiast FIRST możesz podać wartość kategorii, np. BASE=1 (IBM Corp., b.d.-d).
2. Te same liczby w R i pliki .sav oraz CSV
R
# Wielomianowa regresja logistyczna – liczby do tabel procedury Multinomial Logistic Regression (NOMREG) w SPSS
# Dane fikcyjne (symulowane): 280 studentów, główne miejsce nauki przed sesją (1 = dom, 2 = biblioteka,
# 3 = nauka z innymi). Predyktory: ekstrawersja (1–5), odległość od uczelni (km), tryb studiów (1 = stacjonarne).
# Ziarno 631 wybrano tak, by każda osoba miała własny wzorzec predyktorów (wtedy pełne −2LL = jądro −2LL).
# Metody jak w NOMREG: największa wiarygodność, test modelu i testy efektów ilorazem wiarygodności,
# Wald = (B / SE)^2, przedziały B ± 1.96 SE, Exp(B), pseudo-R² Coxa i Snella, Nagelkerkego i McFaddena.
suppressPackageStartupMessages({ library(nnet); library(haven) })
options(width = 110)
set.seed(631)
n <- 280
ekstrawersja <- round(pmin(5, pmax(1, rnorm(n, 3.1, 0.75))) * 10) / 10   # średnia z 10 pozycji
odleglosc    <- round(pmin(60, pmax(0.5, rgamma(n, shape = 2, scale = 6))), 1)   # km
stacjonarne  <- rbinom(n, 1, 0.6)
eta_bib <- -0.55 + 1.00 * stacjonarne - 0.07 * (odleglosc - 10) + 0.05 * (ekstrawersja - 3)
eta_wsp <- -0.85 + 0.25 * stacjonarne - 0.01 * (odleglosc - 10) + 1.00 * (ekstrawersja - 3)
P <- cbind(1, exp(eta_bib), exp(eta_wsp)); P <- P / rowSums(P)
miejsce <- apply(P, 1, function(p) sample(1:3, 1, prob = p))
dane <- data.frame(id = 1:n, miejsce, ekstrawersja, odleglosc, stacjonarne)

# 1. Plik .sav z etykietami i ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$miejsce <- labelled(sav$miejsce, labels = c("dom" = 1, "biblioteka" = 2, "nauka z innymi" = 3),
                        label = "Główne miejsce nauki przed sesją")
sav$ekstrawersja <- labelled(sav$ekstrawersja, label = "Ekstrawersja (średnia 1–5)")
sav$odleglosc <- labelled(sav$odleglosc, label = "Odległość od uczelni (km)")
sav$stacjonarne <- labelled(sav$stacjonarne, labels = c("niestacjonarne" = 0, "stacjonarne" = 1),
                            label = "Tryb studiów")
write_sav(sav, "wielomianowa-regresja-spss-dane.sav")
write.csv(dane, "wielomianowa-regresja-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# 2. Case Processing Summary i statystyki opisowe
etyk <- c("dom", "biblioteka", "z innymi")
tab <- table(factor(dane$miejsce, 1:3, etyk))
print(cbind(N = tab, Procent = round(100 * prop.table(tab), 1)))
print(round(sapply(dane[c("ekstrawersja", "odleglosc", "stacjonarne")], function(x) c(M = mean(x), SD = sd(x))), 2))
print(round(aggregate(cbind(ekstrawersja, odleglosc, stacjonarne) ~ miejsce, data = dane, FUN = mean), 2))
wzorce <- nrow(unique(dane[c("ekstrawersja", "odleglosc", "stacjonarne")]))
cat("Liczba wzorców predyktorów (subpopulacji):", wzorce, "na", n, "osób\n")

# 3. Model z kategorią odniesienia „dom” (Reference Category: First)
dane$y <- factor(dane$miejsce, levels = 1:3, labels = etyk)
f <- y ~ ekstrawersja + odleglosc + stacjonarne
m1 <- multinom(f, data = dane, Hess = TRUE, trace = FALSE, maxit = 500, reltol = 1e-12)
m0 <- multinom(y ~ 1, data = dane, Hess = TRUE, trace = FALSE, reltol = 1e-12)
ll1 <- as.numeric(logLik(m1)); ll0 <- as.numeric(logLik(m0)); k <- length(coef(m1))
lr <- 2 * (ll1 - ll0); df_m <- k - length(coef(m0))
cat("\nModel Fitting Information\n")
print(data.frame(Model = c("Intercept Only", "Final"), AIC = round(c(-2 * ll0 + 2 * length(coef(m0)), -2 * ll1 + 2 * k), 3),
                 BIC = round(c(-2 * ll0 + length(coef(m0)) * log(n), -2 * ll1 + k * log(n)), 3),
                 m2LL = round(c(-2 * ll0, -2 * ll1), 3),
                 ChiSq = c(NA, round(lr, 3)), df = c(NA, df_m), Sig = c(NA, signif(pchisq(lr, df_m, lower.tail = FALSE), 3))),
      row.names = FALSE)

# Pseudo R-Square
cs <- 1 - exp(2 * (ll0 - ll1) / n); nag <- cs / (1 - exp(2 * ll0 / n)); mcf <- 1 - ll1 / ll0
cat("\nPseudo R-Square: Cox and Snell =", round(cs, 3), " Nagelkerke =", round(nag, 3), " McFadden =", round(mcf, 3), "\n")

# 4. Likelihood Ratio Tests: model bez danego efektu (ręcznie)
cat("\nLikelihood Ratio Tests\n")
lrt <- t(sapply(c("ekstrawersja", "odleglosc", "stacjonarne"), function(v) {
  mr <- multinom(update(f, paste(". ~ . -", v)), data = dane, trace = FALSE, maxit = 500, reltol = 1e-12)
  llr <- as.numeric(logLik(mr)); chi <- 2 * (ll1 - llr)
  c(m2LL_reduced = round(-2 * llr, 3), ChiSq = round(chi, 3), df = 2, Sig = signif(pchisq(chi, 2, lower.tail = FALSE), 3))
}))
print(lrt)

# 5. Parameter Estimates: B, SE, Wald, df, Sig., Exp(B) i 95% CI dla Exp(B)
parametry <- function(m) {
  b <- coef(m); se <- summary(m)$standard.errors; z <- qnorm(.975)
  out <- do.call(rbind, lapply(rownames(b), function(r) data.frame(
    rownum = r, Parameter = colnames(b), B = round(b[r, ], 3), SE = round(se[r, ], 3),
    Wald = round((b[r, ] / se[r, ])^2, 3), df = 1, Sig = signif(pchisq((b[r, ] / se[r, ])^2, 1, lower.tail = FALSE), 3),
    ExpB = round(exp(b[r, ]), 3), Lower = round(exp(b[r, ] - z * se[r, ]), 3), Upper = round(exp(b[r, ] + z * se[r, ]), 3))))
  rownames(out) <- NULL; out
}
cat("\nParameter Estimates (kategoria odniesienia: dom)\n")
print(parametry(m1))

# Efekt odległości na 5 km
b <- coef(m1)[, "odleglosc"]; s <- summary(m1)$standard.errors[, "odleglosc"]
cat("\nOdległość co 5 km: Exp(5B) =", round(exp(5 * b), 3), " 95% CI dolna =", round(exp(5 * (b - 1.96 * s)), 3),
    " górna =", round(exp(5 * (b + 1.96 * s)), 3), "\n")

# 6. Classification table: kategoria o największym przewidywanym prawdopodobieństwie
pred <- factor(etyk[max.col(fitted(m1), ties.method = "first")], levels = etyk)
ct <- table(Observed = dane$y, Predicted = pred)
print(addmargins(ct, 2))
cat("Percent Correct:", round(100 * diag(ct) / rowSums(ct), 1), " Overall:", round(100 * sum(diag(ct)) / n, 1), "\n")
cat("Odsetek najliczniejszej kategorii (model bez predyktorów):", round(100 * max(tab) / n, 1), "\n")

# 7. Domyślna kategoria odniesienia SPSS: ostatnia („nauka z innymi”) – ten sam model, inne równania
dane$y_last <- relevel(dane$y, ref = "z innymi")
m_last <- multinom(y_last ~ ekstrawersja + odleglosc + stacjonarne, data = dane, Hess = TRUE, trace = FALSE,
                   maxit = 500, reltol = 1e-12)
cat("\n-2LL przy kategorii odniesienia 'z innymi':", round(-2 * as.numeric(logLik(m_last)), 3), "\n")
cat("Parameter Estimates (kategoria odniesienia: nauka z innymi)\n")
print(parametry(m_last))

# 8. Przewidywane prawdopodobieństwa dla typowych osób (odleglosc 30 min, studia stacjonarne)
nowe <- data.frame(ekstrawersja = c(2, 3, 4), odleglosc = 10, stacjonarne = 1)
cat("\nPrzewidywane prawdopodobieństwa (odległość 10 km, stacjonarne):\n")
print(cbind(nowe, round(predict(m1, nowe, type = "probs"), 3)))
cat("Liczba parametrów modelu (bez kategorii odniesienia):", k, "\n")
Wynik w R
             N Procent
dom        102    36.4
biblioteka 101    36.1
z innymi    77    27.5
   ekstrawersja odleglosc stacjonarne
M          3.05     12.23        0.62
SD         0.79      8.65        0.49
  miejsce ekstrawersja odleglosc stacjonarne
1       1         2.86     14.48        0.53
2       2         2.92     10.12        0.78
3       3         3.48     12.04        0.53
Liczba wzorców predyktorów (subpopulacji): 280 na 280 osób

Model Fitting Information
          Model     AIC     BIC    m2LL  ChiSq df      Sig
 Intercept Only 614.787 622.057 610.787     NA NA       NA
          Final 560.280 589.358 544.280 66.507  6 2.12e-12

Pseudo R-Square: Cox and Snell = 0.211  Nagelkerke = 0.238  McFadden = 0.109

Likelihood Ratio Tests
             m2LL_reduced  ChiSq df      Sig
ekstrawersja      576.875 32.595  2 8.36e-08
odleglosc         559.697 15.417  2 4.49e-04
stacjonarne       563.844 19.564  2 5.65e-05

Parameter Estimates (kategoria odniesienia: dom)
      rownum    Parameter      B    SE   Wald df      Sig  ExpB Lower Upper
1 biblioteka  (Intercept) -0.502 0.703  0.509  1 4.75e-01 0.606 0.153 2.400
2 biblioteka ekstrawersja  0.161 0.203  0.631  1 4.27e-01 1.175 0.790 1.747
3 biblioteka    odleglosc -0.070 0.019 13.532  1 2.35e-04 0.933 0.899 0.968
4 biblioteka  stacjonarne  1.311 0.325 16.249  1 5.55e-05 3.711 1.961 7.020
5   z innymi  (Intercept) -3.606 0.803 20.188  1 7.02e-06 0.027 0.006 0.131
6   z innymi ekstrawersja  1.133 0.227 24.981  1 5.79e-07 3.103 1.991 4.838
7   z innymi    odleglosc -0.028 0.018  2.344  1 1.26e-01 0.972 0.938 1.008
8   z innymi  stacjonarne  0.194 0.327  0.351  1 5.53e-01 1.214 0.639 2.305

Odległość co 5 km: Exp(5B) = 0.706 0.869  95% CI dolna = 0.587 0.726  górna = 0.85 1.04
            Predicted
Observed     dom biblioteka z innymi Sum
  dom         53         30       19 102
  biblioteka  21         65       15 101
  z innymi    22         26       29  77
Percent Correct: 52 64.4 37.7  Overall: 52.5
Odsetek najliczniejszej kategorii (model bez predyktorów): 36.4

-2LL przy kategorii odniesienia 'z innymi': 544.28
Parameter Estimates (kategoria odniesienia: nauka z innymi)
      rownum    Parameter      B    SE   Wald df      Sig   ExpB Lower   Upper
1        dom  (Intercept)  3.606 0.803 20.188  1 7.02e-06 36.828 7.638 177.571
2        dom ekstrawersja -1.133 0.227 24.981  1 5.79e-07  0.322 0.207   0.502
3        dom    odleglosc  0.028 0.018  2.344  1 1.26e-01  1.029 0.992   1.066
4        dom  stacjonarne -0.194 0.327  0.351  1 5.53e-01  0.824 0.434   1.564
5 biblioteka  (Intercept)  3.105 0.818 14.413  1 1.47e-04 22.303 4.490 110.783
6 biblioteka ekstrawersja -0.972 0.224 18.881  1 1.39e-05  0.379 0.244   0.587
7 biblioteka    odleglosc -0.041 0.021  3.871  1 4.91e-02  0.959 0.921   1.000
8 biblioteka  stacjonarne  1.117 0.348 10.330  1 1.31e-03  3.057 1.546   6.042

Przewidywane prawdopodobieństwa (odległość 10 km, stacjonarne):
  ekstrawersja odleglosc stacjonarne   dom biblioteka z innymi
1            2        10           1 0.359      0.555    0.086
2            3        10           1 0.281      0.510    0.209
3            4        10           1 0.184      0.392    0.424
Liczba parametrów modelu (bez kategorii odniesienia): 8
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami nnet i haven; rysunki wykonano w pakietach ggplot2 i svglite. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- nnet (wersja 7.3-20): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy
- Domyślna kategoria odniesienia przyjęta bez sprawdzenia. SPSS bierze ostatnią. Ustaw ją w Reference Category albo
BASE=i podaj w opisie. - Wnioski tylko z tabeli parametrów. O istotności predyktora decyduje test z tabeli Likelihood Ratio Tests (2 df). Pojedyncze p mówią o konkretnych porównaniach.
- Exp(B) czytany jak iloraz prawdopodobieństw albo jako szansa „wobec wszystkich innych”. To szansa względem kategorii odniesienia.
- Zmienna nominalna 1–3 jako kowarianta. Liczbowe kody kategorii (np. wydział) wstaw do czynników, inaczej SPSS potraktuje je jak skalę.
- Bardzo duże Exp(B) i błędy standardowe. Często to objaw separacji, np. gdy w jakiejś kombinacji nikt nie wybrał danej kategorii. Połącz rzadkie kategorie predyktora albo uprość model.
- Kategoria wybrana przez kilka osób. Każda kategoria to osobne równanie. Bardzo rzadką połącz z merytorycznie bliską przed analizą i opisz to w pracy (zob. przygotowanie danych w SPSS).
Gdy nie wiesz, czy Twoja zmienna wymaga modelu wielomianowego, porządkowego czy binarnego, sprawdź to w kreatorze wyboru testu.
Najczęstsze pytania
Gdzie w SPSS jest wielomianowa regresja logistyczna?
W menu Analyze → Regression → Multinomial Logistic Regression..., w polskiej dokumentacji IBM: Analiza → Regresja → Wielomianowa regresja logistyczna... Wybierasz jedną zmienną zależną, a predyktory przenosisz do czynników (zmienne kategorialne) albo kowariant (zmienne liczbowe). Według IBM procedura wymaga edycji Standard albo opcji Regression (IBM Corp., b.d.-a). Składnia tej procedury to NOMREG.
Którą kategorię SPSS przyjmuje jako odniesienie w regresji wielomianowej?
Domyślnie ostatnią, czyli kategorię o najwyższej wartości przy kolejności rosnącej (IBM Corp., b.d.-b). Zmienisz to przyciskiem Reference Category (First, Last albo Custom) lub w składni: NOMREG y (BASE=FIRST). Zmiana kategorii odniesienia nie zmienia dopasowania modelu, ale odwraca lub zmienia porównania w tabeli Parameter Estimates.
Czym różni się tabela Likelihood Ratio Tests od Parameter Estimates?
Likelihood Ratio Tests sprawdza każdy predyktor jako całość: porównuje model pełny z modelem bez tego predyktora (przy trzech kategoriach χ² ma 2 df). Parameter Estimates podaje osobny współczynnik B, test Walda i Exp(B) dla każdego porównania z kategorią odniesienia. W przykładzie ekstrawersja jest istotna w teście LR, χ²(2) = 32.60, ale tylko w porównaniu nauki z innymi z domem.
Jak czytać Exp(B) w wielomianowej regresji logistycznej w SPSS?
Exp(B) to iloraz szans wyboru danej kategorii zamiast kategorii odniesienia przy wzroście predyktora o jednostkę i stałych pozostałych predyktorach. W przykładzie studenci stacjonarni mieli 3.71 raza większą szansę wyboru biblioteki zamiast nauki w domu, 95% CI [1.96, 7.02]. To nie jest iloraz prawdopodobieństw ani szansa wobec wszystkich pozostałych kategorii.
Czy SPSS testuje założenie IIA w regresji wielomianowej?
Dokumentacja IBM wymienia to założenie, ale w opisanych opcjach okna Multinomial Logistic Regression nie ma testu IIA (IBM Corp., b.d.-a, b.d.-c). Popularne testy IIA działają zresztą zawodnie (Cheng i Long, 2007). Uzasadnij w pracy merytorycznie, że kategorie są odrębnymi wyborami, i nie zostawiaj osobno kategorii, które są prawie tym samym.
Powiązane hasła
Przeczytaj też
Wielomianowa regresja logistyczna
Kategoria odniesienia, RRR, test predyktorów, prawdopodobieństwa przewidywane, założenie IIA i tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikRegresja porządkowa w SPSS
Ordinal Regression (PLUM) krok po kroku: funkcja wiązania, pseudo-R², progi i znak współczynników, OR = exp(B), test równoległości linii i zapis APA.
Czytaj →PoradnikRegresja logistyczna w SPSS
Binary Logistic krok po kroku: kategoria odniesienia, Hosmer–Lemeshow, pseudo-R², tabela klasyfikacji, Exp(B) z przedziałami ufności i zapis APA.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →Masz zmienną z kilkoma kategoriami i nie wiesz, jak opisać model z SPSS?
Sprawdzimy model, kategorię odniesienia i opis wyników oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cheng, S., & Long, J. S. (2007). Testing for IIA in the multinomial logit model. Sociological Methods & Research, 35(4), 583–600. https://doi.org/10.1177/0049124106292361
- de Jong, V. M. T., Eijkemans, M. J. C., van Calster, B., Timmerman, D., Moons, K. G. M., Steyerberg, E. W., & van Smeden, M. (2019). Sample size considerations and predictive performance of multinomial logistic prediction models. Statistics in Medicine, 38(9), 1601–1619. https://doi.org/10.1002/sim.8063 ● Otwarty dostęp
- IBM Corp. (2026). odds ratio exp(B) is 1 but variable is significant. IBM Support. https://www.ibm.com/support/pages/odds-ratio-expb-1-variable-significant ● Otwarty dostęp
- IBM Corp. (b.d.-a). Multinomial Logistic Regression (Multinomial Logistic Regression Models; Multinomial Logistic Regression Save). IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=regression-multinomial-logistic ● Otwarty dostęp
- IBM Corp. (b.d.-b). Multinomial Logistic Regression Reference Category. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/regression/idh_mnlr_rfct.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). Multinomial Logistic Regression Statistics. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/regression/idh_mnlr_stat.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). NOMREG. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-nomreg ● Otwarty dostęp
- Kwak, C., & Clayton-Matthews, A. (2002). Multinomial logistic regression. Nursing Research, 51(6), 404–410. https://doi.org/10.1097/00006199-200211000-00009
Cytowania BibTeX
@article{cheng2007testing, author={Cheng, Simon and Long, J. Scott}, title={{Testing for IIA in the multinomial logit model}}, journal={Sociological Methods \& Research}, year={2007}, volume={35}, number={4}, pages={583--600}, doi={10.1177/0049124106292361}}@article{dejong2019sample, author={de Jong, Valentijn M. T. and Eijkemans, Marinus J. C. and van Calster, Ben and Timmerman, Dirk and Moons, Karel G. M. and Steyerberg, Ewout W. and van Smeden, Maarten}, title={{Sample size considerations and predictive performance of multinomial logistic prediction models}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={9}, pages={1601--1619}, doi={10.1002/sim.8063}}@misc{ibm2026expb, author={{IBM Corp.}}, title={{odds ratio exp(B) is 1 but variable is significant}}, howpublished={IBM Support}, year={2026}, publisher={IBM}, url={https://www.ibm.com/support/pages/odds-ratio-expb-1-variable-significant}}@misc{ibmnd32nomreg, author={{IBM Corp.}}, title={{Multinomial Logistic Regression (Multinomial Logistic Regression Models; Multinomial Logistic Regression Save)}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=regression-multinomial-logistic}}@misc{ibmnd32nomregref, author={{IBM Corp.}}, title={{Multinomial Logistic Regression Reference Category}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/regression/idh_mnlr_rfct.html}}@misc{ibmnd32nomregstat, author={{IBM Corp.}}, title={{Multinomial Logistic Regression Statistics}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/regression/idh_mnlr_stat.html}}@misc{ibmnd32nomregskladnia, author={{IBM Corp.}}, title={{NOMREG}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-nomreg}}@article{kwak2002multinomial, author={Kwak, Chanyeong and Clayton-Matthews, Alan}, title={{Multinomial logistic regression}}, journal={Nursing Research}, year={2002}, volume={51}, number={6}, pages={404--410}, doi={10.1097/00006199-200211000-00009}}