Gdzie jest regresja porządkowa w jamovi
Regresja porządkowa przewiduje odpowiedź o kilku uporządkowanych kategoriach, np. „na pewno nie – raczej nie – raczej tak – na pewno tak”. Logikę modelu proporcjonalnych szans, interpretację ilorazów szans i prawdopodobieństw opisuje wpis regresja porządkowa krok po kroku, a definicję – hasło regresja porządkowa. Tutaj zajmujemy się tylko jamovi.
W jamovi analiza jest w menu Analyses → Regression → Ordinal Outcomes, w grupie Logistic Regression, obok regresji dwumianowej (2 Outcomes) i wielomianowej (N Outcomes) (The jamovi project, b.d.). Okno nazywa się Ordinal Logistic Regression. Nazwy opcji podajemy po angielsku według dokumentacji jamovi i plików definicji analizy w pakiecie jmv 2.7.7, a polskie – według pliku tłumaczeń jmv (Selker i in., 2025). W Twojej wersji etykiety mogą się nieco różnić. Okno regresji dwumianowej, z którym to okno dzieli większość sekcji, opisuje wpis regresja logistyczna w jamovi, a ten sam model w SPSS – regresja porządkowa w SPSS.
Przykład i pliki do pobrania
Liczby pochodzą z jednego zbioru symulowanego (dane fikcyjne). 300 studentów ostatniego roku studiów licencjackich odpowiedziało na pytanie „Czy planujesz studia drugiego stopnia?” (1 = na pewno nie, 2 = raczej nie, 3 = raczej tak, 4 = na pewno tak). Predyktory: średnia ocen (3.00–5.00), zadowolenie z kierunku (1–7) i praca zarobkowa (nie, dorywcza, etatowa). Odpowiedzi rozłożyły się tak: 70 (23.3%), 84 (28.0%), 95 (31.7%) i 51 (17.0%) osób.
Pobierz plik CSV albo plik .sav z etykietami wartości i powtarzaj kroki w jamovi. Kolumny: id, plan (kody 1–4), srednia, zadowolenie i praca. Dane symulowaliśmy tak, żeby założenie proporcjonalnych szans było naruszone dla pracy etatowej: ziarno set.seed(5520) wybraliśmy spośród 31 sprawdzonych tak, żeby test wykrył to naruszenie tylko dla pracy.
Kolejność kategorii: najważniejszy krok
Model porządkowy korzysta wyłącznie z kolejności odpowiedzi. Jeśli jest zła, wszystkie liczby tracą sens. W tym oknie kolejności poziomów zmiennej zależnej nie ustawisz: sekcja Reference Levels obejmuje tylko zmienne z pola Factors, a kod jmv bierze kolejność wprost z danych (Selker i in., 2025). Ustawiasz ją więc w arkuszu:
- Zmienna
planma mieć typ pomiaru Ordinal (skala porządkowa). Typ, etykiety poziomów i ich kolejność zmienisz w edytorze zmiennej po dwukliku na nagłówku kolumny. Poziom na górze listy jest pierwszy w tabelach (The jamovi project, b.d.). Przy kodach 1–4 przypisz im etykiety i sprawdź, czy „na pewno nie” jest na górze. - Etykiety tekstowe bywają ułożone w innej kolejności niż rosnąca. Dokumentacja jamovi pokazuje taki przykład (poziomy Low, High, Medium) i radzi przesunąć je strzałkami w edytorze (The jamovi project, b.d.).
sredniaizadowoleniemają typ Continuous, apraca– Nominal. Jak ustawić typy i braki danych, opisuje wpis przygotowanie danych w jamovi.
Jak bardzo to ważne? W R wczytaliśmy te same odpowiedzi jako tekst, bez ustawiania poziomów. Powstała kolejność alfabetyczna: „na pewno nie”, „na pewno tak”, „raczej nie”, „raczej tak”. Model na takich danych dał dla średniej ocen 0.76 zamiast 1.56, a praca etatowa zmieniła znak z −0.52 na +0.16 (przepis 2). Dlatego po każdym uruchomieniu czytaj notę pod tabelą Model Fit Measures: „The dependent variable 'plan' has the following order: …” (po polsku „Poziomy zmiennej zależnej … mają następującą kolejność”).
Okno Ordinal Outcomes krok po kroku
- Analyses → Regression → Ordinal Outcomes (po polsku: Regresja → Porządkowa).
- Dependent Variable (Zmienna zależna):
plan. Gdy zmienna ma tylko dwa poziomy, analiza się zatrzymuje i odsyła do regresji dwumianowej (Selker i in., 2025). - Covariates (Współzmienne):
sredniaizadowolenie. Factors (Czynniki):praca. - Model Builder (Kreator modelu): predyktory trafiają do Block 1. Kolejne bloki tworzą modele hierarchiczne i tabelę Model Comparisons (Selker i in., 2025). Tu jeden blok.
- Reference Levels (Poziomy referencyjne): dla
pracawybierz nie. Każdy poziom czynnika jest wtedy porównywany z osobami bez pracy. - Model Fit (Dopasowanie modelu): Deviance i AIC są zaznaczone domyślnie; dodaj Overall model test. W Pseudo R² domyślne jest McFadden's R², dla porównania z SPSS możesz dodać Nagelkerke's R².
- Model Coefficients (Współczynniki modelu): Omnibus Tests → Likelihood ratio tests, Thresholds → Model thresholds, przy Estimate (Log Odds Ratio) – Confidence interval, a przy Odds Ratio – Odds ratio i Confidence interval.
Więcej opcji okno nie ma: brak w nim testu proporcjonalnych szans, przewidywanych prawdopodobieństw i wykresów (Selker i in., 2025). Tabele poniżej pokazujemy w układzie jamovi. Liczby policzyliśmy funkcją jmv::logRegOrd, czyli tym samym kodem, który uruchamia program. Pogrubione są liczby, które trafią do pracy.
Tabela Model Fit Measures
| Model | Deviance | AIC | R²McF | R²N | Overall Model Test | ||
|---|---|---|---|---|---|---|---|
| χ² | df | p | |||||
| 1 | 760.109 | 774.109 | .069 | .093 | 56.711 | 4 | < .001 |
Pod tabelą są dwie noty: kolejność poziomów (na pewno nie | raczej nie | raczej tak | na pewno tak) i N = 300. Do analizy trafiają tylko osoby z kompletem danych (Selker i in., 2025), więc przy brakach N będzie mniejsze niż liczba wierszy.
Overall Model Test to test ilorazu wiarygodności: różnica dewiancji modelu z samymi progami i modelu z predyktorami (Selker i in., 2025). Model z czterema współczynnikami jest lepszy od pustego, χ²(4) = 56.71, p < .001. Kolumna Deviance to dewiancja (−2LL). Polski plik tłumaczeń nazywa ją „Odchyleniem” – w pracy pisz o dewiancji. Pseudo-R² McFaddena wynosi .069, Nagelkerkego .093. To nie odsetki wyjaśnionej wariancji; podaj jedną miarę z nazwą.
Tabele Model Coefficients i Omnibus Likelihood Ratio Tests
| Predictor | Estimate | 95% Confidence Interval | SE | Z | p | Odds ratio | 95% Confidence Interval | ||
|---|---|---|---|---|---|---|---|---|---|
| Lower | Upper | Lower | Upper | ||||||
| srednia | 1.564 | 1.038 | 2.106 | 0.272 | 5.748 | < .001 | 4.779 | 2.822 | 8.214 |
| zadowolenie | 0.313 | 0.160 | 0.469 | 0.079 | 3.981 | < .001 | 1.367 | 1.174 | 1.598 |
| praca: | |||||||||
| dorywcza – nie | −0.050 | −0.571 | 0.471 | 0.265 | −0.188 | .851 | 0.951 | 0.565 | 1.601 |
| etatowa – nie | −0.517 | −1.022 | −0.016 | 0.257 | −2.015 | .044 | 0.596 | 0.360 | 0.984 |
Estimate to zmiana logarytmu szans skumulowanych, a Odds ratio = eEstimate (iloraz szans). Z = Estimate / SE to test Walda. Dodatni współczynnik oznacza przesunięcie odpowiedzi w stronę kategorii z końca listy, czyli „na pewno tak”. Każdy punkt średniej ocen (np. 3.5 wobec 4.5) zwiększa szanse odpowiedzi wyższej niż dowolny próg 4.78 razy, 95% CI [2.82, 8.21]. Punkt zadowolenia z kierunku – 1.37 razy [1.17, 1.60]. Praca etatowa obniża te szanse: OR = 0.60 [0.36, 0.98], p = .044, a praca dorywcza nie różni się od braku pracy (OR = 0.95, p = .851).
Przedziały ufności w tym oknie to przedziały z profilu wiarygodności: kod jmv wywołuje confint dla modelu polr (Selker i in., 2025). Dlatego są lekko asymetryczne wokół OR i różnią się od przedziałów Walda. Dla średniej ocen przedział Walda wynosi [2.80, 8.15] (przepis 2). W oknie regresji dwumianowej przedziały są przedziałami Walda (zob. regresja logistyczna w jamovi) – opisując oba modele, nie dziw się różnicy.
| Predictor | χ² | df | p |
|---|---|---|---|
| srednia | 35.014 | 1 | < .001 |
| zadowolenie | 16.300 | 1 | < .001 |
| praca | 5.001 | 2 | .082 |
Testy omnibus to testy ilorazu wiarygodności dla całych predyktorów (w kodzie jmv: car::Anova, typ III). Czynnik praca ma dwa współczynniki, więc test ma 2 stopnie swobody. Wynik χ²(2) = 5.00, p = .082 mówi, że praca jako całość nie poprawia modelu istotnie, choć porównanie „etatowa – nie” ma p = .044. W pracy podaj najpierw test dla całego czynnika, a porównania poziomów jako uzupełnienie.
Model Thresholds i kierunek znaku
| Threshold | Estimate | SE | Z | p | Odds ratio |
|---|---|---|---|---|---|
| na pewno nie | raczej nie | 6.082 | 1.113 | 5.464 | < .001 | 437.688 |
| raczej nie | raczej tak | 7.508 | 1.141 | 6.581 | < .001 | 1821.718 |
| raczej tak | na pewno tak | 9.249 | 1.180 | 7.837 | < .001 | 10397.768 |
Progi (τ) to punkty cięcia na osi logitu dla osoby z zerowymi wartościami predyktorów. Tu oznacza to średnią ocen 0 i zadowolenie 0, czyli poza zakresem danych. Dlatego progi są duże, a ich p i Odds ratio nie mają interpretacji. Wystarczy sprawdzić, że rosną. Progi przydają się do prawdopodobieństw.
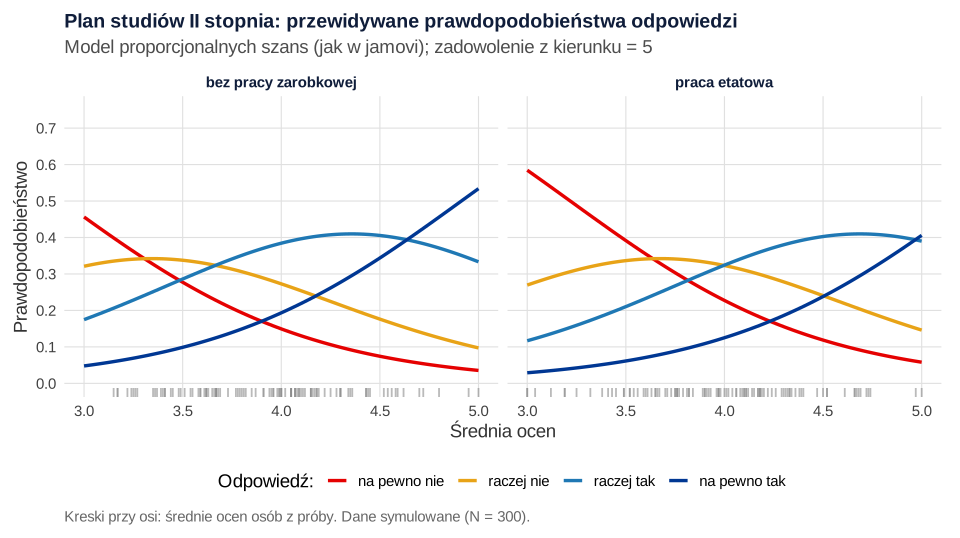
jamovi liczy model funkcją MASS::polr (Selker i in., 2025), więc równanie ma postać logit P(Y ≤ k) = τk − (b1·średnia + b2·zadowolenie + …). Weźmy studenta ze średnią 4.0, zadowoleniem 5, bez pracy. Suma b·x to 1.564 × 4 + 0.313 × 5 = 7.82. Stąd P(Y ≤ „na pewno nie”) = logit−1(6.08 − 7.82) = .149. Pełny rozkład odpowiedzi w R: .149, .273, .384 i .193. Ten sam student z pracą etatową: .227, .323, .324 i .125. Łącznie „raczej” lub „na pewno tak” deklaruje .58 wobec .45 (przepis 2). Rysunek 1 pokazuje te prawdopodobieństwa w całym zakresie średniej.
Kierunek znaku. Znak współczynnika zależy od dwóch rzeczy: zapisu modelu w programie i kolejności kategorii. SPSS (procedura PLUM) używa tego samego zapisu τ − b·x co jamovi (zob. regresja porządkowa w SPSS). Pakiet VGAM w R zapisuje model jako τ + b·x i dla tych samych danych podaje −1.564 dla średniej i +0.517 dla pracy etatowej przy identycznych progach. Odwrócenie kolejności kategorii („na pewno tak” na początku listy) w jamovi też odwraca znaki współczynników, a progi zmieniają znak i kolejność: −9.25, −7.51, −6.08 (przepis 2). Zanim porównasz wynik z artykułem albo z innym programem, sprawdź, co oznacza dodatni współczynnik.
Założenie proporcjonalnych szans – sprawdzenie poza jamovi
Model zakłada, że predyktor tak samo zmienia szanse przekroczenia każdego progu skali (założenie proporcjonalnych szans). McCullagh (1980) uznał ten model za jeden z najbardziej użytecznych dla danych porządkowych. W oknie Ordinal Outcomes w jmv 2.7.7 nie ma testu tego założenia (Selker i in., 2025). W SPSS odpowiada mu test równoległości linii; przy jamovi policz go w R na tych samych danych.
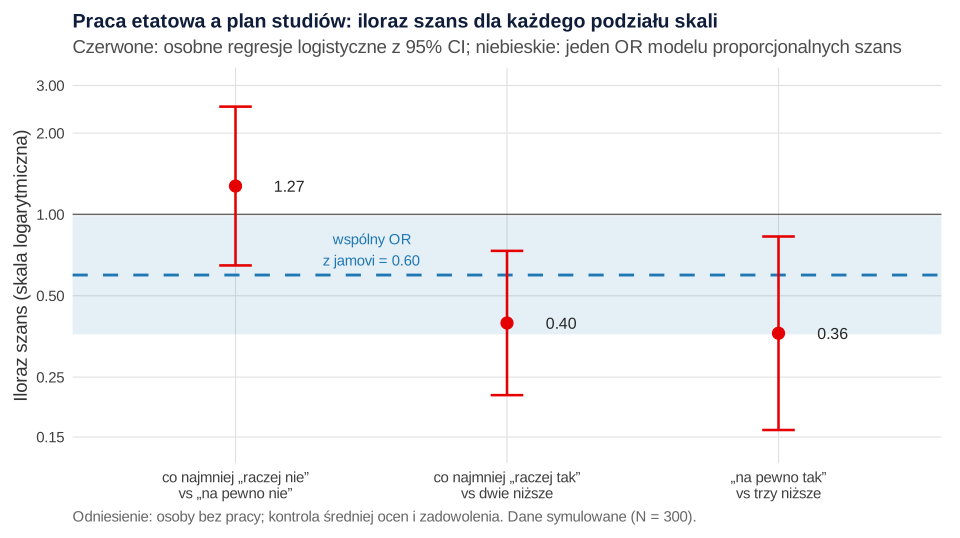
Brant (1990) zauważył, że model proporcjonalnych szans to seria regresji logistycznych dla kolejnych podziałów skali ze wspólnymi współczynnikami. Jego test porównuje osobne dopasowania tych regresji. W naszych danych test ogólny nie jest istotny, χ²(8) = 12.69, p = .123. Test dla pracy etatowej jest jednak wyraźny, χ²(2) = 12.02, p = .002, a dla średniej ocen (p = .815), zadowolenia (p = .792) i pracy dorywczej (p = .440) – nie. Test ilorazu wiarygodności z pakietu ordinal (nominal_test) daje to samo: dla pracy χ²(4) = 12.80, p = .012. Patrz więc na testy dla predyktorów, nie tylko na test ogólny.
Co oznacza to naruszenie, widać na rysunku 2. Osobne regresje logistyczne dają dla pracy etatowej OR = 1.27 przy podziale „na pewno nie” kontra reszta, ale 0.40 i 0.36 przy dwóch wyższych podziałach. Praca etatowa nie wiąże się wyraźnie z wykluczaniem studiów (przedział tego OR obejmuje 1), za to zmniejsza szanse deklaracji „raczej tak” i „na pewno tak”. Wspólny OR = 0.60 z jamovi uśrednia te dwa różne efekty.
Co zrobić, gdy założenie jest naruszone? Fullerton (2009) przypomina, że model proporcjonalnych szans to tylko jeden z wielu modeli logistycznych dla porządkowej zmiennej zależnej, różniących się tym, dla których zmiennych przyjmuje się to założenie. Najczęściej wystarcza model częściowo proporcjonalnych szans (Peterson i Harrell, 1990): osobne współczynniki dostaje tylko predyktor naruszający założenie. W R policzysz go funkcją clm z argumentem nominal (pakiet ordinal). W przykładzie OR pracy etatowej dla trzech progów wynoszą 1.30, 0.42 i 0.35, AIC spada z 774.11 do 769.31, a OR średniej ocen (4.98) i zadowolenia (1.38) prawie się nie zmieniają. Jeśli zostajesz przy modelu z jamovi, opisz naruszenie i podaj OR dla progów jako uzupełnienie. Ostatecznością jest regresja wielomianowa, która pomija kolejność kategorii (wielomianowa regresja logistyczna, w SPSS – wielomianowa regresja logistyczna w SPSS). W dużej próbie test wykryje drobne różnice, a w małej przeoczy duże – oceniaj też, jak bardzo różnią się OR.
Zapis wyników w stylu APA
Podaj kodowanie i kolejność kategorii, test całego modelu, jedną miarę pseudo-R², OR z przedziałami i wynik sprawdzenia założenia. W metodzie wpisz wersję jamovi. Wzór do dostosowania:
Obok ilorazów szans pokaż prawdopodobieństwa dla typowych profili (rysunek 1). Zdania do innych analiz przygotuje generator opisu wyników APA.
To samo w R (pakiet jmv)
Pakiet jmv zawiera analizy jamovi, więc przepis 1 daje te same tabele co okno Ordinal Outcomes (Selker i in., 2025). Argumenty funkcji logRegOrd odpowiadają opcjom okna: covs i factors to pola predyktorów, blocks – Model Builder, refLevels – Reference Levels, a dalej modelTest, pseudoR2, omni, thres, ci, OR i ciOR. Liczby we wpisie pochodzą z tego kodu, nie z uruchomienia jamovi. Przepis 2 to kontrola w MASS, kierunek znaku i sprawdzenie proporcjonalnych szans, a przepis 3 tworzy pliki. Tabele wyników są szerokie: przewiń je w poziomie.
1. Okno Ordinal Outcomes funkcją jmv::logRegOrd
R
# To samo w R: okno Analyses → Regression → Ordinal Outcomes wykonane pakietem jmv (silnik analiz jamovi)
library(jmv)
dane <- read.csv("regresja-porzadkowa-w-jamovi-dane.csv")
# Kolejność poziomów zmiennej zależnej ustawiamy jawnie: od „na pewno nie” do „na pewno tak”
dane$plan <- factor(dane$plan, levels = 1:4,
                    labels = c("na pewno nie", "raczej nie", "raczej tak", "na pewno tak"))
dane$praca <- factor(dane$praca, levels = c("nie", "dorywcza", "etatowa"))

# 1. Exploration → Descriptives: tabela częstości zmiennej zależnej
descriptives(data = dane, vars = "plan", freq = TRUE, n = FALSE, missing = FALSE,
             mean = FALSE, median = FALSE, sd = FALSE, min = FALSE, max = FALSE)

# 2. Ordinal Outcomes: dwie kowarianty, czynnik „praca” z poziomem referencyjnym „nie”
logRegOrd(data = dane, dep = "plan",
          covs = c("srednia", "zadowolenie"), factors = "praca",
          blocks = list(list("srednia", "zadowolenie", "praca")),
          refLevels = list(list(var = "praca", ref = "nie")),
          modelTest = TRUE, pseudoR2 = c("r2mf", "r2n"),
          omni = TRUE, thres = TRUE, ci = TRUE, OR = TRUE, ciOR = TRUE)
Wynik:
 DESCRIPTIVES

 FREQUENCIES

 Frequencies of plan
 ────────────────────────────────────────────────────────
   plan            Counts    % of Total    Cumulative %
 ────────────────────────────────────────────────────────
   na pewno nie        70      23.33333        23.33333
   raczej nie          84      28.00000        51.33333
   raczej tak          95      31.66667        83.00000
   na pewno tak        51      17.00000       100.00000
 ────────────────────────────────────────────────────────

Waiting for profiling to be done...
Waiting for profiling to be done...

 ORDINAL LOGISTIC REGRESSION

 Model Fit Measures
 ─────────────────────────────────────────────────────────────────────────────────────────────
   Model    Deviance    AIC         R²-McF        R²-N          χ²          df    p
 ─────────────────────────────────────────────────────────────────────────────────────────────
       1    760.1092    774.1092    0.06942887    0.09349207    56.71090     4    < .0000001
 ─────────────────────────────────────────────────────────────────────────────────────────────
   Note. The dependent variable 'plan' has the following order: na pewno nie | raczej nie
   | raczej tak | na pewno tak
   Note. Models estimated using sample size of N=300


 MODEL SPECIFIC RESULTS

 MODEL 1

 Omnibus Likelihood Ratio Tests
 ────────────────────────────────────────────────
   Predictor      χ²           df    p
 ────────────────────────────────────────────────
   srednia        35.013577     1    < .0000001
   zadowolenie    16.300268     1     0.0000541
   praca           5.000560     2     0.0820620
 ────────────────────────────────────────────────


 Model Coefficients - plan
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Predictor         Estimate       Lower         Upper          SE            Z             p             Odds ratio    Lower        Upper
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   srednia            1.56426575     1.0375796     2.10587788    0.27212957     5.7482389    < .0000001     4.7791646    2.8223774    8.2143110
   zadowolenie        0.31282535     0.1600825     0.46857244    0.07858783     3.9805828     0.0000687     1.3672827    1.1736077    1.5977117
   praca:
   dorywcza – nie    -0.04995349    -0.5709709     0.47057150    0.26543021    -0.1881982     0.8507213     0.9512737    0.5649766    1.6009089
   etatowa – nie     -0.51691482    -1.0221936    -0.01565254    0.25651788    -2.0151220     0.0438919     0.5963576    0.3598048    0.9844693
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────


 Model Thresholds
 ─────────────────────────────────────────────────────────────────────────────────────────────
   Threshold                    Estimate    SE          Z           p             Odds ratio
 ─────────────────────────────────────────────────────────────────────────────────────────────
   na pewno nie | raczej nie    6.081506    1.113078    5.463685    < .0000001      437.6878
   raczej nie | raczej tak      7.507536    1.140825    6.580798    < .0000001     1821.7184
   raczej tak | na pewno tak    9.249346    1.180206    7.837062    < .0000001    10397.7675
 ─────────────────────────────────────────────────────────────────────────────────────────────
2. Kontrola: MASS::polr, kierunek znaku i proporcjonalne szanse
R
# Kontrola liczb z jamovi (MASS::polr) i to, czego okno Ordinal Outcomes nie liczy
suppressPackageStartupMessages({library(MASS); library(ordinal); library(VGAM); library(brant)})
dane <- read.csv("regresja-porzadkowa-w-jamovi-dane.csv")
etyk <- c("na pewno nie", "raczej nie", "raczej tak", "na pewno tak")
dane$plan <- factor(dane$plan, levels = 1:4, labels = etyk, ordered = TRUE)
dane$praca <- factor(dane$praca, levels = c("nie", "dorywcza", "etatowa"))

# 1. Ten sam model w MASS::polr: logit P(Y ≤ k) = τk − (b1·średnia + b2·zadowolenie + b3·dorywcza + b4·etatowa)
m <- polr(plan ~ srednia + zadowolenie + praca, data = dane, Hess = TRUE)
print(round(c(coef(m), m$zeta), 4))
ci_profil <- suppressMessages(confint(m))         # przedziały z profilu wiarygodności (jak w jamovi)
ci_wald <- confint.default(m)[names(coef(m)), ]   # przedziały Walda: b ± 1.96 × SE
print(round(cbind(OR = exp(coef(m)), exp(ci_profil), exp(ci_wald)), 3))

# 2. Od współczynników do prawdopodobieństw: średnia 4.0, zadowolenie 5, bez pracy i z pracą etatową
profil <- data.frame(srednia = 4, zadowolenie = 5, praca = factor(c("nie", "etatowa"), levels = levels(dane$praca)))
eta <- sum(coef(m)[c("srednia", "zadowolenie")] * c(4, 5))
cat("Ręcznie, bez pracy: P(Y ≤ k) =", round(plogis(m$zeta - eta), 3), "\n")
print(round(predict(m, newdata = profil, type = "probs"), 3))

# 3. Kierunek znaku: VGAM (logit P(Y ≤ k) = τk + b·x) i odwrócona kolejność kategorii
mv <- vglm(plan ~ srednia + zadowolenie + praca, family = cumulative(parallel = TRUE), data = dane)
print(round(coef(mv), 4))
dane$plan_odwr <- factor(dane$plan, levels = rev(etyk), ordered = TRUE)
m_odwr <- polr(plan_odwr ~ srednia + zadowolenie + praca, data = dane)
print(round(c(coef(m_odwr), m_odwr$zeta), 4))

# 4. Kolejność alfabetyczna (np. etykiety tekstowe wczytane bez ustawienia poziomów)
dane$plan_alfa <- factor(as.character(dane$plan))
print(levels(dane$plan_alfa))
m_alfa <- polr(plan_alfa ~ srednia + zadowolenie + praca, data = dane)
print(round(coef(m_alfa), 4))

# 5. Założenie proporcjonalnych szans: test Branta i test ilorazu wiarygodności (ordinal::nominal_test)
invisible(capture.output(bt <- brant(m)))   # wynik bez wydruku funkcji, z p do trzech miejsc
print(round(bt, 3))
m_clm <- clm(plan ~ srednia + zadowolenie + praca, data = dane)
print(nominal_test(m_clm))

# 6. Osobne regresje logistyczne dla trzech podziałów skali: OR pracy etatowej względem braku pracy
for (k in 2:4) {
  g <- glm(as.numeric(plan) >= k ~ srednia + zadowolenie + praca, family = binomial, data = dane)
  cat(sprintf("Y ≥ %-13s OR etatowa = %.3f [%.3f, %.3f]\n", etyk[k], exp(coef(g)["pracaetatowa"]),
              exp(confint.default(g)["pracaetatowa", 1]), exp(confint.default(g)["pracaetatowa", 2])))
}

# 7. Model częściowo proporcjonalnych szans: osobne efekty pracy dla progów (argument nominal)
m_cz <- clm(plan ~ srednia + zadowolenie, nominal = ~ praca, data = dane)
print(anova(m_clm, m_cz))
b_et <- coef(m_cz)[grep("pracaetatowa", names(coef(m_cz)))]
cat("OR pracy etatowej dla P(Y > k):", round(exp(-b_et), 3), "\n")   # w clm efekt nominalny przesuwa próg, stąd minus
print(round(exp(coef(m_cz)[c("srednia", "zadowolenie")]), 3))
Wynik:
                srednia             zadowolenie           pracadorywcza            pracaetatowa
                 1.5643                  0.3128                 -0.0500                 -0.5169
na pewno nie|raczej nie   raczej nie|raczej tak raczej tak|na pewno tak
                 6.0815                  7.5075                  9.2493
                 OR 2.5 % 97.5 % 2.5 % 97.5 %
srednia       4.779 2.822  8.214 2.804  8.147
zadowolenie   1.367 1.174  1.598 1.172  1.595
pracadorywcza 0.951 0.565  1.601 0.565  1.600
pracaetatowa  0.596 0.360  0.984 0.361  0.986
Ręcznie, bez pracy: P(Y ≤ k) = 0.149 0.422 0.807
  na pewno nie raczej nie raczej tak na pewno tak
1        0.149      0.273      0.384        0.193
2        0.227      0.323      0.324        0.125
(Intercept):1 (Intercept):2 (Intercept):3       srednia   zadowolenie pracadorywcza  pracaetatowa
       6.0815        7.5075        9.2493       -1.5643       -0.3128        0.0500        0.5169
                srednia             zadowolenie           pracadorywcza            pracaetatowa
                -1.5642                 -0.3128                  0.0500                  0.5169
na pewno tak|raczej tak   raczej tak|raczej nie raczej nie|na pewno nie
                -9.2493                 -7.5074                 -6.0814
[1] "na pewno nie" "na pewno tak" "raczej nie"   "raczej tak"
      srednia   zadowolenie pracadorywcza  pracaetatowa
       0.7584        0.1791        0.1464        0.1600
                  X2 df probability
Omnibus       12.694  8       0.123
srednia        0.408  2       0.815
zadowolenie    0.467  2       0.792
pracadorywcza  1.643  2       0.440
pracaetatowa  12.020  2       0.002
Tests of nominal effects

formula: plan ~ srednia + zadowolenie + praca
            Df  logLik    AIC     LRT Pr(>Chi)
<none>         -380.05 774.11
srednia      2 -379.99 777.97  0.1352  0.93463
zadowolenie  2 -379.91 777.82  0.2897  0.86515
praca        4 -373.66 769.31 12.7973  0.01231 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Y ≥ raczej nie    OR etatowa = 1.274 [0.647, 2.506]
Y ≥ raczej tak    OR etatowa = 0.396 [0.214, 0.733]
Y ≥ na pewno tak  OR etatowa = 0.363 [0.159, 0.828]
Likelihood ratio tests of cumulative link models:

      formula:                             nominal: link: threshold:
m_clm plan ~ srednia + zadowolenie + praca ~1       logit flexible
m_cz  plan ~ srednia + zadowolenie         ~praca   logit flexible

      no.par    AIC  logLik LR.stat df Pr(>Chisq)
m_clm      7 774.11 -380.05
m_cz      11 769.31 -373.66  12.797  4    0.01231 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
OR pracy etatowej dla P(Y > k): 1.298 0.419 0.353
    srednia zadowolenie
      4.977       1.379
3. Dane symulowane i pliki CSV oraz .sav
R
# Dane symulowane do wpisu „Regresja porządkowa w jamovi”
# 300 studentów odpowiada na pytanie „Czy planujesz studia drugiego stopnia?” (1 = na pewno nie … 4 = na pewno tak).
# Predyktory: średnia ocen, zadowolenie z kierunku (1–7) i praca zarobkowa (nie, dorywcza, etatowa).
library(haven)
set.seed(5520)  # ziarno wybrane spośród 31 tak, by założenie proporcjonalnych szans było naruszone tylko dla pracy
n <- 300
praca <- sample(c("nie", "dorywcza", "etatowa"), n, replace = TRUE, prob = c(.40, .32, .28))
srednia <- round(pmin(5, pmax(3, rnorm(n, 4.0, 0.45))), 2)
zadowolenie <- pmin(7, pmax(1, round(rnorm(n, 4.6, 1.4))))
eta <- 1.3 * (srednia - 4) + 0.35 * (zadowolenie - 4.6) + ifelse(praca == "dorywcza", -0.25, 0)
b_etat <- c(0, -0.6, -1.4)    # efekt pracy etatowej celowo różny dla progów (brak proporcjonalnych szans)
a <- c(1.5, 0.2, -1.3)          # logit P(Y ≥ 2), P(Y ≥ 3), P(Y ≥ 4) dla profilu odniesienia
pg <- sapply(1:3, function(k) plogis(a[k] + eta + (praca == "etatowa") * b_etat[k]))
u <- runif(n)
plan <- 1 + (u < pg[, 1]) + (u < pg[, 2]) + (u < pg[, 3])
dane <- data.frame(id = seq_len(n), plan, srednia, zadowolenie, praca)
write.csv(dane, "regresja-porzadkowa-w-jamovi-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Ten sam zbiór w .sav: etykiety wartości dla planu i pracy, etykiety zmiennych
etyk_plan <- c("na pewno nie" = 1, "raczej nie" = 2, "raczej tak" = 3, "na pewno tak" = 4)
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$plan <- labelled(dane$plan, labels = etyk_plan, label = "Czy planujesz studia drugiego stopnia?")
sav$srednia <- labelled(sav$srednia, label = "Średnia ocen (3.00–5.00)")
sav$zadowolenie <- labelled(sav$zadowolenie, label = "Zadowolenie z kierunku (1–7)")
sav$praca <- labelled(match(dane$praca, c("nie", "dorywcza", "etatowa")),
                      labels = c("nie" = 1, "dorywcza" = 2, "etatowa" = 3), label = "Praca zarobkowa")
write_sav(sav, "regresja-porzadkowa-w-jamovi-dane.sav")
cat("Zapisano", nrow(dane), "wierszy\n")
print(head(dane, 4), row.names = FALSE)
print(table(plan = dane$plan, praca = factor(dane$praca, levels = c("nie", "dorywcza", "etatowa"))))
Wynik:
Zapisano 300 wierszy
 id plan srednia zadowolenie    praca
  1    1    4.25           3 dorywcza
  2    2    4.29           6 dorywcza
  3    4    4.67           6  etatowa
  4    3    4.07           4 dorywcza
    praca
plan nie dorywcza etatowa
   1  29       19      22
   2  20       23      41
   3  35       32      28
   4  22       18      11
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem jmv, który do modelu korzysta z funkcji polr pakietu MASS, a do testów omnibus – z pakietu car. Kontrolę policzono pakietami MASS, ordinal, VGAM i brant, pliki .sav zapisano pakietem haven, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersję jamovi albo R, której faktycznie użyłeś(-aś).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ordinal (wersja 2026.7-26): Christensen, R. H. B. (2026). ordinal: Regression models for ordinal data (R package version 2026.7-26) [Computer software]. https://CRAN.R-project.org/package=ordinal
- VGAM (wersja 1.1.14): Yee, T. W. (2015). Vector generalized linear and additive models: With an implementation in R. Springer. https://doi.org/10.1007/978-1-4939-2818-7
- brant (wersja 0.3.0): Schlegel, B., & Steenbergen, M. (2020). brant: Test for parallel regression assumption [R package]. https://doi.org/10.32614/CRAN.package.brant
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Zła kolejność kategorii, np. alfabetyczna. Program nie zgłosi błędu – sprawdzaj notę pod Model Fit Measures.
- Zmienna zależna jako Continuous i zwykła regresja liniowa na kodach 1–4 zamiast modelu porządkowego.
- Odczyt znaku bez sprawdzenia parametryzacji przy porównaniu z innym programem albo artykułem.
- Interpretowanie progów jak stałej w regresji liniowej, łącznie z ich p i „ilorazami szans”.
- „Etatowcy dwa razy rzadziej odpowiadają »na pewno tak«”. OR dotyczy szans skumulowanych, nie prawdopodobieństwa jednej odpowiedzi – do takich zdań policz prawdopodobieństwa.
- Brak sprawdzenia proporcjonalnych szans, bo „jamovi nic nie pokazało” – okno tego testu nie liczy.
Pierwsze kroki w programie opisuje wpis jamovi krok po kroku, a hasło jamovi – sam program. Jeśli nie wiesz, czy model porządkowy pasuje do Twojej hipotezy, skorzystaj z kreatora doboru testu.
Najczęstsze pytania
Gdzie w jamovi jest regresja porządkowa?
W menu Analyses → Regression, w grupie Logistic Regression, pozycja Ordinal Outcomes (The jamovi project, b.d.). Okno nazywa się Ordinal Logistic Regression, a w polskiej wersji według pliku tłumaczeń jmv – „Porządkowa regresja logistyczna” (Selker i in., 2025). Liczy model proporcjonalnych szans z funkcją logit.
Jak w jamovi ustawić kolejność kategorii zmiennej zależnej w regresji porządkowej?
W edytorze zmiennej (dwuklik na nagłówku kolumny): poziom na górze listy jest pierwszy (The jamovi project, b.d.). Sekcja Reference Levels w tym oknie obejmuje tylko czynniki, nie zmienną zależną (Selker i in., 2025). Kolejność, której użył model, podaje nota pod tabelą Model Fit Measures – sprawdzaj ją przy każdej analizie.
Czy jamovi sprawdza założenie proporcjonalnych szans?
Nie. W definicji okna Ordinal Outcomes w jmv 2.7.7 nie ma testu proporcjonalnych szans (Selker i in., 2025). Sprawdź je w R testem Branta (pakiet brant) albo testem ilorazu wiarygodności (ordinal::nominal_test), a jeśli jest naruszone dla jednego predyktora, rozważ model częściowo proporcjonalnych szans (Peterson i Harrell, 1990).
Czy dodatni współczynnik w regresji porządkowej w jamovi oznacza wyższe kategorie?
Tak. jamovi liczy model funkcją MASS::polr, w której logit P(Y ≤ k) = τk − b·x, więc dodatnie b przesuwa odpowiedzi w stronę kategorii z końca listy poziomów (Selker i in., 2025). Tę samą konwencję ma SPSS (PLUM), a np. pakiet VGAM w R podaje te same liczby z przeciwnym znakiem.
Jakie przedziały ufności podaje jamovi w regresji porządkowej?
Przedziały z profilu wiarygodności: kod jmv wywołuje confint dla modelu polr (Selker i in., 2025). Są trochę asymetryczne i różnią się od przedziałów Walda (b ± 1.96 × SE), których jamovi używa w regresji dwumianowej. W przykładzie dla średniej ocen: OR = 4.78 [2.82, 8.21], a z przedziałem Walda [2.80, 8.15].
Powiązane hasła
Przeczytaj też
Regresja porządkowa krok po kroku
Model proporcjonalnych szans w R: progi, ilorazy szans, prawdopodobieństwa przewidywane, test Branta i tabela APA – na danych do pobrania.
Czytaj →PoradnikRegresja porządkowa w SPSS
Ordinal Regression (PLUM) krok po kroku: funkcja wiązania, pseudo-R², progi i znak współczynników, OR = exp(B), test równoległości linii i zapis APA.
Czytaj →PoradnikRegresja logistyczna w jamovi
2 Outcomes krok po kroku: Factors i Covariates, poziom referencyjny, bloki, ilorazy szans z CI, pseudo-R², tabela klasyfikacji, AUC i zapis APA.
Czytaj →PoradnikWielomianowa regresja logistyczna w SPSS
Multinomial Logistic Regression od pliku .sav po opis APA: kategoria odniesienia, testy ilorazu wiarygodności, Exp(B) w dwóch równaniach, klasyfikacja i składnia NOMREG.
Czytaj →Masz regresję porządkową w jamovi i nie wiesz, co przepisać do pracy?
Sprawdzimy Twój plik .omv, kolejność kategorii, poziomy referencyjne i założenie proporcjonalnych szans i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brant, R. (1990). Assessing proportionality in the proportional odds model for ordinal logistic regression. Biometrics, 46(4), 1171–1178. https://doi.org/10.2307/2532457
- Fullerton, A. S. (2009). A conceptual framework for ordered logistic regression models. Sociological Methods & Research, 38(2), 306–347. https://doi.org/10.1177/0049124109346162
- McCullagh, P. (1980). Regression models for ordinal data. Journal of the Royal Statistical Society: Series B (Methodological), 42(2), 109–127. https://doi.org/10.1111/j.2517-6161.1980.tb01109.x
- Peterson, B., & Harrell, F. E., Jr. (1990). Partial proportional odds models for ordinal response variables. Applied Statistics, 39(2), 205–217. https://doi.org/10.2307/2347760
- Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (R package version 2.7.7) – Ordinal Logistic Regression (logRegOrd): dokumentacja funkcji, definicja analizy, kod R i polskie tłumaczenie etykiet. https://docs.jamovi.org/jmv/jmv_logRegOrd.html ● Otwarty dostęp: pełny tekst
- The jamovi project. (b.d.). Logistic Regression; From SPSS to jamovi: Logistic Regression; Data Variables. jamovi docs. Pobrano 10 listopada 2026 z https://docs.jamovi.org/analyses/jg_43_regression-logistic.html ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{brant1990assessing, author={Brant, Rollin}, title={{Assessing proportionality in the proportional odds model for ordinal logistic regression}}, journal={Biometrics}, year={1990}, volume={46}, number={4}, pages={1171--1178}, doi={10.2307/2532457}}@article{fullerton2009conceptual, author={Fullerton, Andrew S.}, title={{A conceptual framework for ordered logistic regression models}}, journal={Sociological Methods \& Research}, year={2009}, volume={38}, number={2}, pages={306--347}, doi={10.1177/0049124109346162}}@article{mccullagh1980regression, author={McCullagh, Peter}, title={{Regression models for ordinal data}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1980}, volume={42}, number={2}, pages={109--127}, doi={10.1111/j.2517-6161.1980.tb01109.x}}@article{peterson1990partial, author={Peterson, Bercedis and Harrell, Jr., Frank E.}, title={{Partial proportional odds models for ordinal response variables}}, journal={Applied Statistics}, year={1990}, volume={39}, number={2}, pages={205--217}, doi={10.2307/2347760}}@misc{selker2025logregord, author={Selker, Ravi and Love, Jonathon and Dropmann, Damian}, title={{jmv: The 'jamovi' analyses (R package version 2.7.7) – Ordinal Logistic Regression (logRegOrd): dokumentacja funkcji, definicja analizy, kod R i polskie tłumaczenie etykiet}}, year={2025}, url={https://docs.jamovi.org/jmv/jmv_logRegOrd.html}}@misc{jamovindlogreg, author={{The jamovi project}}, title={{Logistic Regression; From SPSS to jamovi: Logistic Regression; Data Variables}}, howpublished={jamovi docs}, url={https://docs.jamovi.org/analyses/jg_43_regression-logistic.html}}