Kiedy regresja porządkowa i co zrobisz w SPSS
Regresja porządkowa przewiduje odpowiedź o kilku uporządkowanych kategoriach, np. pozycję skali Likerta albo stopień nasilenia objawów. Logikę modelu proporcjonalnych szans omawia poradnik regresja porządkowa krok po kroku (z kodem w R). O tym, kiedy pozycję Likerta traktować jako porządkową, piszemy we wpisie czy skala Likerta jest ilościowa. Tutaj pokazujemy tylko SPSS: okno Ordinal Regression (w składni procedura PLUM), tabele wydruku i to, jak nie pomylić kierunku efektu.
Menu, opcje, składnię i wzory sprawdziliśmy w dokumentacji IBM SPSS Statistics 32 oraz w opisie algorytmów PLUM z wersji 31 (IBM Corp., b.d.-a, b.d.-b, b.d.-c, b.d.-d). Procedura należy do podstawowego modułu (Statistics Base). Nazwy podajemy po angielsku, a polskie tylko wtedy, gdy potwierdza je polska dokumentacja IBM. Nazw wierszy i części kolumn tabel wynikowych dokumentacja nie wymienia w całości – tam, gdzie to zaznaczamy, odtwarzamy typowy układ wydruku, więc w Twojej wersji mogą się nieco różnić. Ogólne zasady czytania wydruków opisuje wpis jak czytać wyniki z SPSS.
Przykład. 300 osób przed egzaminem ze statystyki (dane symulowane) oceniło swoje przygotowanie: 1 = bardzo słabe, 2 = słabe, 3 = dobre, 4 = bardzo dobre (przygotowanie). Predyktory: lęk przed statystyką, czyli średnia ze skali 1–5 (lek), godziny nauki w ostatnim tygodniu (godziny) i udział w konsultacjach (konsultacje: 1 = tak, 0 = nie). Pięć osób nie podało liczby godzin. Dane pobierzesz jako plik SPSS .sav (z etykietami zmiennych i wartości) albo plik CSV.
Przygotowanie danych
- Kolejność kategorii. SPSS porządkuje odpowiedzi rosnąco według wartości: najniższa wartość to pierwsza kategoria (IBM Corp., b.d.-a). Zakoduj więc 1 = najniższy poziom cechy. Odwrócone kodowanie odwraca znaki wszystkich współczynników.
- Etykiety. Ustaw miarę porządkową i etykiety wartości (zob. przygotowanie danych w SPSS).
- Liczebność kategorii. W analizie zostaje 295 osób z kompletem danych: 72 (24.4%) ocenia przygotowanie jako bardzo słabe, 71 (24.1%) jako słabe, 88 (29.8%) jako dobre i 64 (21.7%) jako bardzo dobre. Kategorię wybraną przez kilka osób połącz z sąsiednią przed analizą i opisz to w pracy.
- Predyktor 0/1.
konsultacjewstawimy jako kowariantę: współczynnik porównuje wtedy „tak” z „nie”.
Statystyki opisowe: lęk M = 2.99 (SD = 0.79), godziny nauki M = 7.96 (SD = 4.83); na konsultacje chodziło 120 z 300 osób (40%).
Krok 1. Okno Analyze → Regression → Ordinal
W polskiej dokumentacji IBM ta ścieżka to Analiza → Regresja → Skala porządkowa (IBM Corp., b.d.-a).
- Przenieś
przygotowaniedo pola Dependent. Okno przyjmuje jedną zmienną zależną. - Do pola czynników (Factor(s)) trafiają zmienne kategorialne, a do pola kowariant (Covariate(s)) – liczbowe (IBM Corp., b.d.-a, b.d.-d). Przenieś
lek,godzinyikonsultacjedo Covariate(s). - Przyciski Location i Scale zostaw bez zmian. Domyślny model położenia zawiera wszystkie kowarianty i efekty główne czynników (IBM Corp., b.d.-b), a model skali to już inny, ogólniejszy model, w którym test równoległości linii nie jest dostępny (IBM Corp., b.d.-a).
Czynnik czy kowarianta? Zmienną 0/1 możesz wstawić do Factor(s). W typowym wydruku SPSS ustawia wtedy parametr ostatniej kategorii (tu „tak”) na 0 jako nadmiarowy, więc współczynnik porównuje „nie” z „tak” i ma przeciwny znak niż w naszej tabeli. Dokumentacja tego nie opisuje, więc sprawdź przypis pod tabelą Parameter Estimates. Zmienną nominalną o 3+ kategoriach wstaw do Factor(s).
Krok 2. Options i Output
- Options → Link: zostaw Logit (po polsku: funkcja łączenia Logit). Tylko przy tej funkcji wiązania współczynniki przelicza się na ilorazy szans. Pozostałe (Complementary log-log, Negative log-log, Probit, Cauchit) IBM zaleca np. przy przewadze wyższych lub niższych kategorii (IBM Corp., b.d.-a). Nie zmieniaj jej dla lepszego p.
- Output → Display: zaznacz Goodness of fit statistics (Statystyki dobroci dopasowania), Summary statistics (Statystyki podsumowujące), Parameter estimates (Oceny parametrów) i Test of parallel lines (Test równoległości linii).
- Output → Saved Variables (opcjonalnie): Estimated response probabilities dopisze do danych prawdopodobieństwo każdej kategorii, a Predicted category – kategorię o największym prawdopodobieństwie.
Na koniec kliknij Paste zamiast OK, żeby zapisać polecenie w oknie składni.
Składnia do wklejenia
Polecenie zbudowaliśmy według Command Syntax Reference IBM dla PLUM (IBM Corp., b.d.-b). Odpowiada ustawieniom z kroków 1–2. Nie uruchamialiśmy go w SPSS. Liczby na tej stronie pochodzą z R. Podpolecenie PRINT jest konieczne: bez niego PLUM wyświetla tylko podsumowanie przypadków.
* Predyktory liczbowe i zmienna 0/1 jako kowarianty (WITH).
PLUM przygotowanie WITH lek godziny konsultacje
/LINK=LOGIT
/PRINT=FIT PARAMETER SUMMARY TPARALLEL.
Czynniki wpisuje się po BY, a kowarianty po WITH, np. PLUM wynik BY grupa WITH wiek. Prawdopodobieństwa i przewidywaną kategorię zapiszesz, dopisując /SAVE=ESTPROB PREDCAT.
Krok 3. Model Fitting Information i Pseudo R-Square
Tabela 1. Model Fitting Information i Pseudo R-Square. Liczby policzone w R tymi samymi metodami co SPSS; układ tabel jak w SPSS (nazwy wierszy odtworzone z typowego wydruku).
| Model | −2 Log Likelihood | Chi-Square | df | Sig. |
|---|---|---|---|---|
| Intercept Only | 813.827 | |||
| Final | 723.884 | 89.943 | 3 | .000 |
| Miara | Wartość |
|---|---|
| Cox and Snell | .263 |
| Nagelkerke | .281 |
| McFadden | .111 |
Model Fitting Information to test ilorazu wiarygodności: różnica −2LL modelu z samymi progami i modelu z predyktorami (IBM Corp., b.d.-c). Przepisz χ²(3) = 89.94, p < .001.
Pseudo R-Square zawiera trzy pseudo-R², liczone według algorytmów PLUM z logarytmów wiarygodności modelu pustego i końcowego (IBM Corp., b.d.-c). R² Coxa i Snella nie może osiągnąć 1, dlatego Nagelkerke (1991) przeskalował je do zakresu 0–1. R² McFaddena zwykle jest wyraźnie niższe. Podaj jedną nazwaną miarę, np. R² Nagelkerkego = .28, i nie pisz o „procencie wyjaśnionej wariancji” (Menard, 2000).
Goodness-of-Fit i ostrzeżenie o pustych komórkach. SPSS liczy statystyki Pearsona i dewiancji, grupując osoby według wzorców wartości predyktorów (IBM Corp., b.d.-a, b.d.-c). Przy predyktorze ciągłym prawie każda osoba ma własny wzorzec: u nas 885 z 1180 komórek (75.0%) jest pustych i SPSS ostrzega o komórkach z zerową liczebnością. Studium przypadku IBM zaleca, by przy kowariantach ciągłych nie opierać się na tych statystykach, bo nie mają rozkładu χ² (IBM Corp., b.d.-d). Dlatego ich nie raportujemy.
Krok 4. Parameter Estimates: progi, znaki i ilorazy szans
Tabela 2. Parameter Estimates. Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS (etykiety wierszy Threshold i Location oraz nazwy kolumn odtworzone z typowego wydruku).
| Estimate | Std. Error | Wald | df | Sig. | 95% Confidence Interval | |||
|---|---|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | |||||||
| Threshold | [przygotowanie = 1] | −2.791 | .483 | 33.464 | 1 | .000 | −3.737 | −1.846 |
| [przygotowanie = 2] | −1.480 | .460 | 10.337 | 1 | .001 | −2.383 | −.578 | |
| [przygotowanie = 3] | .209 | .459 | .208 | 1 | .648 | −.690 | 1.108 | |
| Location | lek | −.978 | .147 | 44.590 | 1 | .000 | −1.266 | −.691 |
| godziny | .148 | .024 | 36.711 | 1 | .000 | .100 | .195 | |
| konsultacje | .952 | .228 | 17.501 | 1 | .000 | .506 | 1.399 | |
Link function: Logit.
Parametryzacja SPSS. Według opisu algorytmów PLUM model ma postać
logit P(Y ≤ j) = θj − (β1lek + β2godziny + β3konsultacje)
gdzie θj to progi (wiersze Threshold), a β – parametry położenia (wiersze Location) (IBM Corp., b.d.-c). Z minusa wynikają dwie rzeczy:
- Dodatni współczynnik oznacza przesunięcie w stronę wyższych kategorii. Większe βx zmniejsza P(Y ≤ j) dla każdego progu, więc rośnie szansa odpowiedzi powyżej progu. Tak samo opisuje to studium przypadku IBM (IBM Corp., b.d.-d). Godziny nauki (.148) i konsultacje (.952) podnoszą samoocenę przygotowania, lęk (−.978) ją obniża.
- Progi to logity skumulowane przy zerowych predyktorach. θ1 = −2.791 to logit P(Y ≤ „bardzo słabe”) u osoby z lękiem 0, zerem godzin i bez konsultacji. Skala lęku zaczyna się od 1, więc progów nie interpretujesz i nie testujesz – ich istotność (np. p = .648 dla trzeciego progu) nic nie mówi o hipotezach.
Funkcje clm (pakiet ordinal) i polr (MASS) w R mają tę samą parametryzację i dają te same liczby. Funkcja vglm z rodziną cumulative (VGAM) modeluje θj + βx, więc na tych danych dała nachylenia z przeciwnym znakiem (kod poniżej). Porównując wyniki z innym programem, sprawdź, co oznacza dodatni współczynnik.
Ilorazy szans. Dokumentacja PRINT wymienia w tej tabeli oceny, błędy standardowe, istotność i przedziały ufności – bez Exp(B) (IBM Corp., b.d.-b). Iloraz szans policz więc sam jako eB, a przedział – podnosząc e do potęgi obu granic:
- Lęk: OR = e−0.978 = 0.38, 95% CI [0.28, 0.50]. Wzrost lęku o 1 punkt zmniejsza szanse wyższej samooceny (powyżej dowolnego progu) 2.66 raza (1 / 0.376) przy tych samych godzinach i konsultacjach. OR dla odpowiedzi poniżej progu to e−B = 2.66.
- Godziny: OR = 1.16 [1.10, 1.22] na godzinę; dla 5 godzin OR = e5 × 0.148 = 2.09.
- Konsultacje: OR = 2.59 [1.66, 4.05]: osoby chodzące na konsultacje mają 2.59 raza większe szanse wyższej kategorii niż osoby, które nie chodziły.
Jeden OR obowiązuje dla wszystkich trzech podziałów skali – to jest założenie, które sprawdza następna tabela. Wald to (B / SE)², czyli test Walda z 1 df (IBM Corp., b.d.-c). OR nie jest ilorazem prawdopodobieństw. Skalę efektu lepiej pokażą prawdopodobieństwa: przy 8 godzinach nauki i bez konsultacji osoba z lękiem 2 ma przewidywane prawdopodobieństwo odpowiedzi „bardzo słabe” .12, a „bardzo dobre” .27. Przy lęku 4 te wartości to .49 i .05.
Krok 5. Test of Parallel Lines
Tabela 3. Test of Parallel Lines. Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS (nazwy wierszy odtworzone z typowego wydruku).
| Model | −2 Log Likelihood | Chi-Square | df | Sig. |
|---|---|---|---|---|
| Null Hypothesis | 723.884 | |||
| General | 714.723 | 9.161 | 6 | .165 |
Test porównuje model z jednym zestawem współczynników dla wszystkich progów z modelem ogólnym, w którym każdy próg ma własne współczynniki (IBM Corp., b.d.-d). Opis algorytmów przedstawia go jako test ilorazu wiarygodności z (J − 2) × p stopniami swobody, gdzie J to liczba kategorii, a p – liczba predyktorów (IBM Corp., b.d.-c): tu (4 − 2) × 3 = 6. W R dopasowaliśmy taki model ogólny funkcją clm z predyktorami w argumencie nominal i dla kontroli w VGAM – oba dały to samo −2LL. Uwaga: Command Syntax Reference nazywa TPARALLEL testem punktowym (score; IBM Corp., b.d.-b), więc jeśli Twój wydruk różni się w drugim miejscu po przecinku, przyczyną może być inna statystyka.
Wynik χ²(6) = 9.16, p = .165 oznacza brak dowodów, że założenie proporcjonalnych szans jest naruszone. Nie dowodzi, że jest spełnione: przy dużej próbie test wychwytuje drobne różnice, a przy małej przeocza wyraźne (Brant, 1990). Rysunek 1 pokazuje, co porównuje test.
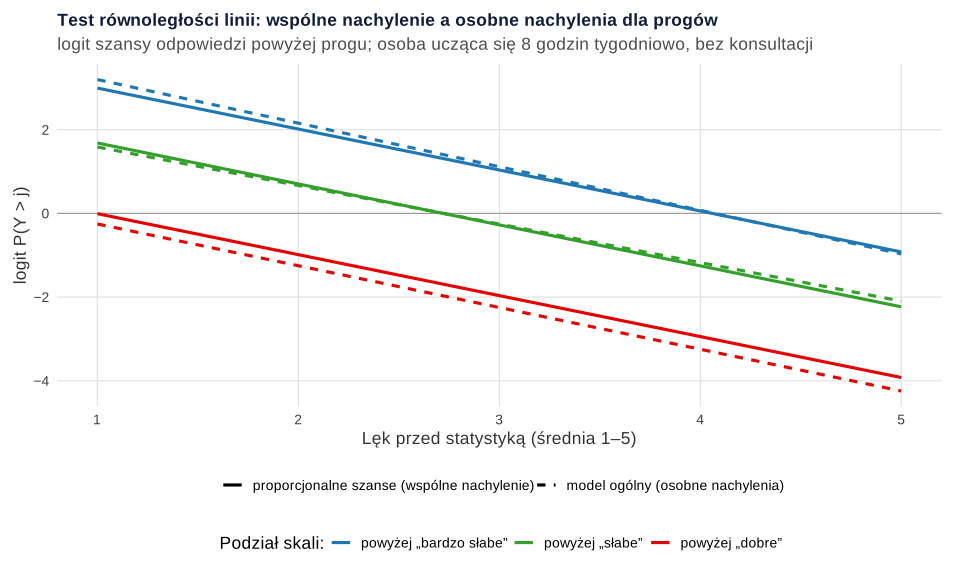
Nachylenia lęku w modelu ogólnym (−1.04, −0.92 i −1.00) są prawie takie same jak wspólne (−0.98). Najbardziej różni się efekt konsultacji (0.58, 0.85 i 1.44), ale test tego nie potwierdza. Gdyby test był istotny, nie zmieniaj w ciemno funkcji wiązania. Sprawdź, który predyktor ma wyraźnie różne nachylenia, i rozważ model częściowych proporcjonalnych szans (Peterson i Harrell, 1990), którego okno Ordinal Regression nie oferuje, albo wielomianową regresję logistyczną. Więcej o tym założeniu piszemy w haśle o założeniu proporcjonalnych szans.
Zapis wyników w stylu APA
Podaj kodowanie kategorii, funkcję wiązania, test modelu, nazwaną miarę pseudo-R², test równoległości linii i dla każdego predyktora B (SE), p oraz OR z 95% CI. Inne opisy złożysz w generatorze opisu wyników APA.
Gdy wystarczy porównanie dwóch grup testem rangowym (zob. testy nieparametryczne w SPSS), podpowie to kreator doboru testu. Wynik dwukategorialny analizuje regresja logistyczna w SPSS, a powtarzane odpowiedzi porządkowe – model mieszany (zob. modele CLMM).
Te same liczby w R
SPSS nie był używany przy przygotowaniu tej strony. Wszystkie liczby z tabel 1–3 policzyliśmy w R tymi samymi metodami, których używa SPSS według opisu algorytmów PLUM: model kumulatywny z funkcją wiązania logit i parametryzacją próg − Bx (funkcja clm z pakietu ordinal), metoda największej wiarygodności z usuwaniem braków wierszami, test modelu jako różnica −2LL modelu z samymi progami i modelu końcowego, R² Coxa i Snella, Nagelkerkego i McFaddena ze wzorów IBM, statystyka Walda jako (B / SE)² z przedziałami B ± 1.96 × SE oraz test równoległości linii jako test ilorazu wiarygodności wobec modelu ogólnego z osobnymi nachyleniami dla progów (clm z argumentem nominal, dla kontroli vglm z pakietu VGAM). Każda osoba ma tu własny wzorzec wartości predyktorów, więc −2LL z pełną funkcją wiarygodności i z jej jądrem (bez stałej wielomianowej) są równe. Uruchom przepisy po kolei z folderu, w którym zapiszesz pliki danych. Przepis 1 tworzy plik CSV i plik .sav (pakiet haven).
1. Dane: CSV i plik SPSS .sav z etykietami
R
# B312 – dane przykładowe: przygotowanie do egzaminu ze statystyki (dane symulowane, set.seed(3121))
# 300 osób; plik CSV i plik SPSS .sav z etykietami zmiennych i wartości
suppressPackageStartupMessages(library(haven))
set.seed(3121)
n <- 300
lek <- round(pmin(pmax(rnorm(n, 2.9, 0.8), 1), 5), 2)                   # lęk przed statystyką, średnia ze skali 1–5
godziny <- round(pmin(rgamma(n, shape = 3, rate = 0.4), 25), 1)          # godziny nauki w ostatnim tygodniu przed egzaminem
konsultacje <- rbinom(n, 1, 0.40)                                         # 1 = chodził(a) na konsultacje, 0 = nie
y_ukryta <- -0.95 * lek + 0.16 * godziny + 0.75 * konsultacje + rlogis(n)
przygotowanie <- cut(y_ukryta, c(-Inf, -2.6, -1.3, 0.2, Inf), labels = FALSE)  # 1 = bardzo słabe … 4 = bardzo dobre
godziny[sample(1:n, 5)] <- NA                                             # braki: 5 osób nie podało liczby godzin
dane <- data.frame(id = 1:n, przygotowanie, lek, godziny, konsultacje)
write.csv(dane, "../regresja-porzadkowa-spss-dane.csv", row.names = FALSE, na = "")

sav <- dane
attr(sav$id, "label") <- "Numer osoby"
sav$przygotowanie <- labelled(sav$przygotowanie, c("bardzo słabe" = 1, "słabe" = 2, "dobre" = 3, "bardzo dobre" = 4),
                              label = "Samoocena przygotowania do egzaminu ze statystyki")
attr(sav$lek, "label") <- "Lęk przed statystyką (średnia 1–5)"
attr(sav$godziny, "label") <- "Godziny nauki w ostatnim tygodniu"
sav$konsultacje <- labelled(sav$konsultacje, c("nie" = 0, "tak" = 1), label = "Udział w konsultacjach")
write_sav(sav, "../regresja-porzadkowa-spss-dane.sav")

summary(dane[, -1])
cbind(n = table(dane$przygotowanie), procent = round(100 * prop.table(table(dane$przygotowanie)), 1))
round(sapply(dane[, c("lek", "godziny")], function(x) c(M = mean(x, na.rm = TRUE), SD = sd(x, na.rm = TRUE),
                                                         n = sum(!is.na(x)))), 2)
table(konsultacje = dane$konsultacje)
Wynik w R
 przygotowanie        lek           godziny        konsultacje
 Min.   :1.000   Min.   :1.000   Min.   : 0.700   Min.   :0.0
 1st Qu.:1.750   1st Qu.:2.417   1st Qu.: 4.400   1st Qu.:0.0
 Median :3.000   Median :2.945   Median : 7.100   Median :0.0
 Mean   :2.483   Mean   :2.987   Mean   : 7.963   Mean   :0.4
 3rd Qu.:3.000   3rd Qu.:3.490   3rd Qu.:10.300   3rd Qu.:1.0
 Max.   :4.000   Max.   :5.000   Max.   :25.000   Max.   :1.0
                                 NA's   :5
   n procent
1 75    25.0
2 71    23.7
3 88    29.3
4 66    22.0
      lek godziny
M    2.99    7.96
SD   0.79    4.83
n  300.00  295.00
konsultacje
  0   1
180 120
2. Ordinal Regression (PLUM): wszystkie tabele wydruku
R
# Ordinal Regression (PLUM), funkcja wiązania logit: przygotowanie ~ lek + godziny + konsultacje
# ordinal::clm ma tę samą parametryzację co SPSS: logit P(Y <= j) = próg_j − (b1*lek + b2*godziny + b3*konsultacje)
suppressPackageStartupMessages(library(ordinal))
dane <- read.csv("../regresja-porzadkowa-spss-dane.csv")
# Case Processing Summary: osoby z brakiem w którejkolwiek zmiennej modelu są pomijane
d <- na.omit(dane[, c("id", "przygotowanie", "lek", "godziny", "konsultacje")])
d$przygotowanie <- factor(d$przygotowanie, levels = 1:4, ordered = TRUE,
                          labels = c("bardzo słabe", "słabe", "dobre", "bardzo dobre"))
n <- nrow(d)
c(Valid = n, Missing = nrow(dane) - n, Total = nrow(dane))
cbind(N = table(d$przygotowanie), Marginal_Percentage = round(100 * prop.table(table(d$przygotowanie)), 1))
# Komórki o zerowej liczebności: wzorce predyktorów × kategorie odpowiedzi
wzorce <- nrow(unique(d[, c("lek", "godziny", "konsultacje")]))
puste <- wzorce * nlevels(d$przygotowanie) - sum(table(interaction(d$lek, d$godziny, d$konsultacje, drop = TRUE),
                                                    d$przygotowanie) > 0)
c(wzorce = wzorce, komorki = wzorce * 4, puste = puste, procent = round(100 * puste / (wzorce * 4), 1))

# Model Fitting Information: −2 Log Likelihood modelu z samymi progami i modelu końcowego
m0 <- clm(przygotowanie ~ 1, data = d, link = "logit")
m <- clm(przygotowanie ~ lek + godziny + konsultacje, data = d, link = "logit")
ll0 <- as.numeric(logLik(m0)); ll1 <- as.numeric(logLik(m))
chi2 <- -2 * ll0 - (-2 * ll1); df_m <- length(coef(m)) - length(coef(m0))
round(c(minus2LL_Intercept_Only = -2 * ll0, minus2LL_Final = -2 * ll1, Chi_Square = chi2, df = df_m), 3)
signif(pchisq(chi2, df_m, lower.tail = FALSE), 3)
# Pseudo R-Square (wzory z dokumentacji algorytmów PLUM)
cs <- 1 - exp(2 * (ll0 - ll1) / n)
nk <- cs / (1 - exp(2 * ll0 / n))
mf <- 1 - ll1 / ll0
round(c(Cox_and_Snell = cs, Nagelkerke = nk, McFadden = mf), 3)

# Parameter Estimates: Threshold i Location, Wald = (B / SE)^2, 95% CI Walda
s <- coef(summary(m))
B <- s[, 1]; SE <- s[, 2]; Wald <- (B / SE)^2
tab <- cbind(Estimate = B, Std_Error = SE, Wald = Wald, df = 1, Sig = pchisq(Wald, 1, lower.tail = FALSE),
             Lower = B - qnorm(.975) * SE, Upper = B + qnorm(.975) * SE)
print(round(tab, 3))
signif(tab[, "Sig"], 3)
# Ilorazy szans dla predyktorów: exp(B) i exp(granic przedziału)
p <- c("lek", "godziny", "konsultacje")
round(cbind(OR = exp(B[p]), OR_Lower = exp(tab[p, "Lower"]), OR_Upper = exp(tab[p, "Upper"])), 3)
round(c(OR_godziny_5h = exp(5 * B[["godziny"]]), OR_lek_odwrotnosc = 1 / exp(B[["lek"]])), 3)

# Test of Parallel Lines: test ilorazu wiarygodności wobec modelu ogólnego
# (osobne nachylenia dla każdego progu; w clm – predyktory w argumencie nominal)
mg <- clm(przygotowanie ~ 1, nominal = ~ lek + godziny + konsultacje, data = d, link = "logit")
llg <- as.numeric(logLik(mg))
chi2_p <- -2 * ll1 - (-2 * llg); df_p <- length(coef(mg)) - length(coef(m))
round(c(minus2LL_Null_Hypothesis = -2 * ll1, minus2LL_General = -2 * llg, Chi_Square = chi2_p, df = df_p,
        Sig = pchisq(chi2_p, df_p, lower.tail = FALSE)), 3)
# Kontrola: to samo jako (J − 2) * p stopni swobody i nachylenia z modelu ogólnego dla kolejnych progów
c(df_wzor = (nlevels(d$przygotowanie) - 2) * length(p))
round(matrix(-coef(mg)[grep("lek|godziny|konsultacje", names(coef(mg)))], nrow = 3,
             dimnames = list(c("próg 1|2", "próg 2|3", "próg 3|4"), p)), 3)
# Kontrola: osobne regresje logistyczne dla kolejnych podziałów skali (Y > j)
round(sapply(1:3, function(j) coef(glm(as.integer(przygotowanie) > j ~ lek + godziny + konsultacje,
                                       family = binomial, data = d))[p]), 3)

# Znak współczynnika: przewidywane prawdopodobieństwa kategorii przy lęku 2 i 4
# (godziny = 8, bez konsultacji)
nowe <- data.frame(lek = c(2, 4), godziny = 8, konsultacje = 0)
pr <- predict(m, newdata = nowe, type = "prob")$fit
dimnames(pr) <- list(c("lek = 2", "lek = 4"), levels(d$przygotowanie)); round(pr, 3)
# To samo „ręcznie” ze wzoru SPSS: P(Y <= j) = 1 / (1 + exp(−(próg_j − suma B*x)))
eta <- sum(B[p] * c(2, 8, 0)); round(plogis(B[1:3] - eta), 3)

# Kontrola parametryzacji w innych funkcjach R
# MASS::polr – ta sama parametryzacja (próg − Bx): te same współczynniki i progi
suppressPackageStartupMessages({ library(MASS); library(VGAM) })
mp <- polr(przygotowanie ~ lek + godziny + konsultacje, data = d)
round(c(coef(mp), mp$zeta), 3)
# VGAM::vglm z rodziną cumulative – parametryzacja próg + Bx: te same liczby, odwrotne znaki nachyleń;
# model z osobnymi nachyleniami (parallel = FALSE) ma to samo −2LL co model ogólny w teście równoległości
v1 <- vglm(przygotowanie ~ lek + godziny + konsultacje, cumulative(parallel = TRUE), data = d)
vg <- vglm(przygotowanie ~ lek + godziny + konsultacje, cumulative(parallel = FALSE), data = d)
round(coef(v1)[c("lek", "godziny", "konsultacje")], 3)
round(c(minus2LL_parallel = -2 * as.numeric(logLik(v1)), minus2LL_general = -2 * as.numeric(logLik(vg))), 3)
Wynik w R
  Valid Missing   Total
    295       5     300
              N Marginal_Percentage
bardzo słabe 72                24.4
słabe        71                24.1
dobre        88                29.8
bardzo dobre 64                21.7
 wzorce komorki   puste procent
    295    1180     885      75
minus2LL_Intercept_Only          minus2LL_Final              Chi_Square                      df
                813.827                 723.884                  89.943                   3.000
[1] 2.25e-19
Cox_and_Snell    Nagelkerke      McFadden
        0.263         0.281         0.111
                   Estimate Std_Error   Wald df   Sig  Lower  Upper
bardzo słabe|słabe   -2.791     0.483 33.464  1 0.000 -3.737 -1.846
słabe|dobre          -1.480     0.460 10.337  1 0.001 -2.383 -0.578
dobre|bardzo dobre    0.209     0.459  0.208  1 0.648 -0.690  1.108
lek                  -0.978     0.147 44.590  1 0.000 -1.266 -0.691
godziny               0.148     0.024 36.711  1 0.000  0.100  0.195
konsultacje           0.952     0.228 17.501  1 0.000  0.506  1.399
bardzo słabe|słabe        słabe|dobre dobre|bardzo dobre                lek            godziny
          7.26e-09           1.30e-03           6.48e-01           2.43e-11           1.37e-09
       konsultacje
          2.87e-05
               OR OR_Lower OR_Upper
lek         0.376    0.282    0.501
godziny     1.159    1.105    1.216
konsultacje 2.592    1.659    4.050
    OR_godziny_5h OR_lek_odwrotnosc
            2.091             2.660
minus2LL_Null_Hypothesis         minus2LL_General               Chi_Square                       df
                 723.884                  714.723                    9.161                    6.000
                     Sig
                   0.165
df_wzor
      6
            lek godziny konsultacje
próg 1|2 -1.041   0.106       0.575
próg 2|3 -0.920   0.165       0.847
próg 3|4 -0.998   0.156       1.440
              [,1]   [,2]   [,3]
lek         -1.070 -0.974 -1.015
godziny      0.113  0.172  0.152
konsultacje  0.469  0.780  1.405
        bardzo słabe słabe dobre bardzo dobre
lek = 2        0.118 0.213 0.397        0.272
lek = 4        0.485 0.292 0.172        0.050
bardzo słabe|słabe        słabe|dobre dobre|bardzo dobre
             0.118              0.331              0.728
               lek            godziny        konsultacje bardzo słabe|słabe        słabe|dobre
            -0.978              0.148              0.952             -2.791             -1.480
dobre|bardzo dobre
             0.209
        lek     godziny konsultacje
      0.978      -0.148      -0.952
minus2LL_parallel  minus2LL_general
          723.884           714.723
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja clm z pakietu ordinal, kontrolnie polr z MASS i vglm z VGAM); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ordinal (wersja 2026.7-26): Christensen, R. H. B. (2026). ordinal: Regression models for ordinal data (R package version 2026.7-26) [Computer software]. https://CRAN.R-project.org/package=ordinal
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- VGAM (wersja 1.1-14): Yee, T. W. (2015). Vector generalized linear and additive models: With an implementation in R. Springer. https://doi.org/10.1007/978-1-4939-2818-7
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files (R package version 2.5.5) [Computer software]. https://CRAN.R-project.org/package=haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w regresji porządkowej w SPSS
- Odwrócony kierunek. Czytanie Estimate tak, jakby dodatni znak oznaczał niższe kategorie, albo przepisanie współczynników do porównania z programem o innej parametryzacji.
- Nieistotny Goodness-of-Fit jako dowód dobrego modelu przy kowariantach ciągłych, gdy większość komórek jest pusta.
- Brak testu równoległości linii albo zmiana funkcji wiązania tylko po to, żeby test przestał być istotny.
- Zmienna 0/1 w Factor(s) bez sprawdzenia, która kategoria jest odniesieniem – znak współczynnika może być odwrotny niż w Twojej hipotezie.
Ustawienia modelu i opis wyników sprawdzimy w ramach oferty analizy statystyczne dla studentów.
Najczęstsze pytania
Gdzie w SPSS jest regresja porządkowa i co w niej zaznaczyć?
Wybierz Analyze → Regression → Ordinal (w polskiej dokumentacji: Analiza → Regresja → Skala porządkowa). Zmienną porządkową przenieś do Dependent, zmienne kategorialne do czynników, a liczbowe do kowariant. W Output zaznacz statystyki dopasowania, podsumowujące, oceny parametrów i test równoległości linii. Kliknij Paste, żeby zachować składnię PLUM.
Dlaczego w SPSS dodatni współczynnik oznacza wyższe kategorie?
SPSS zapisuje model jako logit P(Y ≤ j) = próg − βx. Większe βx zmniejsza prawdopodobieństwo odpowiedzi do danego progu, czyli przesuwa odpowiedzi w górę skali. Tak samo działa clm z pakietu ordinal w R. Programy z zapisem próg + βx dają te same liczby z odwrotnym znakiem.
Jak policzyć iloraz szans w regresji porządkowej w SPSS?
Tabela Parameter Estimates podaje B i przedział ufności, ale nie Exp(B). Policz OR = eB i podnieś e do potęgi obu granic przedziału. W przykładzie lęk ma B = −0.978, więc OR = 0.38, 95% CI [0.28, 0.50]: szanse wyższej kategorii maleją około 2.7 raza na punkt lęku.
Co zrobić, gdy test równoległości linii jest istotny?
Sprawdź, który predyktor ma wyraźnie różne nachylenia dla progów (np. w osobnych regresjach logistycznych) i jak duże są te różnice. Rozważ model częściowych proporcjonalnych szans albo wielomianową regresję logistyczną. Nie zmieniaj funkcji wiązania tylko po to, żeby test przestał być istotny.
Czy przejmować się ostrzeżeniem o pustych komórkach i testem Goodness-of-Fit?
Przy predyktorach ciągłych prawie każda osoba ma własny wzorzec wartości, więc większość komórek jest pusta, a statystyki Pearsona i dewiancji nie mają rozkładu χ². IBM zaleca, by w takim modelu na nich nie polegać. Oceniaj model testem z Model Fitting Information, pseudo-R² i przewidywanymi prawdopodobieństwami.
Powiązane hasła
Przeczytaj też
Regresja porządkowa krok po kroku
Model proporcjonalnych szans w R: progi, ilorazy szans, prawdopodobieństwa przewidywane, test Branta i tabela APA – na danych do pobrania.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikRegresja logistyczna w SPSS
Binary Logistic krok po kroku: kategoria odniesienia, Hosmer–Lemeshow, pseudo-R², tabela klasyfikacji, Exp(B) z przedziałami ufności i zapis APA.
Czytaj →Masz wydruk regresji porządkowej z SPSS i nie wiesz, co z niego przepisać?
Sprawdzimy kodowanie kategorii, ustawienia modelu, kierunek współczynników i test równoległości linii oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brant, R. (1990). Assessing proportionality in the proportional odds model for ordinal logistic regression. Biometrics, 46(4), 1171–1178. https://doi.org/10.2307/2532457
- IBM Corp. (b.d.-a). Ordinal Regression (Ordinal Regression Options; Ordinal Regression Output; Ordinal Regression Location Model). IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=features-ordinal-regression ● Otwarty dostęp
- IBM Corp. (b.d.-b). PLUM. IBM SPSS Statistics 32.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-plum ● Otwarty dostęp
- IBM Corp. (b.d.-c). PLUM algorithms. IBM SPSS Statistics 31 Algorithms. https://www.ibm.com/docs/en/SSLVMB_31.0.0/pdf/IBM_SPSS_Statistics_Algorithms.pdf ● Otwarty dostęp
- IBM Corp. (b.d.-d). Using Ordinal Regression to Build a Credit Scoring Model. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_casestudies_project_ddita/spss/tutorials/plum_germcr_intro.html ● Otwarty dostęp
- Menard, S. (2000). Coefficients of determination for multiple logistic regression analysis. The American Statistician, 54(1), 17–24. https://doi.org/10.1080/00031305.2000.10474502
- Nagelkerke, N. J. D. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691–692. https://doi.org/10.1093/biomet/78.3.691
- Peterson, B., & Harrell, F. E., Jr. (1990). Partial proportional odds models for ordinal response variables. Applied Statistics, 39(2), 205–217. https://doi.org/10.2307/2347760
Cytowania BibTeX
@article{brant1990assessing, author={Brant, Rollin}, title={{Assessing proportionality in the proportional odds model for ordinal logistic regression}}, journal={Biometrics}, year={1990}, volume={46}, number={4}, pages={1171--1178}, doi={10.2307/2532457}}@misc{ibmnd32regresjaporzadkowa, author={{IBM Corp.}}, title={{Ordinal Regression (Ordinal Regression Options; Ordinal Regression Output; Ordinal Regression Location Model)}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=features-ordinal-regression}}@misc{ibmnd32plumskladnia, author={{IBM Corp.}}, title={{PLUM}}, howpublished={IBM SPSS Statistics 32.0.0 Command Syntax Reference}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-plum}}@misc{ibmnd31plumalgorytmy, author={{IBM Corp.}}, title={{PLUM algorithms}}, howpublished={IBM SPSS Statistics 31 Algorithms}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/pdf/IBM_SPSS_Statistics_Algorithms.pdf}}@misc{ibmnd32plumstudium, author={{IBM Corp.}}, title={{Using Ordinal Regression to Build a Credit Scoring Model}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_casestudies_project_ddita/spss/tutorials/plum_germcr_intro.html}}@article{menard2000coefficients, author={Menard, Scott}, title={{Coefficients of determination for multiple logistic regression analysis}}, journal={The American Statistician}, year={2000}, volume={54}, number={1}, pages={17--24}, doi={10.1080/00031305.2000.10474502}}@article{nagelkerke1991note, author={Nagelkerke, N. J. D.}, title={{A note on a general definition of the coefficient of determination}}, journal={Biometrika}, year={1991}, volume={78}, number={3}, pages={691--692}, doi={10.1093/biomet/78.3.691}}@article{peterson1990partial, author={Peterson, Bercedis and Harrell, Jr., Frank E.}, title={{Partial proportional odds models for ordinal response variables}}, journal={Applied Statistics}, year={1990}, volume={39}, number={2}, pages={205--217}, doi={10.2307/2347760}}