Czym jest TIPI
TIPI (Ten-Item Personality Inventory) to bardzo krótka miara pięciu wielkich cech osobowości. Gosling, Rentfrow i Swann (2003) opracowali ją na sytuacje, w których czasu na badanie jest mało. Według autorów TIPI jest nieco słabsze od standardowych, wielopozycyjnych narzędzi. Osiągnęło jednak zadowalający poziom zbieżności z popularnymi miarami Wielkiej Piątki, stabilności w czasie i zgodności samoopisu z oceną obserwatorów. Autorzy polecają je, gdy potrzebna jest bardzo krótka miara, gdy osobowość nie jest głównym tematem badania albo gdy badacz akceptuje słabsze właściwości psychometryczne.
W pracach dyplomowych TIPI pojawia się najczęściej w psychologii (osobowość jako zmienna kontrolna albo tło), w marketingu (osobowość konsumenta, segmentacja) i w zarządzaniu (osobowość a satysfakcja z pracy, styl pracy w zespole). Typowe analizy w tych dziedzinach opisują poradniki statystyka dla psychologa, statystyka w pracy z marketingu i statystyka w pracy z zarządzania i ekonomii. Jeśli osobowość jest główną zmienną Twojej pracy, rozważ dłuższe narzędzie: BFI-2 albo Mini-IPIP.
Budowa i klucz
TIPI ma 10 pozycji. Każda to para przymiotników, a badany ocenia, w jakim stopniu ta para do niego pasuje, na skali od 1 (zdecydowanie się nie zgadzam) do 7 (zdecydowanie się zgadzam). Każda z pięciu skal ma dwie pozycje: jedną opisującą biegun wysoki cechy i jedną opisującą biegun niski. Treści pozycji nie przytaczamy. Formularz jest na oficjalnej stronie autora (Gosling, b.d.).
Klucz poniżej pochodzi z oficjalnej strony Samuela Goslinga, z podstrony z formularzem (odczyt 1 listopada 2026). Litera R oznacza pozycję odwróconą.
| Skala | Pozycje | Wyższy wynik oznacza |
|---|---|---|
| Ekstrawersja (E) | 1, 6R | większą ekstrawersję |
| Ugodowość (A) | 2R, 7 | większą ugodowość |
| Sumienność (C) | 3, 8R | większą sumienność |
| Stabilność emocjonalna (ES) | 4R, 9 | większą stabilność, czyli niższą neurotyczność |
| Otwartość na doświadczenie (O) | 5, 10R | większą otwartość |
Zwróć uwagę na czwartą skalę. TIPI mierzy stabilność emocjonalną, a nie neurotyczność. Jeśli porównujesz wynik z BFI-2 albo z artykułami, w których raportowano neurotyczność, znak korelacji będzie odwrotny.
Jak policzyć wynik TIPI krok po kroku
Krok 1. Sprawdź kodowanie 1–7
W danych powinny być tylko liczby od 1 do 7, gdzie 7 oznacza najsilniejszą zgodę. Sprawdź eksport z ankiety online na kilku odpowiedziach testowych. Przekodowanie w różnych programach opisuje poradnik jak policzyć wynik kwestionariusza.
Krok 2. Odwróć pozycje 2, 4, 6, 8 i 10
Według strony autora przekodowujesz je odwrotnie: 7 na 1, 6 na 2, 5 na 3 i tak dalej (Gosling, b.d.). Na skali 1–7 robi to wzór 8 − x. Połowa pozycji TIPI jest odwrócona, więc pominięcie tego kroku niszczy wszystkie pięć wyników. Ogólne zasady opisuje hasło pozycja odwrócona.
Krok 3. Policz średnią dwóch pozycji w każdej skali
Wynik może przyjąć tylko 13 wartości: 1, 1.5, 2 i tak dalej aż do 7. To mało, ale wystarcza do korelacji i regresji. Nie licz wyniku ogólnego z dziesięciu pozycji, bo TIPI nie ma wyniku łącznego. Każda skala to osobna zmienna.
Krok 4. Brak jednej pozycji to brak wyniku skali
Autor nie podaje reguły dla braków. Przy dwóch pozycjach „wynik” z jednej odpowiedzi opisuje już tylko jeden biegun cechy. W przykładzie przyjęliśmy więc, że brak którejkolwiek pozycji oznacza brak wyniku tej skali. Pozostałe cztery skale tej osoby liczymy normalnie. Więcej o brakach piszemy we wpisie braki danych w ankiecie.
Dlaczego alfa przy dwóch pozycjach jest niska
Alfa Cronbacha zależy od dwóch rzeczy: liczby pozycji i średniej korelacji między nimi. Przy dwóch pozycjach o korelacji r standaryzowana alfa to wzór Spearmana–Browna: 2r / (1 + r). Żeby alfa osiągnęła .70, pozycje musiałyby korelować na poziomie około .54. Tymczasem TIPI celowo do tego nie dąży.
Gosling w nocie na swojej stronie wyjaśnia, że TIPI projektowano pod kątem trafności, w tym trafności treściowej, a nie wysokiej alfy (Gosling, b.d.). Dwie pozycje mają pokryć szeroką domenę i pochodzą z jej przeciwnych biegunów. Łatwo byłoby zbudować skalę ekstrawersji z dwóch niemal synonimów o gadatliwości. Alfa byłaby wtedy wysoka, ale skala mierzyłaby jeden wąski aspekt cechy. Według autora przy takich narzędziach właściwszym wskaźnikiem rzetelności jest rzetelność test–retest.
Jest też powód techniczny. Każda pozycja TIPI ma własną, stałą część wariancji: aspekt cechy, którego nie mierzy druga pozycja. Alfa traktuje tę część jak błąd, bo nie dzieli jej druga pozycja. Pomiar powtórzony po kilku tygodniach traktuje ją jak sygnał, bo jest stabilna. Dlatego test–retest bywa wyraźnie wyższy niż alfa. Omegi McDonalda też nie policzysz, bo model jednoczynnikowy z dwiema pozycjami nie jest identyfikowalny.
Co raportować zamiast samej alfy:
- korelację między pozycjami każdej skali (po odwróceniu) i ewentualnie jej korektę Spearmana–Browna – opisuje to hasło rzetelność połówkowa i wzór Spearmana–Browna;
- rzetelność test–retest, jeśli masz dwa pomiary, albo przytoczenie stabilności z oryginalnej publikacji;
- korelację z dłuższą miarą tej samej cechy (trafność zbieżna), jeśli w badaniu jest takie narzędzie.
Alfę możesz podać dla porządku, ale z jednym zdaniem wyjaśnienia. Promotorowi, który pyta o niską alfę, pomoże wpis alfa Cronbacha poniżej .70 – co zrobić.
Interpretacja: bez progów i bez polskich norm
Wyższy wynik oznacza wyższy poziom cechy w samoopisie. TIPI nie ma punktów odcięcia, a wynik analizuj jako zmienną ciągłą. Strona autora udostępnia normy z internetowego badania preferencji muzycznych prowadzonego przez Jasona Rentfrowa (Gosling, b.d.). Nie są to normy testowe dla Polski, więc nie klasyfikuj na ich podstawie osób z Twojej próby.
Krótkość ma swoją cenę. Credé i in. (2012) pokazali, że bardzo krótkie miary Wielkiej Piątki mogą zaniżać związki osobowości z zachowaniem i zwiększać ryzyko błędów I i II rodzaju. Słaby albo nieistotny związek ze skalą TIPI nie musi więc znaczyć, że cecha nie ma znaczenia. Wpisz to do ograniczeń badania.
Przykład: TIPI u 320 osób
Dane są symulowane i możesz je pobrać jako plik CSV. Zawierają surowe odpowiedzi 1–7 na 10 pozycji (t1–t10, przed odwróceniem), wyniki dłuższej miary tych samych cech (dl_E–dl_O, średnie 1–5) i drugi pomiar TIPI po około 6 tygodniach u 110 osób (r1–r10). Trzy osoby pominęły po jednej pozycji, więc nie mają wyniku jednej skali.
| Skala | n | M (SD) | r między pozycjami | α | Test–retest | r z dłuższą miarą |
|---|---|---|---|---|---|---|
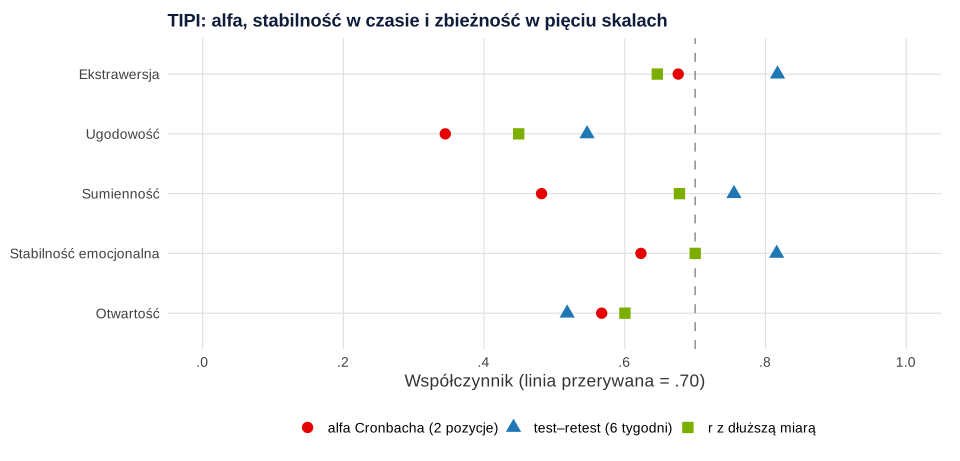
| Ekstrawersja | 320 | 4.04 (1.32) | .51 | .68 | .82 | .65 |
| Ugodowość | 318 | 4.02 (1.19) | .21 | .34 | .55 | .45 |
| Sumienność | 320 | 4.01 (1.24) | .32 | .48 | .76 | .68 |
| Stabilność emocjonalna | 320 | 3.95 (1.34) | .45 | .62 | .82 | .70 |
| Otwartość | 319 | 3.91 (1.27) | .40 | .57 | .52 | .60 |
Test–retest liczyliśmy na 110 osobach (przy ugodowości na 109). Alfa wahała się od .34 do .68, czyli w każdej skali była poniżej zwyczajowego .70. Korelacje między pozycjami wyniosły od .21 do .51. Mimo to wyniki TIPI korelowały z dłuższą miarą tej samej cechy na poziomie od .45 do .70. W trzech skalach test–retest był wyraźnie wyższy od alfy (rysunek 1). W otwartości było odwrotnie (.52 wobec .57), co przypomina, że korelacja ze 110 osób ma szeroki przedział ufności. Najsłabiej wypadła ugodowość: alfa .34, a korelacja z dłuższą miarą r = .45, 95% CI [.36, .53]. Taki wynik warto skomentować w ograniczeniach.
Co się dzieje bez odwrócenia pozycji
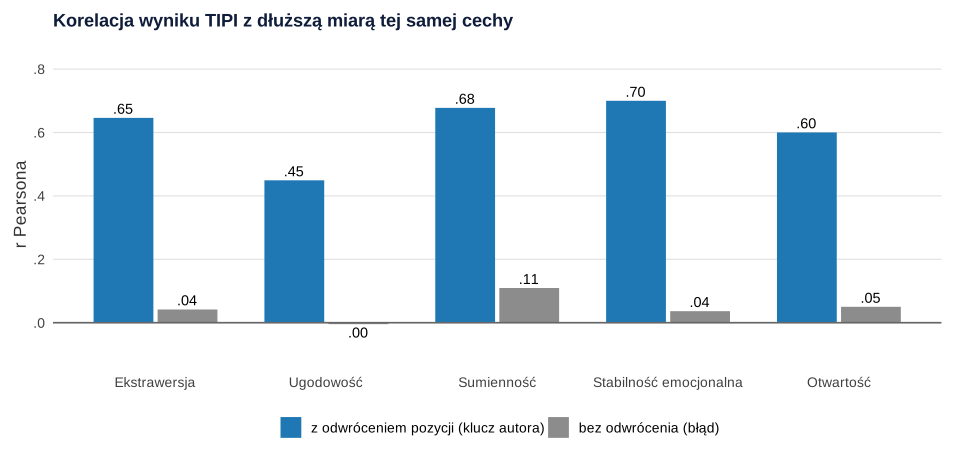
Policzyliśmy też wyniki błędnie, jako średnią surowych odpowiedzi bez odwracania. Korelacje z dłuższą miarą spadły wtedy do przedziału od .00 do .11 (rysunek 2). Pozycja standardowa i nieodwrócona pozycja przeciwna znoszą się nawzajem, więc taki „wynik” prawie niczego nie mierzy. Szybki test poprawności: po odwróceniu korelacja dwóch pozycji jednej skali powinna być dodatnia.
Jak opisać TIPI w pracy
Wzór zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane wersji, której używasz.
Jeśli nie masz drugiego pomiaru ani dłuższej miary, zostaw korelacje między pozycjami i powołaj się na stabilność i zbieżność opisane przez autorów (Gosling i in., 2003). Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a zasady interpretacji siły korelacji we wpisie czy korelacja .30 to dużo.
Licencja i polska wersja
Strona autora mówi wprost: każdy może używać TIPI w dowolnym celu i nie trzeba prosić o zgodę (Gosling, b.d.; odczyt 1 listopada 2026). To jedno z najswobodniej dostępnych narzędzi osobowości. W pracy i tak zacytuj artykuł Goslinga i in. (2003).
Na tej samej stronie są odnośniki do dwóch polskich wersji TIPI. Jedną opracowała Agnieszka Sorokowska, drugą Mariola Laguna. Autor zaznacza, że tłumaczeń nie opracował ani nie ocenia, i zachęca do kontaktu z ich autorkami. Publikacji walidacyjnych tych wersji nie weryfikowaliśmy, więc nie podajemy ich właściwości ani norm. W pracy zacytuj źródło wersji, której użyłeś (użyłaś). Własny przekład wymaga procedury opisanej we wpisie adaptacja kulturowa kwestionariusza.
TIPI w R: odwracanie, wyniki skal, test–retest i trafność zbieżna
Kod odtwarza liczby z tekstu i zapisuje plik CSV z danymi. Funkcja wynik_tipi() odwraca pozycje według klucza autora i liczy średnią każdej pary. Alfę dla par liczy pakiet psych, pozostałe wskaźniki – bazowe R.
Wynik TIPI krok po kroku
R
# B278 – TIPI: odwracanie pozycji, wynik 5 skal (średnia 2 pozycji), alfa przy 2 pozycjach, test–retest
# i korelacje z dłuższą miarą (dane symulowane, set.seed(27801)). Treści pozycji nie podajemy.
# Klucz z oficjalnej strony autora (Gosling, b.d.): pozycje odwrócone 2, 4, 6, 8, 10 (przekodowanie 8 − x);
# E = 1, 6R; A = 2R, 7; C = 3, 8R; ES (stabilność emocjonalna) = 4R, 9; O = 5, 10R; wynik skali = średnia 2 pozycji (1–7).
# Reguła braków (brak jednej pozycji = brak wyniku tej skali) jest decyzją badacza, nie autorów.
suppressPackageStartupMessages(library(psych))
set.seed(27801)
n <- 320
skale <- c("E", "A", "C", "ES", "O")
klucz <- list(E = c("t1", "t6"), A = c("t2", "t7"), C = c("t3", "t8"), ES = c("t4", "t9"), O = c("t5", "t10"))
odwr <- paste0("t", c(2, 4, 6, 8, 10))
r_wsp <- c(E = .52, A = .22, C = .38, ES = .46, O = .27)      # wspólna wariancja pary (szeroka domena, różne aspekty)
s_spec <- .40                                                   # stała wariancja specyficzna pozycji (aspekt, nie błąd)
progi <- c(-1.9, -1.2, -0.6, 0, 0.6, 1.3)
na_skale <- function(z) 1 + findInterval(z, progi)
cecha <- matrix(rnorm(n * 5), n, 5, dimnames = list(NULL, skale))
spec <- matrix(rnorm(n * 10), n, 10)
# pomiar 2 po ok. 6 tygodniach: cecha i aspekty stabilne (r = .92 i .88), błąd chwilowy nowy
cecha2 <- .92 * cecha + sqrt(1 - .92^2) * matrix(rnorm(n * 5), n, 5)
spec2 <- .88 * spec + sqrt(1 - .88^2) * matrix(rnorm(n * 10), n, 10)
generuj <- function(C, S) {
  out <- matrix(NA, n, 10, dimnames = list(NULL, paste0("t", 1:10)))
  for (d in skale) for (j in klucz[[d]]) {
    i <- as.integer(sub("t", "", j)); znak <- if (j %in% odwr) -1 else 1
    z <- sqrt(r_wsp[[d]]) * C[, d] + sqrt(s_spec) * S[, i] + sqrt(1 - r_wsp[[d]] - s_spec) * rnorm(n)
    out[, j] <- na_skale(znak * z)                                   # surowa odpowiedź 1–7 (przed odwróceniem)
  }
  out
}
t1 <- generuj(cecha, spec); t2 <- generuj(cecha2, spec2)
dl <- sapply(skale, function(d) round(pmin(5, pmax(1, 3.3 + .65 * (.85 * cecha[, d] + sqrt(1 - .85^2) * rnorm(n)))), 2))
colnames(dl) <- paste0("dl_", skale)                                # dłuższa miara (średnia 1–5), symulowana
retest <- seq_len(n) <= 110                                         # 110 osób wypełniło TIPI drugi raz
t2[!retest, ] <- NA; colnames(t2) <- paste0("r", 1:10)
dane <- data.frame(id = 1:n, t1, dl, t2)
dane$t7[c(44, 190)] <- NA; dane$t10[251] <- NA                     # pojedyncze braki
write.csv(dane, "../tipi-dane-przyklad.csv", row.names = FALSE, na = "")   # plik do pobrania

wynik_tipi <- function(d, pref = "t") {                             # odwrócenie 8 − x i średnia pary
  sapply(skale, function(s) {
    p <- sub("^t", pref, klucz[[s]]); x <- d[, p]
    for (k in seq_along(p)) if (klucz[[s]][k] %in% odwr) x[, k] <- 8 - x[, k]
    rowMeans(x)                                                       # NA, gdy brakuje którejkolwiek pozycji
  })
}

# Krok 1. Kontrola kodowania i braków
all(sapply(dane[, paste0("t", 1:10)], function(x) all(x %in% c(1:7, NA))))
colSums(is.na(dane[, paste0("t", 1:10)]))

# Krok 2. Wyniki pięciu skal (1–7, krok 0.5) i statystyki opisowe
W <- wynik_tipi(dane)
round(t(apply(W, 2, function(v) c(n = sum(!is.na(v)), M = mean(v, na.rm = TRUE), SD = sd(v, na.rm = TRUE)))), 2)

# Krok 3. Rzetelność par: korelacja pozycji (po odwróceniu), Spearman–Brown, alfa Cronbacha
pary <- t(sapply(skale, function(s) {
  x <- dane[, klucz[[s]]]; for (k in 1:2) if (klucz[[s]][k] %in% odwr) x[, k] <- 8 - x[, k]
  x <- na.omit(x); r <- cor(x[, 1], x[, 2])
  c(r = r, SB = 2 * r / (1 + r), alfa = alpha(x, warnings = FALSE)$total$raw_alpha)
}))
round(pary, 2)

# Krok 4. Test–retest (110 osób, ok. 6 tygodni) i trafność zbieżna z dłuższą miarą (cała próba)
W2 <- wynik_tipi(dane, "r")
rt <- sapply(skale, function(s) cor(W[, s], W2[, s], use = "complete.obs"))
zb <- sapply(skale, function(s) cor(W[, s], dane[, paste0("dl_", s)], use = "complete.obs"))
round(rbind(retest = rt, zbiezna = zb), 2)
sapply(skale, function(s) sum(complete.cases(W[, s], W2[, s])))      # n par test–retest
ct <- cor.test(W[, "A"], dane$dl_A)
round(c(A_pearson = unname(ct$estimate), lo = ct$conf.int[1], hi = ct$conf.int[2]), 2)

# Krok 5. Błąd: średnia bez odwrócenia pozycji – korelacja z dłuższą miarą
zle <- sapply(skale, function(s) rowMeans(dane[, klucz[[s]]]))
round(sapply(skale, function(s) cor(zle[, s], dane[, paste0("dl_", s)], use = "complete.obs")), 2)
Wynik w R
[1] TRUE
 t1  t2  t3  t4  t5  t6  t7  t8  t9 t10
  0   0   0   0   0   0   2   0   0   1
     n    M   SD
E  320 4.04 1.32
A  318 4.02 1.19
C  320 4.01 1.24
ES 320 3.95 1.34
O  319 3.91 1.27
      r   SB alfa
E  0.51 0.68 0.68
A  0.21 0.35 0.34
C  0.32 0.48 0.48
ES 0.45 0.62 0.62
O  0.40 0.57 0.57
           E    A    C   ES    O
retest  0.82 0.55 0.76 0.82 0.52
zbiezna 0.65 0.45 0.68 0.70 0.60
  E   A   C  ES   O
110 109 110 110 110
A_pearson        lo        hi
     0.45      0.36      0.53
   E    A    C   ES    O
0.04 0.00 0.11 0.04 0.05
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy TIPI
- Brak odwrócenia pozycji 2, 4, 6, 8 i 10. To najczęstszy i najgroźniejszy błąd. Sprawdź, czy po odwróceniu pozycje każdej pary korelują dodatnio.
- Neurotyczność zamiast stabilności. Czwarta skala TIPI to stabilność emocjonalna. Jeśli w pracy piszesz o neurotyczności, odwróć interpretację albo wynik i napisz to wprost.
- Wynik ogólny z 10 pozycji. TIPI daje pięć osobnych wyników, nie jeden.
- Usuwanie pozycji „żeby podnieść alfę”. Przy dwóch pozycjach usunięcie jednej zostawia pojedynczą pozycję i niszczy trafność treściową.
- Sama alfa bez komentarza. Dodaj korelacje między pozycjami i zdanie o tym, dlaczego alfa jest niska z założenia.
- TIPI jako główna zmienna pracy. Gdy osobowość jest w centrum pytania badawczego, krótka miara może zaniżyć efekty. Wtedy lepiej sięgnąć po BFI-2 albo Mini-IPIP.
Pełną ścieżkę analizy kwestionariusza porządkuje przewodnik po analizie kwestionariusza. Jeśli chcesz, żeby ktoś sprawdził liczenie wyników TIPI w Twojej bazie, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Które pozycje TIPI są odwrócone?
Według oficjalnej strony autora odwrócone są pozycje 2, 4, 6, 8 i 10. Przekodowujesz je wzorem 8 − x (7 na 1, 6 na 2 itd.). Pary to: ekstrawersja 1 i 6R, ugodowość 2R i 7, sumienność 3 i 8R, stabilność emocjonalna 4R i 9, otwartość 5 i 10R.
Dlaczego alfa Cronbacha w TIPI jest taka niska?
Bo każda skala ma tylko dwie pozycje, dobrane z przeciwnych biegunów szerokiej cechy. Przy dwóch pozycjach alfa zależy wyłącznie od ich korelacji, a ta jest umiarkowana z założenia. Autor zaleca, by jako wskaźnik rzetelności traktować raczej test–retest.
Co raportować zamiast alfy w TIPI?
Podaj korelację między pozycjami każdej skali (po odwróceniu), rzetelność test–retest, jeśli masz dwa pomiary, i korelację z dłuższą miarą tej samej cechy, jeśli była w badaniu. Alfę możesz dodać, ale z krótkim wyjaśnieniem, dlaczego jest niska.
Czy na użycie TIPI potrzebna jest zgoda autora?
Nie. Strona Samuela Goslinga mówi, że każdy może używać TIPI w dowolnym celu bez proszenia o zgodę. Zacytuj artykuł Goslinga i in. (2003) oraz źródło polskiej wersji, której używasz.
Czy TIPI wystarczy, jeśli osobowość jest główną zmienną pracy?
Raczej nie. Credé i in. (2012) pokazali, że bardzo krótkie miary Wielkiej Piątki mogą zaniżać związki osobowości z zachowaniem. Gdy osobowość jest w centrum pytania badawczego, wybierz dłuższe narzędzie, np. BFI-2 albo Mini-IPIP.
Powiązane hasła
Przeczytaj też
BFI-2 – jak policzyć wyniki Wielkiej Piątki
60 pozycji 1–5, zrównoważony klucz, średnie pięciu domen i 15 aspektów, rzetelność krótkich skal i opis wyników bez norm – z przykładem w R.
Czytaj →PoradnikMini-IPIP i IPIP – jak policzyć wyniki
Odpowiedzi 1–5, pozycje „+” i „−”, suma 4–20, klucz IPIP-50, rzetelność krótkich skal i opis wyników bez progów – z przykładem w R.
Czytaj →PoradnikAlfa Cronbacha poniżej .70
Pozycje odwrócone, kody braków, liczba pozycji, podskale i alfa po usunięciu pozycji: co sprawdzić przy niskiej alfie i jak ją opisać w pracy.
Czytaj →Masz wyniki TIPI i nie wiesz, jak je opisać?
Sprawdzimy odwrócenie pozycji, wyniki pięciu skal i opis rzetelności w Twojej próbie oraz wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Credé, M., Harms, P., Niehorster, S., & Gaye-Valentine, A. (2012). An evaluation of the consequences of using short measures of the Big Five personality traits. Journal of Personality and Social Psychology, 102(4), 874–888. https://doi.org/10.1037/a0027403
- Gosling, S. D. (b.d.). Ten Item Personality Measure (TIPI). Gosling Lab, University of Texas at Austin. https://gosling.psy.utexas.edu/scales-weve-developed/ten-item-personality-measure-tipi/ ● Otwarty dostęp
- Gosling, S. D., Rentfrow, P. J., & Swann, W. B., Jr. (2003). A very brief measure of the Big-Five personality domains. Journal of Research in Personality, 37(6), 504–528. https://doi.org/10.1016/s0092-6566(03)00046-1
Cytowania BibTeX
@article{crede2012evaluation, author={Credé, Marcus and Harms, Peter and Niehorster, Sarah and Gaye-Valentine, Andrea}, title={{An evaluation of the consequences of using short measures of the Big Five personality traits}}, journal={Journal of Personality and Social Psychology}, year={2012}, volume={102}, number={4}, pages={874--888}, doi={10.1037/a0027403}}@misc{goslingndtipi, author={Gosling, Samuel D.}, title={{Ten Item Personality Measure (TIPI)}}, howpublished={Gosling Lab, University of Texas at Austin}, year={b.d.}, url={https://gosling.psy.utexas.edu/scales-weve-developed/ten-item-personality-measure-tipi/}}@article{gosling2003very, author={Gosling, Samuel D. and Rentfrow, Peter J. and Swann, Jr., William B.}, title={{A very brief measure of the Big-Five personality domains}}, journal={Journal of Research in Personality}, year={2003}, volume={37}, number={6}, pages={504--528}, doi={10.1016/s0092-6566(03)00046-1}}