Kim był Quinn McNemar?
Quinn McNemar (1900–1986) był amerykańskim psychologiem i statystykiem, autorem testu dla zależnych proporcji, który dziś nosi jego nazwisko, i podręcznika Psychological Statistics (1949). Urodził się 20 lutego 1900 r. w Greenland w Wirginii Zachodniej, w rodzinie rolników. W 1918 r. zdał stanowy egzamin nauczycielski, a w 1925 r. ukończył Juniata College w Huntingdon w Pensylwanii. Przez dwa lata uczył matematyki i przedmiotów przyrodniczych w szkole średniej w Charles Town, po czym rozpoczął studia psychologiczne na Uniwersytecie Stanforda (Hilgard, 2000).
W Stanford trafił do wydziału kierowanego przez Lewisa Termana, twórcy stanfordzkiej wersji skali Bineta. Doktorat obronił jeszcze za kierownictwa Termana, a gdy statystyk Truman Kelley, jeden z pionierów analizy czynnikowej, odszedł na Harvard, McNemar przejął po nim rolę wydziałowego statystyka (Hilgard i Hastorf, 2004). Zmarł 3 lipca 1986 r. (Hilgard, 2000).
Najważniejsze pomysły
- Test dla zależnych proporcji (1947). W krótkiej notce w czasopiśmie Psychometrika McNemar podał dwa wzory na istotność różnicy między skorelowanymi proporcjami – na przykład odsetkiem odpowiedzi „tak” tych samych osób w dwóch pomiarach – i wskazał odpowiednik chi-kwadrat jednego z nich (McNemar, 1947). Tak powstał test McNemara: liczą się w nim wyłącznie pary niezgodne, czyli osoby, które zmieniły odpowiedź.
- Rewizja skali Stanford–Binet (1942). W książce poświęconej danym normalizacyjnym nowej wersji skali, z rozdziałem wstępnym Termana, McNemar przeanalizował wyniki próby, na której ustalano normy testu (McNemar, 1942). To przykład pracy, w której statystyka służy normalizacji testu psychometrycznego.
- Badania nad ilorazem inteligencji. W 1940 r. ogłosił obszerny krytyczny przegląd badań prowadzonych na Uniwersytecie Stanu Iowa nad wpływem środowiska na IQ (McNemar, 1940).
- Psychological Statistics (1949). Podręcznik statystyki dla psychologów wydany przez Wiley; miał kolejne wydania w latach 1955, 1962 i 1969 (McNemar, 1949).
Ciekawostka
Zanim McNemar zaczął uczyć statystyki w Stanford, uczył arytmetyki – jako dziecko. Chodził do jednoklasowej szkoły wiejskiej, w której nauczyciele często nie byli dobrze przygotowani, ale szkoła pozwalała mu sięgać po podręczniki wszystkich klas i pracować we własnym tempie. Arytmetykę z podręcznika dla ósmej klasy przerobił do końca piątego roku nauki. W następnym roku to on uczył arytmetyki ósmoklasistów, bo nauczyciel sobie z nią nie radził (Hilgard, 2000).
W tej samej szkole został do 18. roku życia, a stanowy egzamin nauczycielski w 1918 r. zdał – jak pisze Hilgard – bez trudu. Na uczelnię trafił dopiero jako dwudziestokilkulatek i przez kilka lat sam był nauczycielem, zanim wybrał psychologię (Hilgard, 2000).
Przykład: czy więcej kobiet pracowało w 1971 r. niż w 1967 r.?
Dane pochodzą z pakietu R vcdExtra (data(Heckman, package = "vcdExtra")): 1583 zamężne kobiety w latach 1967–1971 co roku pytano, czy pracują zawodowo. Według pliku pomocy dane pochodzą z pracy Jamesa Heckmana i Roberta Willisa z 1977 r., a w tej postaci tablicę podał J. K. Lindsey w książce z 1993 r. To prawdziwy panel: ta sama kobieta daje odpowiedź w każdym roku, więc lata nie są niezależnymi próbami.
W 1967 r. pracowało 42.7% kobiet, w 1971 r. – 45.7%. W tabeli par 499 kobiet pracowało w obu latach, a 682 – w żadnym. Te 1181 par zgodnych nic nie mówi o zmianie. Liczą się dwie komórki: 177 kobiet odeszło z pracy, a 225 ją podjęło. Statystyka McNemara wynosi (177 − 225)² / (177 + 225) = 5.73, χ²(1) = 5.73, p = .017. Wersja z poprawką na ciągłość daje χ²(1) = 5.50, p = .019, dokładny test dwumianowy – p = .019, a mid-p – .017. Odsetek pracujących wzrósł o 3.03 punktu procentowego, 95% CI [0.55, 5.51].
Na czym polega pomysł McNemara, widać po porównaniu błędów standardowych różnicy odsetków. Uwzględniający sparowanie wynosi 0.0126, a liczony tak, jakby w obu latach badano różne kobiety – 0.0176. Ten drugi daje z = 1.72 i p = .086 zamiast z = 2.40 i p = .017. Zwykły test dla dwóch proporcji marnuje informację o tym, że większość kobiet nie zmienia statusu.
Test McNemara dla kolejnych par lat pokazuje więcej niż porównanie końców okresu: w latach 1967–1968 i 1968–1969 pracę podejmowało istotnie więcej kobiet, niż ją porzucało (χ²(1) = 11.47 i 9.40, p = .001 i .002), w latach 1969–1970 przewaga była odwrotna (130 wobec 96, χ²(1) = 5.12, p = .024), a w latach 1970–1971 różnica nie była istotna (104 wobec 86, p = .192).
Na rysunku
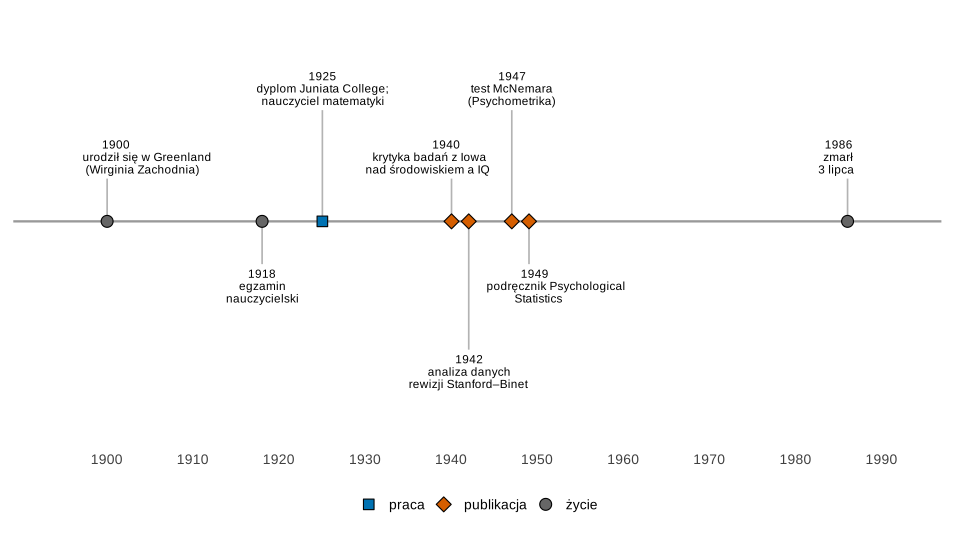
Co widać. Długą drogę do nauki przez wiejską szkołę i pracę nauczyciela, a potem dekadę 1940–1949, w której powstały prace, z których McNemar jest znany.
Na co uważać. Oś pokazuje tylko zdarzenia, których daty podają cytowane źródła; nie ma na niej roku doktoratu ani dat kolejnych stanowisk.
Podpis do pracy:
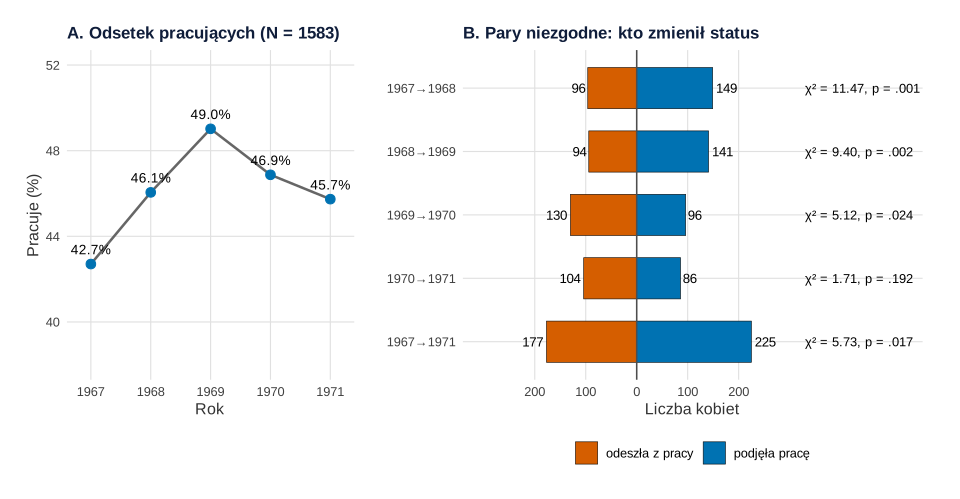
Co widać. Odsetek pracujących rósł do 1969 r., a potem spadał. Panel B pokazuje, z czego składa się każda zmiana: w każdym okresie kilkaset kobiet zmienia status w obie strony, a test ocenia tylko przewagę jednego kierunku.
Na co uważać. Pięć testów na tych samych danych to porównania wielokrotne (zob. korekta Bonferroniego); do jednoczesnego porównania wszystkich pięciu lat służy test Q Cochrana. Test McNemara nie wyjaśnia też, dlaczego kobiety zmieniały status.
Podpis do pracy:
Gdzie spotkasz McNemara w swojej pracy
- Badanie przed–po z odpowiedzią tak/nie. Gdy te same osoby odpowiadają dwukrotnie (przed szkoleniem i po nim), użyj testu McNemara zamiast chi-kwadrat niezależności; krok po kroku opisuje to poradnik Test McNemara – przed i po dla tak/nie, a wynik policzysz w kalkulatorze kappy i testu McNemara.
- Pary dopasowane. Ten sam test stosuje się, gdy każdej osobie z jednej grupy dobrano „bliźniaka” z drugiej.
- Więcej niż dwa pomiary. Dla trzech i więcej pomiarów dychotomicznych tych samych osób sięgnij po test Q Cochrana; dla zmiennej ilościowej odpowiednikiem jest test t dla prób zależnych.
- Raport. Podaj liczbę par niezgodnych w obu kierunkach, wersję testu i różnicę odsetków z przedziałem ufności.
Spory, mity i trudne strony
- Spór o środowisko i IQ. Praca z 1940 r. była krytyką badań zespołu z Iowa, które wiązały zmiany ilorazu inteligencji z wpływem środowiska. McNemar wypowiadał się w niej jako metodolog, recenzując cudze badania (McNemar, 1940). Tekst przedrukowano w 1973 r. w zbiorze The Measurement of Intelligence.
- „Chi-kwadrat McNemara” a test dokładny. Sam McNemar (1947) przedstawił wzory przybliżone i ich odpowiednik chi-kwadrat. Wersja dokładna, dwumianowa, i mid-p to późniejsze warianty tego samego pomysłu; przy małej liczbie par niezgodnych to one są właściwym wyborem.
Test McNemara w R
Kod buduje tabelę par z danych panelowych, liczy test McNemara w czterech wersjach, porównuje błąd standardowy różnicy odsetków dla prób zależnych i niezależnych, wykonuje test dla kolejnych par lat i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie używa losowania.
1. Test McNemara na danych panelowych: rysunek 2
Kod R rysunku 2
# Test McNemara na prawdziwych danych panelowych: zatrudnienie 1583 zamężnych kobiet w latach 1967–1971
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(odeszla = "#D55E00", podjela = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

data(Heckman, package = "vcdExtra")   # tablica 2 × 2 × 2 × 2 × 2: pracuje (Yes) / nie (No) w każdym roku
sum(Heckman)

# 1. Tabela par: ta sama kobieta w 1967 i w 1971 r.
tab <- margin.table(Heckman, c("e1967", "e1971"))
dimnames(tab) <- list(r1967 = c("pracuje", "nie pracuje"), r1971 = c("pracuje", "nie pracuje"))
tab
N <- sum(tab)
round(100 * c(odsetek_1967 = sum(tab[1, ]) / N, odsetek_1971 = sum(tab[, 1]) / N), 1)

# 2. Liczą się tylko pary niezgodne
b <- tab["pracuje", "nie pracuje"]   # odeszła z pracy
c_ <- tab["nie pracuje", "pracuje"]  # podjęła pracę
c(b = b, c = c_, zgodne = N - b - c_)
chi2 <- (b - c_)^2 / (b + c_)
chi2_popr <- (abs(b - c_) - 1)^2 / (b + c_)
p_dokl <- binom.test(c_, b + c_, p = 0.5)$p.value
p_mid <- 2 * min(pbinom(min(b, c_) - 1, b + c_, 0.5) + 0.5 * dbinom(min(b, c_), b + c_, 0.5), 0.5)
data.frame(wersja = c("bez poprawki", "z poprawką na ciągłość", "dokładna (dwumianowa)", "mid-p"),
           chi2 = round(c(chi2, chi2_popr, NA, NA), 2),
           p = round(c(pchisq(chi2, 1, lower.tail = FALSE), pchisq(chi2_popr, 1, lower.tail = FALSE), p_dokl, p_mid), 4))
mcnemar.test(tab, correct = FALSE)$statistic   # kontrola: to samo co chi2

# 3. Różnica odsetków i jej błąd standardowy dla proporcji skorelowanych (zależnych)
roznica <- (c_ - b) / N
se_zal <- sqrt((b + c_) / N - roznica^2) / sqrt(N)
round(100 * c(roznica = roznica, dolna = roznica - 1.96 * se_zal, gorna = roznica + 1.96 * se_zal), 2)
# błąd standardowy, gdyby (błędnie) potraktować oba lata jak niezależne próby
p1 <- sum(tab[1, ]) / N; p2 <- sum(tab[, 1]) / N
se_niez <- sqrt(p1 * (1 - p1) / N + p2 * (1 - p2) / N)
round(c(se_zalezne = se_zal, se_niezalezne = se_niez, z_zalezne = roznica / se_zal, z_niezalezne = roznica / se_niez), 4)
round(c(p_zalezne = 2 * pnorm(-abs(roznica / se_zal)), p_niezalezne = 2 * pnorm(-abs(roznica / se_niez))), 4)

# 4. Każda para lat: ile kobiet odeszło z pracy, ile ją podjęło
lata <- c("e1967", "e1968", "e1969", "e1970", "e1971")
pary <- list(c(1, 2), c(2, 3), c(3, 4), c(4, 5), c(1, 5))
zmiany <- do.call(rbind, lapply(pary, function(k) {
  t2 <- margin.table(Heckman, lata[k])
  b <- t2[1, 2]; c_ <- t2[2, 1]
  data.frame(okres = paste0(substr(lata[k[1]], 2, 5), "→", substr(lata[k[2]], 2, 5)), odeszla = b, podjela = c_,
             chi2 = round((b - c_)^2 / (b + c_), 2),
             p = round(pchisq((b - c_)^2 / (b + c_), 1, lower.tail = FALSE), 4),
             p_dokladne = round(binom.test(c_, b + c_)$p.value, 4))
}))
zmiany

# Rysunek: A – odsetek pracujących w kolejnych latach; B – pary niezgodne w każdej parze lat
odsetki <- data.frame(rok = 1967:1971, proc = sapply(lata, function(v) 100 * margin.table(Heckman, v)[1] / N))
pA <- ggplot(odsetki, aes(rok, proc)) +
  geom_line(colour = "grey40", linewidth = 0.9) + geom_point(size = 3, colour = "#0072B2") +
  geom_text(aes(label = sprintf("%.1f%%", proc)), vjust = -1, size = 3.6) +
  scale_x_continuous(expand = expansion(add = 0.4)) + scale_y_continuous(limits = c(38, 52)) +
  labs(title = "A. Odsetek pracujących (N = 1583)", x = "Rok", y = "Pracuje (%)") + motyw
dl <- rbind(data.frame(okres = zmiany$okres, kierunek = "odeszła z pracy", n = -zmiany$odeszla),
            data.frame(okres = zmiany$okres, kierunek = "podjęła pracę", n = zmiany$podjela))
dl$okres <- factor(dl$okres, levels = rev(zmiany$okres))
etyk <- data.frame(okres = factor(zmiany$okres, levels = rev(zmiany$okres)),
                   opis = paste0("χ² = ", sprintf("%.2f", zmiany$chi2), ", p = ", sub("^0", "", sprintf("%.3f", zmiany$p))))
pB <- ggplot(dl, aes(n, okres, fill = kierunek)) +
  geom_col(width = 0.65, colour = "black", linewidth = 0.2) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_text(aes(label = abs(n), hjust = ifelse(n < 0, 1.15, -0.15)), size = 3.5) +
  geom_text(data = etyk, aes(x = 330, y = okres, label = opis), inherit.aes = FALSE, hjust = 0, size = 3.4) +
  scale_fill_manual(values = unname(kol), name = NULL) +
  scale_x_continuous(limits = c(-300, 520), breaks = seq(-200, 200, 100), labels = abs(seq(-200, 200, 100))) +
  labs(title = "B. Pary niezgodne: kto zmienił status", x = "Liczba kobiet", y = NULL) + motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.6))
p2
Wynik w R
[1] 1583
             r1971
r1967         pracuje nie pracuje
  pracuje         499         177
  nie pracuje     225         682
odsetek_1967 odsetek_1971
        42.7         45.7
     b      c zgodne
   177    225   1181
                  wersja chi2      p
1           bez poprawki 5.73 0.0167
2 z poprawką na ciągłość 5.50 0.0191
3  dokładna (dwumianowa)   NA 0.0190
4                  mid-p   NA 0.0167
McNemar's chi-squared
             5.731343
roznica   dolna   gorna
   3.03    0.55    5.51
   se_zalezne se_niezalezne     z_zalezne  z_niezalezne
       0.0126        0.0176        2.3984        1.7185
   p_zalezne p_niezalezne
      0.0165       0.0857
      okres odeszla podjela  chi2      p p_dokladne
1 1967→1968      96     149 11.47 0.0007     0.0009
2 1968→1969      94     141  9.40 0.0022     0.0026
3 1969→1970     130      96  5.12 0.0237     0.0279
4 1970→1971     104      86  1.71 0.1916     0.2174
5 1967→1971     177     225  5.73 0.0167     0.0190
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Quinn McNemar (1900–1986) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1900, 1918, 1925, 1940, 1942, 1947, 1949, 1986),
  opis = c("urodził się w Greenland\n(Wirginia Zachodnia)", "egzamin\nnauczycielski", "dyplom Juniata College;\nnauczyciel matematyki",
           "krytyka badań z Iowa\nnad środowiskiem a IQ", "analiza danych\nrewizji Stanford–Binet", "test McNemara\n(Psychometrika)",
           "podręcznik Psychological\nStatistics", "zmarł\n3 lipca"),
  rodzaj = c("życie", "życie", "praca", "publikacja", "publikacja", "publikacja", "publikacja", "życie"),
  poziom = c(0.5, -0.5, 1.3, 0.5, -1.5, 1.3, -0.5, 0.5),   # wysokość etykiety
  wyrownanie = c(0.2, 0.5, 0.5, 0.7, 0.5, 0.5, 0.3, 0.8))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1894, 1992), breaks = seq(1900, 1990, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tabele brzegowe – margin.table(), test McNemara – mcnemar.test(), test dwumianowy – binom.test() z pakietów base i stats; dane – pakiet vcdExtra; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- vcdExtra (wersja 0.9.3): Friendly, M. (2026). vcdExtra: 'vcd' extensions and additions [R package]. https://doi.org/10.32614/CRAN.package.vcdExtra
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Quinn McNemar?
Amerykańskim psychologiem i statystykiem (1900–1986). Urodził się w Greenland w Wirginii Zachodniej, ukończył Juniata College (1925), przez dwa lata uczył w szkole średniej, a potem studiował psychologię w Stanford u Lewisa Termana i został tam statystykiem wydziału (Hilgard, 2000; Hilgard i Hastorf, 2004).
Skąd nazwa „test McNemara”?
Od notki McNemara w czasopiśmie Psychometrika z 1947 r., w której podał wzory na istotność różnicy między skorelowanymi proporcjami (np. odsetek „tak” tych samych osób w dwóch pomiarach) i wskazał ich odpowiednik chi-kwadrat. Test opiera się wyłącznie na parach niezgodnych.
Dlaczego przy danych przed–po nie wystarczy zwykły test dla dwóch proporcji?
Bo traktuje oba pomiary jak niezależne próby i pomija to, że większość osób odpowiada tak samo. W przykładzie z zatrudnieniem 1583 kobiet błąd standardowy różnicy odsetków wynosi 0.0126 przy uwzględnieniu sparowania i 0.0176 bez niego; p zmienia się z .017 na .086.
Czym zajmował się McNemar poza testem nazwanym jego nazwiskiem?
Pomiarem inteligencji: analizował dane normalizacyjne rewizji skali Stanford–Binet (1942) i w 1940 r. opublikował krytyczny przegląd badań z Uniwersytetu Stanu Iowa nad wpływem środowiska na IQ. Napisał też podręcznik Psychological Statistics (1949), wznawiany do 1969 r.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Test McNemara – przed i po dla tak/nie
Tabela par, wybór wersji testu (asymptotyczna, dokładna, mid-p) i 95% CI dla sparowanej różnicy odsetków – z przykładem w R i wzorem opisu.
Czytaj →PoradnikKalkulator kappy Cohena i testu McNemara
Kappa Cohena i kappa ważona z przedziałem ufności dla dwóch oceniających oraz test McNemara w czterech wersjach z przedziałem dla różnicy odsetków.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hilgard, E. R. (2000). McNemar, Quinn. In American National Biography. Oxford University Press. https://doi.org/10.1093/anb/9780198606697.article.1400919
- Hilgard, E. R., & Hastorf, A. H. (2004). History of the Department of Psychology at Stanford University. Stanford University, Department of Psychology. https://psychology.stanford.edu/about/history ● Otwarty dostęp
- McNemar, Q. (1940). A critical examination of the University of Iowa studies of environmental influences upon the IQ. Psychological Bulletin, 37(2), 63–92. https://doi.org/10.1037/h0051468
- McNemar, Q. (1942). The revision of the Stanford-Binet scale: An analysis of the standardization data. Houghton Mifflin.
- McNemar, Q. (1947). Note on the sampling error of the difference between correlated proportions or percentages. Psychometrika, 12(2), 153–157. https://doi.org/10.1007/BF02295996
- McNemar, Q. (1949). Psychological statistics. Wiley.
Cytowania BibTeX
@incollection{hilgard2000mcnemar, author={Hilgard, Ernest R.}, title={{McNemar, Quinn}}, booktitle={American National Biography}, year={2000}, publisher={Oxford University Press}, doi={10.1093/anb/9780198606697.article.1400919}}@misc{hilgard2004stanford, author={Hilgard, Ernest R. and Hastorf, Albert H.}, title={{History of the Department of Psychology at Stanford University}}, howpublished={Stanford University, Department of Psychology}, year={2004}, publisher={Stanford University}, url={https://psychology.stanford.edu/about/history}}@article{mcnemar1940critical, author={McNemar, Quinn}, title={{A critical examination of the University of Iowa studies of environmental influences upon the IQ}}, journal={Psychological Bulletin}, year={1940}, volume={37}, number={2}, pages={63--92}, doi={10.1037/h0051468}}@book{mcnemar1942revision, author={McNemar, Quinn}, title={{The revision of the Stanford-Binet scale: An analysis of the standardization data}}, year={1942}, publisher={Houghton Mifflin}, url={https://lccn.loc.gov/42014483}}@article{mcnemar1947note, author={McNemar, Quinn}, title={{Note on the sampling error of the difference between correlated proportions or percentages}}, journal={Psychometrika}, year={1947}, volume={12}, number={2}, pages={153--157}, doi={10.1007/bf02295996}}@book{mcnemar1949psychological, author={McNemar, Quinn}, title={{Psychological statistics}}, year={1949}, publisher={Wiley}, url={https://lccn.loc.gov/49001014}}