Kim był Lewis Terman?
Lewis Madison Terman (1877–1956) był amerykańskim psychologiem, który zrobił z ilorazu inteligencji (IQ) pojęcie powszechnie znane. Urodził się 15 stycznia 1877 r. na farmie w hrabstwie Johnson w Indianie jako dwunaste z czternaściorga dzieci. W wieku 15 lat zaczął naukę w Central Normal College w Danville, uczył w wiejskich szkołach, potem studiował na Indiana University, a w 1905 r. obronił doktorat u G. Stanleya Halla w Clark University. W doktoracie porównał siedmioro dzieci bystrych i siedmioro słabych w testach własnego pomysłu (Boring, 1959).
Z powodu gruźlicy szukał posady w ciepłym klimacie: był dyrektorem szkoły średniej w San Bernardino, w latach 1906–1910 wykładał w szkole nauczycielskiej w Los Angeles, a w 1910 r. przeszedł na Uniwersytet Stanforda. W latach 1922–1942 kierował tam wydziałem psychologii, w 1923 r. był prezesem American Psychological Association, a w 1928 r. został członkiem National Academy of Sciences. Zmarł w Stanfordzie 21 grudnia 1956 r. (Boring, 1959).
Najważniejsze pomysły
- Stanford–Binet i IQ. W 1916 r. wydał stanfordzką rewizję i rozszerzenie skali Bineta–Simona. Wynik podawał jako iloraz inteligencji – wiek umysłowy podzielony przez wiek życia – a poprawnie zbudowana skala miała dawać medianę IQ równą 100 w każdym roczniku niewybranych dzieci (Terman, 1916). Wyniki klasyfikował w przedziałach: powyżej 140 – „blisko geniuszu lub geniusz”, poniżej 70 – niedorozwój umysłowy; sam zaznaczał, że granice są umowne (Terman, 1916). W 1937 r. z Maud Merrill wydał nową wersję z dwiema równoległymi formami, które pozwalały badać tę samą osobę ponownie (Boring, 1959).
- Testy dla armii. W 1917 r. był jednym z pięciu psychologów, którzy w Vineland zaplanowali badanie testami poborowych armii USA pod kierunkiem Roberta Yerkesa; napisał część raportu z tych badań wydanego w 1921 r. (Boring, 1959).
- Badanie dzieci zdolnych. Od 1921 r., z pieniędzy Commonwealth Fund, prowadził badanie kalifornijskich uczniów z IQ co najmniej 140. Nauczyciele wskazywali w każdej klasie troje najbystrzejszych dzieci i dziecko najmłodsze – i to drugie kryterium okazało się najlepsze. Grupa urosła do 1528 osób (Boring, 1959). To jedno z pierwszych dużych badań w schemacie podłużnym, z ponownymi pomiarami w latach 1927–28, 1936, 1940 i 1945 oraz tomami „Genetic Studies of Genius” (1925–1947).
Ciekawostka
Przepowiednia frenologa. Gdy Terman miał około dziesięciu lat, jego brat kupił książkę o frenologii. Sprzedawca obmacał chłopcu guzy na głowie i przepowiedział mu wielką przyszłość (Boring, 1959). Chłopiec czytał potem w domu encyklopedię i niemal wszystkie książki ojca.
Drugi tom „Genetic Studies of Genius” (1926), napisany przez Catharine Cox, był rodzajem grupy porównawczej: na podstawie biografii 300 wybitnych postaci historycznych oszacowano ich IQ w dzieciństwie – Goethemu wyszło około 210, a Napoleonowi 145 (Boring, 1959).
Przykład: próg IQ 140 i powtórne badanie
Terman wybierał dzieci jednym progiem – IQ 140 – a potem badał je ponownie przez lata. Boring (1959) streszcza wniosek z 1947 r. tak: zdolności grupy nieco „cofnęły się” ku przeciętności, ale tylko tyle, ile należało oczekiwać ze względów statystycznych. Tym zjawiskiem jest regresja do średniej. Pokazujemy je na danych fikcyjnych, a nie na danych Termana.
Zasymulowaliśmy 160 000 uczniów (set.seed(901)) – tylu, według Boringa (1959), liczyła wtedy populacja szkolna Kalifornii. Wynik testu to poziom prawdziwy plus błąd pomiaru, na skali o średniej 100 i SD 15, a korelacja dwóch równoległych badań (rzetelność) wynosi .90. Parametry dobraliśmy ręcznie. W rozkładzie normalnym z SD 15 próg 140 przekracza 0.38% populacji (w symulacji 0.40%), a próg 130 – 2.28%.
Progiem 140 w pierwszym badaniu wybraliśmy 637 dzieci. Ich średnie IQ wynosiło 144.5, a w drugim badaniu tym samym testem – 139.9; wzór 100 + .90 × (144.5 − 100) przewidywał 140.1. Tylko 48.2% wybranych dzieci miało 140 lub więcej także w drugim badaniu, a 46.8% miało prawdziwy poziom co najmniej 140. Za to 92 dzieci o prawdziwym poziomie 140+ nie przekroczyło progu w pierwszym badaniu i nie zostało wybranych.
Na rysunku
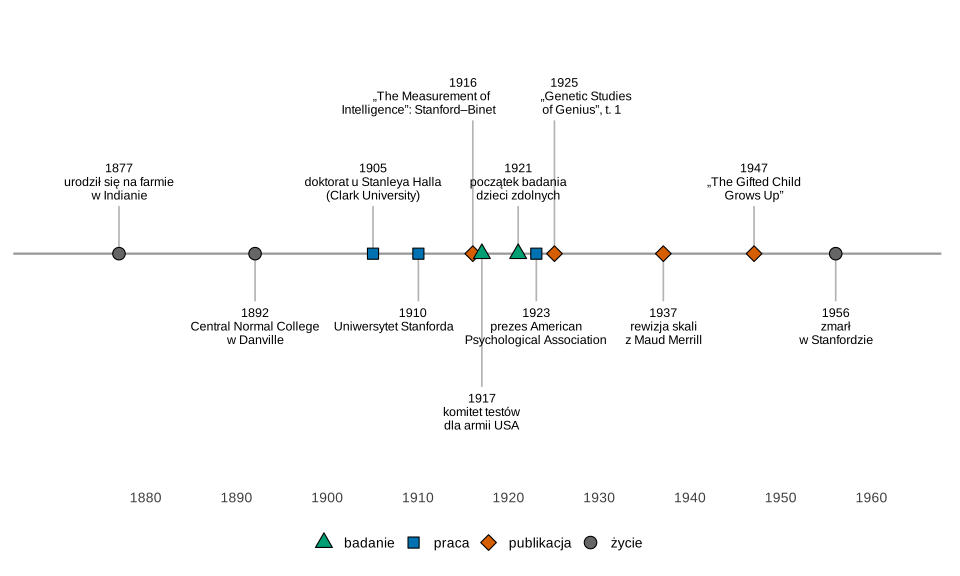
Co widać. Najważniejsze prace Termana skupiły się w latach 1916–1925; badanie dzieci zdolnych trwało do jego śmierci i dłużej.
Na co uważać. Rok 1921 to początek badania, a nie publikacji – pierwszy tom wyników ukazał się w 1925 r. Piąty tom był w przygotowaniu w chwili śmierci Termana i miała go dokończyć Melita Oden (Boring, 1959).
Podpis do pracy:
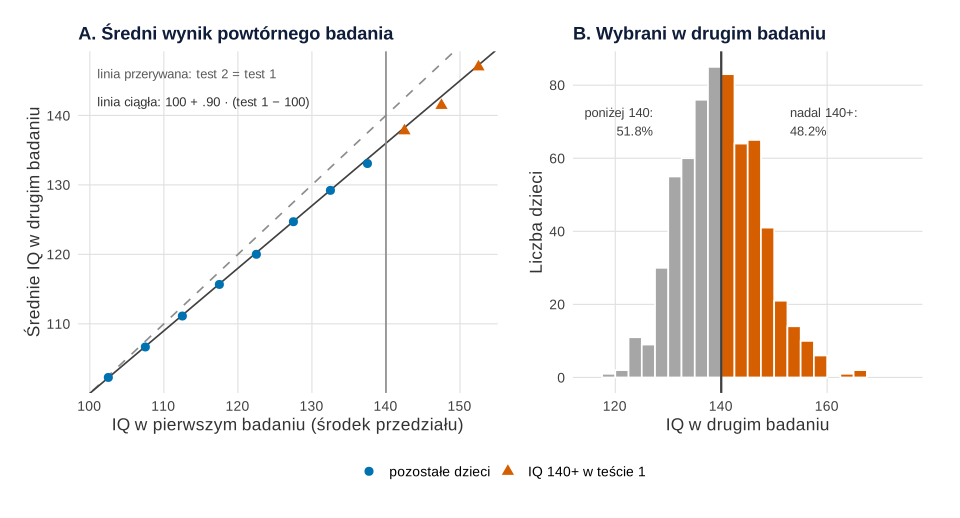
set.seed(901)).Co widać. Im dalej od średniej leży pierwszy wynik, tym bardziej drugi wynik „cofa się” ku 100 – o 10% odległości przy rzetelności .90. Grupa wybrana progiem średnio prawie dokładnie trafia na próg, więc mniej więcej połowa dzieci przy drugim badaniu spada poniżej 140.
Na co uważać. Nikt tu nie „stracił” zdolności: poziom prawdziwy się nie zmienił, a spadek wynika z błędu pomiaru przy wyborze. W prawdziwym badaniu podłużnym dochodzą zmiany rozwojowe, inne wersje testu i błąd selekcji w samym doborze uczniów do testowania.
Podpis do pracy:
Gdzie spotkasz Termana w swojej pracy
- Wynik testu inteligencji podajesz dziś jako iloraz dewiacyjny względem rówieśników – zob. skala IQ i normy wiekowe. Przejście do ilorazu dewiacyjnego opisuje hasło David Wechsler.
- Gdy kwalifikujesz osoby do badania progiem (np. wysoki wynik w skali objawów albo wysokie IQ), licz się z regresją do średniej i potrzebą grupy porównawczej lub pomiaru wyjściowego w analizie.
- Badanie Termana pokazuje siłę i granice badań podłużnych: grupa wybrana skrajnym wynikiem nie reprezentuje populacji.
- Szukanie jednostek wybitnych łączy Termana z Galtonem. Rozbijaniu inteligencji na zdolności pierwotne (Thurstone) Terman się sprzeciwiał (Boring, 1959).
Spory, mity i trudne strony
- Eugenika i rasa. W książce z 1916 r. Terman pisał, że testy pomogą ograniczać rozrodczość osób „niedorozwiniętych umysłowo”. Niskie wyniki dzieci z rodzin meksykańskich, indiańskich i czarnoskórych uznawał za dziedziczne, proponował uczyć te dzieci w osobnych klasach i nazywał je problemem z punktu widzenia eugeniki (Terman, 1916, s. 7, 91–92). W 1932 r. pisał, że różnic w wynikach między grupami rasowymi nie wyjaśni samo środowisko. Na marginesie własnego egzemplarza dopisał jednak w 1951 r., że jest tego mniej pewny, a w 1955 r. – że jeszcze mniej (Boring, 1959).
- Ocena dorobku. Warne (2019) uważa, że najczęstsze zarzuty – przecenianie IQ, poparcie dla merytokracji i przedkładanie wyjaśnień genetycznych nad środowiskowe – są do pewnego stopnia uzasadnione przez źródła, a Terman często budował mocne opinie na słabych danych. Ten sam autor podkreśla jego wkład w psychometrię i gotowość do zmiany zdania pod wpływem nowych dowodów.
- IQ to nie wszystko. Według Boringa (1959) już z danych z 1947 r. wynikało, że wysokie IQ utrzymane w dorosłości nie wystarcza do wybitnych osiągnięć – potrzebna jest też motywacja.
Próg IQ 140 w R
Kod symuluje 160 000 uczniów, liczy odsetki powyżej progów IQ, wybiera dzieci z IQ co najmniej 140, porównuje ich pierwszy i drugi wynik z wartością przewidywaną i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne.
1. Wybór progiem i powtórne badanie: rysunek 2
Kod R rysunku 2
# Lewis Terman: wybór dzieci „zdolnych” progiem IQ 140 i powtórne badanie – symulacja (dane fikcyjne)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(wybrane = "#D55E00", pozostale = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
# Założenia (dobrane ręcznie, ilustracyjne): 160 000 uczniów; wynik testu = poziom prawdziwy + błąd pomiaru;
# skala IQ: średnia 100, SD 15; rzetelność testu .90 (korelacja dwóch równoległych pomiarów)
set.seed(901)
n <- 160000
rzetelnosc <- 0.90
prawdziwy <- rnorm(n, 100, 15 * sqrt(rzetelnosc))
sd_bledu <- 15 * sqrt(1 - rzetelnosc)
test1 <- prawdziwy + rnorm(n, 0, sd_bledu)    # pierwsze badanie: na jego podstawie wybieramy dzieci
test2 <- prawdziwy + rnorm(n, 0, sd_bledu)    # powtórne badanie tym samym (równoległym) testem
prog <- 140

# 1) Jaki odsetek populacji przekracza progi przy SD = 15 (teoretycznie i w symulacji)?
progi <- c(120, 130, 140, 150)
round(data.frame(prog = progi,
                 teoria_proc = 100 * pnorm(progi, 100, 15, lower.tail = FALSE),
                 symulacja_proc = sapply(progi, function(p) 100 * mean(test1 >= p))), 2)

# 2) Wybór: IQ co najmniej 140 w pierwszym badaniu
wybrane <- test1 >= prog
c(liczba_wybranych = sum(wybrane))
c(korelacja_badan = sprintf("%.3f", cor(test1, test2)))
round(c(srednia_test1 = mean(test1[wybrane]),
        srednia_test2 = mean(test2[wybrane]),
        przewidywana_test2 = 100 + cor(test1, test2) * (mean(test1[wybrane]) - 100),
        srednia_poziom_prawdziwy = mean(prawdziwy[wybrane])), 1)
# Ile wybranych dzieci ma 140+ także w powtórnym badaniu, a ile ma prawdziwy poziom 140+?
round(c(proc_140_w_test2 = 100 * mean(test2[wybrane] >= prog),
        proc_prawdziwy_140 = 100 * mean(prawdziwy[wybrane] >= prog),
        pominiete_z_prawdziwym_140 = sum(!wybrane & prawdziwy >= prog)), 1)

# Rysunek 2A: średni wynik powtórnego badania w przedziałach wyniku pierwszego badania (szerokość 5 pkt)
przedzialy <- cut(test1, breaks = seq(60, 165, by = 5))
srednie <- aggregate(data.frame(test2 = test2), list(przedzial = przedzialy), mean)
srednie$srodek <- seq(62.5, 162.5, by = 5)[as.integer(srednie$przedzial)]
srednie$n <- as.vector(table(przedzialy))[as.integer(srednie$przedzial)]
srednie <- srednie[srednie$n >= 20 & srednie$srodek >= 100, ]
srednie$grupa <- ifelse(srednie$srodek >= prog, "wybrane", "pozostale")
pA <- ggplot(srednie, aes(srodek, test2)) +
  geom_abline(intercept = 0, slope = 1, colour = "grey55", linetype = "dashed") +
  geom_abline(intercept = 100 * (1 - rzetelnosc), slope = rzetelnosc, colour = "grey25") +
  geom_vline(xintercept = prog, colour = "grey55") +
  geom_point(aes(colour = grupa, shape = grupa), size = 2.8) +
  annotate("text", x = 101, y = 146, label = "linia przerywana: test 2 = test 1", hjust = 0, size = 3.4, colour = "grey35") +
  annotate("text", x = 101, y = 142, label = "linia ciągła: 100 + .90 · (test 1 − 100)", hjust = 0, size = 3.4, colour = "grey20") +
  scale_colour_manual(values = kol, name = NULL, labels = c(wybrane = "IQ 140+ w teście 1", pozostale = "pozostałe dzieci")) +
  scale_shape_manual(values = c(wybrane = 17, pozostale = 16), name = NULL,
                     labels = c(wybrane = "IQ 140+ w teście 1", pozostale = "pozostałe dzieci")) +
  scale_x_continuous(breaks = seq(100, 160, by = 10)) + scale_y_continuous(breaks = seq(100, 160, by = 10)) +
  labs(title = "A. Średni wynik powtórnego badania", x = "IQ w pierwszym badaniu (środek przedziału)", y = "Średnie IQ w drugim badaniu") +
  motyw
# Rysunek 2B: rozkład wyników powtórnego badania u dzieci wybranych progiem 140 (szare – poniżej 140 w teście 2)
druga <- data.frame(test2 = test2[wybrane], nadal = test2[wybrane] >= prog)
pB <- ggplot(druga, aes(test2, fill = nadal)) +
  geom_histogram(breaks = seq(115, 175, by = 2.5), colour = "white") +
  geom_vline(xintercept = prog, colour = "grey25", linewidth = 0.8) +
  annotate("text", x = 127, y = 70, label = paste0("poniżej 140:\n", round(100 * mean(!druga$nadal), 1), "%"),
           hjust = 1, size = 3.4, colour = "grey25") +
  annotate("text", x = 153, y = 70, label = paste0("nadal 140+:\n", round(100 * mean(druga$nadal), 1), "%"),
           hjust = 0, size = 3.4, colour = "grey25") +
  scale_fill_manual(values = c("FALSE" = "grey65", "TRUE" = "#D55E00"), guide = "none") +
  labs(title = "B. Wybrani w drugim badaniu", x = "IQ w drugim badaniu", y = "Liczba dzieci") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.2, 1), guides = "collect") & theme(legend.position = "bottom")
p2
Wynik w R
  prog teoria_proc symulacja_proc
1  120        9.12           9.25
2  130        2.28           2.30
3  140        0.38           0.40
4  150        0.04           0.05
liczba_wybranych
             637
korelacja_badan
        "0.900"
           srednia_test1            srednia_test2       przewidywana_test2
                   144.5                    139.9                    140.1
srednia_poziom_prawdziwy
                   140.0
          proc_140_w_test2         proc_prawdziwy_140
                      48.2                       46.8
pominiete_z_prawdziwym_140
                      92.0
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Lewis Terman, 1877–1956 – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1877, 1892, 1905, 1910, 1916, 1917, 1921, 1923, 1925, 1937, 1947, 1956),
  opis = c("urodził się na farmie\nw Indianie", "Central Normal College\nw Danville", "doktorat u Stanleya Halla\n(Clark University)",
           "Uniwersytet Stanforda", "„The Measurement of\nIntelligence”: Stanford–Binet", "komitet testów\ndla armii USA",
           "początek badania\ndzieci zdolnych", "prezes American\nPsychological Association", "„Genetic Studies\nof Genius”, t. 1",
           "rewizja skali\nz Maud Merrill", "„The Gifted Child\nGrows Up”", "zmarł\nw Stanfordzie"),
  rodzaj = c("życie", "życie", "praca", "praca", "publikacja", "badanie", "badanie", "praca", "publikacja", "publikacja", "publikacja", "życie"))
# Etykiety na przemian nad (1) i pod (−1) osią, na dwóch wysokościach, w gęstych latach przesunięte w bok
zdarzenia$strona <- c(1, -1, 1, -1, 1, -1, 1, -1, 1, -1, 1, -1)
zdarzenia$poziom <- c(0.5, 0.5, 0.5, 0.5, 1.4, 1.4, 0.5, 0.5, 1.4, 0.5, 0.5, 0.5)
zdarzenia$wyrownanie <- c(0.5, 0.5, 0.5, 0.7, 0.85, 0.5, 0.5, 0.5, 0.15, 0.5, 0.5, 0.5)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "badanie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "badanie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = (poziom + 0.07) * strona, label = paste0(rok, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie),
            size = 3.3, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1870, 1963), breaks = seq(1880, 1960, by = 10)) +
  scale_y_continuous(limits = c(-2.2, 2.3)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie – funkcja rnorm(), odsetki – pnorm(), korelacja – cor() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Lewis Terman?
Amerykańskim psychologiem (1877–1956), od 1910 r. związanym z Uniwersytetem Stanforda, w latach 1922–1942 kierownikiem jego wydziału psychologii i w 1923 r. prezesem American Psychological Association. Był autorem skali Stanford–Binet i badania dzieci zdolnych (Boring, 1959).
Czym jest skala Stanford–Binet?
Opracowaną przez Termana w 1916 r. amerykańską rewizją i rozszerzeniem skali Bineta–Simona. Wynik podawała jako iloraz inteligencji: wiek umysłowy podzielony przez wiek życia, razy 100 (Terman, 1916). W 1937 r. Terman i Maud Merrill wydali jej nową wersję z dwiema równoległymi formami (Boring, 1959).
Na czym polegało badanie dzieci zdolnych Termana?
Od 1921 r. nauczyciele w Kalifornii wskazywali najbystrzejszych uczniów, których badano testem; do grupy trafiały dzieci z IQ 140 i wyższym. Grupa liczyła w końcu 1528 osób, a ponowne badania prowadzono w latach 1927–28, 1936, 1940 i 1945 (Boring, 1959).
Czy Lewis Terman był eugenikiem?
W książce z 1916 r. pisał o ograniczaniu rozrodczości osób „niedorozwiniętych umysłowo”, a niskie wyniki niektórych grup etnicznych uznawał za dziedziczne i problem z punktu widzenia eugeniki (Terman, 1916, s. 91–92). Później, w 1951 i 1955 r., zanotował, że w sprawie dziedziczenia różnic rasowych jest coraz mniej pewny (Boring, 1959).
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Boring, E. G. (1959). Lewis Madison Terman, 1877–1956. Biographical Memoirs of the National Academy of Sciences, 33, 414–461. https://www.nasonline.org/wp-content/uploads/2024/06/terman-lewis.pdf ● Otwarty dostęp
- Terman, L. M. (1916). The measurement of intelligence: An explanation of and a complete guide for the use of the Stanford revision and extension of the Binet-Simon intelligence scale. Houghton Mifflin. https://doi.org/10.1037/10014-000
- Warne, R. T. (2019). An evaluation (and vindication?) of Lewis Terman: What the father of gifted education can teach the 21st century. Gifted Child Quarterly, 63(1), 3–21. https://doi.org/10.1177/0016986218799433
Cytowania BibTeX
@article{boring1959lewis, author={Boring, Edwin G.}, title={{Lewis Madison Terman, 1877–1956}}, journal={Biographical Memoirs of the National Academy of Sciences}, year={1959}, volume={33}, pages={414--461}, publisher={National Academy of Sciences}, url={https://www.nasonline.org/wp-content/uploads/2024/06/terman-lewis.pdf}}@book{terman1916measurement, author={Terman, Lewis M.}, title={{The measurement of intelligence: An explanation of and a complete guide for the use of the Stanford revision and extension of the Binet-Simon intelligence scale}}, year={1916}, publisher={Houghton Mifflin}, doi={10.1037/10014-000}}@article{warne2019evaluation, author={Warne, Russell T.}, title={{An evaluation (and vindication?) of Lewis Terman: What the father of gifted education can teach the 21st century}}, journal={Gifted Child Quarterly}, year={2019}, volume={63}, number={1}, pages={3--21}, doi={10.1177/0016986218799433}}