Kim był Peter Armitage?
Peter Armitage (1924–2024) urodził się 15 czerwca 1924 r. w Huddersfield w hrabstwie Yorkshire. W styczniu 1941 r. rozpoczął studia matematyczne w Trinity College w Cambridge. Przerwała je służba wojenna, a dyplom z wyróżnieniem uzyskał w 1947 r. W grudniu tego roku zaczął pracę w jednostce badań statystycznych Medical Research Council (MRC) przy London School of Hygiene and Tropical Medicine (LSHTM). Jednostką kierował Austin Bradford Hill. W 1951 r. Armitage obronił doktorat na Uniwersytecie Londyńskim, a w 1961 r. zastąpił Hilla na stanowisku profesora statystyki medycznej LSHTM (Matthews, 2024).
W 1976 r. przeniósł się do Oksfordu jako profesor biomatematyki. W 1988 r. został pierwszym kierownikiem nowego Wydziału Statystyki, a w 1990 r. przeszedł na emeryturę. W latach 1982–1984 był prezesem Royal Statistical Society. W 1990 r. jako druga osoba w historii miał już komplet Medali Guya: złoty, srebrny i brązowy (Royal Statistical Society, 2024). Zmarł 14 lutego 2024 r. w Wallingford, w wieku 99 lat (Matthews, 2024).
Najważniejsze pomysły
- Badania sekwencyjne w medycynie. Armitage chciał, żeby badanie kliniczne można było przerwać wcześniej, gdy różnica między leczeniami staje się wyraźna. Zamiast otwartych planów Abrahama Walda zaproponował plany zamknięte z górną granicą liczby obserwacji. Opisał je w pracy z 1957 r. i w książce Sequential Medical Trials (Armitage, 1981; Matthews, 2024). To korzenie dzisiejszych analiz pośrednich i reguł zatrzymania.
- Powtarzane testy na narastających danych (1969). Armitage, McPherson i Rowe (1969) policzyli, jak bardzo rośnie szansa fałszywie istotnego wyniku, gdy test na tym samym poziomie α powtarza się po każdej porcji danych. Ten problem rozwiązują dziś m.in. granice grupowych planów sekwencyjnych i funkcja wydatkowania alfa.
- Test trendu w proporcjach (1955). Armitage (1955) zauważył, że przy grupach uporządkowanych pytanie brzmi zwykle nie „czy proporcje się różnią”, ale „czy rosną z porządkiem grup”. Test ukierunkowany na trend może wtedy wykazać efekt silniej niż zwykły chi-kwadrat. To test trendu Cochrana–Armitage’a.
- Podręcznik i szkoła. Statistical Methods in Medical Research (1971) wciąż się ukazuje, od drugiego wydania wraz z Geoffreyem Berrym. Armitage założył w LSHTM studia magisterskie ze statystyki medycznej. Z Richardem Dollem opracował wielostopniowy model powstawania nowotworów (Matthews, 2024).
Ciekawostka
Do statystyki medycznej Armitage trafił przez przypadek. Statystyki uczył się w czasie wojny w SR17, jednostce badań statystycznych Ministerstwa Zaopatrzenia. Kierował nią George Barnard, a obok pracowali m.in. Robin Plackett i Dennis Lindley. Po studiach Armitage zaczął pracę w National Physical Laboratory. Jego tamtejszy szef, Edgar Fieller, przypadkiem spotkał epidemiologa Donalda Reida. Z tej rozmowy wyszła propozycja, by Armitage starał się o posadę u Bradforda Hilla (Matthews, 2024).
Wojenna praca nad kontrolą odbioru w przemyśle dała mu też pierwszy kontakt z analizą sekwencyjną (Armitage, 1981). Do niej wracał przez całą karierę, a publikował wyjątkowo długo. Pierwsza praca ukazała się w 1946 r., ostatnia w 2023 r., czyli 77 lat później. Wspomnienia z pierwszych lat w jednostce MRC wydano już po jego śmierci (Matthews, 2024).
Przykład na danych z pakietu R
Zbiór pneumo z pakietu VGAM to według pliku pomocy dane o pylicy u górników pracujących przy przodku. Dla ośmiu grup czasu pracy (od 5.8 do 51.5 roku) podano liczby górników bez pylicy, z postacią łagodną i z ciężką. Źródłem jest praca Ashforda z 1959 r. w Biometrics. Liczymy odsetek górników z jakąkolwiek pylicą: od 0 na 98 w pierwszej grupie do 7 na 11 (64%) w ostatniej; łącznie 82 z 371.
Test trendu Armitage’a to nachylenie prostej odsetka względem wyniku grupy, ważonej liczebnościami. Statystykę tworzy kwadrat nachylenia podzielony przez jego wariancję przy braku związku. Gdy wynikiem grupy jest czas pracy, odsetek rośnie o 13.7 punktu procentowego na 10 lat pracy. Daje to χ²(1) = 79.62, p < .001 – dokładnie tyle samo, co prop.trend.test(). Identyczny jest też test punktowy (Rao) dla nachylenia w regresji logistycznej; iloraz szans na 10 lat pracy wynosi tam 2.62.
Zwykły chi-kwadrat dla tabeli 2 × 8 wynosi χ²(7) = 81.57. Prawie cały przypada na trend, a na odchylenie od niego zostaje χ²(6) = 1.95, p = .924. Wybór wyników grup ma jednak znaczenie: dla logarytmu czasu pracy statystyka trendu spada do 69.74, a dla numerów grup 1–8 wynosi 80.12.
Na rysunku
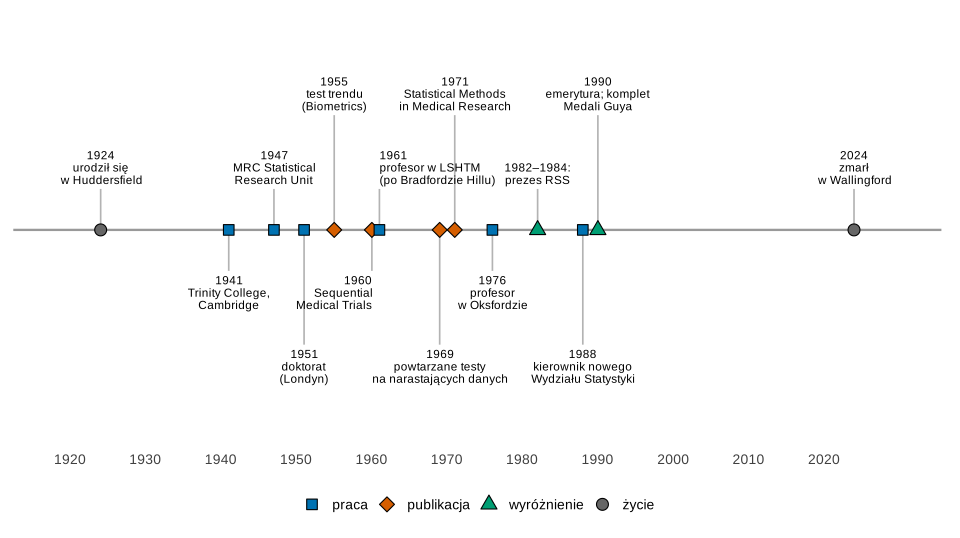
Co widać. Wszystkie trzy prace metodologiczne z hasła powstały w czasie pracy w jednostce MRC i w LSHTM. Oksford i Royal Statistical Society to druga połowa kariery.
Na co uważać. Matthews (2024) datuje Sequential Medical Trials na 1960 r., a sam Armitage (1981) w bibliografii komentarza podaje 1961 r.; na osi jest rok z nekrologu.
Podpis do pracy:
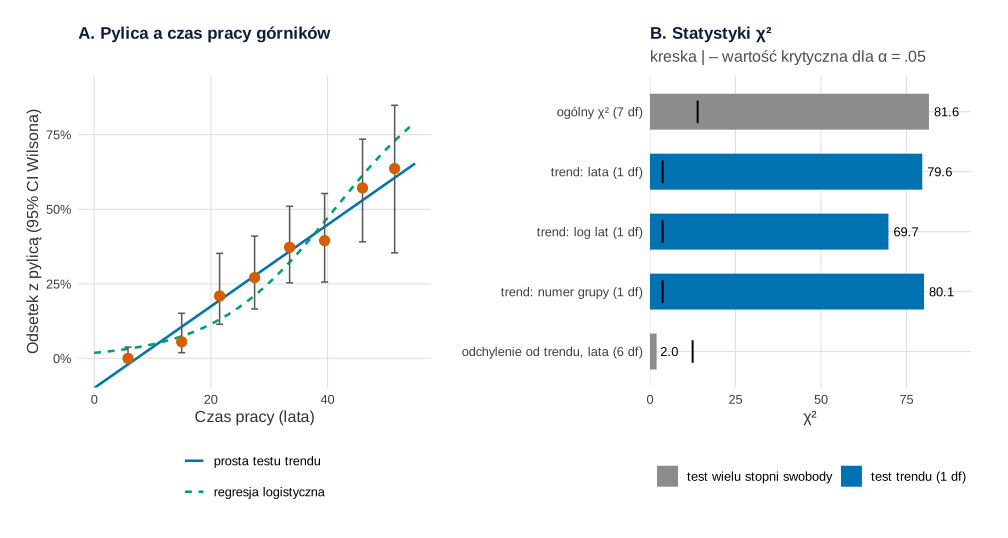
VGAM::pneumo. Obliczenia i rysunek: R, pakiety ggplot2 i patchwork (bez losowania).Co widać. W panelu A prosta, którą „widzi” test trendu, przechodzi przez przedziały wszystkich grup, ale przy krótkim stażu schodzi poniżej zera. Krzywa logistyczna tego błędu nie ma. W panelu B słupki trendu prawie dorównują ogólnemu χ² z 7 df, a odchylenie od trendu leży daleko poniżej wartości krytycznej.
Na co uważać. Test trendu wykrywa składową liniową względem wybranych wyników, więc wynik zależy od tego, czy wpiszesz lata, ich logarytm czy numery grup – wybierz je przed analizą. W pierwszej grupie nikt nie miał pylicy, a najmniejsza liczebność oczekiwana wynosi 2.43, więc przybliżenie chi-kwadrat dla ogólnego testu 2 × 8 jest tu tylko orientacyjne.
Podpis do pracy:
Gdzie spotkasz Armitage’a w swojej pracy
- gdy w tabeli krzyżowej 2 × k grupy mają naturalny porządek (dawka, wiek, staż) – sprawdź trend, zanim policzysz ogólny chi-kwadrat; więcej w haśle o zależności dawka–odpowiedź;
- gdy w badaniu klinicznym planujesz analizy pośrednie: nie sprawdzaj p po każdej porcji danych bez korekty (praktyka – we wpisie Analizy pośrednie w praktyce; pokrewny pomysł Walda to SPRT);
- gdy przy odsetkach podajesz przedziały ufności – w grupie z zerem zdarzeń przedział Wilsona nadal ma sens.
Spory, mity i trudne strony
- Dlaczego „Cochrana–Armitage’a”? Nazwa łączy nazwiska Armitage’a i Williama Cochrana; o udziale obu autorów pisze hasło o teście. W literaturze spotkasz obie kolejności nazwisk – chodzi o ten sam test.
- „Zaglądanie” do danych. Wniosek z pracy Armitage’a, McPhersona i Rowe’a (1969) bywa streszczany jako zakaz analiz pośrednich. Pokazali oni jednak tylko, że bez planu i korekty błąd I rodzaju rośnie. Sam Armitage (1981) zauważył, że praktyka przesunęła się od analizy po każdej obserwacji ku kilku zaplanowanym analizom pośrednim.
- Ciągłość z Waldem. Armitage (1981) wspominał, że początkowo chciał wprost przenieść metody Walda do medycyny. Nazwę swoich planów („restricted”) wybrał, bo określenie „truncated” Wald stosował już do innego podejścia.
Test trendu Armitage’a w R
Kod wczytuje dane pneumo, liczy test trendu ręcznie, porównuje go z prop.trend.test() i testem punktowym regresji logistycznej, rozkłada ogólny chi-kwadrat na trend i odchylenie od trendu, sprawdza trzy zestawy wyników grup i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Test trendu ręcznie i trzy sposoby wyboru wyników: rysunek 2
Kod R rysunku 2
# Peter Armitage: test trendu w proporcjach liczony ręcznie, prop.trend.test() i test punktowy regresji logistycznej (VGAM::pneumo)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(odsetek = "#D55E00", prosta = "#0072B2", logistyczna = "#009E73", ogolny = "grey55")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(pneumo, package = "VGAM")
# exposure.time – czas pracy (lata); normal, mild, severe – liczby górników bez pylicy, z łagodną i z ciężką postacią
lata <- pneumo$exposure.time
r <- pneumo$mild + pneumo$severe                     # górnicy z pylicą (łagodną lub ciężką)
n <- pneumo$normal + pneumo$mild + pneumo$severe     # wszyscy zbadani w grupie
data.frame(lata, z_pylica = r, zbadani = n, odsetek = round(r / n, 3))

# 1. Test trendu ręcznie: nachylenie ważonej prostej odsetka względem wyniku grupy x i jego wariancja przy H0
trend_reczny <- function(x, r, n) {
  N <- sum(n); p <- sum(r) / N; xs <- sum(n * x) / N
  b <- sum(n * (r / n - p) * (x - xs)) / sum(n * (x - xs)^2)      # nachylenie (odsetek na jednostkę x)
  chi2 <- b^2 * sum(n * (x - xs)^2) / (p * (1 - p))                # statystyka trendu, 1 df
  c(nachylenie = b, chi2 = chi2)
}
tr <- trend_reczny(lata, r, n)
round(c(tr, nachylenie_na_10_lat = 10 * unname(tr["nachylenie"])), 4)
c(p = signif(pchisq(unname(tr["chi2"]), df = 1, lower.tail = FALSE), 3))

# 2. To samo funkcją prop.trend.test() i jako test punktowy (Rao) w regresji logistycznej
round(c(prop_trend_test = unname(prop.trend.test(r, n, score = lata)$statistic)), 4)
m0 <- glm(cbind(r, n - r) ~ 1, family = binomial)
m1 <- glm(cbind(r, n - r) ~ lata, family = binomial)
round(c(test_punktowy_Rao = anova(m0, m1, test = "Rao")$Rao[2],
        OR_na_10_lat = exp(10 * unname(coef(m1)[2]))), 4)

# 3. Ogólny chi-kwadrat 2 × 8 (bez założenia trendu) i jego rozkład na trend i odchylenie od trendu
p_cal <- sum(r) / sum(n)
chi2_ogolny <- sum((r - n * p_cal)^2 / (n * p_cal * (1 - p_cal)))
round(c(chi2_ogolny_7df = chi2_ogolny, trend_1df = unname(tr["chi2"]),
        odchylenie_6df = chi2_ogolny - unname(tr["chi2"]),
        p_odchylenia = pchisq(chi2_ogolny - unname(tr["chi2"]), df = 6, lower.tail = FALSE)), 4)
c(najmniejsza_liczebnosc_oczekiwana = round(min(n * p_cal), 2))

# 4. Wybór wyników grup: lata, logarytm lat, numer grupy 1–8
wyniki <- list(lata = lata, log_lat = log(lata), numer_grupy = seq_along(lata))
round(sapply(wyniki, function(x) trend_reczny(x, r, n)[["chi2"]]), 3)

# Rysunek: A – odsetki z 95% CI Wilsona, prosta testu trendu i krzywa logistyczna; B – statystyki chi-kwadrat
wilson <- function(r, n, z = qnorm(0.975)) {
  p <- r / n; srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  pol <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  cbind(dolna = srodek - pol, gorna = srodek + pol)
}
dA <- data.frame(lata, odsetek = r / n, wilson(r, n), n)
xs <- sum(n * lata) / sum(n)
krzywe <- data.frame(lata = seq(0, 55, by = 0.5))
krzywe$prosta <- p_cal + unname(tr["nachylenie"]) * (krzywe$lata - xs)
krzywe$logistyczna <- predict(m1, newdata = data.frame(lata = krzywe$lata), type = "response")
kdl <- rbind(data.frame(lata = krzywe$lata, p = krzywe$prosta, linia = "prosta testu trendu"),
             data.frame(lata = krzywe$lata, p = krzywe$logistyczna, linia = "regresja logistyczna"))
pA <- ggplot(dA, aes(lata, odsetek)) +
  geom_line(data = kdl, aes(lata, p, colour = linia, linetype = linia), linewidth = 0.9) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 1.2, colour = "grey35") +
  geom_point(size = 3.2, colour = kol[["odsetek"]]) +
  scale_colour_manual(values = c(kol[["prosta"]], kol[["logistyczna"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  coord_cartesian(ylim = c(-0.05, 0.9)) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(title = "A. Pylica a czas pracy górników", x = "Czas pracy (lata)", y = "Odsetek z pylicą (95% CI Wilsona)") +
  motyw
dB <- data.frame(statystyka = c("ogólny χ² (7 df)", "trend: lata (1 df)", "trend: log lat (1 df)",
                                "trend: numer grupy (1 df)", "odchylenie od trendu, lata (6 df)"),
                 wartosc = c(chi2_ogolny, sapply(wyniki, function(x) trend_reczny(x, r, n)[["chi2"]]),
                             chi2_ogolny - unname(tr["chi2"])),
                 df = c(7, 1, 1, 1, 6))
dB$krytyczna <- qchisq(0.95, dB$df)
dB$statystyka <- factor(dB$statystyka, levels = rev(dB$statystyka))
pB <- ggplot(dB, aes(wartosc, statystyka)) +
  geom_col(aes(fill = df == 1), width = 0.6) +
  geom_point(aes(x = krytyczna), shape = 124, size = 6) +
  geom_text(aes(label = sprintf("%.1f", wartosc)), hjust = -0.2, size = 3.4) +
  scale_fill_manual(values = c(`TRUE` = kol[["prosta"]], `FALSE` = kol[["ogolny"]]),
                    labels = c("test wielu stopni swobody", "test trendu (1 df)"), name = NULL) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.15))) +
  labs(title = "B. Statystyki χ²", subtitle = "kreska | – wartość krytyczna dla α = .05", x = "χ²", y = NULL) +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.1, 1))
p2
Wynik w R
  lata z_pylica zbadani odsetek
1  5.8        0      98   0.000
2 15.0        3      54   0.056
3 21.5        9      43   0.209
4 27.5       13      48   0.271
5 33.5       19      51   0.373
6 39.5       15      38   0.395
7 46.0       16      28   0.571
8 51.5        7      11   0.636
          nachylenie                 chi2 nachylenie_na_10_lat
              0.0137              79.6163               0.1369
       p
4.55e-19
prop_trend_test
        79.6163
test_punktowy_Rao      OR_na_10_lat
          79.6163            2.6187
chi2_ogolny_7df       trend_1df  odchylenie_6df    p_odchylenia
        81.5700         79.6163          1.9537          0.9239
najmniejsza_liczebnosc_oczekiwana
                             2.43
       lata     log_lat numer_grupy
     79.616      69.737      80.123
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Peter Armitage (1924–2024) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1924, 1941, 1947, 1951, 1955, 1960, 1961, 1969, 1971, 1976, 1982, 1988, 1990, 2024),
  opis = c("urodził się\nw Huddersfield", "Trinity College,\nCambridge", "MRC Statistical\nResearch Unit",
           "doktorat\n(Londyn)", "test trendu\n(Biometrics)", "Sequential\nMedical Trials", "profesor w LSHTM\n(po Bradfordzie Hillu)",
           "powtarzane testy\nna narastających danych", "Statistical Methods\nin Medical Research", "profesor\nw Oksfordzie",
           "1982–1984:\nprezes RSS", "kierownik nowego\nWydziału Statystyki", "emerytura; komplet\nMedali Guya", "zmarł\nw Wallingford"),
  rodzaj = c("życie", "praca", "praca", "praca", "publikacja", "publikacja", "praca",
             "publikacja", "publikacja", "praca", "wyróżnienie", "praca", "wyróżnienie", "życie"),
  poziom = c(0.5, -0.5, 0.5, -1.4, 1.4, -0.5, 0.5, -1.4, 1.4, -0.5, 0.5, -1.4, 1.4, 0.5),   # wysokość etykiety
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 0.5, 1, 0, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5))           # rozsunięcie etykiet
zdarzenia$etykieta <- ifelse(grepl("^19[0-9]{2}–", zdarzenia$opis), zdarzenia$opis, paste0(zdarzenia$rok, "\n", zdarzenia$opis))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1918, 2030), breaks = seq(1920, 2020, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.4)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test trendu – prop.trend.test(), regresja logistyczna i test Rao – glm() i anova() z pakietu stats; dane – pakiet VGAM; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- VGAM (wersja 1.1.14): Yee, T. W. (2015). Vector generalized linear and additive models: With an implementation in R. Springer. https://doi.org/10.1007/978-1-4939-2818-7
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Peter Armitage?
Brytyjskim statystykiem medycznym (1924–2024). Od 1947 r. pracował w jednostce statystycznej MRC u Austina Bradforda Hilla, w 1961 r. zastąpił go jako profesor statystyki medycznej w London School of Hygiene and Tropical Medicine, a od 1976 r. był profesorem w Oksfordzie, gdzie w 1988 r. został pierwszym kierownikiem Wydziału Statystyki. W latach 1982–1984 przewodniczył Royal Statistical Society.
Co wymyślił Peter Armitage?
Przede wszystkim zamknięte plany sekwencyjne dla badań klinicznych, które pozwalają przerwać badanie, gdy różnica między leczeniami jest wyraźna. W pracy z McPhersonem i Rowe’em z 1969 r. pokazał też, że powtarzanie testu po każdej porcji danych zawyża błąd I rodzaju, i zaproponował test trendu w proporcjach (1955).
Czy test trendu Cochrana–Armitage’a to to samo co regresja logistyczna?
Statystyka testu trendu jest równa testowi punktowemu (Rao) dla nachylenia w regresji logistycznej z tym samym wynikiem grupy. W przykładzie z danymi o pylicy obie dają χ²(1) = 79.62. Regresja daje dodatkowo iloraz szans – tu 2.62 na 10 lat pracy.
Dlaczego nie można sprawdzać p po każdej nowej porcji danych?
Bo każde spojrzenie to kolejna szansa na fałszywie istotny wynik. Armitage, McPherson i Rowe (1969) pokazali, że przy powtarzanych testach na tym samym poziomie α łączne prawdopodobieństwo błędu I rodzaju jest znacznie większe od nominalnego. Analizy pośrednie trzeba zaplanować i skorygować.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Armitage, P. (1955). Tests for linear trends in proportions and frequencies. Biometrics, 11(3), 375–386. https://doi.org/10.2307/3001775
- Armitage, P. (1981). This week’s citation classic: Armitage P. Restricted sequential procedures. Current Contents/Life Sciences, 24(24), 16. https://garfield.library.upenn.edu/classics1981/A1981LS07400001.pdf ● Otwarty dostęp
- Armitage, P., McPherson, C. K., & Rowe, B. C. (1969). Repeated significance tests on accumulating data. Journal of the Royal Statistical Society. Series A (General), 132(2), 235–244. https://doi.org/10.2307/2343787
- Matthews, J. N. S. (2024). Peter Armitage 1924–2024. Journal of the Royal Statistical Society Series A: Statistics in Society, 187(3), 845–847. https://doi.org/10.1093/jrsssa/qnae034 ● Otwarty dostęp
- Royal Statistical Society. (2024). Peter Armitage, 1924–2024. https://rss.org.uk/news-publication/news-publications/2024/general-news/peter-armitage,-1924–2024/ ● Otwarty dostęp
Cytowania BibTeX
@article{armitage1955tests, author={Armitage, P.}, title={{Tests for linear trends in proportions and frequencies}}, journal={Biometrics}, year={1955}, volume={11}, number={3}, pages={375--386}, doi={10.2307/3001775}}@article{armitage1981citation, author={Armitage, Peter}, title={{This week’s citation classic: Armitage P. Restricted sequential procedures}}, journal={Current Contents/Life Sciences}, year={1981}, volume={24}, number={24}, pages={16}, publisher={Institute for Scientific Information}, url={https://garfield.library.upenn.edu/classics1981/A1981LS07400001.pdf}}@article{armitage1969repeated, author={Armitage, P. and McPherson, C. K. and Rowe, B. C.}, title={{Repeated significance tests on accumulating data}}, journal={Journal of the Royal Statistical Society. Series A (General)}, year={1969}, volume={132}, number={2}, pages={235--244}, doi={10.2307/2343787}}@article{matthews2024peter, author={Matthews, John N. S.}, title={{Peter Armitage 1924–2024}}, journal={Journal of the Royal Statistical Society Series A: Statistics in Society}, year={2024}, volume={187}, number={3}, pages={845--847}, doi={10.1093/jrsssa/qnae034}}@misc{rss2024peter, author={{Royal Statistical Society}}, title={{Peter Armitage, 1924–2024}}, year={2024}, publisher={Royal Statistical Society}, url={https://rss.org.uk/news-publication/news-publications/2024/general-news/peter-armitage,-1924–2024/}}