Kim był Max O. Lorenz?
Max Otto Lorenz (1876–1959) był amerykańskim ekonomistą i statystykiem. Urodził się 19 września 1876 r. w Burlington w stanie Iowa. W 1899 r. ukończył studia licencjackie na University of Iowa, przez dwa lata uczył w szkole średniej, a w latach 1901–1907 był instruktorem ekonomii na University of Wisconsin, gdzie w 1906 r. obronił doktorat (The Annals of Iowa, 1959).
Potem przez całe życie zawodowe pracował jako statystyk w administracji. Był zastępcą komisarza ds. statystyki pracy i przemysłu w Wisconsin, agentem biura spisowego USA i statystykiem w Bureau of Railway Economics. W latach 1911–1916 był statystykiem w Interstate Commerce Commission (ICC), federalnej komisji nadzorującej m.in. koleje, w następnym roku sekretarzem komisji ds. ośmiogodzinnego dnia pracy, a potem dyrektorem statystyki ICC aż do emerytury w 1944 r. Był też współautorem podręcznika „Outlines of Economics”. Zmarł 1 lipca 1959 r. w Palo Alto w Kalifornii (The Annals of Iowa, 1959).
Najważniejsze pomysły
- Krzywa Lorenza (1905). W artykule „Methods of measuring the concentration of wealth” Lorenz zaproponował, by na jednej osi odłożyć skumulowany odsetek ludności uporządkowanej od najuboższych, a na drugiej – odsetek bogactwa, który ta część ludności posiada. Przy równym podziale wychodzi prosta; im bardziej linia jest wygięta, tym większa koncentracja (Lorenz, 1905). Dziś to krzywa Lorenza.
- Porównania niezależne od skali. Lorenz pokazał na prostym przykładzie, że gdy każdemu podwoi się majątek, nierówność się nie zmienia, a mimo to popularne wtedy miary – przepływy między stałymi klasami dochodu czy odległość między dwiema medianami – wskazywały wzrost koncentracji. Wykres miał uwzględniać jednocześnie zmiany bogactwa i liczby ludności (Lorenz, 1905).
- Krytyka innych metod. Za błędne uznał m.in. logarytmiczne wykresy Vilfreda Pareto oparte na stałych progach dochodu. Wśród miar liczbowych najlepszą była dla niego miara Bowleya oparta na kwartylach: różnica dwóch kwartyli podzielona przez ich sumę (Lorenz, 1905).
Ciekawostka
Lorenz opublikował swoją krzywą jako młody pracownik uczelni, a nie jako uznany uczony. Artykuł ukazał się w czerwcu 1905 r., gdy Lorenz kończył doktorat na University of Wisconsin. Według Kleibera (2005) był to zapewne jego jedyny artykuł w czasopiśmie naukowym – i to on przyniósł mu sławę.
Sam Lorenz nie nazwał wykresu swoim nazwiskiem. Określenie „krzywa Lorenza” pojawiło się po raz pierwszy w podręczniku statystyki Willforda I. Kinga z 1912 r. (Kleiber, 2005, za: Derobert i Thieriot, 2003). Co więcej, oryginalny wykres wyglądał inaczej niż dzisiejszy: odsetek bogactwa leżał na osi poziomej, a odsetek ludności na pionowej, więc krzywa wyginała się nad przekątną, a nie pod nią. Derobert i Thieriot (2003) opisują, jak w kolejnych dekadach krzywa została w praktyce „odwrócona”.
Przykład na historycznych danych
Lorenz zilustrował swoją metodę tabelą dochodów w Prusach z lat 1892 i 1901. Dla sześciu klas dochodu (w markach) podał odsetek osób i odsetek łącznego dochodu (Lorenz, 1905, s. 214). Te liczby wpisaliśmy ręcznie do kodu. Sam autor zaznaczył, że dochody poniżej 900 marek oszacowano, przyjmując, że wynosiły średnio 700 marek.
Z tabeli od razu widać problem, o którym pisał Lorenz. W 1892 r. 70.1% osób miało 41.2% dochodu, a w 1901 r. 60.5% osób – 31.7%. Ale to różne odsetki ludności, więc nie wiadomo, czy nierówność wzrosła. Krzywa Lorenza rozwiązuje to porównanie. Najuboższa połowa miała w 1892 r. 29.4% dochodu, a w 1901 r. – 26.2%. Indeks Giniego policzony z punktów krzywej wzrósł z 0.357 do 0.394. To ten sam wniosek, który Lorenz odczytał z wykresu: w 1901 r. koncentracja była większa.
Uwaga na dwa przybliżenia. Między granicami klas łączymy punkty odcinkami, czyli zakładamy, że wewnątrz klasy wszyscy zarabiają tyle samo. Dlatego indeks z danych pogrupowanych jest raczej zaniżony. Udział najbogatszego 1% (17.8% i 19.8%) to oszacowanie z takiej samej interpolacji.
Na rysunku
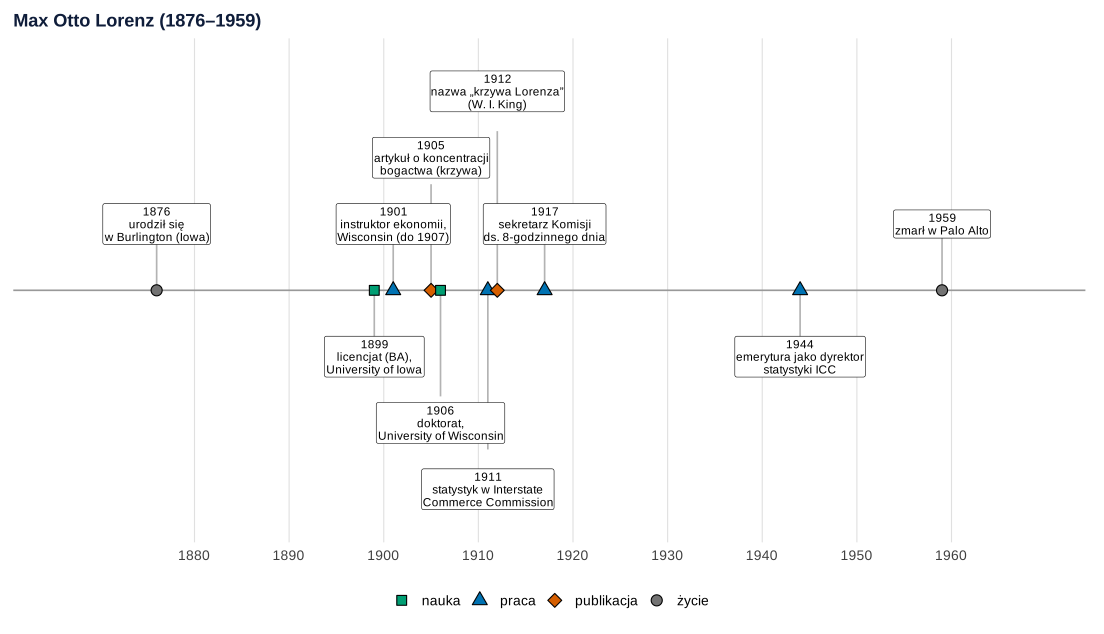
Co widać. Najważniejsza praca Lorenza powstała w czasie studiów doktoranckich; resztę kariery wypełniła praca statystyka w administracji federalnej, głównie w Interstate Commerce Commission.
Na co uważać. Oś pokazuje tylko lata podane w cytowanych źródłach. Nie ma na niej roku objęcia stanowiska dyrektora statystyki ICC, bo wspomnienie z 1959 r. go nie podaje.
Podpis do pracy:
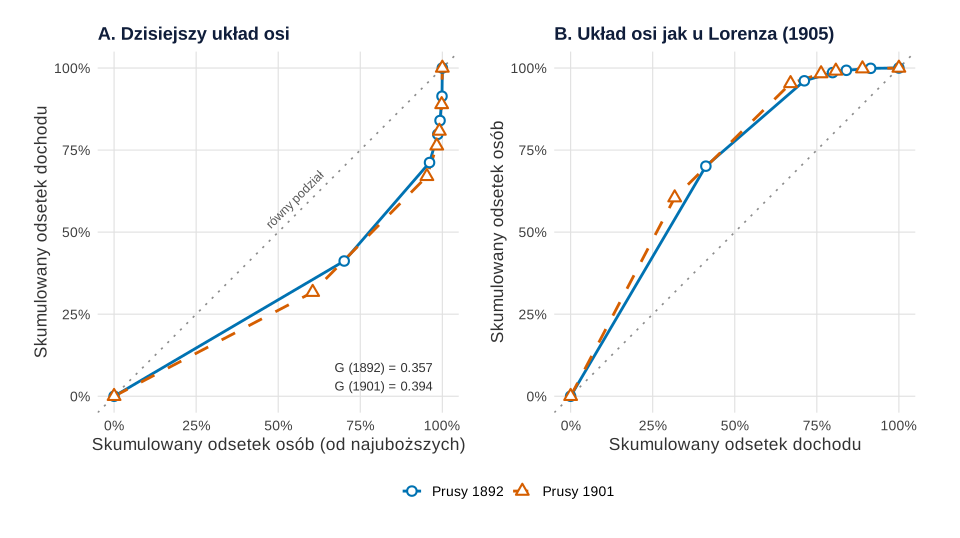
Co widać. W panelu A krzywa z 1901 r. leży prawie na całej długości pod krzywą z 1892 r., a jej indeks Giniego jest większy (0.394 wobec 0.357). Punkty odpowiadają granicom sześciu klas dochodu: aż 70.1% osób (1892) mieści się w pierwszym odcinku, a pięć bogatszych klas tłoczy się przy prawym brzegu. Panel B pokazuje te same liczby w układzie Lorenza – nad przekątną.
Na co uważać. Sześć klas to mało: między punktami krzywa jest odcinkiem prostym, a nierówność wewnątrz klas znika. Dochody najuboższych w obu latach oszacowano, a nie zmierzono. Krzywe stykają się w okolicy 70% osób, gdzie krzywa z 1901 r. przez krótki odcinek leży minimalnie wyżej – to skutek łączenia punktów odcinkami. Gdy krzywe się zbliżają lub przecinają, jeden indeks nie wystarcza i trzeba pokazać obie.
Podpis do pracy:
Gdzie spotkasz Lorenza w swojej pracy
Wszędzie tam, gdzie pytasz nie o średnią, ale o to, jak nierówno coś się rozkłada:
- w pracy z ekonomii, gdy opisujesz dochody gospodarstw domowych – zwykle obok mediany i indeksu Giniego; jak zadać pytanie o dochód, żeby dane się do tego nadawały, pokazuje wpis Pytanie o dochód w ankiecie;
- w analizie koncentracji rynku i sprzedaży – wpis Koncentracja rynku: HHI i krzywa Lorenza pokazuje, kiedy krzywa pomaga, a kiedy myli, a analiza ABC/XYZ asortymentu korzysta z tego samego pomysłu skumulowanych udziałów co wykres Pareto;
- przy zmiennych silnie prawoskośnych, np. o rozkładzie lognormalnym, gdzie krzywa Lorenza i współczynnik zmienności uzupełniają się;
- w zadaniach z ekonomii – kilka przykładów z rozwiązaniami zbiera wpis Statystyka w ekonomii – zadania z rozwiązaniami.
Spory, mity i trudne strony
- Czy Lorenz był pierwszy? Kleiber (2005) zauważa, że Chatelain opisał w 1907 r. tę samą krzywą w innym układzie osi, prawdopodobnie niezależnie od Lorenza. Pierwszeństwo publikacji należy jednak do Lorenza.
- Krzywa Lorenza a indeks Giniego. To dwa różne pomysły dwóch autorów. Indeks wywodzi się od Corrada Giniego (1914), a z krzywą łączy go to, że wyraża się przez pole pod nią (Kleiber, 2005). Sam Lorenz zaproponował metodę graficzną, a z miar liczbowych polecał kwartylową miarę Bowleya.
- Jakość danych. Lorenz zastrzegł na wstępie, że nie ocenia wiarygodności danych użytych do ilustracji (Lorenz, 1905). Jego wniosek o Prusach dotyczy więc metody, a nie rozstrzyga sporu o rzeczywistą nierówność.
- Długo zapomniana. Według Kleibera (2005) szersze zainteresowanie krzywą w literaturze anglojęzycznej przyszło dopiero na początku lat 70. XX w., ponad 60 lat po publikacji.
Krzywa Lorenza na danych z 1905 r. w R
Kod rysuje oś czasu (rysunek 1), a potem wpisuje tabelę dochodów w Prusach z artykułu Lorenza (1905), liczy punkty krzywej Lorenza, indeks Giniego z danych pogrupowanych, udział najuboższej połowy i najbogatszego 1% oraz rysuje krzywe w dwóch układach osi (rysunek 2). Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda, którym podmieniono tylko krój i tło na motyw serwisu; dane, geometrie i skale są identyczne.
Oś czasu i krzywe Lorenza dla Prus: rysunki 1 i 2
Kod R rysunków 1 i 2
# Max O. Lorenz: oś czasu i krzywa Lorenza na danych o dochodach w Prusach z jego artykułu (1905)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", cynober = "#D55E00", pomaranczowy = "#E69F00", zielony = "#009E73", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# 1. Oś czasu (lata według: The Annals of Iowa 1959, Kleiber 2005, Lorenz 1905)
zdarzenia <- data.frame(
  rok = c(1876, 1899, 1901, 1905, 1906, 1911, 1912, 1917, 1944, 1959),
  opis = c("urodził się\nw Burlington (Iowa)", "licencjat (BA),\nUniversity of Iowa", "instruktor ekonomii,\nWisconsin (do 1907)",
           "artykuł o koncentracji\nbogactwa (krzywa)", "doktorat,\nUniversity of Wisconsin", "statystyk w Interstate\nCommerce Commission",
           "nazwa „krzywa Lorenza”\n(W. I. King)", "sekretarz Komisji\nds. 8-godzinnego dnia", "emerytura jako dyrektor\nstatystyki ICC",
           "zmarł w Palo Alto"),
  rodzaj = c("życie", "nauka", "praca", "publikacja", "nauka", "praca", "publikacja", "praca", "praca", "życie"))
zdarzenia$y <- c(1.1, -1.1, 1.1, 2.2, -2.2, -3.3, 3.3, 1.1, -1.1, 1.1)   # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "nauka" = 22, "praca" = 24, "publikacja" = 23), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "nauka" = oi[["zielony"]], "praca" = oi[["niebieski"]],
                               "publikacja" = oi[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1880, 1960, 10), limits = c(1866, 1969)) + scale_y_continuous(limits = c(-3.8, 3.8)) +
  labs(title = "Max Otto Lorenz (1876–1959)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())

# 2. Dane z artykułu Lorenza (1905, s. 214): dochody w Prusach w latach 1892 i 1901.
#    Dla każdej klasy dochodu (w markach) odsetek liczby osób i odsetek łącznego dochodu.
#    Lorenz zaznaczył, że dochody poniżej 900 marek oszacowano (przyjęto średnio 700 marek).
klasy <- c("poniżej 900", "900–3000", "3000–6000", "6000–9500", "9500–30 500", "30 500 i więcej")
prusy <- data.frame(
  rok = rep(c("1892", "1901"), each = 6), klasa = rep(klasy, 2),
  proc_osob    = c(70.1, 26.0, 2.5, 0.7, 0.6, 0.1,    60.5, 34.8, 3.0, 0.8, 0.7, 0.2),
  proc_dochodu = c(41.2, 30.0, 8.6, 4.2, 7.4, 8.6,    31.7, 35.3, 9.3, 4.5, 8.1, 11.1))
stopifnot(all(abs(tapply(prusy$proc_osob, prusy$rok, sum) - 100) < 1e-9),
          all(abs(tapply(prusy$proc_dochodu, prusy$rok, sum) - 100) < 1e-9))
# Średni dochód klasy względem średniej ogólnej = udział w dochodzie / udział w liczbie osób
prusy$wzgledny_dochod <- round(prusy$proc_dochodu / prusy$proc_osob, 2)
print(prusy, row.names = FALSE)

# Punkty krzywej Lorenza: skumulowany odsetek osób (od najuboższych) i skumulowany odsetek dochodu
krzywa <- do.call(rbind, lapply(split(prusy, prusy$rok), function(d)
  data.frame(rok = d$rok[1], F = c(0, cumsum(d$proc_osob)) / 100, L = c(0, cumsum(d$proc_dochodu)) / 100)))
# Indeks Giniego z danych pogrupowanych (łamana krzywa, równość wewnątrz klas – dolne ograniczenie):
# G = 1 − Σ (F_i − F_{i−1}) (L_i + L_{i−1})
gini <- sapply(split(krzywa, krzywa$rok), function(d) 1 - sum(diff(d$F) * (head(d$L, -1) + tail(d$L, -1))))
# Udział „uboższej połowy” (propozycja Lorenza) i najbogatszych 1% – interpolacja liniowa po krzywej
udzial <- function(d, f) approx(d$F, d$L, xout = f)$y
podsumowanie <- data.frame(
  rok = names(gini), Gini = round(gini, 3),
  ubozsza_polowa_proc = round(100 * sapply(split(krzywa, krzywa$rok), udzial, f = 0.5), 1),
  najbogatsze_1proc_proc = round(100 * (1 - sapply(split(krzywa, krzywa$rok), udzial, f = 0.99)), 1))
print(podsumowanie, row.names = FALSE)

# Rysunek 2A: krzywa Lorenza w dzisiejszym układzie osi
krzywa$rok_et <- paste0("Prusy ", krzywa$rok)
kol <- c("Prusy 1892" = oi[["niebieski"]], "Prusy 1901" = oi[["cynober"]])
pA <- ggplot(krzywa, aes(F, L, colour = rok_et, shape = rok_et, linetype = rok_et)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey55", linetype = "dotted") +
  annotate("text", x = 0.55, y = 0.6, label = "równy podział", angle = 45, size = 3.3, colour = "grey35") +
  geom_line(linewidth = 1) + geom_point(size = 2.6, fill = "white", stroke = 1.1) +
  annotate("text", x = 0.97, y = 0.06, hjust = 1, size = 3.4, colour = "grey20",
           label = sprintf("G (1892) = %.3f\nG (1901) = %.3f", gini[["1892"]], gini[["1901"]])) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(21, 24), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%")) + scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  coord_equal() +
  labs(title = "A. Dzisiejszy układ osi", x = "Skumulowany odsetek osób (od najuboższych)", y = "Skumulowany odsetek dochodu") +
  motyw
# Rysunek 2B: te same punkty w układzie Lorenza z 1905 r. (osie zamienione miejscami)
pB <- ggplot(krzywa, aes(L, F, colour = rok_et, shape = rok_et, linetype = rok_et)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey55", linetype = "dotted") +
  geom_line(linewidth = 1) + geom_point(size = 2.6, fill = "white", stroke = 1.1) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(21, 24), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%")) + scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  coord_equal() +
  labs(title = "B. Układ osi jak u Lorenza (1905)", x = "Skumulowany odsetek dochodu", y = "Skumulowany odsetek osób") +
  motyw
p_metoda <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p_os
p_metoda
Wynik w R
  rok           klasa proc_osob proc_dochodu wzgledny_dochod
 1892     poniżej 900      70.1         41.2            0.59
 1892        900–3000      26.0         30.0            1.15
 1892       3000–6000       2.5          8.6            3.44
 1892       6000–9500       0.7          4.2            6.00
 1892     9500–30 500       0.6          7.4           12.33
 1892 30 500 i więcej       0.1          8.6           86.00
 1901     poniżej 900      60.5         31.7            0.52
 1901        900–3000      34.8         35.3            1.01
 1901       3000–6000       3.0          9.3            3.10
 1901       6000–9500       0.8          4.5            5.62
 1901     9500–30 500       0.7          8.1           11.57
 1901 30 500 i więcej       0.2         11.1           55.50
  rok  Gini ubozsza_polowa_proc najbogatsze_1proc_proc
 1892 0.357                29.4                   17.8
 1901 0.394                26.2                   19.8
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (obliczenia – funkcje cumsum() i approx() z pakietów base i stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Max O. Lorenz?
Amerykańskim ekonomistą i statystykiem (1876–1959), urodzonym w Burlington w stanie Iowa. Doktorat zrobił na University of Wisconsin w 1906 r., a większość kariery spędził w Interstate Commerce Commission – od 1911 r. jako statystyk, później jako dyrektor statystyki, do emerytury w 1944 r.
Kiedy i gdzie Lorenz opublikował swoją krzywą?
W czerwcu 1905 r. w Publications of the American Statistical Association, w artykule „Methods of measuring the concentration of wealth”. Kończył wtedy doktorat na University of Wisconsin. Krzywą zilustrował danymi o dochodach w Prusach z lat 1892 i 1901.
Dlaczego krzywa Lorenza nazywa się od jego nazwiska?
Bo to on pierwszy ją opublikował, ale nazwy nie nadał sam. Określenie „krzywa Lorenza” pojawiło się po raz pierwszy w podręczniku statystyki Willforda I. Kinga z 1912 r. Oryginalny wykres Lorenza miał przy tym osie zamienione względem dzisiejszego.
Czy Lorenz wymyślił indeks Giniego?
Nie. Indeks pochodzi od Corrada Giniego (1914), a z krzywą Lorenza łączy go to, że równa się dwukrotności pola między przekątną a krzywą. Lorenz zaproponował metodę graficzną, a z miar liczbowych polecał miarę opartą na kwartylach.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Koncentracja rynku: HHI i krzywa Lorenza
Przewoźnicy autokarowi w 16 województwach: CR4, HHI, Gini, fuzja i ΔHHI oraz bootstrap HHI z próby biletów – z kodem R.
Czytaj →PoradnikPytanie o dochód w ankiecie
Definicja dochodu, kwota a przedziały, kaskada, braki MNAR i model przedziałowy w R zamiast punktów środkowych przedziałów.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Derobert, L., & Thieriot, G. (2003). The Lorenz curve as an archetype: A historico-epistemological study. The European Journal of the History of Economic Thought, 10(4), 573–585. https://doi.org/10.1080/0967256032000137720
- Kleiber, C. (2005). The Lorenz curve in economics and econometrics (Technical Report 30/2005 (SFB 475)). Technische Universität Dortmund. https://doi.org/10.17877/de290r-14481 ● Otwarty dostęp: pełny tekst
- Lorenz, M. O. (1905). Methods of measuring the concentration of wealth. Publications of the American Statistical Association, 9(70), 209–219. https://doi.org/10.1080/15225437.1905.10503443
- The Annals of Iowa. (1959). Iowa’s notable dead. The Annals of Iowa, 35(2), 151–160. https://doi.org/10.17077/0003-4827.7540 ● Otwarty dostęp
Cytowania BibTeX
@article{derobert2003lorenz, author={Derobert, Laurent and Thieriot, Guillaume}, title={{The Lorenz curve as an archetype: A historico-epistemological study}}, journal={The European Journal of the History of Economic Thought}, year={2003}, volume={10}, number={4}, pages={573--585}, doi={10.1080/0967256032000137720}}@techreport{kleiber2005lorenz, author={Kleiber, Christian}, title={{The Lorenz curve in economics and econometrics}}, year={2005}, institution={Technische Universität Dortmund}, doi={10.17877/de290r-14481}}@article{lorenz1905methods, author={Lorenz, M. O.}, title={{Methods of measuring the concentration of wealth}}, journal={Publications of the American Statistical Association}, year={1905}, volume={9}, number={70}, pages={209--219}, doi={10.1080/15225437.1905.10503443}}@article{annals1959iowas, author={{The Annals of Iowa}}, title={{Iowa’s notable dead}}, journal={The Annals of Iowa}, year={1959}, volume={35}, number={2}, pages={151--160}, doi={10.17077/0003-4827.7540}}