Kim był Marek Fisz?
Marek Fisz urodził się 15 stycznia 1910 r. w Szydłowcu w rodzinie żydowskiej; pierwotnie nosił imię Mojżesz, zmienione na Marek w 1950 r. O jego dzieciństwie i młodości źródła wiedzą bardzo mało. Wiadomo, że kurs szkoły średniej zaczął w 22. roku życia i w 1934 r. zdał maturę jako eksternista. Jesienią tego roku rozpoczął studia matematyczne na Uniwersytecie Warszawskim, a w czasie studiów uczył matematyki w szkole dla dorosłych na Żoliborzu. Magisterium uzyskał pod kierunkiem Stanisława Saksa w czerwcu 1939 r. (Krzyśko, 2010).
Wojnę spędził w Związku Radzieckim; biografie nie podają szczegółów. W 1946 r. wrócił do Polski, a od jesieni 1947 r. pracował w Głównym Urzędzie Statystycznym, gdzie kierował zaprojektowaniem i opracowaniem wyników pierwszego powojennego spisu powszechnego (stan na noc z 2 na 3 grudnia 1950 r.). Doktorat obronił we Wrocławiu – egzamin zdał 19 grudnia 1950 r., a promotorem rozprawy o kontroli jakości produkcji masowej był Hugo Steinhaus (Krzyśko, 2010; Krzyśko, 2022).
Od 1951 r. pracował w Państwowym Instytucie Matematycznym, a od 1954 r. kierował Katedrą Statystyki Matematycznej Uniwersytetu Warszawskiego. W 1957 r. został profesorem nadzwyczajnym, a w 1958 r. – kierownikiem Działu Statystyki Matematycznej w Instytucie Matematycznym PAN. Wykładał w Moskwie (1955) i Pekinie (1957). W 1960 r. wyjechał na roczny staż do USA i już nie wrócił; pracował w University of Washington, Stanford, Columbia i New York University. Zmarł 4 listopada 1963 r. w szpitalu w Nowym Jorku, mając 53 lata (Krzyśko, 2010).
Najważniejsze pomysły
Kariera naukowa Fisza trwała zaledwie 16 lat. Krzyśko (2010) dzieli jego prace na kilka grup:
- Pobieranie prób i kontrola jakości – tego dotyczyły pierwsze prace, w tym doktorat, m.in. projekt badania reprezentacyjnego spisu powszechnego (1950). Jedna z prac z 1950 r. opisuje konsultacje komisji GUS z Jerzym Neymanem.
- Rozkłady graniczne zmiennych dyskretnych, zwłaszcza związanych z rozkładem Poissona i wielomianowym – wśród nich praca z 1953 r. o rozkładzie granicznym różnicy dwóch niezależnych zmiennych Poissona.
- Statystyki typu Kołmogorowa–Smirnowa (1957–1958) – rozkłady graniczne funkcji dystrybuanty empirycznej, na których opiera się test Kołmogorowa–Smirnowa.
- Prawo wielkich liczb i rozkłady nieskończenie podzielne – warunki konieczne i wystarczające prawa wielkich liczb (1959–1960) oraz przeglądowy referat o rozkładach nieskończenie podzielnych, wygłoszony na zaproszenie w Seattle w 1961 r.
Najbardziej znanym dziełem Fisza jest jednak podręcznik Rachunek prawdopodobieństwa i statystyka matematyczna (Fisz, 1954), rozszerzony w kolejnych wydaniach i przełożony na angielski (Fisz, 1963).
Ciekawostka
Fisz zaczął późno – i bardzo szybko nadrobił. Szkołę średnią zaczął jako 22-latek, a jego biografowie zwracają uwagę, że z pracą naukową matematyka zetknął się po raz pierwszy, mając ponad 37 lat (Krzyśko, 2010; Krzyśko, 2022).
Podręcznik zaczął pisać w 1950 r., jeszcze przed doktoratem. Pierwsze wydanie z 1954 r. rozeszło się w ciągu kilku miesięcy. Oprócz czterech wydań polskich książka miała trzy wydania angielskie (w tym jedno w Indiach) i jedenaście niemieckich (Krzyśko, 2010).
Przykład: różnica dwóch zmiennych Poissona
Bierzemy zagadnienie z jego pracy z 1953 r., ale nie odtwarzamy jej wyniku – pokazujemy samo pytanie i trzy sposoby odpowiedzi. Dane są wymyślone: dwie linie produkcyjne mają średnio 4 i 2 usterki na zmianę, a liczby usterek mają niezależne rozkłady Poissona. Jaki rozkład ma różnica D = X − Y i jakie jest prawdopodobieństwo, że pierwsza linia będzie miała co najmniej o 3 usterki więcej?
- Rachunek dokładny. P(D = k) to suma iloczynów P(X = k + y) · P(Y = y) po wszystkich y (splot). Ten sam wynik daje wzór z funkcją Bessela (różnica obu wzorów wynosi 8 · 10⁻¹⁷). P(D ≥ 3) = .4078.
- Symulacja. 100 000 par losowań (
set.seed(1954)) daje .4101, średnią 2.005 i wariancję 5.995 (teoretycznie 2 i 6 – wartości oczekiwane się odejmują, wariancje dodają). - Przybliżenie normalne N(2, 6) z poprawką na ciągłość daje .4191 – o 0.011 za dużo.
Błąd przybliżenia maleje, gdy liczby zdarzeń rosną. Największa różnica między dokładną a normalną dystrybuantą (przy λ₁ = 2λ₂) spada z 0.030 dla λ₁ + λ₂ = 1.5 do 0.0013 dla λ₁ + λ₂ = 300. Iloczyn błędu i pierwiastka z λ₁ + λ₂ ustala się na około 0.022, czyli błąd maleje jak 1/√(λ₁ + λ₂).
Na rysunku
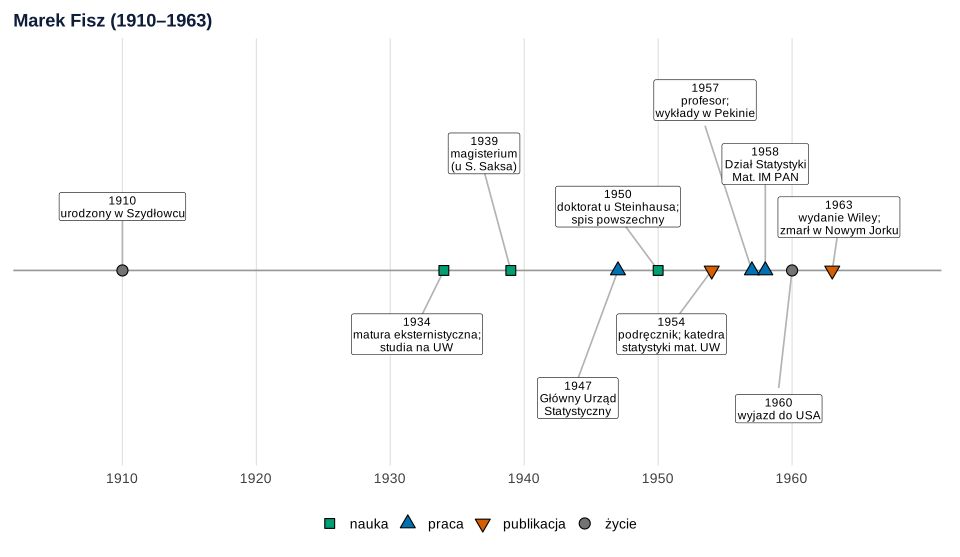
Co widać. Długa przerwa między urodzeniem a maturą i niemal cały dorobek naukowy skupiony w latach 1949–1963.
Na co uważać. Lata 1910–1934 i 1939–1946 są puste, bo źródła prawie nic o nich nie mówią. Etykiety są przesunięte – rok wskazuje znacznik na osi.
Podpis do pracy:
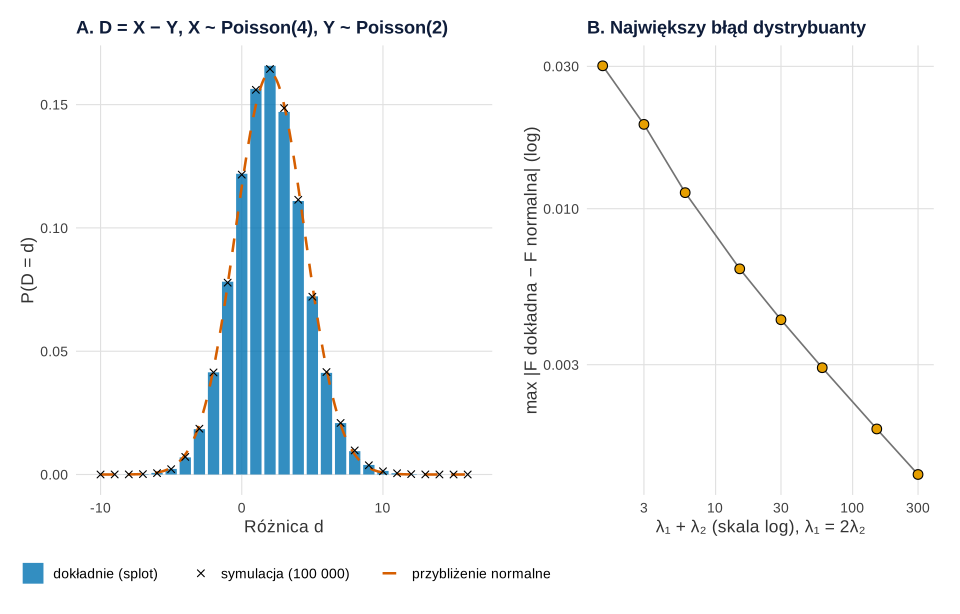
set.seed(1954)).Co widać. Już przy λ₁ = 4 i λ₂ = 2 przybliżenie normalne jest bliskie rozkładowi dokładnemu, a symulacja odtwarza rachunek. Panel B pokazuje tempo poprawy: w skali log–log punkty leżą na prostej.
Na co uważać. Mały błąd dystrybuanty nie oznacza małego błędu względnego w ogonach – tam, gdzie liczą się rzadkie zdarzenia, używaj rachunku dokładnego. Parametry 4 i 2 dobraliśmy ręcznie, dla czytelności.
Podpis do pracy:
Gdzie spotkasz Fisza w swojej pracy
- Porównanie dwóch liczebności. Gdy porównujesz liczbę zdarzeń w dwóch grupach (wypadki, usterki, zgłoszenia), pracujesz z różnicą zmiennych Poissona; przy większej liczbie zmiennych sięgnij po regresję dla zliczeń.
- Kontrola jakości i próby. Doktorat Fisza dotyczył kontroli jakości produkcji – dziś to karty kontrolne i plany kontroli odbiorczej; jego wczesne prace o pobieraniu prób łączą się z doborem losowym.
- Zadania z prawdopodobieństwa. Rachunek dokładny kontra symulacja to schemat, który przyda się przy każdym zadaniu – zob. zadania z rozwiązaniami.
Spory, mity i trudne strony
- Skąpa biografia. Krzyśko (2010) pisze wprost, że dzieciństwo i młodość Fisza owiane są tajemnicą; nie wiemy też, co robił w ZSRR w czasie wojny. Nie uzupełniamy tych luk domysłami.
- Wyjazd. Fisz starał się o zgodę na wyjazd do Izraela i jej nie otrzymał; w 1960 r. wyjechał na staż do USA i nie wrócił. Krzyśko (2010) odnotowuje, że żadne polskie czasopismo naukowe nie wspomniało o jego śmierci.
Różnica zmiennych Poissona w R
Kod rysuje oś czasu, liczy rozkład różnicy dwóch niezależnych zmiennych Poissona przez splot i wzorem z funkcją Bessela (besselI()), porównuje go z symulacją i przybliżeniem normalnym, a potem sprawdza, jak maleje błąd przybliżenia. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
zgodność dwóch wzorów dokładnych, P(D ≥ 3) trzema metodami, średnia i wariancja z symulacji oraz największy błąd przybliżenia normalnego dla ośmiu par parametrów.
Kod R rysunków 1 i 2
# Marek Fisz: oś czasu i różnica dwóch niezależnych zmiennych Poissona – rachunek dokładny, symulacja, przybliżenie normalne
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73",
        fiolet = "#CC79A7", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Krzyśki 2010 i biogramu w tomie „Polish statisticians” 2022)
zdarzenia <- data.frame(
  rok = c(1910, 1934, 1939, 1947, 1950, 1954, 1957, 1958, 1960, 1963),
  opis = c("urodzony w Szydłowcu", "matura eksternistyczna;\nstudia na UW", "magisterium\n(u S. Saksa)",
           "Główny Urząd\nStatystyczny", "doktorat u Steinhausa;\nspis powszechny", "podręcznik; katedra\nstatystyki mat. UW",
           "profesor;\nwykłady w Pekinie", "Dział Statystyki\nMat. IM PAN", "wyjazd do USA", "wydanie Wiley;\nzmarł w Nowym Jorku"),
  rodzaj = c("życie", "nauka", "nauka", "praca", "nauka", "publikacja", "praca", "praca", "życie", "publikacja"))
zdarzenia$y  <- c(1.2, -1.2, 2.2, -2.4, 1.2, -1.2, 3.2, 2.0, -2.6, 1.0)              # wysokość etykiet
zdarzenia$xl <- c(1910, 1932, 1937, 1944, 1947, 1951, 1953.5, 1958, 1959, 1963.5)  # położenie etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = xl, yend = y * 0.85), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(x = xl, y = y, label = paste0(rok, "\n", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "nauka" = 22, "praca" = 24, "publikacja" = 25), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "nauka" = oi[["zielony"]], "praca" = oi[["niebieski"]],
                               "publikacja" = oi[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1910, 1960, 10), limits = c(1905, 1968)) + scale_y_continuous(limits = c(-3.3, 4)) +
  labs(title = "Marek Fisz (1910–1963)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. D = X − Y, gdzie X ~ Poisson(4) i Y ~ Poisson(2) są niezależne.
#    Ilustracja: dwie linie produkcyjne z średnio 4 i 2 usterkami na zmianę (dane wymyślone).
l1 <- 4; l2 <- 2
d <- -10:16
# (a) rachunek dokładny przez splot: P(D = k) = suma po y P(X = k + y) P(Y = y)
p_splot <- sapply(d, function(k) sum(dpois(k + 0:200, l1) * dpois(0:200, l2)))
# (b) ten sam rozkład wzorem z funkcją Bessela I (base R: besselI)
p_bessel <- exp(-(l1 + l2)) * (l1 / l2)^(d / 2) * besselI(2 * sqrt(l1 * l2), nu = abs(d))
max(abs(p_splot - p_bessel))                     # oba wzory dają to samo
# (c) symulacja: 100 000 par losowań
set.seed(1954)
D <- rpois(1e5, l1) - rpois(1e5, l2)
p_sym <- sapply(d, function(k) mean(D == k))
# (d) przybliżenie normalne N(l1 − l2, l1 + l2) z poprawką na ciągłość
p_norm <- pnorm(d + 0.5, l1 - l2, sqrt(l1 + l2)) - pnorm(d - 0.5, l1 - l2, sqrt(l1 + l2))
# Pytanie: jakie jest prawdopodobieństwo, że linia 1 będzie miała co najmniej o 3 usterki więcej (D >= 3)?
data.frame(metoda = c("dokładnie (splot)", "symulacja (n = 100 000)", "przybliżenie normalne"),
           P_D_co_najmniej_3 = round(c(sum(p_splot[d >= 3]), mean(D >= 3), sum(p_norm[d >= 3])), 4))
c(srednia_sym = mean(D), wariancja_sym = var(D), srednia_teor = l1 - l2, wariancja_teor = l1 + l2)

# 3. Jak szybko rozkład różnicy zbliża się do normalnego? Największy błąd przybliżenia
#    (różnica dystrybuant) dla lambda1 = 2 * lambda2 przy rosnących parametrach
blad <- function(l1, l2) {
  k <- floor(l1 - l2 - 12 * sqrt(l1 + l2)):ceiling(l1 - l2 + 12 * sqrt(l1 + l2))
  dok <- sapply(k, function(j) sum(dpois(j + 0:(10 * l2 + 100), l1) * dpois(0:(10 * l2 + 100), l2)))
  max(abs(cumsum(dok) - pnorm(k + 0.5, l1 - l2, sqrt(l1 + l2))))
}
siatka <- data.frame(lambda2 = c(0.5, 1, 2, 5, 10, 20, 50, 100))
siatka$lambda1 <- 2 * siatka$lambda2
siatka$max_blad <- mapply(blad, siatka$lambda1, siatka$lambda2)
siatka$max_blad_razy_pierw <- siatka$max_blad * sqrt(siatka$lambda1 + siatka$lambda2)
round(siatka, 4)

# Rysunek 2A: rozkład D dokładny (słupki), symulacja (punkty), normalny (linia)
tabA <- data.frame(d = d, dokladny = p_splot, symulacja = p_sym)
krzywa <- data.frame(x = seq(-10, 16, by = 0.05))
krzywa$f <- dnorm(krzywa$x, l1 - l2, sqrt(l1 + l2))
pA <- ggplot(tabA, aes(d)) +
  geom_col(aes(y = dokladny, fill = "dokładnie (splot)"), width = 0.8, alpha = 0.8) +
  geom_line(data = krzywa, aes(x, f, linetype = "przybliżenie normalne"), colour = oi[["cynober"]], linewidth = 0.9) +
  geom_point(aes(y = symulacja, shape = "symulacja (100 000)"), colour = "black", size = 2) +
  scale_fill_manual(values = oi[["niebieski"]], name = NULL) +
  scale_linetype_manual(values = "dashed", name = NULL) +
  scale_shape_manual(values = 4, name = NULL) +
  labs(title = "A. D = X − Y, X ~ Poisson(4), Y ~ Poisson(2)", x = "Różnica d", y = "P(D = d)") +
  motyw + theme(legend.position = "bottom", legend.direction = "vertical")
# Rysunek 2B: błąd przybliżenia normalnego maleje jak 1 / pierwiastek z (lambda1 + lambda2)
pB <- ggplot(siatka, aes(lambda1 + lambda2, max_blad)) +
  geom_line(colour = oi[["szary"]]) +
  geom_point(size = 3, shape = 21, fill = oi[["pomaranczowy"]]) +
  scale_x_log10() + scale_y_log10() +
  labs(title = "B. Największy błąd dystrybuanty", x = "λ₁ + λ₂ (skala log), λ₁ = 2λ₂",
       y = "max |F dokładna − F normalna| (log)") +
  motyw
p_metoda <- pA + pB + plot_layout(widths = c(1.2, 1))
p_os
p_metoda
Wynik w R
[1] 8.326673e-17
                   metoda P_D_co_najmniej_3
1       dokładnie (splot)            0.4078
2 symulacja (n = 100 000)            0.4101
3   przybliżenie normalne            0.4191
   srednia_sym  wariancja_sym   srednia_teor wariancja_teor
      2.004740       5.995117       2.000000       6.000000
  lambda2 lambda1 max_blad max_blad_razy_pierw
1     0.5       1   0.0301              0.0369
2     1.0       2   0.0192              0.0332
3     2.0       4   0.0113              0.0277
4     5.0      10   0.0063              0.0244
5    10.0      20   0.0042              0.0233
6    20.0      40   0.0029              0.0227
7    50.0     100   0.0018              0.0224
8   100.0     200   0.0013              0.0223
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (rozkład Poissona – dpois() i rpois(), funkcja Bessela – besselI(), rozkład normalny – pnorm() z pakietów base i stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Marek Fisz?
Polskim matematykiem i statystykiem (1910–1963). Pracował w Głównym Urzędzie Statystycznym, doktorat zrobił u Hugona Steinhausa, kierował Katedrą Statystyki Matematycznej Uniwersytetu Warszawskiego. Od 1960 r. pracował na uczelniach w USA; zmarł w Nowym Jorku.
Jaki podręcznik napisał Marek Fisz?
„Rachunek prawdopodobieństwa i statystyka matematyczna” – pierwsze wydanie ukazało się w 1954 r. (PWN, 374 s.), drugie w 1958 r., a angielski przekład „Probability theory and mathematical statistics” w 1963 r. w wydawnictwie Wiley. Książka miała też wiele wydań niemieckich.
Czym zajmował się Marek Fisz w nauce?
Metodami pobierania prób i kontrolą jakości, rozkładami granicznymi zmiennych dyskretnych (zwłaszcza Poissona i wielomianowego), statystykami typu Kołmogorowa–Smirnowa, warunkami prawa wielkich liczb oraz rozkładami nieskończenie podzielnymi.
Dlaczego Marek Fisz wyjechał z Polski?
Źródła podają tylko fakty: starał się o zgodę na wyjazd do Izraela i jej nie dostał, a w 1960 r. wyjechał na roczny staż do USA i już nie wrócił. Jego motywów biografie nie opisują.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kontrola odbiorcza i krzywa OC
Huta szkła i przetwórnia: plan (n, c) z ryzyka α i β, krzywa OC, AOQL, plan podwójny i sezon z dryfem jakości – z kodem R.
Czytaj →PoradnikPrawdopodobieństwo i rozkłady – zadania
Dziesięć zadań jak na kolokwium: prawdopodobieństwo warunkowe, wartość oczekiwana, rozkład dwumianowy, Poissona i normalny, CTG – z rozwiązaniami krok po kroku.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fisz, M. (1954). Rachunek prawdopodobieństwa i statystyka matematyczna. Państwowe Wydawnictwo Naukowe.
- Fisz, M. (1963). Probability theory and mathematical statistics (3rd ed.). Wiley.
- Krzyśko, M. (2010). Profesor Marek Fisz (1910–1963). W setną rocznicę urodzin. Przegląd Statystyczny, 57(4), 183–190. https://ps.stat.gov.pl/Article/2010/4/183-190 ● Otwarty dostęp: pełny tekst
- Krzyśko, M. (Ed.). (2022). Polish statisticians: Biographical notes (2nd ed., revised (Statistical Research Papers, Vol. 4)). Główny Urząd Statystyczny; Polskie Towarzystwo Statystyczne. https://srp.stat.gov.pl/SRP/gus_srp_vol4_polish_statisticians_biographical_notes.pdf ● Otwarty dostęp
Cytowania BibTeX
@book{fisz1954rachunek, author={Fisz, Marek}, title={{Rachunek prawdopodobieństwa i statystyka matematyczna}}, year={1954}, publisher={Państwowe Wydawnictwo Naukowe}}@book{fisz1963probability, author={Fisz, Marek}, title={{Probability theory and mathematical statistics}}, year={1963}, edition={3rd ed.}, publisher={Wiley}}@article{krzysko2010profesor, author={Krzyśko, Mirosław}, title={{Profesor Marek Fisz (1910–1963). W setną rocznicę urodzin}}, journal={Przegląd Statystyczny}, year={2010}, volume={57}, number={4}, pages={183--190}, url={https://ps.stat.gov.pl/Article/2010/4/183-190}}@book{krzysko2022polish, author={Krzyśko, Mirosław}, title={{Polish statisticians: Biographical notes}}, year={2022}, edition={2nd ed., revised (Statistical Research Papers, Vol. 4)}, publisher={Główny Urząd Statystyczny; Polskie Towarzystwo Statystyczne}, url={https://srp.stat.gov.pl/SRP/gus_srp_vol4_polish_statisticians_biographical_notes.pdf}}