Kim byli Ludwik i Hanna Hirszfeldowie?
Ludwik Hirszfeld (1884–1954) był lekarzem, immunologiem i mikrobiologiem, Hanna Hirszfeldowa (1884–1964) – lekarką pediatrą. Oboje urodzili się w 1884 r.: on w Warszawie, ona w Wilczkowicach pod Warszawą; poznali się w Łodzi (Kolbuszewska, 2025). Ludwik obronił w 1907 r. w Berlinie doktorat o aglutynacji krwi (Kucharz i in., 2010). W Heidelbergu z Emilem von Dungernem wykazał, że grupy krwi są dziedziczne, i wprowadził ich oznaczenia A, B, O (Czerwiński i in., 2022). Od 1914 r. był docentem w Zurychu, gdzie Hanna pracowała jako asystentka w klinice pediatrycznej (Kolbuszewska, 2025).
W czasie I wojny światowej Ludwik zgłosił się jako lekarz do armii serbskiej, a pod koniec 1915 r. Hanna została w Serbii lekarzem wojskowym i razem walczyli z epidemią tyfusu (Kucharz i in., 2010; Kolbuszewska, 2025). Po zajęciu Serbii trafili do Grecji, gdzie pod Salonikami założyli laboratorium bakteriologiczne (Kolbuszewska, 2025). W 1920 r. wrócili do Warszawy; Ludwik kierował działami bakteriologii i serologii w Państwowym Zakładzie Higieny (Kucharz i in., 2010).
W czasie okupacji Hirszfeldowie trafili do getta warszawskiego. Ludwik przewodniczył tam Radzie Zdrowia walczącej z tyfusem plamistym i uczył na tajnych kursach medycznych (Czerwiński i in., 2022), a Hanna kierowała oddziałem niemowlęcym szpitala przy ulicy Leszno (Kolbuszewska, 2025). W 1942 r. uciekli z getta i do końca wojny ukrywali się pod nazwiskiem Haleccy; w tym czasie zmarła ich jedyna córka Maria (Czerwiński i in., 2022; Kolbuszewska, 2025). Po wojnie współtworzyli wydziały lekarskie w Lublinie i we Wrocławiu (Kolbuszewska, 2025). Ludwik został pierwszym dyrektorem Instytutu Immunologii i Terapii Doświadczalnej we Wrocławiu i zmarł 7 marca 1954 r. (Czerwiński i in., 2022; Kucharz i in., 2010). Hanna, profesor pediatrii, zmarła 20 lutego 1964 r. (Kolbuszewska, 2025).
Najważniejsze pomysły
- Grupy krwi jako cecha populacji (1919). W artykule w The Lancet Hirszfeldowie opisali grupy krwi około 8000 osób różnych narodowości, badanych na froncie macedońskim (Hirschfeld i Hirschfeld, 1919). Czerwiński i in. (2022) nazywają tę pracę pierwszą, która na dużej próbie pokazała, że częstość grup krwi różni się między populacjami.
- Indeks biochemiczny. Każdą grupę opisali jedną liczbą: stosunkiem odsetka osób z cechą A (grupy A i AB) do odsetka osób z cechą B (grupy B i AB). U narodów europejskich wynosił według nich od 4.5 do 2.5, u ludów Azji i Afryki – 1 lub mniej (Hirschfeld i Hirschfeld, 1919).
- Sprawdzanie modelu dziedziczenia rachunkiem. W tej samej pracy porównali odsetki grupy O i AB z wartościami policzonymi przy założeniu, że cechy A i B występują niezależnie – to porównanie obserwowanych z oczekiwanymi, tylko bez testu.
Ciekawostka
Najsłynniejsza praca Hirszfeldów powstała w warunkach frontowych. Jak wynika z przypisu w artykule, przedstawili ją na posiedzeniu Towarzystwa Lekarskiego w Salonikach 5 czerwca 1918 r., a na angielski przetłumaczyli ją oficerowie łącznikowi armii serbskiej i brytyjskiej (Hirschfeld i Hirschfeld, 1919).
W tym samym tekście autorzy przeprowadzili mały eksperyment na sobie: sprawdzili własną krew i znaleźli te same grupy i aglutyniny co osiem lat wcześniej, choć jedno z nich przeszło dur, a teraz cierpiało na przewlekłą malarię. Według Kolbuszewskiej (2025) dur i malarię przechodził w Salonikach Ludwik.
Przykład na historycznych danych
Dane pochodzą z tabeli II pracy z 1919 r. (s. 677): odsetki grup A, B, AB i O oraz liczba zbadanych w każdej grupie. Pomijamy Niemców (autorzy podali ich wyniki z pamięci, z wcześniejszych badań) i Austriaków (liczba zbadanych nieznana). Zostaje 14 grup i 7900 osób. Liczebności odtworzyliśmy z odsetków, więc mogą nieznacznie różnić się od oryginalnych. Nazwy grup podajemy za autorami („Żydzi” to uchodźcy z Monastyru, „Turcy” – muzułmanie z Macedonii).
Test chi-kwadrat niezależności dla tabeli 14 × 4 daje χ²(39, N = 7900) = 586.6, p < .001, a V Craméra = .157. Największe skorygowane reszty mają Indusi (grupa B: 16.3) i Anglicy (grupa B: −8.0). Nawet sześć narodów „typu europejskiego” różni się istotnie (χ²(15, N = 3000) = 44.5, p < .001), ale słabo (V = .07). Indeks biochemiczny liczony z tabeli II wynosi od 4.55 u Anglików (95% przedział bootstrapu parametrycznego [3.48, 6.22]) do 0.55 u Indusów [0.48, 0.63]; Serbowie, Grecy i Bułgarzy mają 2.26–2.30, nieco mniej niż 2.5 podane w tekście pracy.
Na rysunku
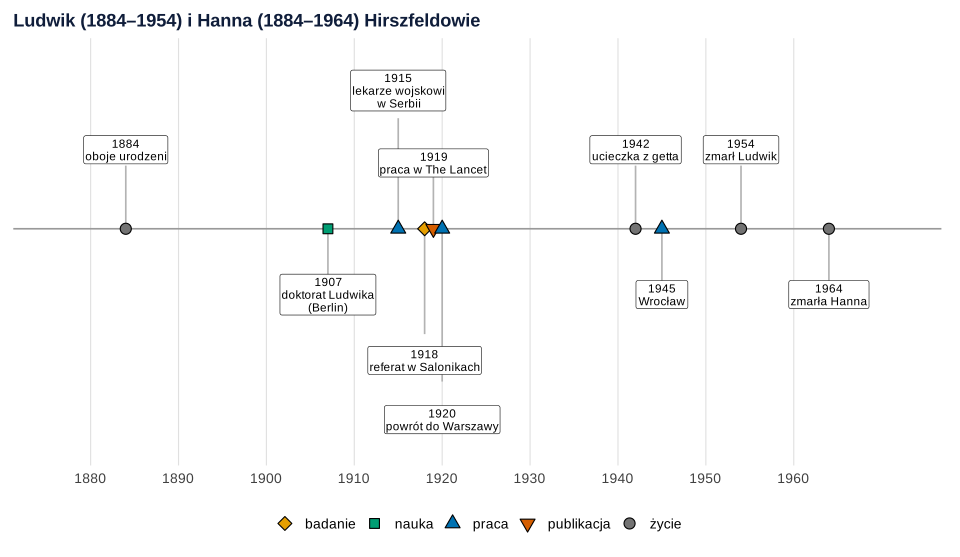
Co widać. Badanie, które wprowadziło serologię do antropologii (Czerwiński i in., 2022), powstało w latach wojny na Bałkanach.
Na co uważać. Oś zawiera tylko daty z cytowanych źródeł. Źródła różnią się co do dnia urodzenia Ludwika i roku ucieczki z getta; przyjmujemy rok 1942 za Czerwińskim i in. (2022) oraz Kolbuszewską (2025).
Podpis do pracy:
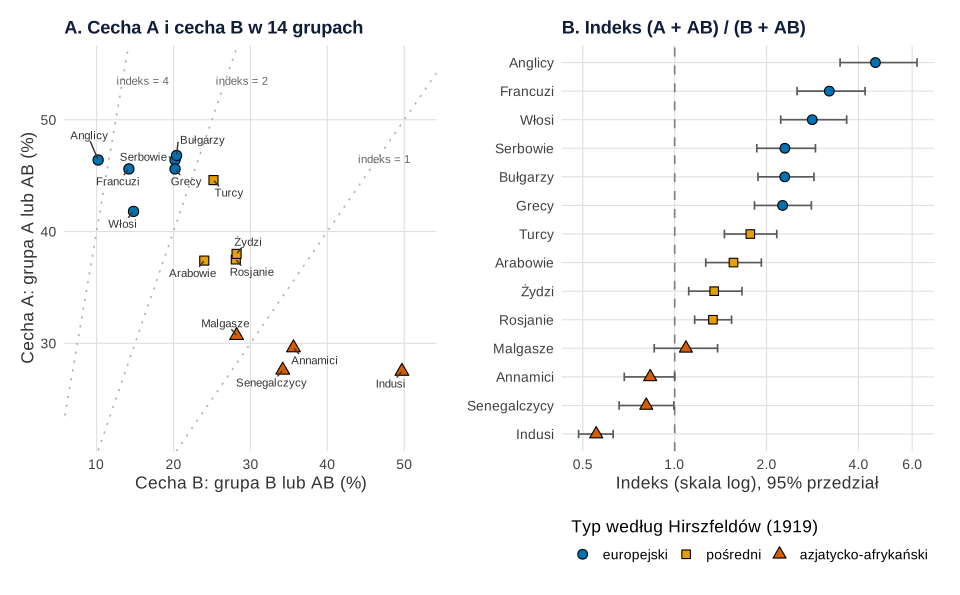
set.seed(1919)).Co widać. Panel A pokazuje opisany przez autorów gradient: im dalej od zachodniej Europy, tym mniej cechy A, a więcej cechy B. Panel B porządkuje grupy według indeksu: trzy „typy” autorów odpowiadają kolejności, ale granice są płynne.
Na co uważać. Próby nie były losowe: to żołnierze i uchodźcy, którzy akurat znaleźli się w Salonikach. Indeks jest ilorazem, więc jego przedział jest niesymetryczny (stąd skala logarytmiczna).
Podpis do pracy:
Gdzie spotkasz Hirszfeldów w swojej pracy
- Tabela krzyżowa i chi-kwadrat. Porównanie rozkładu kategorii w grupach to klasyczny test niezależności; siłę związku opisuj V Craméra, a ważne komórki wskaż resztami – zob. test chi-kwadrat krok po kroku i wykres mozaikowy.
- Jedna liczba zamiast tabeli. Indeks Hirszfeldów to iloraz dwóch proporcji. Takie wskaźniki są wygodne, ale potrzebują przedziału ufności – zob. przedział ufności dla proporcji i bootstrap.
- Dziedziczenie i rachunek prawdopodobieństwa. Hirszfeldowie wprost powoływali się na prawa Gregora Mendla, sprawdzając, czy odsetki grup zgadzają się z przewidywaniami.
Spory, mity i trudne strony
- „Rasy biochemiczne”. Praca z 1919 r. mówi o rasach i stawia hipotezę dwóch ośrodków pochodzenia: cechy A w Europie i cechy B w Indiach – sami autorzy nazywali ją hipotetyczną (Hirschfeld i Hirschfeld, 1919). Czerwiński i in. (2022) piszą, że łączenie grup krwi z „pochodzeniem rasowym” zostało później nadużyte w nazistowskich Niemczech, a Hirszfeld w książce z 1938 r. odciął się od wiązania grup krwi z mistyką rasy. Dane traktujemy tu jako historyczny przykład różnic między populacjami, nie klasyfikację ras.
- Kto zorganizował ucieczkę z getta? Czerwiński i in. (2022) przypisują ją aptekarzowi Konstantemu Potockiemu, Kolbuszewska (2025) – pomocy Żegoty.
- Hanna w cieniu męża. Kolbuszewska (2025) zauważa, że współautorkę pracy z 1919 r. pamiętano głównie jako żonę uczonego.
Dane Hirszfeldów w R
Kod rysuje oś czasu, a potem wpisuje tabelę II z pracy z 1919 r., odtwarza liczebności z odsetków, liczy indeks biochemiczny z przedziałami bootstrapu parametrycznego, test chi-kwadrat niezależności z V Craméra (dla wszystkich 14 grup i dla sześciu grup europejskich) oraz skorygowane reszty standaryzowane. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
liczebności odtworzone z odsetków, indeks biochemiczny z 95% przedziałami, wynik testu chi-kwadrat i V Craméra oraz skorygowane reszty dla Anglików i Indusów.
Kod R rysunków 1 i 2
# Ludwik i Hanna Hirszfeldowie: oś czasu i grupy krwi żołnierzy frontu macedońskiego (Hirschfeld i Hirschfeld, 1919)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(ggrepel)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73",
        fiolet = "#CC79A7", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Czerwińskiego i in. 2022, Kolbuszewskiej 2025, Kucharza i in. 2010 oraz pracy z 1919 r.)
zdarzenia <- data.frame(
  rok = c(1884, 1907, 1915, 1918, 1919, 1920, 1942, 1945, 1954, 1964),
  opis = c("oboje urodzeni", "doktorat Ludwika\n(Berlin)", "lekarze wojskowi\nw Serbii",
           "referat w Salonikach", "praca w The Lancet", "powrót do Warszawy", "ucieczka z getta",
           "Wrocław", "zmarł Ludwik", "zmarła Hanna"),
  rodzaj = c("życie", "nauka", "praca", "badanie", "publikacja", "praca", "życie", "praca", "życie", "życie"))
zdarzenia$y <- c(1.2, -1, 2.1, -2, 1, -2.9, 1.2, -1, 1.2, -1)   # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "nauka" = 22, "praca" = 24, "badanie" = 23, "publikacja" = 25), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "nauka" = oi[["zielony"]], "praca" = oi[["niebieski"]],
                               "badanie" = oi[["pomaranczowy"]], "publikacja" = oi[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1880, 1960, 10), limits = c(1876, 1972)) + scale_y_continuous(limits = c(-3.3, 2.6)) +
  labs(title = "Ludwik (1884–1954) i Hanna (1884–1964) Hirszfeldowie", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Tabela II z pracy Hirszfeldów (Hirschfeld i Hirschfeld, 1919, s. 677): odsetki grup krwi i liczba zbadanych.
#    Pomijamy Niemców (liczby z pamięci, z wcześniejszych badań) i Austriaków (liczba zbadanych nieznana).
#    Typ według tabeli IV tej samej pracy. Liczebności odtwarzamy z odsetków (zaokrąglenie do osoby).
tab2 <- data.frame(
  grupa = c("Anglicy", "Francuzi", "Włosi", "Serbowie", "Grecy", "Bułgarzy", "Arabowie", "Turcy", "Rosjanie",
            "Żydzi", "Malgasze", "Senegalczycy", "Annamici", "Indusi"),
  A  = c(43.4, 42.6, 38.0, 41.8, 41.6, 40.6, 32.4, 38.0, 31.2, 33.0, 26.2, 22.6, 22.4, 19.0),
  B  = c( 7.2, 11.2, 11.0, 15.6, 16.2, 14.2, 19.0, 18.6, 21.8, 23.2, 23.7, 29.2, 28.4, 41.2),
  AB = c( 3.0,  3.0,  3.8,  4.6,  4.0,  6.2,  5.0,  6.6,  6.3,  5.0,  4.5,  5.0,  7.2,  8.5),
  O  = c(46.4, 43.2, 47.2, 38.0, 38.2, 39.0, 43.6, 36.8, 40.7, 38.8, 45.5, 43.2, 42.0, 31.3),
  n  = c( 500,  500,  500,  500,  500,  500,  500,  500, 1000,  500,  400,  500,  500, 1000),
  typ = c(rep("europejski", 6), rep("pośredni", 4), rep("azjatycko-afrykański", 4)))
liczebnosci <- round(as.matrix(tab2[, c("A", "B", "AB", "O")]) * tab2$n / 100)
rownames(liczebnosci) <- tab2$grupa
cbind(liczebnosci, suma = rowSums(liczebnosci))

# Indeks biochemiczny Hirszfeldów: (A + AB) / (B + AB) – ile razy częstsza jest cecha A niż cecha B
tab2$indeks <- (tab2$A + tab2$AB) / (tab2$B + tab2$AB)
# 95% przedział bootstrapowy (parametryczny, 5000 losowań z rozkładu wielomianowego dla każdej grupy)
set.seed(1919)
przedzialy <- t(sapply(seq_len(nrow(liczebnosci)), function(i) {
  sym <- rmultinom(5000, size = sum(liczebnosci[i, ]), prob = liczebnosci[i, ] / sum(liczebnosci[i, ]))
  ind <- (sym["A", ] + sym["AB", ]) / (sym["B", ] + sym["AB", ])
  quantile(ind, c(0.025, 0.975))
}))
tab2$dolna <- przedzialy[, 1]; tab2$gorna <- przedzialy[, 2]
data.frame(grupa = tab2$grupa, typ = tab2$typ, indeks = round(tab2$indeks, 2), dolna = round(tab2$dolna, 2), gorna = round(tab2$gorna, 2))

# Test chi-kwadrat niezależności: grupa krwi a narodowość (14 × 4) i V Craméra
test <- chisq.test(liczebnosci)
v_cramera <- function(t, chi2) unname(sqrt(chi2 / (sum(t) * (min(dim(t)) - 1))))
data.frame(chi2 = round(unname(test$statistic), 1), df = unname(test$parameter), p = signif(test$p.value, 3),
           V = round(v_cramera(liczebnosci, test$statistic), 3), N = sum(liczebnosci))
# To samo tylko dla sześciu narodów „typu europejskiego”
euro <- liczebnosci[tab2$typ == "europejski", ]
test_e <- chisq.test(euro)
data.frame(chi2 = round(unname(test_e$statistic), 1), df = unname(test_e$parameter), p = signif(test_e$p.value, 3),
           V = round(v_cramera(euro, test_e$statistic), 3), N = sum(euro))
# Największe skorygowane reszty standaryzowane w tabeli 14 × 4
reszty <- round(test$stdres, 1)
reszty[c("Anglicy", "Indusi"), ]

# Rysunek 2A: odsetek osób z cechą A (A + AB) i z cechą B (B + AB)
tab2$cechaA <- tab2$A + tab2$AB; tab2$cechaB <- tab2$B + tab2$AB
tab2$typ <- factor(tab2$typ, levels = c("europejski", "pośredni", "azjatycko-afrykański"))
kolory_typ <- c("europejski" = oi[["niebieski"]], "pośredni" = oi[["pomaranczowy"]], "azjatycko-afrykański" = oi[["cynober"]])
ksztalty_typ <- c("europejski" = 21, "pośredni" = 22, "azjatycko-afrykański" = 24)
linie <- data.frame(indeks = c(1, 2, 4), etykieta = c("indeks = 1", "indeks = 2", "indeks = 4"))
pA <- ggplot(tab2, aes(cechaB, cechaA)) +
  geom_abline(data = linie, aes(slope = indeks, intercept = 0), colour = "grey70", linetype = "dotted") +
  annotate("text", x = c(44, 25.5, 12.6), y = c(46.5, 53.5, 53.5), label = linie$etykieta, size = 3, colour = "grey40", hjust = 0) +
  geom_point(aes(fill = typ, shape = typ), size = 3.2) +
  geom_text_repel(aes(label = grupa), size = 3, colour = "grey20", seed = 1, min.segment.length = 0.2, box.padding = 0.35) +
  scale_fill_manual(values = kolory_typ, name = "Typ według Hirszfeldów (1919)") +
  scale_shape_manual(values = ksztalty_typ, name = "Typ według Hirszfeldów (1919)") +
  scale_x_continuous(limits = c(8, 52)) + scale_y_continuous(limits = c(22, 55)) +
  labs(title = "A. Cecha A i cecha B w 14 grupach", x = "Cecha B: grupa B lub AB (%)", y = "Cecha A: grupa A lub AB (%)") +
  motyw + theme(legend.position = "none")
# Rysunek 2B: indeks biochemiczny z 95% przedziałem bootstrapowym (skala logarytmiczna)
tab2$grupa_upo <- factor(tab2$grupa, levels = tab2$grupa[order(tab2$indeks)])
pB <- ggplot(tab2, aes(indeks, grupa_upo)) +
  geom_vline(xintercept = 1, colour = "grey50", linetype = "dashed") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.3, orientation = "y", colour = "grey35") +
  geom_point(aes(fill = typ, shape = typ), size = 3) +
  scale_fill_manual(values = kolory_typ, name = "Typ według Hirszfeldów (1919)") +
  scale_shape_manual(values = ksztalty_typ, name = "Typ według Hirszfeldów (1919)") +
  scale_x_log10(breaks = c(0.5, 1, 2, 4, 6)) +
  guides(fill = guide_legend(title.position = "top", nrow = 1), shape = guide_legend(title.position = "top", nrow = 1)) +
  labs(title = "B. Indeks (A + AB) / (B + AB)", x = "Indeks (skala log), 95% przedział", y = NULL) +
  motyw + theme(legend.position = "bottom")
p_metoda <- pA + pB + plot_layout(widths = c(1, 1))
p_os
p_metoda
Wynik w R
               A   B AB   O suma
Anglicy      217  36 15 232  500
Francuzi     213  56 15 216  500
Włosi        190  55 19 236  500
Serbowie     209  78 23 190  500
Grecy        208  81 20 191  500
Bułgarzy     203  71 31 195  500
Arabowie     162  95 25 218  500
Turcy        190  93 33 184  500
Rosjanie     312 218 63 407 1000
Żydzi        165 116 25 194  500
Malgasze     105  95 18 182  400
Senegalczycy 113 146 25 216  500
Annamici     112 142 36 210  500
Indusi       190 412 85 313 1000
          grupa                  typ indeks dolna gorna
1       Anglicy           europejski   4.55  3.48  6.22
2      Francuzi           europejski   3.21  2.52  4.21
3         Włosi           europejski   2.82  2.23  3.66
4      Serbowie           europejski   2.30  1.86  2.89
5         Grecy           europejski   2.26  1.83  2.80
6      Bułgarzy           europejski   2.29  1.87  2.86
7      Arabowie             pośredni   1.56  1.26  1.92
8         Turcy             pośredni   1.77  1.46  2.16
9      Rosjanie             pośredni   1.33  1.16  1.54
10        Żydzi             pośredni   1.35  1.11  1.66
11     Malgasze azjatycko-afrykański   1.09  0.86  1.38
12 Senegalczycy azjatycko-afrykański   0.81  0.66  0.99
13     Annamici azjatycko-afrykański   0.83  0.68  1.00
14       Indusi azjatycko-afrykański   0.55  0.48  0.63
   chi2 df        p     V    N
1 586.6 39 7.12e-99 0.157 7900
  chi2 df        p    V    N
1 44.5 15 9.33e-05 0.07 3000
           A    B   AB    O
Anglicy  5.2 -8.0 -2.5  2.9
Indusi  -9.9 16.3  4.5 -6.2
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test – funkcja chisq.test(), losowanie – rmultinom() z pakietu stats; rysunki – pakiety ggplot2, ggrepel i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim byli Ludwik i Hanna Hirszfeldowie?
Polskimi lekarzami: Ludwik (1884–1954) był immunologiem i mikrobiologiem, współtwórcą oznaczeń grup krwi A, B, O, Hanna (1884–1964) – pediatrą. W czasie I wojny światowej pracowali w Serbii i pod Salonikami, przeżyli getto warszawskie, a po wojnie tworzyli medycynę we Wrocławiu.
Co odkryli Hirszfeldowie w Salonikach?
Że częstość grup krwi A i B wyraźnie różni się między narodami: u Anglików przeważała cecha A, u żołnierzy z Indii – cecha B. Wyniki około 8000 osób opublikowali w „The Lancet” w 1919 r.
Co to jest indeks biochemiczny Hirszfeldów?
Stosunek odsetka osób z cechą A (grupy A i AB) do odsetka osób z cechą B (grupy B i AB). Według autorów u narodów europejskich wynosił od 4.5 do 2.5, a u ludów Azji i Afryki – 1 lub mniej.
Czy praca Hirszfeldów była rasistowska?
Praca z 1919 r. używa pojęcia ras i stawia hipotezę dwóch ośrodków pochodzenia cech A i B, którą sami autorzy nazywali hipotetyczną. Takie ujęcie nadużyto później w nazistowskich Niemczech, a Ludwik Hirszfeld w 1938 r. odciął się od wiązania grup krwi z mistyką rasy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Test chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikKalkulator tabeli 2×2 i r×c
Chi-kwadrat, test dokładny Fishera, V Craméra i reszty dla tabel do 5 × 5, a dla 2 × 2 także OR, RR i różnica odsetków z przedziałami ufności.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Czerwinski, M., Kaczmarek, R., & Glensk, U. (2022). Ludwik Hirszfeld: A pioneer of transfusion and immunology during the world wars and beyond. Vox Sanguinis, 117(4), 467–475. https://doi.org/10.1111/vox.13214 ● Otwarty dostęp
- Hirschfeld, L., & Hirschfeld, H. (1919). Serological differences between the blood of different races: The result of researches on the Macedonian front. The Lancet, 194(5016), 675–679. https://doi.org/10.1016/s0140-6736(01)48686-7 ● Otwarty dostęp: pełny tekst
- Kolbuszewska, J. (2025). „Blaski i cienie życia żony uczonego...” O emancypacji, naukowej karierze i małżeństwie Hanny Hirszfeldowej. Czasopismo Naukowe Instytutu Studiów Kobiecych, 173–193. https://doi.org/10.15290/cnisk.2025.02.19.07 ● Otwarty dostęp: pełny tekst
- Kucharz, E. J., Shampo, M. A., & Kyle, R. A. (2010). Ludwik Hirszfeld—Polish immunologist, microbiologist, and hematologist. Mayo Clinic Proceedings, 85(5), Article e35. https://doi.org/10.4065/mcp.2010.0251 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{czerwinski2022ludwik, author={Czerwinski, Marcin and Kaczmarek, Radoslaw and Glensk, Urszula}, title={{Ludwik Hirszfeld: A pioneer of transfusion and immunology during the world wars and beyond}}, journal={Vox Sanguinis}, year={2022}, volume={117}, number={4}, pages={467--475}, doi={10.1111/vox.13214}}@article{hirschfeld1919serological, author={Hirschfeld, Ludwik and Hirschfeld, Hanka}, title={{Serological differences between the blood of different races: The result of researches on the Macedonian front}}, journal={The Lancet}, year={1919}, volume={194}, number={5016}, pages={675--679}, doi={10.1016/s0140-6736(01)48686-7}}@article{kolbuszewska2025blaski, author={Kolbuszewska, Jolanta}, title={{„Blaski i cienie życia żony uczonego...” O emancypacji, naukowej karierze i małżeństwie Hanny Hirszfeldowej}}, journal={Czasopismo Naukowe Instytutu Studiów Kobiecych}, year={2025}, number={2(19)}, pages={173--193}, url={https://doi.org/10.15290/cnisk.2025.02.19.07}}@article{kucharz2010ludwik, author={Kucharz, Eugene Joseph and Shampo, Marc A. and Kyle, Robert A.}, title={{Ludwik Hirszfeld—Polish immunologist, microbiologist, and hematologist}}, journal={Mayo Clinic Proceedings}, year={2010}, volume={85}, number={5}, eid={e35}, doi={10.4065/mcp.2010.0251}}