Kim był Leslie Kish?
Leslie Kish (1910–2000) urodził się 27 lipca 1910 r. w Popradzie – wówczas w Austro-Węgrzech, dziś na Słowacji (United States Census Bureau, b.d.; Rivers, 2000). Jako nastolatek przyjechał z rodziną do Nowego Jorku. Szkołę średnią i studia matematyczne w City College of New York kończył wieczorowo, pracując na pełny etat. Studia przerwał w 1937 r., gdy wyjechał jako ochotnik do Hiszpanii; dyplom z matematyki (cum laude) uzyskał po powrocie, w 1939 r. (Frankel i King, 1996).
W 1940 r. zaczął pracę w amerykańskim Biurze Spisowym, w 1941 r. przeszedł do działu badań sondażowych Departamentu Rolnictwa (Division of Program Surveys), a w latach 1942–1945 służył jako meteorolog w lotnictwie armii USA. W 1947 r. z grupą kolegów z Departamentu Rolnictwa przeniósł się na Uniwersytet Michigan, do nowo utworzonego Survey Research Center, z którego wyrósł Institute for Social Research (Rivers, 2000; White, 2008). Pracując na pełny etat, zrobił tam magisterium ze statystyki matematycznej (1948) i doktorat z socjologii (1952). Profesorem został w 1960 r., na emeryturę przeszedł w 1981 r. W 1977 r. był prezesem American Statistical Association (Frankel i King, 1996). Zmarł 7 października 2000 r.
Najważniejsze pomysły
- „Survey Sampling” (1965). Podręcznik, który według Biura Spisowego wyłożył teorię doboru prób i schematów badań stosowaną do dziś (United States Census Bureau, b.d.; Kish, 1965). W nekrologu w Kongresie USA przypomniano, że studenci i wykładowcy nazywali go „biblią” (Rivers, 2000).
- Efekt schematu (deff). To w tej książce Kish zaproponował miarę, która mówi, ile razy wariancja oszacowania w danym schemacie jest większa niż w prostej próbie losowej tej samej liczebności (White, 2008). Dziś efekt schematu podaje się przy każdym poważnym sondażu, a przy doborze grupowym przybliża się go wzorem 1 + (m − 1)ρ, gdzie ρ to korelacja wewnątrzklasowa.
- Wybór respondenta w gospodarstwie domowym (1949). Kish (1949) opisał obiektywną procedurę wyboru jednej osoby dorosłej w wylosowanym gospodarstwie i sprawdził ją w czterech badaniach. Od jego nazwiska pochodzi „metoda Kisha”, w Polsce zwykle „siatka Kisha”.
- Szkolenie statystyków z całego świata. W 1948 r. zapoczątkował letni program dla zagranicznych statystyków (Rivers, 2000); według Frankela i Kinga (1996) wykształcił setki specjalistów od doboru prób z ponad 90 krajów.
Ciekawostka
Autor „biblii” doboru prób zaczynał od zera. Jak streszczają rozmowę z nim Frankel i King (1996), przyjechał do Stanów Zjednoczonych, znając około 300 angielskich słów. W ciągu roku zmarł jego ojciec i kilkunastoletni Leslie został głównym żywicielem pięcioosobowej rodziny.
Od 1929 r. pracował na pełny etat jako asystent laboratoryjny w Rockefeller Institute, a uczył się wieczorami – najpierw w wieczorowym liceum, potem na wieczorowych studiach w City College. Także magisterium i doktorat w Michigan zrobił, pracując na pełny etat.
Przykład na danych z pakietu R
Pakiet survey zawiera dane o kalifornijskich szkołach: wskaźnik osiągnięć API z 2000 r. dla wszystkich szkół mających co najmniej 100 uczniów oraz kilka prób z tej populacji, przygotowanych do ćwiczeń z doboru prób (opis z pliku pomocy ?api). Bierzemy dwie z nich. apisrs to prosta próba losowa 200 szkół. apiclus1 to próba gronowa: wylosowano 15 okręgów szkolnych z 757 i zbadano wszystkie ich szkoły – razem 183. W okręgu było od 1 do 37 szkół, średnio 12.2.
Błąd standardowy średniej API wynosi 9.25 w próbie prostej i 23.54 w próbie gronowej. Efekt schematu policzony z opisu schematu to 9.35, więc 183 szkoły z 15 okręgów są warte tyle, co około 19.6 szkoły wylosowanej niezależnie. Przyczyną jest podobieństwo szkół w okręgu (ρ = 0.46).
Wzór Kisha z średnią liczbą szkół w okręgu (m = 12.2) daje deff = 6.17 – wyraźnie za mało. Okręgi są bardzo nierówne, a duże ważą w średniej więcej. Gdy zamiast zwykłej średniej weźmiemy średnią ważoną wielkością okręgu (Σm²/Σm = 21.66), wzór daje 10.54, bliżej wartości z danych.
Na rysunku
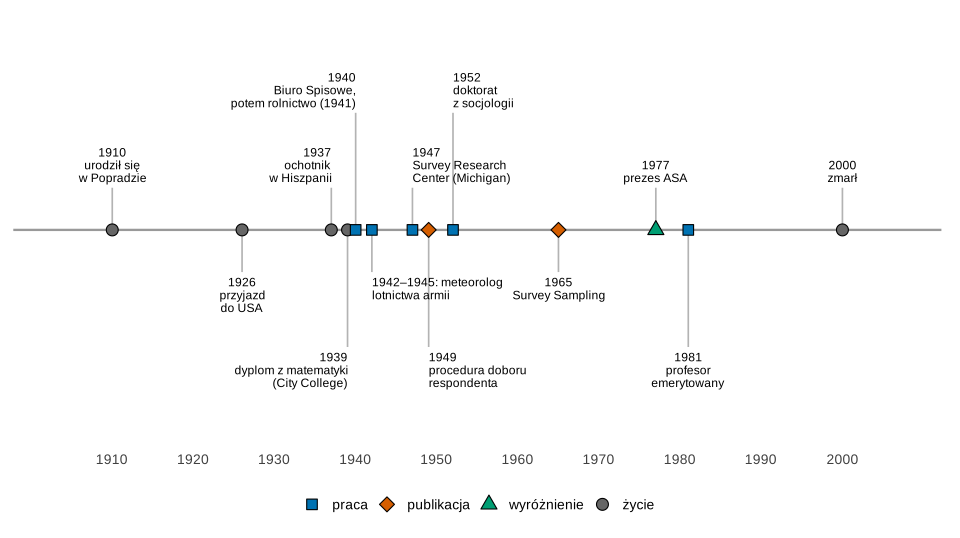
Co widać. Do statystyki sondażowej Kish doszedł późno i okrężną drogą – przez pracę fizyczną, wieczorowe studia, wojnę i służbę meteorologiczną.
Na co uważać. Źródła różnią się rokiem przyjazdu do USA: streszczenie rozmowy z Kishem (Frankel i King, 1996) podaje 1926, wspomnienie w Kongresie (Rivers, 2000) – 1925; na osi jest rok z rozmowy.
Podpis do pracy:
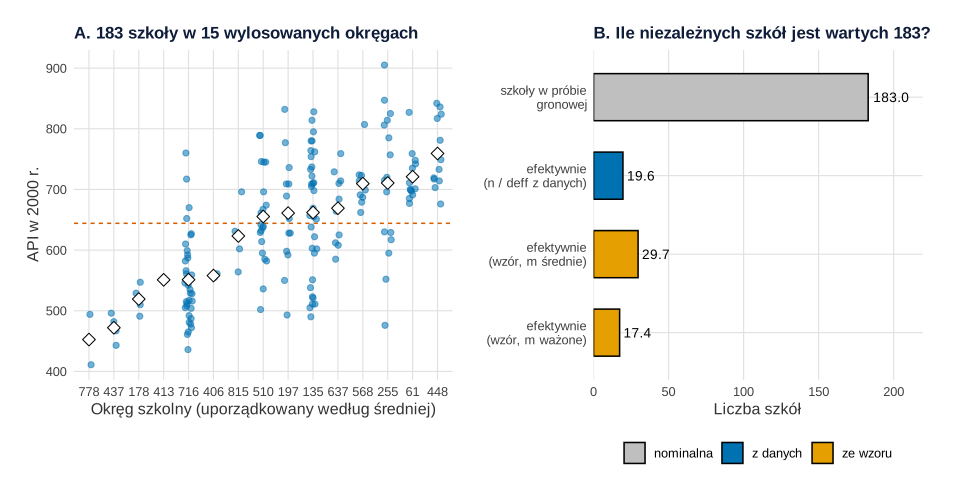
survey::apiclus1. Obliczenia i rysunek: R, pakiety survey, ggplot2 i patchwork (punkty rozsunięte poziomo z seed = 929; poza tym bez losowania).Co widać. Panel A pokazuje, skąd bierze się efekt schematu: szkoły z jednego okręgu mają podobne wyniki, a średnie okręgów (romby) leżą daleko od siebie. Kolejna szkoła z tego samego okręgu dodaje więc niewiele nowej informacji. Panel B przelicza to na liczbę szkół: 183 obserwacje dają precyzję jak około 20 niezależnych.
Na co uważać. Wzór 1 + (m − 1)ρ zakłada grona równej wielkości. Przy bardzo nierównych gronach wynik zależy od tego, jakie m się wstawi, a przy 15 gronach także sam efekt schematu z danych jest oszacowany mało precyzyjnie.
Podpis do pracy:
Gdzie spotkasz Kisha w swojej pracy
Zawsze, gdy osoby są zgrupowane (uczniowie w klasach, pacjenci w poradniach) albo dane pochodzą z dużego sondażu:
- planując liczebność, policz efekt schematu i efektywną liczebność próby (pomoże kalkulator ICC i efektu schematu); liczy się przede wszystkim liczba gron, nie osób;
- analizując dane gronowe jak niezależne, popełniasz pseudoreplikację – błędy standardowe wychodzą za małe; uwzględnij schemat w pakiecie survey albo w modelu wielopoziomowym;
- margines błędu w sondażu z doborem wielostopniowym jest szerszy niż z wzoru dla prostej próby – mnoży się go przez √deff (więcej w haśle dobór wielostopniowy);
- w badaniach gospodarstw domowych wybór jednej osoby (np. procedurą Kisha) daje nierówne prawdopodobieństwa wyboru, które trzeba wyrównać wagami; jak pracować z takimi danymi, pokazuje wpis analiza danych z ESS, PGSS i Diagnozy Społecznej.
Klasyczny podręcznik doboru prób napisał też William G. Cochran, a o losowaniu warstwowym pisze hasło o Jerzym Neymanie. Jak próba losowa wygrała z ogromną, ale nielosową, opowiada hasło o George’u Gallupie.
Spory, mity i trudne strony
- Wojna w Hiszpanii. W 1937 r., na mniej niż rok przed dyplomem, Kish zgłosił się do Brygad Międzynarodowych i walczył po stronie republikańskiego rządu Hiszpanii; do USA wrócił w 1939 r. (Frankel i King, 1996; Rivers, 2000). Cytowane źródła nie opisują jego służby szczegółowiej.
- Czy efekt schematu to wzór 1 + (m − 1)ρ? Nie – efekt schematu to stosunek dwóch wariancji, a wzór jest jego przybliżeniem dla doboru grupowego z gronami równej wielkości. Przykład wyżej pokazuje, że przy nierównych gronach przybliżenie może się mylić o kilkadziesiąt procent.
- Wagi w danych
apiclus1. Plik pomocy ostrzega, że wagi w tym zbiorze są błędne (powinny wynosić 757/15). Dla średniej stała skala wag nie ma znaczenia, ale przy szacowaniu sum trzeba je poprawić.
Efekt schematu Kisha w R
Kod wczytuje dane o szkołach kalifornijskich z pakietu survey, liczy średnią API z błędem standardowym i efektem schematu w próbie gronowej i prostej, porównuje wynik ze wzorem Kisha i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Jedyne losowanie to rozsunięcie punktów na rysunku (seed = 929).
1. Efekt schematu w próbie gronowej: rysunek 2
Kod R rysunku 2
# Leslie Kish: efekt schematu (deff) w prawdziwej próbie gronowej szkół – survey::apiclus1 vs survey::apisrs
suppressPackageStartupMessages({library(survey); library(ggplot2); library(patchwork)})
kol <- c(grono = "#0072B2", srednia = "#D55E00", srs = "#009E73", wzor = "#E69F00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(api, package = "survey")
# apiclus1 – losowanie 15 okręgów szkolnych (z 757) i wszystkie ich szkoły; apisrs – prosta próba losowa 200 szkół
# api00 – wskaźnik osiągnięć szkoły (Academic Performance Index) w 2000 r.
c(szkoly_grono = nrow(apiclus1), okregi = length(unique(apiclus1$dnum)), szkoly_srs = nrow(apisrs))
m <- as.numeric(table(apiclus1$dnum))           # liczba szkół w każdym wylosowanym okręgu
summary(m)

# 1. Efekt schematu z opisu schematu (wagi z pliku; dla średniej ich stała skala nie ma znaczenia)
dclus1 <- svydesign(id = ~dnum, weights = ~pw, data = apiclus1, fpc = ~fpc)
dsrs   <- svydesign(id = ~1, weights = ~pw, data = apisrs, fpc = ~fpc)
w_grono <- svymean(~api00, dclus1, deff = TRUE)
w_srs   <- svymean(~api00, dsrs, deff = TRUE)
deff_grono <- as.numeric(deff(w_grono))
round(rbind(grono_15_okregow = c(srednia = coef(w_grono), SE = SE(w_grono), deff = deff_grono),
            prosta_200_szkol = c(srednia = coef(w_srs), SE = SE(w_srs), deff = as.numeric(deff(w_srs)))), 2)
c(n = nrow(apiclus1), n_efektywne = round(nrow(apiclus1) / deff_grono, 1))

# 2. Wzór Kisha: deff ≈ 1 + (m − 1)ρ; ρ – korelacja wewnątrzklasowa szkół w okręgu (estymator ANOVA)
a <- anova(lm(api00 ~ factor(dnum), data = apiclus1))
k <- length(m); n <- sum(m); m0 <- (n - sum(m^2) / n) / (k - 1)   # „średnia” liczebność dla grup nierównych
rho <- (a[1, 3] - a[2, 3]) / (a[1, 3] + (m0 - 1) * a[2, 3])
m_sr <- mean(m); m_wazona <- sum(m^2) / sum(m)                    # zwykła średnia i średnia ważona wielkością
round(c(rho = rho, m_srednia = m_sr, deff_wzor_m_srednia = 1 + (m_sr - 1) * rho,
        m_wazona = m_wazona, deff_wzor_m_wazona = 1 + (m_wazona - 1) * rho, deff_z_danych = deff_grono), 2)

# Rysunek: A – szkoły w 15 okręgach; B – liczebność nominalna i efektywna
okregi <- aggregate(api00 ~ dnum, data = apiclus1, FUN = mean)
okregi <- okregi[order(okregi$api00), ]
apiclus1$okreg <- factor(apiclus1$dnum, levels = okregi$dnum)
pA <- ggplot(apiclus1, aes(okreg, api00)) +
  geom_hline(yintercept = coef(w_grono), colour = kol[["srednia"]], linetype = "22") +
  geom_point(colour = kol[["grono"]], alpha = 0.55, size = 1.8, position = position_jitter(width = 0.15, height = 0, seed = 929)) +
  stat_summary(fun = mean, geom = "point", shape = 23, size = 3.2, fill = "white", colour = "black") +
  labs(title = "A. 183 szkoły w 15 wylosowanych okręgach", x = "Okręg szkolny (uporządkowany według średniej)",
       y = "API w 2000 r.") +
  motyw + theme(axis.text.x = element_blank(), panel.grid.major.x = element_blank())
liczebnosci <- data.frame(
  co = factor(c("szkoły w próbie\ngronowej", "efektywnie\n(n / deff z danych)", "efektywnie\n(wzór, m średnie)",
                "efektywnie\n(wzór, m ważone)"),
              levels = rev(c("szkoły w próbie\ngronowej", "efektywnie\n(n / deff z danych)", "efektywnie\n(wzór, m średnie)",
                             "efektywnie\n(wzór, m ważone)"))),
  n = c(n, n / deff_grono, n / (1 + (m_sr - 1) * rho), n / (1 + (m_wazona - 1) * rho)),
  rodzaj = c("nominalna", "z danych", "ze wzoru", "ze wzoru"))
pB <- ggplot(liczebnosci, aes(n, co, fill = rodzaj)) +
  geom_col(width = 0.6, colour = "black") +
  geom_text(aes(label = sprintf("%.1f", n)), hjust = -0.15, size = 3.6) +
  scale_fill_manual(values = c(nominalna = "grey75", `z danych` = kol[["grono"]], `ze wzoru` = kol[["wzor"]]), name = NULL) +
  scale_x_continuous(limits = c(0, 215), expand = expansion(mult = c(0, 0.02))) +
  labs(title = "B. Ile niezależnych szkół jest wartych 183?", x = "Liczba szkół", y = NULL) +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.15, 1))
p2
Wynik w R
szkoly_grono       okregi   szkoly_srs
         183           15          200
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
    1.0     4.0    11.0    12.2    14.5    37.0
                 srednia.api00    SE deff
grono_15_okregow        644.17 23.54 9.35
prosta_200_szkol        656.58  9.25 1.00
          n n_efektywne
      183.0        19.6
                rho           m_srednia deff_wzor_m_srednia            m_wazona
               0.46               12.20                6.17               21.66
 deff_wzor_m_wazona       deff_z_danych
              10.54                9.35
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Leslie Kish (1910–2000) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1910, 1926, 1937, 1939, 1940, 1942, 1947, 1949, 1952, 1965, 1977, 1981, 2000),
  opis = c("urodził się\nw Popradzie", "przyjazd\ndo USA", "ochotnik\nw Hiszpanii", "dyplom z matematyki\n(City College)",
           "Biuro Spisowe,\npotem rolnictwo (1941)", "1942–1945: meteorolog\nlotnictwa armii",
           "Survey Research\nCenter (Michigan)", "procedura doboru\nrespondenta", "doktorat\nz socjologii",
           "Survey Sampling", "prezes ASA", "profesor\nemerytowany", "zmarł"),
  rodzaj = c("życie", "życie", "życie", "życie", "praca", "praca", "praca", "publikacja", "praca",
             "publikacja", "wyróżnienie", "praca", "życie"),
  poziom = c(0.45, -0.45, 0.45, -1.25, 1.25, -0.45, 0.45, -1.25, 1.25, -0.45, 0.45, -1.25, 0.45),   # wysokość etykiety
  wyrownanie = c(0.5, 0.5, 1, 1, 1, 0, 0, 0, 0, 0.5, 0.5, 0.5, 0.5))      # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- ifelse(zdarzenia$rok == 1942, zdarzenia$opis, paste0(zdarzenia$rok, "\n", zdarzenia$opis))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.2, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1903, 2007), breaks = seq(1910, 2000, by = 10)) +
  scale_y_continuous(limits = c(-2.1, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (opis schematu, średnia i efekt schematu – funkcje svydesign(), svymean() i deff() z pakietu survey; dane – pakiet survey; korelacja wewnątrzklasowa z anova() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8), 1–19. https://doi.org/10.18637/jss.v009.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Leslie Kish?
Amerykańskim statystykiem (1910–2000) urodzonym w Popradzie. Po pracy w Biurze Spisowym i Departamencie Rolnictwa USA od 1947 r. działał w Survey Research Center Uniwersytetu Michigan, współtworzył Institute for Social Research, napisał podręcznik Survey Sampling (1965), a w 1977 r. był prezesem American Statistical Association.
Co to jest efekt schematu Kisha (deff)?
Stosunek wariancji oszacowania w danym schemacie doboru do wariancji w prostej próbie losowej tej samej liczebności. Kish zaproponował go w Survey Sampling (1965). W przykładzie z pakietu survey 183 szkoły z 15 okręgów miały deff = 9.35, czyli dawały precyzję jak około 20 szkół wylosowanych niezależnie.
Na czym polega siatka Kisha?
To procedura obiektywnego wyboru jednej osoby dorosłej w wylosowanym gospodarstwie domowym, którą Kish opisał w 1949 r. i sprawdził w czterech badaniach dorosłej ludności. Dzięki niej o tym, z kim ankieter przeprowadzi wywiad, nie decyduje ani on sam, ani to, kto akurat otworzy drzwi.
Dlaczego wzór 1 + (m − 1)ρ nie zgadza się z efektem schematu z danych?
Bo zakłada grona równej wielkości. W próbie 15 okręgów szkolnych (od 1 do 37 szkół) wzór ze średnią liczbą szkół dał 6.17, ze średnią ważoną wielkością okręgu 10.54, a efekt schematu z danych wyniósł 9.35.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kalkulator ICC i efektu schematu
ICC z modelu pustego, ANOVA lub wyniku binarnego, efekt schematu z poprawką na nierówne grupy i liczba grup potrzebna w badaniu klastrowym.
Czytaj →PoradnikAnaliza danych z ESS, PGSS i Diagnozy Społecznej
Dostęp i rejestracja, wagi dweight, pspwght i anweight, warstwy i klastry, błędy standardowe ze schematu i regresja w R z wzorem opisu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Frankel, M., & King, B. (1996). A conversation with Leslie Kish. Statistical Science, 11(1), 65–87. https://doi.org/10.1214/ss/1032209665 ● Otwarty dostęp
- Kish, L. (1949). A procedure for objective respondent selection within the household. Journal of the American Statistical Association, 44(247), 380–387. https://doi.org/10.1080/01621459.1949.10483314
- Kish, L. (1965). Survey sampling. Wiley.
- Rivers, L. N. (2000). Tribute to the late Leslie Kish. Congressional Record (Bound Edition). https://www.govinfo.gov/content/pkg/CRECB-2000-pt17/html/CRECB-2000-pt17-Pg25085-2.htm ● Otwarty dostęp
- United States Census Bureau. (b.d.). Notable alumni: Leslie Kish. Pobrano 20 listopada 2026 z https://www.census.gov/library/photos/1940/leslie-kish.html ● Otwarty dostęp
- White, E. (2008). Kish, Leslie (1910–2000). In P. J. Lavrakas (Ed.), Encyclopedia of survey research methods. Sage. https://doi.org/10.4135/9781412963947.n261
Cytowania BibTeX
@article{frankel1996conversation, author={Frankel, Martin and King, Benjamin}, title={{A conversation with Leslie Kish}}, journal={Statistical Science}, year={1996}, volume={11}, number={1}, pages={65--87}, doi={10.1214/ss/1032209665}}@article{kish1949procedure, author={Kish, Leslie}, title={{A procedure for objective respondent selection within the household}}, journal={Journal of the American Statistical Association}, year={1949}, volume={44}, number={247}, pages={380--387}, doi={10.1080/01621459.1949.10483314}}@book{kish1965survey, author={Kish, Leslie}, title={{Survey sampling}}, year={1965}, publisher={Wiley}}@misc{rivers2000tribute, author={Rivers, Lynn N.}, title={{Tribute to the late Leslie Kish}}, howpublished={Congressional Record (Bound Edition)}, year={2000}, volume={146}, number={17}, pages={25085--25086}, publisher={U.S. Government Publishing Office}, url={https://www.govinfo.gov/content/pkg/CRECB-2000-pt17/html/CRECB-2000-pt17-Pg25085-2.htm}}@misc{uscensuskishnd, author={{United States Census Bureau}}, title={{Notable alumni: Leslie Kish}}, url={https://www.census.gov/library/photos/1940/leslie-kish.html}}@incollection{white2008kish, author={White, Eric}, title={{Kish, Leslie (1910–2000)}}, booktitle={Encyclopedia of survey research methods}, year={2008}, publisher={Sage}, doi={10.4135/9781412963947.n261}}