Kim był George Gallup?
George Horace Gallup (1901–1984) urodził się w Jefferson w stanie Iowa. Od 1919 r. studiował na State University of Iowa, gdzie w 1921 r. został redaktorem studenckiego dziennika „Daily Iowan”. Latem 1922 r. prowadził ankiety od drzwi do drzwi dla „St. Louis Post-Dispatch” i – jak pisze Hawbaker (b.d.) – wtedy zainteresował się mierzeniem opinii. Na studiach podyplomowych z psychologii badał metodami ankietowymi m.in. czytelników gazet z Des Moines.
W 1929 r. objął kierownictwo dziennikarstwa na Drake University, w latach 1931–1932 uczył dziennikarstwa na Northwestern, a w 1932 r. przeszedł do nowojorskiej agencji reklamowej Young & Rubicam. W tym samym roku jego teściowa, Ola Babcock Miller, kandydowała na sekretarza stanu Iowa – i Gallup zrobił wtedy pierwsze, proste sondaże wyborcze. W 1935 r. założył z Harrym Andersonem w Princeton American Institute of Public Opinion, który publikował wyniki w kolumnie prasowej „America Speaks”. Zmarł 26 lipca 1984 r. w swoim letnim domu w Szwajcarii (Hawbaker, b.d.).
Najważniejsze pomysły
- Mała próba zamiast ogromnej. W 1936 r. „Literary Digest” oparł prognozę na 2.3 mln kart zwróconych z 10 mln rozesłanych i wskazał zwycięstwo Alfa Landona. Sondaż Gallupa na próbie kwotowej trafnie przewidział wygraną Franklina D. Roosevelta (Baker i in., 2013). Od tej porażki zaczyna się historia „naukowych” sondaży (Lusinchi, 2012).
- Sondaż jako stała instytucja. Instytut Gallupa regularnie publikował wyniki w gazetach, z czasem rozwinął sieć zagranicznych filii, badania rynku i reklamy, a od 1969 r. coroczny sondaż o szkołach publicznych (Hawbaker, b.d.).
- Sondaże a demokracja. Gallup przekonywał, że skoro rząd ma opierać się na woli obywateli, ktoś powinien tę wolę zbadać (Hawbaker, b.d.).
- Od kwot do losowania. Po błędzie z 1948 r. Gallup wkrótce przyjął metody oparte na doborze losowym, a inni sondażyści poszli w jego ślady (Baker i in., 2013).
Ciekawostka
Gallup postawił w 1936 r. pieniądze na własną metodę. Według Hawbaker (b.d.) publicznie rzucił wyzwanie „Literary Digest” – wówczas najbardziej znanej ankiecie korespondencyjnej w kraju – i zapowiedział zwycięstwo Roosevelta. Gazetom, które kupowały jego wyniki, obiecał zwrot pieniędzy, jeśli jego prognoza nie okaże się trafniejsza niż prognoza „Digestu”.
Ryzyko było realne: według raportu AAPOR „Literary Digest” trafnie wskazywał zwycięzcę w każdych wyborach od 1920 r. (Baker i in., 2013). Tym razem się pomylił, a porażka przyczyniła się do upadku pisma w 1938 r.
Przykład na danych historycznych
The American Presidency Project (Peters, 2024) zestawia ostatnie przedwyborcze szacunki Gallupa z wynikami wyborów prezydenckich w USA w latach 1936–2012. Wpisaliśmy je ręcznie do kodu (odsetki głosów kandydatów dwóch głównych partii) i dla każdych wyborów policzyliśmy przewagę demokraty nad republikaninem w sondażu i w wyborach oraz błąd przewagi (sondaż − wynik). Liczebności prób tabela nie podaje, więc nie da się oddzielić błędu losowego od obciążenia.
W 1936 r. Gallup dawał Rooseveltowi 11.4 punktu przewagi, a Roosevelt wygrał o 24.3 – zwycięzca się zgadzał, ale przewaga była niedoszacowana o 12.9 punktu. To największy błąd w całym zestawieniu. W 1948 r. sondaż dawał 5.0 punktu przewagi Deweyowi, a Truman wygrał o 4.4 (błąd 9.4 punktu w tę samą stronę). W latach 1936–1948 przeciętny błąd bezwzględny przewagi wyniósł 8.2 punktu i za każdym razem sondaż zaniżał wynik demokraty; w latach 1952–2012 – 3.6 punktu, z błędami w obie strony. Zwycięzcę w głosach powszechnych sondaż wskazał źle w 4 z 20 wyborów (1948, 1976, 2000, 2012), a w 2004 r. dawał remis.
Na rysunku
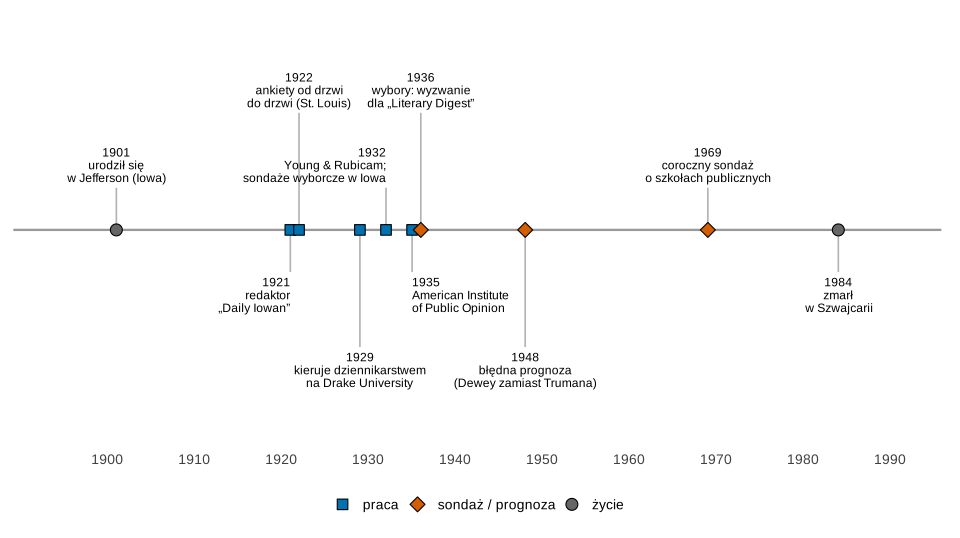
Co widać. Gallup przyszedł do sondaży z dziennikarstwa i reklamy; między pierwszymi sondażami w Iowa a ogólnokrajową prognozą minęły cztery lata.
Na co uważać. Źródła różnią się dniem urodzenia (18 albo 19 listopada 1901 r.), dlatego podajemy tylko rok. Daty uzyskania stopni naukowych pomijamy, bo cytowane źródło ich nie podaje.
Podpis do pracy:
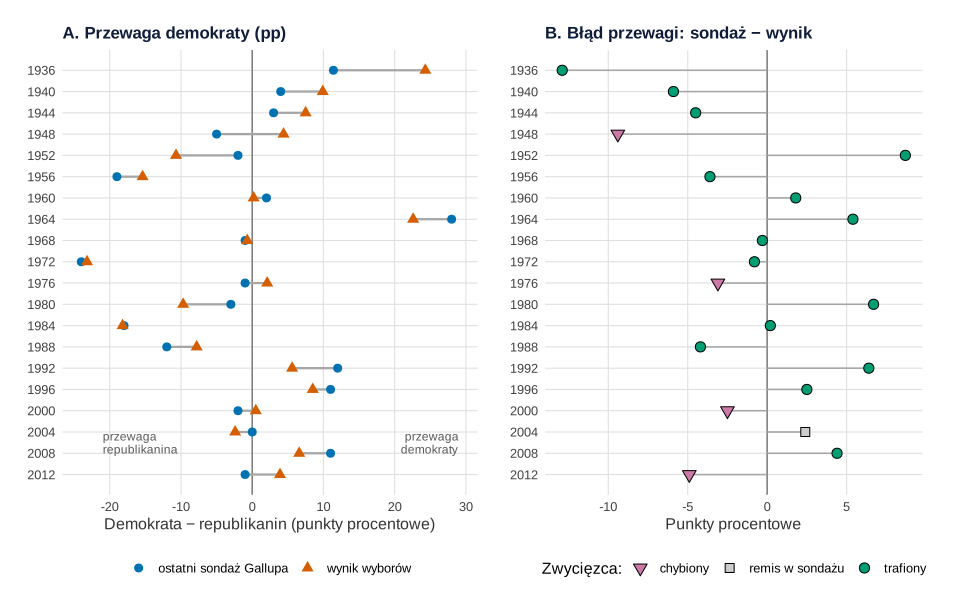
Co widać. W panelu A długość szarej linii to błąd przewagi. W pierwszych czterech wyborach trójkąty leżą wyraźnie na prawo od kółek: sondaż za każdym razem zaniżał przewagę demokraty, a w 1948 r. przeskoczył na złą stronę zera. Panel B pokazuje, że później błędy są zwykle mniejsze i wypadają w obie strony, ale nie znikają – źle wskazany zwycięzca zdarzał się przy wyrównanych wyborach.
Na co uważać. To tylko 20 wyborów, a metody i liczebności prób mogły się zmieniać w czasie; podział na lata 1936–1948 i 1952–2012 to ilustracja, nie dowód. Odsetki dla kandydatów trzecich partii pominęliśmy.
Podpis do pracy:
Gdzie spotkasz Gallupa w swojej pracy
Lekcja z 1936 i 1948 r. dotyczy każdej ankiety, także tej do pracy dyplomowej:
- liczebność nie naprawi złej próby – liczy się sposób doboru i operat losowania; zobacz wpis sondaż w obrazkach, gdzie ankieta z 10 000 odpowiedzi myli się bardziej niż mała próba losowa;
- próba kwotowa odtwarza strukturę populacji tylko w zmiennych kwotowych, a wybór osób w kategoriach zostaje w rękach ankietera lub samych respondentów;
- margines błędu obejmuje tylko błąd losowania; obciążenie z operatu czy braku odpowiedzi opisuje całkowity błąd badania sondażowego;
- ważenie pomaga tylko wtedy, gdy wagi obejmują zmienne związane z doborem – pokazuje to wpis o panelu internetowym i próbie losowej.
O tym, jak liczyć precyzję prób ze złożonym schematem, pisze hasło o Leslie Kishu.
Spory, mity i trudne strony
- Dlaczego pomylił się „Literary Digest”? Popularna odpowiedź brzmi: operat z książek telefonicznych i list właścicieli samochodów, czyli zamożniejszych wyborców. Lohr i Brick (2017) potwierdzają takie źródła operatu i podają, że odpowiedziało 24% adresatów. Squire (1988), na danych z sondażu Gallupa z 1937 r., uznał, że obciążone były i próba, i odpowiedzi; gdyby odpowiedzieli wszyscy, pismo wskazałoby przynajmniej zwycięzcę. Lusinchi (2012) twierdzi, że posiadacze telefonów i samochodów popierali Roosevelta, a błąd wynikał głównie z braku odpowiedzi jego zwolenników.
- Czy Gallup przewidział porażkę „Digestu”? Hawbaker (b.d.) pisze o publicznym wyzwaniu i gwarancji zwrotu pieniędzy. Nie podajemy, jakie dokładnie liczby Gallup zapowiadał dla „Digestu”, bo nie zweryfikowaliśmy tego w cytowanych źródłach. Jego własny sondaż też się mylił – o 12.9 punktu w przewadze.
- 1948 i dobór kwotowy. Crossley, Gallup i Roper używali doboru kwotowego i wszyscy wskazali Deweya. Przegląd zespołu Fredericka Mostellera z 1949 r. wymienił wiele źródeł błędu; przy doborze kwotowym ankieterzy wybierali nieco lepiej wykształconych i zamożniejszych respondentów, co działało na niekorzyść Trumana. Raport nie obwiniał samych kwot, ale krytykował je za brak miary rzetelności oszacowań (Baker i in., 2013).
Trafność sondaży Gallupa w R
Kod wpisuje tabelę ostatnich sondaży Gallupa i wyników wyborów prezydenckich w USA (1936–2012), liczy przewagę i błąd przewagi, podsumowuje je dla dwóch okresów i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Sondaże Gallupa a wyniki wyborów: rysunek 2
Kod R rysunku 2
# George Gallup: ostatnie sondaże Gallupa przed wyborami prezydenckimi w USA 1936–2012 a wyniki wyborów
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(sondaz = "#0072B2", wynik = "#D55E00", trafiony = "#009E73", chybiony = "#CC79A7")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
# Dane wpisane ręcznie z tabeli „The Gallup Poll (1936–2012)” w: Peters, G. (2024). Election year presidential
# preference polling and voting outcome. The American Presidency Project (UCSB). Odsetki głosów powszechnych (%):
# d_* – kandydat demokratów, r_* – kandydat republikanów; *_sondaz – ostatni sondaż Gallupa, *_wynik – wybory
g <- data.frame(
  rok = seq(1936, 2012, by = 4),
  d_sondaz = c(55.7, 52, 51.5, 44.5, 49, 40.5, 51, 64, 42, 38, 48, 44, 41, 44, 49, 52, 46, 49, 55, 49),
  r_sondaz = c(44.3, 48, 48.5, 49.5, 51, 59.5, 49, 36, 43, 62, 49, 47, 59, 56, 37, 41, 48, 49, 44, 50),
  d_wynik  = c(60.8, 54.7, 53.4, 49.5, 44.4, 42.0, 49.7, 61.1, 42.7, 37.5, 50.1, 41.0, 40.6, 45.6, 43.0, 49.2, 48.4, 48.3, 52.6, 51.1),
  r_wynik  = c(36.5, 44.8, 45.9, 45.1, 55.1, 57.4, 49.5, 38.5, 43.4, 60.7, 48.0, 50.7, 58.8, 53.4, 37.4, 40.7, 47.9, 50.7, 46.0, 47.2))
# Przewaga demokraty nad republikaninem (punkty procentowe) w sondażu i w wyborach; błąd = sondaż − wynik
g$przewaga_sondaz <- g$d_sondaz - g$r_sondaz
g$przewaga_wynik  <- g$d_wynik - g$r_wynik
g$blad_przewagi   <- g$przewaga_sondaz - g$przewaga_wynik
g$zwyciezca <- ifelse(g$przewaga_sondaz == 0, "remis w sondażu",
                      ifelse(sign(g$przewaga_sondaz) == sign(g$przewaga_wynik), "trafiony", "chybiony"))
g[, c("rok", "przewaga_sondaz", "przewaga_wynik", "blad_przewagi", "zwyciezca")]

# Podsumowanie: przeciętny błąd bezwzględny przewagi w latach 1936–1948 i 1952–2012
g$okres <- ifelse(g$rok <= 1948, "1936–1948", "1952–2012")
aggregate(cbind(sredni_blad_bezwzgledny = abs(blad_przewagi), sredni_blad_ze_znakiem = blad_przewagi) ~ okres,
          data = g, FUN = function(x) round(mean(x), 1))
table(g$okres, g$zwyciezca)
round(c(sredni_blad_bezwzgledny_wszystkie = mean(abs(g$blad_przewagi)),
        najwiekszy_blad = max(abs(g$blad_przewagi))), 1)
g$rok[which.max(abs(g$blad_przewagi))]

# Rysunek: A – przewaga w sondażu i w wyborach; B – błąd przewagi w kolejnych wyborach
dl <- rbind(data.frame(rok = g$rok, przewaga = g$przewaga_sondaz, co = "ostatni sondaż Gallupa"),
            data.frame(rok = g$rok, przewaga = g$przewaga_wynik, co = "wynik wyborów"))
pA <- ggplot(g, aes(y = rok)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_segment(aes(x = przewaga_sondaz, xend = przewaga_wynik, yend = rok), colour = "grey65", linewidth = 0.8) +
  geom_point(data = dl, aes(x = przewaga, colour = co, shape = co), size = 2.8) +
  scale_colour_manual(values = c(kol[["sondaz"]], kol[["wynik"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_y_reverse(breaks = g$rok) +
  annotate("text", x = -21, y = 2006, label = "przewaga\nrepublikanina", hjust = 0, size = 3.2, colour = "grey35", lineheight = 0.9) +
  annotate("text", x = 29, y = 2006, label = "przewaga\ndemokraty", hjust = 1, size = 3.2, colour = "grey35", lineheight = 0.9) +
  labs(title = "A. Przewaga demokraty (pp)", x = "Demokrata − republikanin (punkty procentowe)", y = NULL) +
  motyw
pB <- ggplot(g, aes(blad_przewagi, rok, fill = zwyciezca, shape = zwyciezca)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_segment(aes(x = 0, xend = blad_przewagi, yend = rok), colour = "grey65") +
  geom_point(size = 3.2, colour = "black") +
  scale_fill_manual(values = c(chybiony = kol[["chybiony"]], `remis w sondażu` = "grey80", trafiony = kol[["trafiony"]]),
                    name = "Zwycięzca:") +
  scale_shape_manual(values = c(chybiony = 25, `remis w sondażu` = 22, trafiony = 21), name = "Zwycięzca:") +
  scale_y_reverse(breaks = g$rok) +
  labs(title = "B. Błąd przewagi: sondaż − wynik", x = "Punkty procentowe", y = NULL) +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.1, 1))
p2
Wynik w R
    rok przewaga_sondaz przewaga_wynik blad_przewagi       zwyciezca
1  1936            11.4           24.3         -12.9        trafiony
2  1940             4.0            9.9          -5.9        trafiony
3  1944             3.0            7.5          -4.5        trafiony
4  1948            -5.0            4.4          -9.4        chybiony
5  1952            -2.0          -10.7           8.7        trafiony
6  1956           -19.0          -15.4          -3.6        trafiony
7  1960             2.0            0.2           1.8        trafiony
8  1964            28.0           22.6           5.4        trafiony
9  1968            -1.0           -0.7          -0.3        trafiony
10 1972           -24.0          -23.2          -0.8        trafiony
11 1976            -1.0            2.1          -3.1        chybiony
12 1980            -3.0           -9.7           6.7        trafiony
13 1984           -18.0          -18.2           0.2        trafiony
14 1988           -12.0           -7.8          -4.2        trafiony
15 1992            12.0            5.6           6.4        trafiony
16 1996            11.0            8.5           2.5        trafiony
17 2000            -2.0            0.5          -2.5        chybiony
18 2004             0.0           -2.4           2.4 remis w sondażu
19 2008            11.0            6.6           4.4        trafiony
20 2012            -1.0            3.9          -4.9        chybiony
      okres sredni_blad_bezwzgledny sredni_blad_ze_znakiem
1 1936–1948                     8.2                   -8.2
2 1952–2012                     3.6                    1.2

            chybiony remis w sondażu trafiony
  1936–1948        1               0        3
  1952–2012        3               1       12
sredni_blad_bezwzgledny_wszystkie                   najwiekszy_blad
                              4.5                              12.9
[1] 1936
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: George Gallup (1901–1984) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1901, 1921, 1922, 1929, 1932, 1935, 1936, 1948, 1969, 1984),
  opis = c("urodził się\nw Jefferson (Iowa)", "redaktor\n„Daily Iowan”", "ankiety od drzwi\ndo drzwi (St. Louis)",
           "kieruje dziennikarstwem\nna Drake University", "Young & Rubicam;\nsondaże wyborcze w Iowa",
           "American Institute\nof Public Opinion", "wybory: wyzwanie\ndla „Literary Digest”",
           "błędna prognoza\n(Dewey zamiast Trumana)", "coroczny sondaż\no szkołach publicznych",
           "zmarł\nw Szwajcarii"),
  rodzaj = c("życie", "praca", "praca", "praca", "praca", "praca", "publikacja", "publikacja", "publikacja", "życie"),
  poziom = c(0.45, -0.45, 1.25, -1.25, 0.45, -0.45, 1.25, -1.25, 0.45, -0.45),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 1, 0.5, 0.5, 1, 0, 0.5, 0.5, 0.5, 0.5))                      # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.2, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, labels = c("życie" = "życie", "praca" = "praca", "publikacja" = "sondaż / prognoza"), name = NULL) +
  scale_fill_manual(values = kolory, labels = c("życie" = "życie", "praca" = "praca", "publikacja" = "sondaż / prognoza"), name = NULL) +
  scale_x_continuous(limits = c(1894, 1991), breaks = seq(1900, 1990, by = 10)) +
  scale_y_continuous(limits = c(-2.1, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (obliczenia – funkcje aggregate() i table() z pakietów stats i base; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był George Gallup?
Amerykańskim badaczem opinii publicznej (1901–1984) z Iowa. Był dziennikarzem i wykładowcą dziennikarstwa, pracował w agencji reklamowej Young & Rubicam, a w 1935 r. założył w Princeton American Institute of Public Opinion. Zmarł w 1984 r. w Szwajcarii (Hawbaker, b.d.).
Dlaczego „Literary Digest” pomylił się w 1936 roku?
Pismo rozesłało 10 mln kart i dostało 2.3 mln odpowiedzi, ale ani wielkość, ani źródło próby nie dawały reprezentatywności. Badacze spierają się o proporcje: operat z książek telefonicznych i rejestrów samochodów, niski odsetek odpowiedzi (24%) czy to, że nie odpowiadali głównie zwolennicy Roosevelta (Squire, 1988; Lusinchi, 2012; Lohr i Brick, 2017).
Dlaczego sondaż Gallupa pomylił się w 1948 roku?
Według raportu AAPOR przegląd z 1949 r. wskazał wiele źródeł błędu; jednym był dobór kwotowy, w którym ankieterzy wybierali nieco lepiej wykształconych i zamożniejszych respondentów, co obciążało próbę na niekorzyść Trumana (Baker i in., 2013). Gallup dawał Deweyowi 5 punktów przewagi, a Truman wygrał o 4.4.
Jak dokładne były sondaże Gallupa przed wyborami prezydenckimi?
W latach 1936–2012 przeciętny błąd przewagi kandydata demokratów nad republikaninem wynosił 4.5 punktu procentowego – 8.2 w latach 1936–1948 i 3.6 później. Zwycięzcę w głosach powszechnych sondaż wskazał źle w 4 z 20 wyborów (dane: Peters, 2024).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Sondaż w obrazkach
Margines błędu a n i odsetek 50%, 1000 sondaży, różnica dwóch odsetków, duża ankieta online z błędem i liczba zaproszeń – sześć rysunków z R.
Czytaj →PoradnikCałkowity błąd badania sondażowego (TSE)
Pokrycie, brak odpowiedzi, pomiar i ważenie w jednym rachunku MSE: symulacja czterech planów za ten sam budżet i opis ograniczeń.
Czytaj →PoradnikPanel internetowy a próba losowa
Sieć ładowarek: panel 20.8%, prawda 12.8%. Raking, kalibracja do próby losowej, efektywna liczebność i 1000 badań – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Baker, R., Brick, J. M., Bates, N. A., Battaglia, M., Couper, M. P., Dever, J. A., Gile, K. J., & Tourangeau, R. (2013). Report of the AAPOR Task Force on Non-Probability Sampling. American Association for Public Opinion Research. https://www.aapor.org/wp-content/uploads/2022/11/NPS_TF_Report_Final_7_revised_FNL_6_22_13.pdf ● Otwarty dostęp
- Hawbaker, B. W. (b.d.). Gallup, George Horace. The Biographical Dictionary of Iowa. Pobrano 20 listopada 2026 z https://uipress.lib.uiowa.edu/bdi/DetailsPage.aspx?id=131 ● Otwarty dostęp
- Lohr, S. L., & Brick, J. M. (2017). Roosevelt predicted to win: Revisiting the 1936 Literary Digest poll. Statistics, Politics and Policy, 8(1), 65–84. https://doi.org/10.1515/spp-2016-0006
- Lusinchi, D. (2012). “President” Landon and the 1936 Literary Digest poll: Were automobile and telephone owners to blame? Social Science History, 36(1), 23–54. https://doi.org/10.1017/s014555320001035x ● Otwarty dostęp
- Peters, G. (2024). Election year presidential preference polling and voting outcome. The American Presidency Project (J. T. Woolley & G. Peters, Eds.). https://www.presidency.ucsb.edu/statistics/data/election-year-presidential-preferences ● Otwarty dostęp
- Squire, P. (1988). Why the 1936 Literary Digest poll failed. Public Opinion Quarterly, 52(1), 125–133. https://doi.org/10.1086/269085
Cytowania BibTeX
@techreport{baker2013report, author={Baker, Reg and Brick, J. Michael and Bates, Nancy A. and Battaglia, Mike and Couper, Mick P. and Dever, Jill A. and Gile, Krista J. and Tourangeau, Roger}, title={{Report of the AAPOR Task Force on Non-Probability Sampling}}, year={2013}, institution={American Association for Public Opinion Research}, url={https://www.aapor.org/wp-content/uploads/2022/11/NPS_TF_Report_Final_7_revised_FNL_6_22_13.pdf}}@misc{hawbakergallupnd, author={Hawbaker, Becky Wilson}, title={{Gallup, George Horace}}, howpublished={The Biographical Dictionary of Iowa}, publisher={University of Iowa Press}, url={https://uipress.lib.uiowa.edu/bdi/DetailsPage.aspx?id=131}}@article{lohr2017roosevelt, author={Lohr, Sharon L. and Brick, J. Michael}, title={{Roosevelt predicted to win: Revisiting the 1936 Literary Digest poll}}, journal={Statistics, Politics and Policy}, year={2017}, volume={8}, number={1}, pages={65--84}, doi={10.1515/spp-2016-0006}}@article{lusinchi2012president, author={Lusinchi, Dominic}, title={{“President” Landon and the 1936 Literary Digest poll: Were automobile and telephone owners to blame?}}, journal={Social Science History}, year={2012}, volume={36}, number={1}, pages={23--54}, doi={10.1017/s014555320001035x}}@misc{peters2024election, author={Peters, Gerhard}, title={{Election year presidential preference polling and voting outcome}}, howpublished={The American Presidency Project (J. T. Woolley \& G. Peters, Eds.)}, year={2024}, publisher={University of California, Santa Barbara}, url={https://www.presidency.ucsb.edu/statistics/data/election-year-presidential-preferences}}@article{squire1988why, author={Squire, Peverill}, title={{Why the 1936 Literary Digest poll failed}}, journal={Public Opinion Quarterly}, year={1988}, volume={52}, number={1}, pages={125--133}, doi={10.1086/269085}}